 VLSI Korea
Los TPU de Google se amortizan en menos de un año: la economía del silicio personalizado frente a NVIDIA
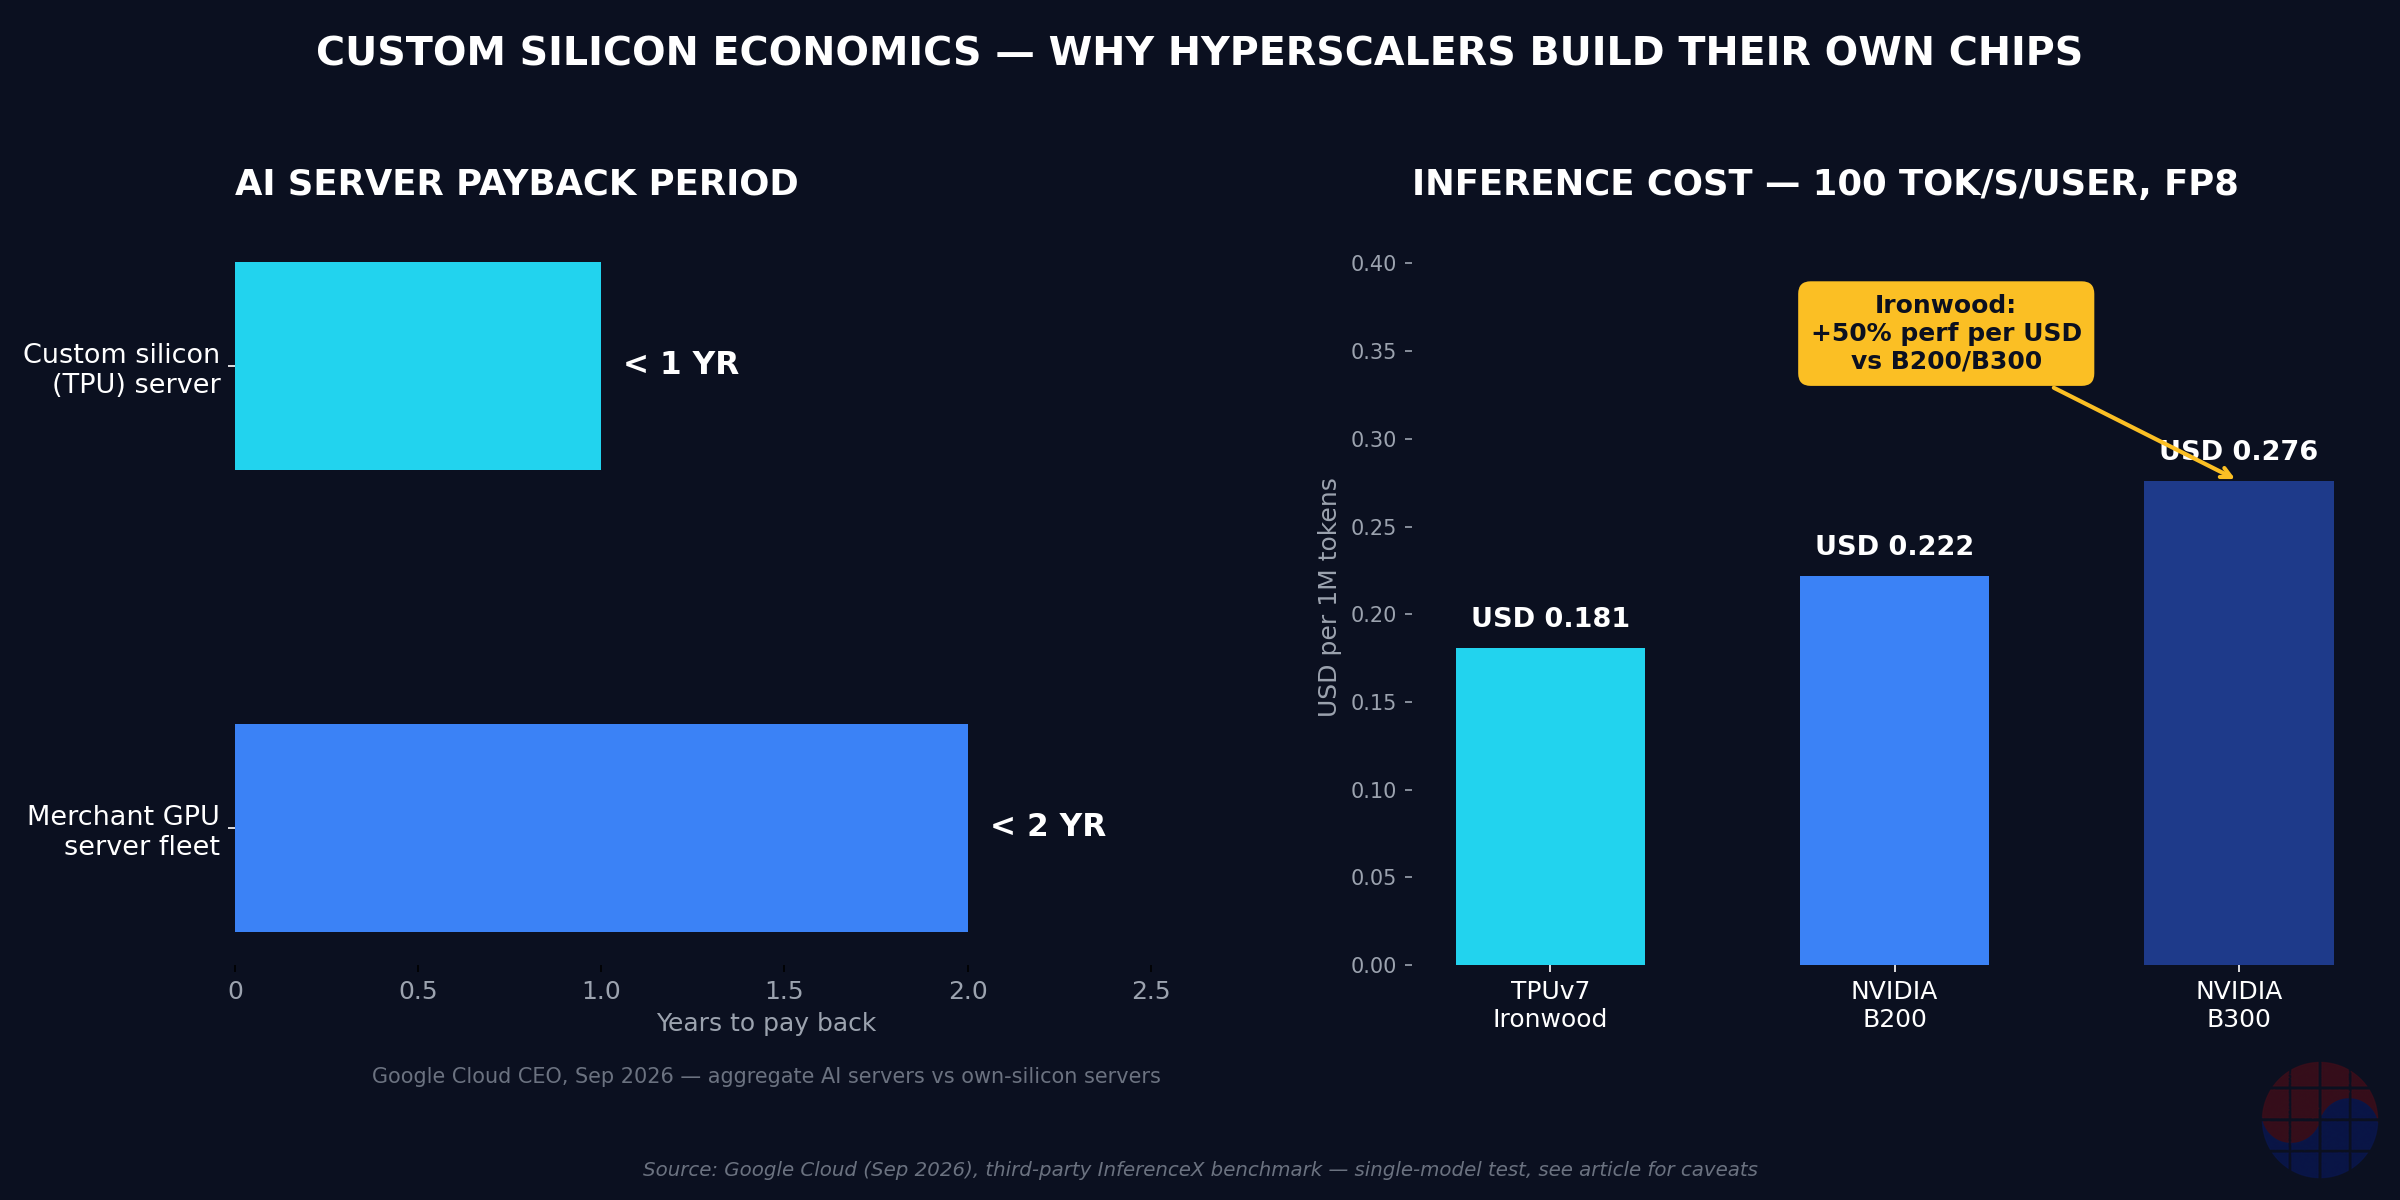
Los servidores con TPU de Google recuperan su inversión en menos de un año. El TPUv7 Ironwood ofrece hasta un 50% mejor rendimiento por dólar en inferencia que el B200/B300. Con un año de amortización, fabricar tu propio chip no es una opción: es sentido común financiero.


Extracto: Los servidores con TPU de Google recuperan su inversión en menos de un año. El TPUv7 Ironwood ofrece hasta un 50% mejor rendimiento por dólar en inferencia que el B200/B300. Con un periodo de amortización de un año, fabricar tu propio chip no es una opción: es sentido común financiero. La cadena de valor ASIC de Broadcom y MediaTek entra en crecimiento estructural.
Resumen en 30 segundos (AEO)
- El CEO de Google Cloud, Thomas Kurian, reveló en septiembre de 2026: los servidores de IA se amortizan en menos de dos años en conjunto; los servidores con silicio propio (TPU) lo hacen en aproximadamente la mitad de tiempo. Un año de amortización convierte el silicio personalizado de "opción estratégica" en sentido común financiero. (Fuente)
- La evaluación independiente (InferenceX) concluyó que el TPUv7 Ironwood ofrece "hasta un 50% mejor rendimiento por dólar" frente al B200/B300 en inferencia comparable, con la salvedad de ser una prueba de un solo modelo (Qwen 3.5 397B, FP8) realizada por el proveedor. (Fuente)
- Anthropic reveló en su documentación de IPO de octubre de 2026 un arrendamiento de capacidad TPU a cinco años por 125.200 millones de dólares; Broadcom acordó hasta 42.000 millones en financiación mediante deuda convertible. Venta de chips más finanzas: un nuevo modelo comercial. (Fuente)
- MediaTek duplicó su previsión de ingresos ASIC para 2026 hasta más de 2.000 millones de dólares, con su primer ASIC de IA para Google entrando en producción masiva en el cuarto trimestre de 2026. (Fuente)
- Conclusión: a escala de hiperescalador, el debate fabricar-vs-comprar ha terminado. El periodo de amortización decide.
Background: por qué silicio personalizado, por qué ahora
Durante años, el debate de los chips de IA era quién era más rápido. En la segunda mitad de 2026 la pregunta cambió. Con Alphabet previendo entre 195.000 y 205.000 millones de dólares de capex en 2026 (fuente), los accionistas dejaron de preguntar por los FLOPS y empezaron a preguntar cuándo vuelve el dinero.
La respuesta de Kurian fue inusualmente concreta. En la Goldman Sachs Communacopia + Technology Conference del 8 de septiembre de 2026 dijo que la amortización agregada de los servidores de IA era inferior a dos años, y que la del silicio propio era aproximadamente la mitad. Google Cloud lo repitió en un resumen oficial el 11 de septiembre. Añadió que Google Cloud ofrece 2,7 veces mejor relación precio-rendimiento en entrenamiento y un 80% mejor en inferencia, y que su negocio de aceleradores es más del doble que el del siguiente hiperescalador. (Fuente)
El peso de la declaración no está en el número dos, sino en lo que un periodo de amortización de un año hace a la economía de fabricar tu propio chip. El NRE de un ASIC de IA de nodo avanzado (diseño, máscaras, validación) ronda los 100–200 millones de dólares. Repartido entre un millón de chips, son 100–200 dólares por chip: insignificante frente a la cuña de margen merchant de las GPU (el margen bruto de NVIDIA supera el 70%). Cuando el volumen acompaña, fabricar tu propio silicio es incondicionalmente más barato. La declaración de Kurian equivale a que el CEO de Google Cloud declare que el volumen acompaña.
Business Deep Dive
Tamaño del mercado: ~80.000 millones de dólares en chips de IA personalizados para 2027
Las estimaciones de los analistas sitúan el TAM de chips de IA personalizados en torno a 70.000–80.000 millones de dólares para 2027. MediaTek dijo a los inversores en julio de 2026 que aspira a capturar entre el 15% y el 20%. (Fuente)
Los movimientos de los hiperescaladores ya están en el marcador:
- Google: En Cloud Next de abril de 2026 presentó los TPU de octava generación (8t para entrenamiento, 8i para inferencia) y una nueva arquitectura de red Virgo que enlaza 134.000 TPU en un solo centro de datos y más de un millón entre sedes en un único clúster lógico. (Fuente) La restricción ya no es el suministro de silicio sino la energía: a escala de cientos de miles, cuánta potencia acondicionada puedes alimentar a los racks limita el crecimiento. (Fuente)
- Anthropic: Un acuerdo plurianual firmado en octubre de 2025 compromete hasta un millón de TPU Ironwood (cifras reportadas en decenas de miles de millones de dólares), y la documentación de IPO del 1 de octubre de 2026 reveló un arrendamiento de capacidad TPU a cinco años por 125.200 millones de dólares. (Fuente)
- Meta: 'Iris', el chip del programa MTIA co-diseñado con Broadcom, entró en producción en volumen en TSMC en 3nm en septiembre de 2026. Meta planea duplicar su capacidad de cómputo de IA de 7GW en 2026 a 14GW a finales de 2027. (Fuente)
- OpenAI: Presentó su primer chip personalizado 'Jalapeño' con Broadcom en junio de 2026, con 10GW de co-desarrollo en marcha. Los despliegues de racks empiezan a finales de 2026 y continúan hasta 2029. (Fuente)
Estructura de costes: dónde diverge el TCO
La economía de Ironwood descansa en tres palancas.
1. Rendimiento por dólar. En la evaluación InferenceX (Qwen 3.5 397B, FP8, 100 tokens/s/usuario), Ironwood costó 0,181 dólares por millón de tokens frente a 0,222 del B200 y 0,276 del B300: la base del "hasta 50% mejor rendimiento por dólar". En TCO interno, un servidor Ironwood se estima ~44% más barato que un servidor GB200 Blackwell equivalente; clientes externos como Anthropic ven ahorros de ~30% frente a NVIDIA. (Fuente) Salvedad: prueba de un solo modelo y condición, realizada por el proveedor. Un contrapunto con sabor independiente: la startup Inferact evaluó el Kimi K3 de Moonshot AI en el mismo motor vLLM — 16 chips TPUv7 alcanzaron 709 tokens/s frente a 452 de 16 GB200, un 57% de ventaja incluyendo optimización de la pila de software. (Fuente)
2. Eliminación del margen merchant. Cuando Google vende o alquila sus propios chips a terceros, el precio no lleva la cuña de margen merchant al estilo NVIDIA. Es hardware verticalmente integrado (chip, interconexión, pila de software) a coste interno más tarifas de servicio cloud. Mismos FLOPS, estructura de factura distinta.
3. Energía y economías de escala. La energía y la refrigeración rozan el 40% del TCO del centro de datos. Los vatios por chip importan, pero a escala de un millón la eficiencia de la arquitectura de red (goodput) decide el dinero, por eso Google anuncia "más del 97% de goodput" para el TPU 8t. Es el mismo juego estructural que los fabricantes de memoria juegan con el rendimiento (yield): no la performance unitaria, sino la economía de los ciclos que sobreviven.
Posicionamiento competitivo: cuatro ejes
| Eje | Jugadores | Posición |
|---|---|---|
| Chips propios de hiperescaladores | Google TPU, Meta MTIA, Amazon Trainium, Microsoft Maia, OpenAI Jalapeño | Específicos por carga de trabajo; eliminan el margen merchant |
| Socios de diseño ASIC | Broadcom, MediaTek, Marvell, Alchip | Ganan por diseño + integración CoWoS + HBM |
| Foundry | TSMC (monopolio efectivo) | Asignador de capacidad de nodo avanzado |
| Memoria | SK hynix, Samsung, Micron (HBM) | Las pilas HBM por chip (cientos de Gb por chip) son un eje de coste clave |
La posición de Broadcom es la más interesante. Firmó en abril de 2026 un acuerdo a largo plazo de suministro de TPU y redes con Google hasta 2031 (fuente), amplió el 14 de abril su colaboración MTIA con Meta (más de 1GW) y co-desarrolla 10GW con OpenAI. Es decir, Broadcom diseña simultáneamente chips para tres bandos de IA en competencia: el arsenal de la guerra del silicio personalizado.
MediaTek ataca desde otro ángulo: reciclar la IP de CPU, GPU y NPU de la era smartphone y sus activos de diseño de bajo consumo en ASIC para centros de datos. En el segundo trimestre de 2026, su segmento Smart Device Platform (incluye ASIC) superó por primera vez a los chips de smartphone como mayor fuente de ingresos. Las llamadas de resultados de abril y julio duplicaron la previsión de ingresos ASIC de 2026 hasta más de 2.000 millones de dólares, con el primer acelerador de IA para Google entrando en producción masiva en el cuarto trimestre de 2026. (Fuente) A vigilar: rumores de mercado sobre entregas de muestras y rendimientos hacen de la ejecución del cuarto trimestre la verdadera prueba.
Opciones estratégicas: tres escenarios
- La integración vertical se acelera (caso base): si la externalización de TPU tiene éxito, el 20–30% de las cargas de inferencia correrá en silicio personalizado en lugar de GPU merchant para 2027. Re-rating de múltiplos para los socios de diseño ASIC.
- El merchant contraataca: NVIDIA puede estrechar la brecha de TCO con precios y paquetes en la generación Rubin. El coste de cambio del ecosistema CUDA sigue siendo un foso. Que Ironwood solo soporte FP8 de forma nativa (FP4 llega con TPUv8i) limita el rango válido de la comparación.
- El riesgo financiero se materializa (caso bajista): la financiación a clientes al estilo Broadcom se parece estructuralmente a la financiación a proveedores de Nortel y Lucent en la burbuja de telecomunicaciones de 2001: los fabricantes de equipos sostuvieron las compras de los clientes hasta que el crédito de estos colapsó. La exposición máxima de 29.000 millones de dólares en la propia declaración trimestral de Broadcom muestra ambas caras de esta estructura. (Fuente)
Chase's Take
La lectura como caso MBA es única: el fabricar-vs-comprar lo decide el periodo de amortización, no la tecnología.
En el análisis clásico, divides el coste fijo (NRE) entre el volumen. En los chips de IA el denominador crece exponencialmente mientras el numerador, aunque aumenta con los nodos avanzados, no le sigue el ritmo. Un millón de chips × miles de dólares ahorrados por chip = miles de millones. En el momento en que esa ecuación se cumple, el CFO pregunta a ingeniería "por qué no lo fabricamos". La declaración de Kurian es la respuesta a nivel CEO a esa pregunta.
Segundo: la innovación GTM de Broadcom. Una empresa de chips que presta 42.000 millones de dólares a su cliente no es un descuento: es "las finanzas como ventas". En positivo, maximización de barreras de entrada (cautividad del cliente); en negativo, internalización del riesgo crediticio. Los inversores deberían leer el balance de Broadcom con ojos de cuasi-banco, no de empresa de chips.
Tercero, la perspectiva de mercados emergentes. Este juego tiene dos asientos para el resto del mundo. Uno es la HBM: con 8–12 pilas HBM (cientos de Gb por chip) por acelerador personalizado, el crecimiento del volumen ASIC es crecimiento de la demanda de HBM. El otro es el manual fabless: la estrategia de MediaTek de reciclar IP de smartphones es una plantilla que los fabless de cualquier región pueden seguir hacia ASIC específicos por carga de trabajo (inferencia, edge).
Implications: inversión y gestión
- Inversión: los socios de diseño ASIC (Broadcom, MediaTek, Marvell, Alchip) están en fase de crecimiento estructural. Pero los múltiplos pueden reflejarlo ya en buena parte: hay que seguir trimestralmente la rampa de producción de MediaTek en el cuarto trimestre y la exposición financiera de Broadcom. En foundry, la asignación de capacidad avanzada de TSMC determina cada vez más la calidad de la cartera de clientes.
- Gestión: los compradores de cloud no deberían presupuestar el TCO de inferencia de 2027 solo con cotizaciones de GPU merchant. Hay que incluir siempre una oferta paralela de externalización de TPU: solo el apalancamiento negociador ha recortado ~30% los precios de GPU existentes en casos documentados (OpenAI). (Fuente)
- Riesgo: el escenario donde se rompen las estructuras de financiación a clientes no viene de un desplome de la demanda de chips sino de una contracción del crédito. Con la financiación de infraestructura de IA ya en cientos de miles de millones, la métrica a vigilar son los diferenciales y los swaps de impago, no los envíos de chips.
FAQ
Q1. ¿Los TPU realmente se amortizan en menos de un año? Es la cifra oficial del CEO de Google Cloud en una conferencia de septiembre de 2026: menos de dos años para los servidores de IA en conjunto, aproximadamente la mitad para el silicio propio. Refleja la contabilidad interna de Google; no significa que clientes externos puedan replicar las mismas condiciones. (Fuente)
Q2. ¿Es justa la comparación del "50% mejor rendimiento por dólar" de Ironwood? Tiene los límites de una prueba de un solo modelo, una sola condición, realizada por el proveedor. Pero una evaluación independiente (Inferact) también mostró al TPUv7 por delante del GB200, y los análisis de TCO interno apuntan en la misma dirección. El contraargumento: el soporte nativo solo hasta FP8. (Fuente)
Q3. ¿Por qué importa que Broadcom preste 42.000 millones a Anthropic? Es un nuevo modelo comercial donde la venta de chips y las finanzas se fusionan: el proveedor sostiene directamente el poder de compra del cliente para ganar el pedido, absorbiendo a cambio el riesgo crediticio del cliente. La estructura recuerda a la financiación a proveedores de la burbuja de telecomunicaciones de 2001: hay que leer ambas caras. (Fuente)
Q4. ¿Qué significa para las empresas de semiconductores fuera de EE. UU.? En HBM es favorable para SK hynix, Samsung y Micron: los chips personalizados también llevan HBM. En diseño, el manual de MediaTek de "reciclar IP de smartphones" es una plantilla replicable.
Lecturas recomendadas
- El panorama de la lucha por los chips de IA: Chip War — Chris Miller (Amazon)
- Anatomía del modelo de negocio de NVIDIA: The Nvidia Way — Tae Kim (Amazon)
Las compras a través de este enlace pueden generar una comisión.
Este artículo es un análisis basado en comunicados públicos, llamadas de resultados y prensa; no es asesoramiento de inversión. Las cifras citadas corresponden a las fechas de publicación de sus fuentes (abril–octubre de 2026) y pueden haber cambiado.


