 VLSI Korea
¿Inferencia de IA sin HBM? La apuesta de Intel con 480 GB de LPDDR5X y la guerra del TCO
Intel desveló en OCP 2026 la GPU D270 para inferencia: 1,3 PFLOPS en FP8, hasta 480 GB de LPDDR5X en tarjetas de socios ODM y 350 W con refrigeración por aire. Con la HBM agotada en 2026 y buena parte de 2027 comprometida, la batalla ya no es el ancho de banda: es el costo por token.


Excerpt: Intel desveló en OCP 2026 la GPU D270 para inferencia: 1,3 PFLOPS en FP8, hasta 480 GB de LPDDR5X en tarjetas de socios ODM y 350 W con refrigeración por aire. Con la HBM agotada en 2026 y buena parte de 2027 comprometida, la batalla ya no es el ancho de banda: es el costo por token.
¿Inferencia de IA sin HBM? La apuesta de Intel con 480 GB de LPDDR5X y la guerra del TCO
Resumen en 30 segundos: Intel desveló en la cumbre OCP 2026 su GPU D270 (Crescent Island) para inferencia: 1,3 PFLOPS en FP8, 1,5 TB/s de ancho de banda de memoria y una tarjeta PCIe de 350 W refrigerada por aire. La noticia no es la HBM: es la LPDDR5X — 160 GB en la tarjeta propia de Intel, hasta 480 GB en las tarjetas de sus socios ODM. Una sola tarjeta aloja un modelo de 300B de parámetros en FP8; un sistema de ocho GPU gestiona más de un billón de parámetros. Precio no publicado, sin benchmarks independientes todavía. Mientras tanto, la HBM está prácticamente agotada para 2026 y gran parte del suministro de 2027 ya está comprometido. Quien consigue la memoria impone la arquitectura — y en inferencia, la guerra se gana en costo por token (TCO), no en ancho de banda.
Background
La infraestructura de IA está desplazando su centro de gravedad del entrenamiento (training) a la inferencia. El entrenamiento es una carrera de cómputo colosal y puntual; la inferencia es un servicio continuo que emite miles de millones de tokens cada día. Cuando la carga de trabajo se convierte en un servicio, la estructura de costos se convierte en la estrategia.
Pero a finales de 2026, el primer muro con el que se topan los planificadores de infraestructura de inferencia no es el FLOPS de la GPU: es la compra de memoria. Samsung afirma que su volumen de HBM4 de 2026 está prácticamente agotado. SK hynix informa de que toda su producción de DRAM y NAND de 2026 está vendida. Según la prensa del sector, Micron ya tiene comprometida gran parte de su memoria de 2027 a precios más altos. (Source: RCR Wireless)
En este contexto, la respuesta de Intel en la cumbre global de OCP del 12 de octubre resulta llamativa: no entrar en la batalla por la HBM y construir sobre una memoria completamente distinta.
Business Deep Dive
1. Diseccionando la D270: por qué LPDDR5X
Las especificaciones publicadas por Intel para la GPU D270 (antes Crescent Island): (Source: Intel)
| Elemento | Especificación |
|---|---|
| Arquitectura | Xe3P — 32 núcleos Xe3P, 256 motores matriciales XMX, 32 MB de caché L2 unificada |
| Cómputo | 1,3 PFLOPS en FP8 |
| Memoria | LPDDR5X — 160 GB (tarjeta de Intel) / hasta 480 GB (tarjetas de socios ODM) |
| Ancho de banda de memoria | 1,5 TB/s |
| Potencia y refrigeración | 350 W, refrigeración por aire, PCIe 5.0 x16 |
| Modelos soportados | 300B de parámetros por tarjeta, más de un billón de parámetros con 8 GPU |
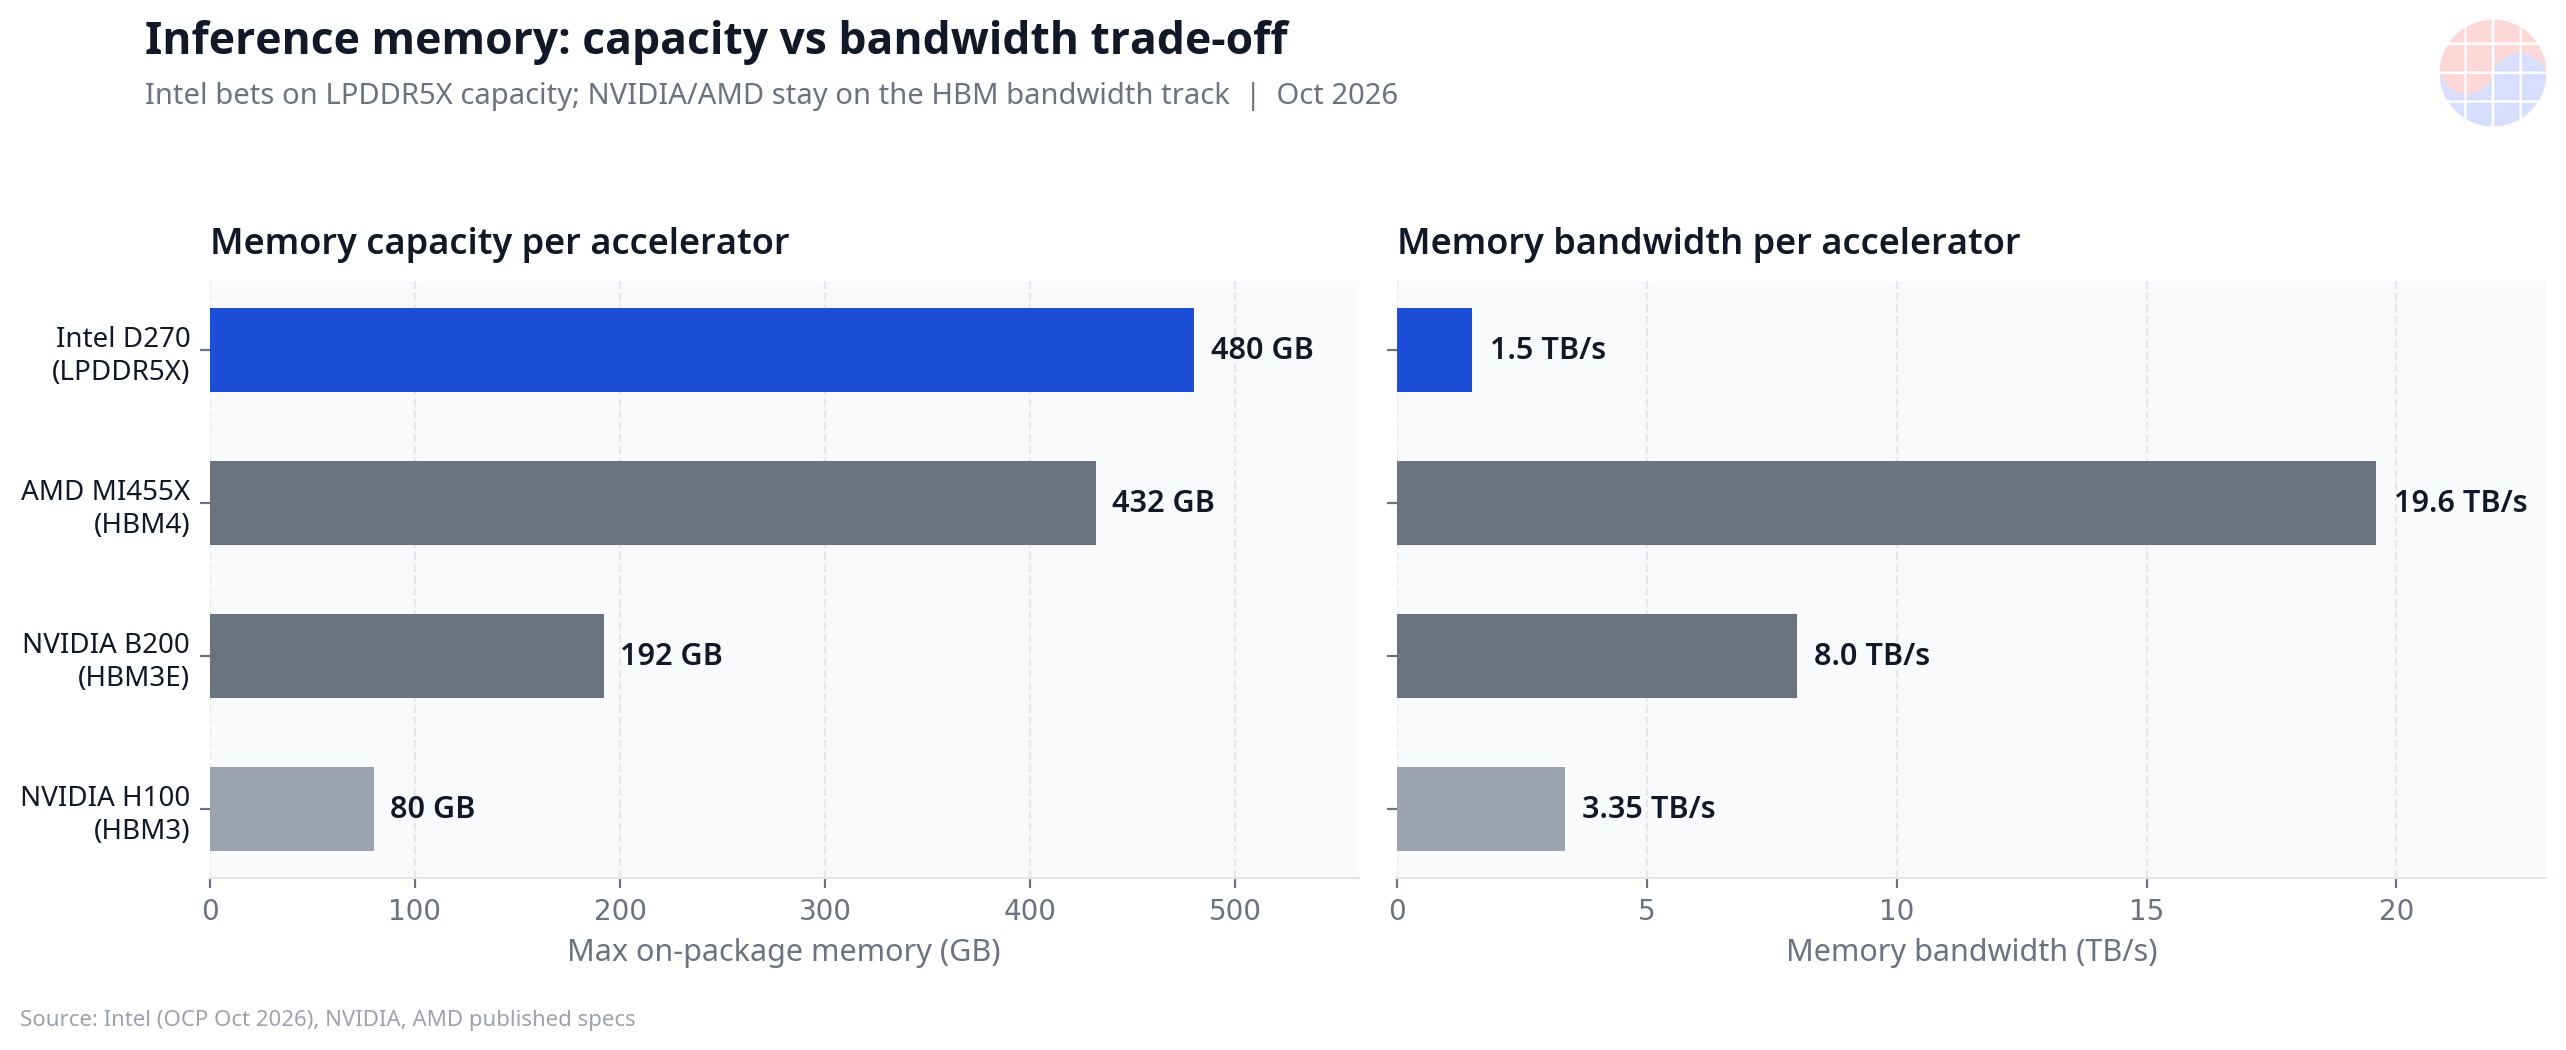
La decisión de diseño más reveladora: el hardware convencional de gráficos 3D y de trazado de rayos ha desaparecido. El área del chip que antes ocupaban las unidades gráficas de función fija ahora está al servicio del cómputo de IA. La inferencia, grabada en el silicio como único propósito.
La segunda decisión es la memoria: LPDDR5X en lugar de HBM. Con 1,5 TB/s, el ancho de banda es aproximadamente una quinta parte del de una tarjeta de clase HBM3E (8 TB/s). La capacidad, en cambio, es abrumadora: los 480 GB de las tarjetas de los socios son unas 2,5 veces los de la generación insignia actual de HBM.
Las matemáticas son simples. En FP8, un parámetro ocupa aproximadamente un byte, así que los pesos de un modelo de 300B de parámetros (~300 GB) caben cómodamente en una tarjeta de 480 GB. Los ~180 GB restantes van al devorador oculto de memoria de la inferencia, la KV cache, y al procesamiento por lotes (batching). Un modelo de un billón de parámetros repartido en 8 tarjetas necesita ~125 GB por tarjeta. El déficit de ancho de banda pesa menos que en el entrenamiento, porque la inferencia reutiliza los pesos ya cargados a lo largo de miles de tokens.
La tercera decisión es la potencia y el formato. Una tarjeta PCIe de 350 W refrigerada por aire se integra en la infraestructura existente de los centros de datos. A diferencia de los aceleradores de clase 1.000 W refrigerados por líquido, no exige inversión especial en potencia ni refrigeración — un factor con más peso en el TCO de lo que parece.
Las advertencias son igualmente claras. Precio no publicado. La disponibilidad general solo aparece descrita como 2027 en la prensa. Y no existen benchmarks independientes: los 1,3 PFLOPS son un pico teórico. (Source: VideoCardz)
2. La escasez de memoria está reescribiendo las arquitecturas
Para entender la apuesta de Intel hay que mirar dónde está el mercado de memoria en octubre de 2026:
- HBM4 (generación actual): el volumen de 2026 de Samsung está prácticamente agotado; toda la producción de DRAM y NAND de 2026 de SK hynix está vendida. No se puede comprar lo que no existe.
- HBM4E (siguiente generación): interfaz de 2.048 bits, 14–16 Gbps por pin, hasta 3,6 TB/s por pila. Muestras de 12-high (384Gb (48GB)) enviadas por Samsung (mayo) y SK hynix (junio). Producción en volumen prevista para 2027. Todavía es una generación definida por los fabricantes, sin estándar JEDEC. (Source: RCR Wireless)
- Según informes, la HBM4E de 12-high de Samsung habría superado las pruebas de cualificación de NVIDIA, aunque ni Samsung ni NVIDIA lo han confirmado oficialmente. (Source: HardwareBrief)
- Micron habría vendido ya el 75 % de su suministro de memoria de 2027. (Source: Tech Insider)
En otras palabras, subirse a la hoja de ruta de la HBM significa hacer cola por la asignación de 2027. En ese mercado, "construir una granja de inferencia sin HBM" no es solo una reducción de costos: es evitar el riesgo de aprovisionamiento. La LPDDR5X es DRAM commodity producida en masa para teléfonos y PC. Sin el cuello de botella del empaquetado TSV/interposer, con una amplia base de proveedores y un menor costo por GB. Tesla llegó a la misma conclusión.
3. Tesla se mueve en la misma dirección: recorte de memoria en AI5/AI6
El 1 de octubre, Elon Musk anunció que Tesla recortaría la memoria de AI5 de los 144 GB de LPDDR5 previstos a 72 GB, y la de AI6 a 144 GB de LPDDR6 (un recorte de un tercio). La razón fue explícita: asegurar suficiente volumen para la producción de Optimus. AI5 se ajustó después a 96 GB. Musk añadió que el ancho de banda de memoria, no la capacidad, es la restricción más importante, por lo que el impacto en el rendimiento debería ser despreciable. (Source: Wccftech)
El patrón es inconfundible: la crisis de memoria está cambiando las propias especificaciones de diseño, y redefinir los productos en torno a la memoria que se puede conseguir se convierte en el procedimiento estándar del hardware de IA a finales de 2026. AI5 ya está en producción de prueba en la fab de Samsung Foundry en Taylor, Texas.
4. Las estrategias de memoria divergen: NVIDIA frente a Intel
Quienes confían en su suministro de memoria van en la dirección opuesta. La hoja de ruta de NVIDIA:
- Rubin (2026): HBM4
- Rubin Ultra (2027): HBM4E
- Feynman (2028): según informes, HBM personalizada: un diseño a medida en lugar de HBM estándar (Source)
- NVHBM (anunciada en agosto de 2026): la tecnología de HBM personalizada de NVIDIA para el dado base (base die), codiseñada con los fabricantes de memoria: +30 % de ancho de banda por pila frente a la HBM4E estándar, −15 % de potencia de la HBM y −67 % de área del PHY (Source: WeDoAny)
AMD también se mantiene en la vía HBM: la MI455X integra 432GB (3,456Gb) de HBM4 a 19,6 TB/s. (Source: TweakTown)
La estrategia de memoria se está bifurcando:
| Estrategia | Jugadores | Dirección |
|---|---|---|
| Optimización de ancho de banda y potencia | NVIDIA (HBM personalizada NVHBM), AMD (HBM4/HBM4E) | Exprimir más la memoria cara: entrenamiento e inferencia insignia |
| Optimización de capacidad y costo | Intel (480 GB LPDDR5X), Tesla (LPDDR5/6) | Más de la memoria barata: competencia de TCO en granjas de inferencia |
Ninguna es "la correcta". Las cargas de trabajo se están dividiendo. El entrenamiento de frontera y la inferencia premium son voraces en ancho de banda; el servicio masivo de tokens, los dispositivos y la inferencia robótica dependen de la capacidad y el costo.
5. Descomponiendo el TCO: cuatro palancas detrás del costo por token
El TCO de la infraestructura de inferencia se descompone en cuatro palancas:
① Aprovisionamiento de memoria. La HBM está agotada: los compradores luchan por asignación pagando prima. La LPDDR5X es un mercado commodity con capacidad de negociación y estabilidad de suministro.
② Potencia y refrigeración. 350 W con aire frente a 1.000 W con líquido no es solo potencia del chip: arrastra la densidad de potencia por rack, el CAPEX de la refrigeración líquida y la factura eléctrica. Por eso Intel presume de "escalar sin infraestructura especializada de rack o refrigeración".
③ Capacidad por servidor. Un sistema de 8× D270 ofrece 3,84 TB de memoria para modelos de más de un billón de parámetros. Menos nodos significa menos redes, menos potencia y menos complejidad operativa. La capacidad es densidad de nodos.
④ Utilización. Los servidores de inferencia viven limitados por la memoria, no ociosos. Incluso con menor ancho de banda, cachés KV grandes y lotes amplios extraen rendimiento en tokens.
Chase's Take
Si la métrica del entrenamiento era el FLOPS, la métrica de la inferencia es el dólar por token. La apuesta de Intel traduce esa proposición al silicio. 1,3 PFLOPS parece modesto frente a los buques insignia, pero si reformulamos la pregunta de "quién es más rápido" a "quién acuña tokens más baratos", el juego cambia.
Dos puntos estructurales:
Primero, la escasez de HBM se ha convertido en una variable estructural que obliga a tomar decisiones de arquitectura, no en un bache temporal de suministro. Que Tesla recorte especificaciones e Intel apueste por LPDDR son respuestas distintas a la misma presión. Mientras los poseedores de memoria (SK hynix, con ~57 % de los ingresos de HBM, y sus pares) ejercen poder de fijación de precios, los compradores de memoria rediseñan en torno a la memoria disponible. Las noticias de hardware de IA de los próximos 2–3 años hay que leerlas sobre esta tensión.
Segundo, los intereses de Corea están a ambos lados. Samsung y SK hynix son beneficiarios directos de la prima de la HBM. Al mismo tiempo, Samsung Foundry está fabricando el AI5 de Tesla en Taylor, y la china CXMT se acerca en la cadena de suministro de LPDDR. Un mix de memoria que pase de solo-HBM a HBM-más-LPDDR repercute en las carteras del duopolio coreano de memoria y en la mezcla de clientes de su foundry. Cualquier análisis que apueste por un solo lado es medio análisis.
Los contraargumentos, con justicia: 1,5 TB/s es poco, y la inferencia en tiempo real sensible a la latencia (TTFT) puede sufrir. Sobre todo, el precio no se ha publicado: la ventaja de TCO no se puede verificar hasta que exista la lista de precios. Declarar una "victoria de valor en inferencia" solo con números teóricos sería prematuro.
Implications
Para inversores: - A medida que crece la participación de la inferencia en la carga de trabajo, el mix de memoria se aleja del solo-HBM. Es momento de reevaluar a los beneficiarios estructurales de la demanda de LPDDR5X y DRAM para servidores. - La prima de la HBM probablemente persista hasta 2027: 2026 agotado, asignación de 2027 precontratada y transición a una HBM4E definida por los fabricantes. El poder de fijación de precios de los fabricantes de memoria se mantiene por ahora. - La infraestructura de potencia/refrigeración (mantenerse en aire frente a pasar a líquido) es una nueva variable del CAPEX de los centros de datos. Una expansión de tarjetas de inferencia de clase 350 W podría ralentizar la transición a la refrigeración líquida.
Para operadores: - La compra de infraestructura de IA está pasando del "chip más rápido" a la "memoria que se puede conseguir". Planifiquen la capacidad de 2027 hacia atrás, desde la asignación de memoria. - Sigan las opciones de inferencia basadas en LPDDR como cobertura de diversificación de proveedores. Podría ser el primer caso real de una alternativa de inferencia distinta de NVIDIA.
FAQ
P1. La LPDDR5X tiene mucho menos ancho de banda que la HBM: ¿de verdad basta para la inferencia? R. Depende de la carga de trabajo. A diferencia del entrenamiento, que renueva los pesos constantemente, la inferencia carga los pesos una vez y genera miles de tokens. El cuello de botella suele ser la capacidad de la KV cache y el tamaño del lote, no el ancho de banda. El servicio en tiempo real sensible a la latencia (TTFT) es donde se nota el déficit de ancho de banda.
P2. ¿De verdad caben 300B de parámetros en una tarjeta de 480 GB? R. En FP8, un parámetro ≈ un byte, así que 300B de parámetros ≈ 300 GB. Quedan ~180 GB en una tarjeta de 480 GB para la KV cache y el batching: matemáticamente coherente con la afirmación de Intel. El comportamiento real espera benchmarks independientes.
P3. ¿Cuánto cuesta? R. No se ha publicado. Intel dice que el muestreo a clientes está en marcha. La verdadera ventaja de TCO frente a las tarjetas con HBM no se puede calcular hasta que exista el precio. Un debate de valor sin lista de precios es medio debate.
P4. ¿Cuándo se alivia la escasez de HBM? R. El volumen de 2026 está prácticamente agotado y gran parte de 2027 ya está precontratado. La producción en volumen de HBM4E está prevista para 2027, pero al ser una generación definida por los fabricantes, su velocidad de rampa es la variable. Hay que contar con condiciones ajustadas durante todo 2027.
Lecturas recomendadas
- Chris Miller, Chip War — la geopolítica y las cadenas de suministro de la hegemonía de los semiconductores. Ver en Amazon
- Clayton Christensen, The Innovator's Dilemma — el clásico MBA sobre cómo los entrantes de gama baja vuelcan los mercados; una lente para leer la apuesta LPDDR de Intel. Ver en Amazon
Las compras a través de este enlace pueden generar una comisión.
Nota: las cifras y los calendarios se basan en información pública a 13 de octubre de 2026. Los números de rendimiento de la GPU D270 de Intel son valores teóricos publicados por el fabricante, sin verificación mediante benchmarks independientes. No es asesoramiento de inversión.
Tags: deep-dive, inference, memory-tco, lpddr5x, hbm, spanish


