 VLSI Korea
Intel y su GPU de inferencia, a fondo: por qué el D270 deja el HBM por 480 GB de LPDDR5X
Intel dejó el HBM y eligió LPDDR5X: 160 GB en su tarjeta y hasta 480 GB en diseños ODM. Verificamos la cifra viral, la lógica de capacidad sobre ancho de banda y lo que significa para Samsung, SK hynix y Micron.


Resumen en 30 segundos
El 12 de octubre de 2026, en el OCP Global Summit, Intel dio nombre comercial y especificaciones finales a su GPU dedicada a inferencia. Con nombre en clave Crescent Island, la línea se llama Intel GPU D-Series y su primera tarjeta es la D270 (según la prensa especializada). El titular está en la memoria: esta tarjeta no usa HBM en absoluto. Veinte paquetes LPDDR5X entregan 1,5 TB/s de ancho de banda, y aunque la tarjeta de la propia Intel lleva 160 GB, los diseños de socios ODM pueden escalar la capacidad hasta 480 GB. La cifra de «480 GB de LPDDR5X» que circuló en análisis de redes sociales es real, pero condicional: la tarjeta que vende Intel es de 160 GB. El cómputo es de 1,3 PFLOPS en FP8, con 350 W en una tarjeta PCIe refrigerada por aire. Intel afirma que una sola tarjeta puede servir modelos de hasta 300 000 millones de parámetros y que un sistema de ocho tarjetas supera el billón de parámetros. El muestreo a clientes está en curso; no hay precio ni fecha de disponibilidad general anunciados. Este análisis reúne todos los hechos confirmados, la lógica técnica y económica del «por qué LPDDR» y lo que significa para Samsung Electronics, SK hynix y Micron.
Lo que Intel anunció realmente
Crescent Island no apareció de la noche a la mañana. Intel presentó la GPU de inferencia en el OCP Global Summit de octubre de 2025, con una configuración de 160 GB de LPDDR5X. En Hot Chips, en agosto de 2026, detalló la arquitectura Xe3P, y el 12 de octubre de 2026 fijó la marca GPU D-Series y las especificaciones finales. También mostró un prototipo de módulo OAM refrigerado por líquido —dos GPU por módulo, ocho módulos en un chasis de 5U—, señal de que el PCIe por aire es la cabeza de playa y los formatos densos quedan en la hoja de ruta.
La filosofía de diseño ha sido constante: no pelear de frente con las GPU insignia de entrenamiento. El objetivo no es el bastión HBM de Blackwell Ultra de NVIDIA o la serie MI de AMD, sino las cargas de inferencia que caben en los servidores x86 estándar que las empresas ya poseen. Anil Nanduri, vicepresidente de productos de IA y salida al mercado del grupo de centros de datos de Intel, lo dijo sin rodeos: «La inferencia se está convirtiendo en la carga de trabajo que define la IA, y las empresas necesitan infraestructura que ofrezca el rendimiento adecuado al coste adecuado».
| Especificación | Intel GPU D270 (Crescent Island) |
|---|---|
| Arquitectura | Xe3P (Xe3 mejorada) |
| Núcleos Xe | 32 (cuatro slices) |
| Motores matriciales XMX | 256 |
| Cómputo FP8 (denso) | 1,3 PFLOPS |
| Cómputo vectorial FP64 | 10,2 TFLOPS |
| Caché L2 | 32 MB (unificada) |
| Memoria | LPDDR5X, 20 paquetes, 80 canales, 1.280 bits |
| Velocidad de memoria | 9.375 MT/s |
| Ancho de banda | 1,5 TB/s |
| Capacidad | 160 GB (tarjeta Intel) / hasta 480 GB (diseños ODM) |
| Interfaz | PCIe Gen5 x16 |
| Potencia | 350 W |
| Formato / refrigeración | PCIe CEM de doble ancho, aire |
| Estado | Muestreo a clientes (oct. 2026); precio y disponibilidad sin anunciar |
Fuente: divulgaciones de Intel en el OCP Global Summit del 12 de octubre de 2026 y materiales de arquitectura de Hot Chips 2026.
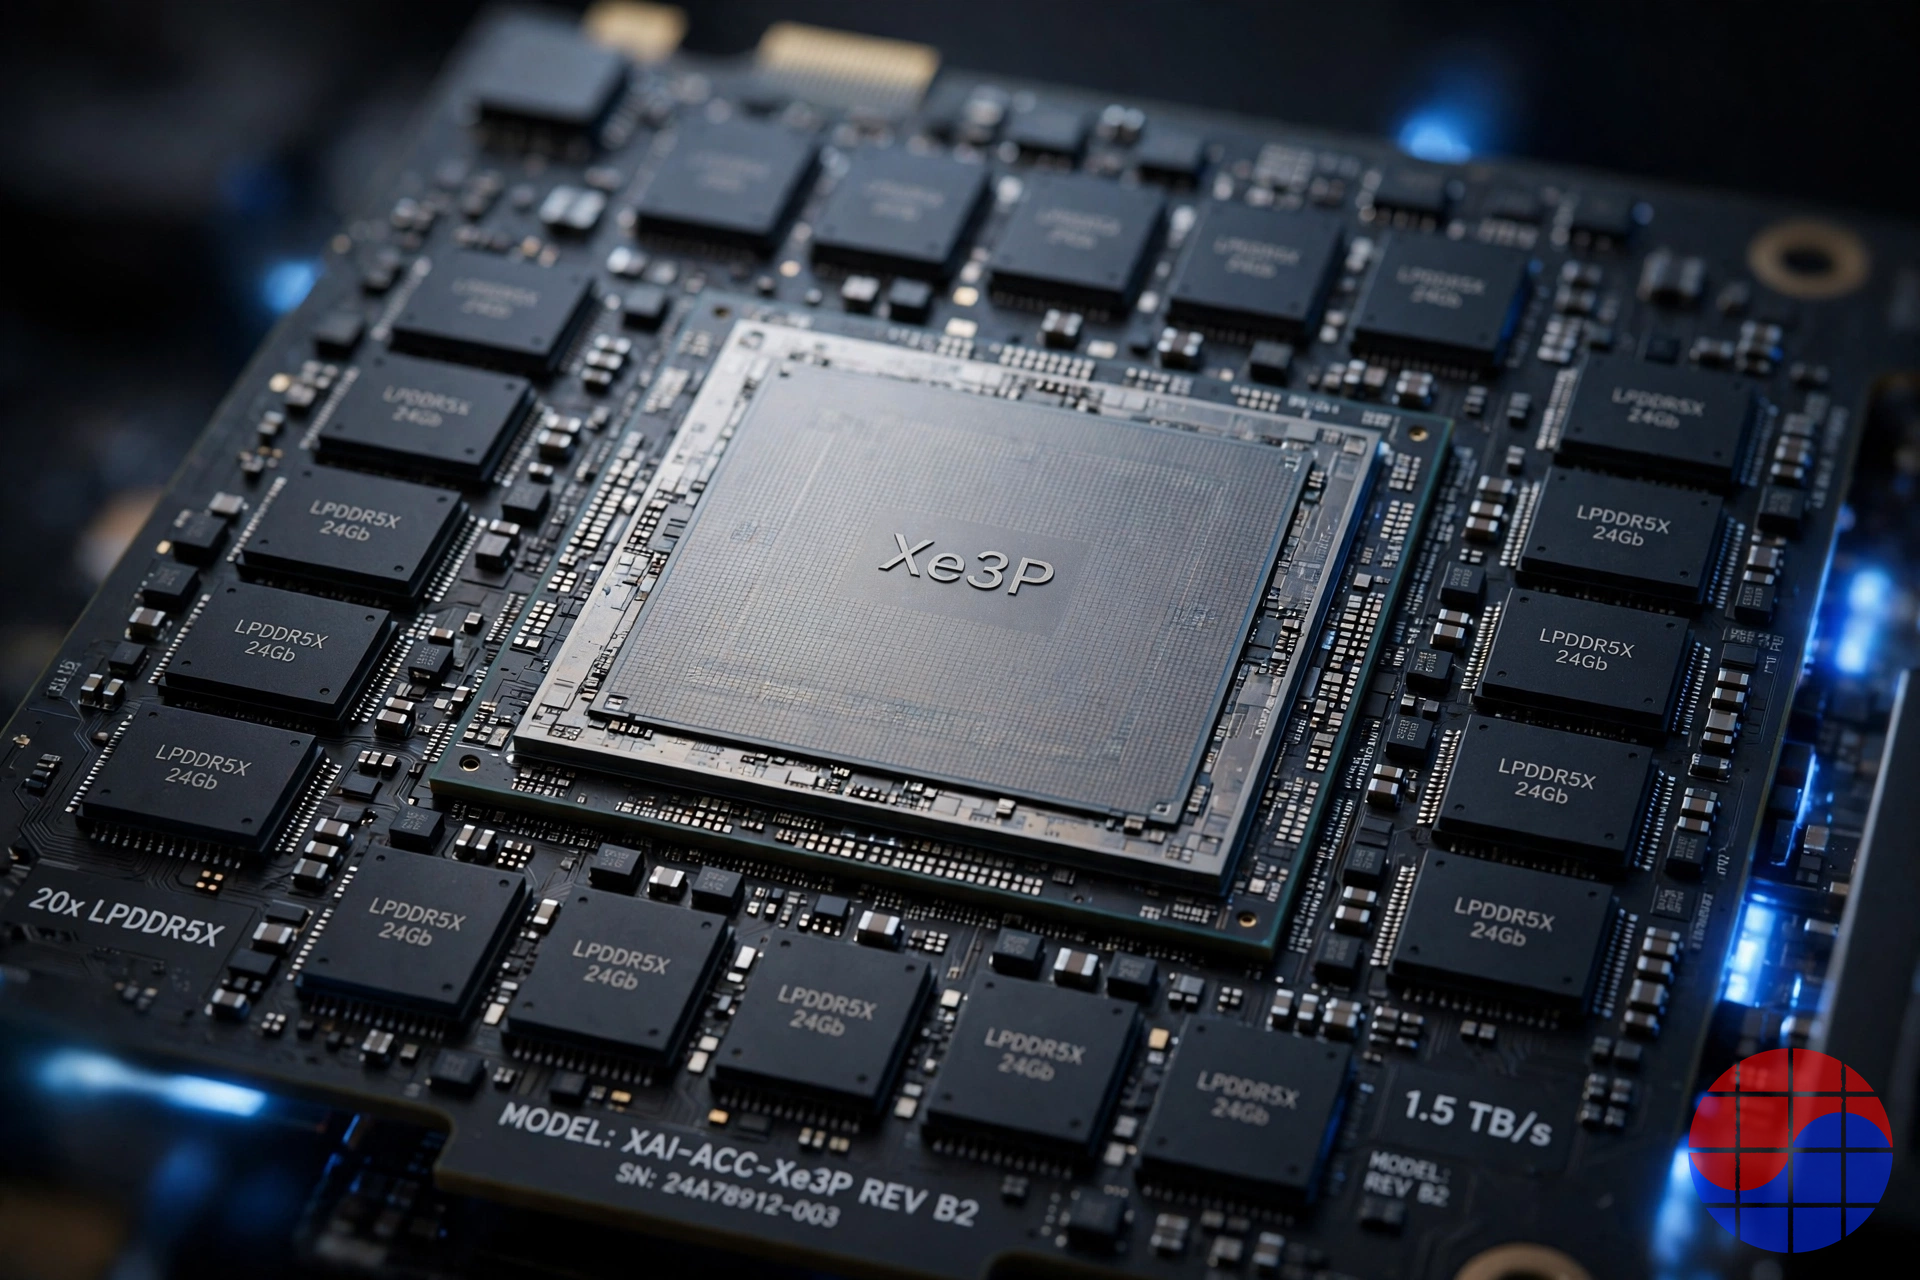
El propio núcleo Xe3P se recortó para inferencia. La matriz sistólica XMX pasó de 4 niveles de profundidad en Xe2 a 16, el archivo de registros general se duplicó a 1 MB por núcleo y la memoria L1/compartida local creció a 512 KB por núcleo. Los bloques de gráficos 3D y trazado de rayos de las GPU de juego desaparecieron por completo, cediendo cada milímetro cuadrado a la matemática matricial y a los tipos de datos de inferencia, de FP4 a FP64. El software se apoya en una pila abierta centrada en OpenVINO y oneAPI.
Verificación de los 480 GB: cifra real, nota al pie ausente
Tras el anuncio, «480 GB de LPDDR5X» viajó por los análisis sociales como si fuera la especificación titular de la tarjeta. La cifra sí aparece en la divulgación de Intel, pero es la configuración máxima que los socios ODM pueden construir, no la especificación de la tarjeta con marca Intel. Sin esa nota al pie, la cifra engaña.
| Configuración | Densidad por paquete | Paquetes | Capacidad total | Quién la vende |
|---|---|---|---|---|
| Tarjeta de referencia Intel | Paquetes clase 64 Gb | 20 | 160 GB | Intel (tarjeta de marca) |
| Máximo ODM | Paquetes clase 192 Gb | 20 | 480 GB | Socios (placas ODM) |
El subsistema de memoria es idéntico en ambas: un bus de 80 canales de 16 bits (1.280 bits) a 9.375 MT/s para 1,5 TB/s. Solo cambia cuántos chips de DRAM se apilan dentro de cada paquete. Así, 480 GB es «el techo que permite el diseño» y 160 GB es «lo que Intel envía realmente». En cualquier caso, es la mayor clase de capacidad anunciada para una tarjeta PCIe de inferencia. A modo de comparación, la GPU Rubin de NVIDIA lleva 288 GB de HBM4 y la serie MI450 de AMD se sitúa en 432 GB: en capacidad bruta, el diseño LPDDR invierte la jerarquía habitual.
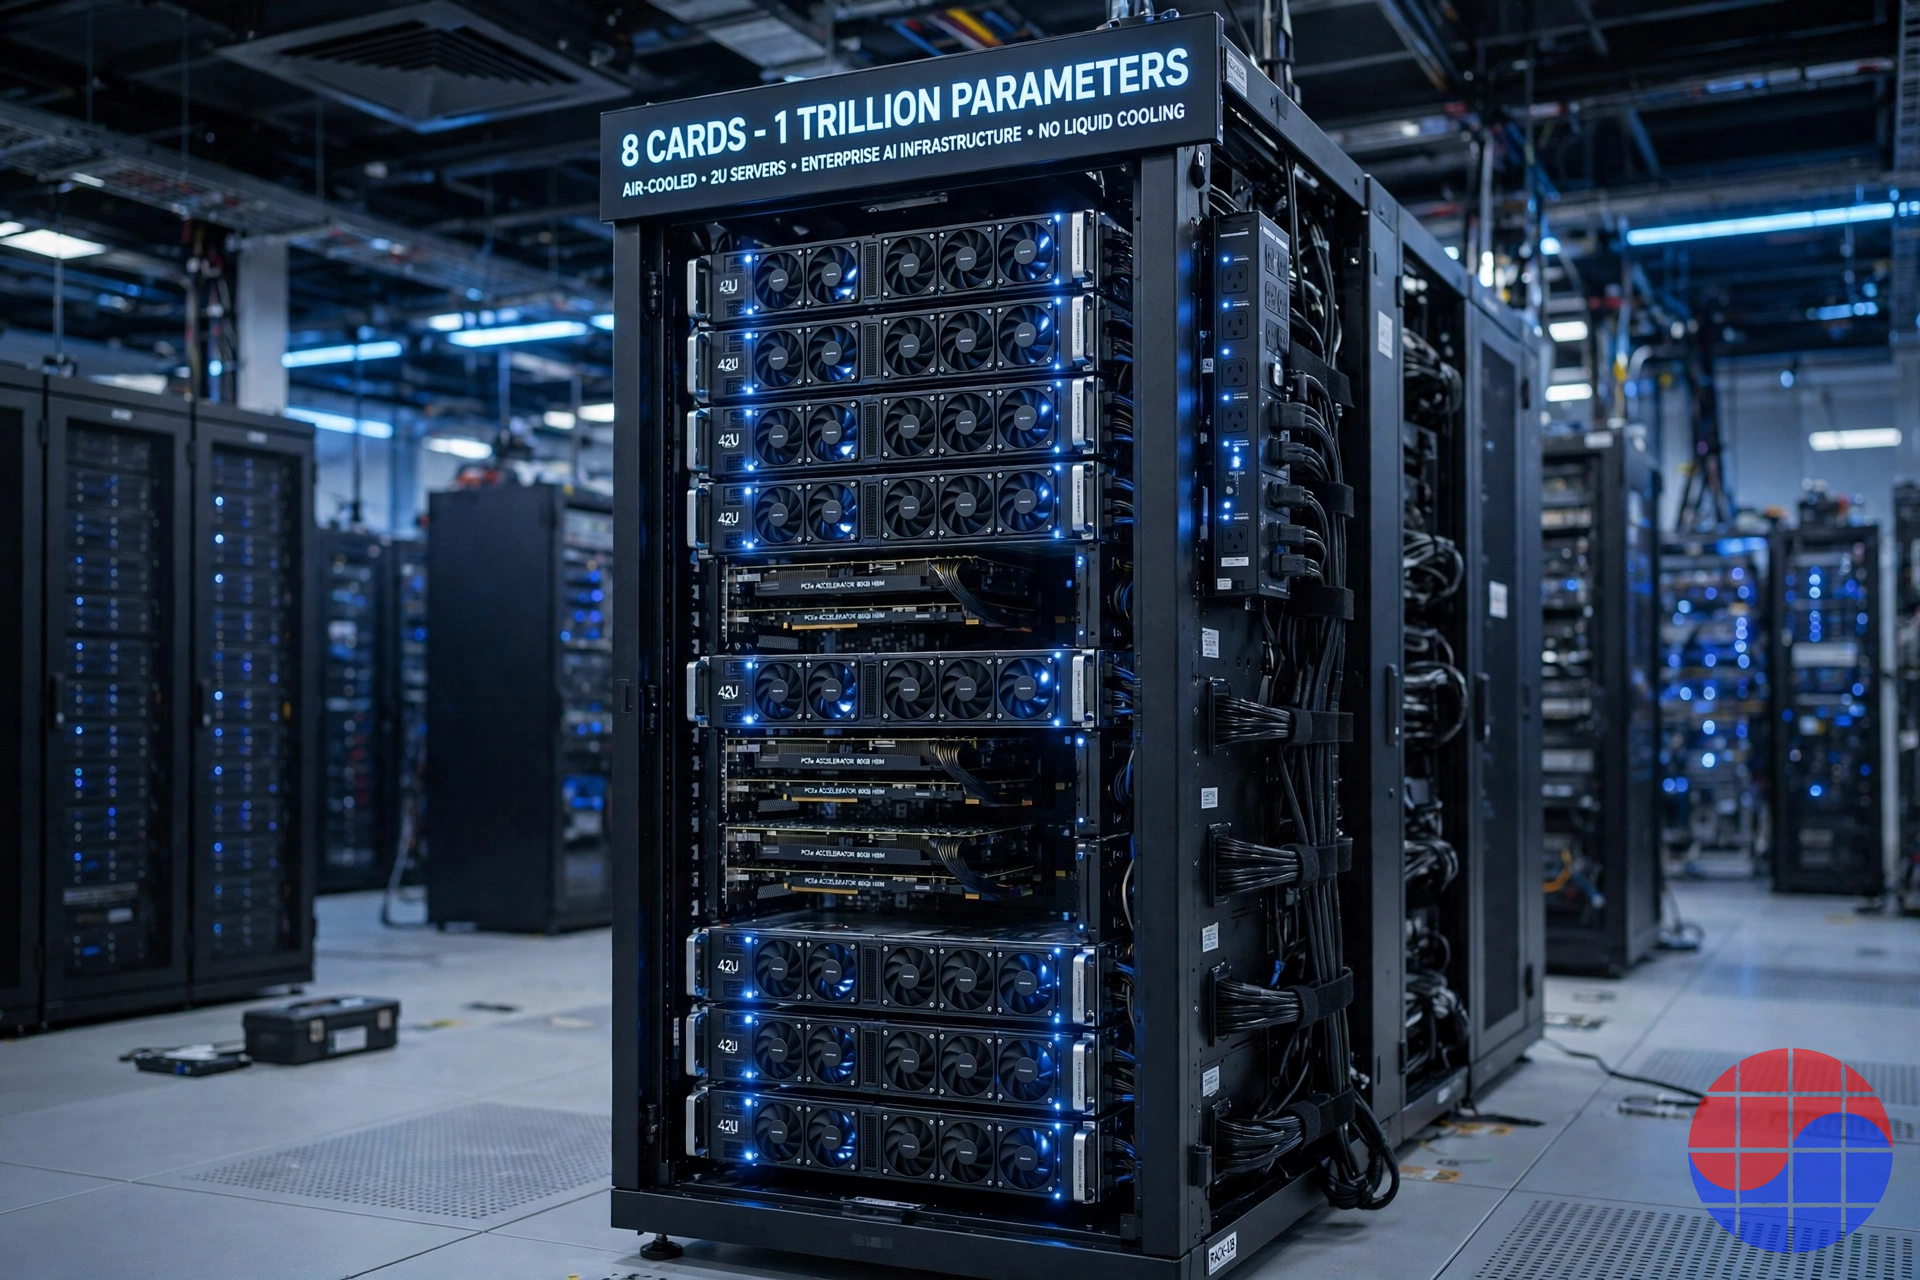
La aritmética de tamaño de modelo exige el mismo cuidado. En FP8 (un byte por parámetro), una tarjeta de 160 GB alberga unos 160 000 millones de parámetros en pesos antes de la caché KV y la sobrecarga de ejecución; los «300 000 millones de parámetros en una tarjeta» de Intel corresponden a la configuración de 480 GB. El sistema de ocho tarjetas con «más de un billón de parámetros» supone igualmente 480 GB × 8 = 3,84 TB de memoria agregada. Las cifras no son falsas, pero la configuración de referencia debe viajar siempre con ellas.
Por qué LPDDR5X (1): la inferencia se atasca en la memoria, no en el cómputo
Entrenamiento e inferencia usan la memoria de forma distinta. El entrenamiento repite multiplicaciones matriciales enormes, así que importan tanto los FLOPS como el ancho de banda. La inferencia —sobre todo la fase de decodificación que emite un token cada vez— es un juego de ancho de banda con lotes pequeños: cada token exige leer de memoria el conjunto completo de pesos del modelo, y el tiempo de transmitir esos pesos fija la latencia entre tokens.
Pero en el servicio en producción, el ancho de banda no es el único muro. Cuando suben la concurrencia y se alargan los contextos, la caché KV devora memoria rápidamente. La restricción vinculante pasa a ser: ¿cabe el modelo en una tarjeta, y cuántas peticiones simultáneas y cuánto contexto puede sostener esa tarjeta? Si la capacidad no alcanza, el modelo debe fragmentarse entre tarjetas, y el tráfico entre ellas y el cómputo ocioso se convierten en coste puro. Ahí está exactamente la apuesta de Intel. El D270 cede un orden de magnitud de ancho de banda frente a los buques insignia HBM, pero multiplica la capacidad por dos o tres a una fracción del precio y la potencia de la tarjeta — y en ese régimen gana el coste por token.
El encuadre en cifras: 1,5 TB/s no alcanza ni una sola pila HBM4 (2,8 TB/s o más), y mucho menos las decenas de TB/s de un buque insignia de 12 pilas. A cambio, el D270 es una tarjeta de 350 W refrigerada por aire. Donde los buques insignia HBM superan los 1.000 W y fuerzan racks con refrigeración líquida, el D270 entra en una ranura PCIe libre de un servidor empresarial existente. Intel no vende rendimiento máximo; vende capacidad de inferencia desplegable hoy, en infraestructura que ya existe.
Por qué LPDDR5X (2): coste por GB y poder comprarla, sin más
El segundo argumento es dinero y suministro. Del HBM4 se habla en torno a 31–32 dólares por GB, el doble aproximado de los 17–18 dólares por GB del HBM3E (estimaciones del sector). El LPDDR5X, incluso tras las subidas del superciclo, se negociaba en torno a 12 dólares por GB en paquetes de 12 GB: menos de la mitad que el HBM4. El encapsulado acentúa la brecha: el HBM hereda el cuello de botella del apilado TSV y el interposer sobre la capacidad de encapsulado avanzado, mientras que el LPDDR5X es DRAM de consumo masivo —cientos de millones de teléfonos y PC al año—, con una amplia base de proveedores y encapsulado estándar.
El riesgo de suministro es la realidad de 2026. La producción de HBM de 2026 de Samsung y SK hynix está prácticamente agotada, y Micron habría comprometido por adelantado buena parte de su suministro de 2027. Entrar hoy en la cola del HBM significa esperar a la asignación de 2027. El LPDDR5X, en cambio, se puede comprar ahora. Para un actor rezagado y con baja prioridad en la fila de asignación de HBM, una «tarjeta de inferencia sin HBM» es a la vez un recorte de coste y una cobertura frente al riesgo de suministro. Intel no es el único que llega a esta conclusión: los chips de inferencia propios de Meta, la familia MTIA, usan memoria de clase LPDDR, y el silicio de inferencia de Tesla hizo la misma elección de familia.
Tres memorias frente a frente: HBM4 vs LPDDR5X vs GDDR7
| Dimensión | HBM4 | LPDDR5X | GDDR7 |
|---|---|---|---|
| Ancho de banda por pila/chip | 2,8+ TB/s por pila | ~77 GB/s por paquete (1,5 TB/s por tarjeta) | Hasta ~144 GB/s por chip |
| Ancho de banda total por acelerador | Decenas de TB/s (12 pilas) | 1,5 TB/s (D270) | ~1,8 TB/s (512 bits) |
| Capacidad por acelerador | 288–432 GB | 160–480 GB | 32–96 GB |
| Coste por GB | ~31–32 dólares (estimaciones) | ~12 dólares (precios del repunte de 2026) | Muy por debajo del HBM (gráficos de consumo) |
| Perfil de potencia | Alto, incluido el sistema de interposer | Menor energía por bit (diseño móvil) | Mayor energía por bit que LPDDR |
| Encapsulado | Pila TSV + interposer obligatorios | Paquetes estándar, montaje en placa | Montaje en placa |
| Situación de suministro | Producción 2026 agotada; carrera por la asignación | DRAM de consumo; amplia base de proveedores | Compite con la demanda de gráficos |
| Adoptantes clave | NVIDIA Rubin, serie MI450 de AMD, buques insignia TPU/Trainium | Intel GPU D-Series, Grace/Vera de NVIDIA (memoria de CPU), Meta MTIA | Serie GeForce RTX 50 y otras tarjetas gráficas |
Nota: las cifras de coste por GB son estimaciones que varían mucho según el momento y las condiciones del contrato; se muestran para ilustrar la dirección: LPDDR5X a menos de la mitad que HBM4. Las cifras de ancho de banda siguen las especificaciones divulgadas por cada fabricante.
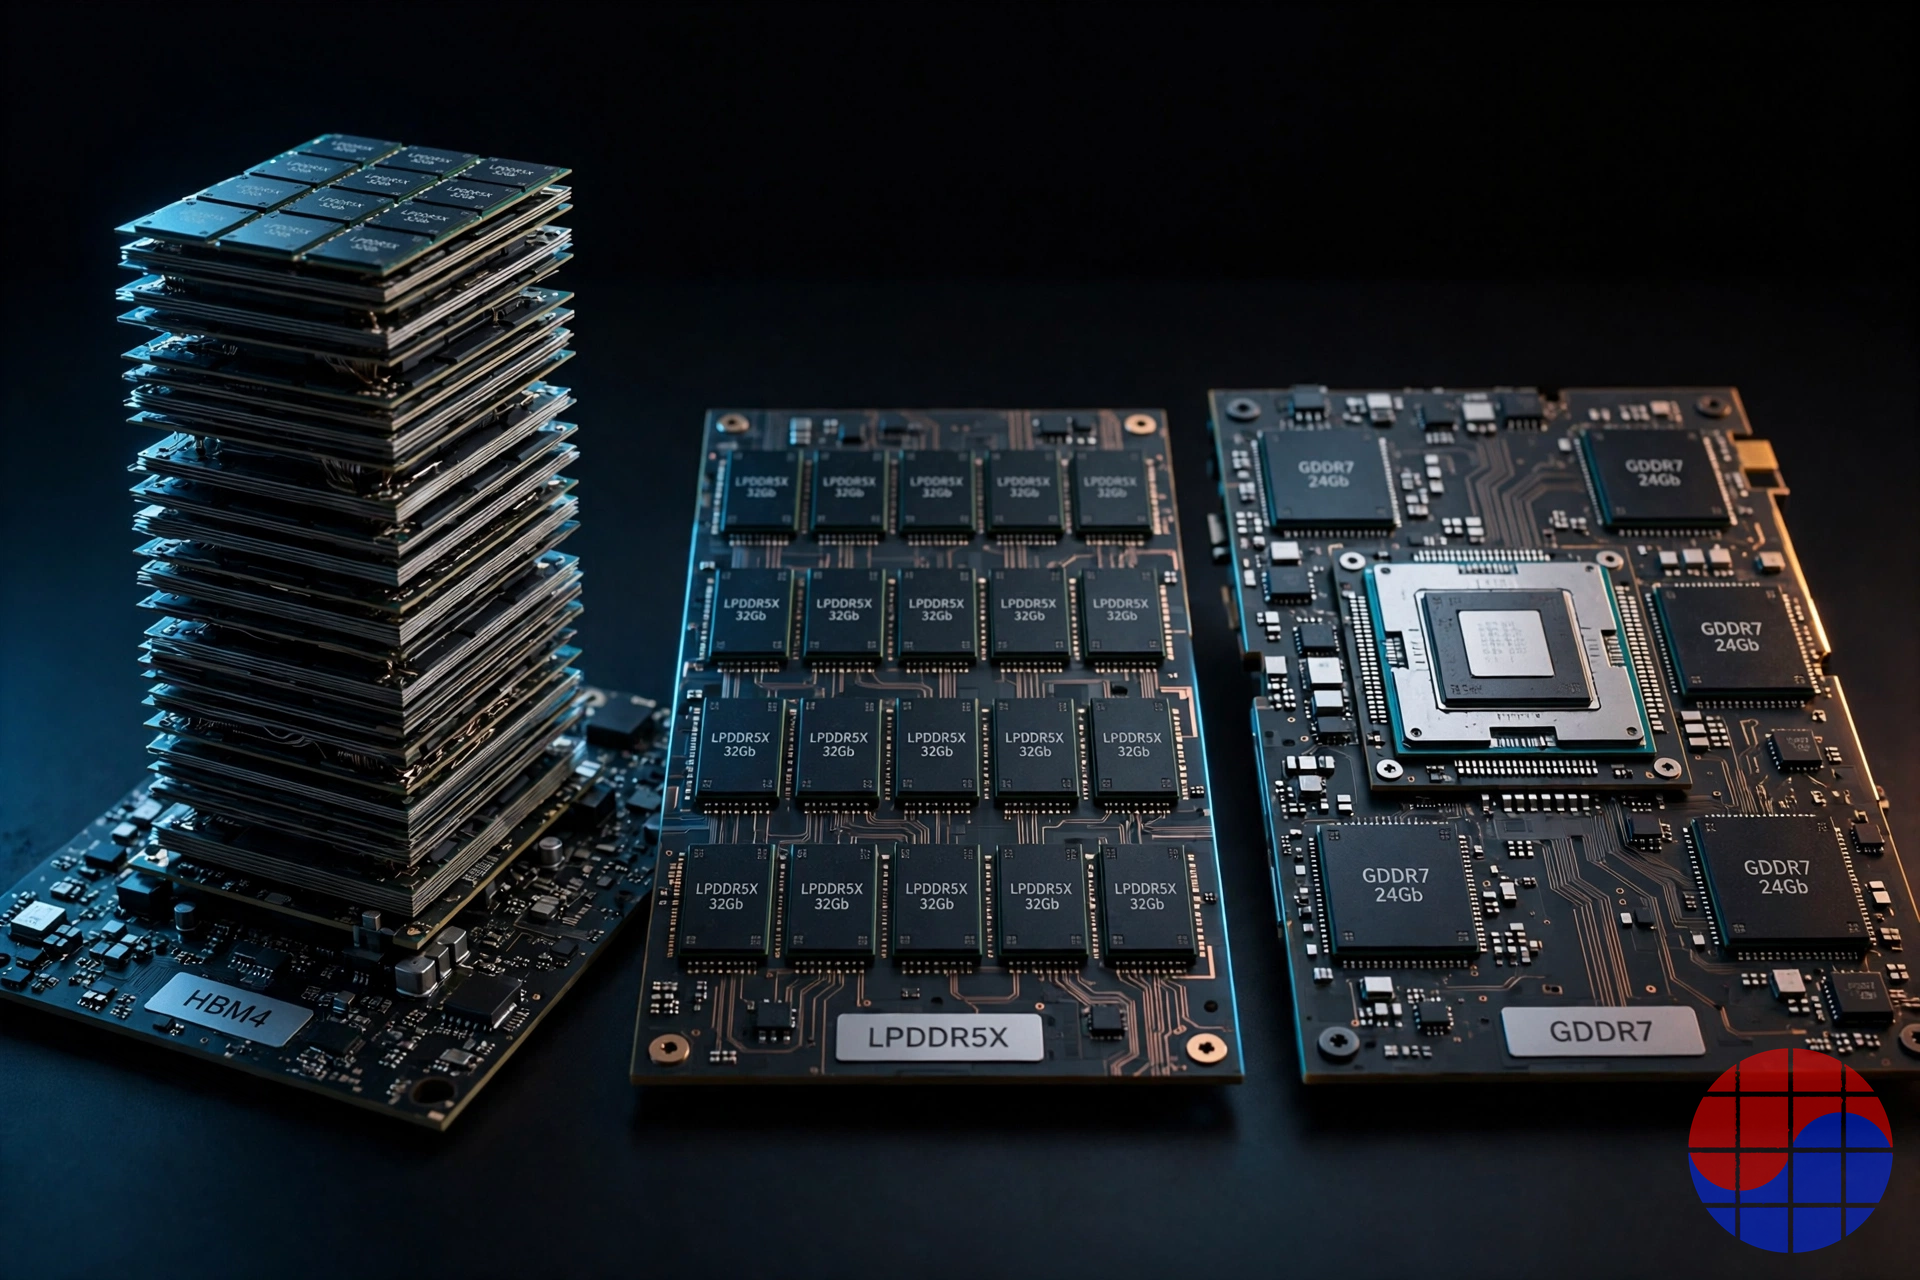
La tabla no es un ranking: es la elección de qué restricción comprar. El HBM4 compra ancho de banda y acepta coste de capacidad y riesgo de asignación. El GDDR7 es barato y con un ancho de banda respetable, pero su pequeña capacidad por chip dificulta colocar cientos de gigabytes en una tarjeta. El LPDDR5X renuncia al ancho de banda y gana en coste de capacidad, disponibilidad y potencia. A medida que la demanda de inferencia pasa de «el token más rápido» a «el token más barato», el centro de gravedad de esta tabla se inclina hacia el LPDDR.
Qué significa para los proveedores: Samsung, SK hynix, Micron y SOCAMM
Para los tres grandes de la memoria, la señal es sencilla: la demanda de DRAM de los centros de datos de IA no converge solo en el HBM. En el lado de la CPU ya fluyen grandes volúmenes hacia el LPDDR. Grace de NVIDIA llevaba hasta 480 GB de LPDDR5X por CPU; su sucesora Vera escala hasta 1,5 TB a 1,2 TB/s mediante módulos SOCAMM2. Un solo rack Vera Rubin NVL72 alberga 36 CPU Vera: hasta 54 TB de memoria de CPU por rack. Si se suman aceleradores LPDDR como el D270, el LPDDR de centro de datos crece de «memoria junto a la CPU» a eje de demanda independiente.
La modularización importa. El LPDDR nació como un componente móvil soldado a la placa; el formato SOCAMM de NVIDIA lo redefinió como una pieza de servidor reemplazable y ampliable. Samsung, SK hynix y Micron participan en el suministro SOCAMM, y NVIDIA habría incorporado a la taiwanesa Nanya a la cadena de LPDDR de Vera — una diversificación que por sí misma indica el tamaño del volumen.
Desde el asiento de un proveedor coreano, la demanda es un arma de doble filo. Por un lado, un nuevo fondo de demanda de IA llena el mercado de DRAM de consumo que la conversión a HBM ha ido drenando; la demanda de servidores es parte de por qué los precios del LPDDR5X saltaron a doble dígito trimestral durante 2026. Por otro, el LPDDR sigue siendo DRAM de consumo: nada de márgenes excesivos tipo HBM, y exposición directa a la competencia de precios de seguidores como CXMT. Aun así, la dirección del volumen es inequívoca. Desde 2027, la demanda de bits LPDDR en la infraestructura de IA crece estructuralmente desde los zócalos de CPU y los aceleradores de inferencia a la vez.
El marco competitivo: hasta NVIDIA pone LPDDR junto a sus CPU
Leer la elección de Intel solo como «el recurso de quien no pudo asegurarse HBM» es ver la mitad. NVIDIA —el mayor comprador de HBM del planeta— ejecuta ella misma una estrategia de memoria dual: HBM4 en la GPU, LPDDR5X en la CPU, repartiendo los roles hambrientos de ancho de banda y de capacidad según la carga. De Grace a Vera, la capacidad de memoria de la CPU se triplicó de 480 GB a 1,5 TB y el ancho de banda subió de 512 GB/s a 1,2 TB/s; en la visión de NVIDIA, la CPU de la era de la IA agéntica es una pieza que debe cargar más memoria, no menos.
AMD sostiene el flanco contrario: la serie MI mantiene la línea ortodoxa de HBM en todas partes y pelea la inferencia con ancho de banda. Los ASIC a medida se dividen: el TPU de Google y el Trainium de AWS toman HBM; el MTIA de Meta toma memoria de clase LPDDR. El consenso emergente del sector es una estructura de dos plantas: HBM para entrenamiento y servicio de frontera; LPDDR creciendo debajo, en inferencia masiva y memoria de CPU. El D270 es el primer intento a gran escala de atacar esa planta baja en formato GPU.
Chase's Take
Quita la marca y este producto es una estrategia de compra de memoria con disfraz de GPU. Intel evitó una pelea de cómputo que no puede ganar y presentó la mayor capacidad de inferencia construible con memoria que de verdad se puede comprar en 2026–2027. La cifra de 1,3 PFLOPS es discreta; la combinación —480 GB en una tarjeta de 350 W refrigerada por aire— es una coordenada que ningún rival ocupa.
Para los fabricantes coreanos de memoria es un viento de cola silencioso. Tras el glamour de precios del HBM, un segundo eje de demanda de IA —el LPDDR de servidor— se está endureciendo en volumen real. Cuando los 1,5 TB por zócalo de Vera y los hasta 480 GB por tarjeta del D270 empiecen a enviarse a la vez, el LPDDR5X se revalorizará de componente de smartphone a infraestructura de IA. La trampa: el encarecimiento del LPDDR roe la propia lógica de TCO de Intel. Cuanto más caro el LPDDR, más fino el margen de la ecuación «memoria barata, inferencia barata». El destino de este producto lo decidirá menos su silicio que la curva de precios de la memoria.
Para la estructura de costes de la memoria de inferencia, leída frente a las cifras del propio bando HBM, véase también: No HBM Needed? Intel's 480GB LPDDR5X Bet and the Inference Memory TCO War
Riesgos y lo que aún no se sabe
Primero, la naturaleza de las cifras de rendimiento: 1,3 PFLOPS es un pico teórico sin benchmarks independientes todavía, y el rendimiento real de tokens depende mucho de la optimización de kernels y de la madurez de la pila. Segundo, el ecosistema de software: la gravedad de CUDA también es fuerte en inferencia, y la fluidez con que la pila OpenVINO/oneAPI se acople a los marcos de servicio en producción decidirá la adopción — la línea Gaudi de Intel perdió por ecosistema más que por silicio, un precedente que no se puede ignorar. Tercero, el techo de ancho de banda: 1,5 TB/s puede ser un cuello de botella en la decodificación de modelos muy grandes con lotes altos, y la propia Intel traza la línea fuera del entrenamiento y el servicio de frontera. Cuarto, las condiciones comerciales están en blanco: sin precio ni fecha de disponibilidad, con envíos en volumen discutidos para 2027 — para entonces habrá llegado el HBM4E y los precios del LPDDR pueden haber subido más, redibujando el mapa competitivo. Por último, la primera reacción del mercado fue fría: las acciones de Intel habrían cerrado a la baja el día del anuncio.
FAQ
Q: ¿Son los 480 GB de LPDDR5X del D270 una especificación confirmada? A: Es real como configuración máxima, pero la tarjeta de la propia Intel lleva 160 GB. Los 480 GB son el techo para placas ODM pobladas con paquetes de mayor densidad (clase 192 Gb). La mayoría de las citas sociales de «480 GB» omiten esa condición.
Q: ¿Por qué usar LPDDR5X en lugar de HBM en una GPU de inferencia? A: Porque la inferencia en producción está limitada menos por el cómputo bruto que por la capacidad para alojar el modelo y la caché KV, y por el coste por token. Del LPDDR5X se habla a menos de la mitad del coste por GB del HBM4, es mucho más fácil de adquirir y consume menos. El diseño sacrifica ancho de banda pico para ganar en capacidad y coste.
Q: ¿Qué nivel es el ancho de banda de 1,5 TB/s del D270? A: Está por debajo de una sola pila HBM4 (2,8 TB/s o más) y un orden de magnitud por debajo de los aceleradores insignia de decenas de TB/s, pero en la misma banda que una configuración GDDR7 de 512 bits (~1,8 TB/s). Es una cifra pensada para competir en capacidad por vatio y por dólar, no en rendimiento absoluto.
Q: ¿Qué significa esto para Samsung Electronics y SK hynix? A: Señala que la demanda de LPDDR de los centros de datos de IA se expande desde las CPU de servidor (SOCAMM de Grace y Vera de NVIDIA) hacia los aceleradores de inferencia. Los márgenes no igualarán al HBM, pero el crecimiento estructural de volumen está a la vista, y ambas compañías coreanas están dentro de la cadena de suministro SOCAMM.
Q: ¿Cuándo se podrá comprar el D270 y a qué precio? A: En octubre de 2026 la pieza está en muestreo a clientes. Intel no ha revelado precios ni fecha de disponibilidad general; los envíos en volumen se discuten para 2027.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


