 VLSI Korea
Fábricas de IA en 14 días, no en 6 meses: la producción de Vera Rubin y la jugada de velocidad del DSX POD (HBM4)
Vera Rubin está en producción plena y el DSX POD reduce el despliegue en un sitio preparado de unos 6 meses a un mínimo de 14 días. Un contenedor: 7 racks NVL72 y 504 GPU. La velocidad ahora es ingreso.


El cuello de botella de la infraestructura de IA ya no es el chip. Es la obra — y NVIDIA acaba de trasladar la fábrica dentro de la fábrica.
Resumen en 30 segundos
- Vera Rubin está en producción plena. En el GTC de Berlín, el 21 de octubre de 2026, el CEO Jensen Huang anunció que la próxima plataforma de IA de NVIDIA ha entrado en producción plena (full production).
- El DSX POD convierte una fábrica de IA en un producto que se envía. El diseño de referencia ensambla y prueba una fábrica de IA Vera Rubin completa dentro de contenedores modulares en la fábrica, y luego la envía. El despliegue en sitio, en un sitio preparado, cae de unos 6 meses a un mínimo de 14 días.
- Un contenedor de cómputo es una máquina seria: 7 racks Vera Rubin NVL72, 504 GPU Rubin, unos 28.000 kg, alimentado con 800 VDC. Un contenedor ya no es una caja. Es un bloque de construcción de un centro de datos.
- El propio nodo fue rediseñado para la velocidad de ensamblaje. Los nodos Vera Rubin no tienen cables, son 100% refrigerados por líquido y reducen el tiempo de ensamblaje del nodo de 2 horas en Grace Blackwell a menos de 5 minutos.
- 17 socios respaldan el diseño, entre ellos Dell, HPE, Lenovo, Schneider Electric, Vertiv, Eaton y Foxconn (Ingrasys), con envíos previstos a partir de principios de 2027. Conviene leer bien los 14 días: es el despliegue en sitio en un lugar donde la infraestructura de energía y refrigeración ya está preparada, no el periodo de construcción de un centro de datos completo.
Contexto
La fila se movió de la fab al terreno
Durante tres años, la historia de la infraestructura de IA fue una historia de suministro de chips. Las GPU escaseaban, la HBM escaseaba, el encapsulado avanzado escaseaba, y quien aseguraba obleas y memoria aseguraba ingresos. Esa escasez no ha desaparecido, pero detrás de ella se ha formado una segunda fila: el trabajo físico de convertir el hardware entregado en una fábrica de IA en funcionamiento. Los racks llegan, y entonces comienzan meses de integración en sitio: distribución de energía, circuitos de refrigeración, redes, ensamblaje nodo a nodo, pruebas y depuración, gran parte de ello a cargo de escasos ingenieros de campo en edificios que aún se están terminando.
Los anuncios de NVIDIA del 21 de octubre de 2026 en el GTC de Berlín atacan directamente esa segunda fila. La noticia de plataforma es que Vera Rubin, la arquitectura sucesora de Grace Blackwell, está en producción plena, en palabras del CEO Jensen Huang. La noticia de negocio es el DSX POD: un diseño de referencia en el que la fábrica de IA Vera Rubin completa se ensambla y se verifica en contenedores modulares antes de salir de la fábrica, de modo que el sitio recibe un sistema probado y no una pila de piezas.
Qué es exactamente un DSX POD
El DSX POD se entiende mejor como un cambio en el lugar donde ocurre la integración. En el modelo convencional, la integración ocurre en el destino, bajo condiciones de obra y con la variabilidad de una obra. En el modelo POD, la integración ocurre en el origen, bajo condiciones de fábrica, donde la misma tarea se repite, se mide y se mejora. El contenedor es la unidad de entrega: los contenedores de cómputo transportan los racks, y el diseño está especificado con la precisión suficiente para que el contenido de un contenedor se conozca al kilogramo y al voltio antes de su envío.
| Contenedor de cómputo DSX POD | Especificación |
|---|---|
| Racks por contenedor | 7 racks Vera Rubin NVL72 |
| GPU por contenedor | 504 GPU Rubin |
| Peso | Unos 28.000 kg |
| Entrada de energía | 800 VDC |
| Diseño del nodo | Sin cables, 100% refrigeración líquida |
| Tiempo de ensamblaje del nodo | Menos de 5 minutos (Grace Blackwell: 2 horas) |
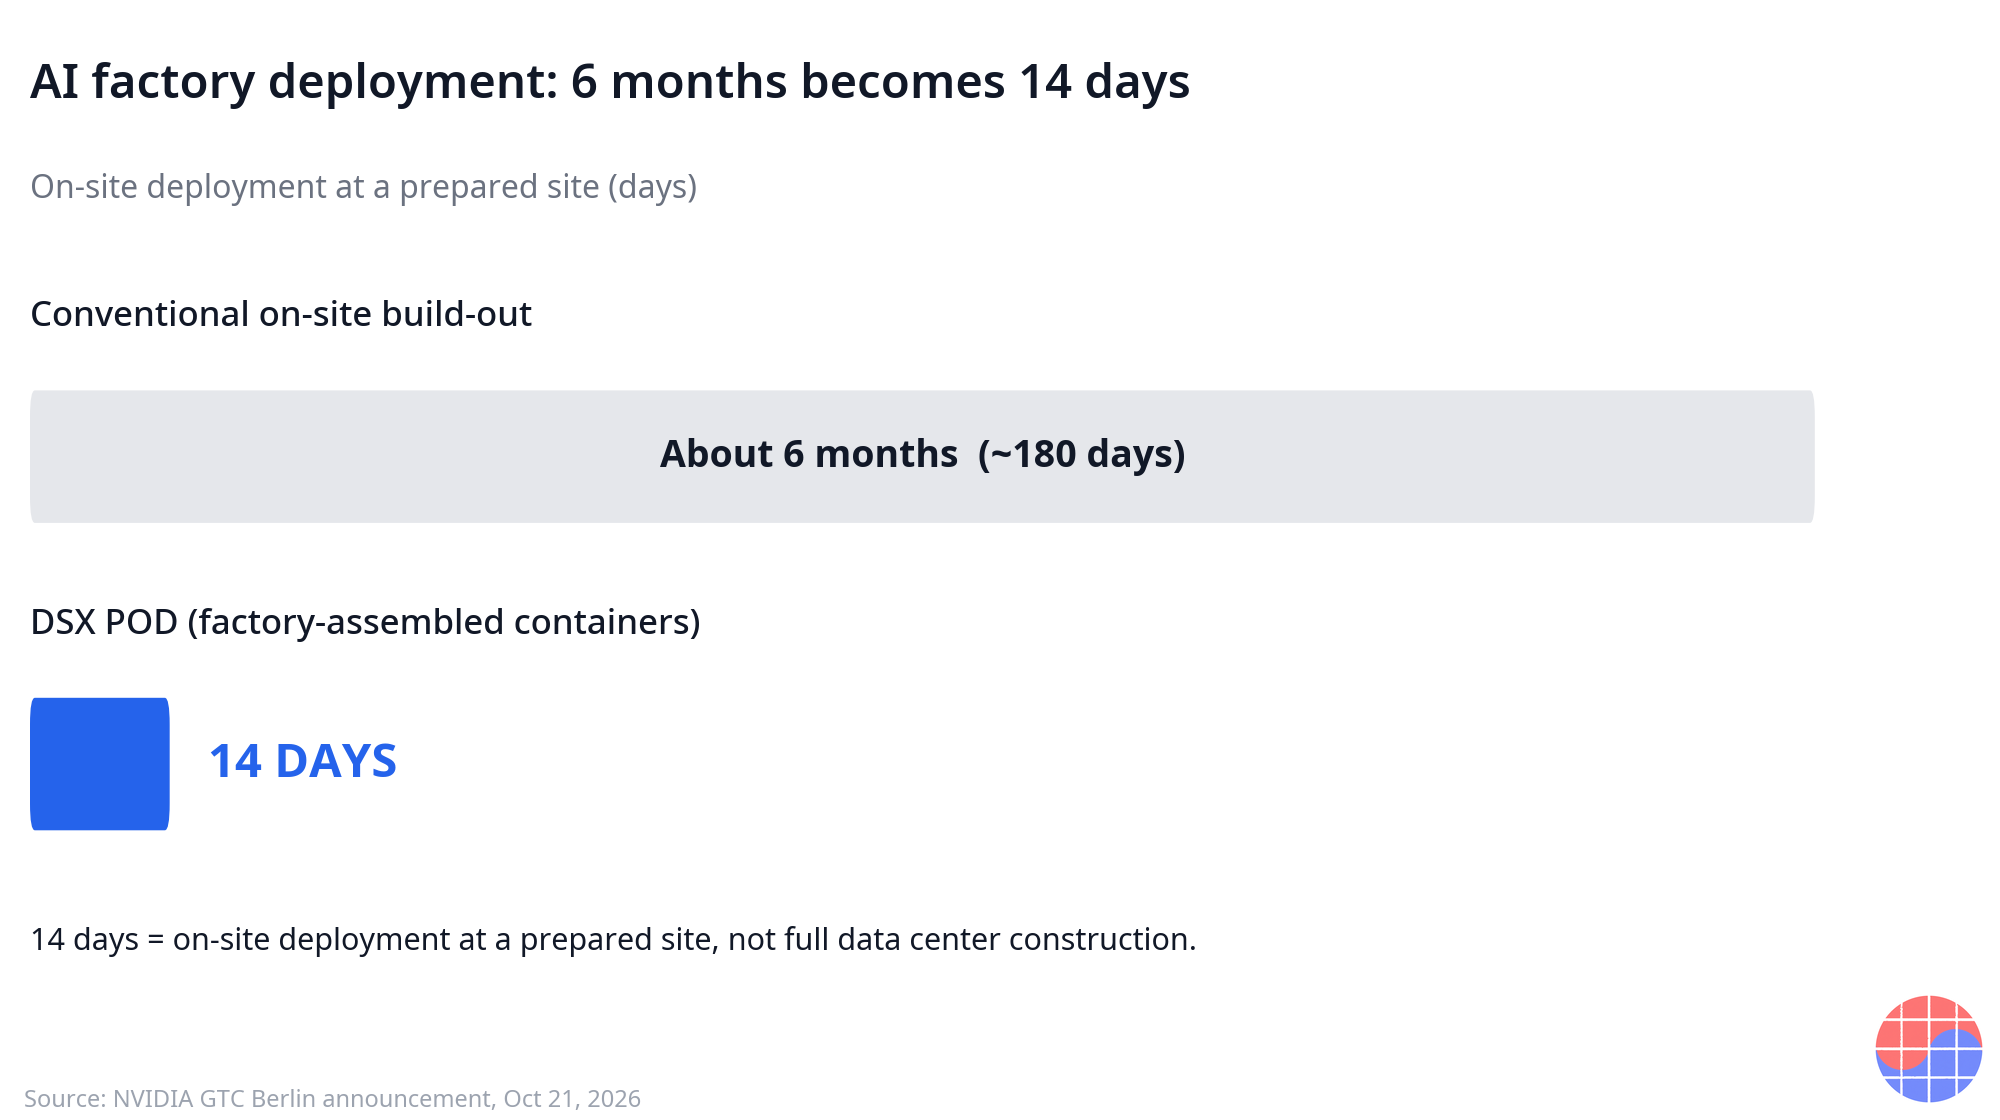
Fuente: anuncios de NVIDIA en el GTC de Berlín, 21 de octubre de 2026. Enlaces en la nota al pie.
El dato del ensamblaje del nodo merece una pausa. Reducir el ensamblaje de 2 horas a menos de 5 minutos no es una función de comodidad. Es lo que ocurre cuando una plataforma se diseña hacia atrás desde el proceso de despliegue: el cableado, históricamente una gran parte tanto del tiempo de ensamblaje como de los errores de campo, se elimina por completo del nodo, y la refrigeración pasa íntegramente a líquido. Un nodo que se ensambla en minutos es también un nodo que se sustituye en minutos, lo que cambia la economía de mantenimiento de la base instalada durante una década.
Los 14 días, dichos con precisión
La cifra más citada del anuncio — despliegue en un mínimo de 14 días, frente a unos 6 meses de construcción convencional en sitio — necesita su condición adjunta, porque la condición es donde vive el modelo de negocio. Los 14 días son el periodo de despliegue en sitio en un sitio preparado: un lugar donde la infraestructura de energía, refrigeración y edificio ya está instalada. No es el periodo de construcción de un centro de datos completo. El terreno, los permisos, la conexión a la red eléctrica y la estructura del edificio siguen tardando lo que tardan.
Esa distinción no debilita el anuncio. Aclara quién captura el valor. El POD comprime el segmento del calendario que se sitúa entre «infraestructura lista» y «fábrica de IA produciendo tokens», el segmento que determina cuándo el capital de un cliente empieza a rendir. Todo lo que está antes del sitio preparado sigue siendo un problema de construcción y de servicios públicos, y por eso la lista de socios importa tanto como el contenedor.
Análisis de negocio en profundidad
La velocidad es reconocimiento de ingresos
En la infraestructura de IA, la velocidad de despliegue no es un detalle operativo. Es la pendiente de la curva de ingresos. Un hiperescalador o un operador de fábricas de IA que pone capacidad en línea meses antes empieza a vender tokens, ejecuciones de entrenamiento e instancias en la nube meses antes, con un hardware cuya vida media competitiva se mide en trimestres. Cuando una generación de plataforma dura aproximadamente un año en la frontera, una cola de integración de 6 meses puede consumir la mitad de la vida económica del activo antes de que gane su primer dólar a plena utilización.
Esa es la lente para el DSX POD. Acortar el despliegue en sitio preparado de unos 6 meses a un mínimo de 14 días adelanta los ingresos meses por sitio, y lo hace exactamente en el momento en que la demanda de cómputo de IA hace fila. El cliente no compra contenedores. El cliente compra tiempo de calendario: el insumo más escaso de toda la expansión de la IA, más escaso que los chips, porque los chips se pueden acelerar y los calendarios no.
| Modelo de despliegue | Despliegue en sitio, en un sitio preparado | A dónde va el tiempo |
|---|---|---|
| Construcción convencional | Unos 6 meses (unos 180 días) | Integración de racks en sitio, cableado, conexión de refrigeración, ensamblaje de nodos, pruebas por etapas |
| DSX POD | Un mínimo de 14 días | Posicionamiento de contenedores preensamblados y preverificados, y puesta en marcha final |
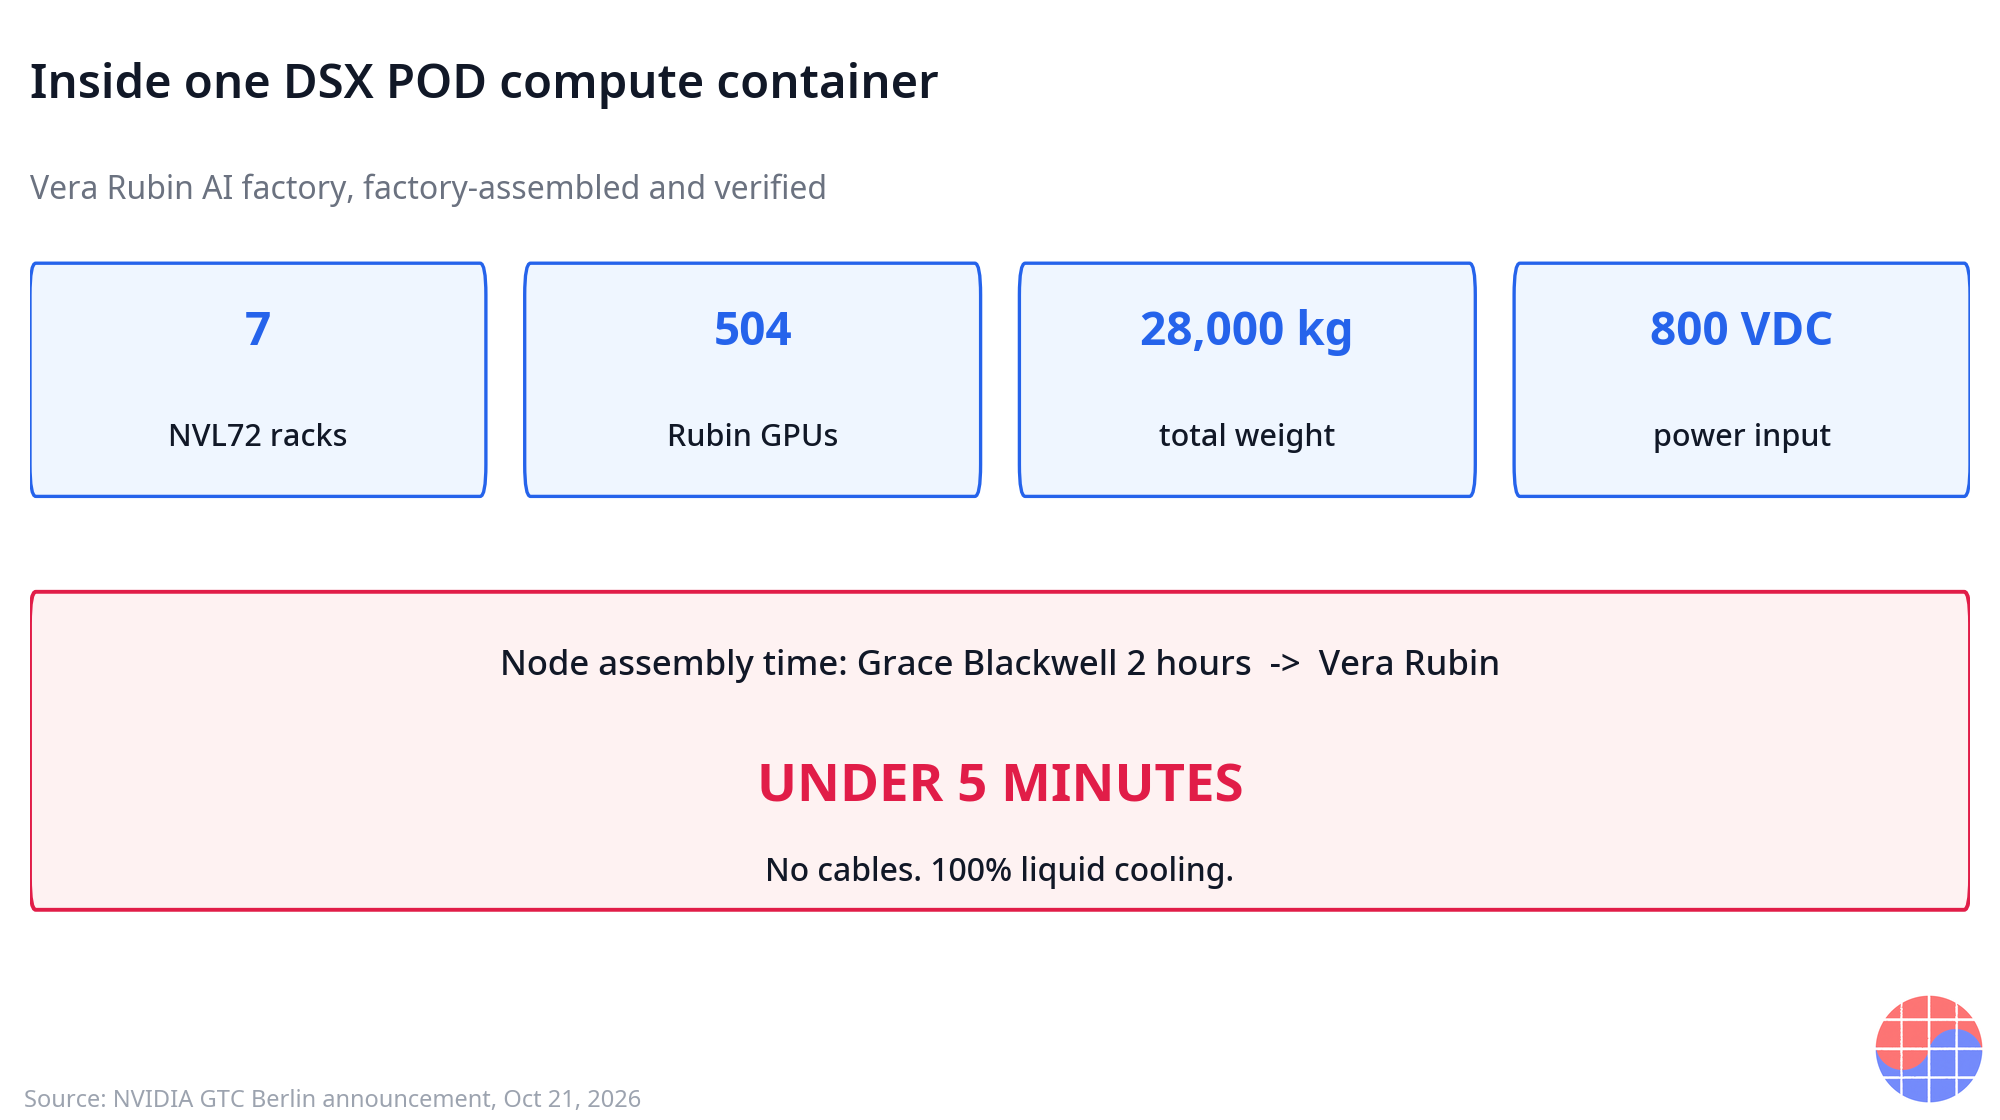
Fuente: anuncios de NVIDIA en el GTC de Berlín, 21 de octubre de 2026. Enlaces en la nota al pie.
La pila de NVIDIA sube un nivel más
El patrón estratégico ya es familiar, pero el POD lo extiende. NVIDIA subió de los chips a las placas, de las placas a los racks (NVL72), de los racks a los sistemas en red, y ahora, con el diseño de referencia DSX POD, de los sistemas a la propia fábrica. Cada subida amplía los ingresos que NVIDIA y su ecosistema pueden asociar a un gigavatio de capacidad de IA, y cada subida profundiza la dependencia del cliente respecto del diseño de referencia que define ese nivel.
Un diseño de referencia es una forma particular de poder. NVIDIA no necesita fabricar contenedores para controlar la capa de contenedores; necesita que la industria construya según su especificación, para que la especificación se convierta en la interfaz que todos los demás deben cumplir. Los 17 socios de lanzamiento — Dell, HPE y Lenovo en sistemas; Schneider Electric, Vertiv y Eaton en infraestructura de energía y refrigeración; Foxconn (a través de Ingrasys), Delta, GIGABYTE, Pegatron, QCT, Wistron y otros en la base de ODM y componentes — no son solo proveedores. Son la distribución del estándar. Los envíos están previstos a partir de principios de 2027.
La integración en fábrica mueve el cuello de botella, no lo elimina
La preintegración es una estrategia de manufactura aplicada a un problema de construcción, y su economía sigue la lógica de la manufactura. El ensamblaje en fábrica convierte la mano de obra de campo, variable, en trabajo de línea repetible: la calidad se comprueba donde vive el equipo de pruebas, los errores se encuentran donde se sientan los ingenieros que diseñaron el nodo, y la curva de aprendizaje se acumula con cada contenedor construido en lugar de reiniciarse en cada sitio. El rediseño del nodo — sin cables, totalmente refrigerado por líquido, ensamblable en menos de 5 minutos — es la plataforma moldeada para encajar en esa línea.
Pero el cuello de botella se mueve en lugar de desaparecer. Si los contenedores se pueden desplegar en 14 días en un sitio preparado, entonces el sitio preparado se convierte en la restricción: la interconexión a la red, los plazos de entrega del equipo eléctrico, la infraestructura de refrigeración y los permisos. La presencia de Schneider Electric, Vertiv y Eaton en la lista de socios es un reconocimiento exactamente de eso: la próxima fila es eléctrica. También es la razón por la que la lectura honesta del anuncio combina la cifra de 14 días con su condición. Entre los ganadores de la próxima fase estará quien pueda entregar sitios preparados al ritmo al que ahora se pueden llenar los contenedores.
La capa de software: DSX MaxLPS y la afirmación de eficiencia
NVIDIA también anunció el software DSX MaxLPS, que según la empresa ofrece la misma producción de IA con hasta un 30% menos de energía. En una industria donde la restricción vinculante es cada vez más el megavatio y no el rack, una afirmación de eficiencia a nivel de software de ese tamaño tiene carga estratégica: si la producción por vatio aumenta, la misma conexión a la red admite más cómputo vendible, y la capacidad efectiva de cada sitio preparado crece sin nueva construcción. La afirmación es de NVIDIA, presentada como cifra de anuncio, y el mercado la verificará en el despliegue; pero incluso la dirección importa, porque la eficiencia energética se compone con la velocidad de despliegue: más rápido de instalar, y más producción por megavatio instalado.
La señal del ecosistema se extendió también a la capa de nube: A5X de Google Cloud, construido sobre Vera Rubin, tiene su disponibilidad general prevista para noviembre. Las plataformas de frontera ahora se lanzan simultáneamente como productos que se compran, contenedores que se despliegan e instancias en la nube que se alquilan: tres canales, una cadena de suministro y una fila de asignación detrás de todos ellos.
La conexión con HBM4
Cada rack Vera Rubin que se envía es también un envío de HBM4. La memoria de la plataforma es HBM4, lo que significa que la rampa de producción de Vera Rubin y los envíos de POD de principios de 2027 se traducen directamente en volumen de HBM4 para los fabricantes de memoria calificados en la plataforma. Este es el vínculo silencioso entre un anuncio de velocidad de despliegue en Berlín y los libros de pedidos de la industria de la memoria: la velocidad de despliegue determina la rapidez con la que los racks se convierten en sistemas en funcionamiento, y los sistemas en funcionamiento son los que impulsan la siguiente ronda de pedidos de GPU y HBM. Un modelo de despliegue más rápido no solo adelanta los ingresos de NVIDIA. Aprieta la cadencia de toda la cadena — encapsulado, HBM, sustratos y equipo eléctrico — que alimenta la fábrica.
La lectura de Chase
La lectura perezosa del DSX POD es «NVIDIA inventó un centro de datos más rápido». La lectura correcta trata de qué segmento de la expansión de la IA todavía tenía meses de holgura, y de quién acaba de reclamarlo.
Los chips acapararon los titulares durante tres años porque los chips eran la restricción. Pero un rack entregado que pasa meses en integración de campo es inventario, no capacidad, y la industria ha estado cargando silenciosamente con una cantidad enorme de ambas cosas. El POD ataca esa posición de inventario. Verificación en fábrica, un nodo sin cables que se ensambla en menos de 5 minutos, un contenedor especificado al kilogramo: cada elemento apunta a la brecha entre «hardware entregado» y «hardware ganando». NVIDIA examinó el calendario de la expansión, encontró el bloque más grande de tiempo muerto que podía razonablemente poseer, y lo convirtió en producto.
Dos implicaciones están infravaloradas. Primera: los diseños de referencia redistribuyen el margen sin redistribuir el control. Los 17 socios ganan un mercado real — fábricas de IA en contenedores que se envían desde principios de 2027 — pero lo ganan dentro de una especificación propiedad de NVIDIA, lo que significa que el crecimiento del ecosistema y el bloqueo de la plataforma de NVIDIA son el mismo acontecimiento visto desde dos lados. Segunda: el anuncio redefine silenciosamente lo que significa «preparado» como activo competitivo. Cuando el despliegue tarda 6 meses, un sitio listo y uno no listo difieren en una fase de construcción. Cuando el despliegue tarda 14 días, difieren en casi todo el calendario, y los sitios, las posiciones de energía y los permisos se convierten en activos estratégicos negociables de una manera en que antes no lo eran.
La pregunta abierta es la cadencia de ejecución. Un diseño de referencia es una promesa hasta que los contenedores se envían en volumen, y principios de 2027 es cuando la promesa tendrá su primera prueba dura: cuántos POD, con qué rendimiento (yield), en cuántos sitios genuinamente preparados. Conviene seguir los informes de envíos de los socios, no las conferencias magistrales. Si el despliegue de 14 días se mantiene en el campo aunque sea aproximadamente, cada plataforma competidora se verá obligada a responder una pregunta que antes no tenía que responder: no lo rápidos que son sus chips, sino lo rápido que se ensamblan sus fábricas.
Implicaciones
- Para hiperescaladores y operadores de fábricas de IA: la velocidad de despliegue es ahora un criterio de compra a la par del rendimiento por vatio. Una plataforma que llega a producción meses antes monetiza meses antes: hay que evaluar el intervalo entre sitio preparado y producción, no solo el silicio.
- Para los socios de NVIDIA: el POD crea un mercado de capa de contenedores a partir de principios de 2027, dentro de la especificación de NVIDIA. La oportunidad es real; también lo es la dependencia. Los socios con posiciones en energía y refrigeración (la capa del sitio preparado) tienen las cartas más escasas a medida que el cuello de botella se vuelve eléctrico.
- Para los fabricantes de memoria: Vera Rubin en producción plena, más los envíos de POD desde principios de 2027, es una señal de volumen de HBM4. La velocidad de despliegue aguas arriba determina la cadencia de pedidos aguas abajo.
- Para los proveedores de plataformas competidoras: la contienda se ha ampliado de los chips a los sistemas de despliegue. Un rack rival ahora compite no solo en cómputo, sino en tiempo hasta la producción en un sitio preparado.
- Para los inversores: hay que seguir tres puntos de verificación: los envíos de POD de los socios a principios de 2027, los informes de campo sobre la afirmación de despliegue en 14 días, y los resultados medidos de la afirmación de hasta un 30% menos de energía del DSX MaxLPS. Los anuncios fijan la narrativa; los envíos fijan las cifras.
Preguntas frecuentes
¿Qué es exactamente el DSX POD de NVIDIA?
Es un diseño de referencia que convierte una fábrica de IA Vera Rubin completa en contenedores modulares: la fábrica se ensambla y se verifica en la fábrica, y luego se envía. Un contenedor de cómputo alberga 7 racks Vera Rubin NVL72 con 504 GPU Rubin, pesa unos 28.000 kg y toma una entrada de energía de 800 VDC. NVIDIA lo anunció en el GTC de Berlín el 21 de octubre de 2026, con 17 socios y envíos previstos desde principios de 2027.
¿Significa la cifra de 14 días que un centro de datos se puede construir en 14 días?
No. Los 14 días son el periodo de despliegue en sitio en un sitio preparado — uno donde la energía, la refrigeración y la infraestructura del edificio ya están instaladas — frente a unos 6 meses de construcción convencional en sitio. Construir el propio sitio, incluida la conexión a la red y los permisos, sigue llevando mucho más tiempo. El POD comprime el segmento entre «sitio listo» y «fábrica de IA en funcionamiento».
¿Qué cambió en el nodo Vera Rubin para que el ensamblaje sea tan rápido?
NVIDIA afirma que los nodos Vera Rubin no tienen cables, son 100% refrigerados por líquido y reducen el tiempo de ensamblaje del nodo de 2 horas en Grace Blackwell a menos de 5 minutos. Eliminar el cableado elimina tanto el tiempo de ensamblaje como una fuente importante de errores de campo, y además hace que los nodos sean rápidos de sustituir en servicio, no solo de instalar.
¿Por qué importa la producción de Vera Rubin para la HBM4?
Los sistemas Vera Rubin utilizan memoria HBM4, por lo que la rampa de producción plena de la plataforma — y los envíos de DSX POD previstos desde principios de 2027 — se traducen directamente en demanda de HBM4. La velocidad de despliegue importa a los fabricantes de memoria porque un despliegue más rápido adelanta la siguiente ronda de pedidos de GPU y HBM.
Fuentes: cobertura del anuncio de despliegue del DSX POD de NVIDIA; informe del GTC de Berlín sobre Vera Rubin y el DSX POD; informe sobre el despliegue en 14 días del DSX POD (todos sobre los anuncios de NVIDIA en el GTC de Berlín del 21 de octubre de 2026). Este artículo es un análisis, no asesoramiento de inversión.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


