 VLSI Korea
La caída del PC no es un regalo para la IA: la paradoja del suministro de memoria
La caída del PC libera obleas maduras, pero la IA necesita HBM, no silicio genérico. Análisis de 2026: crowding-out del HBM, disciplina de proveedores, LTA al alza y la carrera del capex hacia el billón anual.


Resumen en 30 segundos
La caída del PC libera obleas maduras, pero ese "suministro liberado" es una ilusión para la IA: un acelerador no funciona con DRAM genérica, necesita HBM, y el silicio de nodo maduro no se convierte en HBM. La verdadera historia de suministro de 2026 es otra: (1) el HBM está canibalizando recursos de fab a un ritmo desproporcionado, lo que limita el crecimiento de la oferta de DRAM y NAND commodity; (2) los proveedores, ya disciplinados tras el desplome de 2023–2024, están recortando exposición al commodity, subiendo precios de contrato, renegociando LTA al alza y racionando a los clientes por niveles; (3) el capex de IA avanza hacia el billón de dólares anuales y los mercados de crédito empiezan a ponerle precio a la pregunta incómoda: quién paga la factura. A eso se suma la paradoja de Jevons de los tokens — tokens más baratos hacen que el cómputo valga más, lo que sostiene la demanda de HBM. Para inversores y para Corea, la conclusión es la misma: el poder de fijación de precios se quedó del lado de la oferta de memoria.
Antecedentes: el PC se enfría y las obleas "sobran"
A fecha de 14 de octubre de 2026, el mercado de PC y portátiles atraviesa uno de sus tramos más flojos del ciclo. Los ciclos de reemplazo se alargaron, la digestión del último gran ciclo de renovación empresarial sigue en curso y la demanda del consumidor no repunta. El resultado visible: líneas de fabricación en nodos maduros — DRAM DDR4, NAND de generaciones tempranas — operando por debajo de su utilización óptima.
De ahí surgió una lectura cómoda en ciertos círculos de mercado: si el PC consume menos, esas obleas "quedan libres" para la IA. Es una aritmética tentadora y completamente equivocada. Confunde obleas con obleas útiles. La IA no necesita obleas; necesita ancho de banda de memoria empaquetado de una forma muy concreta. Y esa forma concreta tiene nombre propio: HBM.
Análisis profundo
La ilusión del silicio liberado
Un stack de HBM no es DRAM genérica apilada. Exige obleas DRAM de clase avanzada (nodos 1-alpha/1-beta y equivalentes), formación de TSV a través de cada die, una base lógica (logic base die) que gestiona el stack, y capacidad de empaquetado avanzado de clase CoWoS. Cada uno de esos pasos requiere herramientas, recetas de proceso y rendimientos (yield) que una línea de nodo maduro simplemente no tiene.
Dicho de forma directa: la capacidad liberada por el PC es silicio del tipo equivocado, con las especificaciones equivocadas, en los nodos equivocados. Una línea optimizada para DDR4 en 20 nm no se "convierte" en una línea de HBM con un cambio de máscara. La economía tampoco cuadra: el capex necesario para reconvertirla supera con creces el valor del producto commodity que saldría de ella. El "suministro liberado" es un error de categoría, no una oportunidad de arbitraje.
Lo que sí hace la caída del PC es otra cosa más sutil: debilita el poder de negociación de los compradores de commodity. Los OEM de PC, que durante décadas fueron el cliente ancla de la DRAM genérica, llegan a la mesa de negociación de 2026 con menos volumen y menos palanca. Y enfrente se encuentran con proveedores que aprendieron la lección del último desplome.
Crowding-out: el HBM se come la fab
Aquí está el mecanismo central de 2026. Un stack HBM4 de 12-high construido con dies de 24 Gb suma 288 Gb por stack; la variante de 16-high alcanza 384 Gb. Para entregar esos bits hay que fabricar 12 o 16 dies DRAM, perforarlos con TSV, apilarlos con precisión micrométrica, añadir el base die y someter el conjunto a pruebas que descartan una fracción no trivial del material en cada etapa.
El resultado, en términos de recursos de fab por bit entregado, es que el HBM consume múltiplos del área de oblea, las horas de equipo y la capacidad de prueba que exige la DRAM commodity. Cada punto porcentual de mezcla (mix) que el HBM gana dentro de la producción de bits de los grandes proveedores es capacidad que no va al commodity. Y como el espacio de fab, las horas de litografía y el capex son finitos, el crecimiento de la oferta de DRAM y NAND commodity queda efectivamente limitado — no por falta de demanda, sino por desplazamiento interno.
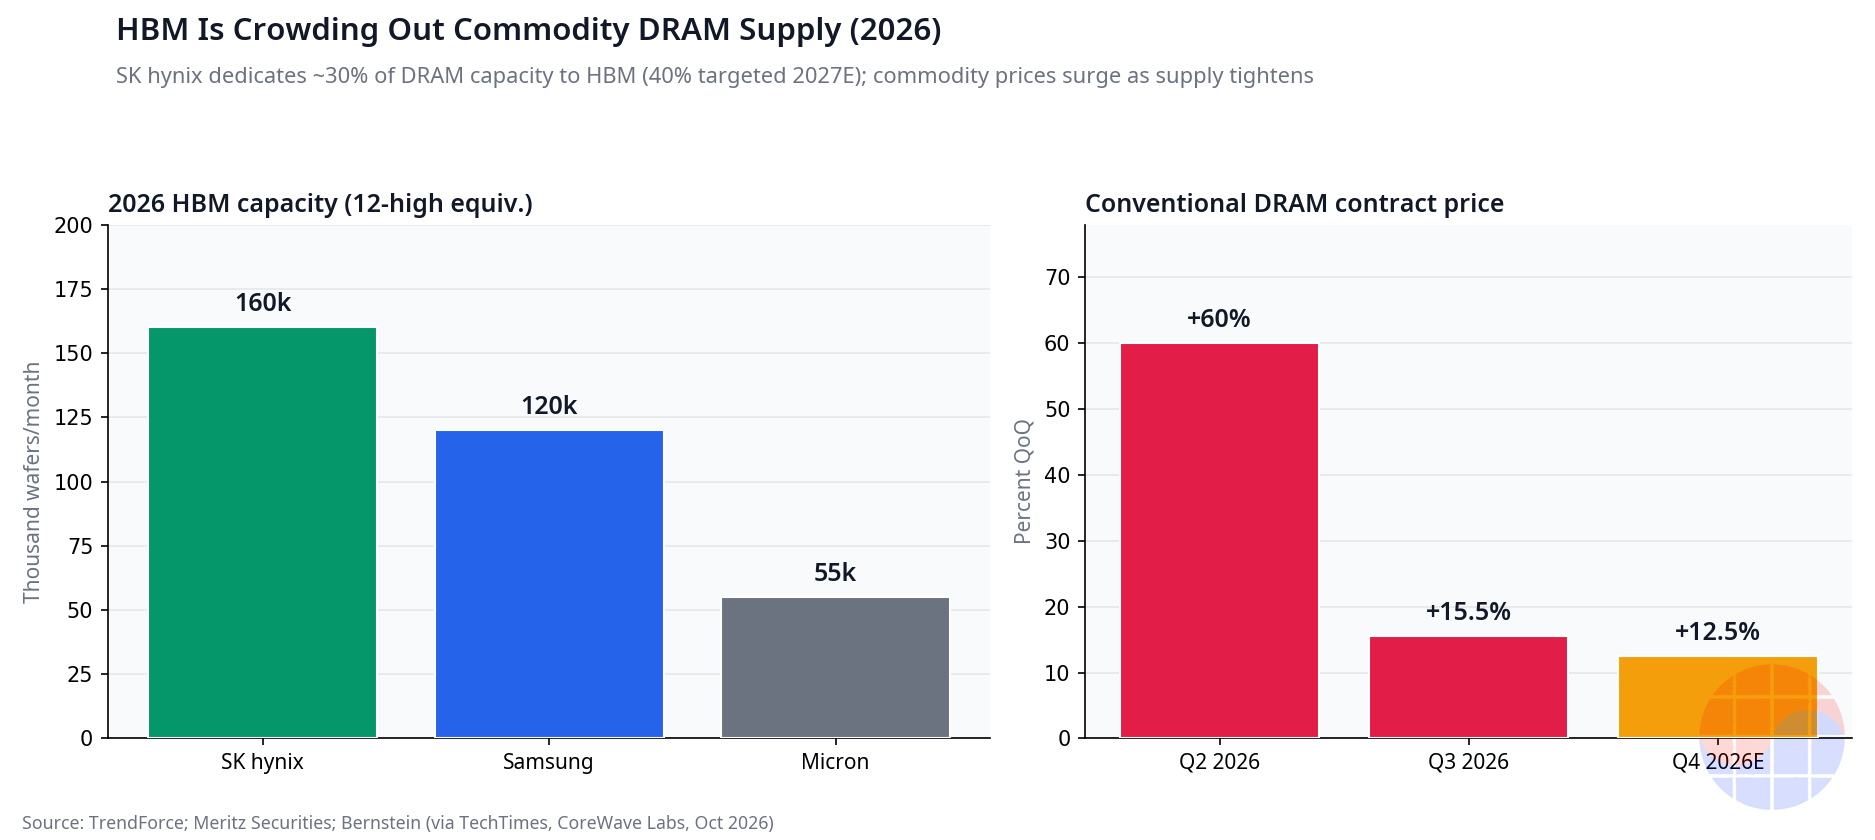
Este es el crowding-out: la IA no está "aprovechando" la capacidad ociosa del PC; está expulsando al commodity de las fabs más avanzadas. Los datos públicos de mezcla de producto de los tres grandes fabricantes de memoria apuntan en la misma dirección a fecha de octubre de 2026: la porción HBM de la producción de bits crece trimestre a trimestre, mientras la inversión incremental se dirige de forma desproporcionada a capacidad habilitada para HBM. El commodity recibe mantenimiento, no expansión.
Disciplina del proveedor: menos commodity, más precio, clientes por niveles
El desplome de 2023–2024 cambió el ADN de la industria de memoria. Los tres grandes proveedores aprendieron —a un coste brutal— que inundar el mercado de commodity destruye el margen de todos. En 2026 operan como lo que son: un oligopolio disciplinado.
Esa disciplina se manifiesta en cuatro movimientos visibles a fecha de 14 de octubre de 2026:
- Recorte de exposición al commodity. Los planes de capex priorizan capacidad HBM y nodos avanzados; las líneas de commodity se mantienen, no se amplían.
- Precios de contrato al alza. Las referencias públicas de precios de contrato de DRAM muestran una trayectoria ascendente durante 2026, con los proveedores empujando subidas trimestre a trimestre.
- LTA renegociados al alza. Los acuerdos a largo plazo (LTA, long-term agreements) —el instrumento con el que los grandes compradores aseguraban volumen y precio— se están renovando en condiciones más duras: precios más altos, duraciones que favorecen al vendedor y cláusulas de volumen más estrictas.
- Clientes por niveles (tiering). La asignación de suministro prioriza a los compradores de IA —hiperescaladores y fabricantes de aceleradores— mientras los compradores tradicionales de commodity negocian desde una posición más débil.
El efecto neto: precios más altos y más rígidos a la baja. El ciclo de memoria de 2026 no se parece al de 2018 o 2021; la oferta está gestionada.
Quién paga: la carrera del capex hacia el billón anual
La otra mitad de la historia está en el lado de la demanda. Sumando las guías públicas de capex de los grandes hiperescaladores y constructores de infraestructura de IA, el gasto agregado en construcción de IA avanza hacia el rango del billón de dólares anuales a fecha de finales de 2026. Es una cifra sin precedente en la historia de la infraestructura tecnológica.
Ese gasto se financia con una mezcla de flujo de caja operativo, emisión de deuda corporativa, estructuras SPV y vehículos fuera de balance. Y aquí aparece la pregunta que los mercados de crédito han empezado a formular: ¿quién soporta realmente el riesgo si la construcción va por delante de los ingresos? Los diferenciales de crédito (spreads) de los emisores más expuestos a la construcción de IA y las referencias de CDS empiezan a discriminar —a fecha de octubre de 2026— entre balances que pueden absorber el ciclo y balances que están apostando el balance mismo.
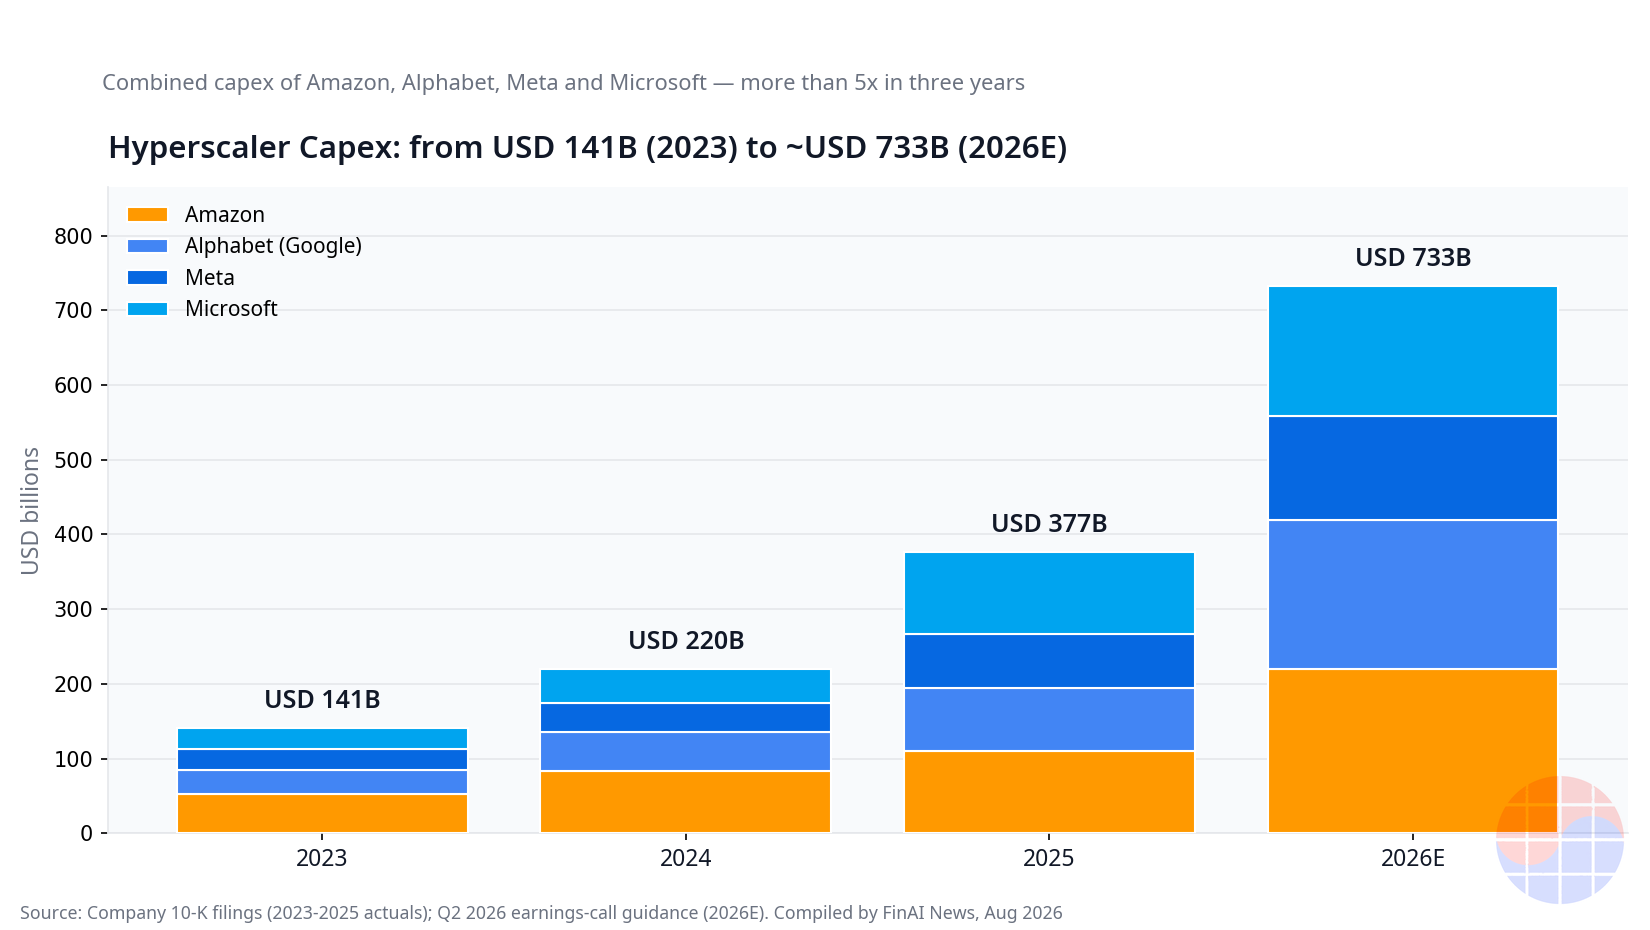
Para los proveedores de memoria, esta dinámica es relativamente benigna: venden las palas y los picos (HBM) con precios protegidos por LTA. El riesgo de sobreconstrucción recae sobre compradores y constructores. Para el inversor, la lectura es clara: en la cadena de valor de la IA, la memoria con liderazgo en HBM es el eslabón con mejor relación riesgo-retorno del lado de la oferta.
La paradoja de Jevons de los tokens
Falta una pieza, y es la que explica por qué la demanda de HBM no se agota aunque los precios de inferencia caigan. En los últimos dos años, el coste por token se ha desplomado por mejoras de eficiencia de los modelos, competencia entre proveedores y optimización de infraestructura. La intuición diría que tokens más baratos significan menos gasto en cómputo. La historia de la economía dice lo contrario: cuando un insumo se abarata, su uso se expande más que proporcionalmente.
Tokens más baratos abren casos de uso que antes no eran viables —agentes autónomos, inferencia siempre activa, video generado a escala— y cada uno de esos casos exige más aceleradores, cada acelerador exige más HBM. La paradoja de Jevons, aplicada a los tokens: cuanto más barato es el token, más valioso se vuelve el cómputo, y más sostenida es la demanda de memoria de alto ancho de banda. Por eso las narrativas de "el pico de la demanda de IA" yerran el mecanismo: confunden precio unitario con gasto agregado.
Chase's Take
Esto no es una historia de demanda; es una historia de oferta con foso estructural. Tres ventajas componen el foso, y ninguna se improvisa:
Primero, el HBM es un foso compuesto: proceso DRAM avanzado más TSV más apilado de precisión más empaquetado avanzado más cualificación con el cliente. Cada capa filtra competidores; la combinación los elimina. No se compra con dinero rápido.
Segundo, el oligopolio aprendió disciplina. El trauma de 2023–2024 enseñó a los tres grandes a recortar antes que a inundar. Esa memoria institucional —literalmente— es lo que mantiene los precios de contrato firmes en 2026 pese a la debilidad del PC.
Tercero, la pila de clientes se invirtió. Hace una década, el OEM de PC dictaba condiciones; hoy el hiperescalador ruega por asignación de HBM. Cuando el cliente con más dinero es el que tiene menos palanca, el poder de fijación de precios vive en la oferta.
Para Corea, la lectura es doblemente favorable. Samsung aporta la amplitud del IDM —DRAM, NAND, foundry y empaquetado bajo un mismo techo— y SK hynix aporta la mejor ejecución en HBM de la industria. Son, a fecha de octubre de 2026, los dos nombres de memoria mejor posicionados del mundo para este ciclo. Y detrás de ellos, el ecosistema doméstico de equipos y materiales (소부장) —test, manejo de obleas adelgazadas, TSV, materiales avanzados— cabalga la misma ola de capex HBM.
El riesgo existe y hay que nombrarlo: si el capex de IA se detuviera en seco, la prima del HBM se comprimiría. Pero los LTA y el tiering de clientes retrasan y amortiguan ese escenario de una forma que el ciclo de 2023 no tenía. La corrección, si llega, será más corta y menos profunda.
Implicaciones
Para inversores
- Prefiera proveedores de memoria con liderazgo en HBM sobre compradores de commodity. El poder de fijación de precios está del lado de la oferta.
- Vigile tres señales: dirección de los precios de contrato de DRAM, duración y precio de los LTA que se renuevan, y mezcla (mix) de bits HBM en la producción de los grandes. Son los indicadores adelantados del ciclo.
- La pregunta "quién paga" es una pregunta de crédito. Infrapondere a los constructores de IA más apalancados o exija compensación en spread; los diferenciales de crédito y las referencias de CDS son el termómetro de la sostenibilidad del capex.
- No confunda debilidad del PC con debilidad de la memoria. Son ciclos distintos desde 2024; el PC débil incluso refuerza el pricing del commodity al debilitar al comprador.
Para Corea y sus jugadores
- Samsung y SK hynix capturan tanto el poder de fijación de precios del commodity como la prima de mezcla del HBM. Es la mejor combinación posible del ciclo.
- El ecosistema 소부장 doméstico —equipos de prueba HBM, manejo de TSV, materiales avanzados— recibe un viento de cola de capex directo y sostenido.
- Ángulo de política industrial: la memoria sigue siendo la palanca estratégica de Corea en la pila de la IA. Cada acelerador del mundo lleva memoria coreana; esa es una posición negociadora que trasciende el ciclo.
Preguntas frecuentes
¿La caída del PC libera capacidad para la IA? No. Libera obleas de nodo maduro con especificaciones de commodity (DDR4, NAND temprana), que no pueden convertirse en HBM: faltan las herramientas, los procesos TSV, el apilado de precisión y la cualificación. Es silicio del tipo equivocado. Lo que la caída del PC sí hace es debilitar al comprador tradicional de commodity en la mesa de negociación.
¿Qué es el crowding-out del HBM y por qué importa para los precios? Cada stack HBM4 de 12-high usa 12 dies de 24 Gb (288 Gb por stack) más TSV, base die y empaquetado avanzado, con pérdidas de rendimiento en cada etapa. Por bit entregado, el HBM consume múltiplos de los recursos de fab que la DRAM commodity. Como la capacidad de fab es finita, el crecimiento del HBM limita mecánicamente el crecimiento de la oferta de commodity — y esa restricción sostiene los precios.
¿Qué son los LTA y el tiering de clientes? Los LTA (long-term agreements) son contratos plurianuales de volumen y precio entre proveedores de memoria y grandes compradores. En 2026 se renuevan al alza y con condiciones más duras para el comprador. El tiering es la asignación prioritaria de suministro: los compradores de IA (hiperescaladores, fabricantes de aceleradores) reciben preferencia; el resto negocia con menos palanca.
¿Quién paga la construcción de IA y cómo lo muestran los mercados de crédito? El capex agregado de IA avanza hacia el billón de dólares anuales a finales de 2026, financiado con caja, deuda y estructuras SPV. Los mercados de crédito —spreads de emisores expuestos y referencias de CDS— han empezado a discriminar qué balances pueden absorber el ciclo. Los proveedores de memoria están relativamente aislados porque venden con LTA; el riesgo de sobreconstrucción recae sobre compradores y constructores.
Nota: análisis basado en datos públicos y estimaciones de la industria a fecha de 14 de octubre de 2026; los términos contractuales específicos y las cifras internas de capex no se divulgan públicamente en su totalidad, por lo que las proyecciones deben leerse como direccionales.
