VLSI Korea
Google TPUは1年で投資回収——カスタムシリコン経済学が変えるAIチップの勢力図
GoogleのTPUサーバーは1年以内に投資を回収する。TPUv7 IronwoodはB200/B300比で最大50%優れた推論のドル当たり性能を持つ。回収期間が1年なら自社チップは選択肢ではなく財務的な自明性だ——Broadcom・MediaTekへと続くASICバリューチェーンが構造的成長に入った。


抜粋: GoogleのTPUサーバーは1年以内に投資を回収する。TPUv7 IronwoodはB200/B300比で最大50%優れた推論のドル当たり性能を持つ。回収期間が1年なら、自社チップは選択肢ではなく財務的な自明性だ——Broadcom・MediaTekへと続くASICバリューチェーンが構造的成長に入った。
30秒サマリー(AEO)
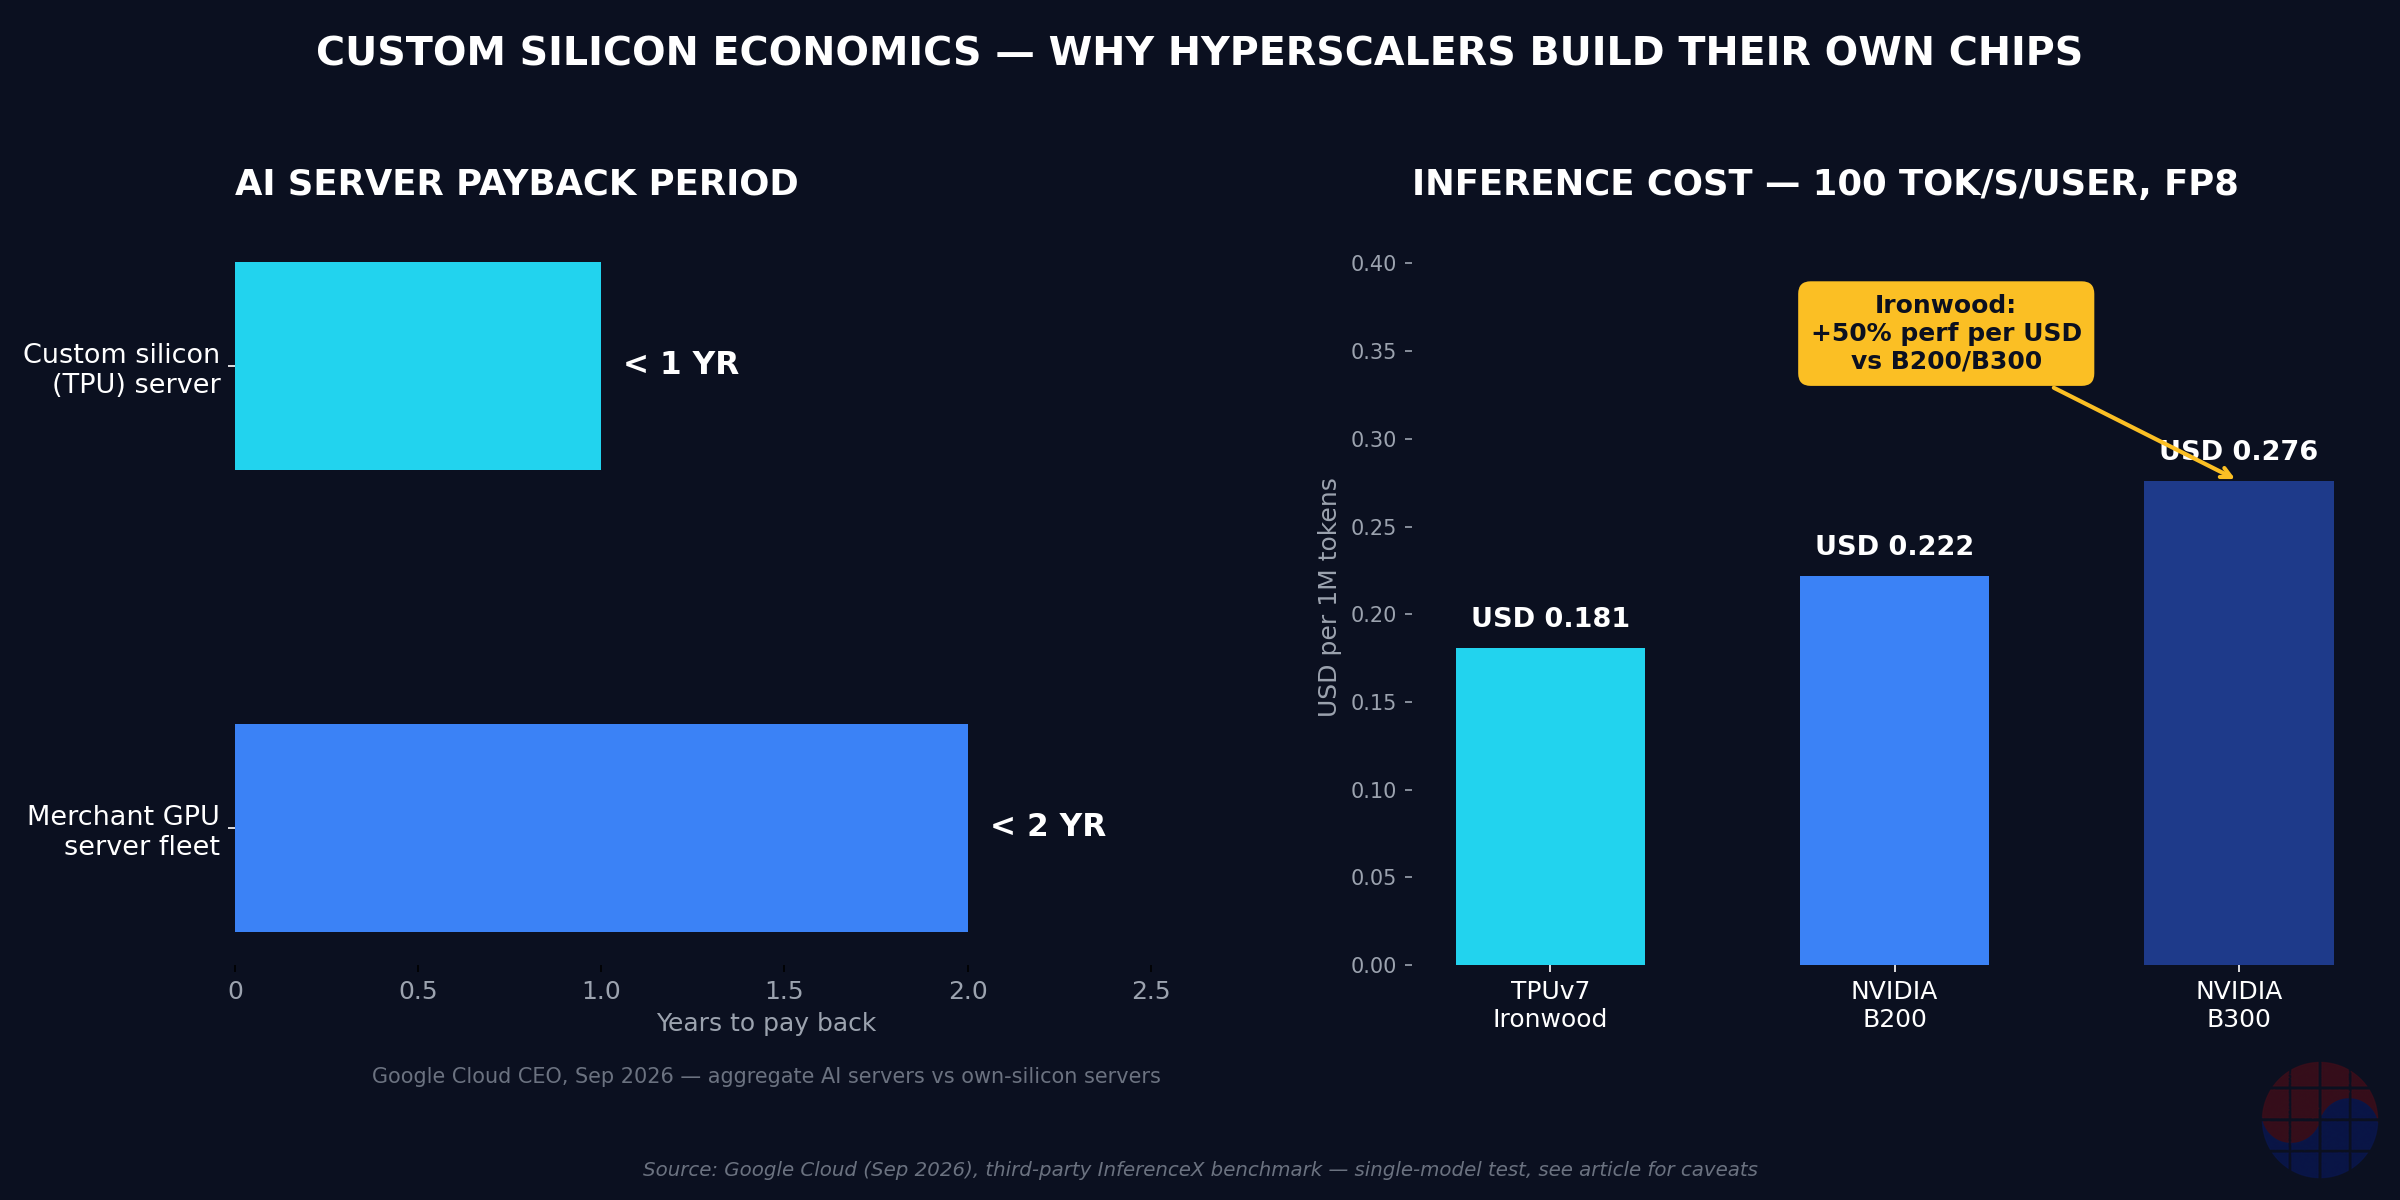
- Google Cloud CEO Thomas Kurianが2026年9月に開示:AIサーバーの投資回収期間は全体平均で2年未満、自社シリコン(TPU)搭載サーバーはその約半分。1年クラスの回収期間は、カスタムシリコンを「戦略的選択」から「財務的自明性」へ変える。(出典)
- 第三者ベンチマーク(InferenceX)では、TPUv7 Ironwoodが同一条件の推論でB200/B300比「最大50%優れたドル当たり性能」を記録。ただし単一モデル(Qwen 3.5 397B、FP8)のベンダー実施テストという留保付き。(出典)
- Anthropicは2026年10月のIPO書類でTPU容量の5年リース1,252億ドルを開示、Broadcomは最大420億ドルの転換社債ファイナンスで合意。チップ販売と金融が結合した新しい営業モデルだ。(出典)
- MediaTekは2026年のASIC売上見通しを20億ドル超へ2倍に上方修正、Google向け初のAI ASICは2026年第4四半期に量産開始。(出典)
- 結論:ハイパースケールではmake-vs-buy論争は終わった。回収期間が答えを決める。
Background:なぜ今、カスタムシリコンなのか
AIチップ論争の中心は長らく「誰が速いか」だった。しかし2026年後半、問いが変わった。Alphabetが2026年の設備投資(CapEx)を1,950億〜2,050億ドルと予告する中(出典)、株主の質問は「その金はいつ戻るのか」になった。
Kurianの答えは異例なほど具体的だった。2026年9月8日のGoldman Sachs Communacopia + Technology Conferenceで、彼はAIサーバー全体の回収期間が2年未満、自社シリコンはその約半分だと述べた。Google Cloudは9月11日の公式recapでも同内容を再確認した。さらに学習用途で2.7倍、推論用途で80%優れた価格性能を主張し、自社アクセラレータ事業は次位ハイパースケーラーの2倍以上の規模だとした。(出典)
この発言の真の重みは「2年」という数字自体ではない。回収期間が1年台に落ちると、自社チップ開発の経済学が根本からひっくり返る点だ。最先端プロセスのAI ASICのNRE(設計・マスク・検証費用)は1億〜2億ドル級と推定される。100万チップで割ればチップ当たり100〜200ドルに過ぎない。merchant GPUに付く流通マージン(NVIDIAの売上総利益率は70%台)と比較すれば、数量さえ支えれば自社チップが無条件に安い。Kurianの発言は「数量が支える」ことをGoogle Cloud CEOが自ら宣言したに等しい。
Business Deep Dive
市場規模:2027年に800億ドルのカスタムAIチップ市場
証券会社の推定では、カスタムAIチップのTAMは2027年に約700億〜800億ドルに達する見通し。MediaTekは2026年7月の決算説明会で、この市場の15〜20%獲得を目標に掲げた。(出典)
ハイパースケーラーの動きは既に数字の上に載っている。
- Google:2026年4月のGoogle Cloud Nextで第8世代TPU(学習用8t、推論用8i)を公開。新Virgoネットワークファブリックにより、単一データセンターで13万4,000個、複数拠点で100万個超のTPUを1つの論理クラスタに束ねるとした。(出典)ボトルネックはもはやシリコン供給ではなく電力だ——数十万個規模では、ラックにどれだけ電力を供給できるかが成長の天井になる。(出典)
- Anthropic:2025年10月に最大100万個のIronwood TPU導入を骨子とする複数年契約をGoogleと締結(数百億ドル規模と報道)。2026年10月1日のIPO書類ではTPU容量の5年リース1,252億ドルを開示した。(出典)
- Meta:Broadcomと共同設計したMTIAプログラムの「Iris」チップが2026年9月にTSMC 3nmで量産開始。MetaはAI演算容量を2026年の7GWから2027年末に14GWへ倍増する計画だ。(出典)
- OpenAI:2026年6月にBroadcomと初のカスタムチップ「Jalapeño」を公開、10GW規模の共同開発を進行中。ラック展開は2026年末開始、2029年まで続く。(出典)
原価構造:TCOはどこで分かれるか
Ironwoodの経済学を分解すると3つのレバーがある。
1. ドル当たり推論性能。InferenceXベンチマーク(Qwen 3.5 397B、FP8、ユーザー当たり100 tokens/s条件)でIronwoodは100万トークン当たり0.181ドルを記録。B200は0.222ドル、B300は0.276ドル。「最大50%優れたドル当たり性能」の根拠はここだ。内部TCO基準ではGB200 Blackwellサーバー比で約44%安く、Anthropicのような外部顧客基準でもNVIDIA比で約30%安いとの分析もある。(出典)ただし、単一モデル・単一条件のベンダー実施テストという限界がある。独立色の強い反証として、スタートアップInferactがMoonshot AIのKimi K3を同一vLLMエンジンで回した結果——16個のTPUv7チップが709 tokens/sで、16個のGB200(452 tokens/s)を57%上回った。ソフトウェアスタック最適化(メガカーネル)込みの結果だが、独立ベンチマークとして意味がある。(出典)
2. merchantマージンの除去。Googleが自社チップを外部に売る・貸すとき、価格にNVIDIA式のmerchantマージンの楔はない。垂直統合ハードウェア(チップ・インターコネクト・ソフトウェアスタック)を内部原価にクラウドサービス手数料を上乗せして売る構造だ。同じFLOPSでも請求書の構造が違う。
3. 電力と規模の経済。データセンターTCOに占める電力・冷却の比率は40%に迫る。チップ単体のワット当たり性能も重要だが、100万個規模ではファブリック効率(goodput)が金を分ける。GoogleがTPU 8tで「97%超のgoodput」を掲げる理由だ。メモリ業界が歩留まりで勝負するのと同じ構造——単位性能ではなく「生き残るサイクル」の経済学である。
競争ポジショニング:4つの軸
| 軸 | 代表プレイヤー | ポジション |
|---|---|---|
| ハイパースケーラー自社チップ | Google TPU、Meta MTIA、Amazon Trainium、Microsoft Maia、OpenAI Jalapeño | ワークロード特化、merchantマージン除去 |
| ASIC設計パートナー | Broadcom、MediaTek、Marvell、Alchip | 設計・CoWoS・HBM統合力で受注 |
| ファウンドリ | TSMC(事実上の独占) | 最先端キャパの配分者 |
| メモリ | SK hynix・Samsung・Micron(HBM) | チップ当たりHBMスタック数(チップ当たり数百Gb級)が原価の大きな軸 |
Broadcomの位置が特に興味深い。2026年4月にGoogleと2031年までの長期TPU・ネットワーキング供給契約を結び(出典)、4月14日にはMeta MTIA協力も拡大(1GW超)。OpenAIとは10GWの共同開発。つまりBroadcomは競合する3つのAI陣営のチップを同時に設計する「カスタムシリコンの武器庫」になった。
MediaTekは別の角度から切り込む。スマートフォンチップで鍛えたCPU・GPU・NPUのIPと低電力設計資産をデータセンターASICに転用する戦略だ。2026年第2四半期にはASICを含むSmart Device Platform部門が史上初めてスマートフォンチップを抜き最大の売上源になった。4月と7月の決算説明会で2026年のASIC売上見通しを20億ドル超へ2倍に上方修正し、Google向け初のAI加速器ASICは2026年第4四半期に量産入りする。(出典)ただし市場ではサンプル納期・歩留まり関連の噂もあり、第4四半期の量産が実際に軌道に乗るかが観戦ポイントだ。
戦略オプション:3つのシナリオ
- 垂直統合の加速(ベースケース):TPU externalizationが成功すれば、2027年には推論ワークロードの20〜30%がmerchant GPUではなくカスタムシリコンで回る。ASIC設計パートナーのマルチプルがリレーティングされる。
- merchantの反撃:NVIDIAはRubin世代でTCOギャップを狭める方向に価格・バンドル戦略を調整し得る。CUDAエコシステムの切替コストは依然として堀だ。IronwoodがFP8までしかネイティブ対応しない点(TPUv8iでFP4追加予定)は比較の有効範囲を制限する。
- 金融リスクの顕在化(ベアケース):Broadcom式の顧客ファイナンスは、2001年の通信機器バブル時のNortel・Lucentのベンダーファイナンスと構造が似ている。当時も機器メーカーが顧客の購買を支えたが、顧客信用の崩壊で道連れになった。Anthropicの開示(リースバックストップの最大290億ドル露出)自体がこの構造の両面性を示す。(出典)
Chase's Take
ここでMBAケースとして読むべきポイントは一つだ。make-vs-buyの答えは技術ではなく回収期間が決める。
伝統的な製造業のmake-vs-buy分析では、固定費(NRE)を数量で割るのが全てだ。ところがAIチップでは分母(数量)が指数関数的に膨らむ一方、分子(NRE)は最先端プロセスで膨らむものの数量の伸びに追いつけない。100万チップ×チップ当たり数千ドルの節約=数十億ドル。この算式が成立する瞬間、CFOはエンジニアに「なぜ作らないのか」と問う。Kurianの発言は、まさにその問いへのCEO級の回答だ。
二つ目はBroadcomのGTMイノベーションだ。チップを売る会社が顧客に420億ドルを貸す構造——これは単なる値引きではなく「金融こそ営業」のモデルだ。肯定的に見れば参入障壁(顧客ロックイン)の極大化、否定的に見れば信用リスクの内部化だ。投資家はBroadcomのバランスシートをチップ会社ではなく「準金融機関」の目で見るべきだ。
三つ目は日本・台湾・韓国への示唆だ。このゲームでのアジアの座は二つある。一つはHBM——カスタムチップ1個当たり8〜12スタック(チップ当たり数百Gb級)のHBMが付く構造では、ASIC数量の増加はそのままHBM需要の増加だ。SK hynix・Samsung・Micronにとってはmerchant GPU用でもカスタムASIC用でもHBMが売れればよい。もう一つはファブレスの教科書——MediaTekの「スマホIP転用」戦略は、アジアのファブレスが特定ワークロード(推論・エッジ)に特化したASICで切り込む際の雛形になり得る。
Implications:投資・経営への示唆
- 投資:ASIC設計パートナー(Broadcom・MediaTek・Marvell・Alchip)は構造的成長局面。ただしマルチプルは既に相当織り込まれている可能性があり、第4四半期のMediaTek量産の軌道乗りとBroadcomのファイナンス露出規模を四半期ごとにチェックすべきだ。ファウンドリではTSMCの最先端キャパ配分がそのまま顧客ポートフォリオの質を決める。
- 経営:クラウド購買者は2027年の推論ワークロードのTCOをmerchant GPU単一基準で組んではいけない。TPU externalizationの見積もりを必ず並行入札に入れること。交渉レバレッジ効果だけでも既存GPU単価を30%近く下げた事例(OpenAI)がある。(出典)
- リスク:顧客ファイナンス構造が壊れるシナリオは、チップ需要の急減ではなく「信用収縮」から来る。AIインフラファイナンスが数千億ドル規模になった今、モニタリング指標はチップ出荷量ではなくスプレッドとデフォルトスワップだ。
FAQ
Q1. TPUは本当に1年で投資を回収するのか? Google Cloud CEOが2026年9月のカンファレンスで述べた公式数字だ。AIサーバー全体平均は2年未満、自社シリコンはその約半分。ただしこれはGoogleの内部集計基準であり、外部顧客が同条件を再現できる意味ではない。(出典)
Q2. Ironwoodの「ドル当たり性能50%優位」は公正な比較か? 単一モデル・単一条件のベンダー実施テストという限界がある。ただし独立スタートアップ(Inferact)の第三者ベンチマークでもTPUv7がGB200を上回り、内部TCO基準で44%削減との分析もあり、方向性自体は複数の情報源が一致する。反論としてはFP8までしかネイティブ対応しない制約がある。(出典)
Q3. BroadcomがAnthropicに420億ドルを貸すことがなぜ重要か? チップ販売と金融が結合した新しい営業モデルだからだ。顧客の購買力を直接支えて受注を確保する代わりに、顧客信用リスクを抱える。2001年の通信機器バブルのベンダーファイナンスと似た構造であり、両面性を見るべきだ。(出典)
Q4. アジア企業への影響は? HBM需要面ではSK hynix・Samsung・Micronに追い風だ。カスタムチップにもHBMが大量に付くからだ。設計面ではMediaTekの「スマホIP転用」戦略がアジアのファブレスの教科書になり得る。
関連書籍
- AIチップ覇権争いの全体像:Chip War — Chris Miller (Amazon)
- NVIDIAのビジネスモデル解剖:The Nvidia Way — Tae Kim (Amazon)
このリンクから購入すると、手数料が発生する場合があります。
本記事は公開されたプレスリリース・決算発表・報道に基づく分析であり、投資助言ではありません。引用した数値は各出典の発表時点(2026年4月〜10月)基準であり、その後変更されている可能性があります。