VLSI Korea
HBMなしでAI推論? インテル480GB LPDDR5Xの賭けと推論メモリTCO戦争
インテルがOCP 2026で発表した推論専用GPU D270は、HBMを使わずLPDDR5Xで最大480GBを搭載する。2026年のHBMはほぼ完売、2027年分も予約で埋まる中、メモリを確保できる者がアーキテクチャを決める時代に。推論の勝負は帯域幅ではなく、トークンあたりの総保有コスト(TCO)だ。


Excerpt: インテルがOCP 2026で発表した推論専用GPU D270は、HBMを使わずLPDDR5Xで最大480GBを搭載する。2026年のHBMはほぼ完売、2027年分も予約で埋まる中、メモリを確保できる者がアーキテクチャを決める時代に。推論の勝負は帯域幅ではなく、トークンあたりの総保有コスト(TCO)だ。
Slug: inference-memory-tco-lpddr5x-hbm-ja
30秒でわかる要点: インテルはOCP 2026で、推論専用GPU D270(コード名Crescent Island)を発表した。FP8演算性能1.3 PFLOPS、メモリ帯域幅1.5 TB/s、350W空冷のPCIeカード。その最大の特徴はHBMではなくLPDDR5Xだ——自社カードは160GB、ODMパートナーカードは最大480GBを搭載できる。FP8換算で3000億パラメータのモデルを1枚のカードに載せ、8基構成で1兆パラメータ超に対応する。価格は未公表、独立したベンチマークもまだ存在しない。一方、HBMは2026年分がほぼ完売し、2027年分も多くが予約で埋まっている。メモリを確保できる者がアーキテクチャを決める——推論の勝負は帯域幅ではなく、トークンあたりの総保有コスト(TCO)で決まる。
Background
AIインフラの重心は、学習(training)から推論(inference)へ移っている。学習は一度きりの巨大な演算レースだが、推論は毎日数十億トークンを吐き出し続けるサービスだ。ワークロードがサービスになれば、コスト構造そのものが戦略になる。
ところが2026年後半、推論インフラを計画する現場が最初にぶつかる壁はGPUのFLOPSではなく、メモリ調達だ。サムスン電子は2026年分のHBM4がほぼ完売したとし、SKハイニックスは2026年のDRAM・NAND全生産分が完売したと発表した。マイクロンは2027年分のメモリ供給の多くをすでに高値で予約済みだと報じられている。(関連報道)
そんな中、10月12日のOCP Global Summitでインテルが示した答えは鮮烈だった。HBM争奪戦に参戦せず、まったく別のメモリで勝負する、という宣言である。
Business Deep Dive
1. D270を分解する——なぜLPDDR5Xなのか
インテルが公表したGPU D270(旧Crescent Island)の仕様は以下の通りだ。(インテル公式発表)
| 項目 | スペック |
|---|---|
| アーキテクチャ | Xe3P —— 32基のXe3Pコア、256基のXMX行列演算エンジン、32MB統合L2キャッシュ |
| 演算性能 | FP8で1.3 PFLOPS |
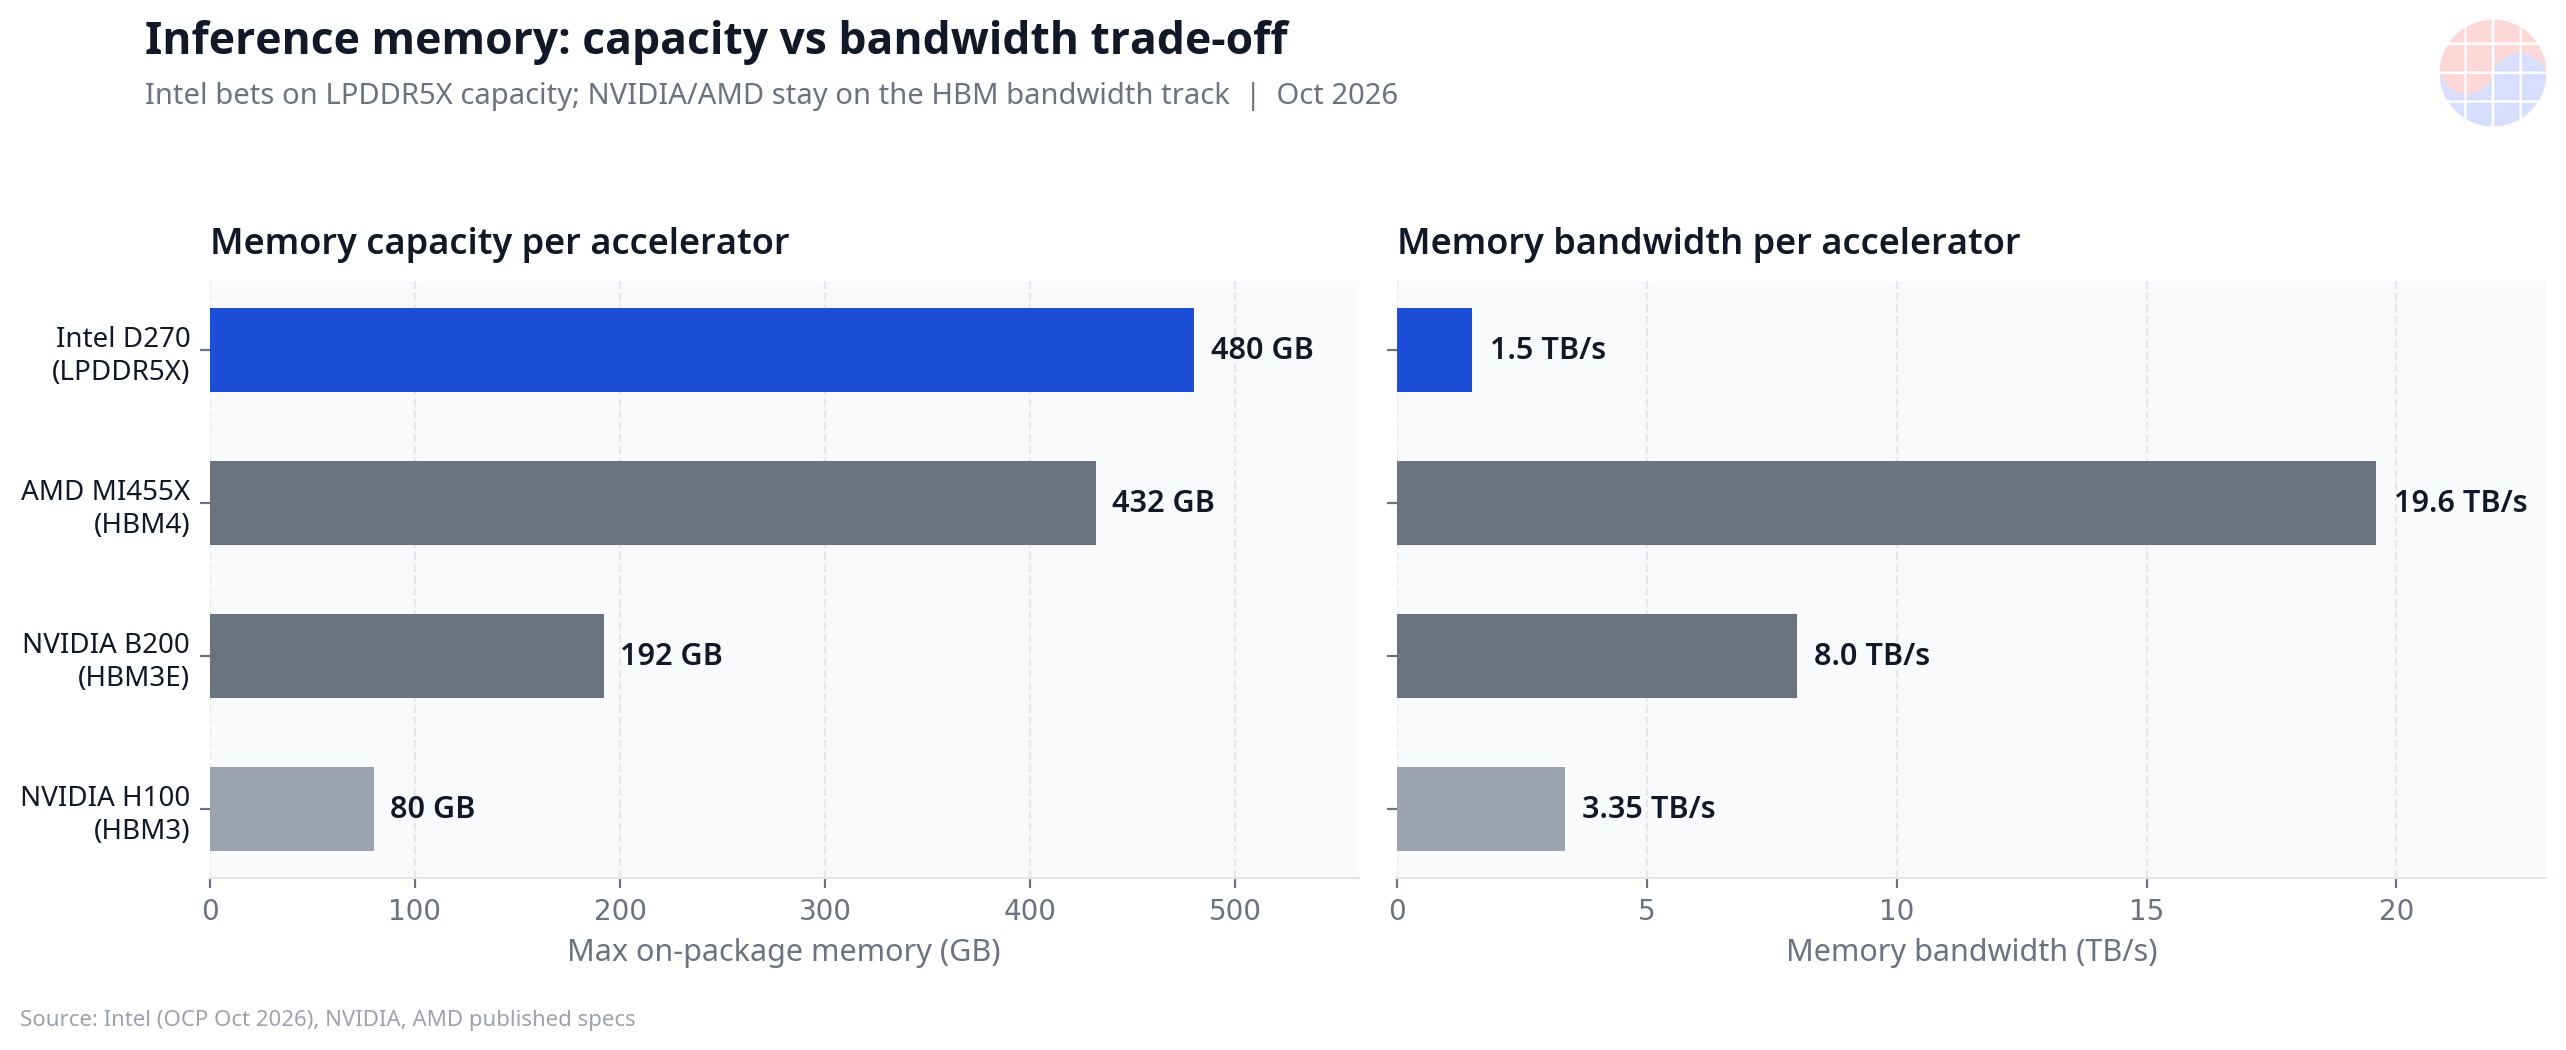
| メモリ | LPDDR5X —— インテル自社カード160GB / ODMパートナーカード最大480GB |
| メモリ帯域幅 | 1.5 TB/s |
| 電力・冷却 | 350W、空冷式 PCIe 5.0 x16 |
| 対応モデル | 1カードで3000億パラメータ、8基構成で1兆パラメータ超 |
最も雄弁な設計判断は、従来の3Dグラフィックスとレイトレーシングのハードウェアを削り去ったことだ。固定機能グラフィックスが占めていたダイ面積をAI演算に振り向けた。推論専用という宣言を、シリコンに刻んだ形である。
第二の判断がメモリだ。HBMではなくLPDDR5X。1.5 TB/sの帯域幅は、HBM3E級カード(8 TB/s)のおよそ5分の1。だが容量は圧倒的で、パートナーカードの480GBは現行世代のHBMフラグシップの約2.5倍に達する。
計算はシンプルだ。FP8ではパラメータ1個が約1バイト。3000億パラメータのモデル重みは約300GB——480GBカード1枚に十分収まる。残りの約180GBは、推論の隠れたメモリ消費源であるKVキャッシュとバッチ処理に使える。1兆パラメータのモデルを8枚に分割すれば1枚あたり約125GB。帯域幅の不足は、重みを一度ロードして何千・何万ものトークンを生成する推論の特性上、学習ほど致命的ではない。
第三の判断は電力とフォームファクタだ。350W空冷のPCIeカードは、既存のデータセンターインフラにそのまま差さる。1000W級の液冷アクセラレータと違い、特殊な電源・冷却設備を必要としない——TCO計算では見た目以上に大きな差になる。
ただし限界もはっきりしている。価格は未公表。供給開始も「2027年」という報道レベル。そして独立したベンチマークが一切存在しない——1.3 PFLOPSはあくまで理論ピーク値だ。(関連報道)
2. メモリ不足がアーキテクチャを書き換える
D270の賭けを理解するには、2026年10月時点のメモリ市場の立ち位置を見る必要がある。
- HBM4(現行世代):サムスン電子の2026年分はほぼ完売。SKハイニックスの2026年DRAM・NAND全量も完売。買いたくても買えない。
- HBM4E(次世代):2048ビットインターフェース、1ピンあたり14〜16 Gbps、1スタック最大3.6 TB/s。12段積層(384Gb / 48GB)のサンプルはサムスン(5月)とSKハイニックス(6月)から既に出荷。量産目標は2027年。まだJEDEC標準がなく、ベンダ定義の世代だ。(関連報道)
- サムスンの12段積層HBM4EはNVIDIAの認証試験を通過したとの報道があるが、両社とも公式には確認していない——報道段階の情報だ。(関連報道)
- マイクロンは2027年分のメモリ供給の75%をすでに販売済みと報じられている。(関連報道)
つまり、HBMロードマップに乗るということは2027年分の割り当てに並ぶということだ。そんな市場では「HBMなしで推論ファームを建てる」は単なるコスト削減ではなく、調達リスクの回避そのものになる。LPDDR5Xはスマートフォン・PC向けに大量生産されるコモディティDRAMだ。HBMのようなTSV・インターポーザのパッケージングボトルネックがなく、供給元は広く、1GBあたりの調達単価も安い。テスラも同じ結論に到達した。
3. テスラも同じ方向へ——AI5/AI6のメモリ仕様引き下げ
10月1日、イーロン・マスクはテスラAI5のメモリを当初計画の144GB(LPDDR5)から72GBへ半減し、AI6は144GB(LPDDR6)に3分の1削減すると発表した。理由は明快で、Optimus量産に必要な数量を確保するためだった。その後、AI5は96GBに再調整された。「メモリ帯域幅のほうが容量より大きな制約だ」とし、性能への影響は無視できる水準だとも付け加えた。(関連報道)
浮かび上がるパターンは明確だ。メモリ不足が設計仕様そのものを変えている。確保できるメモリに合わせて製品を再定義する——これが2026年後半のAIハードウェアの標準動作になりつつある。なおAI5はサムスン ファウンドリーのテイラー工場(テキサス州)で既に試作生産中だ。
4. 分岐するメモリ戦略——NVIDIA vs インテル
一方、メモリ確保に自信のある側は正反対の方向に進む。NVIDIAのロードマップはこうだ。
- Rubin(2026年):HBM4搭載
- Rubin Ultra(2027年):HBM4E搭載
- Feynman(2028年):カスタムHBM採用との報道——標準HBMではなく特注設計 (関連報道)
- NVHBM(2026年8月発表):NVIDIAのカスタムHBMベースダイ技術。メモリメーカーと共同設計・検証し、標準HBM4E比でスタックあたり帯域幅+30%、HBM電力−15%、PHY面積−67%をうたう。(関連報道)
AMDもHBM路線を維持する。MI455Xは432GB(3,456Gb)のHBM4を19.6 TB/sで搭載する。(関連報道)
整理すると、メモリ戦略は二つに分岐している。
| 戦略 | 代表プレイヤー | 方向性 |
|---|---|---|
| 帯域幅・電力の最適化 | NVIDIA(NVHBMカスタムHBM)、AMD(HBM4/HBM4E) | 高いメモリをさらに効率よく——フラグシップの学習・推論向け |
| 容量・コストの最適化 | インテル(480GB LPDDR5X)、テスラ(LPDDR5/6) | 安いメモリをより多く——推論ファームのTCO競争 |
どちらが「正しい」ではない。ワークロードが分かれているのだ。フロンティアモデルの学習とプレミアム推論は帯域幅集約型。大規模トークンサービス、オンデバイス、ロボティクス推論は容量とコストが鍵になる。
5. TCOを分解する——トークン単価を決める4つのレバー
推論インフラのTCOは、次の4つのレバーに分解できる。
① メモリ調達。 HBMは完売——プレミアムを払っても割り当てを争う。LPDDR5Xはコモディティ市場で、価格交渉力と供給安定性が違う。「確保できるか」がTCOの第一項になる時代だ。
② 電力・冷却。 350W空冷カードと1000W級液冷アクセラレータの差はチップ電力だけではない。ラックあたりの電力密度、液冷設備の投資、電気代がすべて連動する。インテルが「特殊なラック・冷却インフラなしで拡張できる」を前面に出す理由だ。
③ サーバーあたりの容量。 D270を8基搭載したシステムはメモリ合計3.84TBで1兆パラメータ超のモデルをカバーする。ノード数が減れば、ネットワーク、電力、運用の複雑さも下がる。容量がそのままノード密度になる。
④ 利用率。 推論サーバーはアイドルではなく、メモリバウンドの状態で回り続ける。帯域幅が低くても、KVキャッシュとバッチサイズを大きく取ればトークンスループットを引き出せる。テスラの「帯域幅のほうが容量より大きな制約」という発言と同じ理屈だ。
Chase's Take
学習時代の指標がFLOPSだったとすれば、推論時代の指標はトークンあたりのドルだ。インテルの賭けは、この命題をシリコンに翻訳したものだ。1.3 PFLOPSという数字はフラグシップと比べれば地味に見えるが、問いを「どちらが速いか」から「どちらがトークンを安く量産できるか」に変えれば、ゲームは変わる。
構造的なポイントを二つ。
第一に、HBM不足は一時的な需給のひずみではなく、アーキテクチャの選択を強制する構造変数になった。テスラが仕様を削り、インテルがLPDDRに回帰したのは、同じ圧力に対する異なる応答だ。メモリを握る側(HBM売上に占めるSKハイニックスのシェア約57%など)がバリューチェーンで価格決定力を持つ間、メモリを使う側は「確保できるメモリ」に合わせて設計を変える。今後2〜3年のAIハードウェアのニュースは、この緊張の上に読むべきだ。
第二に、韓国の利害は両側にまたがっている。HBMプレミアムの直接の受益者はサムスン電子とSKハイニックスだ。同時に、サムスン ファウンドリーはテスラAI5をテイラー工場で試作し、LPDDRサプライチェーンでは中国のCXMTの追い上げが激しい。メモリミックスがHBM一辺倒からLPDDR併用へ動けば、韓国メモリ2強の製品ポートフォリオとファウンドリーの顧客構成にも波及する。片側だけに賭ける分析は半分の絵だ。
反論も公正に記しておく。D270の帯域幅1.5 TB/sは低い。遅延に敏感なリアルタイム推論(TTFT)では不利になりうる。そして何より価格が未公表だ。TCOの優位性は価格表が出て初めて検証できる。理論値だけで「推論のコスパ勝利」を宣言するのは早計だ。
Implications
投資家向け: - 推論ワークロードの比率が上がるほど、メモリミックスはHBM一辺倒から離れる。LPDDR5XとサーバーDRAM需要の構造的な受益者を見直す時期だ。 - HBMプレミアムは2027年まで続く可能性が高い——2026年完売、2027年分の事前予約、HBM4Eのベンダ定義世代への移行期。メモリメーカーの価格決定力は当面維持される。 - 電力・冷却インフラ(空冷維持か液冷移行か)はデータセンター設備投資の新たな変数だ。350W級推論カードの普及は、液冷移行の速度を鈍らせる可能性がある。
経営者向け: - AIインフラ調達の基準は「最速のチップ」から「確保できるメモリ」に変わりつつある。2027年のキャパシティ計画はメモリ割り当てから逆算すべきだ。 - ベンダーロックイン回避の観点で、LPDDRベース推論オプションの成熟度を追跡する必要がある。NVIDIA代替の初の実戦テストケースになりうる。
FAQ
Q1. LPDDR5XはHBMより帯域幅がずっと低いのですが、推論に本当に大丈夫ですか? A. ワークロードによります。重みを絶えず入れ替える学習と違い、推論は重みを一度ロードして何千・何万ものトークンを生成します。ボトルネックは帯域幅より、KVキャッシュを収める容量とバッチサイズであることが多いのです。ただ、初回応答の遅延(TTFT)が重要なリアルタイムサービスでは帯域幅の不足が表に出ます。
Q2. 480GBで本当に3000億パラメータのモデルが1枚のカードで動くのですか? A. FP8ではパラメータ1個が約1バイトなので、3000億パラメータは約300GBです。480GBのカードに重みを載せても約180GBが残り、KVキャッシュとバッチ処理に使えます。インテルの主張と数学的に整合しています。ただし実際の動作は独立したベンチマークで検証されていません。
Q3. 価格はいくらですか? A. 未公表です。インテルは顧客サンプリングが進行中とのみ説明しています。価格が出るまで、HBMカードに対する真のTCO優位は計算できません。価格なきコスパ論争は半分の議論です。
Q4. HBM不足はいつ解消しますか? A. 2026年分はほぼ完売、2027年分も多くが予約済みです。HBM4Eの量産は2027年が目標ですが、ベンダ定義の世代であり立ち上がり速度が変数です。2027年を通じて逼迫が続く可能性を織り込むべきです。
Further Reading
- Chris Miller著『Chip War』——半導体覇権の地政学とサプライチェーンを描いた一冊。Amazonで見る
- Clayton Christensen著『The Innovator's Dilemma(イノベーションのジレンマ)』——低価格・低性能の新規参入者が市場をひっくり返す構造を説くMBAの古典。インテルのLPDDRの賭けを読むためのレンズ。Amazonで見る
このリンク経由の購入で手数料が発生する場合があります
免責事項:本記事の数値とスケジュールは2026年10月13日時点の公開情報に基づきます。インテルD270の性能数値はベンダー公表の理論値であり、独立したベンチマークによる検証はありません。投資判断の根拠として使用しないでください。
Tags: deep-dive, inference, memory-tco, lpddr5x, hbm, japanese