 VLSI Korea
Intel推論GPU深掘り: HBMではなくLPDDR5X 480GBを選んだ理由 — Crescent Island D270を全解剖
IntelはHBMを捨てLPDDR5Xを選んだ。自社カード160GB、ODM最大480GB — SNSで広がった480GBの真偽、推論で容量が帯域幅に勝る区間、そしてサムスン電子・SK hynix・Micronへの含意を全解剖する。


30秒サマリー
Intelは2026年10月12日、OCP Global Summitで推論専用GPUの正式製品名と最終仕様を公開した。コードネームCrescent Island、製品名はIntel GPU D-Series、初の製品はD270(報道ベース)である。核心はメモリだ。このカードはHBMを一切使わない。代わりにLPDDR5Xを20パッケージ並べ、1.5 TB/sの帯域幅を構成する。Intel自社カードの容量は160GBだが、ODMパートナーの構成では最大480GBまで拡張できる。SNSの分析投稿で広がった「LPDDR5X 480GB」という数字は事実だが、前提付きの数字である。Intelが自ら販売するカードは160GBだ。FP8演算は1.3 PFLOPS、電力は350W、空冷のPCIeカードである。単一カードで3,000億パラメータ級のモデルを、8枚構成で1兆パラメータ級のモデルを載せられるとIntelは説明する。顧客サンプリングは進行中で、価格と正式な発売日は未公表だ。本稿では発表ファクトの全体、「なぜLPDDRなのか」という技術・経済の論理、そしてサムスン電子、SK hynix、Micronへの含意を解剖する。
発表の概要: Intelが実際に発表したこと
Crescent Islandは突然現れた製品ではない。Intelは2025年10月のOCP Global Summitでこの推論GPUを初めて披露し、160GBのLPDDR5X構成を明らかにした。2026年8月のHot ChipsではXe3Pアーキテクチャの詳細を公開し、2026年10月12日にGPU D-Seriesという商用ブランドと最終仕様を確定した。同時に液冷OAMモジュールのプロトタイプ(モジュールあたりGPU 2基、5Uシャーシあたり8モジュール)も披露しており、空冷PCIeを本命としつつ高密度フォームファクタへの道も開けておく構えが読み取れる。
設計思想は当初から一貫している。学習用フラッグシップと正面から戦わない。NVIDIAのBlackwell UltraやAMDのMIシリーズといったHBM基盤アクセラレータが押さえる学習・超大規模サービング市場ではなく、すでに構築済みの企業データセンターにある標準x86サーバーに差して使う推論市場を狙う。IntelデータセンターグループのAI製品・GTM担当VPであるAnil Nanduri氏は当日、「推論はAIを定義するワークロードになりつつあり、企業は適切なコストで適切な性能を出すインフラを必要としている」と述べた。
| 項目 | Intel GPU D270 (Crescent Island) |
|---|---|
| アーキテクチャ | Xe3P (Xe3強化型) |
| Xeコア | 32基 (4スライス) |
| XMX行列エンジン | 256基 |
| FP8演算 (dense) | 1.3 PFLOPS |
| FP64ベクトル演算 | 10.2 TFLOPS |
| L2キャッシュ | 32MB (統合) |
| メモリ | LPDDR5X、20パッケージ、80チャネル、1,280-bit |
| メモリ速度 | 9,375 MT/s |
| メモリ帯域幅 | 1.5 TB/s |
| メモリ容量 | 160GB (Intel自社カード) / 最大480GB (ODM構成) |
| インターフェース | PCIe Gen5 x16 |
| 電力 | 350W |
| フォームファクタ・冷却 | ダブルワイドPCIe CEM、空冷 |
| 状態 | 顧客サンプリング中 (2026年10月時点)、価格・発売日は未公表 |
出典: Intelの2026年10月12日OCP Global Summit発表およびHot Chips 2026のアーキテクチャ公開資料。
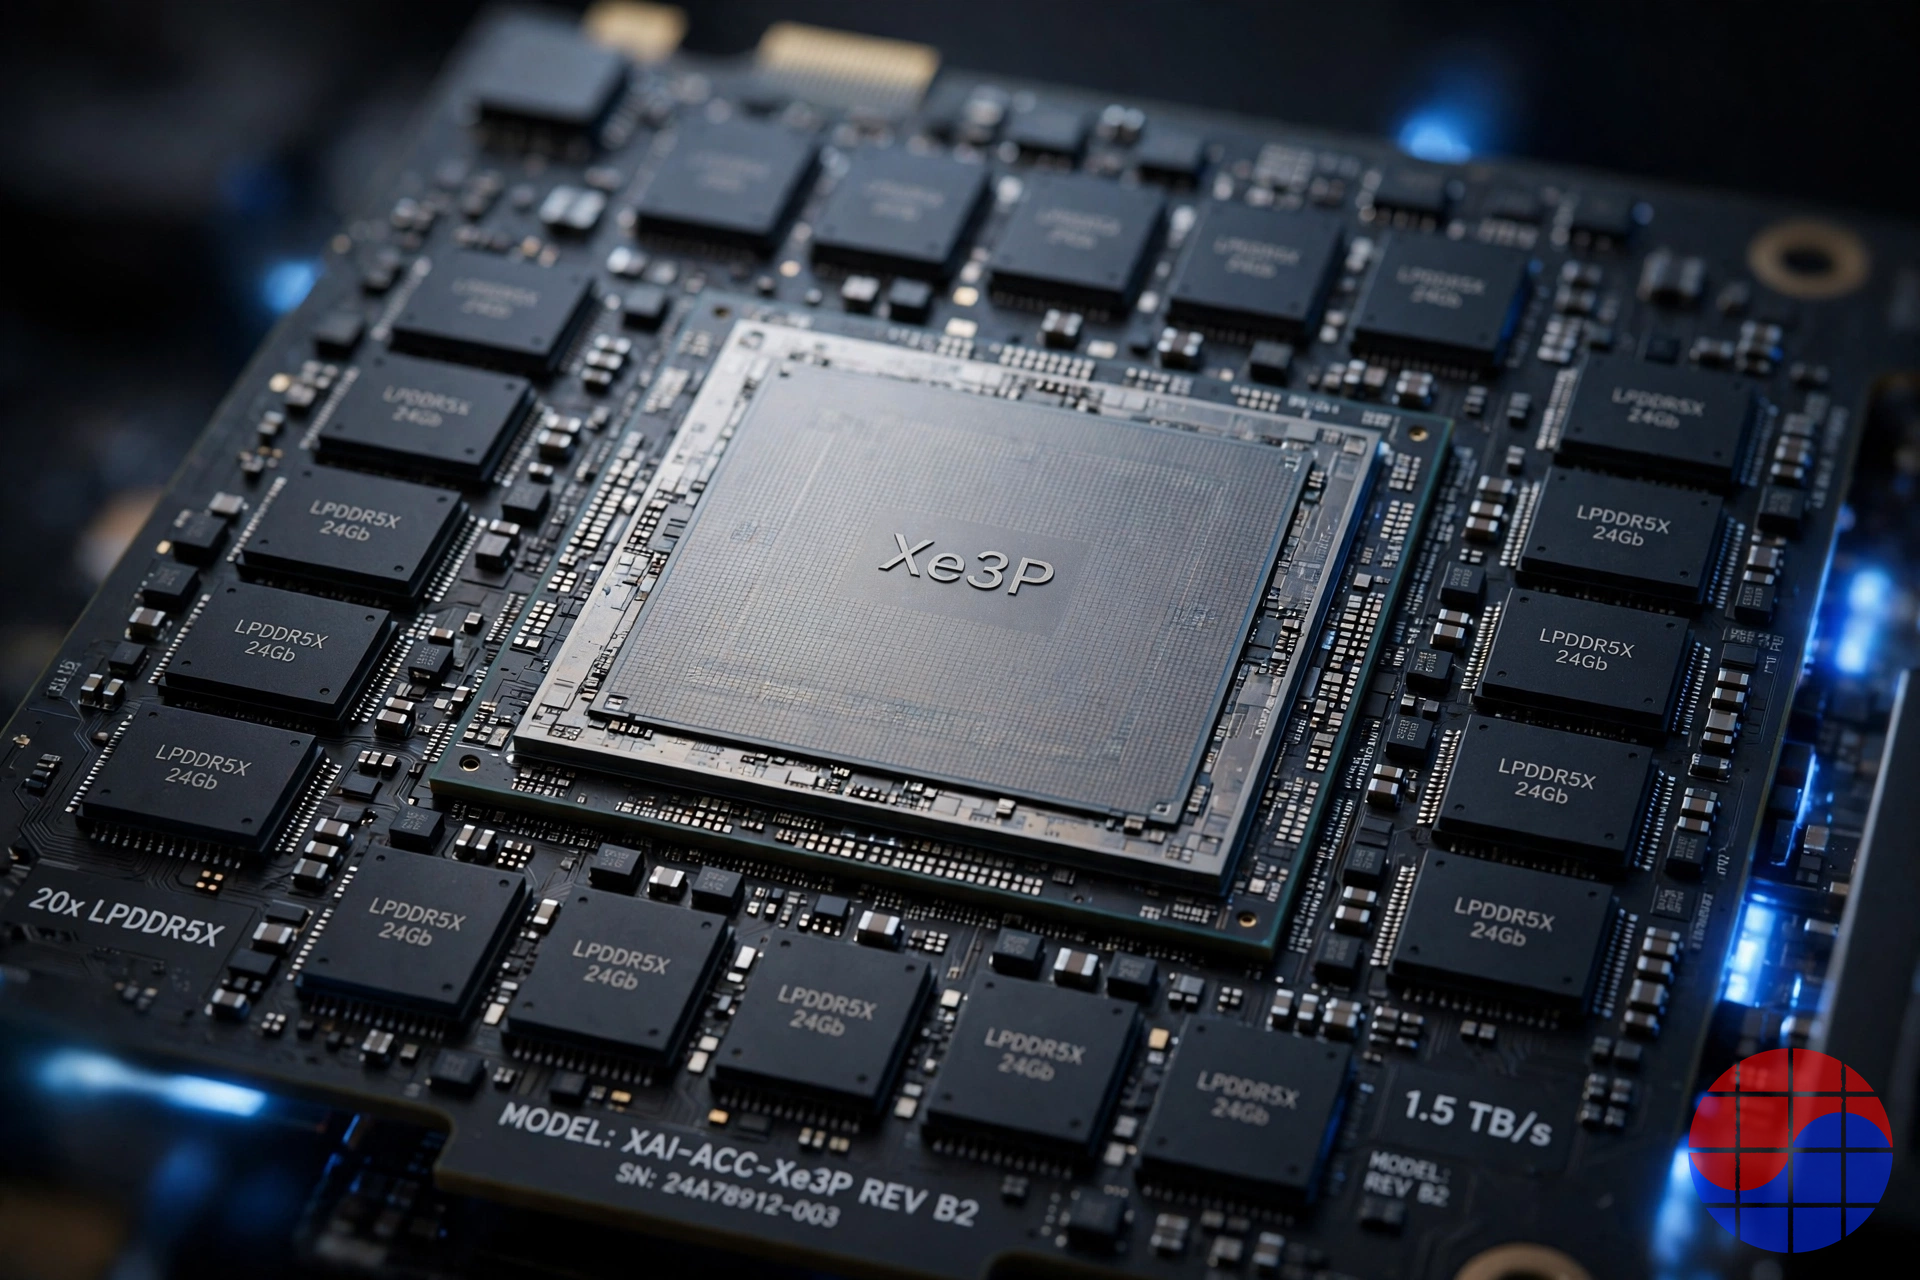
Xe3Pコア自体も推論専用に削り直されている。XMXのシストリックアレイはXe2の4段から16段へ深くなり、コアあたりの汎用レジスタファイルは1MBへ倍増、L1/共有ローカルメモリはコアあたり512KBに拡大した。逆に、ゲーミングGPUにあった3Dグラフィックスとレイトレーシングのブロックは丸ごと取り除かれた。ダイ面積のすべてを行列演算とFP4からFP64までの推論用データ型に振り向けた構造だ。ソフトウェアはOpenVINOとoneAPIを中心とするオープンなスタックを掲げる。
480GB検証: 事実だが、前提付きの数字
発表直後、「LPDDR5X 480GB」はSNSの分析記事で見出しの数字として独り歩きした。結論から言えば、この数字はIntelの発表に実際に登場する。ただしIntel自社カードの仕様ではなく、ODMパートナーが作り得る最大構成の仕様である。この区別を落として引用すると、読者はIntelが売るカードに480GBが載っていると誤解する。
| 構成 | パッケージあたり容量 | パッケージ数 | 総容量 | 販売者 |
|---|---|---|---|---|
| Intelリファレンスカード | 64Gb級パッケージ | 20個 | 160GB | Intel自社ブランドカード |
| ODM最大構成 | 192Gb級パッケージ | 20個 | 480GB | パートナー (ODM) 設計ボード |
メモリサブシステム自体は両構成で同じだ。16-bitチャネル80本を束ねた1,280-bitバスが9,375 MT/sで動作し、1.5 TB/sを生む。違いはパッケージ1個にDRAMダイを何枚積むかだけである。つまり480GBは「設計が許す上限」、160GBは「Intelが実際に出荷する構成」だ。どちらにせよ、PCIe推論カードとして発表された容量としては最大クラスに入る。比較すれば、NVIDIAのRubin GPUは288GB、AMDのMI450系は432GBのHBM4を搭載するとされる。容量だけ見れば、LPDDR構成がHBMフラッグシップを上回る逆転の構図になる。
モデル収容能力の計算にも同じ注意が要る。FP8(パラメータあたり1バイト)基準では、160GBカードには理論上1,600億パラメータまでの重みが入り、KVキャッシュとランタイムの余裕を差し引くと、Intelの言う「単一カードで3,000億パラメータ」は480GB構成を基準にした数値に近い。8枚構成の1兆パラメータも、480GB × 8 = 3.84TBの総容量を前提に読むべきだ。数字が嘘なのではない。ただし基準構成を常にセットで見る必要がある。
なぜLPDDR5Xか (1): 推論のボトルネックは演算ではなくメモリ
学習と推論ではメモリの使い方が違う。学習は巨大な行列積を繰り返すため、演算量(FLOPS)と帯域幅の両方が重要だ。一方、推論、とりわけトークンを1つずつ吐き出すデコード段階は、バッチサイズが小さいとき事実上メモリ帯域幅の勝負になる。トークン1個を作るたびにモデルの重み全体をメモリから1回ずつ読み直す必要があり、重みを読み終える時間がトークン間レイテンシを決めるからだ。
しかし実サービスの運用で壁になるのは帯域幅だけではない。同時接続が増え、コンテキストが長くなるほど、KVキャッシュがメモリを急速に食う。プロダクションサービングの実際の制約は「このモデルがこのカードに載るか、そして1枚で何人の同時リクエストとどれだけのコンテキストをさばけるか」に収れんする。容量が足りなければモデルを複数カードに分割しなければならず、カード間通信と遊休演算がコストとして上乗せされる。Intelの賭けはまさにこの点にある。絶対帯域幅ではHBMに大きく劣るが、容量を2〜3倍にし、カード価格と電力を大きく下げれば、トークンあたりコストで勝てる区間が存在するという計算だ。
数字で見た構図はこうだ。D270の帯域幅1.5 TB/sはHBM4スタック1個分(約2.8 TB/s以上)にも届かず、スタック12個を載せるフラッグシップアクセラレータの数十TB/sとは桁が違う。その代わりD270は350Wの空冷カードだ。HBMフラッグシップが1,000Wを超えて液冷ラックを強制するのに対し、D270は既存の企業サーバーの空きPCIeスロットにそのまま入る。Intelが売るのは最高性能ではなく、「すでにあるインフラで今日から回せる推論容量」である。
なぜLPDDR5Xか (2): GBあたり価格と調達可能性
第二の論理はお金と物量だ。HBM4のGBあたり価格は前世代HBM3Eの約2倍にあたるGBあたり31〜32ドル水準とされる(業界推定)。同じ時期、LPDDR5Xはスーパーサイクルで価格が急騰したにもかかわらず、12GBパッケージ基準でGBあたり約12ドル水準と、HBM4の半分以下で取引された。パッケージングでも差がつく。HBMはTSV積層とインターポーザ、先端パッケージング能力というボトルネックをそのまま引き継ぐが、LPDDR5XはスマートフォンとPCが毎年数億台規模で消費する汎用DRAMであり、供給者のプールも広く、パッケージングも標準工程だ。
調達リスクは2026年の現実である。サムスン電子とSK hynixの2026年HBM物量は事実上完売し、Micronも2027年供給量のかなりの部分をすでに契約で押さえたという報道が続く。今HBMのロードマップに並べば、2027年の割り当てを待つことになる。対してLPDDR5Xは今すぐ買えるメモリだ。HBM割り当て競争で優先順位の低い後発組にとって、「HBMなしの推論カード」は原価削減であると同時に調達リスクの回避戦略でもある。実際、この結論に至ったのはIntelだけではない。Metaの自社推論チップMTIA系もLPDDR級メモリを採用してきたし、Teslaの推論チップも同じ系譜の選択をした。
メモリ3種比較: HBM4 vs LPDDR5X vs GDDR7
| 項目 | HBM4 | LPDDR5X | GDDR7 |
|---|---|---|---|
| スタック/チップあたり帯域幅 | スタックあたり2.8 TB/s以上 | パッケージあたり約77 GB/s (カード合計1.5 TB/s) | チップあたり最大約144 GB/s |
| アクセラレータあたり総帯域幅 | 数十TB/s (12スタック基準) | 1.5 TB/s (D270) | 約1.8 TB/s (512-bit構成) |
| アクセラレータあたり容量 | 288〜432GB | 160〜480GB | 32〜96GB |
| GBあたりコスト | 約31〜32ドル (業界推定) | 約12ドル前後 (2026年急騰相場基準) | HBM比で大幅に安い (グラフィックス用汎用品) |
| 電力特性 | スタック・インターポーザ込みで高電力 | ビットあたり電力は最低水準 (モバイル設計) | LPDDRより高いビットあたり電力 |
| パッケージング | TSV積層 + インターポーザ必須 | 標準パッケージ、ボード直接実装 | ボード直接実装 |
| 供給状況 | 2026年物量は完売、割り当て競争 | 汎用DRAM、供給者プールが広い | グラフィックス需要と競合 |
| 主な採用先 | NVIDIA Rubin、AMD MI450系、TPU・Trainium等の学習/サービング旗艦 | Intel GPU D-Series、NVIDIA Grace・Vera (CPUメモリ)、Meta MTIA | GeForce RTX 50シリーズ等のグラフィックスカード |
注: GBあたりコストは時期と契約条件で大きく変動する推定値であり、方向性(LPDDR5XがHBM4の半分以下)を示すためのもの。帯域幅は各社の仕様公開資料に基づく。
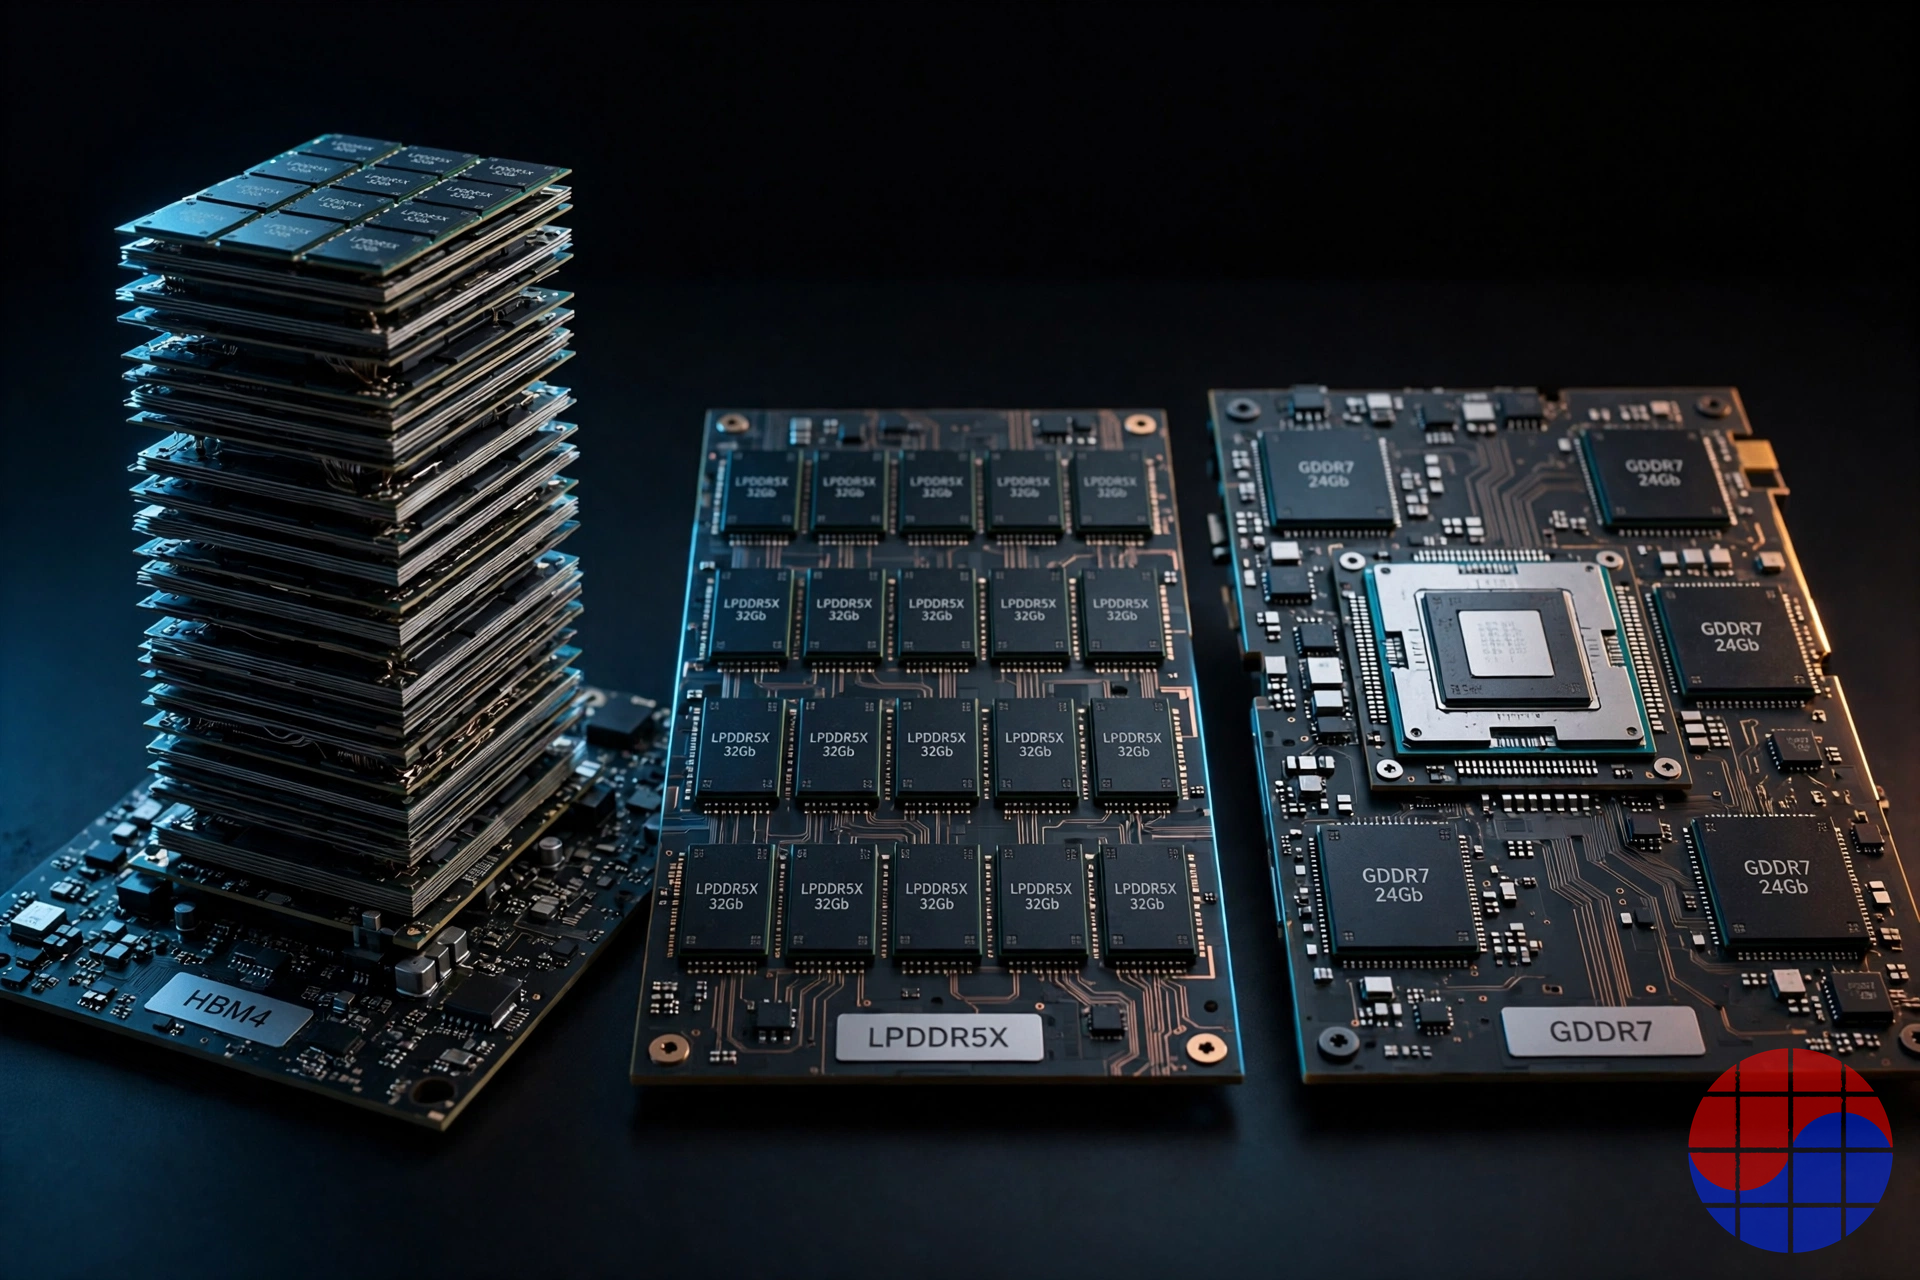
この表が示すのは「どのメモリが優れているか」ではなく、「どの制約を金で買うか」の違いだ。HBM4は帯域幅を買う代わりに容量単価と調達リスクを引き受ける。GDDR7は単価が安く帯域幅も悪くないが、チップあたり容量が小さく、数百GB級のモデルを1枚に載せにくい。LPDDR5Xは帯域幅を諦める代わりに容量単価と調達、電力で勝つ。推論市場の需要が「最速のトークン」から「最安のトークン」へ移るほど、この表の重心はLPDDR側に傾く。
供給者への含意: サムスン電子・SK hynix・Micron、そしてSOCAMM
メモリ大手3社にとってこの流れが意味するのは単純だ。AIデータセンターのDRAM需要はHBM一本に収れんしない。CPU側ではすでに大きな物量がLPDDRに流れている。NVIDIA GraceはCPUあたり最大480GBのLPDDR5Xを載せ、後継のVeraはSOCAMM2モジュールで最大1.5TB、帯域幅1.2 TB/sまで引き上げた。Vera Rubin NVL72ラック1台にはVera CPUが36基入るため、ラックあたりCPUメモリだけで最大54TB規模になる。ここにIntel D270のようなLPDDRアクセラレータが加われば、データセンターLPDDRは「CPU脇の補助メモリ」から独立した需要軸へ育つ。
注目すべきはモジュール化だ。LPDDRは本来ボードにはんだ付けするモバイル部品だが、NVIDIAがSOCAMMというモジュール規格でサーバー用に交換・増設可能にしたことで、サーバー部品として再定義された。サムスン電子、SK hynix、MicronはいずれもSOCAMM供給に加わっており、NVIDIAはVera向けLPDDR供給網に台湾のNanyaまで引き入れたと報じられた。供給者の多様化は、それ自体が物量の大きさの証拠である。
韓国企業から見て、この需要は両刃の剣だ。一方では、HBMへの能力転換で痩せていく汎用DRAM市場に、AI発の新規需要が生まれる。LPDDR5X価格が2026年に入って四半期ごとに数十%跳ねる背景にもサーバー需要がある。他方で、LPDDRはどこまでも汎用DRAMであり、HBMのような超過マージンは期待しにくく、中国CXMTのような後発組との価格競争にさらされる。それでも物量の方向は明らかだ。2027年以降、AIインフラにおけるLPDDRのビット需要は、CPUソケットと推論アクセラレータの両方から構造的に増える。
競争構図: NVIDIAもCPUにはLPDDRを使う
Intelの選択を「HBMを確保できなかった会社の次善策」とだけ読むと半分しか見ていない。HBMの最大の買い手であるNVIDIAでさえ、メモリを二元化している。GPUにはHBM4を、CPUにはLPDDR5Xを使う。ワークロードの性格に応じて、帯域幅が要る場所と容量が要る場所を分けた設計だ。GraceからVeraへの移行でCPUメモリ容量は480GBから1.5TBへ3倍になり、帯域幅も512 GB/sから1.2 TB/sへ跳ねた。NVIDIAの見立てでは、エージェント型AI時代のCPUはより多くのメモリを背負うべき存在なのだ。
AMDは反対側に立つ。MIシリーズはGPUにHBMを載せる正統路線を維持し、推論でもHBMの帯域幅で勝負する。カスタムASIC陣営も割れる。Google TPUとAWS TrainiumはHBMを、Meta MTIAはLPDDR級を選んだ。結局、業界の合意は「学習とフロンティアサービングはHBM、その下の大規模推論とCPUメモリではLPDDRが育つ」という二層構造に収れんしつつある。Intel D270は、その下層をGPUフォームファクタで攻める初の本格的な試みだ。
Chase's Take
この製品の本質はGPUではなく、メモリ調達戦略である。Intelは演算性能では勝てない戦いを避け、2026〜2027年に実際に調達可能なメモリで作れる最大の推論容量を持ち出した。1.3 PFLOPSという数字は平凡だが、350Wの空冷カードに480GBという組み合わせは、競合製品の一覧にない座標だ。
韓国のメモリ業界には静かな追い風である。HBMの華やかな単価の陰で、サーバーLPDDRという第二のAI需要軸が実際の物量として固まりつつあるからだ。Veraのソケットあたり1.5TBとD270のカードあたり最大480GBが同時に出荷され始めれば、LPDDR5Xはスマートフォン部品ではなくAIインフラ部品として価格表が書き換わる。ただし、LPDDRの単価上昇はIntelのTCO論理を自ら蝕む変数でもある。LPDDRが高くなるほど、「安いメモリで作る安い推論」という方程式のマージンは薄くなる。この製品の成否はシリコンよりもメモリ価格の曲線が決めるだろう。
推論メモリのコスト構造をHBM陣営の数字とあわせて分析した記事もあわせてどうぞ: No HBM Needed? Intel's 480GB LPDDR5X Bet and the Inference Memory TCO War
リスクと未確認事項
第一に、性能数値の性格だ。1.3 PFLOPSは理論最大値であり、独立ベンチマークはまだない。実際のトークン処理量はカーネル最適化とソフトウェアスタックの完成度に大きく左右される。第二に、ソフトウェア生態系だ。CUDAの慣性は推論市場でも強く、OpenVINO・oneAPI基盤のスタックがプロダクションのサービングフレームワークとどれだけ滑らかに接続できるかが採用の関門になる。Intelの前作Gaudiが技術よりも生態系で敗れた前例は無視できない。第三に、帯域幅の天井だ。1.5 TB/sは大型モデルの高バッチデコードでボトルネックになり得るし、Intel自身も学習とフロンティアサービングは競争領域ではないと線を引いている。第四に、商用条件が空欄だ。価格と正式発売日は未公表で、大量出荷は2027年とされる。その間にHBM4Eが登場し、LPDDR価格がさらに上がれば、発売時点の競争構図は今と変わり得る。最後に、市場の初動も冷静だった — 発表当日のIntel株価は下落して引けたと報じられている。
FAQ
Q: Intel GPU D270のLPDDR5X 480GBは確定仕様か? A: 最大構成としては事実だが、Intel自社カードの容量は160GBだ。480GBはODMパートナーが高密度パッケージ(192Gb級)を実装したボードで可能な上限である。SNSの「480GB」引用は、この前提が落ちている場合が多い。
Q: なぜ推論GPUにHBMではなくLPDDR5Xを使うのか? A: プロダクション推論の制約は演算量よりも、モデルとKVキャッシュを収める容量とトークンあたりコストだからだ。LPDDR5XはGBあたり価格がHBM4の半分以下とされ、調達も容易で、電力も低い。ピーク帯域幅を捨てる代わりに容量とコストで勝つ区間を狙った設計である。
Q: D270の帯域幅1.5 TB/sはどの水準か? A: HBM4スタック1個(2.8 TB/s以上)にも届かず、フラッグシップアクセラレータの数十TB/sとは桁が違う。一方でGDDR7の512-bit構成(約1.8 TB/s)とは近い帯域にある。絶対性能ではなく、ワットあたり・ドルあたり容量で勝負する数値だ。
Q: サムスン電子とSK hynixにとっての意味は? A: AIデータセンターのLPDDR需要がサーバーCPU(NVIDIA Grace・VeraのSOCAMM)から推論アクセラレータへ広がるという信号だ。HBMほどのマージンではないが構造的な物量成長が見込まれ、両社ともSOCAMM供給網に入っている。
Q: D270はいつ、いくらで買えるのか? A: 2026年10月現在は顧客サンプリング中で、Intelは価格と正式な発売日を公表していない。大量出荷の時期は2027年とされる。
📩 VLSI Korea ニュースレター
毎日配信の半導体ディープダイブを、メールでいち早くお届けします。購読は無料です。


