 VLSI Korea
AIファクトリー構築が6カ月から14日へ ― Vera Rubin本格生産とDSX PODの速度経済学(HBM4)
Vera Rubinが本格生産に入り、DSX PODは準備済みサイトでの現場構築を約6カ月から最短14日へ短縮する。コンテナ1台にNVL72ラック7台、GPU 504基。速度がそのまま売上になる時代を分析する。


AIインフラのボトルネックは、もはやチップではない。建設現場である。そしてNVIDIAは、その工場を工場の中へ移した。
30秒サマリー
- Vera Rubinが本格生産に入った。 2026年10月21日、GTCベルリンでJensen Huang CEOは、NVIDIAの次世代AIプラットフォームが本格生産(full production)に入ったと発表した。
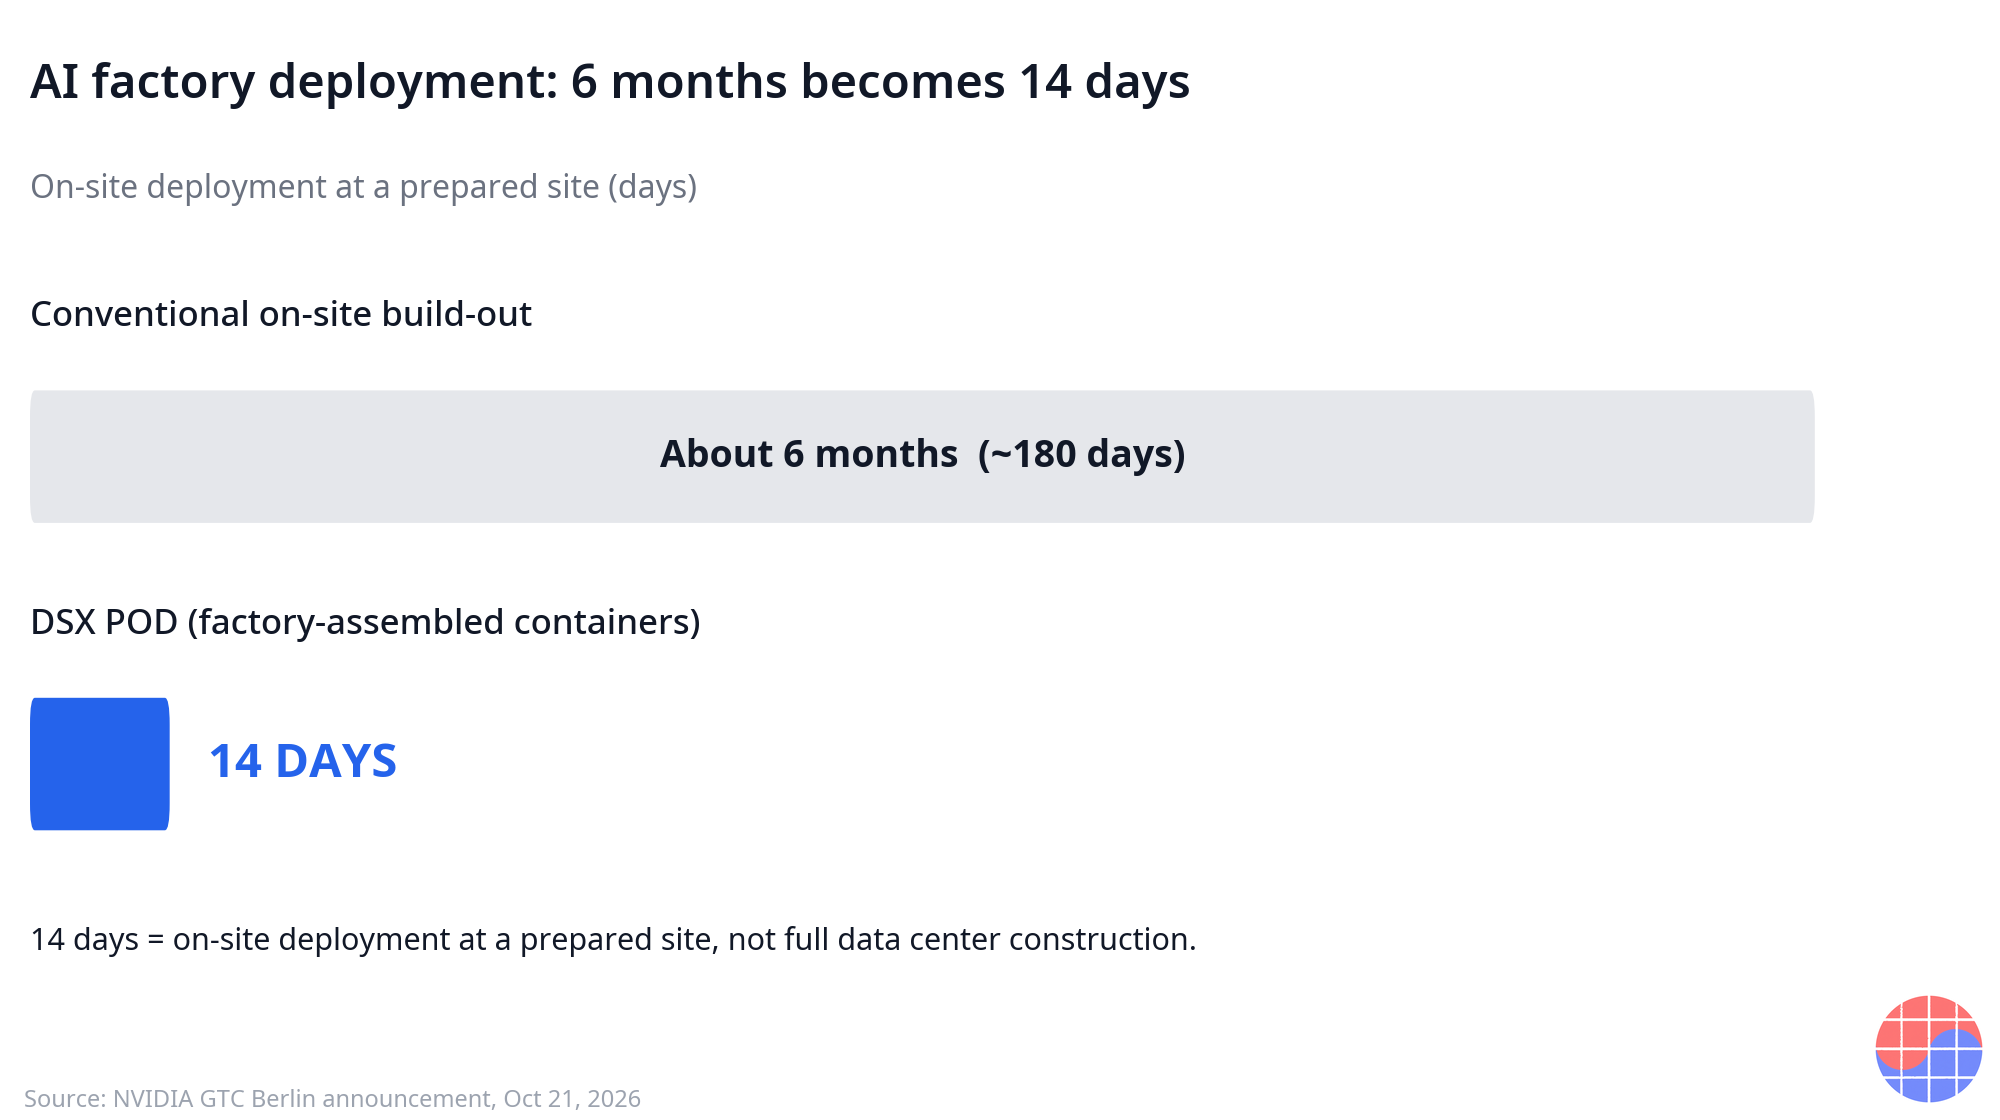
- DSX PODはAIファクトリー全体を出荷製品に変える。 Vera Rubin AIファクトリー全体をモジュール型コンテナとして工場で組み立て、検証してから出荷するリファレンスデザインである。準備の整ったサイトにおける現場構築は、約6カ月から最短14日へ短縮される。
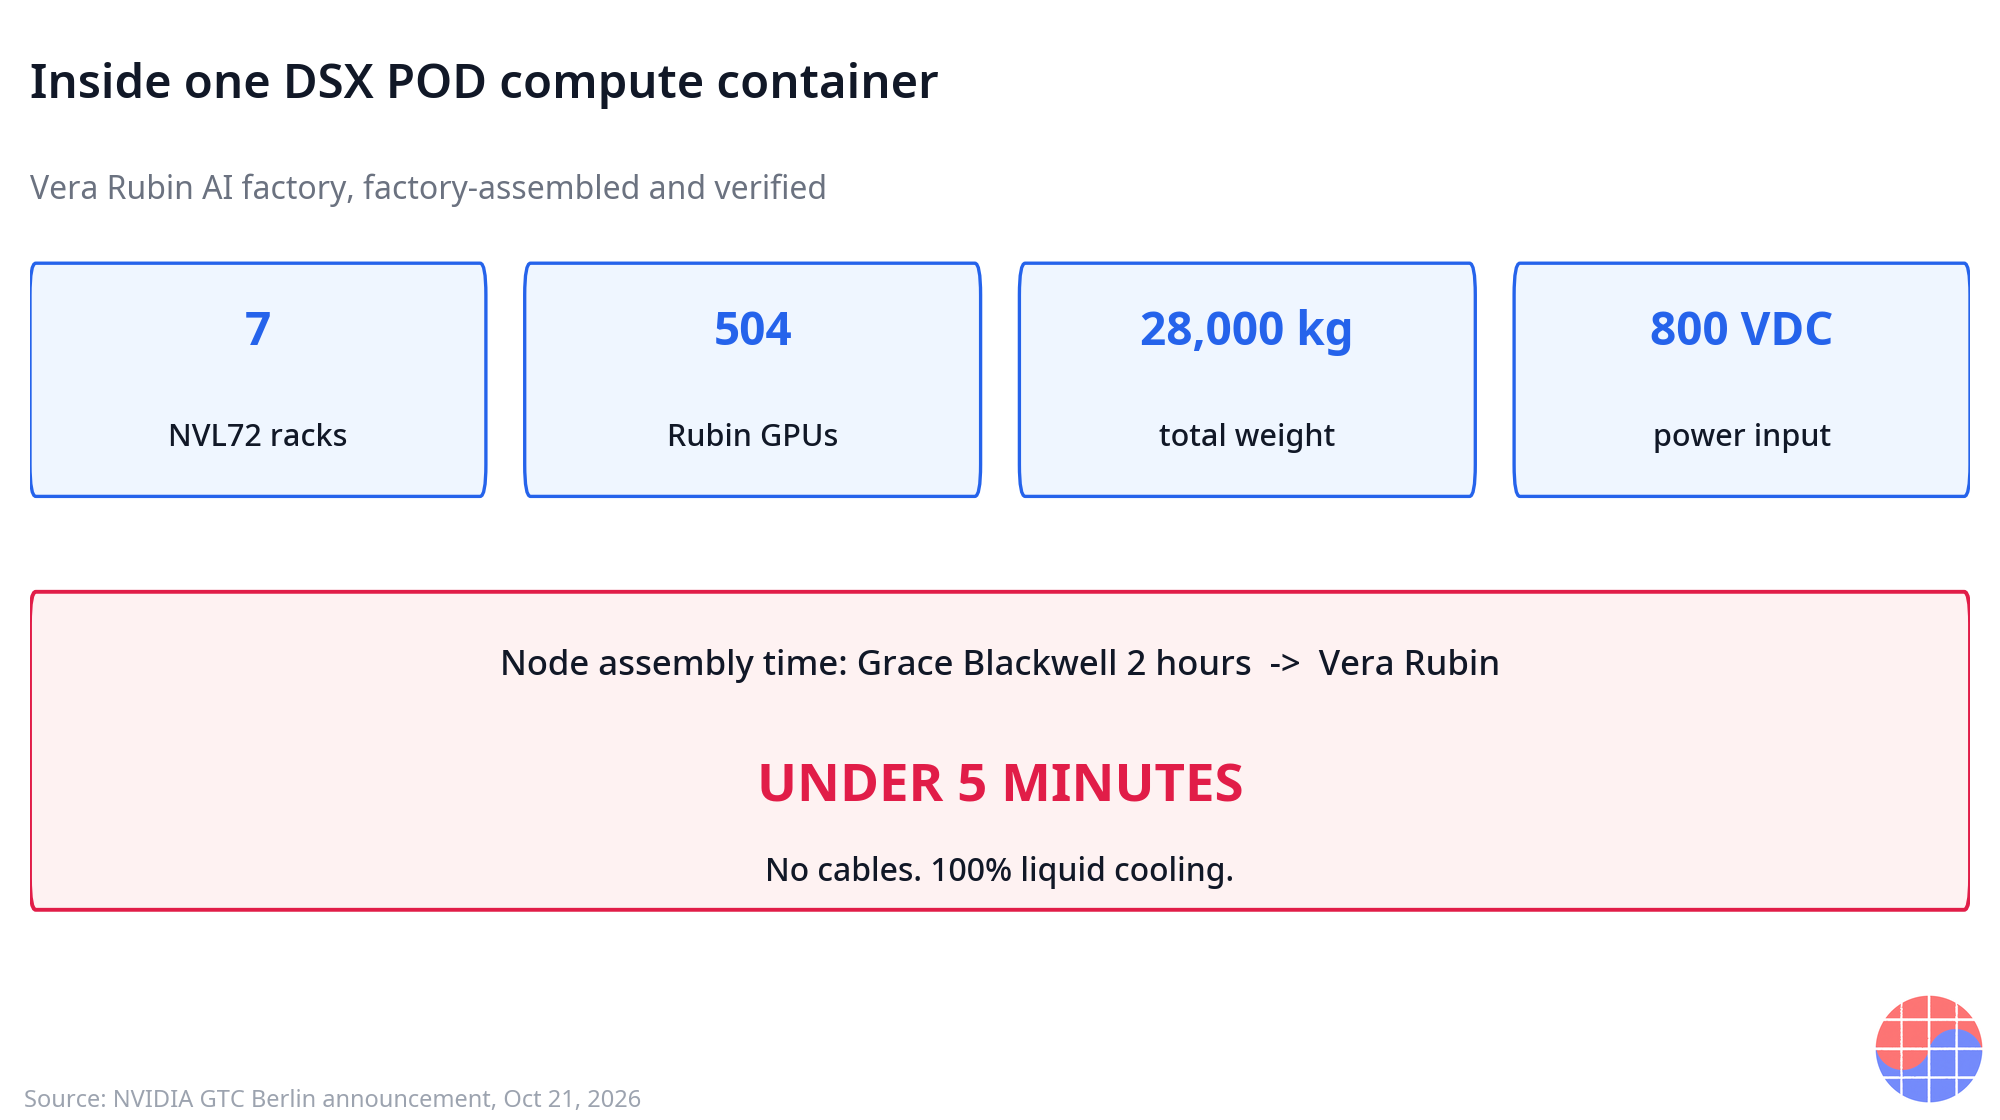
- コンピュートコンテナ1台が、データセンターの一つのブロックである。 Vera Rubin NVL72ラック7台、Rubin GPU 504基、重量は約28,000kg、電源入力は800 VDCである。
- ノード自体が組み立て速度のために再設計された。 Vera Rubinノードはケーブルがなく、100%液冷であり、ノード組み立て時間はGrace Blackwellの2時間から5分未満へ短縮された。
- パートナーは17社である。 Dell、HPE、Lenovo、Schneider Electric、Vertiv、Eaton、Foxconn(Ingrasys)などが参加し、出荷は2027年初頭に始まる予定である。ただし14日とは、電力と冷却などの基盤が準備されたサイトでの現場構築期間であり、データセンター全体の建設期間ではない点を明確にしておく必要がある。
背景
待機列はファブから現場へ移った
過去3年間、AIインフラの物語はチップ供給の物語だった。GPUが不足し、HBMが不足し、先端パッケージが不足し、ウェハーとメモリを確保した側が売上を確保した。その不足が消えたわけではない。ただし、その後ろに第二の待機列が生まれた。納入されたハードウェアを、実際に稼働するAIファクトリーへ変える物理的な作業である。ラックが到着した後も、電力分配と冷却ループ、ネットワーキング、ノード単位の組み立て、テストとデバッグまで、数カ月にわたる現場統合が続き、その相当部分は建物自体がまだ完成していない現場で、貴重な現場エンジニアの手に委ねられている。
2026年10月21日のGTCベルリンにおけるNVIDIAの発表は、この第二の待機列を正面から狙う。プラットフォームの見出しは、Grace Blackwellの後継アーキテクチャであるVera Rubinが、Jensen Huang CEOの言葉どおり本格生産に入ったことである。ビジネスの見出しはDSX PODである。Vera Rubin AIファクトリー全体をモジュール型コンテナとして工場で組み立て、検証してから出荷するリファレンスデザインであり、サイトは部品の山ではなく、テストを終えたシステムを受け取る。
DSX PODとは何か
DSX PODを理解する鍵は、統合が起きる場所の変化である。従来モデルでは、統合は目的地、すなわち建設現場の条件とばらつきの下で起きる。PODモデルでは、統合は出発地、すなわち工場の条件の下で起きる。同じ作業が繰り返され、測定され、改善される環境である。コンテナが納入単位であり、コンピュートコンテナにはラックが入り、デザインは出荷前にコンテナの中身が重量と電圧まで分かるほど細かく規定されている。
| DSX PODコンピュートコンテナ | 仕様 |
|---|---|
| コンテナ当たりラック | Vera Rubin NVL72ラック 7台 |
| コンテナ当たりGPU | Rubin GPU 504基 |
| 重量 | 約28,000kg |
| 電源入力 | 800 VDC |
| ノード設計 | ケーブルなし、100%液冷 |
| ノード組み立て時間 | 5分未満(Grace Blackwellは2時間) |
出典:2026年10月21日、GTCベルリンにおけるNVIDIAの発表。リンクは脚注参照。
ノード組み立て時間という数字は、立ち止まって見る価値がある。組み立てを2時間から5分未満へ縮めたのは、便利機能ではない。プラットフォームを構築工程から逆向きに設計した結果である。組み立て時間と現場エラーの大きな割合を占めていたケーブリングがノードから完全に取り除かれ、冷却は全面的に液冷へ移った。組み立てに数分で済むノードは交換にも数分で済み、設置された機器全体の保守経済性を10年単位で変える。
14日という数字を正確に読む
今回の発表で最も多く引用される数字、すなわち従来の現場構築の約6カ月に対して最短14日という構築期間には条件が付いており、その条件こそがビジネスモデルの座る場所である。14日とは、電力と冷却、建物の基盤がすでに整ったサイトにおける現場構築期間である。 データセンター全体の建設期間ではない。用地と許認可、電力網への接続、建物の外枠は、依然として掛かるだけ掛かる。
この区別が発表の重みを減らすことはない。むしろ、価値が誰のところへ行くのかを明確にする。PODが圧縮する区間は、基盤の準備完了とAIファクトリーがトークンを生み始める時点の間の区間、つまり顧客の資本が収益を生み始める時点を決める区間である。準備の整ったサイトより手前のすべては依然として建設とユーティリティの問題であり、だからこそパートナー名簿がコンテナと同じくらい重要になる。
ビジネス深掘り
速度はそのまま売上計上である
AIインフラにおいて、構築速度は運用上の配慮ではない。売上曲線の傾きである。数カ月早く容量を稼働させるハイパースケーラーやAIファクトリー運営者は、トークンと学習実行、クラウドインスタンスの販売を数カ月早く始め、そのハードウェアの競争的な半減期は四半期単位で測られる。フロンティアのプラットフォーム世代の寿命がおおよそ1年なら、6カ月の統合の尾は、資産が本格的に収益を生む前に、その経済寿命の半分を食い潰しかねない。
DSX PODを読むレンズがこれである。準備の整ったサイトにおける構築を約6カ月から最短14日へ縮めれば、サイトごとに売上が数カ月前倒しされ、その時点はAIコンピューティング需要が行列を作っているまさにその瞬間である。顧客が買うのはコンテナではない。カレンダーの時間である。チップは特急料金を払えば前倒しできても、カレンダーは前倒しできないという点で、時間はAI構築全体で最も希少な投入要素である。
| 構築モデル | 準備済みサイトでの現場構築 | 時間の行方 |
|---|---|---|
| 従来の現場構築 | 約6カ月(約180日) | 現場でのラック統合、ケーブリング、冷却接続、ノード組み立て、段階的テスト |
| DSX POD | 最短14日 | 事前組み立てと事前検証を終えたコンテナの配置と最終試運転 |
出典:2026年10月21日、GTCベルリンにおけるNVIDIAの発表。リンクは脚注参照。
NVIDIAのスタックがもう一段上がる
戦略のパターンは今やおなじみだが、PODはそれを拡張する。NVIDIAはチップからボードへ、ボードからラック(NVL72)へ、ラックからネットワークシステムへと上がり、今度はDSX PODリファレンスデザインによって、システムからファクトリー自体へ上がった。一段上がるごとに、NVIDIAとそのエコシステムがAI容量1GWに付けられる売上が大きくなり、顧客のリファレンスデザインへの依存は深まる。
リファレンスデザインは独特な形の力である。コンテナ層を支配するために、NVIDIAが自らコンテナを製造する必要はない。業界に自社の仕様に合わせて作らせればよく、その仕様が全員が合わせなければならないインターフェースになる。立ち上げパートナー17社、すなわちシステムのDellとHPE、Lenovo、電力と冷却基盤のSchneider ElectricとVertiv、Eaton、そしてFoxconn(Ingrasys)とDelta、GIGABYTE、Pegatron、QCT、WistronなどODMと部品基盤の全体にわたる企業は、単なる供給者ではない。標準の流通網である。出荷は2027年初頭に始まる予定である。
工場での事前統合はボトルネックを移すだけで、消しはしない
事前統合は建設問題に製造戦略を適用したものであり、その経済性は製造の論理に従う。工場組み立ては、ばらつきの大きい現場労働を繰り返し可能なライン作業に変える。品質はテスト設備のある場所で確認され、エラーはノードを設計したエンジニアが座る場所で発見され、学習曲線はサイトごとに初期化されず、作られるコンテナごとに蓄積される。ケーブルがなく、全面的に液冷で、5分未満で組み立てられるノードの再設計は、プラットフォームがそのラインに合わせて形作られた結果である。
しかしボトルネックは消えずに移動する。準備の整ったサイトでコンテナを14日で構築できるようになれば、準備の整ったサイト自体が制約になる。電力網への接続と電力設備のリードタイム、冷却基盤、許認可である。パートナー名簿にSchneider ElectricとVertiv、Eatonがいるのは、まさにその事実の承認であり、次の待機列が電気の領域にあるという意味である。だからこそ、この発表を正直に読むには、14日という数字にその条件を一緒に付けなければならない。次の段階の勝者には、コンテナを満たせる速さに合わせて準備済みサイトを納入できる側が含まれる。
ソフトウェア層:DSX MaxLPSと効率の主張
NVIDIAはDSX MaxLPSソフトウェアも発表した。同社の説明では、同じAI出力を最大30%少ない電力で生み出す。拘束条件がラックからメガワットへ移る産業において、その規模のソフトウェア効率の主張は戦略的な重みを持つ。ワット当たり出力が上がれば、同じ電力網接続で売れるコンピューティングが増え、準備済みサイトの実質容量は新規建設なしに大きくなる。この数値はNVIDIAが公表した発表値であり、市場が実際の構築で検証する部分だが、方向自体も重要である。電力効率は構築速度と複利で重なるからだ。より速く設置でき、設置されたメガワット当たりの出力はより大きくなる。
エコシステムの信号はクラウド層まで続いた。Vera Rubinを基盤とするGoogle Cloud A5Xは、11月に一般提供が始まる予定である。フロンティアのプラットフォームは今や、買う製品、構築するコンテナ、借りるクラウドインスタンスという三つの経路で同時に登場し、その三経路の背後には一つのサプライチェーンと一つの配分待機列がある。
HBM4との接続
出荷されるVera Rubinラックは、すべてHBM4の出荷でもある。このプラットフォームのメモリはHBM4であるため、Vera Rubinの量産ランプと2027年初頭のPOD出荷は、プラットフォームに認定されたメモリメーカーのHBM4物量に直結する。ベルリンでの構築速度の発表と、メモリ産業の受注台帳を結ぶ静かな輪がこれである。構築速度はラックが稼働するシステムへ変わる速さを決め、稼働するシステムが次のGPUとHBMの注文を引き出す。より速い構築モデルは、NVIDIAの売上を前倒しするだけではない。ファクトリーを養うパッケージとHBM、基板、電力設備のチェーン全体の拍子を引き締める。
Chaseの見立て
DSX PODに対する怠惰な読み方は「NVIDIAがより速いデータセンターを発明した」である。正しい読み方は、AI構築の中でまだ数カ月の緩みが残っていた区間はどこだったのか、そして誰がそれを取りに行ったのかについてである。
チップは3年間ずっと見出しを占めてきたが、それはチップが制約だったからである。しかし納入されたラックが現場統合に数カ月を使えば、それは容量ではなく在庫であり、業界はその両方を膨大に抱えてきた。PODはその在庫ポジションを攻撃する。工場検証、5分未満で組み立てられるケーブルのないノード、重量まで規定されたコンテナ、そのすべての要素が、ハードウェアの納入とハードウェアの収益化の間の溝を狙っている。NVIDIAは構築カレンダーを見渡し、自ら所有できそうな最大の死に時間の塊を見つけ、製品にした。
過小評価されている帰結が二つある。第一に、リファレンスデザインは支配権を再配分せずに利益を再配分する。パートナー17社は、2027年初頭から出荷されるコンテナ型AIファクトリーという実際の市場を得るが、それはNVIDIAが所有する仕様の中で得るものであり、エコシステムの成長とNVIDIAプラットフォームへの囲い込みは、同じ出来事の両面である。第二に、今回の発表は「準備が整っていること」という資産の意味を静かに再定義する。構築に6カ月掛かるなら、準備済みサイトとそうでないサイトの差は建設の一段階である。構築が14日なら、その差は日程のほぼ全体になり、サイトと電力ポジション、許認可は以前とは異なる形で取引可能な戦略資産になる。
開かれた問いは実行の拍子である。リファレンスデザインは、コンテナが物量として出荷されるまでは約束であり、2027年初頭がその約束の最初の実証試験になる。PODが何台、どの歩留まりで、本当に準備の整ったサイト何カ所に入るのか。基調講演ではなく、パートナーの出荷報告を見るべきだ。14日構築が現場で大まかにでも成立すれば、競合プラットフォームはすべて、これまで答える必要のなかった問いに答えなければならなくなる。チップがどれだけ速いかではなく、ファクトリーがどれだけ速く組み立てられるかである。
含意
- ハイパースケーラーとAIファクトリー運営者へ: 構築速度は今や、ワット当たり性能と同格の調達基準である。数カ月早く生産に入るプラットフォームは、数カ月早く収益化する。シリコンだけでなく、準備済みサイトから生産までの区間を評価すべきだ。
- NVIDIAのパートナーへ: PODは2027年初頭から、NVIDIAの仕様の中でコンテナ層の市場を作る。機会は実在し、依存も実在する。ボトルネックが電気の領域へ移る局面では、電力と冷却のポジション、すなわち準備済みサイト層を握るパートナーが最も希少なカードを持つ。
- メモリメーカーへ: Vera Rubinの本格生産と2027年初頭のPOD出荷は、HBM4物量の信号である。上流の構築速度が下流の注文の拍子を決める。
- 競合プラットフォーム企業へ: 競争の場はチップから構築システムへ広がった。競合ラックは今や演算性能だけでなく、準備済みサイトにおける生産到達時間でも競う。
- 投資家へ: 検証すべき点は三つある。2027年初頭のパートナーのPOD出荷、14日構築の主張に関する現場報告、そして最大30%の電力削減というDSX MaxLPSの主張の実測結果である。発表は物語を作り、出荷は数字を作る。
FAQ
NVIDIA DSX PODとは正確には何か?
Vera Rubin AIファクトリー全体をモジュール型コンテナに変えるリファレンスデザインである。ファクトリーを工場で組み立て、検証してから出荷する。コンピュートコンテナ1台には、Rubin GPU 504基を備えたVera Rubin NVL72ラック7台が入り、重量は約28,000kg、電源入力は800 VDCである。NVIDIAは2026年10月21日、GTCベルリンでパートナー17社とともにこれを発表し、出荷は2027年初頭に始まる予定である。
14日でデータセンターが建つという意味か?
違う。14日とは、電力と冷却、建物の基盤がすでに整った準備済みサイトにおける現場構築期間であり、従来の現場構築の約6カ月から短縮された数値である。電力網への接続と許認可を含め、サイト自体を建てる作業は依然として遥かに長く掛かる。PODは、サイトの準備完了とAIファクトリーの稼働の間の区間を圧縮する。
Vera Rubinノードは何が変わって組み立てがそれほど速くなったのか?
NVIDIAによれば、Vera Rubinノードはケーブルがなく、100%液冷であり、ノード組み立て時間はGrace Blackwellの2時間から5分未満へ短縮された。ケーブリングを取り除けば、組み立て時間と現場エラーの主要な原因が一緒に消え、保守の場面でのノード交換も設置と同じくらい速くなる。
Vera Rubinの量産がHBM4にとって重要なのはなぜか?
Vera RubinシステムはHBM4メモリを使うため、プラットフォームの本格生産ランプと、2027年初頭に始まる予定のDSX POD出荷は、HBM4需要に直結する。構築速度がメモリメーカーにとって重要なのは、より速い構築が次のGPUとHBMの注文を前倒しするからである。
出典:NVIDIA DSX POD構築発表の報道、GTCベルリンのVera RubinとDSX PODに関する報道、DSX PODの14日構築に関する報道(いずれも2026年10月21日のGTCベルリンにおけるNVIDIAの発表に基づく)。本稿は分析であり、投資助言ではない。
📩 VLSI Korea ニュースレター
毎日配信の半導体ディープダイブを、メールでいち早くお届けします。購読は無料です。


