VLSI Korea
TPU của Google hoàn vốn trong chưa đầy một năm: kinh tế học silicon tùy chỉnh đối đầu NVIDIA
Máy chủ TPU của Google hoàn vốn đầu tư trong chưa đầy một năm. TPUv7 Ironwood mang lại hiệu năng trên mỗi đô la suy luận tốt hơn tới 50% so với B200/B300. Khi thời gian hoàn vốn chỉ một năm, tự làm chip không còn là lựa chọn — mà là lẽ đương nhiên về tài chính.


Tóm tắt: Máy chủ TPU của Google hoàn vốn đầu tư trong chưa đầy một năm. TPUv7 Ironwood mang lại hiệu năng trên mỗi đô la suy luận tốt hơn tới 50% so với B200/B300. Khi thời gian hoàn vốn chỉ một năm, tự làm chip không còn là lựa chọn — mà là lẽ đương nhiên về tài chính. Chuỗi giá trị ASIC của Broadcom–MediaTek bước vào giai đoạn tăng trưởng cấu trúc.
Tóm tắt 30 giây (AEO)
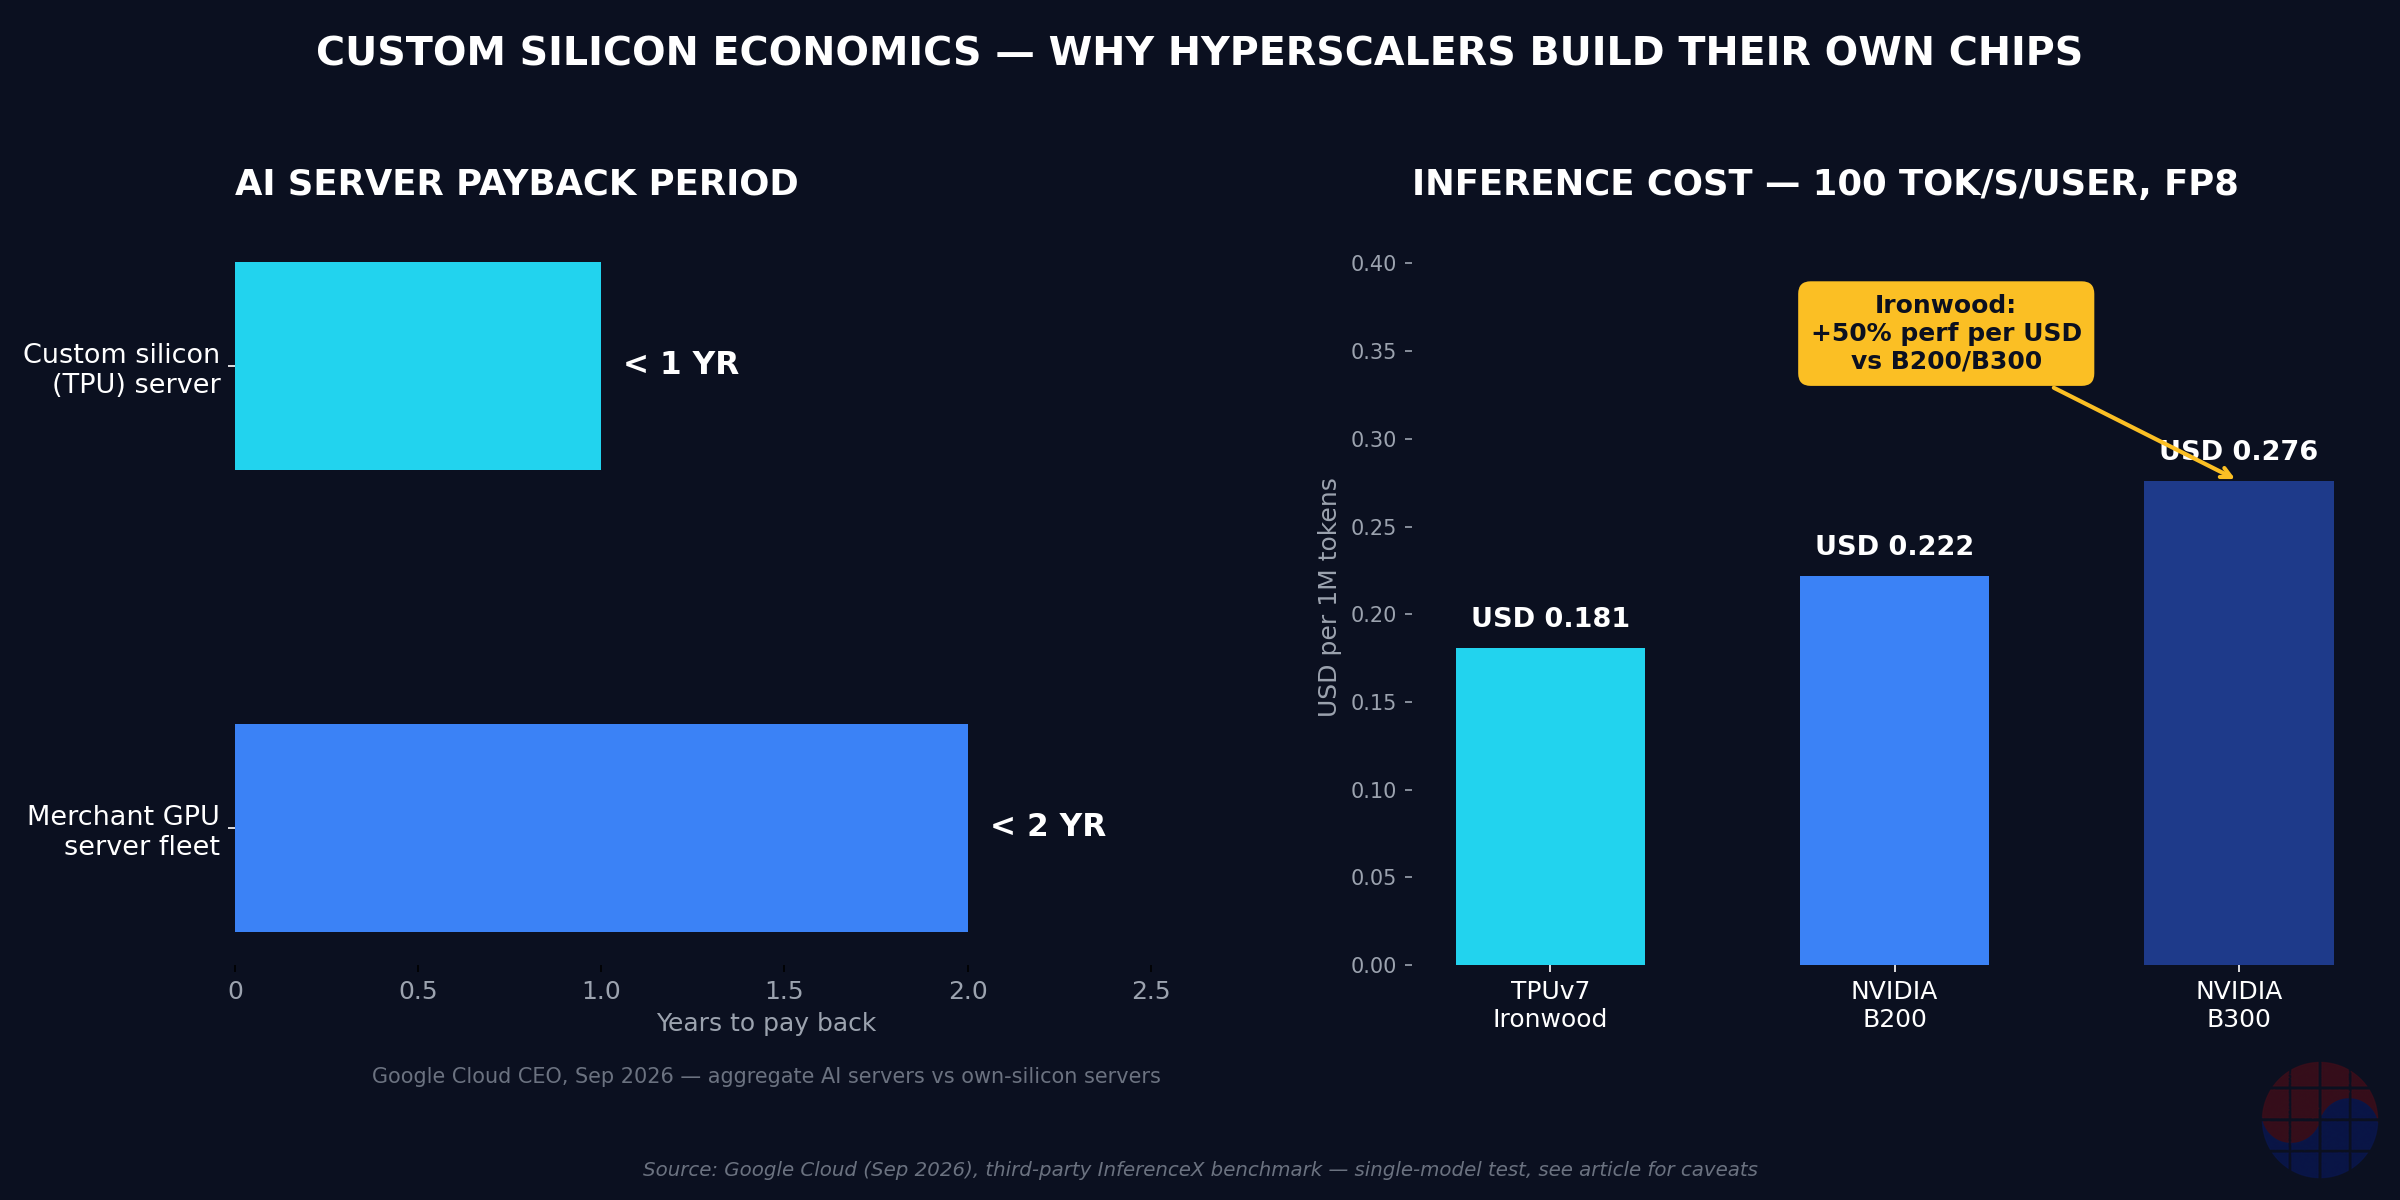
- CEO Google Cloud Thomas Kurian tiết lộ tháng 9/2026: máy chủ AI hoàn vốn trong chưa đầy hai năm xét tổng thể; máy chủ dùng silicon tự phát triển (TPU) chỉ mất khoảng một nửa thời gian. Thời gian hoàn vốn một năm biến silicon tùy chỉnh từ "lựa chọn chiến lược" thành lẽ đương nhiên tài chính. (Nguồn)
- Đánh giá độc lập (InferenceX) kết luận TPUv7 Ironwood mang lại "hiệu năng trên mỗi đô la tốt hơn tới 50%" so với B200/B300 trong suy luận tương đương — với lưu ý đây là kiểm thử một mô hình (Qwen 3.5 397B, FP8) do nhà cung cấp thực hiện. (Nguồn)
- Anthropic tiết lộ trong hồ sơ IPO tháng 10/2026 cam kết thuê dung lượng TPU 5 năm trị giá 125,2 tỷ USD; Broadcom đồng ý tài trợ tới 42 tỷ USD dưới dạng trái phiếu chuyển đổi. Bán chip cộng tài chính: một mô hình kinh doanh mới. (Nguồn)
- MediaTek tăng gấp đôi dự báo doanh thu ASIC 2026 lên hơn 2 tỷ USD, với ASIC AI đầu tiên cho Google bước vào sản xuất hàng loạt trong Q4/2026. (Nguồn)
- Kết luận: ở quy mô hyperscaler, tranh luận tự làm hay mua ngoài đã ngã ngũ. Thời gian hoàn vốn quyết định.
Background: Vì sao là silicon tùy chỉnh, vì sao là bây giờ
Trong nhiều năm, tranh luận về chip AI xoay quanh việc ai nhanh hơn. Nửa cuối 2026, câu hỏi đã đổi. Khi Alphabet dự kiến chi tiêu vốn (capex) 2026 lên tới 195–205 tỷ USD (nguồn), cổ đông ngừng hỏi về FLOPS và bắt đầu hỏi tiền bao giờ quay về.
Câu trả lời của Kurian cụ thể một cách bất thường. Tại hội nghị Goldman Sachs Communacopia + Technology ngày 8/9/2026, ông cho biết thời gian hoàn vốn tổng thể của máy chủ AI chưa đầy hai năm, còn silicon tự phát triển chỉ khoảng một nửa. Google Cloud nhắc lại trong bản tổng kết chính thức ngày 11/9. Ông còn cho biết Google Cloud có hiệu năng trên giá tốt hơn 2,7 lần cho huấn luyện và 80% cho suy luận, và mảng tăng tốc của công ty lớn gấp hơn hai lần đối thủ hyperscaler gần nhất. (Nguồn)
Sức nặng của phát biểu không nằm ở con số hai, mà ở chỗ thời gian hoàn vốn một năm làm gì với kinh tế học của việc tự làm chip. Chi phí NRE cho ASIC AI tiến trình tiên tiến (thiết kế, mặt nạ, kiểm chứng) khoảng 100–200 triệu USD. Chia cho một triệu chip, chỉ còn 100–200 USD mỗi chip — không đáng kể so với biên lợi nhuận merchant của GPU (biên gộp của NVIDIA trên 70%). Khi sản lượng đủ lớn, tự làm silicon rẻ hơn một cách vô điều kiện. Phát biểu của Kurian tương đương tuyên bố ở cấp CEO của Google Cloud rằng sản lượng đã đủ lớn.
Business Deep Dive
Quy mô thị trường: thị trường chip AI tùy chỉnh ~80 tỷ USD vào 2027
Ước tính của giới phân tích đặt TAM chip AI tùy chỉnh khoảng 70–80 tỷ USD vào 2027. MediaTek nói với nhà đầu tư tháng 7/2026 rằng họ nhắm chiếm 15–20%. (Nguồn)
Các bước đi của hyperscaler đã lên bảng điểm:
- Google: Tại Cloud Next tháng 4/2026, giới thiệu TPU thế hệ thứ tám (8t cho huấn luyện, 8i cho suy luận) và kiến trúc mạng Virgo mới, liên kết 134.000 TPU trong một trung tâm dữ liệu và hơn một triệu TPU xuyên các cơ sở thành một cụm logic duy nhất. (Nguồn) Nút thắt giờ không còn là nguồn cung silicon mà là điện năng — ở quy mô hàng trăm nghìn, lượng điện có thể cấp cho các rack giới hạn tăng trưởng. (Nguồn)
- Anthropic: Thỏa thuận nhiều năm ký tháng 10/2025 cam kết tới một triệu TPU Ironwood (được đưa tin trị giá hàng chục tỷ USD), và hồ sơ IPO ngày 1/10/2026 tiết lộ cam kết thuê dung lượng TPU 5 năm trị giá 125,2 tỷ USD. (Nguồn)
- Meta: Chip 'Iris' thuộc chương trình MTIA đồng thiết kế với Broadcom bước vào sản xuất hàng loạt tại TSMC trên tiến trình 3nm tháng 9/2026. Meta dự định tăng gần gấp đôi dung lượng tính toán AI từ 7GW năm 2026 lên 14GW cuối 2027. (Nguồn)
- OpenAI: Giới thiệu chip tùy chỉnh đầu tiên 'Jalapeño' cùng Broadcom tháng 6/2026, với 10GW đồng phát triển đang triển khai. Triển khai rack bắt đầu cuối 2026, kéo dài đến 2029. (Nguồn)
Cơ cấu chi phí: TCO phân kỳ ở đâu
Kinh tế học của Ironwood dựa trên ba đòn bẩy.
1. Hiệu năng trên mỗi đô la. Trong đánh giá InferenceX (Qwen 3.5 397B, FP8, 100 tokens/giây/người dùng), Ironwood tốn 0,181 USD mỗi triệu token so với 0,222 USD của B200 và 0,276 USD của B300 — cơ sở của tuyên bố "hiệu năng trên mỗi đô la tốt hơn tới 50%". Theo TCO nội bộ, máy chủ Ironwood rẻ hơn khoảng 44% so với máy chủ GB200 Blackwell tương đương; khách hàng bên ngoài như Anthropic tiết kiệm khoảng 30% so với NVIDIA. (Nguồn) Lưu ý: kiểm thử một mô hình, một điều kiện, do nhà cung cấp thực hiện. Một phản biện mang tính độc lập: startup Inferact đánh giá Kimi K3 của Moonshot AI trên cùng engine vLLM — 16 chip TPUv7 đạt 709 tokens/giây so với 452 của 16 GB200, hơn 57% kể cả tối ưu ngăn xếp phần mềm. (Nguồn)
2. Loại bỏ biên merchant. Khi Google bán hoặc cho thuê chip của mình ra bên ngoài, giá không mang "nêm" biên merchant kiểu NVIDIA. Đó là phần cứng tích hợp dọc (chip, kết nối, ngăn xếp phần mềm) với chi phí nội bộ cộng phí dịch vụ đám mây. Cùng FLOPS, cấu trúc hóa đơn khác hẳn.
3. Điện năng và kinh tế quy mô. Điện và làm mát chiếm gần 40% TCO trung tâm dữ liệu. Watt trên mỗi chip quan trọng, nhưng ở quy mô một triệu chip, hiệu quả kiến trúc mạng (goodput) mới quyết định tiền bạc — đó là lý do Google quảng bá "goodput trên 97%" cho TPU 8t. Đây là ván cờ cấu trúc giống như các nhà sản xuất bộ nhớ chơi với tỷ lệ đạt (yield): không phải hiệu năng đơn vị, mà là kinh tế học của các chu kỳ sống sót.
Định vị cạnh tranh: bốn trục
| Trục | Các bên | Vị thế |
|---|---|---|
| Chip tự phát triển của hyperscaler | Google TPU, Meta MTIA, Amazon Trainium, Microsoft Maia, OpenAI Jalapeño | Chuyên biệt theo khối lượng công việc; loại bỏ biên merchant |
| Đối tác thiết kế ASIC | Broadcom, MediaTek, Marvell, Alchip | Thắng nhờ thiết kế + tích hợp CoWoS + HBM |
| Foundry | TSMC (độc quyền thực tế) | Người phân bổ công suất tiến trình tiên tiến |
| Bộ nhớ | SK hynix, Samsung, Micron (HBM) | Số ngăn xếp HBM mỗi chip (hàng trăm Gb mỗi chip) là trục chi phí trọng yếu |
Vị thế của Broadcom thú vị nhất. Tháng 4/2026, họ ký thỏa thuận cung ứng TPU và mạng dài hạn với Google đến 2031 (nguồn), mở rộng hợp tác MTIA với Meta ngày 14/4 (hơn 1GW), và đồng phát triển 10GW với OpenAI. Nói cách khác, Broadcom đồng thời thiết kế chip cho ba phe AI đang cạnh tranh — kho vũ khí của cuộc chiến silicon tùy chỉnh.
MediaTek tấn công từ góc khác: tái sử dụng IP CPU, GPU, NPU thời smartphone và tài sản thiết kế tiết kiệm điện cho ASIC trung tâm dữ liệu. Q2/2026, mảng Smart Device Platform (gồm ASIC) lần đầu vượt chip smartphone, trở thành nguồn doanh thu lớn nhất. Các cuộc gọi kết quả kinh doanh tháng 4 và tháng 7 tăng gấp đôi dự báo doanh thu ASIC 2026 lên hơn 2 tỷ USD, với bộ tăng tốc AI đầu tiên cho Google bước vào sản xuất hàng loạt Q4/2026. (Nguồn) Cần theo dõi: tin đồn thị trường về giao mẫu và tỷ lệ đạt khiến việc thực thi Q4 trở thành bài kiểm tra thực sự.
Các lựa chọn chiến lược: ba kịch bản
- Tích hợp dọc tăng tốc (kịch bản cơ sở): nếu việc đưa TPU ra bên ngoài thành công, 20–30% khối lượng suy luận sẽ chạy trên silicon tùy chỉnh thay vì GPU merchant vào 2027. Các đối tác thiết kế ASIC được định giá lại bội số.
- Merchant phản công: NVIDIA có thể thu hẹp khoảng cách TCO bằng giá và gói sản phẩm ở thế hệ Rubin. Chi phí chuyển đổi hệ sinh thái CUDA vẫn là hào lũy. Việc Ironwood chỉ hỗ trợ native tới FP8 (FP4 đến với TPUv8i) giới hạn phạm vi hợp lệ của phép so sánh.
- Rủi ro tài chính hiện hữu (kịch bản bi quan): tài trợ khách hàng kiểu Broadcom về cấu trúc giống vendor financing của Nortel và Lucent trong bong bóng viễn thông 2001: các nhà sản xuất thiết bị chống đỡ sức mua của khách hàng cho đến khi tín dụng khách hàng sụp đổ. Mức phơi nhiễm tối đa 29 tỷ USD trong chính báo cáo quý của Broadcom cho thấy cả hai mặt của cấu trúc này. (Nguồn)
Chase's Take
Cách đọc theo kiểu tình huống MBA chỉ có một: tự làm hay mua ngoài do thời gian hoàn vốn quyết định, không phải công nghệ.
Trong phân tích cổ điển, bạn chia chi phí cố định (NRE) cho sản lượng. Với chip AI, mẫu số tăng theo cấp số nhân trong khi tử số, dù tăng theo tiến trình tiên tiến, không theo kịp. Một triệu chip × hàng nghìn USD tiết kiệm mỗi chip = hàng tỷ USD. Khoảnh khắc phương trình này đúng, CFO sẽ hỏi kỹ sư "sao không tự làm". Phát biểu của Kurian là câu trả lời cấp CEO cho câu hỏi đó.
Thứ hai: đổi mới GTM của Broadcom. Một công ty chip cho khách hàng vay 42 tỷ USD không phải giảm giá — mà là "tài chính chính là bán hàng". Mặt tích cực: tối đa hóa rào cản gia nhập (khóa chặt khách hàng); mặt tiêu cực: nội bộ hóa rủi ro tín dụng. Nhà đầu tư nên đọc bảng cân đối của Broadcom bằng con mắt của một ngân hàng, chứ không phải công ty chip.
Thứ ba, góc nhìn thị trường mới nổi. Ván cờ này có hai ghế cho phần còn lại của thế giới. Một là HBM: với 8–12 ngăn xếp HBM (hàng trăm Gb mỗi chip) trên mỗi bộ tăng tốc tùy chỉnh, tăng trưởng sản lượng ASIC chính là tăng trưởng nhu cầu HBM. Hai là cẩm nang fabless: chiến lược tái sử dụng IP smartphone của MediaTek là khuôn mẫu mà các fabless ở bất kỳ khu vực nào cũng có thể theo đuổi, hướng tới ASIC chuyên biệt theo khối lượng công việc (suy luận, biên).
Implications: đầu tư và quản trị
- Đầu tư: các đối tác thiết kế ASIC (Broadcom, MediaTek, Marvell, Alchip) đang trong giai đoạn tăng trưởng cấu trúc. Nhưng bội số có thể đã phản ánh phần lớn — cần theo dõi hàng quý tiến độ sản xuất của MediaTek trong Q4 và mức phơi nhiễm tài chính của Broadcom. Về foundry, việc phân bổ công suất tiên tiến của TSMC ngày càng quyết định chất lượng danh mục khách hàng.
- Quản trị: người mua đám mây không nên lập ngân sách TCO suy luận 2027 chỉ dựa trên báo giá GPU merchant. Luôn đưa song song một đề xuất đưa TPU ra bên ngoài — riêng đòn bẩy đàm phán đã từng cắt giảm ~30% giá GPU hiện hữu trong các trường hợp có ghi nhận (OpenAI). (Nguồn)
- Rủi ro: kịch bản các cấu trúc tài trợ khách hàng đổ vỡ không đến từ cú rơi nhu cầu chip, mà từ thắt chặt tín dụng. Với tài trợ hạ tầng AI giờ đã hàng trăm tỷ USD, chỉ số cần theo dõi là chênh lệch lợi suất và hợp đồng hoán đổi vỡ nợ, chứ không phải lượng chip xuất xưởng.
FAQ
Q1. TPU có thực sự hoàn vốn trong chưa đầy một năm? Đó là con số chính thức của CEO Google Cloud tại hội nghị tháng 9/2026: chưa đầy hai năm cho máy chủ AI xét tổng thể, khoảng một nửa cho silicon tự phát triển. Nó phản ánh hạch toán nội bộ của Google — không có nghĩa khách hàng bên ngoài có thể tái tạo cùng điều kiện. (Nguồn)
Q2. Phép so sánh "hiệu năng trên mỗi đô la tốt hơn 50%" của Ironwood có công bằng? Có giới hạn của kiểm thử một mô hình, một điều kiện, do nhà cung cấp thực hiện. Nhưng một đánh giá độc lập (Inferact) cũng cho thấy TPUv7 vượt GB200, và các phân tích TCO nội bộ cùng hướng. Luận điểm phản biện: chỉ hỗ trợ native tới FP8. (Nguồn)
Q3. Vì sao Broadcom cho Anthropic vay 42 tỷ USD lại quan trọng? Đó là mô hình kinh doanh mới nơi bán chip và tài chính hợp nhất: nhà cung cấp trực tiếp chống đỡ sức mua của khách hàng để giành đơn hàng, đổi lại gánh rủi ro tín dụng của khách hàng. Cấu trúc gợi nhớ vendor financing của bong bóng viễn thông 2001 — cần nhìn cả hai mặt. (Nguồn)
Q4. Điều này có ý nghĩa gì với các công ty bán dẫn ngoài Mỹ? Về HBM, đây là tin tốt cho SK hynix, Samsung và Micron: chip tùy chỉnh cũng dùng HBM. Về thiết kế, cẩm nang "tái sử dụng IP smartphone" của MediaTek là khuôn mẫu có thể sao chép.
Đọc thêm
- Bức tranh lớn cuộc đua chip AI: Chip War — Chris Miller (Amazon)
- Giải phẫu mô hình kinh doanh NVIDIA: The Nvidia Way — Tae Kim (Amazon)
Mua hàng qua liên kết này có thể mang lại hoa hồng.
Bài viết là phân tích dựa trên thông cáo công khai, các cuộc gọi kết quả kinh doanh và báo chí; không phải lời khuyên đầu tư. Các số liệu được trích dẫn theo thời điểm công bố của nguồn (tháng 4–10/2026) và có thể đã thay đổi.