VLSI Korea
Suy luận AI không cần HBM? Canh bạc LPDDR5X 480GB của Intel và cuộc chiến TCO
Intel ra mắt GPU suy luận D270 tại OCP 2026: FP8 1,3 PFLOPS, băng thông 1,5 TB/s, PCIe 350W làm mát bằng không khí. LPDDR5X lên đến 480GB chứa được mô hình 300 tỷ tham số — không phải HBM. HBM 2026 coi như cháy hàng: cuộc đua suy luận thắng bằng chi phí trên mỗi token (TCO), không phải băng thông.


Excerpt: Intel ra mắt GPU suy luận D270 tại OCP 2026: FP8 1,3 PFLOPS, băng thông 1,5 TB/s, PCIe 350W làm mát bằng không khí. LPDDR5X lên đến 480GB chứa được mô hình 300 tỷ tham số — không phải HBM. HBM 2026 coi như cháy hàng: cuộc đua suy luận thắng bằng chi phí trên mỗi token (TCO), không phải băng thông. Slug: inference-memory-tco-lpddr5x-hbm-vi
Suy luận AI không cần HBM? Canh bạc LPDDR5X 480GB của Intel và cuộc chiến TCO
Tóm tắt 30 giây: Intel giới thiệu GPU suy luận D270 (Crescent Island) tại OCP 2026: FP8 1,3 PFLOPS, băng thông bộ nhớ 1,5 TB/s, card PCIe 350W làm mát bằng không khí. Tiêu điểm không phải HBM mà là LPDDR5X: 160GB trên card Intel, lên đến 480GB trên card đối tác ODM — một card chứa mô hình 300 tỷ tham số ở FP8, hệ thống tám GPU xử lý 1T+ tham số. Giá không công bố, chưa có benchmark độc lập. Trong khi đó HBM coi như cháy hàng cho 2026, phần lớn nguồn cung 2027 đã bị khóa. Ai đảm bảo được bộ nhớ sẽ định đoạt kiến trúc — và trong suy luận, cuộc đua được thắng bằng chi phí trên mỗi token (TCO), không phải băng thông.
Background
Hạ tầng AI đang dịch chuyển trọng tâm từ training sang suy luận (inference). Training là cuộc đua tính toán khổng lồ một lần; suy luận là dịch vụ liên tục phun ra hàng tỷ token mỗi ngày. Khi khối lượng công việc trở thành dịch vụ, cấu trúc chi phí trở thành chiến lược.
Nhưng cuối năm 2026, bức tường đầu tiên mà các nhà hoạch định hạ tầng suy luận va phải không phải FLOPS của GPU — mà là thu mua bộ nhớ. Samsung cho biết lượng HBM4 năm 2026 coi như bán hết; SK hynix báo cáo toàn bộ sản lượng DRAM và NAND 2026 hết sạch. Micron được cho là đã khóa phần lớn nguồn cung bộ nhớ 2027 với giá cao hơn, theo các bài báo trong ngành. (Nguồn: RCR Wireless)
Trên nền đó, câu trả lời của Intel tại OCP Global Summit ngày 12/10 thật nổi bật: bỏ qua cuộc tranh giành HBM hoàn toàn và xây dựng trên một loại bộ nhớ khác.
Business Deep Dive
1. Mổ xẻ D270 — vì sao là LPDDR5X
Thông số Intel cho GPU D270 (tên cũ Crescent Island): (Nguồn: Intel)
| Hạng mục | Thông số |
|---|---|
| Kiến trúc | Xe3P — 32 nhân Xe3P, 256 XMX matrix engine, L2 hợp nhất 32MB |
| Hiệu năng tính toán | FP8 1,3 PFLOPS |
| Bộ nhớ | LPDDR5X — 160GB (card của Intel) / lên đến 480GB (card đối tác ODM) |
| Băng thông bộ nhớ | 1,5 TB/s |
| Công suất & làm mát | 350W, PCIe 5.0 x16 làm mát bằng không khí |
| Hỗ trợ mô hình | 300B tham số mỗi card, 1T+ tham số trên 8 GPU |
Quyết định thiết kế đáng chú ý nhất: loại bỏ hoàn toàn phần cứng đồ họa 3D truyền thống và ray tracing. Diện tích die từng dành cho đơn vị đồ họa cố định nay phục vụ tính toán AI. Chỉ dành cho suy luận — khắc vào silic.
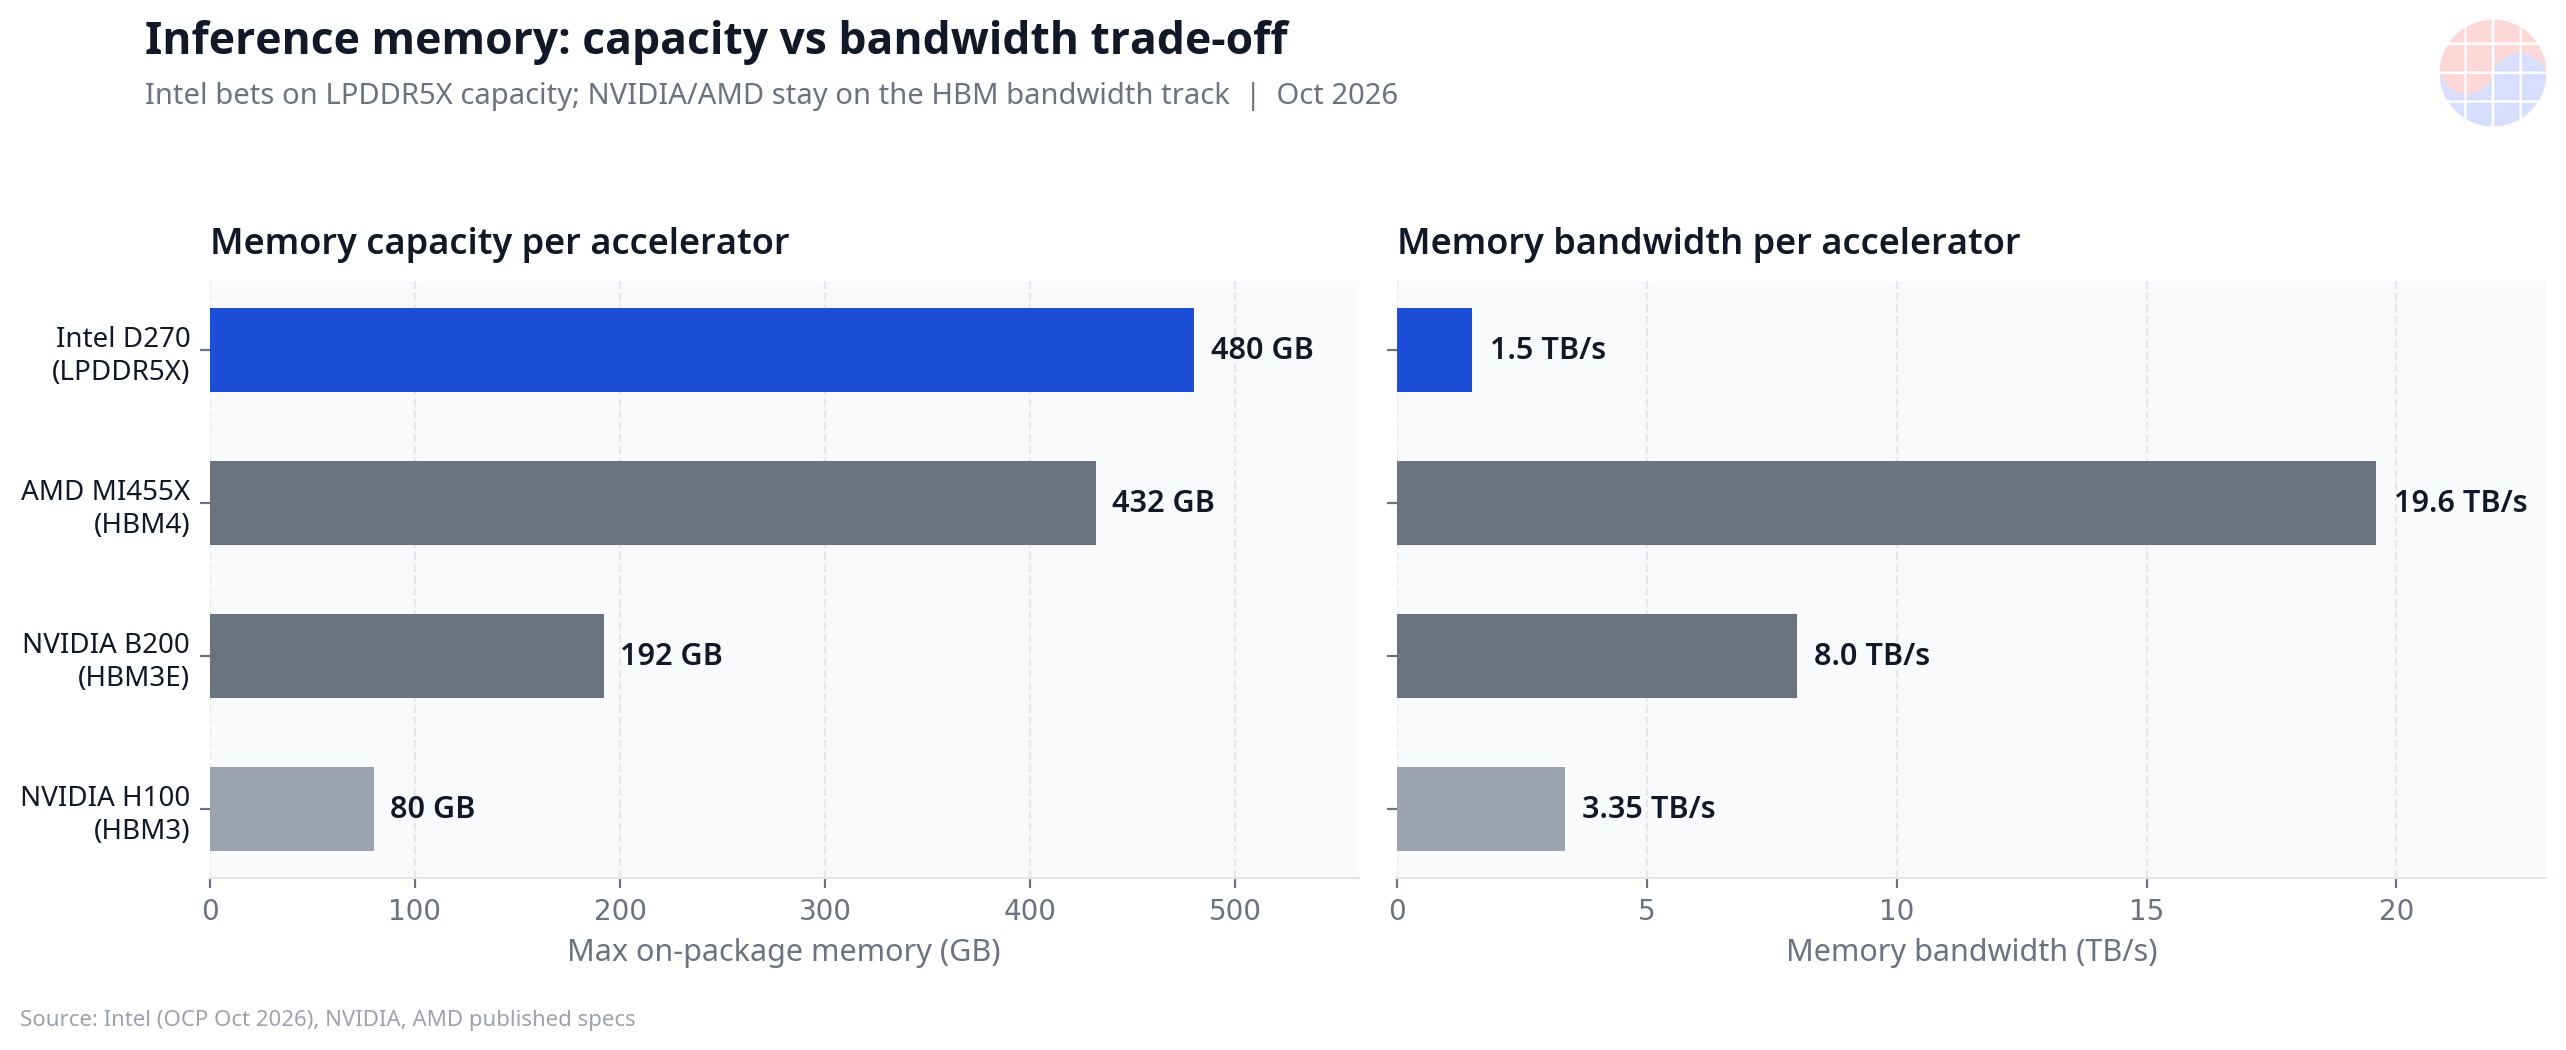
Quyết định thứ hai là bộ nhớ: LPDDR5X thay vì HBM. Với 1,5 TB/s, băng thông chỉ bằng khoảng một phần năm card đẳng cấp HBM3E (8 TB/s). Nhưng dung lượng thì áp đảo — 480GB trên card đối tác gấp khoảng 2,5 lần thế hệ flagship HBM hiện tại.
Phép tính thật đơn giản. Ở FP8, một tham số xấp xỉ một byte. Trọng số của mô hình 300 tỷ tham số là ~300GB — vừa vặn thoải mái trong card 480GB. ~180GB còn lại dành cho "kẻ ngốn bộ nhớ ẩn" của suy luận, KV cache, và batching. Mô hình 1 nghìn tỷ tham số chia cho 8 card cần ~125GB mỗi card. Thiếu hụt băng thông không nghiêm trọng như trong training, vì suy luận tái sử dụng trọng số đã nạp thay vì khuấy đảo liên tục.
Quyết định thứ ba là công suất và dạng thức. Card PCIe 350W làm mát bằng không khí cắm thẳng vào hạ tầng trung tâm dữ liệu hiện có. Không như các bộ tăng tốc làm mát bằng chất lỏng 1.000W, nó không cần hạ tầng nguồn hay làm mát chuyên dụng — điều này trong phép tính TCO quan trọng hơn vẻ bề ngoài.
Các điểm thận trọng cũng rõ ràng không kém. Giá chưa công bố; thời điểm bán rộng rãi chỉ được mô tả là năm 2027 trong các bài báo. Chưa có benchmark độc lập — 1,3 PFLOPS là đỉnh lý thuyết. (Nguồn: VideoCardz)
2. Cơn thiếu hụt bộ nhớ đang viết lại kiến trúc
Để hiểu canh bạc của Intel, hãy xem thị trường bộ nhớ tính đến tháng 10/2026:
- HBM4 (thế hệ hiện hành): lượng 2026 của Samsung coi như bán hết; toàn bộ sản lượng DRAM và NAND 2026 của SK hynix hết sạch — không thể mua thứ không tồn tại.
- HBM4E (thế hệ tiếp theo): giao diện 2.048-bit, 14–16 Gbps mỗi chân, lên đến 3,6 TB/s mỗi stack. Mẫu 12-high (384Gb / 48GB) đã được Samsung (tháng 5) và SK hynix (tháng 6) gửi đi. Sản xuất hàng loạt nhắm đến 2027. Vẫn là thế hệ do nhà cung cấp định nghĩa — chưa có chuẩn JEDEC. (Nguồn: RCR Wireless)
- HBM4E 12-high của Samsung được cho là đã vượt qua kiểm tra chứng nhận của NVIDIA, dù hai bên đều chưa xác nhận chính thức. (Nguồn: HardwareBrief)
- Micron được cho là đã bán 75% nguồn cung bộ nhớ 2027. (Nguồn: Tech Insider)
Nói cách khác, tham gia lộ trình HBM nghĩa là xếp hàng chờ phân bổ 2027. "Xây dựng farm suy luận không cần HBM" trong thị trường này không chỉ là cắt giảm chi phí — mà là né tránh rủi ro thu mua. LPDDR5X là DRAM hàng hóa sản xuất hàng loạt cho điện thoại và PC: không nút thắt đóng gói TSV/interposer, nguồn cung rộng, chi phí trên mỗi GB thấp hơn. Tesla cũng đi đến kết luận tương tự.
3. Tesla đang đi cùng hướng — hạ thông số bộ nhớ AI5/AI6
Ngày 1/10, Elon Musk thông báo Tesla cắt bộ nhớ AI5 từ kế hoạch 144GB LPDDR5 xuống 72GB, và AI6 xuống 144GB LPDDR6 (cắt một phần ba). Lý do rất rõ ràng: đảm bảo đủ lượng cho sản xuất Optimus. AI5 sau đó được điều chỉnh thành 96GB. Musk nói thêm rằng băng thông bộ nhớ, chứ không phải dung lượng, là rào cản lớn hơn nên ảnh hưởng hiệu năng sẽ không đáng kể. (Nguồn: Wccftech)
Mô hình ở đây rõ ràng: cơn thiếu hụt bộ nhớ đang thay đổi chính thông số thiết kế. Định nghĩa lại sản phẩm quanh bộ nhớ có thể đảm bảo được đang thành quy trình vận hành chuẩn của phần cứng AI cuối năm 2026. Đáng chú ý, AI5 đã trong giai đoạn sản xuất thử tại nhà máy Taylor, Texas của Samsung Foundry.
4. Chiến lược bộ nhớ phân nhánh — NVIDIA vs Intel
Bên tự tin về nguồn cung bộ nhớ đi theo hướng ngược lại. Lộ trình của NVIDIA:
- Rubin (2026): HBM4
- Rubin Ultra (2027): HBM4E
- Feynman (2028): được cho là HBM tùy chỉnh — thiết kế riêng thay vì HBM chuẩn (Nguồn)
- NVHBM (công bố tháng 8/2026): công nghệ HBM base-die tùy chỉnh của NVIDIA, đồng thiết kế với các nhà sản xuất bộ nhớ — tuyên bố băng thông mỗi stack +30% so với HBM4E chuẩn, công suất HBM −15%, diện tích PHY −67% (Nguồn: WeDoAny)
AMD cũng bám theo lộ trình HBM: MI455X đóng gói 3.456Gb (432GB) HBM4 với băng thông 19,6 TB/s. (Nguồn: TweakTown)
Chiến lược bộ nhớ đang phân thành hai nhánh:
| Chiến lược | Các hãng | Hướng đi |
|---|---|---|
| Tối ưu băng thông & công suất | NVIDIA (NVHBM HBM tùy chỉnh), AMD (HBM4/HBM4E) | Vắt kiệt bộ nhớ đắt tiền — training & suy luận flagship |
| Tối ưu dung lượng & chi phí | Intel (LPDDR5X 480GB), Tesla (LPDDR5/6) | Dùng nhiều bộ nhớ rẻ — cuộc đua TCO farm suy luận |
Không bên nào "đúng" — khối lượng công việc đang tách ra: training frontier và suy luận cao cấp khát băng thông, còn dịch vụ token đại trà, on-device và suy luận robot được chi phối bởi dung lượng và chi phí.
5. Mổ xẻ TCO — bốn đòn bẩy quyết định chi phí trên mỗi token
TCO hạ tầng suy luận được phân rã thành bốn đòn bẩy:
① Thu mua bộ nhớ. HBM cháy hàng — người mua tranh nhau phân bổ với giá cao. LPDDR5X là thị trường hàng hóa với đòn bẩy đàm phán giá và ổn định nguồn cung. Trong thời đại này, khả năng đảm bảo nguồn cung là dòng đầu tiên của phương trình TCO.
② Công suất & làm mát. 350W làm mát bằng không khí so với 1.000W làm mát bằng chất lỏng không chỉ là chuyện công suất chip — nó kéo theo mật độ công suất rack, chi tiêu vốn (capex) làm mát bằng chất lỏng và hóa đơn điện. Đó là lý do Intel nhấn mạnh "mở rộng mà không cần hạ tầng rack hay làm mát chuyên dụng."
③ Dung lượng mỗi máy chủ. Hệ thống 8 card D270 chứa tổng 3,84TB bộ nhớ cho mô hình 1T+ tham số. Ít node hơn nghĩa là ít mạng, ít điện và ít phức tạp vận hành. Dung lượng chính là mật độ node.
④ Tỷ lệ sử dụng. Máy chủ suy luận sống trong trạng thái bị giới hạn bởi bộ nhớ chứ không nhàn rỗi. Ngay cả với băng thông thấp hơn, KV cache và batch lớn vẫn vắt ra được throughput token — cùng logic với nhận xét của Tesla rằng "băng thông là rào cản lớn hơn."
Chase's Take
Nếu chỉ số thời đại training là FLOPS, chỉ số thời đại suy luận là đô-la trên mỗi token. Canh bạc của Intel dịch mệnh đề đó thành silic. 1,3 PFLOPS trông khiêm tốn so với các flagship — nhưng đổi câu hỏi từ "ai nhanh hơn" thành "ai đúc token rẻ hơn," cuộc chơi thay đổi.
Hai điểm mang tính cấu trúc:
Thứ nhất, cơn thiếu hụt HBM đã trở thành biến số cấu trúc buộc các lựa chọn kiến trúc, không còn là trục trặc nguồn cung tạm thời. Việc Tesla hạ thông số và Intel chuyển sang LPDDR là hai phản ứng khác nhau trước cùng áp lực. Trong khi bên nắm giữ bộ nhớ (SK hynix với ~57% doanh thu HBM, và các đối thủ) nắm quyền định giá, bên mua bộ nhớ thiết kế lại quanh bộ nhớ có thể đảm bảo được — hãy đọc tin tức phần cứng AI 2–3 năm tới trên nền căng thẳng này.
Thứ hai, lợi ích của Hàn Quốc nằm ở cả hai phía. Samsung và SK hynix là bên hưởng lợi trực tiếp từ phí cao HBM. Đồng thời, Samsung Foundry đang tape-out AI5 Tesla tại Taylor, và CXMT của Trung Quốc đang bám sát trong chuỗi cung ứng LPDDR. Sự dịch chuyển cơ cấu bộ nhớ từ chỉ-HBM sang HBM-cộng-LPDDR lan sang danh mục sản phẩm của bộ đôi bộ nhớ Hàn Quốc và cơ cấu khách hàng foundry. Phân tích chỉ đặt cược một phía chỉ là nửa bức tranh.
Các lập luận ngược, trình bày công bằng: 1,5 TB/s là thấp, và suy luận thời gian thực nhạy độ trễ (TTFT) có thể bị ảnh hưởng. Trên hết, giá chưa được công bố — lợi thế TCO không thể kiểm chứng cho đến khi bảng giá xuất hiện. Tuyên bố chiến thắng "giá trị suy luận" chỉ dựa trên số liệu lý thuyết sẽ là vội vàng.
Implications
Với nhà đầu tư: - Khi tỷ trọng suy luận tăng, cơ cấu bộ nhớ dịch chuyển khỏi chỉ-HBM. Đã đến lúc đánh giá lại các bên hưởng lợi cấu trúc từ nhu cầu LPDDR5X và DRAM máy chủ. - Phí cao HBM có thể kéo dài đến 2027 — 2026 cháy hàng, phân bổ 2027 đặt trước, và giai đoạn chuyển tiếp HBM4E do nhà cung cấp định nghĩa. Quyền định giá của các nhà sản xuất bộ nhớ còn giữ được trong lúc này. - Hạ tầng nguồn/làm mát (giữ làm mát bằng không khí hay chuyển sang chất lỏng) là biến số chi tiêu vốn (capex) mới của trung tâm dữ liệu — card suy luận 350W lan rộng có thể làm chậm quá trình chuyển sang làm mát bằng chất lỏng.
Với nhà vận hành: - Thu mua hạ tầng AI đang chuyển từ "chip nhanh nhất" sang "bộ nhớ có thể đảm bảo." Hãy lập kế hoạch công suất 2027 ngược từ phân bổ bộ nhớ. - Theo dõi các lựa chọn suy luận dựa trên LPDDR như một biện pháp phòng ngừa đa dạng hóa nhà cung cấp — đây có thể là ca kiểm chứng thực tế đầu tiên cho một lựa chọn thay thế suy luận ngoài NVIDIA.
FAQ
Q1. Băng thông LPDDR5X thấp hơn nhiều so với HBM — liệu có thực sự đủ cho suy luận? A. Tùy vào khối lượng công việc. Không như training liên tục khuấy đảo trọng số, suy luận nạp trọng số một lần rồi sinh ra hàng nghìn token; nút thắt thường là dung lượng KV cache và kích thước batch chứ không phải băng thông. Phục vụ thời gian thực nhạy độ trễ (TTFT) là nơi thiếu hụt băng thông lộ rõ.
Q2. 480GB có thực sự chứa được mô hình 300 tỷ tham số trên một card? A. Ở FP8, một tham số ≈ một byte, nên 300B tham số ≈ 300GB. Card 480GB còn dư ~180GB cho KV cache và batching — về mặt toán học phù hợp với tuyên bố của Intel. Hành vi thực tế đang chờ benchmark độc lập.
Q3. Giá bao nhiêu? A. Chưa công bố. Intel chỉ cho biết quá trình lấy mẫu khách hàng đang diễn ra. Lợi thế TCO thực sự so với card HBM không thể tính được cho đến khi có giá. Tranh luận về giá trị mà không có bảng giá chỉ là nửa cuộc tranh luận.
Q4. Khi nào cơn thiếu hụt HBM dịu bớt? A. Lượng 2026 coi như bán hết; phần lớn 2027 đã được đặt trước. Sản xuất hàng loạt HBM4E nhắm đến 2027, nhưng là thế hệ do nhà cung cấp định nghĩa nên tốc độ ramp là biến số — hãy chuẩn bị cho tình trạng căng thẳng kéo dài suốt 2027.
Đọc thêm
- Chris Miller, Chip War — địa chính trị và chuỗi cung ứng bá quyền chất bán dẫn. Xem trên Amazon
- Clayton Christensen, The Innovator's Dilemma — kinh điển MBA về cách hãng mới từ phân khúc thấp lật đổ thị trường; lăng kính đọc canh bạc LPDDR của Intel. Xem trên Amazon
Mua hàng qua liên kết này có thể tạo hoa hồng
Ghi chú: Số liệu và mốc thời gian dựa trên công bố công khai tính đến ngày 13/10/2026. Các con số hiệu năng Intel D270 là giá trị lý thuyết do nhà sản xuất công bố, chưa được kiểm chứng bằng benchmark độc lập. Không phải lời khuyên đầu tư.
Tags: deep-dive, inference, memory-tco, lpddr5x, hbm, vietnamese