 VLSI Korea
Phân tích sâu GPU suy luận Intel: vì sao D270 bỏ qua HBM để dùng LPDDR5X 480GB
Intel bỏ qua HBM, chọn LPDDR5X: 160GB trên card của hãng, tới 480GB ở thiết kế ODM. Kiểm chứng con số gây sốt, logic dung lượng thắng băng thông trong suy luận và ý nghĩa với Samsung, SK hynix, Micron.


Tóm tắt 30 giây
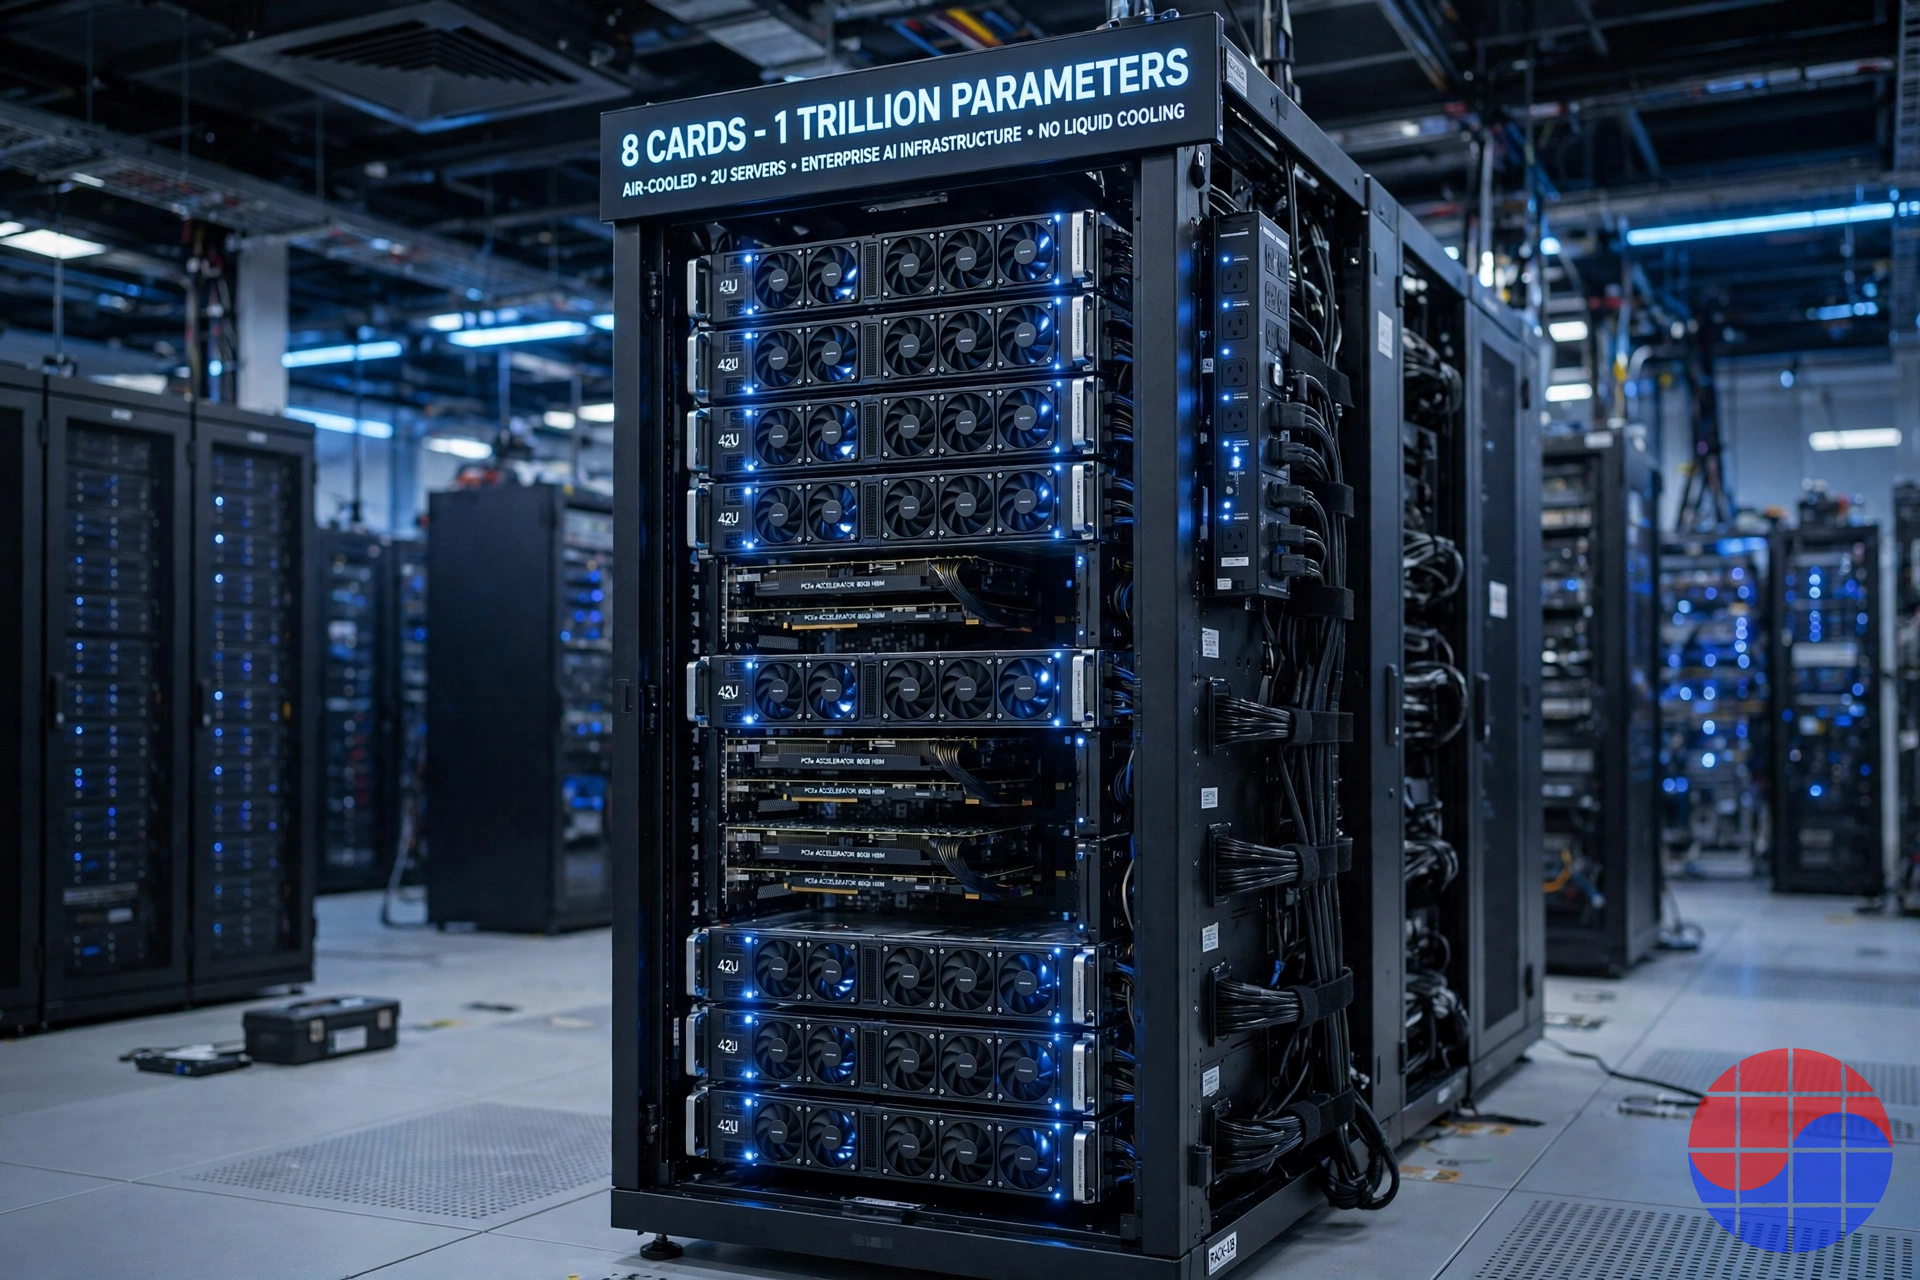
Ngày 12 tháng 10 năm 2026, tại OCP Global Summit, Intel công bố tên thương mại và thông số kỹ thuật cuối cùng cho GPU chuyên suy luận của mình. Với tên mã Crescent Island, dòng sản phẩm được đặt tên là Intel GPU D-Series, và card đầu tiên là D270 (theo báo chí chuyên ngành). Tâm điểm nằm ở bộ nhớ: card này hoàn toàn không dùng HBM. Hai mươi gói LPDDR5X tạo ra băng thông 1,5 TB/s, và dù card của chính Intel mang 160GB, các thiết kế của đối tác ODM có thể nâng dung lượng lên tới 480GB. Con số «LPDDR5X 480GB» lan truyền trong các bài phân tích trên mạng xã hội là có thật — nhưng có điều kiện: card mà Intel bán ra là 160GB. Năng lực tính toán đạt 1,3 PFLOPS FP8 trong một card PCIe 350W làm mát bằng không khí. Intel cho biết một card có thể phục vụ mô hình tới 300 tỷ tham số, và hệ thống tám card vượt một nghìn tỷ tham số. Việc gửi mẫu cho khách hàng đang diễn ra; giá bán và ngày phát hành chính thức chưa được công bố. Bài phân tích này tập hợp toàn bộ sự kiện đã xác nhận, logic kỹ thuật và kinh tế đằng sau câu hỏi «vì sao lại là LPDDR», cùng ý nghĩa đối với Samsung Electronics, SK hynix và Micron.
Intel thực sự đã công bố điều gì
Crescent Island không xuất hiện sau một đêm. Intel lần đầu giới thiệu GPU suy luận này tại OCP Global Summit vào tháng 10 năm 2025, với cấu hình LPDDR5X 160GB. Tại Hot Chips vào tháng 8 năm 2026, Intel trình bày chi tiết kiến trúc Xe3P, và ngày 12 tháng 10 năm 2026 hãng ấn định thương hiệu GPU D-Series cùng thông số cuối cùng. Intel cũng trưng bày nguyên mẫu mô-đun OAM làm mát bằng chất lỏng — hai GPU trên mỗi mô-đun, tám mô-đun trong một khung 5U — tín hiệu cho thấy PCIe làm mát bằng không khí là đầu cầu, còn các dạng thức dày đặc hơn vẫn nằm trên lộ trình.
Triết lý thiết kế nhất quán ngay từ đầu: không đối đầu trực diện với các GPU huấn luyện đầu bảng. Mục tiêu không phải pháo đài HBM của Blackwell Ultra của NVIDIA hay dòng MI của AMD, mà là các tải suy luận vừa trong những máy chủ x86 tiêu chuẩn mà doanh nghiệp đã sở hữu. Anil Nanduri, Phó chủ tịch phụ trách sản phẩm AI và đưa ra thị trường của nhóm trung tâm dữ liệu Intel, nói thẳng: «Suy luận đang trở thành tải công việc định nghĩa AI, và doanh nghiệp cần hạ tầng mang lại hiệu năng phù hợp với chi phí phù hợp».
| Thông số | Intel GPU D270 (Crescent Island) |
|---|---|
| Kiến trúc | Xe3P (Xe3 nâng cao) |
| Nhân Xe | 32 (bốn slice) |
| Động cơ ma trận XMX | 256 |
| Tính toán FP8 (dense) | 1,3 PFLOPS |
| Tính toán vector FP64 | 10,2 TFLOPS |
| Bộ nhớ đệm L2 | 32MB (hợp nhất) |
| Bộ nhớ | LPDDR5X, 20 gói, 80 kênh, 1.280-bit |
| Tốc độ bộ nhớ | 9.375 MT/s |
| Băng thông bộ nhớ | 1,5 TB/s |
| Dung lượng bộ nhớ | 160GB (card Intel) / tới 480GB (thiết kế ODM) |
| Giao diện host | PCIe Gen5 x16 |
| Công suất | 350W |
| Dạng thức / làm mát | PCIe CEM hai khe, làm mát bằng không khí |
| Trạng thái | Đang gửi mẫu cho khách hàng (tháng 10/2026); giá và ngày phát hành chưa công bố |
Nguồn: công bố của Intel tại OCP Global Summit ngày 12 tháng 10 năm 2026 và tài liệu kiến trúc Hot Chips 2026.
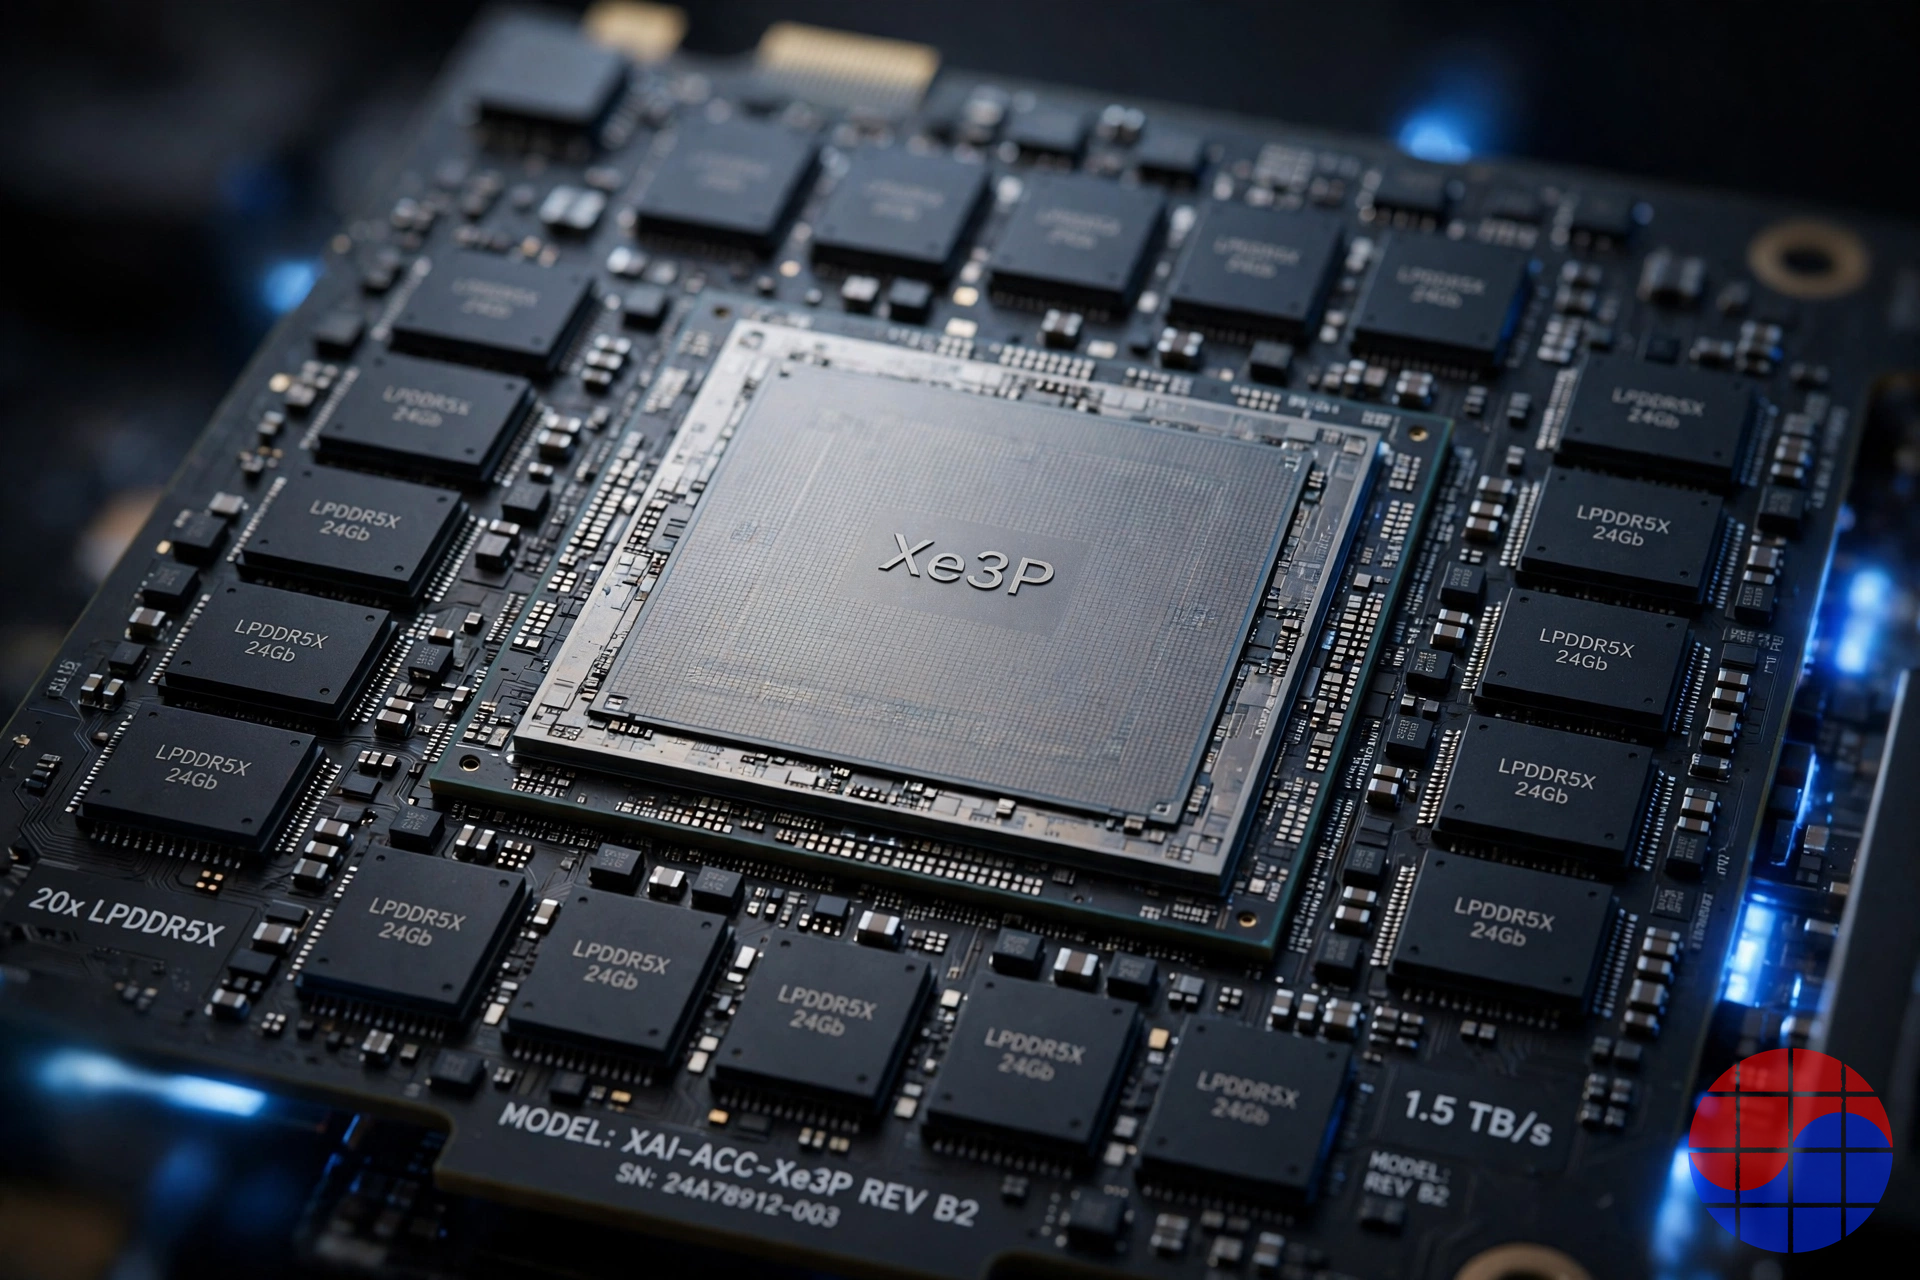
Bản thân nhân Xe3P cũng được cắt gọt lại cho suy luận. Mảng systolic XMX sâu hơn từ 4-deep ở Xe2 lên 16-deep, tệp thanh ghi đa dụng tăng gấp đôi lên 1MB mỗi nhân, và bộ nhớ L1/cục bộ dùng chung tăng lên 512KB mỗi nhân. Các khối đồ họa 3D và ray tracing của GPU chơi game bị loại bỏ hoàn toàn, nhường mỗi milimét vuông cho toán ma trận và các kiểu dữ liệu suy luận từ FP4 đến FP64. Phần mềm dựa trên ngăn xếp mở xoay quanh OpenVINO và oneAPI.
Kiểm chứng con số 480GB: thật, nhưng thiếu chú thích
Sau thông báo, «LPDDR5X 480GB» lan truyền trong các phân tích mạng xã hội như thể đó là thông số tiêu đề của card. Con số này thực sự xuất hiện trong công bố của Intel — nhưng đó là cấu hình tối đa mà đối tác ODM có thể xây dựng, không phải thông số của card mang thương hiệu Intel. Bỏ đi chú thích đó, con số trở nên gây hiểu lầm.
| Cấu hình | Mật độ mỗi gói | Số gói | Tổng dung lượng | Bên bán |
|---|---|---|---|---|
| Card tham chiếu Intel | Gói lớp 64Gb | 20 | 160GB | Intel (card thương hiệu) |
| Tối đa ODM | Gói lớp 192Gb | 20 | 480GB | Đối tác (bo mạch ODM) |
Hệ thống con bộ nhớ giống hệt nhau ở cả hai cấu hình: bus 80 kênh 16-bit (1.280-bit) chạy ở 9.375 MT/s cho 1,5 TB/s. Điểm khác duy nhất là số die DRAM xếp chồng trong mỗi gói. Nói cách khác, 480GB là «trần mà thiết kế cho phép», còn 160GB là «cấu hình Intel thực sự xuất xưởng». Dù theo cách nào, đây cũng thuộc nhóm dung lượng lớn nhất từng công bố cho một card suy luận PCIe. Để so sánh, GPU Rubin của NVIDIA mang 288GB HBM4 và dòng MI450 của AMD được cho là 432GB — xét riêng dung lượng thô, thiết kế LPDDR đảo ngược thứ bậc quen thuộc.
Phép tính kích thước mô hình cũng cần sự cẩn trọng tương tự. Ở FP8 (một byte cho mỗi tham số), card 160GB chứa khoảng 160 tỷ tham số trọng số trước khi trừ bộ nhớ đệm KV và chi phí vận hành; tuyên bố «300 tỷ tham số trên một card» của Intel tương ứng với cấu hình 480GB. Hệ thống tám card «hơn một nghìn tỷ tham số» cũng giả định 480GB × 8 = 3,84TB bộ nhớ gộp. Các con số không sai — nhưng cấu hình tham chiếu phải luôn đi kèm với chúng.
Vì sao là LPDDR5X (1): suy luận tắc ở bộ nhớ, không phải ở tính toán
Huấn luyện và suy luận dùng bộ nhớ theo cách khác nhau. Huấn luyện lặp lại các phép nhân ma trận khổng lồ, nên cả FLOPS lẫn băng thông đều quan trọng. Suy luận — đặc biệt là giai đoạn giải mã phát ra từng token một — là cuộc chơi của băng thông khi kích thước batch nhỏ: mỗi token đều đòi hỏi đọc toàn bộ trọng số của mô hình từ bộ nhớ một lần, vì vậy thời gian truyền hết trọng số quyết định độ trễ giữa các token.
Nhưng trong vận hành dịch vụ thực tế, băng thông không phải bức tường duy nhất. Khi số kết nối đồng thời tăng và ngữ cảnh dài ra, bộ nhớ đệm KV ngốn bộ nhớ rất nhanh. Ràng buộc quyết định trở thành: mô hình có vừa trên một card không, và card đó gánh được bao nhiêu yêu cầu đồng thời với bao nhiêu ngữ cảnh? Nếu dung lượng không đủ, mô hình phải bị chia ra nhiều card, và lưu lượng giữa các card cùng phần tính toán nhàn rỗi trở thành chi phí thuần túy. Đó chính xác là điểm Intel đặt cược. D270 nhường một bậc độ lớn băng thông cho các đầu bảng HBM, nhưng nhân dung lượng lên hai đến ba lần với chỉ một phần nhỏ giá card và công suất — và trong chế độ đó, chi phí trên mỗi token là thứ chiến thắng.
Đặt trong con số: 1,5 TB/s không chạm tới nổi một chồng HBM4 đơn lẻ (2,8 TB/s trở lên), càng không nói tới hàng chục TB/s của đầu bảng 12 chồng. Đổi lại, D270 là card 350W làm mát bằng không khí. Khi các đầu bảng HBM vượt 1.000W và buộc phải dùng rack làm mát bằng chất lỏng, D270 cắm vừa vào khe PCIe trống của một máy chủ doanh nghiệp sẵn có. Intel không bán hiệu năng đỉnh; hãng bán dung lượng suy luận có thể triển khai ngay hôm nay, trên hạ tầng đã tồn tại.
Vì sao là LPDDR5X (2): chi phí trên mỗi GB và khả năng mua được
Lập luận thứ hai là tiền và nguồn cung. HBM4 được bàn ở mức khoảng 31–32 đô la mỗi GB — gấp đôi mức 17–18 đô la mỗi GB của HBM3E (ước tính của ngành). LPDDR5X, ngay cả sau các đợt tăng giá của siêu chu kỳ, vẫn giao dịch quanh mức 12 đô la mỗi GB ở cấp gói 12GB — chưa bằng một nửa HBM4. Đóng gói càng nới rộng khoảng cách: HBM thừa hưởng nút thắt xếp chồng TSV và interposer trên năng lực đóng gói tiên tiến, trong khi LPDDR5X là DRAM hàng hóa được hàng trăm triệu điện thoại và PC tiêu thụ mỗi năm, với nguồn cung ứng rộng và đóng gói tiêu chuẩn.
Rủi ro mua sắm là thực tế của năm 2026. Sản lượng HBM năm 2026 của Samsung và SK hynix về cơ bản đã bán hết, và Micron được cho là đã cam kết trước phần lớn nguồn cung năm 2027. Gia nhập hàng chờ HBM hôm nay đồng nghĩa chờ phân bổ của năm 2027. Ngược lại, LPDDR5X có thể mua ngay bây giờ. Với một kẻ đến sau có ưu tiên thấp trong hàng phân bổ HBM, một «card suy luận không có HBM» vừa là cắt giảm chi phí vừa là phòng hộ trước rủi ro mua sắm. Intel cũng không phải hãng duy nhất đi tới kết luận này: các chip suy luận tự phát triển của Meta, dòng MTIA, dùng bộ nhớ cấp LPDDR, và silicon suy luận của Tesla cũng lựa chọn cùng họ.
Ba loại bộ nhớ đối đầu: HBM4 vs LPDDR5X vs GDDR7
| Khía cạnh | HBM4 | LPDDR5X | GDDR7 |
|---|---|---|---|
| Băng thông mỗi chồng/chip | 2,8+ TB/s mỗi chồng | ~77 GB/s mỗi gói (1,5 TB/s mỗi card) | Tới ~144 GB/s mỗi chip |
| Tổng băng thông mỗi bộ tăng tốc | Hàng chục TB/s (12 chồng) | 1,5 TB/s (D270) | ~1,8 TB/s (512-bit) |
| Dung lượng mỗi bộ tăng tốc | 288–432GB | 160–480GB | 32–96GB |
| Chi phí mỗi GB | ~31–32 đô la (ước tính ngành) | ~12 đô la (giá đợt tăng 2026) | Thấp hơn nhiều so với HBM (đồ họa hàng hóa) |
| Hồ sơ công suất | Cao, gồm cả hệ thống interposer | Năng lượng trên mỗi bit thấp nhất (thiết kế di động) | Năng lượng trên mỗi bit cao hơn LPDDR |
| Đóng gói | Bắt buộc chồng TSV + interposer | Gói tiêu chuẩn, gắn trên bo mạch | Gắn trên bo mạch |
| Tình hình cung ứng | Sản lượng 2026 đã bán hết; chạy đua phân bổ | DRAM hàng hóa; nguồn cung rộng | Tranh chấp với nhu cầu đồ họa |
| Bên áp dụng tiêu biểu | NVIDIA Rubin, dòng MI450 của AMD, đầu bảng TPU/Trainium | Intel GPU D-Series, Grace/Vera của NVIDIA (bộ nhớ CPU), Meta MTIA | Dòng GeForce RTX 50 và các card đồ họa khác |
Lưu ý: số liệu chi phí trên mỗi GB là ước tính biến động mạnh theo thời điểm và điều kiện hợp đồng; chúng được đưa ra để minh họa hướng đi — LPDDR5X chưa bằng một nửa HBM4. Số liệu băng thông theo thông số mà mỗi hãng công bố.
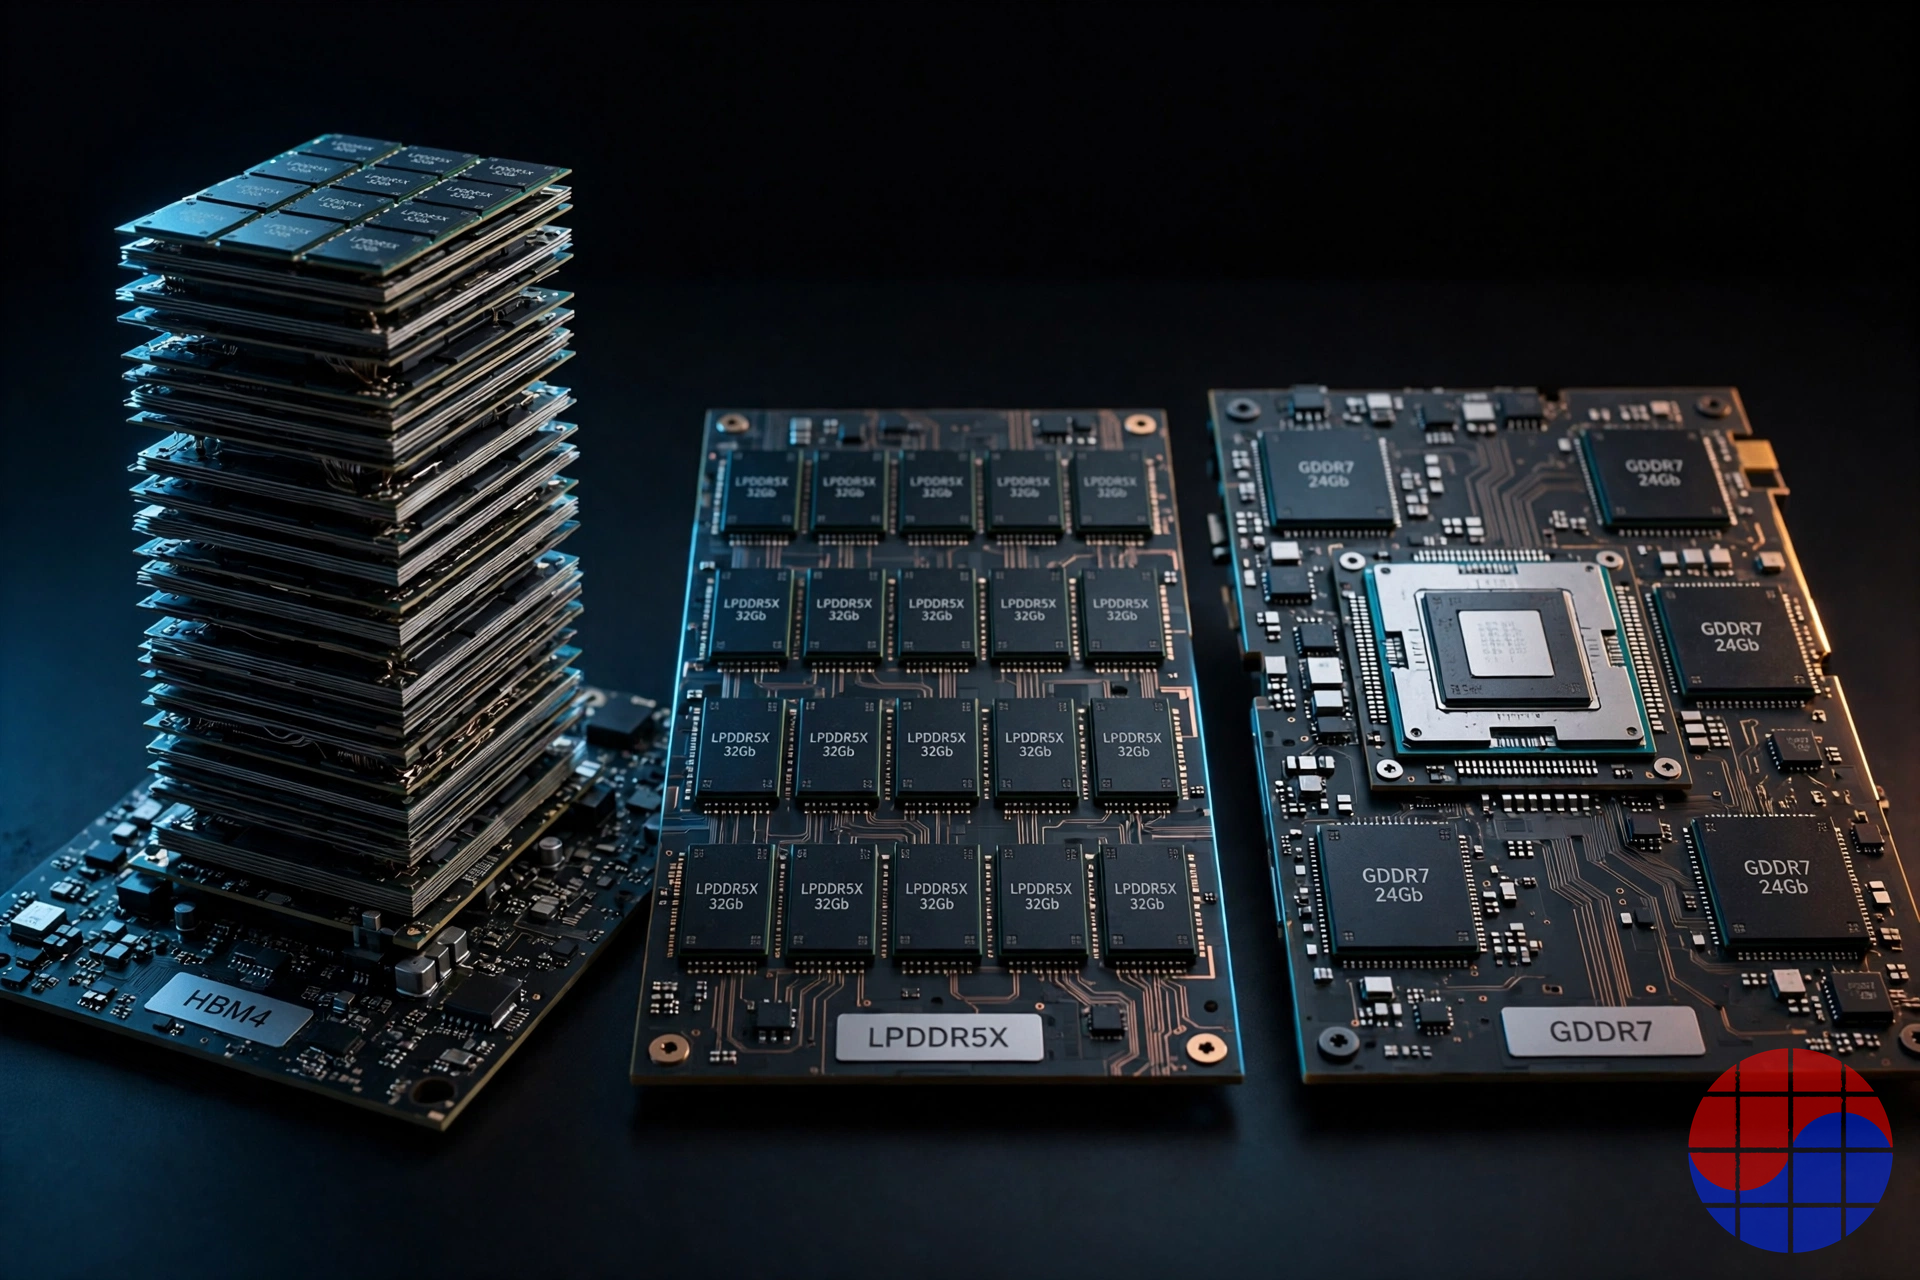
Bảng này không phải một bảng xếp hạng; đó là lựa chọn về việc mua đứt ràng buộc nào. HBM4 mua băng thông và chấp nhận chi phí dung lượng cùng rủi ro phân bổ. GDDR7 rẻ và có băng thông khá, nhưng dung lượng mỗi chip nhỏ khiến khó đặt hàng trăm gigabyte lên một card. LPDDR5X từ bỏ băng thông và thắng ở chi phí dung lượng, tính sẵn có và công suất. Khi nhu cầu suy luận dịch chuyển từ «token nhanh nhất» sang «token rẻ nhất», trọng tâm của bảng này nghiêng về phía LPDDR.
Ý nghĩa đối với nhà cung cấp: Samsung, SK hynix, Micron — và SOCAMM
Với ba ông lớn bộ nhớ, tín hiệu rất đơn giản: nhu cầu DRAM của trung tâm dữ liệu AI không hội tụ chỉ vào HBM. Ở phía CPU, sản lượng lớn đã chảy sang LPDDR. Grace của NVIDIA mang tới 480GB LPDDR5X mỗi CPU; thế hệ kế nhiệm Vera nâng lên tối đa 1,5TB ở 1,2 TB/s thông qua mô-đun SOCAMM2. Một rack Vera Rubin NVL72 chứa 36 CPU Vera — tới 54TB bộ nhớ CPU mỗi rack. Cộng thêm các bộ tăng tốc LPDDR như D270, LPDDR cho trung tâm dữ liệu sẽ lớn lên từ «bộ nhớ cạnh CPU» thành một trục nhu cầu độc lập.
Việc mô-đun hóa rất quan trọng. LPDDR khởi đầu là linh kiện di động hàn chết trên bo mạch; định dạng SOCAMM của NVIDIA đã định nghĩa lại nó thành linh kiện máy chủ có thể thay thế và nâng cấp. Samsung, SK hynix và Micron đều tham gia cung ứng SOCAMM, và NVIDIA được cho là đã đưa Nanya của Đài Loan vào chuỗi cung ứng LPDDR cho Vera — sự đa dạng hóa tự nó đã cho thấy quy mô sản lượng lớn đến mức nào.
Từ ghế của nhà cung cấp Hàn Quốc, nhu cầu này là con dao hai lưỡi. Một mặt, một hồ nhu cầu mới do AI thúc đẩy lấp đầy thị trường DRAM hàng hóa đang bị quá trình chuyển đổi sang HBM rút cạn — nhu cầu máy chủ là một phần lý do giá LPDDR5X tăng hai con số mỗi quý trong suốt năm 2026. Mặt khác, LPDDR vẫn là DRAM hàng hóa: không có biên lợi nhuận vượt trội kiểu HBM, và phải đối mặt trực tiếp với cạnh tranh giá từ những kẻ theo sau như CXMT. Dù vậy, hướng đi của sản lượng là không thể nhầm lẫn. Từ năm 2027, nhu cầu bit LPDDR trong hạ tầng AI tăng trưởng cấu trúc từ cả ổ cắm CPU lẫn bộ tăng tốc suy luận.
Khung cạnh tranh: ngay cả NVIDIA cũng đặt LPDDR cạnh CPU của mình
Đọc lựa chọn của Intel thuần túy như «phương án dự phòng của một công ty không giành được HBM» là bỏ lỡ một nửa câu chuyện. NVIDIA — khách hàng mua HBM lớn nhất hành tinh — tự mình vận hành chiến lược bộ nhớ hai đường: HBM4 trên GPU, LPDDR5X trên CPU, chia các vai trò khát băng thông và khát dung lượng theo tải công việc. Từ Grace sang Vera, dung lượng bộ nhớ CPU tăng gấp ba từ 480GB lên 1,5TB và băng thông tăng từ 512 GB/s lên 1,2 TB/s; theo quan điểm của NVIDIA, CPU của kỷ nguyên AI tác nhân là linh kiện phải mang nhiều bộ nhớ hơn, chứ không phải ít hơn.
AMD giữ sườn đối diện: dòng MI duy trì đường lối chính thống HBM ở khắp nơi và tranh suy luận bằng băng thông. Các ASIC tùy chỉnh chia làm hai hướng — TPU của Google và Trainium của AWS chọn HBM, MTIA của Meta chọn bộ nhớ cấp LPDDR. Đồng thuận đang nổi lên của ngành là một cấu trúc hai tầng: HBM cho huấn luyện và phục vụ tiền tuyến; LPDDR lớn lên ở phía dưới, trong suy luận quy mô lớn và bộ nhớ CPU. D270 là nỗ lực quy mô lớn đầu tiên nhằm tấn công tầng dưới đó trong dạng thức GPU.
Chase's Take
Bóc đi thương hiệu, sản phẩm này là một chiến lược mua sắm bộ nhớ khoác áo GPU. Intel né tránh cuộc chiến tính toán mà hãng không thể thắng, và tung ra dung lượng suy luận lớn nhất có thể xây dựng từ loại bộ nhớ thực sự mua được trong năm 2026–2027. Con số 1,3 PFLOPS không có gì đặc biệt; sự kết hợp — 480GB trên một card 350W làm mát bằng không khí — là tọa độ mà không đối thủ nào chiếm giữ.
Với các nhà sản xuất bộ nhớ Hàn Quốc, đây là làn gió thuận thầm lặng. Phía sau mức giá hào nhoáng của HBM, một trục nhu cầu AI thứ hai — LPDDR cho máy chủ — đang cứng lại thành sản lượng thật. Khi 1,5TB mỗi ổ cắm của Vera và tới 480GB mỗi card của D270 bắt đầu xuất xưởng cùng lúc, LPDDR5X sẽ được định giá lại từ linh kiện điện thoại thông minh thành hạ tầng AI. Cái bẫy nằm ở chỗ: giá LPDDR tăng sẽ gặm nhấm chính logic TCO của Intel. LPDDR càng đắt, biên của phương trình «bộ nhớ rẻ, suy luận rẻ» càng mỏng. Số phận của sản phẩm này sẽ do đường cong giá bộ nhớ quyết định nhiều hơn là do chính silicon của nó.
Để xem cấu trúc chi phí bộ nhớ suy luận đối chiếu với chính các con số của phe HBM, xem thêm: No HBM Needed? Intel's 480GB LPDDR5X Bet and the Inference Memory TCO War
Rủi ro và những điều chưa được biết
Thứ nhất, bản chất của các con số hiệu năng: 1,3 PFLOPS là đỉnh lý thuyết chưa có benchmark độc lập, và thông lượng token thực tế phụ thuộc nhiều vào tối ưu kernel và độ chín của ngăn xếp phần mềm. Thứ hai, hệ sinh thái phần mềm: sức hút của CUDA cũng mạnh trong suy luận, và việc ngăn xếp OpenVINO/oneAPI khớp nối trơn tru đến đâu với các khung phục vụ sản xuất sẽ quyết định mức độ áp dụng — dòng Gaudi của Intel đã thua vì hệ sinh thái hơn là vì silicon, một tiền lệ không thể bỏ qua. Thứ ba, trần băng thông: 1,5 TB/s có thể trở thành nút thắt khi giải mã batch lớn cho các mô hình rất lớn, và chính Intel cũng vạch ranh giới ngoài huấn luyện và phục vụ tiền tuyến. Thứ tư, điều khoản thương mại còn để trống: không giá, không ngày phát hành, với xuất xưởng số lượng lớn được bàn cho năm 2027 — đến lúc đó HBM4E đã xuất hiện và giá LPDDR có thể đã leo cao hơn, vẽ lại bản đồ cạnh tranh. Cuối cùng, phản ứng đầu tiên của thị trường khá lạnh nhạt: cổ phiếu Intel được cho là đã đóng cửa giảm trong ngày công bố.
FAQ
Q: LPDDR5X 480GB của D270 có phải là thông số đã xác nhận không? A: Nó là thật ở dạng cấu hình tối đa, nhưng card của chính Intel mang 160GB. Con số 480GB là trần dành cho các bo mạch ODM lắp gói mật độ cao hơn (lớp 192Gb). Phần lớn trích dẫn «480GB» trên mạng xã hội đều bỏ qua điều kiện đó.
Q: Vì sao dùng LPDDR5X thay vì HBM trong GPU suy luận? A: Vì suy luận sản xuất bị giới hạn ít bởi tính toán thô hơn là bởi dung lượng để chứa mô hình và bộ nhớ đệm KV, cùng chi phí trên mỗi token. LPDDR5X được bàn ở mức chưa bằng một nửa chi phí trên mỗi GB của HBM4, dễ mua hơn nhiều và tiêu thụ ít điện hơn. Thiết kế hy sinh băng thông đỉnh để thắng ở dung lượng và chi phí.
Q: Băng thông 1,5 TB/s của D270 ở mức nào? A: Dưới một chồng HBM4 đơn lẻ (2,8 TB/s trở lên) và thấp hơn một bậc độ lớn so với các bộ tăng tốc đầu bảng ở mức hàng chục TB/s — nhưng cùng dải với cấu hình GDDR7 512-bit (~1,8 TB/s). Đây là con số được xây dựng để cạnh tranh về dung lượng trên mỗi watt và mỗi đô la, không phải về thông lượng tuyệt đối.
Q: Điều này có ý nghĩa gì với Samsung Electronics và SK hynix? A: Nó báo hiệu nhu cầu LPDDR của trung tâm dữ liệu AI đang mở rộng từ CPU máy chủ (SOCAMM của Grace và Vera của NVIDIA) sang các bộ tăng tốc suy luận. Biên lợi nhuận sẽ không sánh được với HBM, nhưng tăng trưởng sản lượng mang tính cấu trúc đã hiện rõ, và cả hai công ty Hàn Quốc đều nằm trong chuỗi cung ứng SOCAMM.
Q: Khi nào có thể mua D270 và với giá bao nhiêu? A: Tính đến tháng 10 năm 2026, linh kiện này đang ở giai đoạn gửi mẫu cho khách hàng. Intel chưa công bố giá bán hay ngày phát hành chính thức; xuất xưởng số lượng lớn được bàn cho năm 2027.
📩 Đăng ký bản tin VLSI Korea
Nhận phân tích bán dẫn chuyên sâu mỗi ngày qua email trước tiên. Đăng ký miễn phí.


