 VLSI Korea
Nhà máy AI trong 14 ngày, không phải 6 tháng: Vera Rubin vào sản xuất hàng loạt và nước cờ tốc độ DSX POD (HBM4)
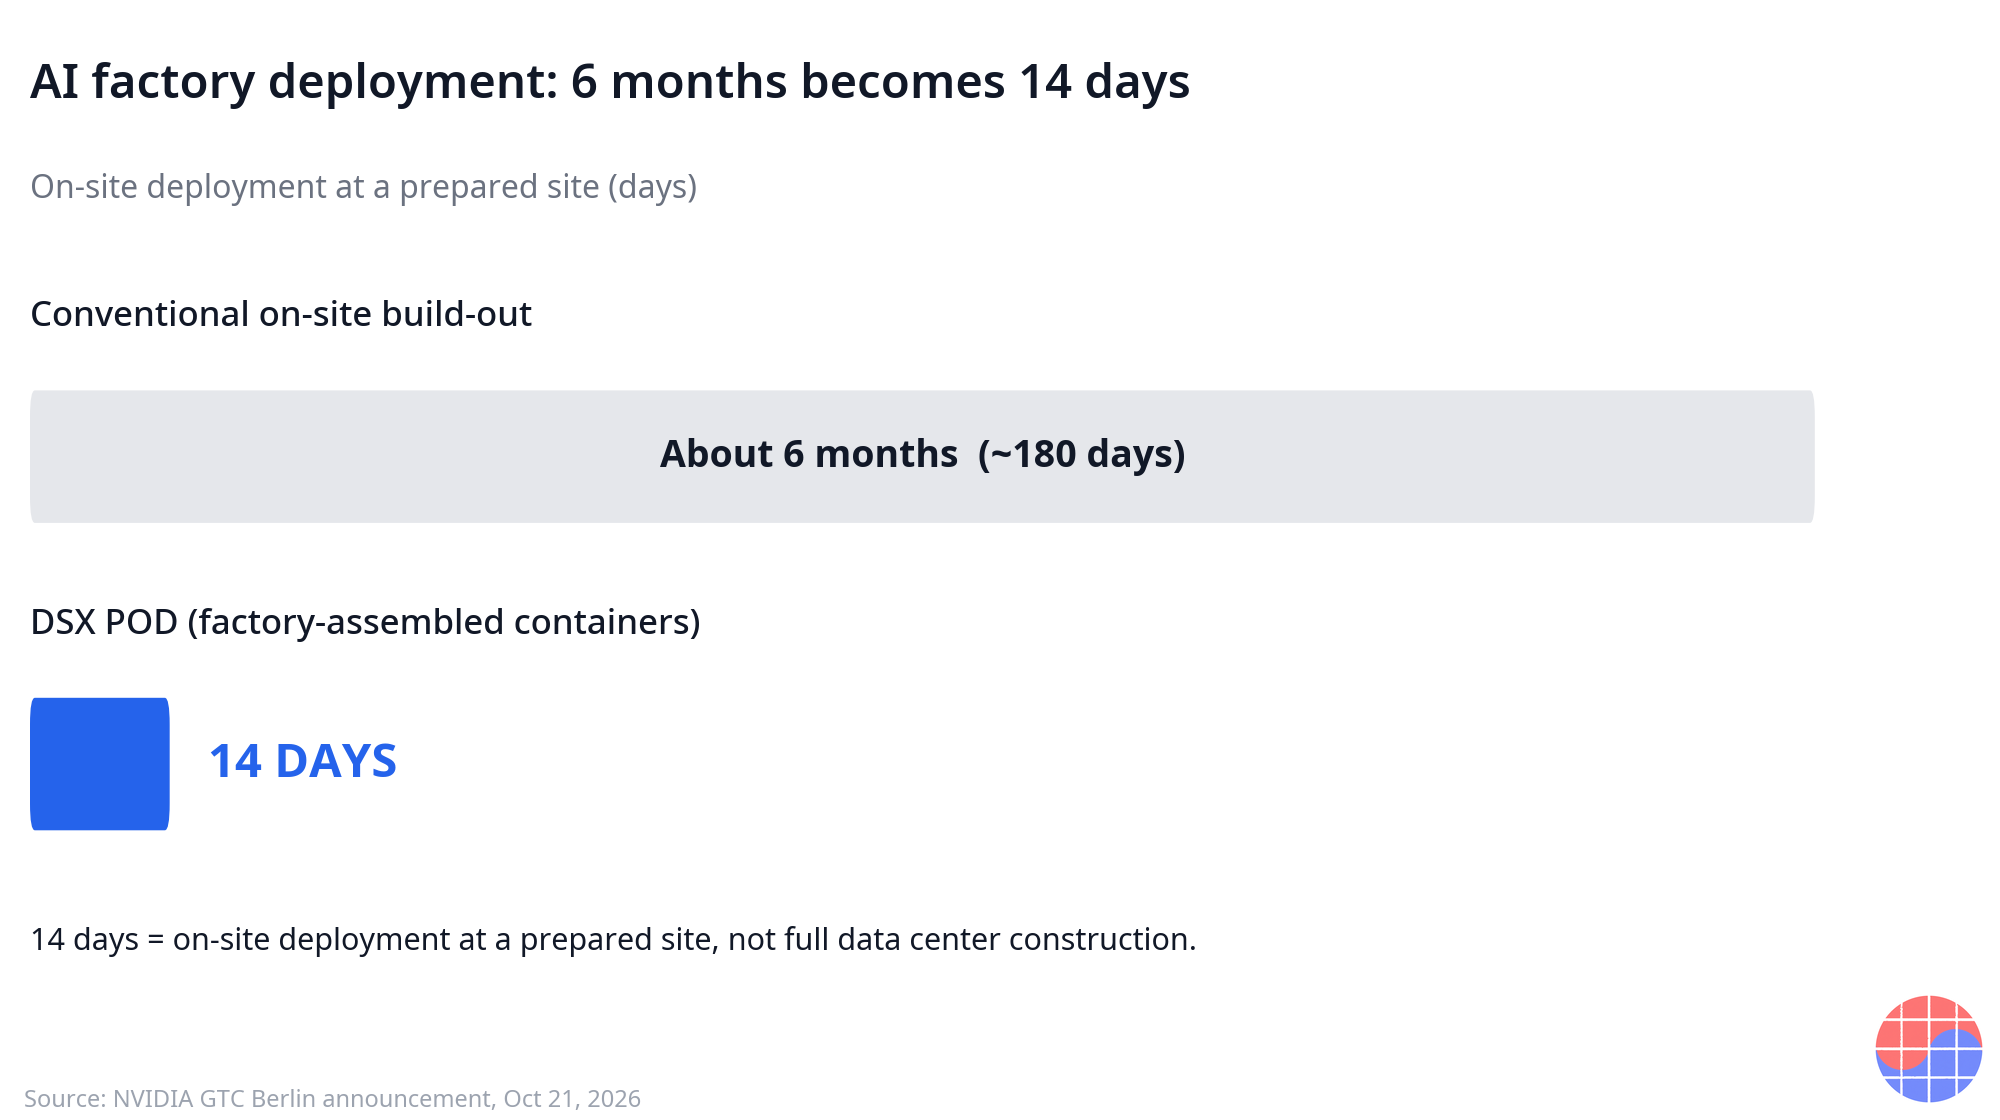
Vera Rubin đã sản xuất toàn diện và DSX POD rút triển khai tại địa điểm đã chuẩn bị từ khoảng 6 tháng xuống 14 ngày. Một container: 7 rack NVL72, 504 GPU. Tốc độ giờ là doanh thu.


Nút thắt của hạ tầng AI giờ không còn là con chip. Đó là công trường — và NVIDIA vừa chuyển nhà máy đó vào trong nhà máy.
Tóm tắt 30 giây
- Vera Rubin đã vào sản xuất hàng loạt. Tại GTC Berlin ngày 21 tháng 10 năm 2026, CEO Jensen Huang tuyên bố nền tảng AI thế hệ tiếp theo của NVIDIA đã bước vào giai đoạn sản xuất toàn diện (full production).
- DSX POD biến cả nhà máy AI thành một sản phẩm có thể giao hàng. Thiết kế tham chiếu này lắp ráp và kiểm chứng toàn bộ nhà máy AI Vera Rubin trong các container mô-đun ngay tại nhà máy, rồi xuất xưởng. Việc triển khai tại chỗ, ở một địa điểm đã chuẩn bị sẵn, rút từ khoảng 6 tháng xuống tối thiểu 14 ngày.
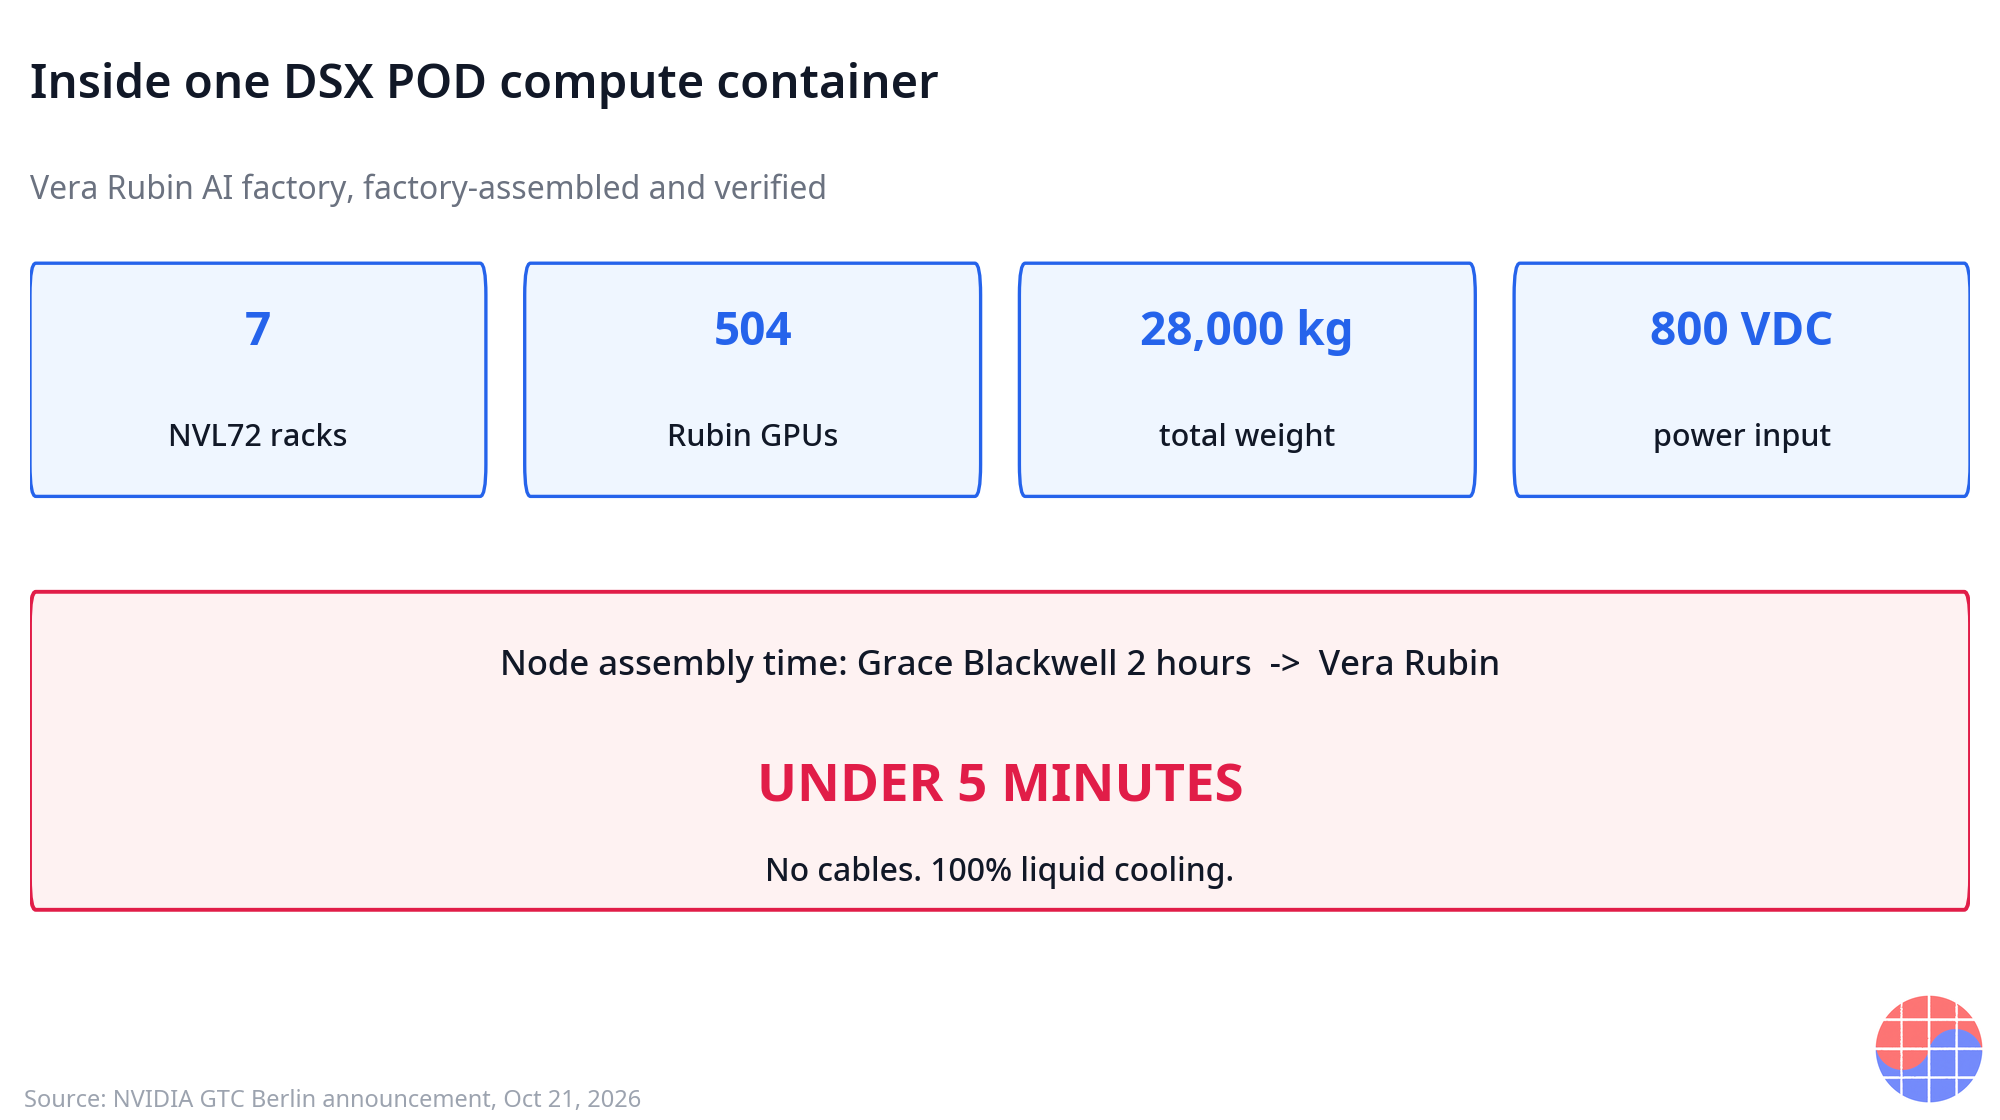
- Một container điện toán là một cỗ máy thực thụ: 7 rack Vera Rubin NVL72, 504 GPU Rubin, khoảng 28.000 kg, cấp nguồn 800 VDC. Một container không còn là một cái thùng. Nó là một khối xây dựng của một trung tâm dữ liệu.
- Chính nút (node) cũng được thiết kế lại vì tốc độ lắp ráp. Các node Vera Rubin không có cáp, làm mát bằng chất lỏng 100%, và cắt thời gian lắp ráp node từ 2 giờ trên Grace Blackwell xuống dưới 5 phút.
- 17 đối tác đứng sau thiết kế này, gồm Dell, HPE, Lenovo, Schneider Electric, Vertiv, Eaton và Foxconn (Ingrasys), với kế hoạch giao hàng từ đầu năm 2027. Cần đọc kỹ con số 14 ngày: đó là thời gian triển khai tại chỗ ở nơi hạ tầng điện và làm mát đã được chuẩn bị sẵn — không phải thời gian xây dựng toàn bộ một trung tâm dữ liệu.
Bối cảnh
Hàng chờ đã chuyển từ fab ra hiện trường
Trong ba năm, câu chuyện hạ tầng AI là câu chuyện về nguồn cung chip. GPU khan hiếm, HBM khan hiếm, đóng gói tiên tiến khan hiếm, và ai giành được wafer cùng bộ nhớ thì giành được doanh thu. Sự khan hiếm đó chưa biến mất, nhưng phía sau nó đã hình thành một hàng chờ thứ hai: công việc vật lý biến phần cứng đã giao thành một nhà máy AI đang vận hành. Rack đến nơi, rồi bắt đầu hàng tháng tích hợp tại chỗ — phân phối điện, vòng làm mát, mạng, lắp ráp từng node, kiểm thử và gỡ lỗi, phần lớn do các kỹ sư hiện trường khan hiếm thực hiện trong những tòa nhà mà bản thân chúng vẫn đang được hoàn thiện.
Các công bố của NVIDIA ngày 21 tháng 10 năm 2026 tại GTC Berlin tấn công trực diện hàng chờ thứ hai đó. Tin tức về nền tảng là Vera Rubin, kiến trúc kế nhiệm Grace Blackwell, đã vào sản xuất toàn diện, theo lời CEO Jensen Huang. Tin tức về kinh doanh là DSX POD: một thiết kế tham chiếu trong đó toàn bộ nhà máy AI Vera Rubin được lắp ráp và kiểm chứng trong các container mô-đun trước khi rời nhà máy, để địa điểm nhận được một hệ thống đã được kiểm thử thay vì một đống linh kiện.
DSX POD thực chất là gì
Cách hiểu DSX POD tốt nhất là sự thay đổi về nơi diễn ra tích hợp. Trong mô hình truyền thống, tích hợp diễn ra tại điểm đến, dưới điều kiện công trường và tính biến động của công trường. Trong mô hình POD, tích hợp diễn ra tại điểm xuất phát, dưới điều kiện nhà máy, nơi cùng một công việc được lặp lại, đo lường và cải tiến. Container là đơn vị giao hàng: các container điện toán chở rack, và thiết kế được quy định đủ chặt để nội dung của một container được biết đến từng kilogram và từng volt trước khi xuất xưởng.
| Container điện toán DSX POD | Thông số |
|---|---|
| Rack mỗi container | 7 rack Vera Rubin NVL72 |
| GPU mỗi container | 504 GPU Rubin |
| Trọng lượng | Khoảng 28.000 kg |
| Nguồn vào | 800 VDC |
| Thiết kế node | Không cáp, làm mát bằng chất lỏng 100% |
| Thời gian lắp ráp node | Dưới 5 phút (Grace Blackwell: 2 giờ) |
Nguồn: các công bố của NVIDIA tại GTC Berlin, ngày 21 tháng 10 năm 2026. Liên kết ở ghi chú cuối bài.
Con số lắp ráp node đáng để dừng lại suy ngẫm. Cắt lắp ráp từ 2 giờ xuống dưới 5 phút không phải là một tính năng tiện ích. Đó là kết quả khi một nền tảng được thiết kế ngược từ quy trình triển khai: việc đi cáp, vốn trong lịch sử chiếm phần lớn cả thời gian lắp ráp lẫn lỗi hiện trường, bị loại bỏ hoàn toàn khỏi node, và làm mát chuyển hoàn toàn sang chất lỏng. Một node lắp ráp trong vài phút cũng là một node thay thế trong vài phút, và điều đó thay đổi kinh tế bảo trì của toàn bộ hệ thống đã lắp đặt trong cả một thập kỷ.
Con số 14 ngày, nói một cách chính xác
Con số được trích dẫn nhiều nhất từ công bố này — triển khai tối thiểu 14 ngày, so với khoảng 6 tháng xây dựng tại chỗ theo cách truyền thống — cần được gắn kèm điều kiện của nó, bởi điều kiện chính là nơi mô hình kinh doanh sống. 14 ngày là thời gian triển khai tại chỗ ở một địa điểm đã chuẩn bị sẵn: nơi hạ tầng điện, làm mát và tòa nhà đã sẵn sàng. Đó không phải là thời gian xây dựng toàn bộ một trung tâm dữ liệu. Đất, giấy phép, kết nối lưới điện và khung tòa nhà vẫn tốn bao lâu thì tốn bấy lâu.
Sự phân biệt đó không làm công bố yếu đi. Nó làm rõ ai nắm bắt giá trị. POD nén đoạn lịch trình nằm giữa «hạ tầng sẵn sàng» và «nhà máy AI bắt đầu tạo token» — đoạn quyết định khi nào vốn của khách hàng bắt đầu sinh lời. Mọi thứ đứng trước địa điểm đã chuẩn bị vẫn là bài toán xây dựng và tiện ích, và chính vì vậy danh sách đối tác quan trọng ngang với chiếc container.
Phân tích kinh doanh chuyên sâu
Tốc độ là ghi nhận doanh thu
Trong hạ tầng AI, tốc độ triển khai không phải là một chi tiết vận hành. Nó là độ dốc của đường cong doanh thu. Một hyperscaler hay nhà vận hành nhà máy AI đưa công suất lên mạng sớm hơn vài tháng sẽ bắt đầu bán token, lượt huấn luyện và phiên bản đám mây sớm hơn vài tháng, trên phần cứng mà nửa đời cạnh tranh của nó được đo bằng quý. Khi một thế hệ nền tảng ở tuyến đầu kéo dài khoảng một năm, cái đuôi tích hợp 6 tháng có thể ăn mất một nửa tuổi thọ kinh tế của tài sản trước khi nó kiếm được đồng đầu tiên ở mức sử dụng tối đa.
Đó là lăng kính để đọc DSX POD. Rút ngắn triển khai tại địa điểm đã chuẩn bị từ khoảng 6 tháng xuống tối thiểu 14 ngày kéo doanh thu về sớm hơn vài tháng cho mỗi địa điểm, và nó làm điều đó đúng vào lúc nhu cầu điện toán AI đang xếp hàng. Khách hàng không mua container. Khách hàng mua thời gian trên lịch — đầu vào khan hiếm nhất trong toàn bộ cuộc xây dựng AI, khan hiếm hơn chip, vì chip có thể được đẩy nhanh còn lịch thì không.
| Mô hình triển khai | Triển khai tại chỗ, ở địa điểm đã chuẩn bị | Thời gian đi đâu |
|---|---|---|
| Xây dựng truyền thống | Khoảng 6 tháng (khoảng 180 ngày) | Tích hợp rack tại chỗ, đi cáp, đấu nối làm mát, lắp ráp node, kiểm thử theo giai đoạn |
| DSX POD | Tối thiểu 14 ngày | Định vị các container đã lắp ráp và kiểm chứng sẵn, cùng chạy thử cuối cùng |
Nguồn: các công bố của NVIDIA tại GTC Berlin, ngày 21 tháng 10 năm 2026. Liên kết ở ghi chú cuối bài.
Ngăn xếp của NVIDIA leo thêm một tầng nữa
Mô hình chiến lược đến nay đã quen thuộc, nhưng POD mở rộng nó. NVIDIA leo từ chip lên bo mạch, từ bo mạch lên rack (NVL72), từ rack lên hệ thống nối mạng — và giờ, với thiết kế tham chiếu DSX POD, từ hệ thống lên chính nhà máy. Mỗi lần leo lên mở rộng doanh thu mà NVIDIA và hệ sinh thái của hãng có thể gắn vào một gigawatt công suất AI, và mỗi lần leo lên làm sâu thêm sự phụ thuộc của khách hàng vào thiết kế tham chiếu định nghĩa tầng đó.
Một thiết kế tham chiếu là một dạng quyền lực đặc biệt. NVIDIA không cần tự sản xuất container để kiểm soát tầng container; hãng cần ngành công nghiệp xây dựng theo đặc tả của mình, để đặc tả trở thành giao diện mà mọi bên khác phải đáp ứng. 17 đối tác ra mắt — Dell, HPE và Lenovo ở hệ thống; Schneider Electric, Vertiv và Eaton ở hạ tầng điện và làm mát; Foxconn (thông qua Ingrasys), Delta, GIGABYTE, Pegatron, QCT, Wistron và những bên khác trên nền ODM và linh kiện — không chỉ là nhà cung cấp. Họ là mạng phân phối của tiêu chuẩn. Giao hàng dự kiến bắt đầu từ đầu năm 2027.
Tích hợp trước tại nhà máy di chuyển nút thắt, không xóa bỏ nó
Tích hợp trước là một chiến lược sản xuất áp dụng cho một bài toán xây dựng, và kinh tế của nó đi theo logic sản xuất. Lắp ráp tại nhà máy biến lao động hiện trường đầy biến động thành công việc dây chuyền có thể lặp lại: chất lượng được kiểm tra nơi thiết bị kiểm thử đặt, lỗi được tìm thấy nơi các kỹ sư thiết kế node ngồi, và đường cong học hỏi tích lũy theo mỗi container được chế tạo thay vì khởi động lại ở mỗi địa điểm. Thiết kế lại node — không cáp, làm mát hoàn toàn bằng chất lỏng, lắp ráp dưới 5 phút — là nền tảng được uốn theo dây chuyền đó.
Nhưng nút thắt di chuyển chứ không biến mất. Nếu container có thể được triển khai trong 14 ngày ở một địa điểm đã chuẩn bị, thì chính địa điểm đã chuẩn bị trở thành ràng buộc: kết nối lưới điện, thời gian giao thiết bị điện, hạ tầng làm mát và giấy phép. Sự hiện diện của Schneider Electric, Vertiv và Eaton trong danh sách đối tác là sự thừa nhận đúng điều đó — hàng chờ tiếp theo thuộc về điện. Đó cũng là lý do cách đọc trung thực về công bố này gắn con số 14 ngày với điều kiện của nó. Trong số những người thắng ở giai đoạn tiếp theo sẽ có bên có thể giao các địa điểm đã chuẩn bị theo nhịp mà container giờ có thể được lấp đầy.
Lớp phần mềm: DSX MaxLPS và tuyên bố hiệu quả
NVIDIA còn công bố phần mềm DSX MaxLPS, mà theo hãng, mang lại cùng một đầu ra AI với mức điện năng ít hơn tới 30%. Trong một ngành mà ràng buộc trói buộc ngày càng là megawatt chứ không phải rack, một tuyên bố hiệu quả ở cấp phần mềm với quy mô như vậy mang trọng lượng chiến lược: nếu đầu ra trên mỗi watt tăng, cùng một kết nối lưới điện hỗ trợ được nhiều điện toán có thể bán hơn, và công suất hiệu dụng của mỗi địa điểm đã chuẩn bị tăng lên mà không cần xây dựng mới. Tuyên bố này là của NVIDIA, được nêu như một con số công bố, và thị trường sẽ kiểm chứng nó trong triển khai — nhưng ngay cả hướng đi cũng quan trọng, vì hiệu quả điện năng cộng hưởng với tốc độ triển khai: lắp đặt nhanh hơn, và đầu ra trên mỗi megawatt đã lắp đặt lớn hơn.
Tín hiệu hệ sinh thái còn mở rộng tới lớp đám mây: A5X của Google Cloud, xây dựng trên Vera Rubin, dự kiến phát hành rộng rãi vào tháng 11. Các nền tảng tuyến đầu giờ ra mắt đồng thời dưới dạng sản phẩm để mua, container để triển khai và phiên bản đám mây để thuê — ba kênh, một chuỗi cung ứng và một hàng chờ phân bổ phía sau tất cả.
Mối liên hệ với HBM4
Mỗi rack Vera Rubin được giao cũng là một lô hàng HBM4. Bộ nhớ của nền tảng này là HBM4, nghĩa là quá trình tăng sản lượng Vera Rubin và các lô giao POD từ đầu năm 2027 chuyển trực tiếp thành sản lượng HBM4 cho các nhà sản xuất bộ nhớ đã đạt chuẩn vào nền tảng. Đây là mối liên hệ lặng lẽ giữa một công bố về tốc độ triển khai ở Berlin và sổ đơn hàng của ngành bộ nhớ: tốc độ triển khai quyết định rack chuyển thành hệ thống đang vận hành nhanh đến đâu, và hệ thống đang vận hành là thứ kéo vòng đơn hàng GPU và HBM tiếp theo. Một mô hình triển khai nhanh hơn không chỉ kéo doanh thu của NVIDIA về phía trước. Nó siết nhịp của toàn bộ chuỗi — đóng gói, HBM, đế và thiết bị điện — nuôi nhà máy.
Góc nhìn của Chase
Cách đọc lười biếng về DSX POD là «NVIDIA phát minh ra một trung tâm dữ liệu nhanh hơn». Cách đọc đúng là về việc đoạn nào của cuộc xây dựng AI vẫn còn vài tháng chùng, và ai vừa giành lấy nó.
Chip chiếm các tiêu đề trong ba năm vì chip là ràng buộc. Nhưng một rack đã giao mà mất hàng tháng tích hợp hiện trường là hàng tồn kho, không phải công suất, và ngành này đã âm thầm gánh một lượng khổng lồ của cả hai. POD tấn công vị thế tồn kho đó. Kiểm chứng tại nhà máy, một node không cáp lắp ráp dưới 5 phút, một container được quy định đến từng kilogram — mọi yếu tố đều nhắm vào khoảng cách giữa «phần cứng đã giao» và «phần cứng đang kiếm tiền». NVIDIA nhìn vào lịch xây dựng, tìm khối thời gian chết lớn nhất mà hãng có thể sở hữu một cách hợp lý, và biến nó thành sản phẩm.
Hai hệ quả đang bị đánh giá thấp. Thứ nhất, các thiết kế tham chiếu phân phối lại biên lợi nhuận mà không phân phối lại quyền kiểm soát. 17 đối tác giành được một thị trường thật — các nhà máy AI dạng container giao hàng từ đầu năm 2027 — nhưng họ giành được nó bên trong một đặc tả thuộc sở hữu của NVIDIA, nghĩa là tăng trưởng của hệ sinh thái và sự khóa chặt nền tảng của NVIDIA là cùng một sự kiện nhìn từ hai phía. Thứ hai, công bố này lặng lẽ định nghĩa lại ý nghĩa của «đã chuẩn bị» như một tài sản cạnh tranh. Khi triển khai mất 6 tháng, một địa điểm sẵn sàng và một địa điểm chưa sẵn sàng khác nhau ở một giai đoạn xây dựng. Khi triển khai mất 14 ngày, chúng khác nhau ở gần như toàn bộ lịch trình — và địa điểm, vị thế điện cùng giấy phép trở thành những tài sản chiến lược có thể giao dịch theo cách trước đây không hề có.
Câu hỏi mở là nhịp thực thi. Một thiết kế tham chiếu là một lời hứa cho đến khi container được giao theo sản lượng, và đầu năm 2027 là lúc lời hứa đó có bài kiểm tra cứng đầu tiên: bao nhiêu POD, với tỷ lệ đạt (yield) bao nhiêu, vào bao nhiêu địa điểm thực sự đã chuẩn bị. Hãy theo dõi báo cáo giao hàng của các đối tác, không phải các bài phát biểu chính. Nếu triển khai 14 ngày đứng vững ở hiện trường dù chỉ gần đúng, mọi nền tảng cạnh tranh sẽ buộc phải trả lời một câu hỏi mà trước đây họ chưa từng phải trả lời: không phải chip của họ nhanh đến đâu, mà là nhà máy của họ lắp ráp nhanh đến đâu.
Hệ quả
- Đối với hyperscaler và nhà vận hành nhà máy AI: tốc độ triển khai giờ là một tiêu chí mua sắm ngang hàng với hiệu năng trên mỗi watt. Một nền tảng vào sản xuất sớm hơn vài tháng sẽ kiếm tiền sớm hơn vài tháng — hãy đánh giá khoảng từ địa điểm sẵn sàng tới sản xuất, không chỉ con chip.
- Đối với các đối tác của NVIDIA: POD tạo ra một thị trường ở tầng container từ đầu năm 2027, bên trong đặc tả của NVIDIA. Cơ hội là thật; sự phụ thuộc cũng vậy. Các đối tác có vị thế về điện và làm mát (tầng địa điểm đã chuẩn bị) nắm những lá bài khan hiếm nhất khi nút thắt chuyển sang điện.
- Đối với các nhà sản xuất bộ nhớ: Vera Rubin sản xuất toàn diện, cộng với giao hàng POD từ đầu năm 2027, là một tín hiệu sản lượng HBM4. Tốc độ triển khai ở thượng nguồn quyết định nhịp đơn hàng ở hạ nguồn.
- Đối với các nhà cung cấp nền tảng cạnh tranh: cuộc cạnh tranh đã mở rộng từ chip sang hệ thống triển khai. Một rack đối thủ giờ cạnh tranh không chỉ ở điện toán, mà ở thời gian tới sản xuất tại một địa điểm đã chuẩn bị.
- Đối với nhà đầu tư: theo dõi ba điểm kiểm chứng — giao hàng POD của các đối tác vào đầu năm 2027, báo cáo hiện trường về tuyên bố triển khai 14 ngày, và kết quả đo được của tuyên bố tiết kiệm điện tới 30% của DSX MaxLPS. Công bố đặt ra câu chuyện; giao hàng đặt ra con số.
Câu hỏi thường gặp
NVIDIA DSX POD chính xác là gì?
Đó là một thiết kế tham chiếu biến toàn bộ nhà máy AI Vera Rubin thành các container mô-đun: nhà máy được lắp ráp và kiểm chứng tại nhà máy, rồi được giao đi. Một container điện toán chứa 7 rack Vera Rubin NVL72 với 504 GPU Rubin, nặng khoảng 28.000 kg và nhận nguồn vào 800 VDC. NVIDIA công bố nó tại GTC Berlin ngày 21 tháng 10 năm 2026, với 17 đối tác và kế hoạch giao hàng từ đầu năm 2027.
Con số 14 ngày có nghĩa là một trung tâm dữ liệu có thể xây trong 14 ngày không?
Không. 14 ngày là thời gian triển khai tại chỗ ở một địa điểm đã chuẩn bị sẵn — nơi điện, làm mát và hạ tầng tòa nhà đã sẵn sàng — rút xuống từ khoảng 6 tháng xây dựng tại chỗ theo cách truyền thống. Xây chính địa điểm đó, gồm kết nối lưới điện và giấy phép, vẫn tốn thời gian lâu hơn nhiều. POD nén đoạn giữa «địa điểm sẵn sàng» và «nhà máy AI đang vận hành».
Điều gì đã thay đổi ở node Vera Rubin khiến lắp ráp nhanh đến vậy?
NVIDIA cho biết các node Vera Rubin không có cáp, làm mát bằng chất lỏng 100%, và cắt thời gian lắp ráp node từ 2 giờ trên Grace Blackwell xuống dưới 5 phút. Loại bỏ đi cáp loại bỏ cả thời gian lắp ráp lẫn một nguồn lỗi hiện trường lớn, và còn khiến node thay thế nhanh khi bảo trì, không chỉ lắp đặt nhanh.
Vì sao sản xuất Vera Rubin quan trọng với HBM4?
Các hệ thống Vera Rubin dùng bộ nhớ HBM4, nên quá trình tăng sản xuất toàn diện của nền tảng — và các lô giao DSX POD dự kiến từ đầu năm 2027 — chuyển trực tiếp thành nhu cầu HBM4. Tốc độ triển khai quan trọng với các nhà sản xuất bộ nhớ vì triển khai nhanh hơn kéo vòng đơn hàng GPU và HBM tiếp theo về phía trước.
Nguồn: bản tin về công bố triển khai DSX POD của NVIDIA; bản tin GTC Berlin về Vera Rubin và DSX POD; bản tin về triển khai 14 ngày của DSX POD (tất cả đều đưa tin các công bố của NVIDIA tại GTC Berlin ngày 21 tháng 10 năm 2026). Bài viết này là phân tích, không phải tư vấn đầu tư.
📩 Đăng ký bản tin VLSI Korea
Nhận phân tích bán dẫn chuyên sâu mỗi ngày qua email trước tiên. Đăng ký miễn phí.


