 VLSI Korea
Las matemáticas de la producción de Vera Rubin: 576 pilas HBM4 por rack y 300.000 obleas por millón de GPU (TSMC, SK hynix, Samsung, Micron)
Vera Rubin ya está en producción plena: un rack NVL72 consume 576 pilas HBM4 y unas 21.5 obleas. Cada millón de GPU exige unas 300,000 obleas, y el cuello de botella de la rampa 2026–2027 es la HBM4, no la lógica de 3nm.


La conclusión en una línea — la velocidad de producción de Vera Rubin no la fijan las GPU, sino los bits de HBM4. En una estructura en la que un rack consume 576 pilas HBM4 y más de 21 obleas, el techo de la rampa de 2027 lo dibujan las obleas de los fabricantes de memoria.
Resumen en 30 segundos
- El 21 de octubre de 2026, en la keynote de GTC Berlin, el CEO Jensen Huang declaró que Vera Rubin está "ya en producción plena". El tiempo de ensamblaje de un nodo cayó de dos horas en Grace Blackwell a menos de cinco minutos, y la refrigeración es 100% líquida.
- Un rack NVL72 alberga 72 GPU Rubin, 36 CPU Vera y 576 pilas HBM4 (20.7 TB = 165,888 Gb). Por GPU, la HBM4 son ocho pilas de 36 GB y 12 capas (12-high), 288 GB (2,304 Gb).
- Los volúmenes existen solo como estimaciones. El caso base actual del mercado es de 5,000–7,000 racks en el segundo semestre de 2026 (estimaciones de la cadena de suministro) y de 11,000–21,000 racks en 2027 (0.8–1.5 millones de GPU).
- Convertido a obleas, una GPU consume 0.037 obleas de lógica + 0.143 obleas CoWoS + 0.118 obleas DRAM HBM — unas 0.30 obleas en total. Un millón de GPU significa unas 300,000 obleas.
- Veredicto sobre el cuello de botella: primero, la HBM4 (el volumen de 2026 está efectivamente comprometido, se reportan recortes de asignación y una perspectiva de precios de contrato para 2027 muy alcista); segundo, CoWoS. Las obleas de lógica y el ensamblaje de racks no son restricciones.
1. La declaración de Berlín — primero los hechos confirmados
El 21 de octubre de 2026, Jensen Huang sostuvo en alto un nodo Vera Rubin en la keynote de GTC Berlin y confirmó tres cosas. Primero, Vera Rubin está ya en producción plena. Segundo, el tiempo de ensamblaje de un nodo ha caído de dos horas en la generación Grace Blackwell a menos de cinco minutos — resultado de eliminar cables y alambres. Tercero, la refrigeración es 100% líquida, frente al 80% líquido de la generación anterior, con una temperatura de entrada del refrigerante de 45°C.
La producción en sí no era noticia. NVIDIA anunció la entrada en producción en el CES de enero de 2026, y su comunicado de GTC Taipei del 31 de mayo fijó los envíos de producción para el otoño. El 1 de junio, el operador cloud CoreWeave completó la puesta en marcha del primer rack NVL72 y confirmó su operación en vivo. Lo que Berlín confirmó es que "en producción" significa ahora una rampa completa, no muestras ni unidades tempranas. Huang también señaló que 150 socios taiwaneses de la cadena de suministro respaldan a Vera Rubin.
Este artículo desmenuza esa declaración en números: cuántos sistemas se construyen, qué lleva un rack y en qué cantidad, cómo se convierte ese volumen en obleas, y qué empresa suministra qué, y cuánto. Las cifras procedentes de divulgaciones oficiales y de la cobertura informativa llevan sus fuentes; las cifras derivadas por cálculo se etiquetan como estimaciones con sus supuestos a la vista.
2. Anatomía de un rack — dentro del NVL72
La unidad de venta de Vera Rubin no es un chip GPU, sino un rack. Un NVL72 consta de 18 bandejas de cómputo y 9 bandejas de conmutación NVLink, con 72 GPU unidas por la red NVLink 6 que se comportan como un único acelerador gigante.
| Componente | Cantidad / Especificación | Notas |
|---|---|---|
| GPU Rubin | 72 | 336B transistores por GPU (dos dies), TSMC 3nm |
| CPU Vera | 36 | Arm de 88 núcleos, NVLink-C2C hacia las GPU |
| HBM4 | 576 pilas, 20.7 TB | 8 pilas × 36 GB por GPU |
| LPDDR5X (para la CPU) | Hasta 54 TB | Hasta 1.5 TB por CPU, módulos SOCAMM2 (según análisis de corredurías) |
| Red NVLink 6 | 260 TB/s por rack | 3.6 TB/s por GPU |
| Red | NIC ConnectX-9, DPU BlueField-4 | Scale-out mediante Ethernet Spectrum-X |
| Refrigeración | 100% líquida | Entrada del refrigerante a 45°C |
| Consumo de energía | ~190–230 kW | Estimaciones de la cadena de suministro |
| Precio del rack | $5M–$7.8M | Cobertura de marzo de 2026 y análisis BOM de corredurías |
Fuente: especificaciones publicadas del NVL72 de NVIDIA, cobertura de la keynote de GTC Berlin 2026 (21 de octubre de 2026), análisis de lista de materiales (BOM) de corredurías.
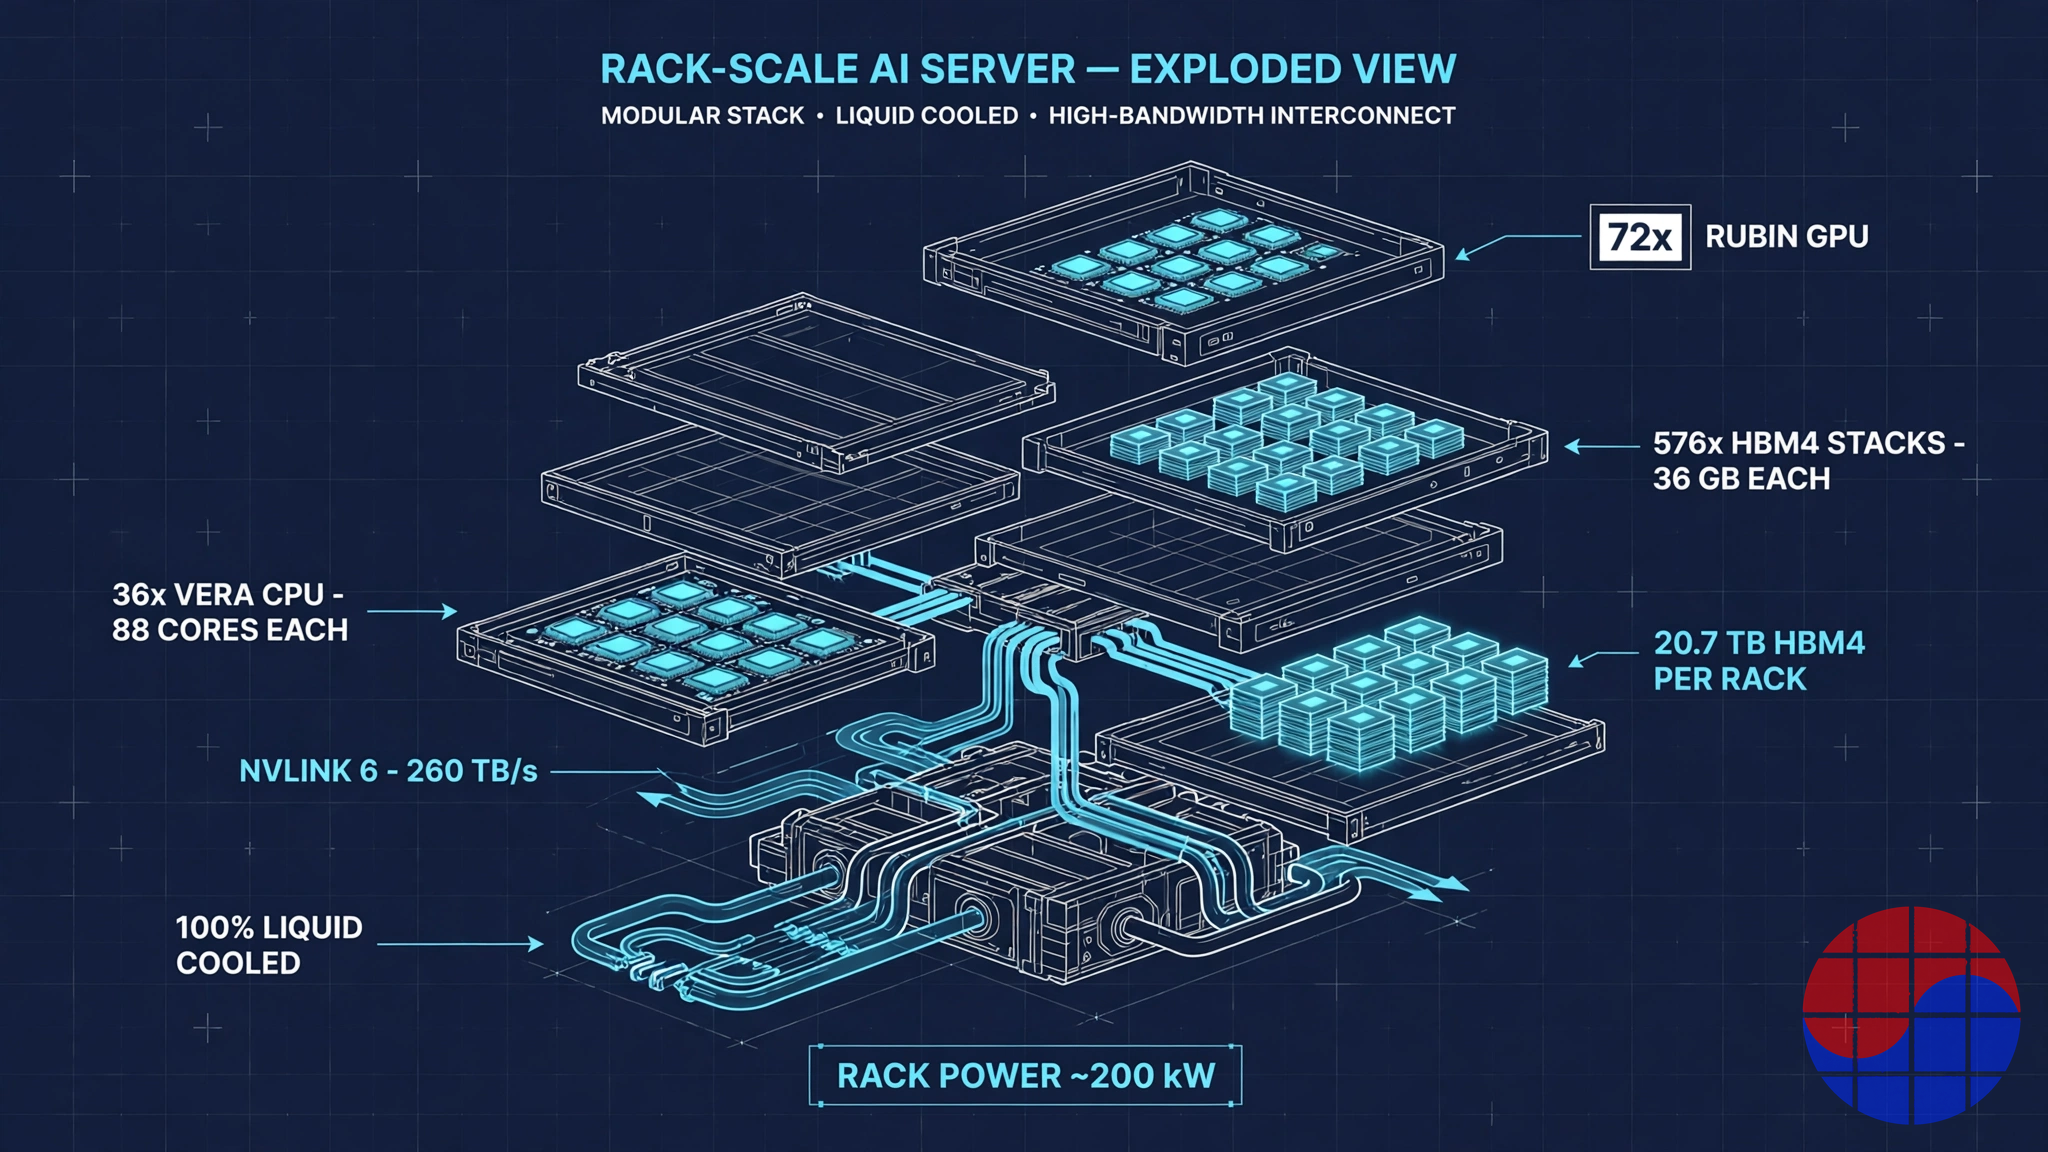
Anatomía de un rack Vera Rubin NVL72 — 72 GPU y 576 pilas HBM4 en un solo rack. Source: VLSI Korea
La aritmética de la HBM4
Esta plataforma es, en esencia, un sistema de memoria. Desglosando la HBM4 de una GPU en bits:
| Elemento | Valor | Cálculo |
|---|---|---|
| Una pila HBM4 | 36 GB (288 Gb) | Doce dies de 24 Gb apilados |
| Pilas por GPU | 8 | Especificación de NVIDIA |
| HBM4 por GPU | 288 GB (2,304 Gb) | 8 × 36 GB |
| Ancho de banda de memoria por GPU | 22 TB/s | Especificación de NVIDIA |
| Pilas por rack | 576 | 72 × 8 |
| HBM4 por rack | 20.7 TB (165,888 Gb) | 72 × 288 GB |
| Dies DRAM HBM por rack | 6,912 | 576 pilas × 12 dies |
Frente a Blackwell, la capacidad HBM por GPU subió 1.5×, de 192 GB a 288 GB, y el ancho de banda 2.75×, de 8 TB/s a 22 TB/s. El número de pilas se mantuvo en ocho, pero cada pila creció de 24 GB a 36 GB y las velocidades por pin aumentaron. Lo que importa para la producción es que todo el aumento de capacidad se factura en obleas DRAM adicionales: cada pila requiere doce dies de 24 Gb y, teniendo en cuenta el rendimiento (yield) de los dies, el consumo real de obleas es aún mayor.
3. Cuántos se construyen — escenarios de volumen
NVIDIA no divulga los envíos de unidades de Rubin. Cada cifra en circulación es una estimación, y este artículo usa solo aquellas con métodos transparentes.
Cálculo inverso 1: desde los ingresos
El debate del mercado, apoyado en la guía de NVIDIA y en comentarios de sus ejecutivos, contempla un ritmo en el que Vera Rubin aporta unos $20 mil millones de ingresos trimestrales. Dividir por el rango de precios de rack reportado ($5M–$7.8M) arroja 2,550–3,975 racks por trimestre, o unos 10,000–16,000 racks anualizados. Nótese que este cálculo inverso supone que todos los ingresos de Rubin proceden de racks NVL72, lo que lo convierte en una referencia de cota superior — en la realidad se mezclan ventas a nivel de placa y módulo e ingresos paralelos de Blackwell.
Cálculo inverso 2: estimaciones de la cadena de suministro
Los analistas que siguen la cadena de suministro taiwanesa sitúan los envíos de racks VR200 del segundo semestre de 2026 en 5,000–7,000 unidades (reportado como estimación de Ming-Chi Kuo), lo que se convierte en 360,000–500,000 GPU. Con los recortes de asignación de HBM4 reportados en la mezcla, un consenso paralelo sitúa el total de GPU Rubin de 2026 en 250,000–350,000. Para 2027, el año de escalado, el escenario base es de 0.8–1.5 millones de GPU (11,000–21,000 racks). Las estimaciones del sector también proyectan que los envíos totales de racks de clase NVL72 (GB300 + VR200 + VR300) crezcan más de un 50% interanual en 2027, con el VR200 llevándose la mayor parte.
| Periodo | Racks (est.) | GPU (est.) | Pilas HBM4 (est.) | Base |
|---|---|---|---|---|
| 2º semestre de 2026 | 3,500–7,000 | 250K–500K | 2.0M–4.0M | Estimaciones de la cadena de suministro; inicio de envíos en otoño |
| Por trimestre en el pico de la rampa | 2,550–3,975 | 180K–290K | 1.47M–2.29M | Cálculo inverso desde ~$20B de ingresos trimestrales |
| 2027 | 11,000–21,000 | 0.8M–1.5M | 6.4M–12.0M | Rango del escenario base |
Cada cifra de esta tabla es una estimación, no un número confirmado. Lo que está confirmado es la producción misma, y el inicio de los envíos en otoño.
Convertido a bits de HBM4, el panorama cambia de escala. Incluso el extremo bajo del caso base de 2027 (0.8 millones de GPU) requiere 230 PB (230,400 TB) de HBM4; el extremo alto (1.5 millones de GPU) alcanza 432 PB. Una sola plataforma absorbe una parte sustancial de toda la producción mundial de HBM.
4. La conversión a obleas — una GPU = 0.30 obleas
Convertir el volumen en obleas revela dónde está el cuello de botella. El modelo siguiente es nuestro, con cada supuesto divulgado; léanse los resultados como rangos.
Supuestos
| Tipo de oblea | Supuesto | Resultado |
|---|---|---|
| Lógica (TSMC 3nm) | Área de die ~800 mm² × 2 (cerca del límite de retícula de 858 mm²), ~65 dies brutos por oblea de 300 mm, rendimiento (yield) de die del 85% | ~55 dies buenos por oblea = ~27 GPU |
| Encapsulado CoWoS | Huella del encapsulado ~4,700 mm² (clase de 5.5 retículas de 2026), 6–8 encapsulados por oblea | ~7 GPU por oblea |
| DRAM HBM4 | Die de 24 Gb ~60 mm², ~1,090 dies brutos por oblea, rendimiento (yield) efectivo KGD/apilado del 75% | ~820 dies por oblea = ~8.5 GPU |
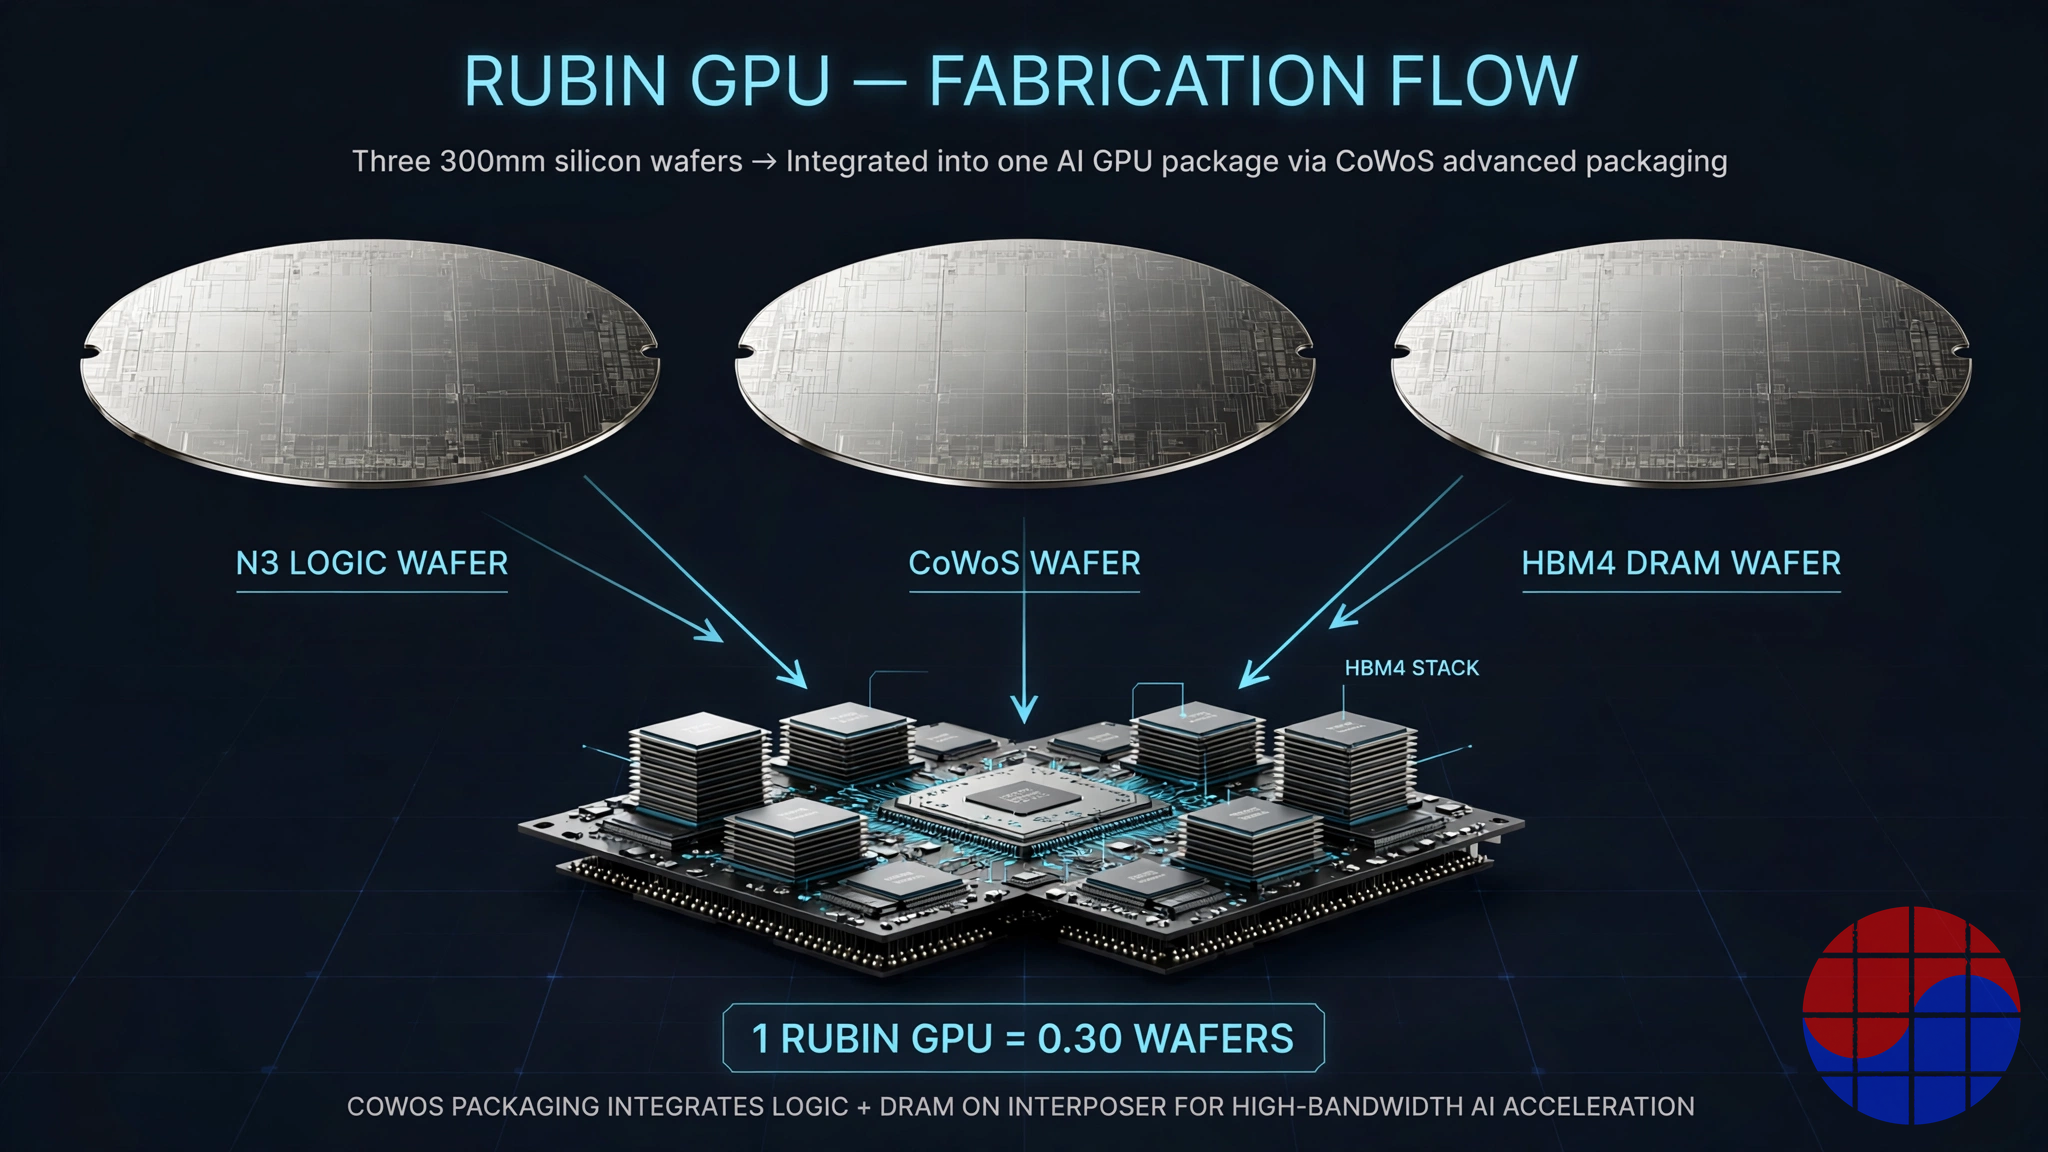
Los tres tipos de oblea que consume una GPU — lógica, CoWoS y DRAM HBM. Source: VLSI Korea
Resultados de la conversión
| Categoría | Por GPU | Por rack (72 GPU) | 2027 (0.8M–1.5M GPU) |
|---|---|---|---|
| Obleas de lógica (3nm) | 0.037 | ~2.7 | 30K–56K |
| Obleas CoWoS | 0.143 | ~10.3 | 114K–214K |
| Obleas DRAM HBM4 | 0.118 | ~8.5 | 94K–176K |
| Total | ~0.30 | ~21.5 | ~240K–450K |
La conclusión es inequívoca. Construir un millón de GPU lleva unas 300,000 obleas entre los tres tipos, y cerca del 90% de ellas son obleas de encapsulado (CoWoS) y de memoria (DRAM). Las obleas de lógica pura son solo alrededor del 12% del total. La cobertura informativa indica igualmente que los cuatro principales diseñadores de chips de IA consumen solo alrededor del 12% de la producción de lógica de nodo avanzado — que es precisamente por lo que las fabs de lógica no son la restricción de la rampa de la IA.
Frente a la oferta: TSMC alcanza unas estimadas 120,000–150,000 obleas CoWoS al mes hacia finales de 2026, y con la capacidad de los socios OSAT el total del sector se acerca a unas 200,000 al mes. Según lo reportado, NVIDIA reservó por anticipado alrededor del 60% del CoWoS de TSMC de 2026. El requisito de CoWoS de Rubin en 2027 (114K–214K obleas al año) es un porcentaje de un solo dígito de la capacidad anual de TSMC, así que la aritmética funciona incluso compartiendo con Blackwell — el problema es el crecimiento del encapsulado: a medida que las huellas de los encapsulados se expanden, los encapsulados por oblea caen, y la expansión sigue siendo devorada por el área.
5. El mapa de proveedores — quién suministra qué, y cuánto
Detrás de un rack Vera Rubin hay cientos de proveedores, incluidos los 150 socios taiwaneses que citó Huang. El mapa central:
| Empresa | Qué suministra | Volumen / función |
|---|---|---|
| TSMC | Dies GPU de 3nm, encapsulado CoWoS-L | Todos los dies GPU. NVIDIA habría reservado ~60% de la capacidad CoWoS de 2026 |
| SK hynix | HBM4, LPDDR5X SOCAMM2 | Rango de mediados del 50% de la asignación inicial de HBM4 (reportado). Pilas de 36 GB y 12 capas; SOCAMM2 mostrado para la CPU Vera |
| Samsung | HBM4 | Rango de mediados del 20% de la asignación inicial (reportado). DRAM 1c + die base de 4nm; la especificación más rápida, hasta 3.0 TB/s por pila, 11.7 Gbps. Las muestras de HBM4E apuntan a Rubin Ultra |
| Micron | HBM4 | ~20% de la asignación inicial (reportado). 36 GB y 12 capas en envíos de alto volumen desde el 1er trimestre de 2026; >2.8 TB/s por pila |
| Ibiden, Shinko, Unimicron, Nan Ya PCB | Sustratos ABF | Sustratos build-up para encapsulados de clase 5.5 retículas; el área del sustrato es capacidad |
| ASE, Amkor | Back-end (desborde de CoWoS) | Una estimada nueva capacidad OSAT de 50K–60K WPM absorbe el desborde de TSMC |
| Foxconn, Quanta, Wistron, Inventec | Ensamblaje e integración de racks | Foxconn citado como el mayor ensamblador; el diseño de nodo de 5 minutos fija el rendimiento |
| Dell, HPE, Lenovo, Supermicro, GIGABYTE | Entrega de sistemas | Racks completos a CSP y empresas |
| Vertiv, Schneider Electric, Delta | Energía y refrigeración | CDU y energía para racks de ~200 kW; socios DSX POD |
| NVIDIA (interno) | ConnectX-9, BlueField-4, conmutadores NVLink, Spectrum-X Photonics | Cuota interna creciente del BOM — la parte de NVIDIA en los ingresos del rack crece cada generación |
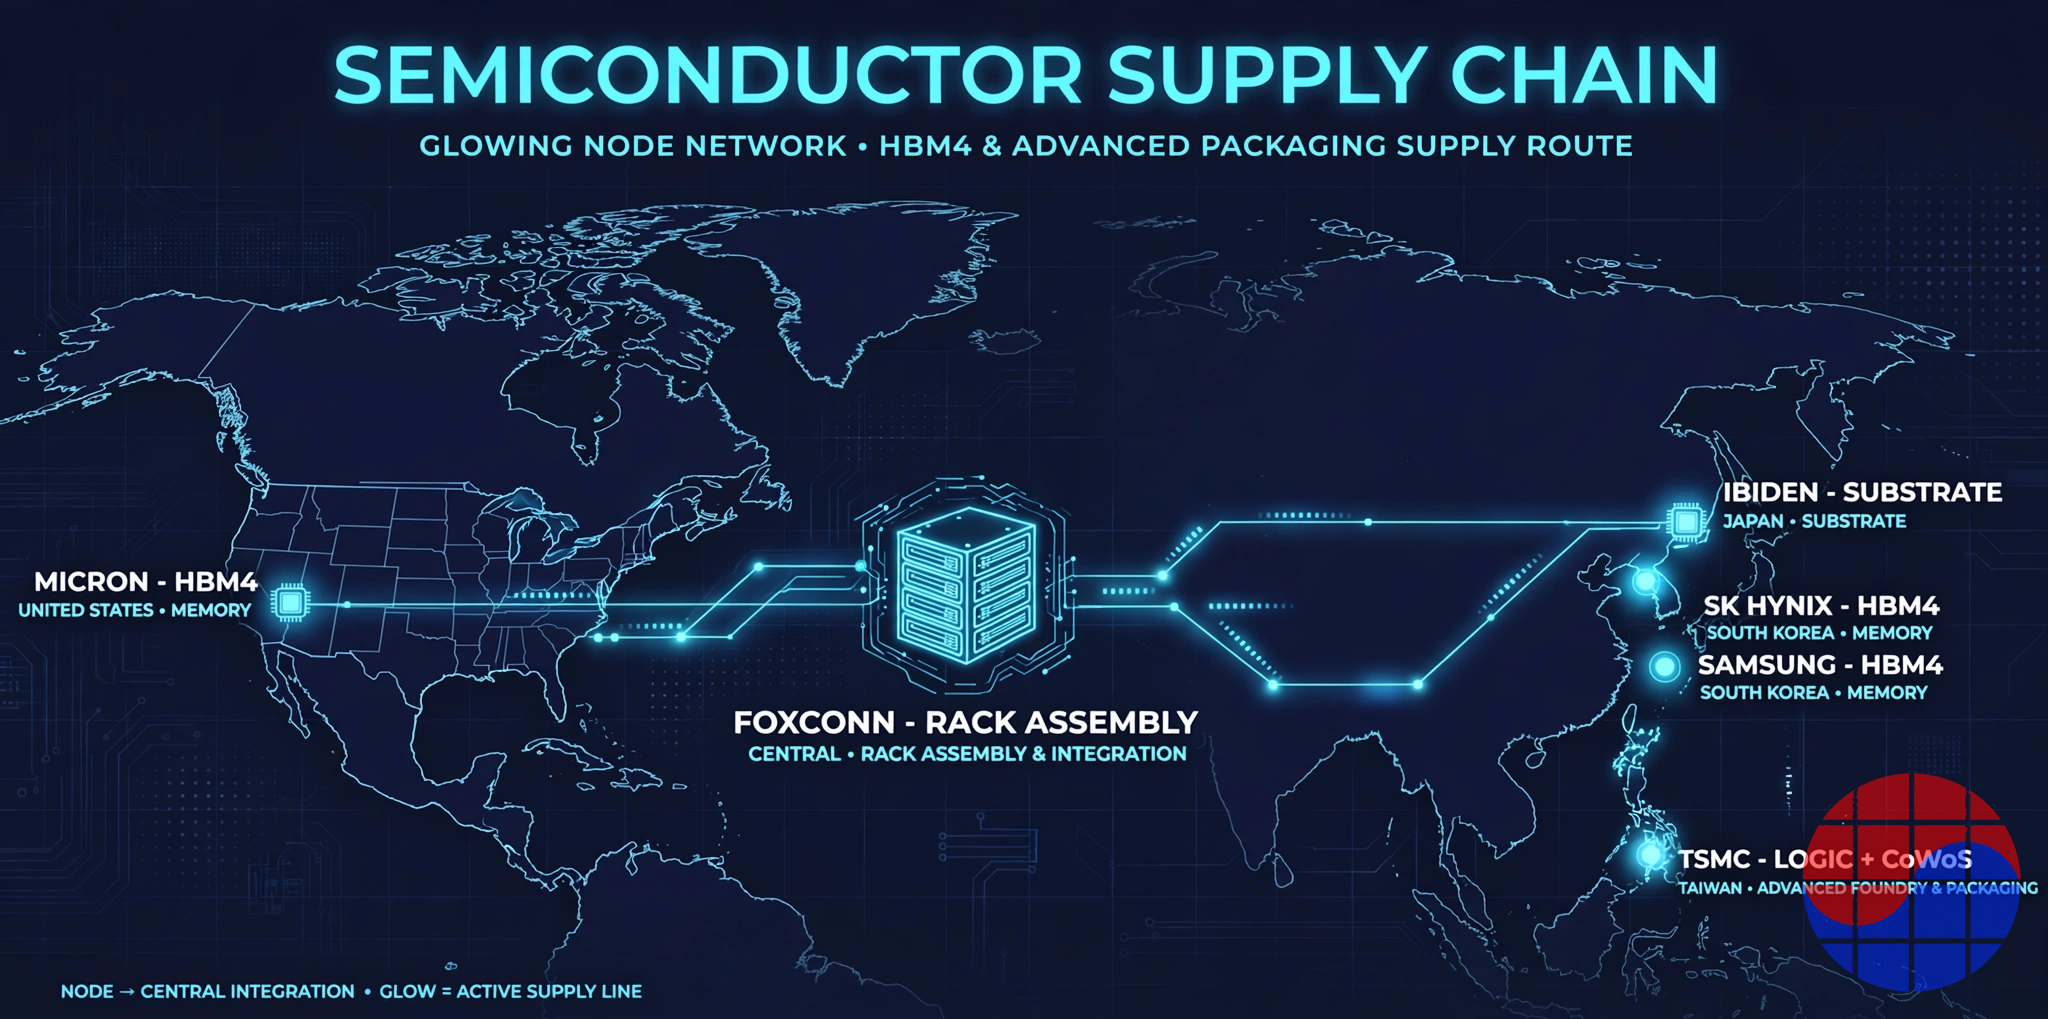
La cadena de suministro de Vera Rubin — lógica y encapsulado en Taiwán, HBM4 repartida entre Corea y EE. UU., sustratos en Japón. Source: VLSI Korea
La asignación de HBM4 se apoya en la cobertura de las asignaciones de volumen de NVIDIA de finales de 2025: SK hynix la mayor, en el rango de mediados del 50%, Samsung en el rango de mediados del 20% y Micron en torno al 20%. Este reparto no es fijo. Samsung inició en febrero de 2026 los primeros envíos de producción en masa de HBM4 del sector y lidera en especificaciones de velocidad, mientras que la cobertura de abril indicó que SK hynix sopesó recortar sus envíos de HBM4 de 2026 a NVIDIA en un 20–30% en medio de los tiempos de la rampa — una estructura en la que las asignaciones trimestrales pueden moverse.
La economía del ensamblaje de racks también cambió. Con el ensamblaje de un nodo reducido de dos horas a cinco minutos, la capacidad de ensamblaje ya no es un problema de mano de obra, sino un problema de llegada de piezas. Para los ensambladores, Vera Rubin es un rack que se envía a la velocidad a la que llegan las piezas — es decir, la HBM4 y los encapsulados CoWoS terminados fijan la utilización de la línea. Nuestro artículo complementario sobre el diseño modular de fábrica de IA de NVIDIA, el análisis en profundidad del Vera Rubin DSX POD, cubre la velocidad de despliegue; este artículo se centra en cuántos sistemas se construyen, y a partir de cuántas obleas.
6. Veredicto sobre el cuello de botella — qué limita realmente la rampa
| Proceso | Veredicto | Evidencia |
|---|---|---|
| HBM4 | La restricción principal | El volumen de 2026 está efectivamente agotado. Revisión de recorte de envíos reportada. Se proyecta que una pila de 36 GB y 12 capas suba de ~$600 en 2026 a ~$1,300 en 2027 (estimación de precio de contrato +121% interanual, reportado) |
| CoWoS | Ajustado, manejable | Capacidad multiplicada por ~8 en tres años, pero el crecimiento del área del encapsulado compensa la expansión. En las estimaciones persiste un déficit de oferta del sector del 10–20% |
| Sustratos ABF | En observación | Directamente expuesto al crecimiento del área de los encapsulados grandes; ya ha sido un cuello de botella silencioso antes |
| Obleas de lógica de 3nm | No es una restricción | Los 4 principales diseñadores de IA consumen ~12% de la producción de lógica de nodo avanzado (reportado) |
| Ensamblaje de racks | No es una restricción | Ensamblaje de nodo de 5 minutos, diseño modular; la restricción es la llegada de piezas |
| Energía y emplazamientos | Una restricción del lado del cliente | 190–230 kW por rack; la transición a 800VDC y la infraestructura de refrigeración líquida son desafíos de emplazamiento |
La conclusión es sencilla. La función de producción de Vera Rubin se lee min(pilas HBM4 ÷ 576, encapsulados CoWoS ÷ 72, dies de lógica ÷ 144), y en 2026–2027 el término que fija el mínimo es la HBM4. Si los ingresos de Rubin no alcanzan la guía en unos resultados de NVIDIA, sospeche de las entregas de HBM4 antes que de la demanda. A la inversa, si los precios de contrato de la HBM4 realmente casi se duplican en 2027, esa es la señal de que el trío de la memoria ha empezado a cobrar su parte de la economía de la rampa.
La opinión de Chase
Con todas las cifras sobre la mesa, Vera Rubin es menos un producto GPU que la forma física de un contrato de compra de memoria. Del precio de un rack de $5M–$7.8M, el coste en obleas de los propios dies GPU es una parte menor de lo que sugiere la intuición; el dinero y la capacidad están encerrados en 576 pilas HBM4 y en el área CoWoS.
Desde una perspectiva coreana, obsérvese la pendiente de la asignación. El rango de mediados del 50% de SK hynix es continuidad respecto a la generación Blackwell, pero el rango de mediados del 20% de Samsung parece un suelo para un regreso — si sus cartas de velocidad y HBM4E juegan en el reinicio de asignación de 2027, la pendiente cambia. Y lo que decide esa pendiente no es el marketing; es el rendimiento (yield) KGD trimestre a trimestre y el rendimiento del apilado.
Por último, la cifra de 0.30 obleas merece ser recordada. La competencia en aceleradores de IA es ahora simultáneamente un concurso de diseño y un concurso de asignación sobre tres tipos de oblea. La hoja de ruta de TSMC, que apunta a HBM5 y encapsulados de clase 14 retículas para la próxima generación, dice que este concurso de asignación no termina — solo se vuelve más caro.
Fuentes: especificaciones publicadas de NVIDIA y cobertura de la keynote de GTC Berlin 2026 (21 de octubre de 2026), cobertura coreana e internacional de la cadena de suministro y de resultados, análisis de lista de materiales (BOM) de corredurías. Las conversiones de volumen y de obleas son estimaciones propias bajo los supuestos indicados y pueden diferir de los envíos reales. Este artículo no es asesoramiento de inversión.
FAQ
Q: ¿Cuántas pilas HBM4 lleva un rack Vera Rubin? A: 576. Cada GPU lleva ocho pilas de 36 GB y 12 capas (288 GB), y un rack alberga 72 GPU, así que 72 × 8 = 576 pilas — 20.7 TB (165,888 Gb) en total.
Q: ¿Cuántos sistemas Vera Rubin se producirán en 2027? A: No hay una cifra confirmada. Combinando las estimaciones de la cadena de suministro y los cálculos inversos desde los ingresos, el escenario base para 2027 es de 11,000–21,000 racks, o 0.8–1.5 millones de GPU. Para el segundo semestre de 2026 se estiman unos 3,500–7,000 racks.
Q: ¿Cuántas obleas se necesitan para construir una GPU? A: Unas 0.30 obleas entre tres tipos: 0.037 de una oblea de lógica de 3nm, 0.143 de una oblea CoWoS y 0.118 de una oblea DRAM HBM4 — nuestra propia estimación bajo los supuestos divulgados en este artículo (área de die, rendimientos, huella del encapsulado). Por rack, son unas 21.5 obleas.
Q: ¿Cuál es el verdadero cuello de botella en la producción de Vera Rubin? A: La HBM4. El volumen de 2026 está efectivamente comprometido, y las revisiones de recorte de envíos reportadas más una perspectiva de precios de contrato para 2027 muy alcista respaldan ese veredicto. CoWoS está ajustado pero en expansión; las obleas de lógica de 3nm y el ensamblaje de racks difícilmente pueden llamarse restricciones.
Q: ¿Qué empresas suministran la HBM4, y en qué proporciones? A: Según la cobertura de la asignación de finales de 2025, SK hynix tiene el rango de mediados del 50%, Samsung el rango de mediados del 20% y Micron en torno al 20%. Samsung aporta los primeros envíos de producción en masa del sector (febrero de 2026) y las especificaciones más rápidas, SK hynix la mayor asignación y SOCAMM2, y Micron envíos de alto volumen desde el 1er trimestre de 2026 — y las asignaciones pueden ajustarse trimestre a trimestre.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


