VLSI Korea
Inferensi AI tanpa HBM? Taruhan 480GB LPDDR5X Intel dan perang TCO memori inferensi
Intel merilis GPU inferensi D270 di OCP 2026: FP8 1,3 PFLOPS, bandwidth 1,5 TB/s, PCIe 350W berpendingin udara. Bukan HBM, melainkan LPDDR5X hingga 480GB — cukup untuk model 300 miliar parameter. HBM 2026 praktis ludes: dalam inferensi, pemenangnya ditentukan biaya per token (TCO), bukan bandwidth.


Excerpt: Intel merilis GPU inferensi D270 di OCP 2026: FP8 1,3 PFLOPS, bandwidth 1,5 TB/s, PCIe 350W berpendingin udara. Bukan HBM, melainkan LPDDR5X hingga 480GB — cukup untuk model 300 miliar parameter. HBM 2026 praktis ludes: dalam inferensi, pemenangnya ditentukan biaya per token (TCO), bukan bandwidth. Slug: inference-memory-tco-lpddr5x-hbm-id
Inferensi AI tanpa HBM? Taruhan 480GB LPDDR5X Intel dan perang TCO memori inferensi
Ringkasan 30 detik: Intel memperkenalkan GPU yang dirancang khusus untuk inferensi, D270 (Crescent Island), di OCP 2026: komputasi FP8 sebesar 1,3 PFLOPS, bandwidth memori 1,5 TB/s, dalam kartu PCIe 350W berpendingin udara. Kabar utamanya bukan HBM — melainkan LPDDR5X: 160GB di kartu buatan Intel sendiri, hingga 480GB di kartu mitra ODM. Satu kartu menampung model 300 miliar parameter dalam FP8; sistem delapan GPU menangani 1T+ parameter. Harga tidak diumumkan, dan belum ada benchmark independen. Sementara itu HBM praktis habis terjual untuk 2026, dan sebagian besar pasokan 2027 sudah dikunci. Siapa pun yang bisa mengamankan memori menentukan arsitekturnya — dan dalam inferensi, pertarungan dimenangkan lewat biaya per token (TCO), bukan bandwidth.
Background
Infrastruktur AI sedang menggeser pusat gravitasinya dari training ke inferensi. Training adalah perlombaan komputasi raksasa yang terjadi sekali; inferensi adalah layanan berkelanjutan yang memancarkan miliaran token setiap hari. Ketika bebannya menjadi layanan, struktur biaya menjadi strategi.
Namun pada akhir 2026, tembok pertama yang dihadapi para perencana infrastruktur inferensi bukanlah FLOPS GPU — melainkan pengadaan memori. Samsung menyatakan volume HBM4 2026-nya praktis habis terjual. SK hynix melaporkan seluruh output DRAM dan NAND 2026-nya ludes. Micron disebut telah mengunci sebagian besar pasokan memori 2027 dengan harga lebih tinggi, menurut pelaporan industri. (Sumber: RCR Wireless)
Dengan latar ini, jawaban Intel di OCP Global Summit pada 12 Oktober sangat mencolok: lewati perebutan HBM sepenuhnya dan bangun di atas memori yang berbeda.
Business Deep Dive
1. Membedah D270 — mengapa LPDDR5X
Spesifikasi resmi Intel untuk GPU D270 (sebelumnya Crescent Island): (Sumber: Intel)
| Item | Spesifikasi |
|---|---|
| Arsitektur | Xe3P — 32 core Xe3P, 256 XMX matrix engine, L2 terpadu 32MB |
| Komputasi | 1,3 PFLOPS FP8 |
| Memori | LPDDR5X — 160GB (kartu Intel) / hingga 480GB (kartu mitra ODM) |
| Bandwidth memori | 1,5 TB/s |
| Daya & pendingin | 350W, PCIe 5.0 x16 berpendingin udara |
| Dukungan model | 300B parameter per kartu, 1T+ parameter pada 8 GPU |
Keputusan desain yang paling mengungkapkan: perangkat keras grafis 3D konvensional dan ray tracing dihilangkan. Luas die yang dulu dipakai untuk unit grafis fungsi-tetap kini melayani komputasi AI. Hanya untuk inferensi — diukir di silikon.
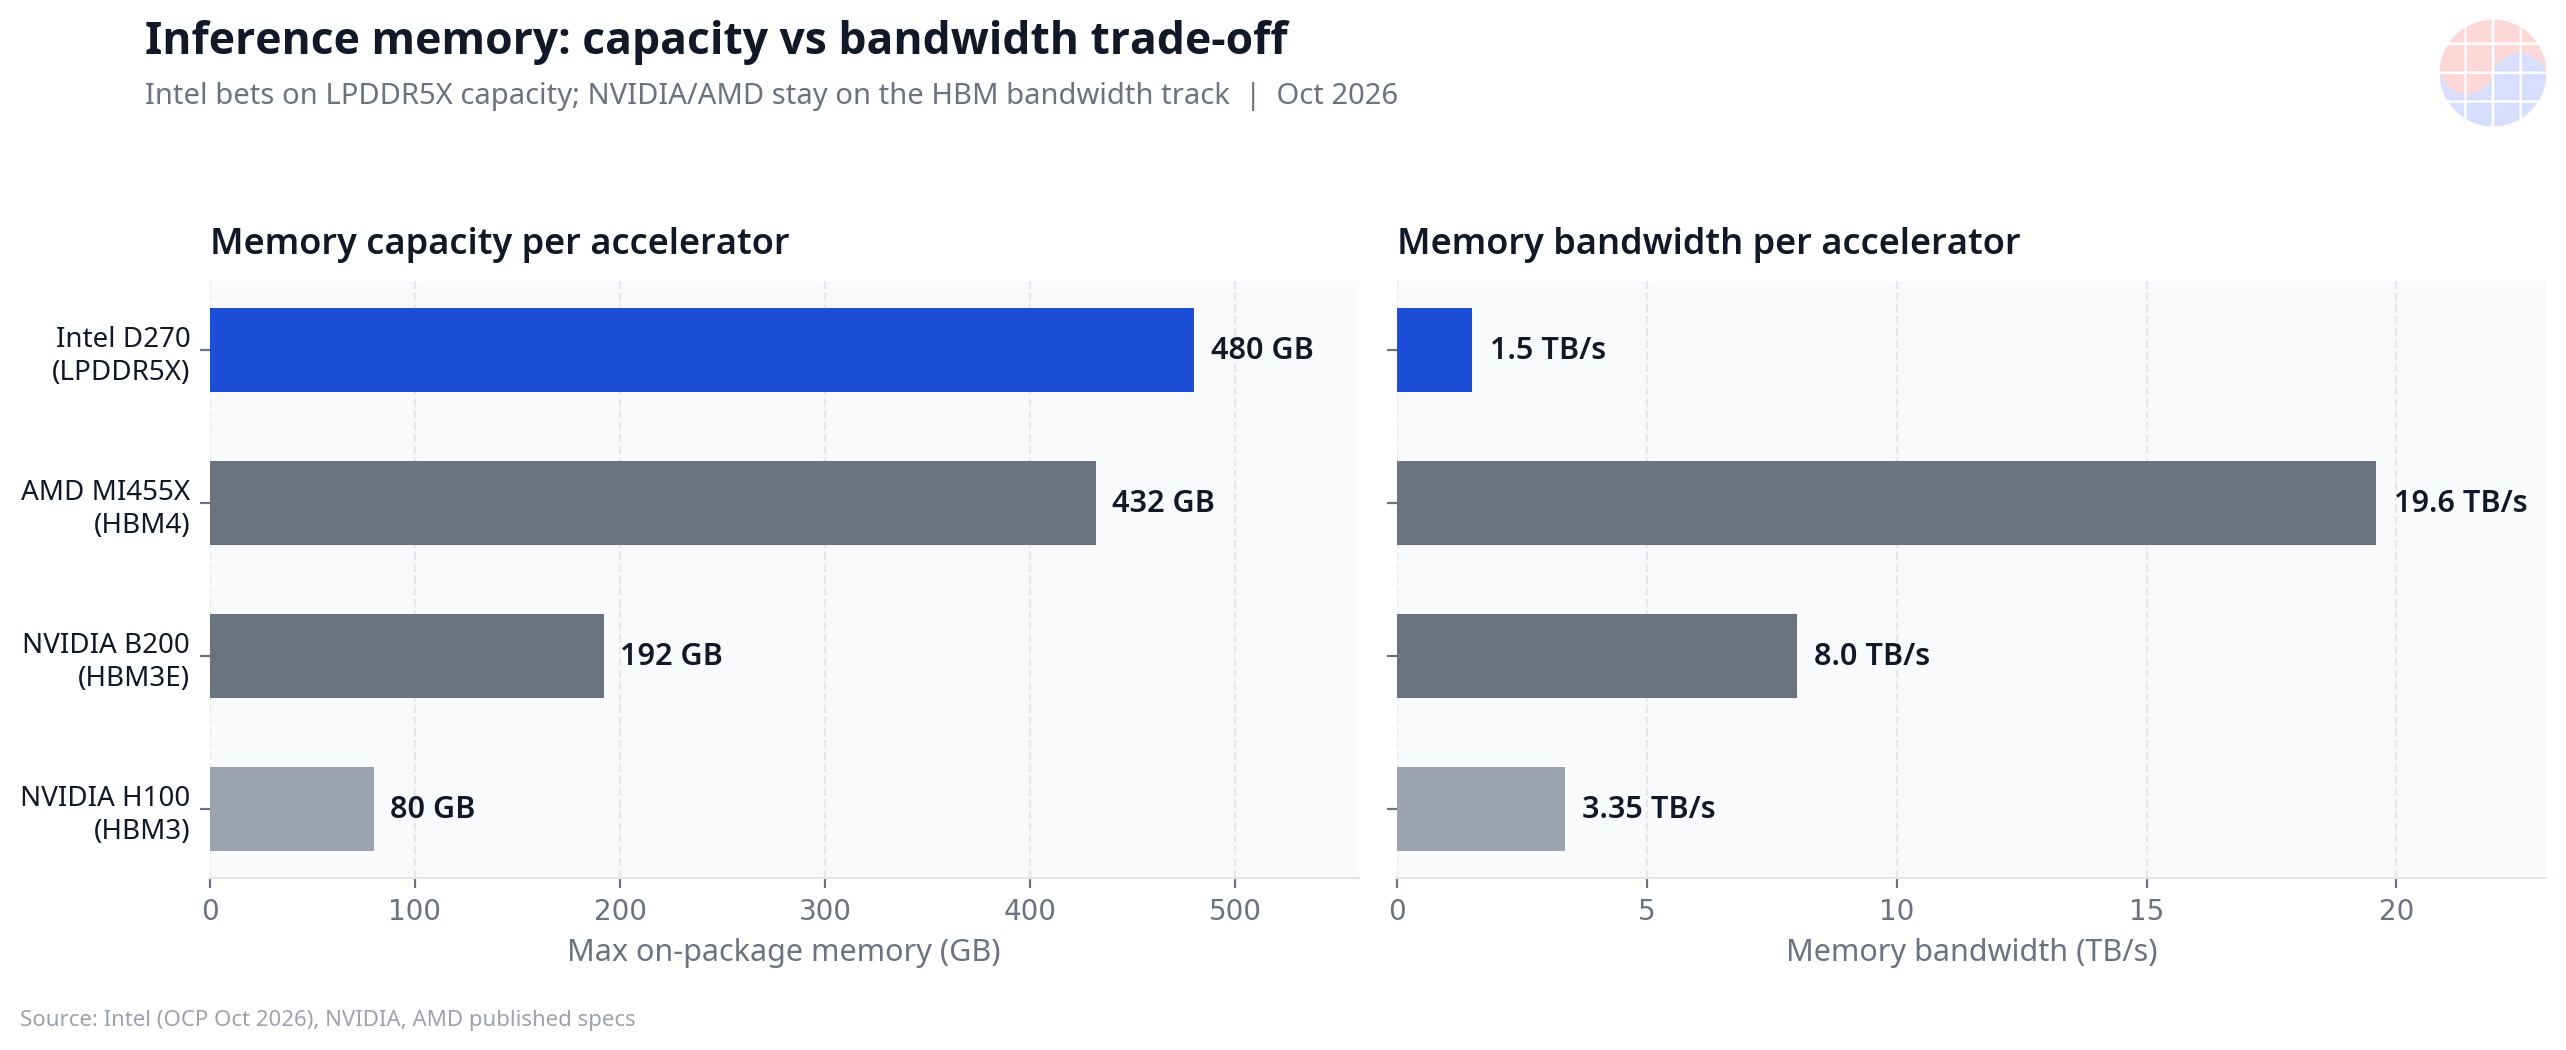
Keputusan kedua adalah memori. LPDDR5X, bukan HBM. Dengan 1,5 TB/s, bandwidth-nya kira-kira seperlima dari kartu kelas HBM3E (8 TB/s). Namun kapasitasnya luar biasa — 480GB di kartu mitra adalah sekitar 2,5x dari generasi flagship HBM saat ini.
Matematikanya sederhana. Dalam FP8, satu parameter kira-kira satu byte. Bobot model 300 miliar parameter adalah ~300GB — muat dengan nyaman di kartu 480GB. Sisa ~180GB dialokasikan untuk "pemakan memori tersembunyi" dalam inferensi, yaitu KV cache, dan batching. Model 1 triliun parameter yang dibagi ke 8 kartu membutuhkan ~125GB per kartu. Defisit bandwidth tidak terlalu menjadi masalah dibanding training, karena inferensi memakai ulang bobot yang sudah dimuat untuk ribuan token, bukan mengaduknya terus-menerus.
Keputusan ketiga adalah daya dan faktor bentuk. Kartu PCIe 350W berpendingin udara tinggal dipasang ke infrastruktur pusat data yang sudah ada. Berbeda dengan akselerator berpendingin cairan kelas 1.000W, ia tidak membutuhkan pembangunan daya atau pendingin khusus — hal yang dalam perhitungan TCO lebih besar dari kelihatannya.
Peringatannya sama jelasnya. Harga tidak diumumkan. Ketersediaan umum hanya digambarkan sebagai 2027 dalam liputan pers. Dan belum ada benchmark independen — 1,3 PFLOPS adalah puncak teoretis. (Sumber: VideoCardz)
2. Kelangkaan memori sedang menulis ulang arsitektur
Untuk memahami taruhan Intel, lihat posisi pasar memori pada Oktober 2026:
- HBM4 (generasi berjalan): volume 2026 Samsung praktis habis terjual; seluruh output DRAM dan NAND 2026 SK hynix ludes. Anda tidak bisa membeli barang yang tidak ada.
- HBM4E (generasi berikutnya): antarmuka 2.048-bit, 14–16 Gbps per pin, hingga 3,6 TB/s per stack. Sampel 12-high (384Gb / 48GB) dikirim dari Samsung (Mei) dan SK hynix (Juni). Produksi volume ditargetkan 2027. Masih generasi yang didefinisikan vendor — belum ada standar JEDEC. (Sumber: RCR Wireless)
- HBM4E 12-high Samsung dilaporkan telah lolos pengujian kualifikasi NVIDIA, meski baik Samsung maupun NVIDIA belum mengonfirmasi secara resmi. (Sumber: HardwareBrief)
- Micron dilaporkan telah menjual 75% pasokan memori 2027-nya. (Sumber: Tech Insider)
Dengan kata lain, ikut dalam roadmap HBM berarti antre untuk alokasi 2027. Di pasar seperti ini, "membangun farm inferensi tanpa HBM" bukan sekadar penghematan biaya — melainkan penghindaran risiko pengadaan. LPDDR5X adalah DRAM komoditas yang diproduksi massal untuk ponsel dan PC. Tidak ada bottleneck pengemasan TSV/interposer, basis pemasok luas, dan biaya per GB lebih rendah. Tesla sampai pada kesimpulan yang sama.
3. Tesla bergerak ke arah yang sama — de-speccing memori AI5/AI6
Pada 1 Oktober, Elon Musk mengumumkan Tesla akan memangkas memori AI5 dari rencana awal 144GB LPDDR5 menjadi 72GB, dan AI6 menjadi 144GB LPDDR6 (pemotongan sepertiga). Alasannya eksplisit: mengamankan volume yang cukup untuk produksi Optimus. AI5 kemudian disesuaikan menjadi 96GB. Musk menambahkan bahwa bandwidth memori, bukan kapasitas, adalah kendala yang lebih besar, sehingga dampak performanya seharusnya bisa diabaikan. (Sumber: Wccftech)
Polanya tidak bisa disalahartikan: kelangkaan memori mengubah spesifikasi desain itu sendiri. Mendefinisikan ulang produk di sekitar memori yang bisa diamankan menjadi prosedur operasi standar untuk perangkat keras AI pada akhir 2026. Perlu dicatat, AI5 sudah dalam produksi percobaan di fab Taylor, Texas milik Samsung Foundry.
4. Strategi memori bercabang — NVIDIA vs Intel
Pihak yang percaya diri dengan pasokan memori justru mengambil arah berlawanan. Roadmap NVIDIA:
- Rubin (2026): HBM4
- Rubin Ultra (2027): HBM4E
- Feynman (2028): dilaporkan custom HBM — desain yang disesuaikan, bukan HBM standar (Sumber)
- NVHBM (diumumkan Agustus 2026): teknologi HBM base-die custom NVIDIA, didesain bersama dengan produsen memori — diklaim bandwidth per stack +30% vs HBM4E standar, daya HBM −15%, area PHY −67% (Sumber: WeDoAny)
AMD juga tetap di jalur HBM: MI455X mengemas 3.456Gb (432GB) HBM4 pada 19,6 TB/s. (Sumber: TweakTown)
Strategi memori kini bercabang dua:
| Strategi | Pemain | Arah |
|---|---|---|
| Optimasi bandwidth & daya | NVIDIA (NVHBM custom HBM), AMD (HBM4/HBM4E) | Memeras memori mahal lebih keras — training & inferensi flagship |
| Optimasi kapasitas & biaya | Intel (LPDDR5X 480GB), Tesla (LPDDR5/6) | Lebih banyak memori murah — kompetisi TCO farm inferensi |
Tidak ada yang "benar". Beban kerja terbelah. Training frontier dan inferensi premium haus bandwidth; layanan token massal, on-device, dan inferensi robotik digerakkan oleh kapasitas dan biaya.
5. Mengurai TCO — empat tuas di balik biaya per token
TCO infrastruktur inferensi terurai menjadi empat tuas:
① Pengadaan memori. HBM habis terjual — pembeli berebut alokasi dengan premi. LPDDR5X adalah pasar komoditas dengan daya tawar negosiasi dan stabilitas pasokan. Di era ini, keteramankan pasokan adalah baris pertama persamaan TCO.
② Daya & pendingin. 350W berpendingin udara vs 1.000W berpendingin cairan bukan sekadar soal daya chip — ia menyeret densitas daya rack, belanja modal (capex) pendingin cairan, dan tagihan listrik. Itulah sebabnya Intel mengedepankan "skala tanpa infrastruktur rack atau pendingin khusus."
③ Kapasitas per server. Sistem D270 8 kartu menampung memori total 3,84TB untuk model 1T+ parameter. Lebih sedikit node berarti lebih sedikit jaringan, daya, dan kompleksitas operasional. Kapasitas adalah densitas node.
④ Utilisasi. Server inferensi hidup dalam keadaan memory-bound, bukan menganggur. Bahkan dengan bandwidth lebih rendah, KV cache dan batch yang besar bisa memeras throughput token. Logika yang sama dengan komentar Tesla bahwa "bandwidth adalah kendala yang lebih besar."
Chase's Take
Jika metrik era training adalah FLOPS, metrik era inferensi adalah dolar per token. Taruhan Intel menerjemahkan proposisi itu menjadi silikon. 1,3 PFLOPS terlihat sederhana dibanding flagship — tapi ubah pertanyaannya dari "siapa yang lebih cepat" menjadi "siapa yang mencetak token lebih murah," dan permainannya berubah.
Dua poin struktural:
Pertama, kelangkaan HBM telah menjadi variabel struktural yang memaksa pilihan arsitektur, bukan sekadar gangguan pasokan sementara. De-speccing Tesla dan LPDDR Intel adalah respons berbeda terhadap tekanan yang sama. Selama pemegang memori (SK hynix dengan ~57% pendapatan HBM, dan para pesaingnya) memegang kekuatan harga, pembeli memori mendesain ulang di sekitar memori yang bisa diamankan. Bacalah berita perangkat keras AI 2–3 tahun ke depan di atas ketegangan ini.
Kedua, kepentingan Korea berada di kedua sisi. Samsung dan SK hynix adalah penerima langsung premi HBM. Pada saat yang sama, Samsung Foundry men-tape-out AI5 Tesla di Taylor, dan CXMT dari Tiongkok mengejar di rantai pasok LPDDR. Pergeseran bauran memori dari HBM saja menuju HBM-plus-LPDDR beriak ke portofolio duopoli memori Korea dan bauran pelanggan foundry. Analisis yang bertaruh hanya pada satu sisi hanyalah setengah gambaran.
Argumen penyeimbang, dinyatakan secara adil: 1,5 TB/s itu rendah, dan inferensi real-time yang sensitif latensi (TTFT) bisa menderita. Di atas segalanya, harga tidak diumumkan — keunggulan TCO tidak bisa diverifikasi sampai daftar harga ada. Menyatakan kemenangan "nilai inferensi" hanya dari angka teoretis akan menjadi prematur.
Implications
Bagi investor: - Seiring porsi beban kerja inferensi tumbuh, bauran memori bergeser menjauh dari HBM saja. Saatnya menilai ulang penerima manfaat struktural dari permintaan LPDDR5X dan DRAM server. - Premi HBM kemungkinan bertahan hingga 2027 — 2026 habis terjual, alokasi 2027 sudah dipesan duluan, dan transisi HBM4E yang didefinisikan vendor. Kekuatan harga produsen memori bertahan untuk saat ini. - Infrastruktur daya/pendingin (tetap berpendingin udara vs beralih ke cairan) adalah variabel belanja modal (capex) pusat data yang baru. Penyebaran kartu inferensi kelas 350W bisa memperlambat transisi pendingin cairan.
Bagi operator: - Pengadaan infrastruktur AI bergeser dari "chip tercepat" ke "memori yang bisa diamankan." Rencanakan kapasitas 2027 mundur dari alokasi memori. - Pantau opsi inferensi berbasis LPDDR sebagai lindung nilai diversifikasi vendor. Ini bisa menjadi studi kasus dunia nyata pertama untuk alternatif inferensi non-NVIDIA.
FAQ
Q1. Bandwidth LPDDR5X jauh lebih rendah dari HBM — apakah benar cukup untuk inferensi? A. Tergantung bebannya. Berbeda dengan training yang terus-menerus mengaduk bobot, inferensi memuat bobot sekali lalu menghasilkan ribuan token. Bottleneck-nya sering kali adalah kapasitas KV cache dan ukuran batch, bukan bandwidth. Serving real-time yang sensitif latensi (TTFT) adalah titik di mana defisit bandwidth terlihat.
Q2. Apakah 480GB benar-benar bisa menampung model 300 miliar parameter dalam satu kartu? A. Dalam FP8, satu parameter ≈ satu byte, jadi 300B parameter ≈ 300GB. Itu menyisakan ~180GB di kartu 480GB untuk KV cache dan batching — secara matematis konsisten dengan klaim Intel. Perilaku aktualnya menunggu benchmark independen.
Q3. Berapa harganya? A. Tidak diumumkan. Intel hanya menyatakan sampling pelanggan sedang berjalan. Keunggulan TCO sejati vs kartu HBM tidak bisa dihitung sampai harga ada. Perdebatan nilai tanpa daftar harga hanyalah setengah perdebatan.
Q4. Kapan kelangkaan HBM mereda? A. Volume 2026 praktis habis terjual; sebagian besar 2027 sudah dipesan duluan. Produksi volume HBM4E ditargetkan 2027, tapi sebagai generasi yang didefinisikan vendor, kecepatan ramp-nya adalah variabelnya. Bersiaplah untuk kondisi ketat hingga 2027.
Bacaan Lanjutan
- Chris Miller, Chip War — geopolitik dan rantai pasok hegemoni semikonduktor. Lihat di Amazon
- Clayton Christensen, The Innovator's Dilemma — klasik MBA tentang bagaimana pendatang dari segmen bawah membalikkan pasar; lensa untuk membaca taruhan LPDDR Intel. Lihat di Amazon
Pembelian melalui tautan ini dapat menghasilkan komisi
Catatan: Angka dan lini masa didasarkan pada pengungkapan publik per 13 Oktober 2026. Angka performa Intel D270 adalah nilai teoretis yang dipublikasikan vendor tanpa verifikasi benchmark independen. Bukan nasihat investasi.
Tags: deep-dive, inference, memory-tco, lpddr5x, hbm, indonesian