VLSI Korea
Bedah GPU Inferensi Intel: Mengapa D270 Melewatkan HBM demi LPDDR5X 480GB
Intel melewatkan HBM dan memilih LPDDR5X: 160GB di kartunya sendiri, hingga 480GB di desain ODM. Memverifikasi angka viral itu, logika kapasitas di atas bandwidth, dan maknanya bagi Samsung, SK hynix, dan Micron.


Ringkasan 30 Detik
Pada 12 Oktober 2026, di OCP Global Summit, Intel memberikan nama komersial dan spesifikasi final untuk GPU khusus inferensinya. Ber-nama sandi Crescent Island, lini produk ini bernama Intel GPU D-Series, dan kartu pertamanya adalah D270 (menurut pemberitaan media teknologi). Sorotan utamanya ada pada memori: kartu ini sama sekali tidak memakai HBM. Dua puluh paket LPDDR5X menghasilkan bandwidth 1,5 TB/s, dan meski kartu Intel sendiri membawa 160GB, desain mitra ODM dapat menaikkan kapasitas hingga 480GB. Angka "LPDDR5X 480GB" yang beredar di unggahan analisis media sosial itu nyata — tetapi bersyarat: kartu yang dijual Intel sendiri adalah 160GB. Komputasinya 1,3 PFLOPS FP8 dalam kartu PCIe 350W berpendingin udara. Intel menyebut satu kartu dapat melayani model hingga 300 miliar parameter, dan sistem delapan kartu melampaui satu triliun parameter. Pengambilan sampel pelanggan sedang berjalan; harga dan tanggal ketersediaan umum belum diumumkan. Bedah ini merangkum seluruh fakta yang terkonfirmasi, logika teknis dan ekonomis di balik "mengapa LPDDR", serta maknanya bagi Samsung Electronics, SK hynix, dan Micron.
Apa yang Sebenarnya Diumumkan Intel
Crescent Island tidak muncul dalam semalam. Intel pertama kali memperkenalkan GPU inferensi ini di OCP Global Summit Oktober 2025, dengan konfigurasi LPDDR5X 160GB. Di Hot Chips pada Agustus 2026, Intel menguraikan arsitektur Xe3P secara rinci, dan pada 12 Oktober 2026 menetapkan merek GPU D-Series beserta spesifikasi finalnya. Intel juga memamerkan prototipe modul OAM berpendingin cairan — dua GPU per modul, delapan modul dalam sasis 5U — sinyal bahwa PCIe berpendingin udara adalah ujung tombak, sementara faktor bentuk yang lebih padat tetap ada di peta jalan.
Filosofi desainnya konsisten sejak awal: tidak bertarung langsung dengan GPU pelatihan kelas flagship. Sasarannya bukan benteng HBM milik Blackwell Ultra dari NVIDIA atau seri MI dari AMD, melainkan beban kerja inferensi yang muat di server x86 standar yang sudah dimiliki perusahaan. Anil Nanduri, VP produk AI dan go-to-market Intel untuk Data Center Group, mengatakannya dengan gamblang: "Inferensi menjadi beban kerja yang mendefinisikan AI, dan perusahaan membutuhkan infrastruktur yang memberikan performa yang tepat dengan biaya yang tepat."
| Spesifikasi | Intel GPU D270 (Crescent Island) |
|---|---|
| Arsitektur | Xe3P (Xe3 yang ditingkatkan) |
| Inti Xe | 32 (empat slice) |
| Mesin matriks XMX | 256 |
| Komputasi FP8 (dense) | 1,3 PFLOPS |
| Komputasi vektor FP64 | 10,2 TFLOPS |
| Cache L2 | 32MB (terpadu) |
| Memori | LPDDR5X, 20 paket, 80 kanal, 1.280-bit |
| Kecepatan memori | 9.375 MT/s |
| Bandwidth memori | 1,5 TB/s |
| Kapasitas memori | 160GB (kartu Intel) / hingga 480GB (desain ODM) |
| Antarmuka host | PCIe Gen5 x16 |
| Daya | 350W |
| Faktor bentuk / pendinginan | PCIe CEM lebar ganda, udara |
| Status | Sampel pelanggan (Okt 2026); harga dan tanggal rilis belum diumumkan |
Sumber: pengungkapan Intel pada OCP Global Summit 12 Oktober 2026 dan materi arsitektur Hot Chips 2026.
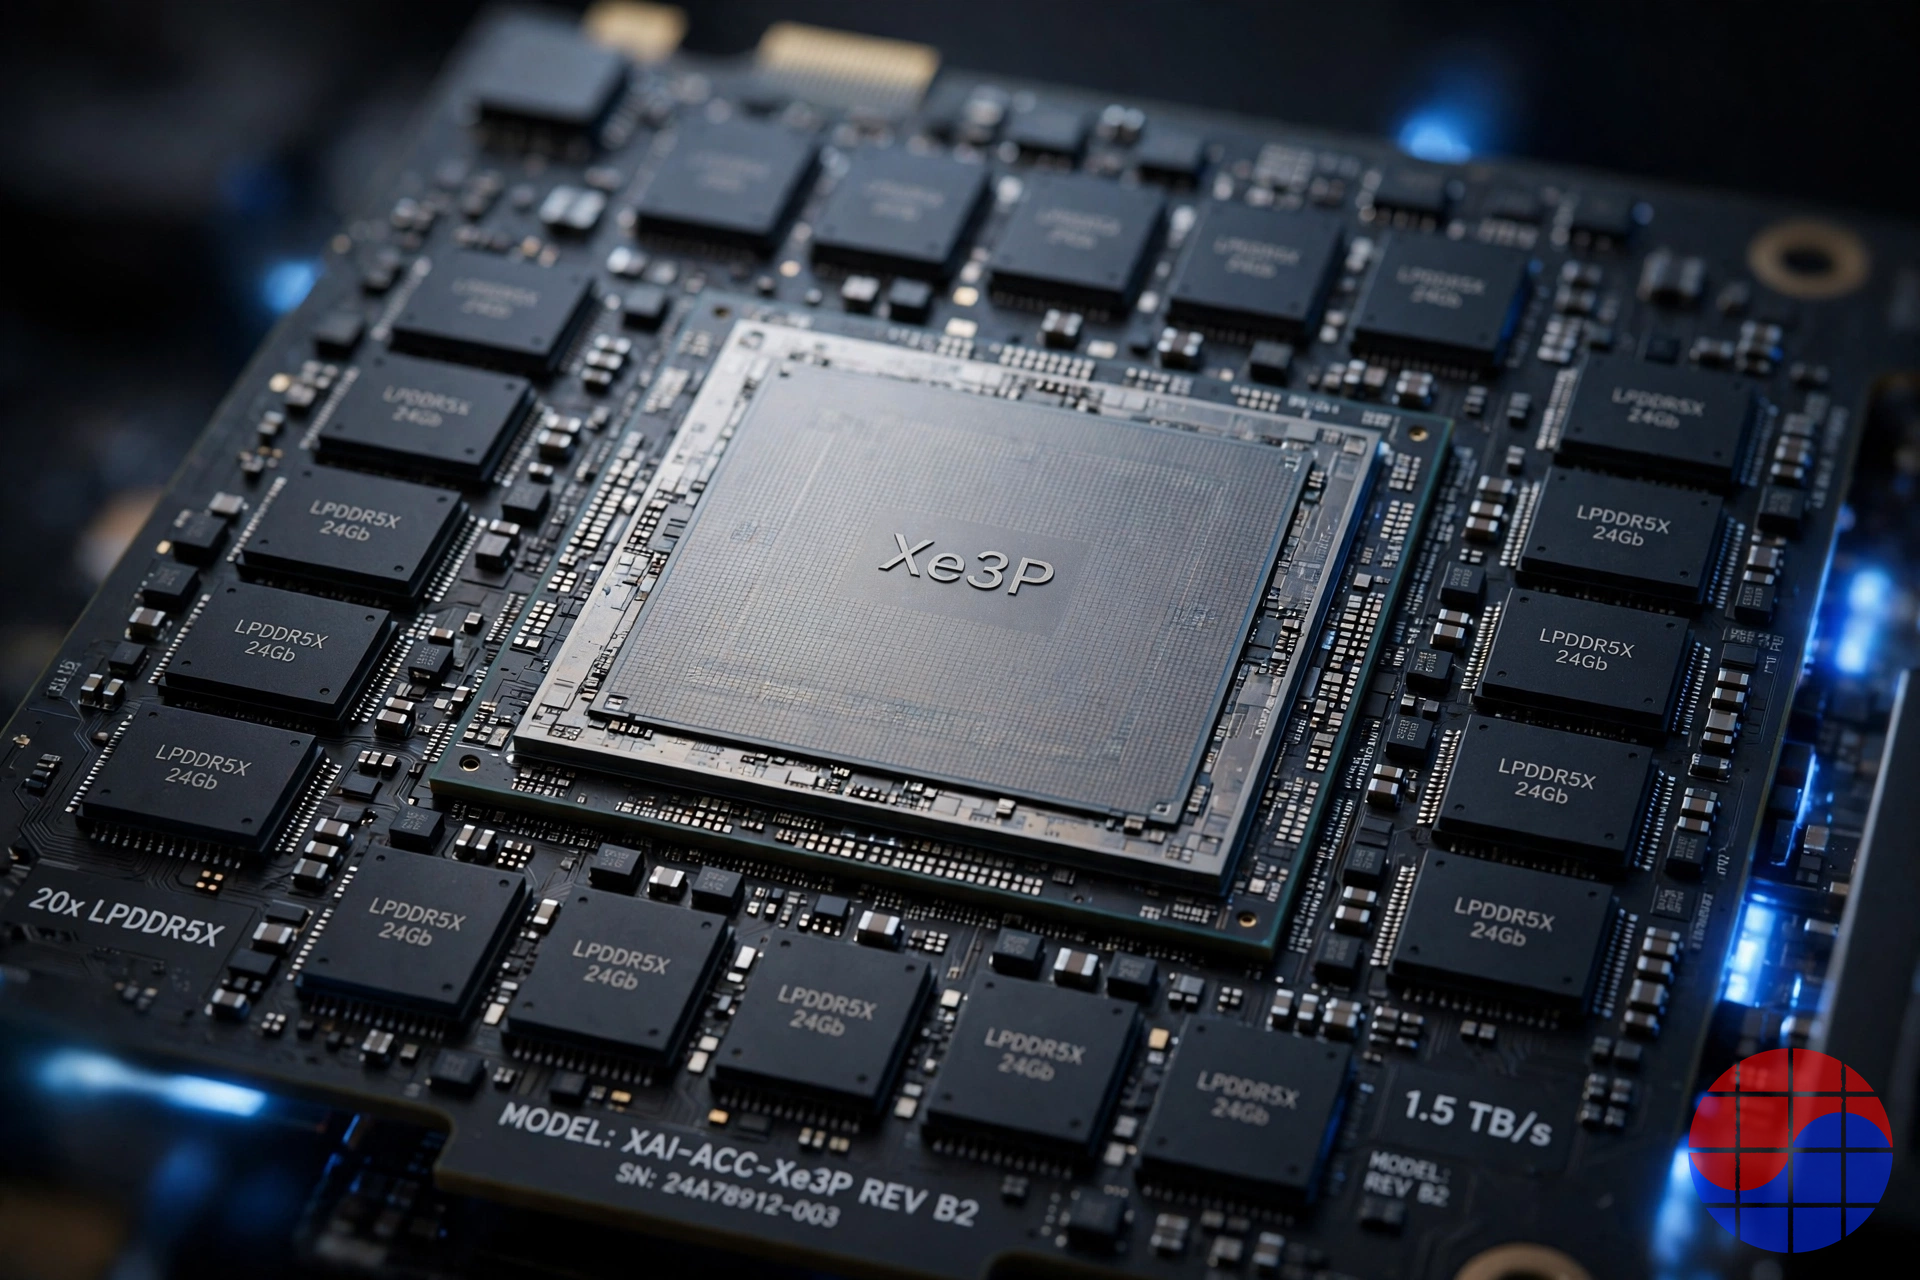
Inti Xe3P sendiri dipangkas ulang untuk inferensi. Array sistolik XMX diperdalam dari 4-deep di Xe2 menjadi 16-deep, file register umum digandakan menjadi 1MB per inti, dan memori L1/lokal bersama tumbuh menjadi 512KB per inti. Blok grafis 3D dan ray tracing khas GPU gaming dibuang seluruhnya, menyerahkan setiap milimeter persegi untuk matematika matriks dan tipe data inferensi dari FP4 hingga FP64. Perangkat lunaknya bertumpu pada tumpukan terbuka yang berpusat pada OpenVINO dan oneAPI.
Memverifikasi 480GB: Angka Nyata, Catatan Kaki yang Hilang
Setelah pengumuman, "LPDDR5X 480GB" berkelana di analisis media sosial seolah-olah itu spesifikasi utama kartu ini. Angka itu memang muncul dalam pengungkapan Intel — tetapi itu adalah konfigurasi maksimum yang dapat dibangun mitra ODM, bukan spesifikasi kartu bermerek Intel. Tanpa catatan kaki itu, angka tersebut menyesatkan.
| Konfigurasi | Kepadatan per paket | Jumlah paket | Total kapasitas | Penjual |
|---|---|---|---|---|
| Kartu referensi Intel | Paket kelas 64Gb | 20 | 160GB | Intel (kartu bermerek) |
| Maksimum ODM | Paket kelas 192Gb | 20 | 480GB | Mitra (papan ODM) |
Subsistem memorinya identik pada kedua konfigurasi: bus 80 kanal 16-bit (1.280-bit) yang berjalan pada 9.375 MT/s untuk 1,5 TB/s. Yang berbeda hanyalah berapa banyak die DRAM yang ditumpuk di dalam setiap paket. Jadi 480GB adalah "langit-langit yang dimungkinkan desain", dan 160GB adalah "yang benar-benar dikirimkan Intel". Either way, ini adalah kelas kapasitas terbesar yang diumumkan untuk kartu inferensi PCIe. Sebagai pembanding, GPU Rubin dari NVIDIA membawa 288GB HBM4 dan seri MI450 dari AMD dilaporkan sebesar 432GB — dalam kapasitas mentah, desain LPDDR membalik hierarki yang biasa.
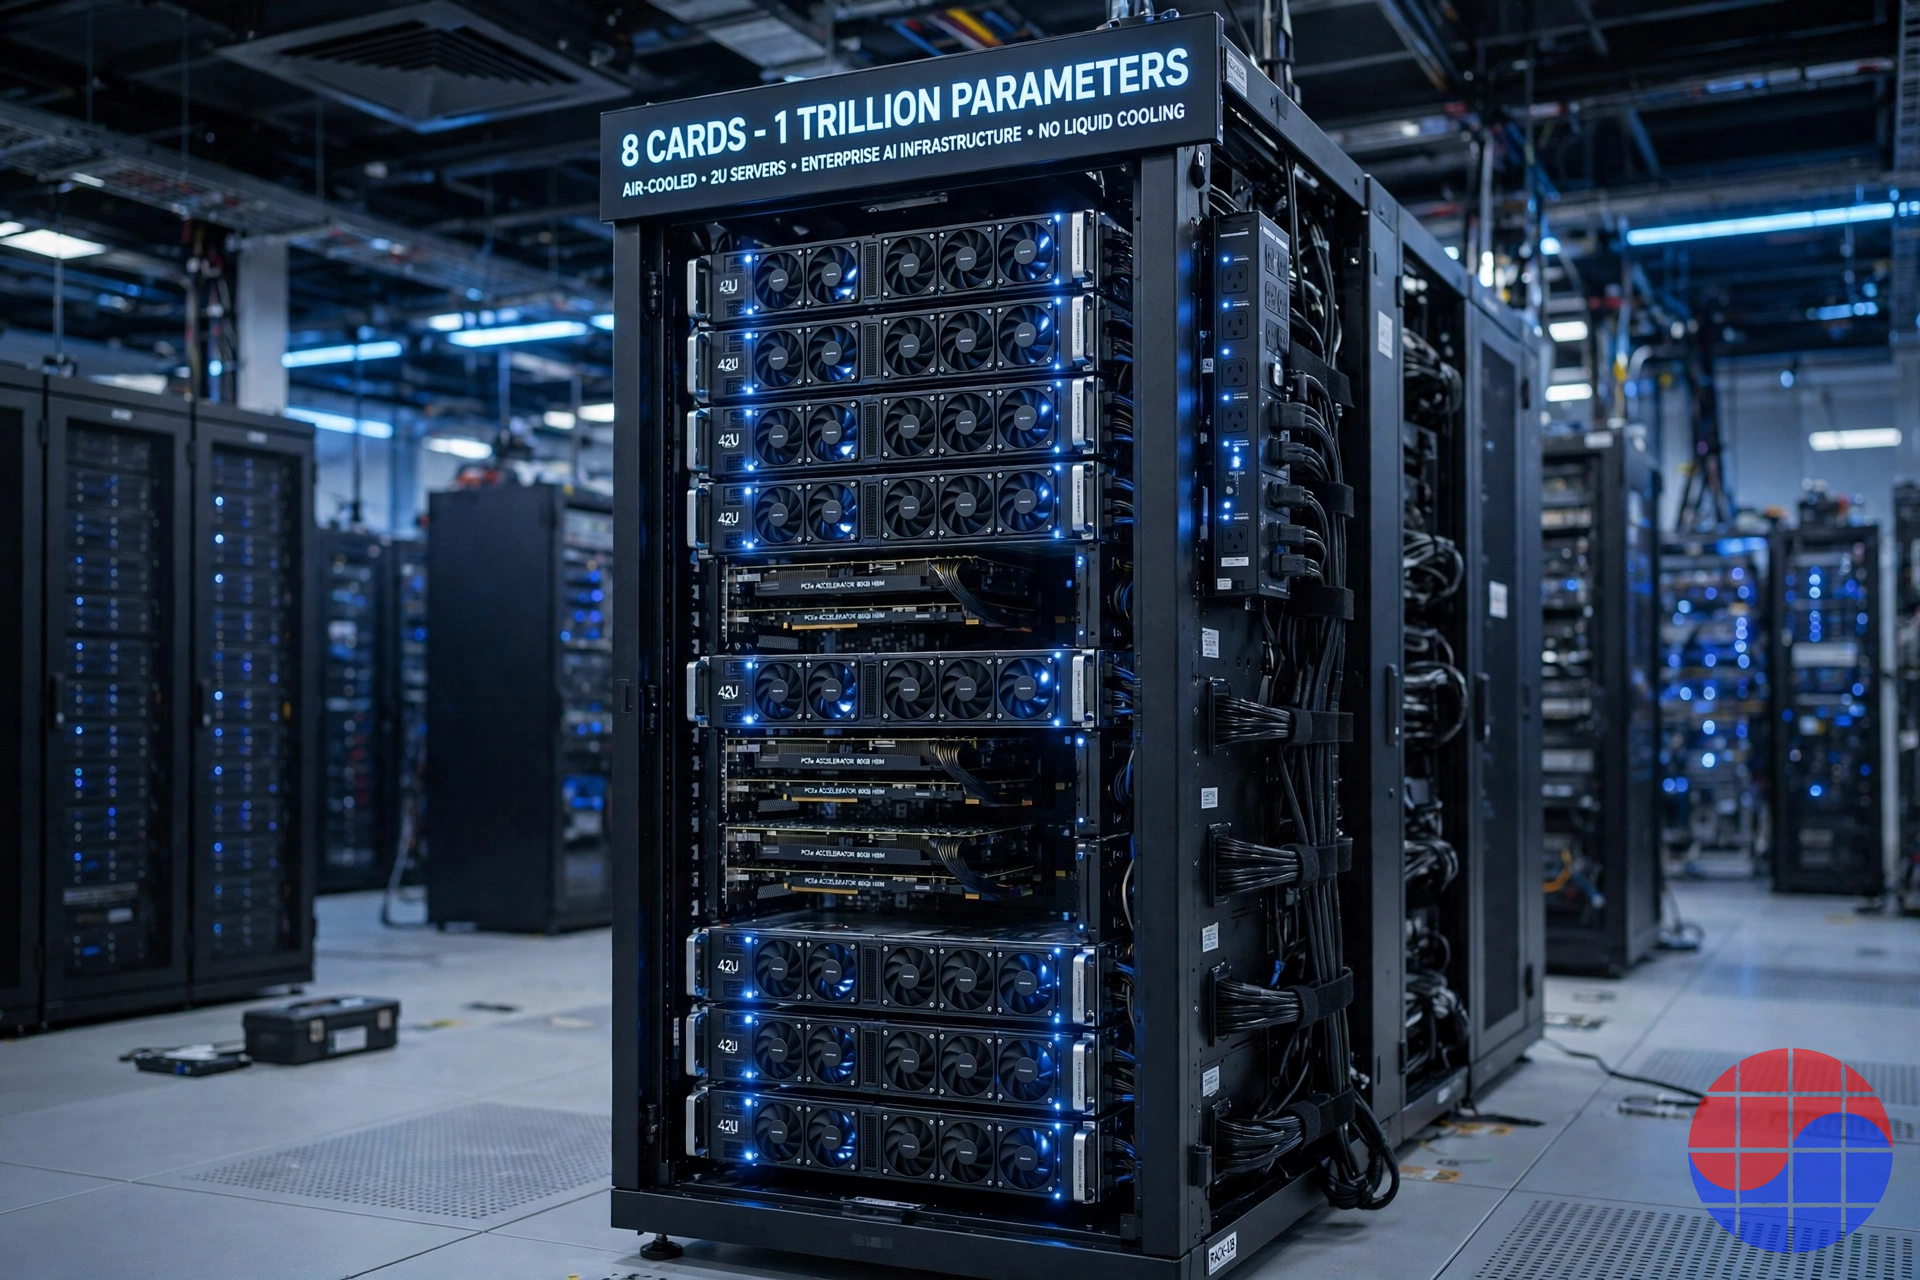
Aritmetika ukuran model memerlukan kehati-hatian yang sama. Pada FP8 (satu byte per parameter), kartu 160GB menampung sekitar 160 miliar parameter bobot sebelum cache KV dan overhead runtime; klaim Intel "300 miliar parameter pada satu kartu" berkorespondensi dengan konfigurasi 480GB. Sistem delapan kartu "lebih dari satu triliun parameter" juga mengandaikan 480GB × 8 = 3,84TB memori gabungan. Angka-angkanya tidak salah — tetapi konfigurasi referensinya harus selalu menyertainya.
Mengapa LPDDR5X (1): Inferensi Tersumbat di Memori, Bukan di Komputasi
Pelatihan dan inferensi memakai memori dengan cara berbeda. Pelatihan mengulang perkalian matriks raksasa, sehingga FLOPS dan bandwidth sama-sama penting. Inferensi — terutama fase decode yang mengeluarkan satu token pada satu waktu — adalah permainan bandwidth pada ukuran batch kecil: setiap token mengharuskan seluruh bobot model dibaca dari memori satu kali, sehingga waktu untuk mengalirkan bobot menentukan latensi antar-token.
Namun dalam layanan produksi, bandwidth bukan satu-satunya tembok. Ketika konkurensi naik dan konteks memanjang, cache KV melahap memori dengan cepat. Kendala yang mengikat menjadi: apakah modelnya muat di satu kartu, dan berapa banyak permintaan bersamaan serta seberapa panjang konteks yang dapat ditopang kartu itu? Jika kapasitas kurang, model harus dipecah ke banyak kartu, dan lalu lintas antar-kartu serta komputasi menganggur menjadi biaya murni. Di titik inilah tepatnya taruhan Intel. D270 menyerahkan satu orde magnitudo bandwidth kepada flagship HBM, tetapi melipatgandakan kapasitas dua hingga tiga kali dengan sebagian kecil dari harga dan daya kartu — dan dalam rezim itu, biaya per token yang menang.
Bingkai dalam angka: 1,5 TB/s tidak mencapai bahkan satu tumpukan HBM4 (2,8 TB/s ke atas), apalagi puluhan TB/s milik flagship 12 tumpukan. Sebagai gantinya, D270 adalah kartu 350W berpendingin udara. Ketika flagship HBM menembus 1.000W dan memaksa rak berpendingin cairan, D270 masuk ke slot PCIe kosong di server perusahaan yang sudah ada. Intel tidak menjual performa puncak; Intel menjual kapasitas inferensi yang dapat diterapkan hari ini, di infrastruktur yang sudah tersedia.
Mengapa LPDDR5X (2): Biaya per GB dan Kemungkinan Membelinya
Argumen kedua adalah uang dan pasokan. HBM4 dibicarakan di kisaran 31–32 dolar per GB — sekitar dua kali lipat 17–18 dolar per GB milik HBM3E (estimasi industri). LPDDR5X, bahkan setelah lonjakan harga supersiklus, diperdagangkan sekitar 12 dolar per GB pada level paket 12GB — kurang dari separuh HBM4. Pengemasan memperlebar jurangnya: HBM mewarisi kemacetan penumpukan TSV dan interposer pada kapasitas pengemasan canggih, sementara LPDDR5X adalah DRAM komoditas yang dikonsumsi ratusan juta ponsel dan PC setiap tahun, dengan kolam pemasok yang luas dan pengemasan standar.
Risiko pengadaan adalah realitas 2026. Produksi HBM 2026 milik Samsung dan SK hynix secara efektif telah habis terjual, dan Micron dilaporkan telah mengikat sebagian besar pasokan 2027-nya di muka. Bergabung dengan antrean HBM hari ini berarti menunggu alokasi 2027. LPDDR5X, sebaliknya, dapat dibeli sekarang. Bagi pendatang akhir dengan prioritas rendah dalam antrean alokasi HBM, "kartu inferensi tanpa HBM" adalah sekaligus pemotongan biaya dan lindung nilai terhadap risiko pengadaan. Intel bukan satu-satunya yang sampai pada kesimpulan ini: chip inferensi internal Meta, keluarga MTIA, menggunakan memori kelas LPDDR, dan silikon inferensi Tesla membuat pilihan keluarga yang sama.
Tiga Memori Berhadapan: HBM4 vs LPDDR5X vs GDDR7
| Dimensi | HBM4 | LPDDR5X | GDDR7 |
|---|---|---|---|
| Bandwidth per tumpukan/chip | 2,8+ TB/s per tumpukan | ~77 GB/s per paket (1,5 TB/s per kartu) | Hingga ~144 GB/s per chip |
| Total bandwidth per akselerator | Puluhan TB/s (12 tumpukan) | 1,5 TB/s (D270) | ~1,8 TB/s (512-bit) |
| Kapasitas per akselerator | 288–432GB | 160–480GB | 32–96GB |
| Biaya per GB | ~31–32 dolar (estimasi industri) | ~12 dolar (harga lonjakan 2026) | Jauh di bawah HBM (grafis komoditas) |
| Profil daya | Tinggi, termasuk sistem interposer | Energi per bit terendah (desain mobile) | Energi per bit lebih tinggi dari LPDDR |
| Pengemasan | Tumpukan TSV + interposer wajib | Paket standar, dipasang di papan | Dipasang di papan |
| Situasi pasokan | Produksi 2026 habis; perebutan alokasi | DRAM komoditas; kolam pemasok luas | Berebut dengan permintaan grafis |
| Pengadopsi utama | NVIDIA Rubin, seri MI450 AMD, flagship TPU/Trainium | Intel GPU D-Series, Grace/Vera NVIDIA (memori CPU), Meta MTIA | Seri GeForce RTX 50 dan kartu grafis lain |
Catatan: angka biaya per GB adalah estimasi yang sangat bervariasi menurut waktu dan syarat kontrak; ditampilkan untuk menggambarkan arah — LPDDR5X kurang dari separuh HBM4. Angka bandwidth mengikuti spesifikasi yang diungkapkan masing-masing vendor.
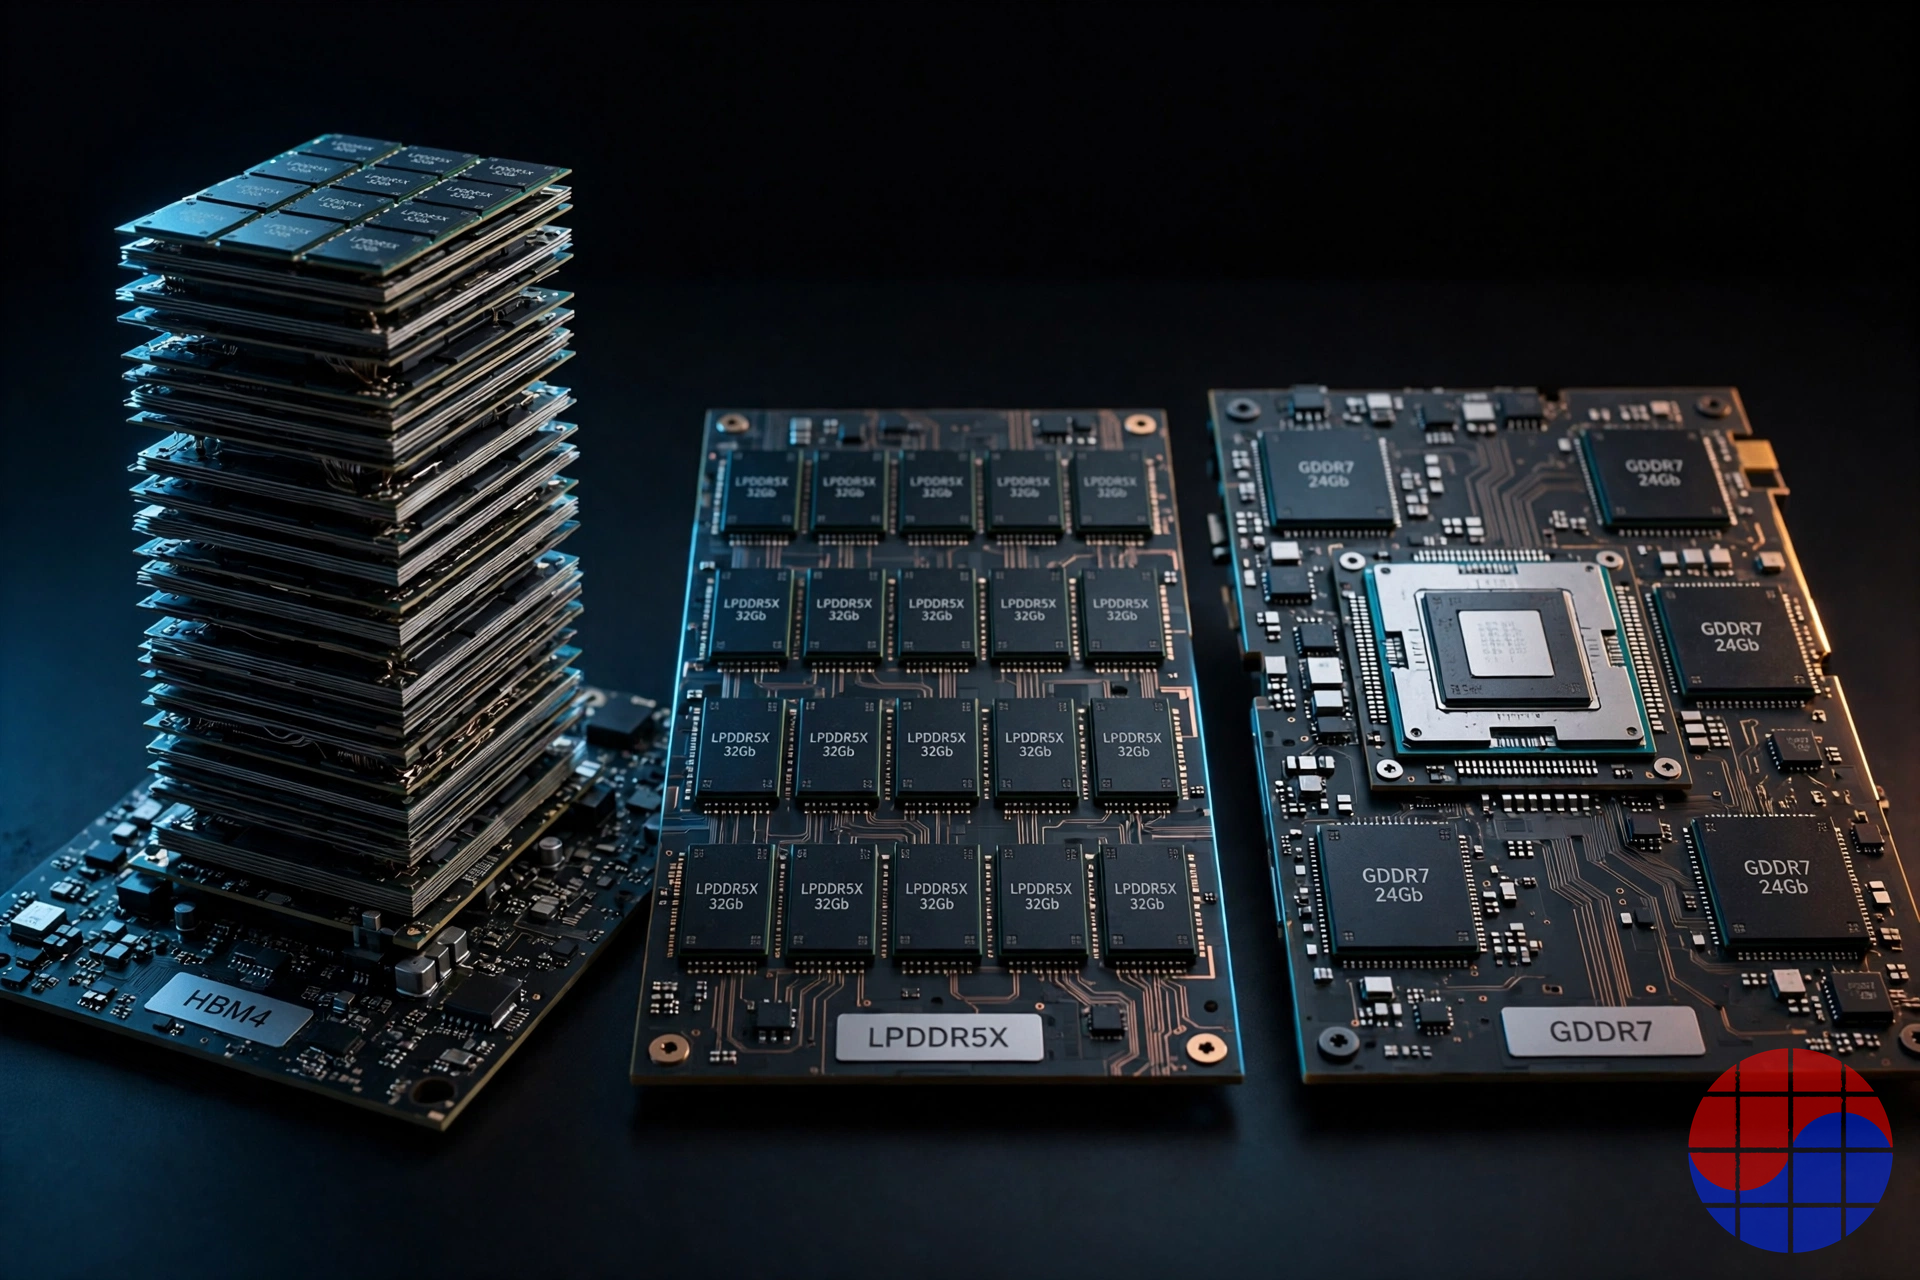
Tabel ini bukan peringkat; ini adalah pilihan tentang kendala mana yang dibeli. HBM4 membeli bandwidth dan menerima biaya kapasitas serta risiko alokasi. GDDR7 murah dengan bandwidth yang terhormat, tetapi kapasitas per chip-nya yang kecil menyulitkan menempatkan ratusan gigabyte pada satu kartu. LPDDR5X menyerahkan bandwidth dan menang dalam biaya kapasitas, ketersediaan, dan daya. Semakin permintaan inferensi bergeser dari "token tercepat" ke "token termurah", semakin pusat gravitasi tabel ini miring ke LPDDR.
Makna bagi Pemasok: Samsung, SK hynix, Micron — dan SOCAMM
Bagi tiga raksasa memori, sinyalnya sederhana: permintaan DRAM pusat data AI tidak hanya menyatu ke HBM. Di sisi CPU, volume besar sudah mengalir ke LPDDR. Grace dari NVIDIA membawa hingga 480GB LPDDR5X per CPU; penerusnya, Vera, naik hingga 1,5TB pada 1,2 TB/s melalui modul SOCAMM2. Satu rak Vera Rubin NVL72 menampung 36 CPU Vera — hingga 54TB memori CPU per rak. Tambahkan akselerator LPDDR seperti D270, dan LPDDR pusat data tumbuh dari "memori di sebelah CPU" menjadi sumbu permintaan yang mandiri.
Modularisasi itu penting. LPDDR bermula sebagai komponen mobile yang disolder ke papan; format SOCAMM dari NVIDIA mendefinisikannya kembali sebagai komponen server yang dapat diganti dan ditingkatkan. Samsung, SK hynix, dan Micron semuanya berpartisipasi dalam pasokan SOCAMM, dan NVIDIA dilaporkan menambahkan Nanya dari Taiwan ke dalam rantai pasokan LPDDR Vera — diversifikasi yang dengan sendirinya menandakan besarnya volume.
Dari kursi pemasok Korea, permintaan ini bermata dua. Di satu sisi, kolam permintaan baru yang digerakkan AI mengisi pasar DRAM komoditas yang telah terkuras oleh konversi ke HBM — permintaan server adalah bagian dari alasan harga LPDDR5X melonjak dua digit per kuartal sepanjang 2026. Di sisi lain, LPDDR tetaplah DRAM komoditas: tidak ada margin berlebih ala HBM, dan ada paparan langsung terhadap persaingan harga dari pengikut seperti CXMT. Meski begitu, arah volumenya tidak ambigu. Mulai 2027, permintaan bit LPDDR di infrastruktur AI tumbuh secara struktural dari soket CPU dan akselerator inferensi sekaligus.
Bingkai Kompetisi: NVIDIA pun Memasang LPDDR di Samping CPU-nya
Membaca pilihan Intel semata-mata sebagai "jalan mundur perusahaan yang gagal mengamankan HBM" berarti melewatkan separuh ceritanya. NVIDIA — pembeli HBM terbesar di planet ini — sendiri menjalankan strategi memori jalur ganda: HBM4 di GPU, LPDDR5X di CPU, membagi peran yang haus bandwidth dan yang haus kapasitas menurut beban kerja. Dari Grace ke Vera, kapasitas memori CPU naik tiga kali lipat dari 480GB menjadi 1,5TB dan bandwidth naik dari 512 GB/s menjadi 1,2 TB/s; dalam pandangan NVIDIA, CPU era AI agentik adalah komponen yang harus memikul lebih banyak memori, bukan lebih sedikit.
AMD memegang sisi yang berlawanan: seri MI mempertahankan garis ortodoks HBM-di-mana-mana dan memperjuangkan inferensi lewat bandwidth. ASIC kustom terbelah dua arah — TPU Google dan Trainium AWS mengambil HBM, MTIA Meta mengambil memori kelas LPDDR. Konsensus industri yang muncul adalah struktur dua lantai: HBM untuk pelatihan dan layanan frontier; LPDDR tumbuh di bawahnya, dalam inferensi massal dan memori CPU. D270 adalah upaya skala penuh pertama untuk menyerang lantai bawah itu dalam faktor bentuk GPU.
Chase's Take
Lepaskan mereknya, dan produk ini adalah strategi pengadaan memori yang menyamar sebagai GPU. Intel menghindari pertarungan komputasi yang tidak dapat dimenanginya dan menghadirkan kapasitas inferensi terbesar yang dapat dibangun dari memori yang benar-benar dapat dibeli pada 2026–2027. Angka 1,3 PFLOPS itu biasa saja; kombinasi — 480GB pada kartu 350W berpendingin udara — adalah koordinat yang tidak ditempati pesaing mana pun.
Bagi pembuat memori Korea, ini adalah angin penarik yang senyap. Di balik harga HBM yang glamor, sumbu permintaan AI kedua — LPDDR server — sedang mengeras menjadi volume nyata. Ketika 1,5TB per soket milik Vera dan hingga 480GB per kartu milik D270 mulai dikirimkan berdampingan, LPDDR5X akan dihargai ulang dari komponen ponsel menjadi infrastruktur AI. Jebakannya: kenaikan harga LPDDR menggerogoti logika TCO Intel sendiri. Semakin mahal LPDDR, semakin tipis margin persamaan "memori murah, inferensi murah". Nasib produk ini akan lebih ditentukan oleh kurva harga memori daripada oleh silikonnya.
Untuk struktur biaya memori inferensi yang dibaca berhadapan dengan angka-angka kubu HBM itu sendiri, lihat juga: No HBM Needed? Intel's 480GB LPDDR5X Bet and the Inference Memory TCO War
Risiko dan Hal yang Belum Diketahui
Pertama, sifat angka performanya: 1,3 PFLOPS adalah puncak teoretis tanpa benchmark independen sejauh ini, dan throughput token nyata sangat bergantung pada optimisasi kernel dan kematangan tumpukan. Kedua, ekosistem perangkat lunak: gravitasi CUDA kuat juga di inferensi, dan kelancaran tumpukan OpenVINO/oneAPI menempel pada kerangka layanan produksi akan menentukan adopsi — lini Gaudi Intel kalah oleh ekosistem lebih daripada oleh silikon, preseden yang tidak dapat diabaikan. Ketiga, langit-langit bandwidth: 1,5 TB/s dapat menjadi kemacetan pada decode batch besar untuk model yang sangat besar, dan Intel sendiri menarik garis di luar pelatihan dan layanan frontier. Keempat, syarat komersialnya masih kosong: tanpa harga, tanpa tanggal ketersediaan, dengan pengiriman volume yang dibicarakan untuk 2027 — pada saat itu HBM4E telah tiba dan harga LPDDR mungkin naik lebih jauh, menggambar ulang peta kompetitifnya. Terakhir, reaksi pertama pasar terasa dingin: saham Intel dilaporkan ditutup melemah pada hari pengumuman.
FAQ
Q: Apakah LPDDR5X 480GB pada D270 adalah spesifikasi yang terkonfirmasi? A: Angka itu nyata sebagai konfigurasi maksimum, tetapi kartu Intel sendiri membawa 160GB. Angka 480GB adalah langit-langit untuk papan ODM yang diisi paket berkepadatan lebih tinggi (kelas 192Gb). Sebagian besar kutipan "480GB" di media sosial menghilangkan syarat tersebut.
Q: Mengapa memakai LPDDR5X alih-alih HBM pada GPU inferensi? A: Karena inferensi produksi lebih dibatasi oleh kapasitas untuk menampung model dan cache KV serta oleh biaya per token, daripada oleh komputasi mentah. LPDDR5X dibicarakan pada kurang dari separuh biaya per GB HBM4, jauh lebih mudah diperoleh, dan berdaya lebih rendah. Desainnya mengorbankan bandwidth puncak untuk menang pada kapasitas dan biaya.
Q: Setara apa bandwidth 1,5 TB/s milik D270? A: Di bawah satu tumpukan HBM4 (2,8 TB/s ke atas) dan satu orde magnitudo di bawah akselerator flagship berpuluhan TB/s — tetapi berada di pita yang sama dengan konfigurasi GDDR7 512-bit (~1,8 TB/s). Ini angka yang dibangun untuk bersaing pada kapasitas per watt dan per dolar, bukan pada throughput mutlak.
Q: Apa artinya ini bagi Samsung Electronics dan SK hynix? A: Ini menandakan permintaan LPDDR pusat data AI meluas dari CPU server (SOCAMM milik Grace dan Vera dari NVIDIA) ke akselerator inferensi. Marginnya tidak akan menyamai HBM, tetapi pertumbuhan volume struktural terlihat jelas, dan kedua perusahaan Korea itu berada di dalam rantai pasokan SOCAMM.
Q: Kapan D270 dapat dibeli, dan berapa harganya? A: Per Oktober 2026, komponen ini berada dalam tahap sampel pelanggan. Intel belum mengungkapkan harga maupun tanggal ketersediaan umum; pengiriman volume dibicarakan untuk 2027.
📩 Berlangganan VLSI Korea
Dapatkan analisis semikonduktor harian kami lebih dulu di email Anda. Berlangganan gratis.