 VLSI Korea
Vera Rubin量産の数学: 1ラック = HBM4 576スタック、GPU 100万個 = ウエハ30万枚 (TSMC・SK hynix・サムスン・Micron)
Vera Rubinは本格生産に入った。1ラックはHBM4 576スタックとウエハ約21.5枚を消費し、GPU100万個にはウエハ約30万枚が必要だ。2027年の上限を決めるのはGPUではなくHBM4だ。TSMC、SKハイニックス、サムスン、マイクロンの供給地図と歩留まり前提を全て数字で分解する。


一言で結論 — Vera Rubinの生産速度を決めるのはGPUではなくHBM4のビット数だ。1ラックでHBM4スタック576個とウエハ21枚以上を消費する構造では、2027年のランプの上限はメモリメーカーのウエハが描く。
30秒サマリー
- 2026年10月21日、GTC Berlinの基調講演でCEOのJensen Huang氏はVera Rubinが「すでに本格生産に入った」と宣言した。ノードの組み立て時間はGrace Blackwellの2時間から5分未満に短縮され、冷却は100%液冷になった。
- NVL72ラック1台にはRubin GPU 72個、Vera CPU 36個、HBM4スタック576個(20.7 TB = 165,888 Gb)が入る。GPU 1個あたりのHBM4は36 GB 12段積層スタック8個で、288 GB(2,304 Gb)だ。
- 数量は推計としてのみ存在する。市場の現在のベースケースは、2026年下半期が5,000–7,000ラック(サプライチェーン推計)、2027年が11,000–21,000ラック(80万–150万GPU)だ。
- ウエハに換算すると、GPU 1個はロジックウエハ0.037枚 + CoWoSウエハ0.143枚 + HBM DRAMウエハ0.118枚、合計で約0.30枚を消費する。GPU 100万個はウエハ約30万枚を意味する。
- ボトルネック判定:第1位はHBM4(2026年分は実質的に割り当て済み、割り当て削減の報道あり、2027年の契約価格は急騰の見通し)、第2位はCoWoSだ。ロジックウエハとラック組み立ては制約ではない。
1. ベルリン宣言 — まず確定した事実から
2026年10月21日、Jensen Huang氏はGTC Berlinの基調講演でVera Rubinノードを掲げ、3点を確認した。第1に、Vera Rubinはすでに本格生産に入っている。第2に、ノードの組み立て時間はGrace Blackwell世代の2時間から5分未満に短縮された — ケーブルとワイヤをなくした成果だ。第3に、冷却は前世代の80%液冷から100%液冷となり、冷却液の入口温度は45°Cだ。
生産そのものは新しいニュースではなかった。NVIDIAは2026年1月のCESで生産開始を発表し、5月31日のGTC Taipeiの発表では秋から生産出荷が始まるとしていた。6月1日にはクラウド事業者のCoreWeaveが初のNVL72ラックの立ち上げを完了し、実稼働を確認した。ベルリンで確認されたのは、「生産中」がサンプルや初期ユニットではなく、本格的なランプを意味するようになったことだ。Huang氏は、Vera Rubinの背後に台湾のサプライチェーンパートナー150社がいるとも述べた。
本稿はその宣言を数字で分解する。何台作られるのか、1ラックに何がどれだけ入るのか、その数量はウエハ何枚に換算されるのか、どの会社が何をどれだけ供給するのか。公式開示と報道に基づく数字には出典を示し、計算で導いた数字は前提を示した上で推計と明記する。
2. 1ラックの解剖 — NVL72の中身
Vera Rubinの販売単位はGPUチップではなくラックだ。NVL72 1台はコンピュートトレイ18台とNVLinkスイッチトレイ9台で構成され、72個のGPUがNVLink 6ファブリックで結ばれ、1台の巨大なアクセラレータのように振る舞う。
| 構成要素 | 数量 / 仕様 | 備考 |
|---|---|---|
| Rubin GPU | 72 | GPUあたり3,360億トランジスタ(ダイ2個)、TSMC 3nm |
| Vera CPU | 36 | 88コアArm、GPUとNVLink-C2C接続 |
| HBM4 | 576スタック、20.7 TB | GPUあたり8スタック × 36 GB |
| LPDDR5X(CPU向け) | 最大54 TB | CPUあたり最大1.5 TB、SOCAMM2モジュール(証券会社分析による) |
| NVLink 6ファブリック | ラックあたり260 TB/s | GPUあたり3.6 TB/s |
| ネットワーキング | ConnectX-9 NIC、BlueField-4 DPU | スケールアウトはSpectrum-X Ethernet |
| 冷却 | 100%液冷 | 冷却液入口45°C |
| 消費電力 | 約190–230 kW | サプライチェーン推計 |
| ラック価格 | 500万–780万ドル | 2026年3月の報道と証券会社のBOM分析 |
出典:NVIDIAが公開したNVL72仕様、GTC Berlin 2026基調講演の報道(2026年10月21日)、証券会社の部材分析。
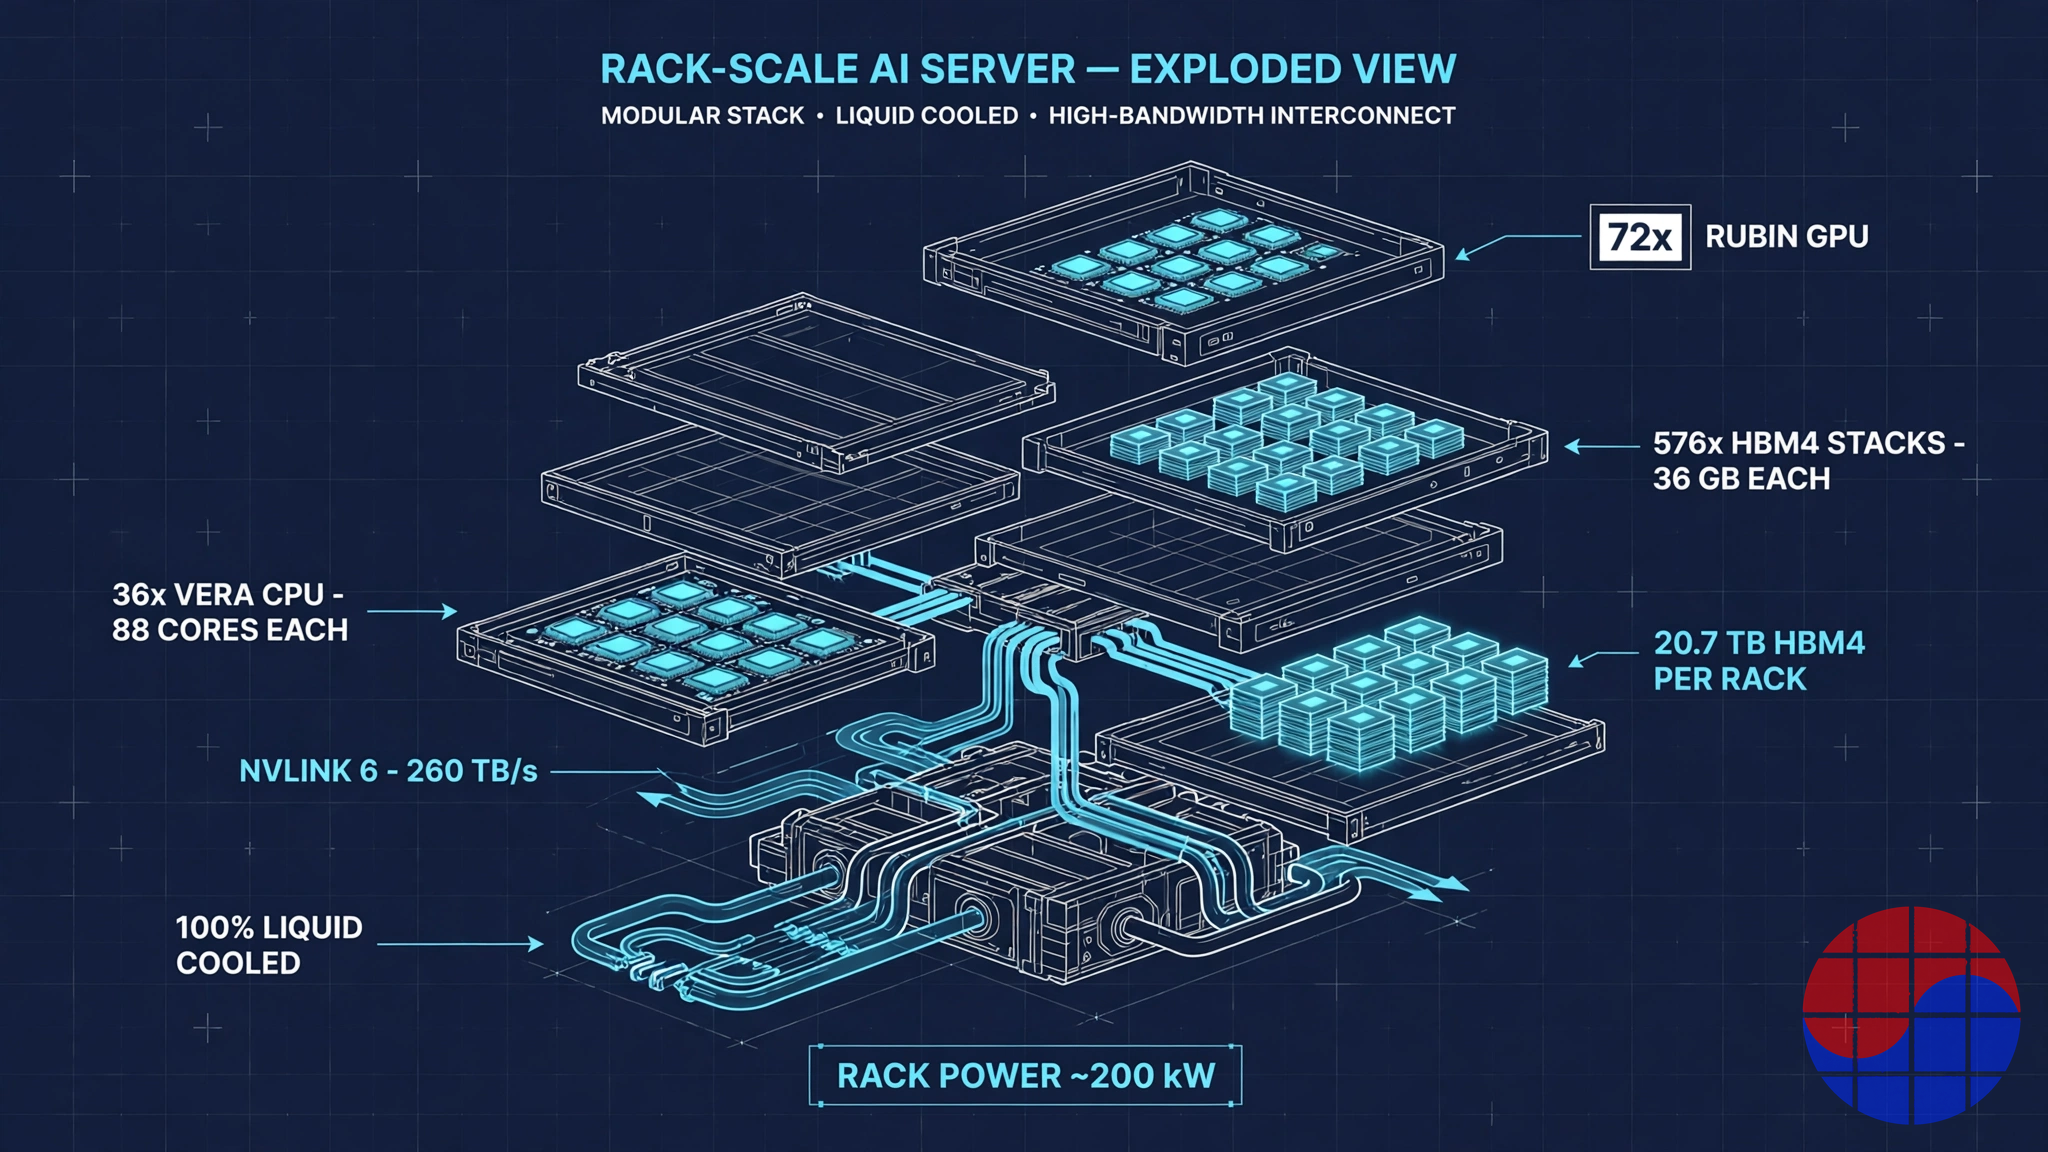
Vera Rubin NVL72ラックの解剖 — 1ラックにGPU 72個とHBM4スタック576個。 Source: VLSI Korea
HBM4の算数
このプラットフォームは本質的にメモリシステムだ。GPU 1個のHBM4をビット単位で分解すると次のようになる。
| 項目 | 値 | 計算 |
|---|---|---|
| HBM4スタック1個 | 36 GB(288 Gb) | 24 Gbダイを12段積層 |
| GPUあたりスタック数 | 8 | NVIDIA仕様 |
| GPUあたりHBM4 | 288 GB(2,304 Gb) | 8 × 36 GB |
| GPUあたり帯域幅 | 22 TB/s | NVIDIA仕様 |
| ラックあたりスタック数 | 576 | 72 × 8 |
| ラックあたりHBM4 | 20.7 TB(165,888 Gb) | 72 × 288 GB |
| ラックあたりHBM DRAMダイ数 | 6,912 | 576スタック × 12ダイ |
Blackwellと比べると、GPUあたりのHBM容量は192 GBから288 GBへ1.5倍に増え、帯域幅は8 TB/sから22 TB/sへ2.75倍になった。スタック数は8個のままだが、各スタックは24 GBから36 GBへ大きくなり、ピン速度も上がった。生産の観点で重要なのは、容量の増加分がすべて追加のDRAMウエハとして請求されることだ。スタック1個には24 Gbダイが12個必要で、ダイの歩留まりを考慮すれば実際のウエハ消費はさらに多くなる。
3. 何台作られるのか — 数量シナリオ
NVIDIAはRubinの出荷台数を開示していない。流通している数字はすべて推計であり、本稿では手法が透明なものだけを使う。
逆算1:売上高から
NVIDIAのガイダンスと経営陣の発言に基づく市場の議論では、Vera Rubinが四半期売上高に約200億ドル寄与するランレートが想定されている。報道されたラック価格の範囲(500万–780万ドル)で割ると、四半期あたり2,550–3,975ラック、年換算で約10,000–16,000ラックになる。なお、この逆算はRubinの売上高がすべてNVL72ラックから来ると仮定しているため上限に近い参考値だ — 実際にはボードやモジュール単位の販売とBlackwellの並行売上高が混ざる。
逆算2:サプライチェーン推計
台湾のサプライチェーンを追うアナリストは、2026年下半期のVR200ラック出荷を5,000–7,000台とみている(Ming-Chi Kuo氏の推計として報道)。GPUに換算すると36万–50万個だ。HBM4の割り当て削減の報道も重なり、並行するコンセンサスでは2026年のRubin GPU総数は25万–35万個とされる。スケーリングの年である2027年のベースシナリオは80万–150万GPU(11,000–21,000ラック)だ。業界推計では、NVL72級ラック全体(GB300 + VR200 + VR300)の出荷が2027年に前年比50%超の伸びとなり、VR200が最大のシェアを占めるとも見込まれている。
| 期間 | ラック(推計) | GPU(推計) | HBM4スタック(推計) | 根拠 |
|---|---|---|---|---|
| 2026年下半期 | 3,500–7,000 | 25万–50万 | 200万–400万 | サプライチェーン推計、秋に出荷開始 |
| ランプピーク時の四半期 | 2,550–3,975 | 18万–29万 | 147万–229万 | 四半期売上高約200億ドルからの逆算 |
| 2027年 | 11,000–21,000 | 80万–150万 | 640万–1,200万 | ベースシナリオの範囲 |
この表の数字はすべて推計であり、確定した数字ではない。確定しているのは生産そのものと、秋の出荷開始だ。
HBM4のビットに換算すると、構図のスケールが変わる。2027年ベースケースの下限(80万GPU)でもHBM4は230 PB(230,400 TB)が必要で、上限(150万GPU)では432 PBに達する。1つのプラットフォームが世界のHBM生産量全体の相当な割合を吸収する構造だ。
4. ウエハ換算 — GPU 1個 = ウエハ0.30枚
数量をウエハに換算すると、ボトルネックの位置が見える。以下のモデルは当社独自のもので、すべての前提を開示する。出力は範囲として読んでほしい。
前提
| ウエハの種類 | 前提 | 結果 |
|---|---|---|
| ロジック(TSMC 3nm) | ダイ面積約800 mm² × 2(レチクル上限858 mm²に近接)、300 mmウエハあたりグロス約65ダイ、ダイ歩留まり85% | ウエハあたり良品ダイ約55個 = GPU約27個 |
| CoWoSパッケージング | パッケージ面積約4,700 mm²(2026年の5.5レチクル級)、ウエハあたり6–8パッケージ | ウエハあたりGPU約7個 |
| HBM4 DRAM | 24 Gbダイ約60 mm²、ウエハあたりグロス約1,090ダイ、KGD・積層の実効歩留まり75% | ウエハあたりダイ約820個 = GPU約8.5個 |
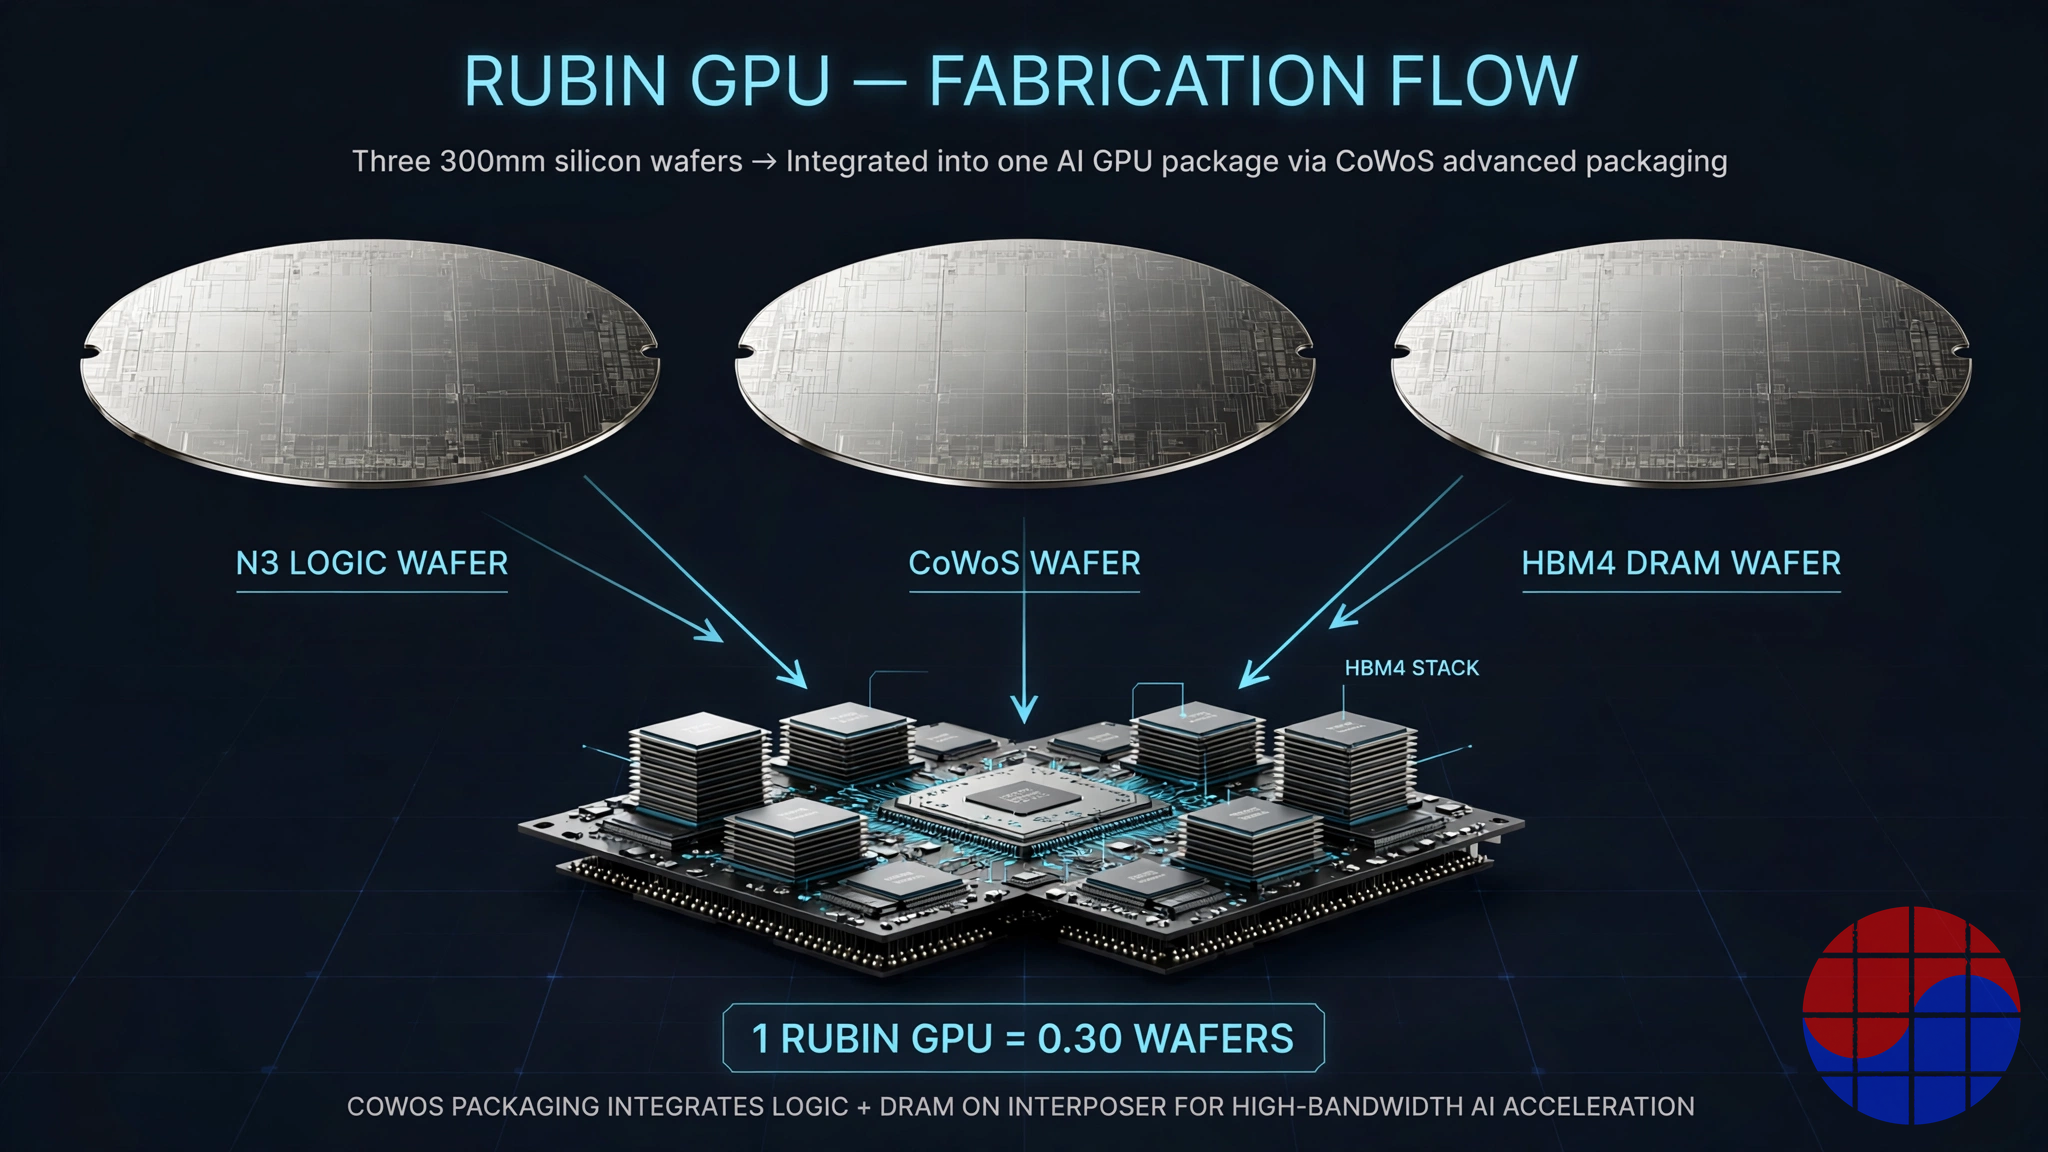
GPU 1個が消費する3種類のウエハ — ロジック、CoWoS、HBM DRAM。 Source: VLSI Korea
換算結果
| 区分 | GPU 1個あたり | ラック1台あたり(72 GPU) | 2027年(80万–150万GPU) |
|---|---|---|---|
| ロジックウエハ(3nm) | 0.037 | 約2.7 | 3.0万–5.6万 |
| CoWoSウエハ | 0.143 | 約10.3 | 11.4万–21.4万 |
| HBM4 DRAMウエハ | 0.118 | 約8.5 | 9.4万–17.6万 |
| 合計 | 約0.30 | 約21.5 | 約24万–45万 |
結論は明快だ。GPU 100万個を作るには3種類合わせてウエハ約30万枚が必要で、そのうち90%近くがパッケージング(CoWoS)とメモリ(DRAM)のウエハだ。純粋なロジックウエハは全体の約12%にすぎない。報道でも、AIチップ設計の上位4社が消費する最先端ロジックの生産量は全体の約12%にとどまるとされる — ロジックファブがAIランプの制約にならない理由はまさにここにある。
供給側と比べると、TSMCのCoWoSは2026年末までに月12万–15万枚規模に達すると推計され、OSATパートナーの生産能力を合わせると業界全体で月約20万枚に近づく。NVIDIAは2026年のTSMCのCoWoSの約60%を事前に確保したと報じられている。Rubinの2027年のCoWoS所要量(年11.4万–21.4万枚)はTSMCの年間生産能力の1桁%にとどまるため、Blackwellと分け合っても計算は成り立つ — 問題はパッケージの大型化だ。パッケージ面積が拡大するほどウエハあたりのパッケージ数は減り、増設分が面積に食われ続ける。
5. サプライヤーマップ — 誰が何をどれだけ供給するのか
Vera Rubinラック1台の背後には、Huang氏が挙げた台湾パートナー150社を含め、数百社のサプライヤーがいる。核となるマップは次の通りだ。
| 会社 | 供給するもの | 数量 / 役割 |
|---|---|---|
| TSMC | 3nm GPUダイ、CoWoS-Lパッケージング | GPUダイ全量。NVIDIAが2026年CoWoS生産能力の約60%を確保したと報道 |
| SKハイニックス | HBM4、SOCAMM2 LPDDR5X | HBM4初期割り当ての50%台半ば(報道)。12段積層36 GBスタック、Vera CPU向けSOCAMM2を展示 |
| サムスン電子 | HBM4 | 初期割り当ての20%台半ば(報道)。1c DRAM + 4nmベースダイ、スタックあたり最大3.0 TB/s、11.7 Gbpsで最速仕様。HBM4EサンプルはRubin Ultra向け |
| マイクロン | HBM4 | 初期割り当ての約20%(報道)。36 GB 12段積層を2026年第1四半期から大量出荷、スタックあたり2.8 TB/s超 |
| イビデン、神鋼、Unimicron、Nan Ya PCB | ABF基板 | 5.5レチクル級パッケージ向けビルドアップ基板。基板面積がそのまま生産能力になる |
| ASE、Amkor | 後工程(CoWoSのオーバーフロー) | OSATの新規生産能力は月5万–6万枚規模と推計され、TSMCのオーバーフローを吸収 |
| Foxconn、Quanta、Wistron、Inventec | ラック組み立て・統合 | Foxconnが最大の組み立て事業者とされる。ノード5分設計がスループットを決める |
| Dell、HPE、Lenovo、Supermicro、GIGABYTE | システム納入 | CSPと企業へ完成ラックを納入 |
| Vertiv、Schneider Electric、Delta | 電力・冷却 | 約200 kWラック向けCDUと電源。DSX PODパートナー |
| NVIDIA(自社) | ConnectX-9、BlueField-4、NVLinkスイッチ、Spectrum-X Photonics | 自社BOM比率が上昇 — ラック売上高に占めるNVIDIAの取り分は世代ごとに増える |
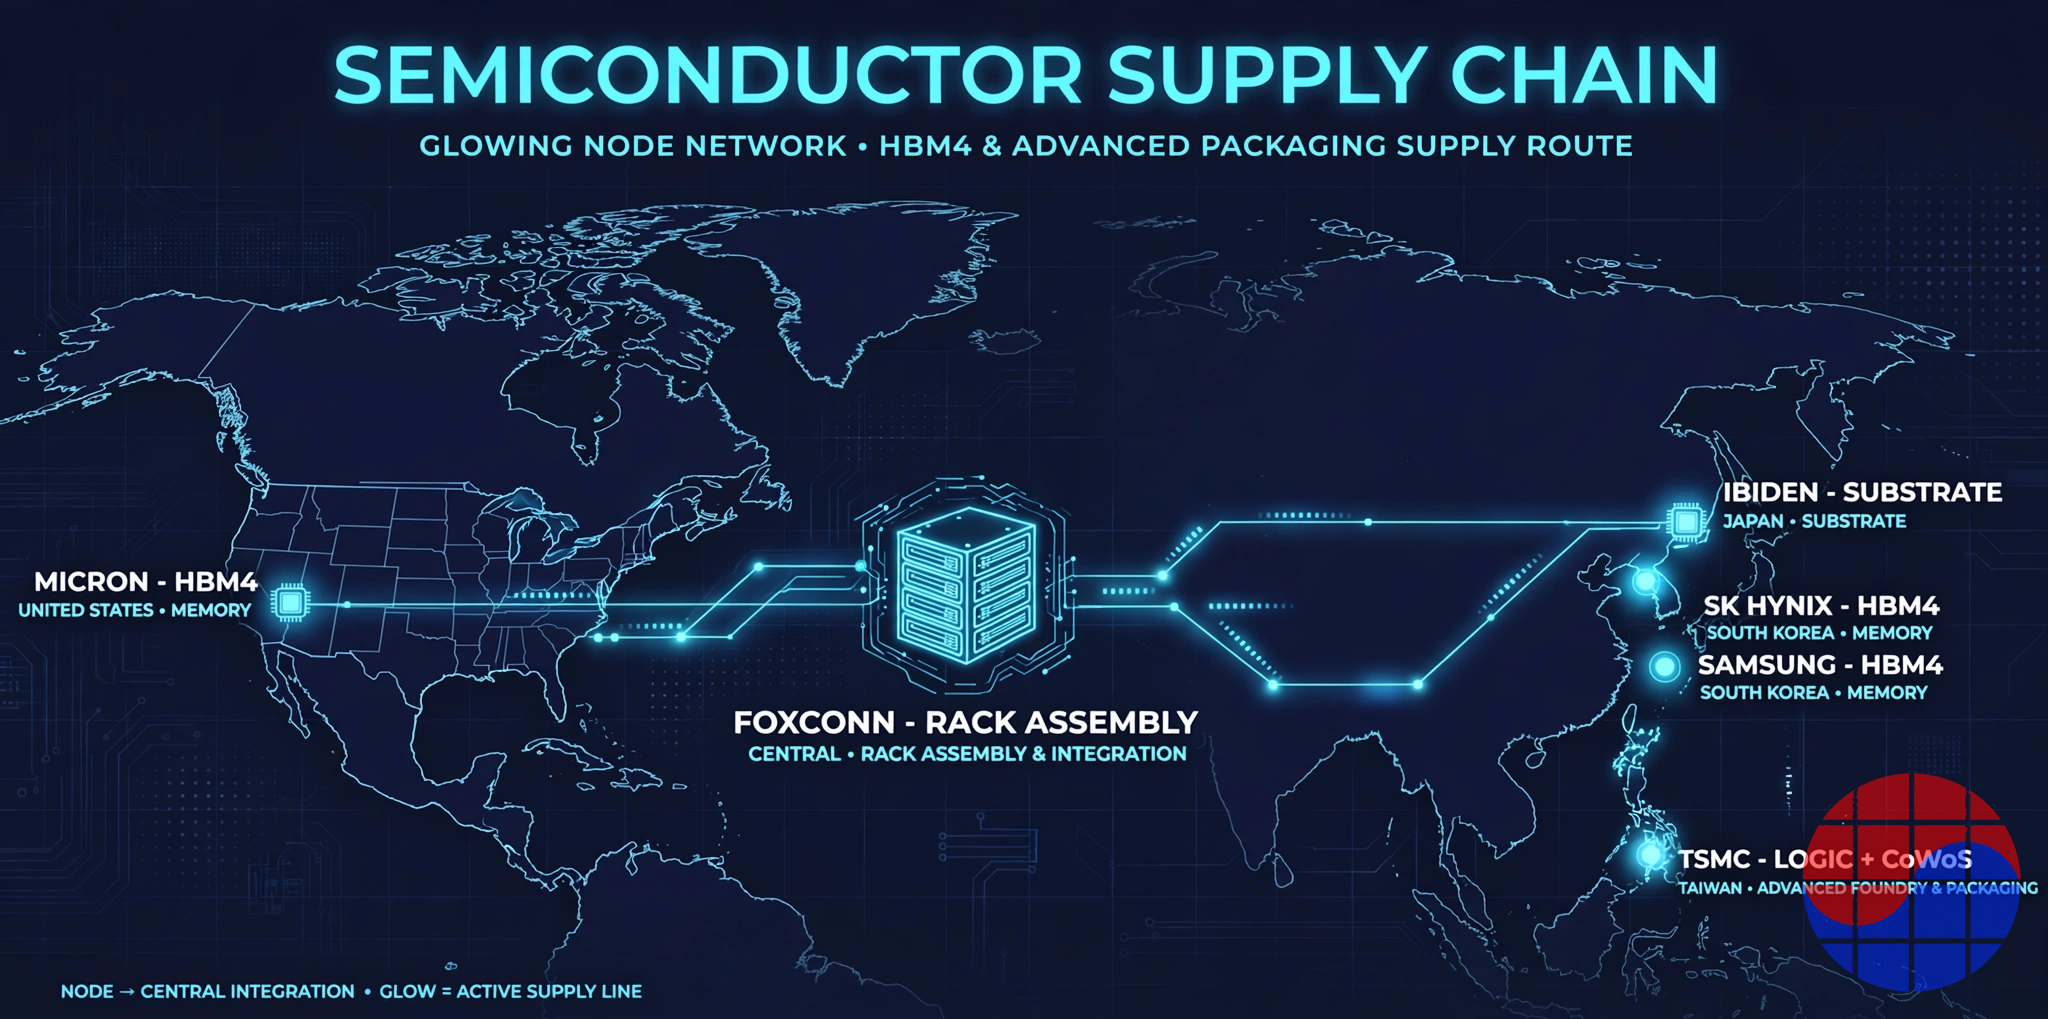
Vera Rubinのサプライチェーン — ロジックとパッケージングは台湾、HBM4は韓国と米国に分かれ、基板は日本。 Source: VLSI Korea
HBM4の割り当ては、2025年末のNVIDIAの数量割り当てに関する報道に基づく。SKハイニックスが50%台半ばで最大、サムスン電子が20%台半ば、マイクロンが約20%だ。この配分は固定ではない。サムスン電子は2026年2月に業界初のHBM4量産出荷を開始し、速度仕様で先行する一方、4月の報道では、ランプのタイミングを巡りSKハイニックスが2026年のNVIDIA向けHBM4出荷を20–30%削減することを検討したとされ、四半期ごとに割り当てが動き得る構造だ。
ラック組み立ての経済性も変わった。ノード組み立てが2時間から5分に短縮されれば、組み立て能力は労働力の問題ではなく部品到着の問題になる。組み立て事業者にとってVera Rubinは、部品が到着する速度で出荷されるラックであり、HBM4と完成したCoWoSパッケージがライン稼働率を決めるということだ。NVIDIAのモジュール型AIファクトリー設計を扱う姉妹記事、Vera Rubin DSX PODディープダイブでは展開速度を扱っている。本稿は、何台作られ、何枚のウエハから作られるかに焦点を当てる。
6. ボトルネック判定 — 実際にランプを律速するのは何か
| 工程 | 判定 | 根拠 |
|---|---|---|
| HBM4 | 最優先の制約 | 2026年分は実質的に完売。出荷削減の検討が報道。12段積層36 GBスタックは2026年の約600ドルから2027年には約1,300ドルへ上昇すると予測(契約価格の前年比+121%推計、報道) |
| CoWoS | タイトだが対応可能 | 生産能力は3年で約8倍になったが、パッケージ面積の拡大が増設を相殺。業界の供給不足は10–20%が続くと推計 |
| ABF基板 | 要注視 | 大型パッケージの面積拡大に直接さらされる。過去にも静かにボトルネックになった経緯がある |
| 3nmロジックウエハ | 制約ではない | 上位4社のAI設計会社が消費する最先端ロジックは全体の約12%(報道) |
| ラック組み立て | 制約ではない | ノード組み立て5分、モジュール設計。制約は部品の到着速度 |
| 電力・拠点 | 顧客側の制約 | ラックあたり190–230 kW。800VDCへの移行と液冷インフラが現場の課題 |
結論はシンプルだ。Vera Rubinの生産関数は min(HBM4スタック ÷ 576、CoWoSパッケージ ÷ 72、ロジックダイ ÷ 144) と書け、2026–2027年に最小値を決める項はHBM4だ。NVIDIAの決算でRubinの売上高がガイダンスに届かなければ、需要ではなくHBM4の納入をまず疑うべきだ。逆に、HBM4の契約価格が2027年に本当に2倍近くになれば、それはメモリ3社がランプの経済的果実の取り分を回収し始めた合図だ。
Chase's Take
数字をすべて並べると、Vera RubinはGPU製品というより、メモリ購買契約の物理的な姿だ。ラック価格500万–780万ドルのうち、GPUダイ自体のウエハコストが占める割合は直感より小さく、お金と生産能力はHBM4スタック576個とCoWoSの面積に縛られている。
韓国の視点で見るべきは割り当ての傾きだ。SKハイニックスの50%台半ばはBlackwell世代からの連続性だが、サムスン電子の20%台半ばは復活のフロアに見える — 速度とHBM4Eのカードが2027年の割り当て見直しで効けば、傾きは変わる。そしてその傾きを決めるのはマーケティングではなく、四半期ごとのKGD歩留まりと積層スループットだ。
最後に、ウエハ0.30枚という数字は覚えておく価値がある。AIアクセラレータの競争は今や、設計の競争であると同時に、3種類のウエハを巡る割り当ての競争でもある。次世代に向けてHBM5と14レチクル級パッケージを指すTSMCのロードマップは、この割り当て競争が終わるのではなく、より高くつくようになるだけだと言っている。
出典:NVIDIAの公開仕様とGTC Berlin 2026基調講演の報道(2026年10月21日)、韓国および国際的なサプライチェーンと決算の報道、証券会社の部材分析。数量とウエハ換算は明記した前提に基づく当社独自の推計であり、実際の出荷と異なる場合がある。本稿は投資助言ではない。
FAQ
Q: Vera Rubinラック1台にHBM4スタックは何個入りますか? A: 576個です。GPU 1個に36 GB 12段積層スタックが8個(288 GB)搭載され、ラックにはGPUが72個入るため、72 × 8 = 576スタック、合計で20.7 TB(165,888 Gb)になります。
Q: 2027年にVera Rubinシステムは何台生産されますか? A: 確定した数字はありません。サプライチェーン推計と売上高からの逆算を合わせると、2027年のベースシナリオは11,000–21,000ラック、すなわち80万–150万GPUです。2026年下半期は約3,500–7,000ラックと推計されます。
Q: GPU 1個を作るのにウエハは何枚必要ですか? A: 3種類合わせて約0.30枚です。3nmロジックウエハ0.037枚、CoWoSウエハ0.143枚、HBM4 DRAMウエハ0.118枚で、本稿で開示した前提(ダイ面積、歩留まり、パッケージ面積)に基づく当社独自の推計です。ラック1台では約21.5枚になります。
Q: Vera Rubin生産の本当のボトルネックは何ですか? A: HBM4です。2026年分は実質的に割り当て済みであり、出荷削減の検討報道と2027年の契約価格急騰の見通しがこの判定を裏付けます。CoWoSはタイトですが拡大中であり、3nmロジックウエハとラック組み立ては制約とは言い難い状況です。
Q: HBM4はどの会社が、どのようなシェアで供給しますか? A: 2025年末の割り当て報道によると、SKハイニックスが50%台半ば、サムスン電子が20%台半ば、マイクロンが約20%です。サムスン電子は業界初の量産出荷(2026年2月)と最速仕様を、SKハイニックスは最大の割り当てとSOCAMM2を、マイクロンは2026年第1四半期からの大量出荷をそれぞれ強みとし、割り当ては四半期ごとに調整され得ます。
📩 VLSI Korea ニュースレター
毎日配信の半導体ディープダイブを、メールでいち早くお届けします。購読は無料です。


