VLSI Korea
TPUs do Google se pagam em menos de um ano: a economia do silício personalizado contra a NVIDIA
Os servidores com TPU do Google recuperam o investimento em menos de um ano. O TPUv7 Ironwood entrega até 50% melhor desempenho por dólar em inferência que o B200/B300. Com um payback de um ano, fabricar o próprio chip não é uma opção: é bom senso financeiro.


Resumo: Os servidores com TPU do Google recuperam o investimento em menos de um ano. O TPUv7 Ironwood entrega até 50% melhor desempenho por dólar em inferência que o B200/B300. Com um payback de um ano, fabricar o próprio chip não é uma opção: é bom senso financeiro. A cadeia de valor ASIC de Broadcom e MediaTek entra em crescimento estrutural.
Resumo em 30 segundos (AEO)
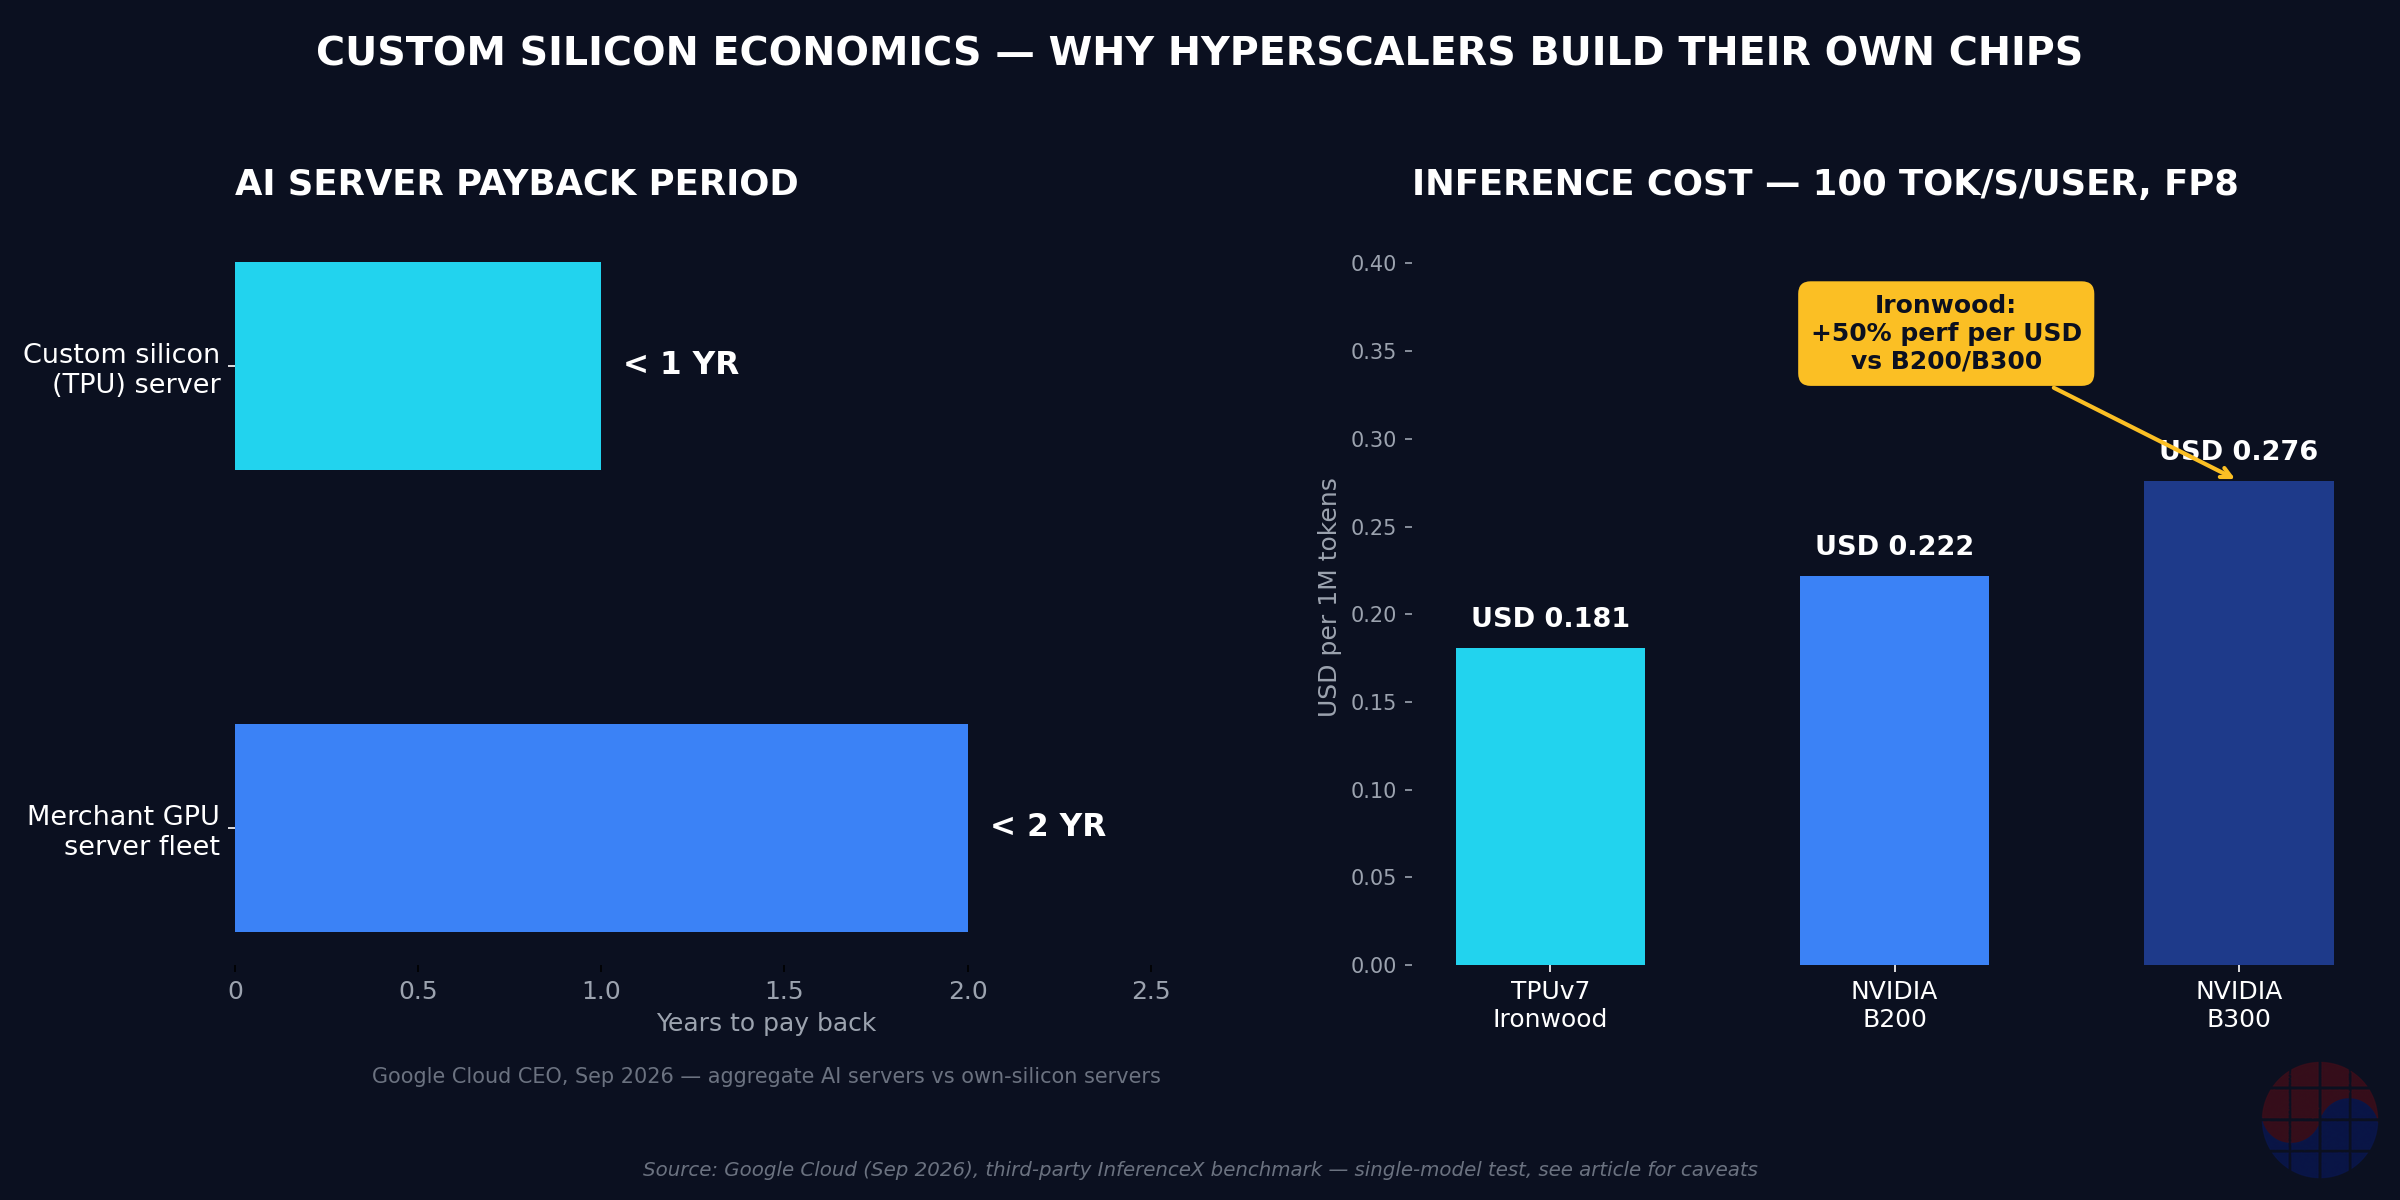
- O CEO do Google Cloud, Thomas Kurian, revelou em setembro de 2026: os servidores de IA se pagam em menos de dois anos no agregado; os servidores com silício próprio (TPU) fazem isso em cerca de metade do tempo. Um ano de payback transforma o silício personalizado de "escolha estratégica" em bom senso financeiro. (Fonte)
- A avaliação independente (InferenceX) concluiu que o TPUv7 Ironwood oferece "até 50% melhor desempenho por dólar" frente ao B200/B300 em inferência comparável, com a ressalva de ser um teste de modelo único (Qwen 3.5 397B, FP8) conduzido pelo fornecedor. (Fonte)
- A Anthropic revelou em seus documentos de IPO de outubro de 2026 um arrendamento de capacidade TPU de cinco anos no valor de US$ 125,2 bilhões; a Broadcom concordou em financiar até US$ 42 bilhões em dívida conversível. Venda de chips mais finanças: um novo modelo comercial. (Fonte)
- A MediaTek dobrou sua previsão de receita ASIC para 2026 para mais de US$ 2 bilhões, com seu primeiro ASIC de IA para o Google entrando em produção em massa no quarto trimestre de 2026. (Fonte)
- Conclusão: na escala dos hiperescaladores, o debate fabricar-vs-comprar acabou. O período de payback decide.
Background: por que silício personalizado, por que agora
Por anos, o debate dos chips de IA era sobre quem era mais rápido. Na segunda metade de 2026, a pergunta mudou. Com a Alphabet prevendo entre US$ 195 e 205 bilhões de capex em 2026 (fonte), os acionistas pararam de perguntar sobre FLOPS e começaram a perguntar quando o dinheiro volta.
A resposta de Kurian foi incomumente concreta. Na Goldman Sachs Communacopia + Technology Conference de 8 de setembro de 2026, ele disse que o payback agregado dos servidores de IA era inferior a dois anos, e o do silício próprio era cerca de metade disso. O Google Cloud repetiu a afirmação em um resumo oficial em 11 de setembro. Ele acrescentou que o Google Cloud oferece 2,7x melhor custo-benefício em treinamento e 80% melhor em inferência, e que seu negócio de aceleradores é mais que o dobro do próximo hiperescalador. (Fonte)
O peso da declaração não está no número dois, mas no que um payback de um ano faz com a economia de fabricar o próprio chip. O NRE de um ASIC de IA de nó avançado (projeto, máscaras, validação) gira em torno de US$ 100–200 milhões. Dividido por um milhão de chips, são US$ 100–200 por chip: insignificante diante da cunha de margem merchant das GPUs (a margem bruta da NVIDIA supera 70%). Quando o volume acompanha, fabricar o próprio silício é incondicionalmente mais barato. A declaração de Kurian equivale ao CEO do Google Cloud declarando que o volume acompanha.
Business Deep Dive
Tamanho do mercado: ~US$ 80 bilhões em chips de IA personalizados até 2027
As estimativas dos analistas colocam o TAM de chips de IA personalizados em cerca de US$ 70–80 bilhões até 2027. A MediaTek disse aos investidores em julho de 2026 que mira capturar de 15% a 20%. (Fonte)
Os movimentos dos hiperescaladores já estão no placar:
- Google: No Cloud Next de abril de 2026, apresentou os TPUs de oitava geração (8t para treinamento, 8i para inferência) e uma nova arquitetura de rede Virgo que liga 134.000 TPUs em um único data center e mais de um milhão entre sites em um único cluster lógico. (Fonte) A restrição agora não é o fornecimento de silício, mas a energia: na escala de centenas de milhares, quanta energia condicionada você consegue alimentar aos racks limita o crescimento. (Fonte)
- Anthropic: Um acordo plurianual assinado em outubro de 2025 compromete até um milhão de TPUs Ironwood (valores reportados em dezenas de bilhões de dólares), e os documentos de IPO de 1º de outubro de 2026 revelaram um arrendamento de capacidade TPU de cinco anos de US$ 125,2 bilhões. (Fonte)
- Meta: O 'Iris', chip do programa MTIA co-projetado com a Broadcom, entrou em produção em volume na TSMC em 3nm em setembro de 2026. A Meta planeja dobrar sua capacidade de computação de IA de 7GW em 2026 para 14GW até o fim de 2027. (Fonte)
- OpenAI: Apresentou seu primeiro chip personalizado 'Jalapeño' com a Broadcom em junho de 2026, com 10GW de co-desenvolvimento em andamento. As implantações de racks começam no fim de 2026 e seguem até 2029. (Fonte)
Estrutura de custos: onde o TCO diverge
A economia do Ironwood repousa em três alavancas.
1. Desempenho por dólar. Na avaliação InferenceX (Qwen 3.5 397B, FP8, 100 tokens/s/usuário), o Ironwood custou US$ 0,181 por milhão de tokens contra US$ 0,222 do B200 e US$ 0,276 do B300: a base do "até 50% melhor desempenho por dólar". Em TCO interno, um servidor Ironwood é estimado ~44% mais barato que um servidor GB200 Blackwell equivalente; clientes externos como a Anthropic veem economias de ~30% frente à NVIDIA. (Fonte) Ressalva: teste de modelo único e condição única, conduzido pelo fornecedor. Um contraponto com sabor independente: a startup Inferact avaliou o Kimi K3 da Moonshot AI no mesmo motor vLLM — 16 chips TPUv7 atingiram 709 tokens/s contra 452 de 16 GB200, 57% de vantagem incluindo otimização da pilha de software. (Fonte)
2. Eliminação da margem merchant. Quando o Google vende ou aluga seus próprios chips a terceiros, o preço não carrega a cunha de margem merchant ao estilo NVIDIA. É hardware verticalmente integrado (chip, interconexão, pilha de software) a custo interno mais taxas de serviço de nuvem. Mesmos FLOPS, estrutura de fatura diferente.
3. Energia e economias de escala. Energia e refrigeração beiram 40% do TCO do data center. Os watts por chip importam, mas na escala de um milhão a eficiência da arquitetura de rede (goodput) decide o dinheiro — por isso o Google anuncia "mais de 97% de goodput" para o TPU 8t. É o mesmo jogo estrutural que os fabricantes de memória jogam com o rendimento (yield): não a performance unitária, mas a economia dos ciclos que sobrevivem.
Posicionamento competitivo: quatro eixos
| Eixo | Jogadores | Posição |
|---|---|---|
| Chips próprios de hiperescaladores | Google TPU, Meta MTIA, Amazon Trainium, Microsoft Maia, OpenAI Jalapeño | Específicos por carga de trabalho; eliminam a margem merchant |
| Parceiros de projeto ASIC | Broadcom, MediaTek, Marvell, Alchip | Vencem por projeto + integração CoWoS + HBM |
| Foundry | TSMC (monopólio efetivo) | Alocador de capacidade de nó avançado |
| Memória | SK hynix, Samsung, Micron (HBM) | As pilhas HBM por chip (centenas de Gb por chip) são um eixo de custo central |
A posição da Broadcom é a mais interessante. Assinou em abril de 2026 um acordo de longo prazo de fornecimento de TPU e redes com o Google até 2031 (fonte), ampliou em 14 de abril sua colaboração MTIA com a Meta (mais de 1GW) e co-desenvolve 10GW com a OpenAI. Ou seja, a Broadcom projeta simultaneamente chips para três campos de IA em competição: o arsenal da guerra do silício personalizado.
A MediaTek ataca de outro ângulo: reciclar a IP de CPU, GPU e NPU da era dos smartphones e seus ativos de projeto de baixo consumo em ASICs para data centers. No segundo trimestre de 2026, seu segmento Smart Device Platform (inclui ASICs) superou pela primeira vez os chips de smartphone como maior fonte de receita. As teleconferências de resultados de abril e julho dobraram a previsão de receita ASIC de 2026 para mais de US$ 2 bilhões, com o primeiro acelerador de IA para o Google entrando em produção em massa no quarto trimestre de 2026. (Fonte) A acompanhar: rumores de mercado sobre entregas de amostras e rendimentos fazem da execução do quarto trimestre o verdadeiro teste.
Opções estratégicas: três cenários
- A integração vertical acelera (caso base): se a externalização de TPU der certo, 20–30% das cargas de inferência rodará em silício personalizado em vez de GPU merchant até 2027. Re-rating de múltiplos para os parceiros de projeto ASIC.
- O merchant contra-ataca: a NVIDIA pode estreitar a diferença de TCO com preços e pacotes na geração Rubin. O custo de troca do ecossistema CUDA continua sendo um fosso. O fato de o Ironwood suportar nativamente apenas FP8 (FP4 chega com o TPUv8i) limita o alcance válido da comparação.
- O risco financeiro se materializa (caso pessimista): o financiamento a clientes ao estilo Broadcom assemelha-se estruturalmente ao financiamento a fornecedores de Nortel e Lucent na bolha de telecom de 2001: os fabricantes de equipamentos sustentaram as compras dos clientes até o crédito destes entrar em colapso. A exposição máxima de US$ 29 bilhões na própria declaração trimestral da Broadcom mostra as duas faces dessa estrutura. (Fonte)
Chase's Take
A leitura como caso de MBA é única: o fabricar-vs-comprar é decidido pelo período de payback, não pela tecnologia.
Na análise clássica, você divide o custo fixo (NRE) pelo volume. Nos chips de IA, o denominador cresce exponencialmente enquanto o numerador, embora aumente com os nós avançados, não acompanha o ritmo. Um milhão de chips × milhares de dólares economizados por chip = bilhões. No momento em que essa equação se confirma, o CFO pergunta à engenharia "por que não fabricamos". A declaração de Kurian é a resposta em nível de CEO a essa pergunta.
Segundo: a inovação de GTM da Broadcom. Uma empresa de chips que empresta US$ 42 bilhões ao seu cliente não é um desconto: é "finanças como vendas". No positivo, maximização de barreiras de entrada (aprisionamento do cliente); no negativo, internalização do risco de crédito. Investidores deveriam ler o balanço da Broadcom com olhos de quase-banco, não de empresa de chips.
Terceiro, a perspectiva dos mercados emergentes. Este jogo tem dois assentos para o resto do mundo. Um é a HBM: com 8–12 pilhas HBM (centenas de Gb por chip) por acelerador personalizado, o crescimento do volume ASIC é crescimento da demanda por HBM. O outro é o manual fabless: a estratégia da MediaTek de reciclar IP de smartphones é um modelo que fabless de qualquer região podem seguir rumo a ASICs específicos por carga de trabalho (inferência, edge).
Implications: investimento e gestão
- Investimento: os parceiros de projeto ASIC (Broadcom, MediaTek, Marvell, Alchip) estão em fase de crescimento estrutural. Mas os múltiplos podem já refletir boa parte disso: é preciso acompanhar trimestralmente a rampa de produção da MediaTek no quarto trimestre e a exposição financeira da Broadcom. Em foundry, a alocação de capacidade avançada da TSMC determina cada vez mais a qualidade da carteira de clientes.
- Gestão: compradores de nuvem não deveriam orçar o TCO de inferência de 2027 apenas com cotações de GPU merchant. É preciso incluir sempre uma proposta paralela de externalização de TPU: só a alavancagem de negociação já cortou ~30% dos preços de GPU existentes em casos documentados (OpenAI). (Fonte)
- Risco: o cenário em que as estruturas de financiamento a clientes se rompem não vem de um colapso da demanda por chips, mas de uma contração de crédito. Com o financiamento de infraestrutura de IA já em centenas de bilhões, a métrica a vigiar são os spreads e os swaps de inadimplência, não os embarques de chips.
FAQ
Q1. Os TPUs realmente se pagam em menos de um ano? É o número oficial do CEO do Google Cloud em uma conferência de setembro de 2026: menos de dois anos para os servidores de IA no agregado, cerca de metade para o silício próprio. Reflete a contabilidade interna do Google; não significa que clientes externos possam replicar as mesmas condições. (Fonte)
Q2. A comparação de "50% melhor desempenho por dólar" do Ironwood é justa? Tem os limites de um teste de modelo único, condição única, conduzido pelo fornecedor. Mas uma avaliação independente (Inferact) também mostrou o TPUv7 à frente do GB200, e as análises de TCO interno apontam na mesma direção. O contra-argumento: o suporte nativo apenas até FP8. (Fonte)
Q3. Por que importa a Broadcom emprestar US$ 42 bilhões à Anthropic? É um novo modelo comercial em que venda de chips e finanças se fundem: o fornecedor sustenta diretamente o poder de compra do cliente para ganhar o pedido, absorvendo em troca o risco de crédito do cliente. A estrutura lembra o financiamento a fornecedores da bolha de telecom de 2001: é preciso ler as duas faces. (Fonte)
Q4. O que isso significa para empresas de semicondutores fora dos EUA? Em HBM é favorável para SK hynix, Samsung e Micron: os chips personalizados também levam HBM. Em projeto, o manual da MediaTek de "reciclar IP de smartphones" é um modelo replicável.
Leituras recomendadas
- O panorama da disputa pelos chips de IA: Chip War — Chris Miller (Amazon)
- Anatomia do modelo de negócios da NVIDIA: The Nvidia Way — Tae Kim (Amazon)
Compras feitas por este link podem gerar uma comissão.
Este artigo é uma análise baseada em comunicados públicos, teleconferências de resultados e imprensa; não é recomendação de investimento. Os números citados correspondem às datas de publicação de suas fontes (abril–outubro de 2026) e podem ter mudado.