 VLSI Korea
Hybrid bonding: por que é tão difícil de aperfeiçoar — e por que ele vai decidir o HBM4 de 16 camadas
O hybrid bonding —interconexão Cu-Cu direta com passo abaixo de 10 µm— vai decidir o HBM4 de 16 camadas (256 Gb), a DRAM 3D e a integração lógica-sobre-memória. Por que é tão difícil de aperfeiçoar: alinhamento sub-100 nm, CMP, plasma, partículas e recozimento; e o que investidores devem observar.


Resumo em 30 segundos
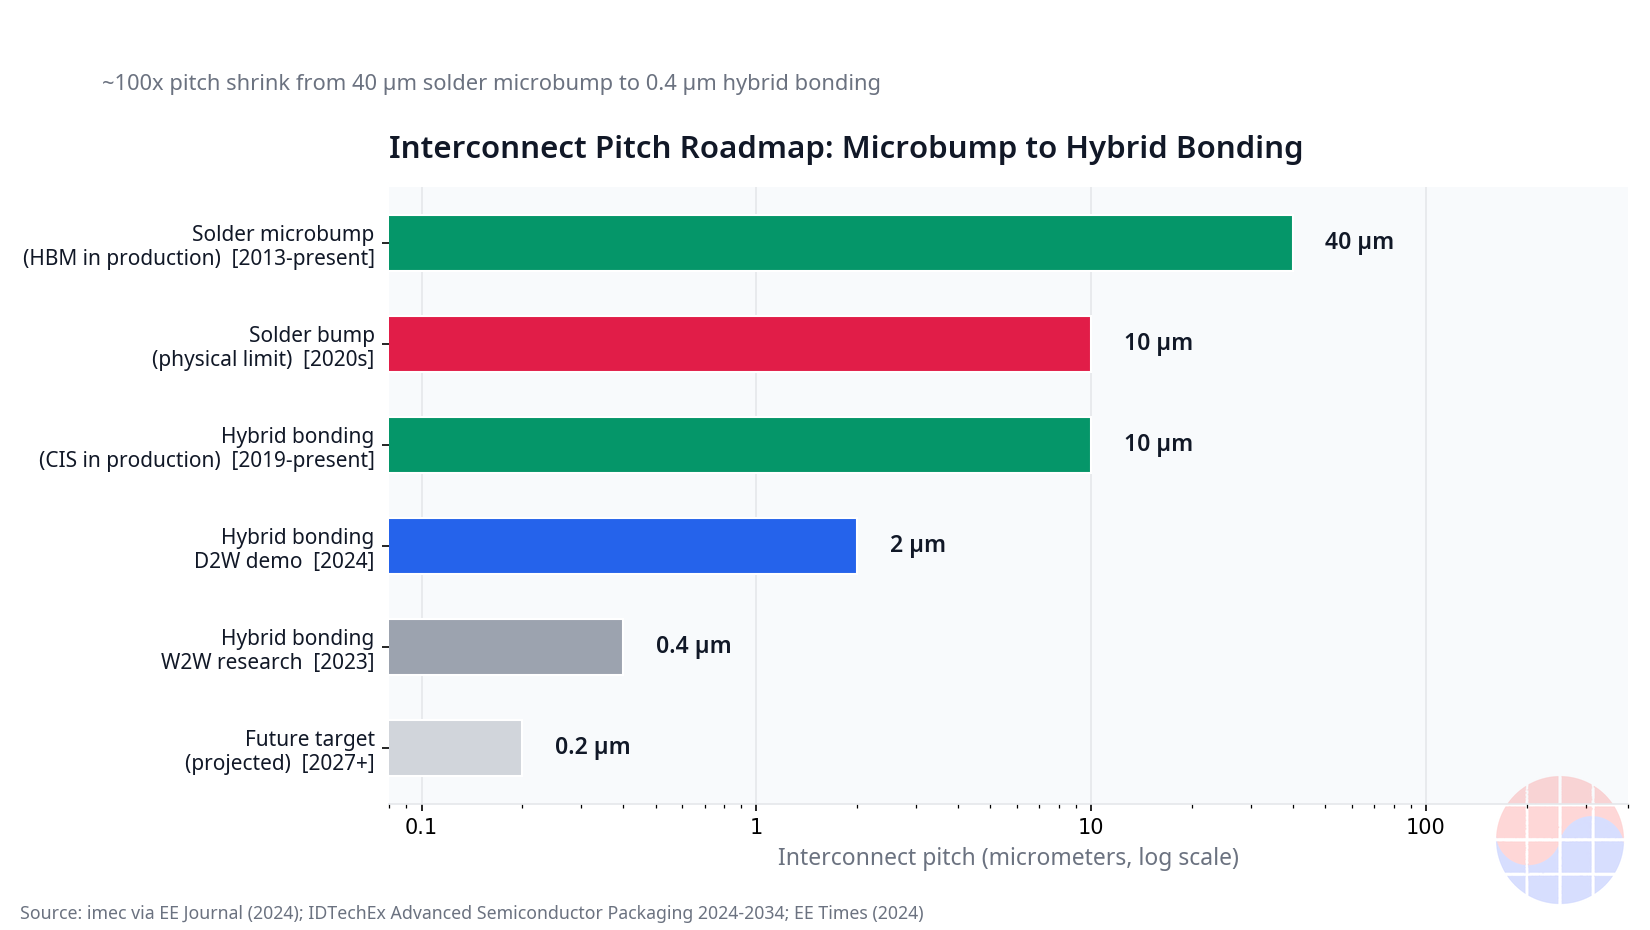
Quem vencer a corrida pela memória na era da IA talvez nem precise do melhor transistor — vai precisar do melhor empilhamento. O hybrid bonding, a união direta de cobre com cobre sem solda, derruba o passo de interconexão de cerca de 40 µm (microbump) para menos de 10 µm e multiplica por mais de dez a densidade de conexões entre dados. É a porta de entrada para o HBM4 de 16 camadas (256 Gb por pilha), para a DRAM 3D e para a integração real de lógica sobre memória.
O problema: acertar essa união em escala industrial exige alinhar wafers de 300 mm com precisão abaixo de 100 nm, polir o cobre com exatidão nanométrica (CMP), ativar superfícies com plasma, operar quase sem partículas e recozer a junção sem degradar a DRAM. Cada etapa troca velocidade de produção (throughput) por rendimento de fabricação (yield). Por isso, em 14 de outubro de 2026, pouquíssimas empresas dominam o processo em volume — e por isso os pedidos de bonders, CMP e metrologia são o indicador antecedente que todo investidor de semicondutores deveria acompanhar.
Contexto
A memória de alta largura de banda (HBM) cresceu por uma década empilhando dados de DRAM ligados por microbumps de solda e perfurados por TSVs. Deu certo: do HBM original ao HBM3E, o setor saiu de pilhas de 4 camadas para 12 camadas. Mas o microbump bateu no teto. Com passo de ~40 µm, cada conexão consome silício demais, carrega parasitas elétricos e limita quantos fios de dados cruzam entre memória e processador. O HBM4 dobra o barramento para 2048 bits e mira ~2 TB/s por pilha; com 16 camadas, a geometria do microbump simplesmente não fecha em altura nem em densidade.
O hybrid bonding aposenta a solda. Duas superfícies — óxido com óxido, cobre com cobre — aderem primeiro por forças de van der Waals à temperatura ambiente e depois passam por recozimento, que funde os grãos de cobre numa interconexão sólida. Sem bumps, o passo cai para menos de 10 µm (a indústria opera hoje entre 4 e 9 µm, com roteiros mirando abaixo de 2 µm), os parasitas despencam e a pilha afina. Não é promessa de laboratório: NAND com arquitetura de união híbrida produz em massa há anos, e processadores com cache 3D empilhado por hybrid bonding (TSMC SoIC, AMD 3D V-Cache) estão no mercado desde 2022. A dúvida não é mais se a técnica funciona — é quem consegue executá-la com o yield e o custo que a memória commodity exige.
Análise aprofundada
As seis batalhas que tornam o processo tão difícil
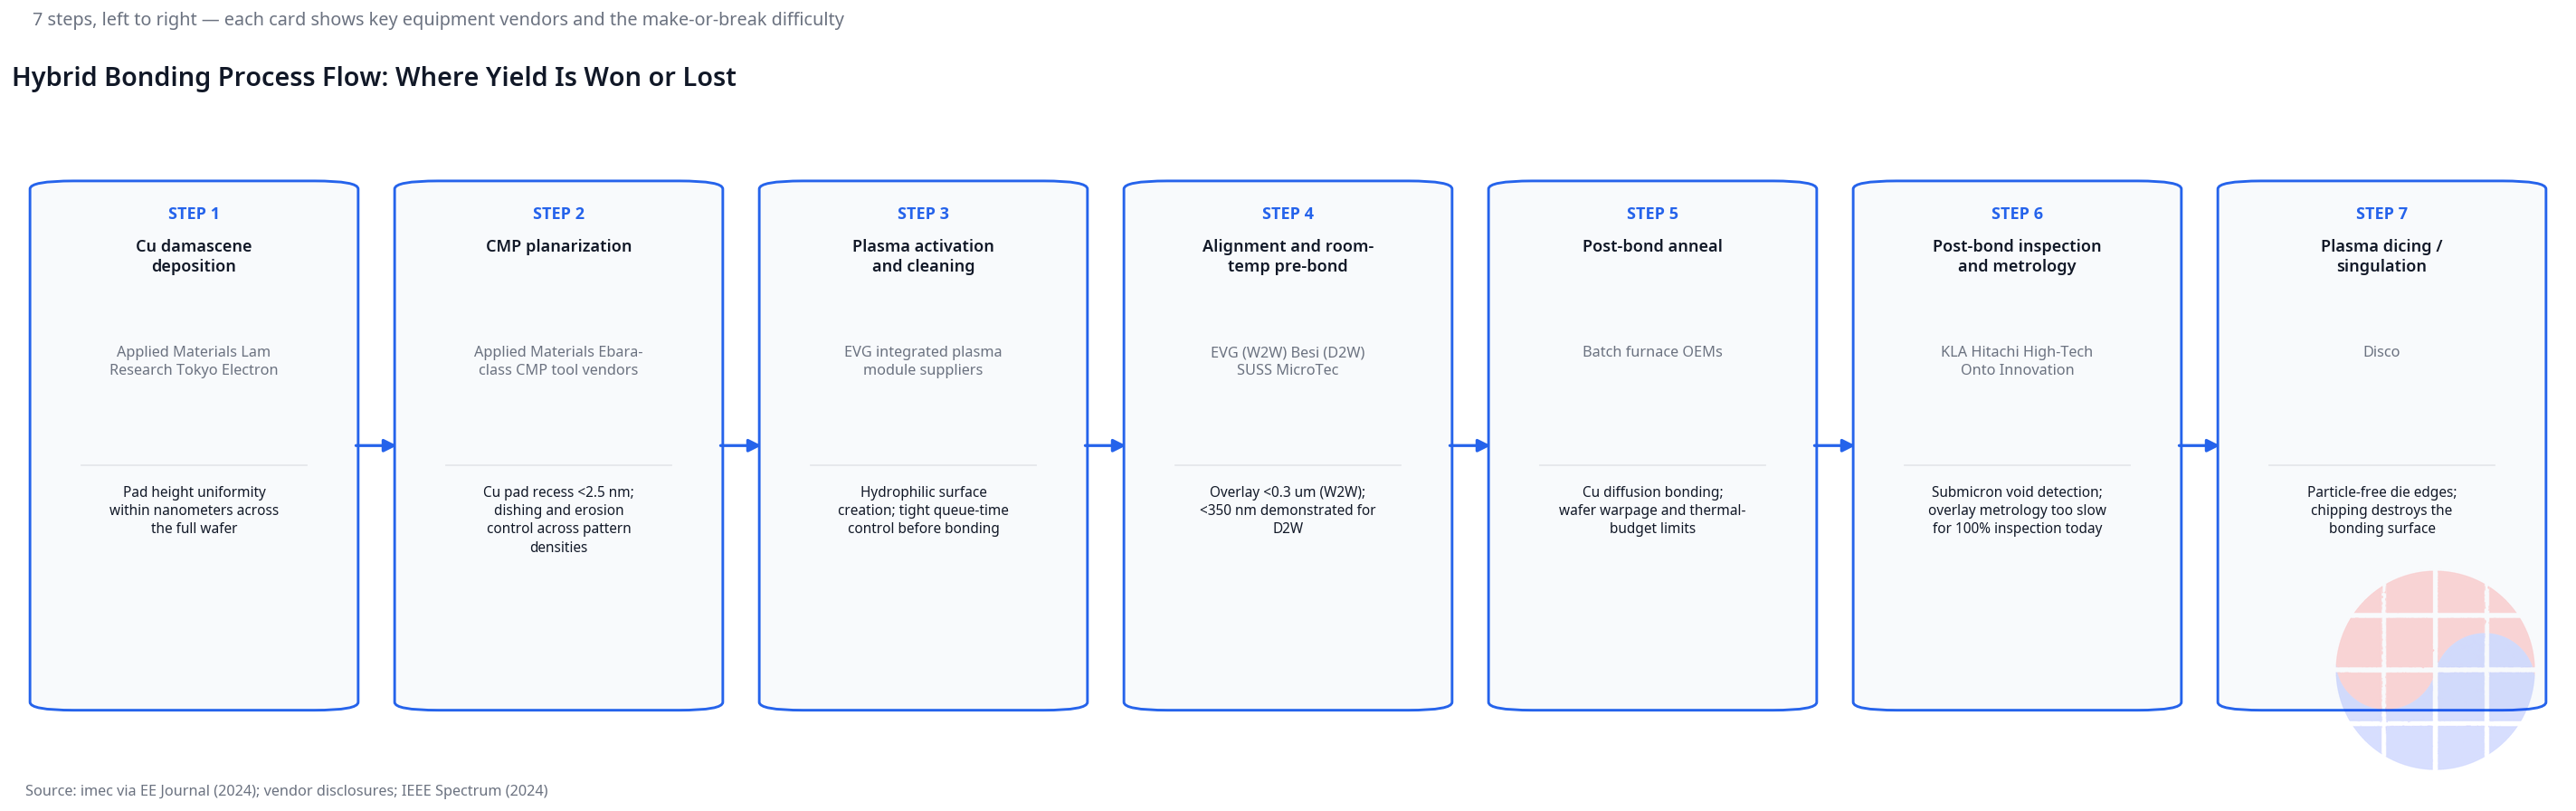
1. Alinhamento (overlay) abaixo de 100 nm. Para unir dois wafers de 300 mm de forma que milhões de pads de cobre de poucos micrômetros coincidam, a precisão de alinhamento precisa ficar abaixo de 100 nm no wafer inteiro. Wafers entortam (bow/warp), dilatam com a temperatura e carregam tensões de etapas anteriores. Cada décimo de micrômetro fora do lugar é um pad que não faz contato. Os bonders mais modernos corrigem distorção em tempo real, mas a janela de processo é mínima.
2. CMP e o "dishing" do cobre. Antes da união, as duas superfícies precisam de planaridade nanométrica. O polimento químico-mecânico (CMP) deixa os pads de cobre levemente rebaixados ou salientes em relação ao óxido — uma diferença de poucos nanômetros decide se o cobre fará contato após o recozimento. Se o polimento escava demais o cobre (dishing) ou corrói o óxido ao redor, a junção falha. Dominar a química do slurry, a pressão e a uniformidade em 300 mm é uma arte que se aprende com milhares de wafers processados.
3. Ativação por plasma. O óxido precisa se tornar hidrofílico para que a adesão à temperatura ambiente seja forte. O plasma resolve, mas a superfície ativada tem prazo de validade: passado o queue time, a qualidade desaba. A logística dentro da sala limpa vira parte do processo.
4. Partículas, o inimigo invisível. Uma partícula submicrométrica presa entre os wafers gera um vazio (void) capaz de comprometer uma área enorme ao redor. O hybrid bonding exige limpeza próxima à sala limpa classe 1 e inspeção de defeitos obsessiva. O custo não está só em filtrar o ar — está em detectar o que quase nenhuma ferramenta enxerga.
5. Recozimento (anneal). Depois da pré-união, um recozimento entre 150 e 350 °C faz os grãos de cobre crescerem e sela a interconexão. Mas a DRAM é sensível ao orçamento térmico: calor demais degrada a retenção das células. Achar a receita — temperatura, tempo, atmosfera — que funde o cobre sem "cozinhar" a memória é um compromisso que cada fabricante trata como segredo industrial.
6. Throughput versus yield: a decisão estratégica. Há dois caminhos: unir wafer com wafer (wafer-to-wafer, rápido, mas um dado defeituoso condena o par) ou dado com wafer (die-to-wafer, que permite usar só dados bons conhecidos — KGD — porém mais lento). Além disso, o hybrid bonding processa menos wafers por hora que uma linha de refusão convencional. Onde cada fabricante se posiciona nessa curva define sua estrutura de custos.
Quem vende as pás: o mercado de equipamentos por etapa
Cada batalha tem seu fornecedor — e aí mora a leitura de negócios. Em bonders, disputam EV Group, Applied Materials, Besi e ASMPT; em CMP, Applied Materials e Ebara; em metrologia e inspeção (verificação de overlay, detecção de voids por microscopia acústica e infravermelha), KLA, Onto Innovation e Camtek. É um nicho dentro do WFE, mas com preço altíssimo por ferramenta e — ponto crucial — receita recorrente de serviços, peças e atualizações de receita de processo. Quem qualifica seu bonder num grande fabricante de memória garante anos de pedidos subsequentes.
O ângulo coreano é direto. A Hanmi Semiconductor, líder coreana em bonders de compressão térmica (TC) para HBM — a tecnologia que empilhou o HBM3E —, desenvolve equipamentos de hybrid bonding para não ficar para trás na transição. Se o HBM4 de 16 camadas migrar para a união híbrida, a Hanmi precisa estar na lista curta de fornecedores qualificados; caso contrário, sua franquia no TC bonding se erosiona. Para o investidor, é a aposta em equipamentos mais legível do ciclo do HBM4.
HBM4 de 16 camadas: confirmado versus rumoreado
Vale separar fatos de expectativas, em 14 de outubro de 2026. Confirmado: a SK hynix concluiu o desenvolvimento do HBM4 de 12 camadas (192 Gb, 24 GB por pilha) e anunciou o início do fornecimento a clientes; o padrão HBM4 com barramento de 2048 bits é público. Em desenvolvimento / meta anunciada: a versão de 16 camadas (256 Gb, 32 GB), que o setor vê como o veículo natural do hybrid bonding por densidade e altura de pilha. Não confirmado publicamente: cronogramas exatos de qualificação em massa nem qual fração da produção de 16 camadas usará união híbrida em vez de microbump avançado. Quem apresenta datas fechadas como fato está vendendo rumor como dado.
A leitura de Chase
Minha tese: hybrid bonding não é uma ferramenta, é um fosso. Nenhum bonder sozinho garante nada — a vantagem está na receita completa (CMP, ativação, alinhamento, recozimento) acoplada a um ciclo de metrologia que aprende a cada wafer. Esse conhecimento é tácito, se acumula com volume e não se compra com capex. Por isso os vencedores serão poucos e o prêmio por chegar primeiro é desproporcional.
Na lógica de negócios, há três vencedores em potencial. Primeiro, os fornecedores de equipamentos com base instalada: cada ponto de yield que entregam vira serviço recorrente. Segundo, o fabricante de memória que qualificar primeiro o HBM4 de 16 camadas com yield saudável — ele definirá o preço de referência do ciclo. Terceiro, a Coreia como ecossistema: a Samsung precisa do hybrid bonding para sua DRAM 3D (o transistor de canal vertical que pesquisa para empilhar células como na NAND 3D), e a SK hynix precisa dele para defender a liderança em HBM. O país que domina a memória não pode se dar ao luxo de perder a tecnologia que decide sua próxima geração.
Uma nota de engenheiro: na fábrica, o hybrid bonding se parece menos com "colar duas coisas" e mais com uma análise de temporização (STA) em escala mecânica — tudo é orçamento de tolerâncias. Quem entende isso entende por que o yield leva anos, não trimestres, para amadurecer.
Implicações
Para o investidor. O sinal antecedente não está nos comunicados à imprensa, está na carteira de pedidos: a relação book-to-bill dos fornecedores de bonding e metrologia antecipa a rampa do HBM4 de 16 camadas em 6 a 9 meses. Segundo sinal: anúncios de qualificação (não de "desenvolvimento") por fabricantes de memória. Riscos: a curva de aprendizado do yield pode atrasar a rampa e comprimir margens; e o segmento de encapsulamento avançado dentro do WFE já precifica expectativas altas — qualquer atraso é punido.
Para a indústria. O capex de memória continuará migrando do front-end para o encapsulamento avançado: o valor se desloca para quem controla a interconexão. Projetistas de sistemas deveriam assumir que a integração de lógica sobre memória com passos abaixo de 10 µm será uma opção real de projeto ainda nesta década e planejar o particionamento dos chips de acordo. E para a Coreia, a implicação é estratégica: a soberania em memória passa por dominar a união, não só o transistor.
Nota: participações de mercado de equipamentos e cronogramas do HBM4 de 16 camadas baseiam-se em anúncios públicos e relatórios do setor disponíveis em 14 de outubro de 2026 e estão sujeitos a alterações.
Perguntas frequentes
O que é exatamente o hybrid bonding e como ele difere do microbump?
O hybrid bonding une duas superfícies diretamente — dielétrico com dielétrico, cobre com cobre — sem solda nem bumps. O microbump usa esferas de solda com passo de ~40 µm; o hybrid bonding fica abaixo de 10 µm, multiplicando por mais de dez a densidade de interconexão, reduzindo parasitas e permitindo pilhas mais finas. É a diferença entre "conectar chips" e "fundi-los".
Se a física é conhecida, por que tão poucas empresas dominam o processo?
Porque o desafio não é a física, é o controle de processo em escala nanométrica sustentado por milhares de wafers: alinhamento sub-100 nm, dishing do CMP controlado em nanômetros, janelas de tempo após ativação por plasma, partículas próximas de zero e um recozimento que funde o cobre sem degradar a DRAM. As variáveis interagem entre si, e o conhecimento é tácito: conquista-se com volume, não se compra.
É certo que o HBM4 de 16 camadas usará hybrid bonding?
Não há certeza total. O confirmado em outubro de 2026 é o HBM4 de 12 camadas (192 Gb) em fornecimento; a versão de 16 camadas (256 Gb) é meta anunciada e candidata natural ao hybrid bonding por densidade e altura. Mas cronogramas de qualificação em massa e a divisão exata entre união híbrida e microbump avançado não estão confirmados publicamente. Acompanhe anúncios de qualificação, não de intenções.
O que um investidor deveria monitorar daqui em diante?
Três coisas: (1) o book-to-bill de fornecedores de bonders, CMP e metrologia — antecipa a rampa em 6 a 9 meses; (2) anúncios de qualificação do HBM4 de 16 camadas por fabricantes de memória; e (3) na Coreia, o avanço da Hanmi Semiconductor em equipamentos de hybrid bonding, pois sua franquia no TC bonding depende de não perder essa transição.


