VLSI Korea
Inferência de IA sem HBM? A aposta de 480 GB LPDDR5X da Intel e a guerra do TCO
A Intel revelou na OCP 2026 a GPU D270 para inferência: 1,3 PFLOPS em FP8, até 480 GB de LPDDR5X em placas de parceiros ODM e 350 W com refrigeração a ar. Com a HBM esgotada em 2026 e boa parte de 2027 já comprometida, a guerra não é mais pela largura de banda: é pelo custo por token.


Excerpt: A Intel revelou na OCP 2026 a GPU D270 para inferência: 1,3 PFLOPS em FP8, até 480 GB de LPDDR5X em placas de parceiros ODM e 350 W com refrigeração a ar. Com a HBM esgotada em 2026 e boa parte de 2027 já comprometida, a guerra não é mais pela largura de banda: é pelo custo por token.
Inferência de IA sem HBM? A aposta de 480 GB LPDDR5X da Intel e a guerra do TCO
Resumo em 30 segundos: A Intel revelou na cúpula OCP 2026 sua GPU D270 (Crescent Island), focada em inferência: 1,3 PFLOPS de computação em FP8, 1,5 TB/s de largura de banda de memória e uma placa PCIe de 350 W refrigerada a ar. A notícia não é a HBM: é a LPDDR5X — 160 GB na placa própria da Intel, até 480 GB nas placas de seus parceiros ODM. Uma única placa hospeda um modelo de 300B de parâmetros em FP8; um sistema de oito GPUs gerencia mais de um trilhão de parâmetros. Preço não divulgado, sem benchmarks independentes ainda. Enquanto isso, a HBM está praticamente esgotada para 2026 e grande parte do fornecimento de 2027 já está comprometida. Quem consegue a memória impõe a arquitetura — e, na inferência, a guerra se vence em custo por token (TCO), não em largura de banda.
Background
A infraestrutura de IA está deslocando seu centro de gravidade do treinamento para a inferência. O treinamento é uma corrida colossal e pontual de computação; a inferência é um serviço contínuo que emite bilhões de tokens todos os dias. Quando a carga de trabalho vira serviço, a estrutura de custos vira a estratégia.
Mas, no fim de 2026, o primeiro muro que os planejadores de infraestrutura de inferência encontram não é o FLOPS da GPU: é a compra de memória. A Samsung afirma que seu volume de HBM4 para 2026 está praticamente esgotado. A SK hynix informa que toda a sua produção de DRAM e NAND de 2026 está vendida. Segundo a imprensa do setor, a Micron já tem comprometida grande parte de sua memória de 2027 a preços mais altos. (Source: RCR Wireless)
Nesse contexto, a resposta da Intel na cúpula global da OCP em 12 de outubro chama a atenção: pular por completo a corrida pela HBM e construir sobre uma memória totalmente diferente.
Business Deep Dive
1. Dissecando a D270: por que LPDDR5X
As especificações publicadas pela Intel para a GPU D270 (antes Crescent Island): (Source: Intel)
| Item | Especificação |
|---|---|
| Arquitetura | Xe3P — 32 núcleos Xe3P, 256 motores matriciais XMX, 32 MB de cache L2 unificada |
| Computação | 1,3 PFLOPS em FP8 |
| Memória | LPDDR5X — 160 GB (placa da Intel) / até 480 GB (placas de parceiros ODM) |
| Largura de banda de memória | 1,5 TB/s |
| Potência e refrigeração | 350 W, refrigeração a ar, PCIe 5.0 x16 |
| Modelos suportados | 300B de parâmetros por placa, mais de um trilhão de parâmetros com 8 GPUs |
A decisão de design mais reveladora: o hardware convencional de gráficos 3D e de ray tracing sumiu. A área do chip antes ocupada pelas unidades gráficas de função fixa agora está a serviço da computação de IA. A inferência, gravada no silício como propósito único.
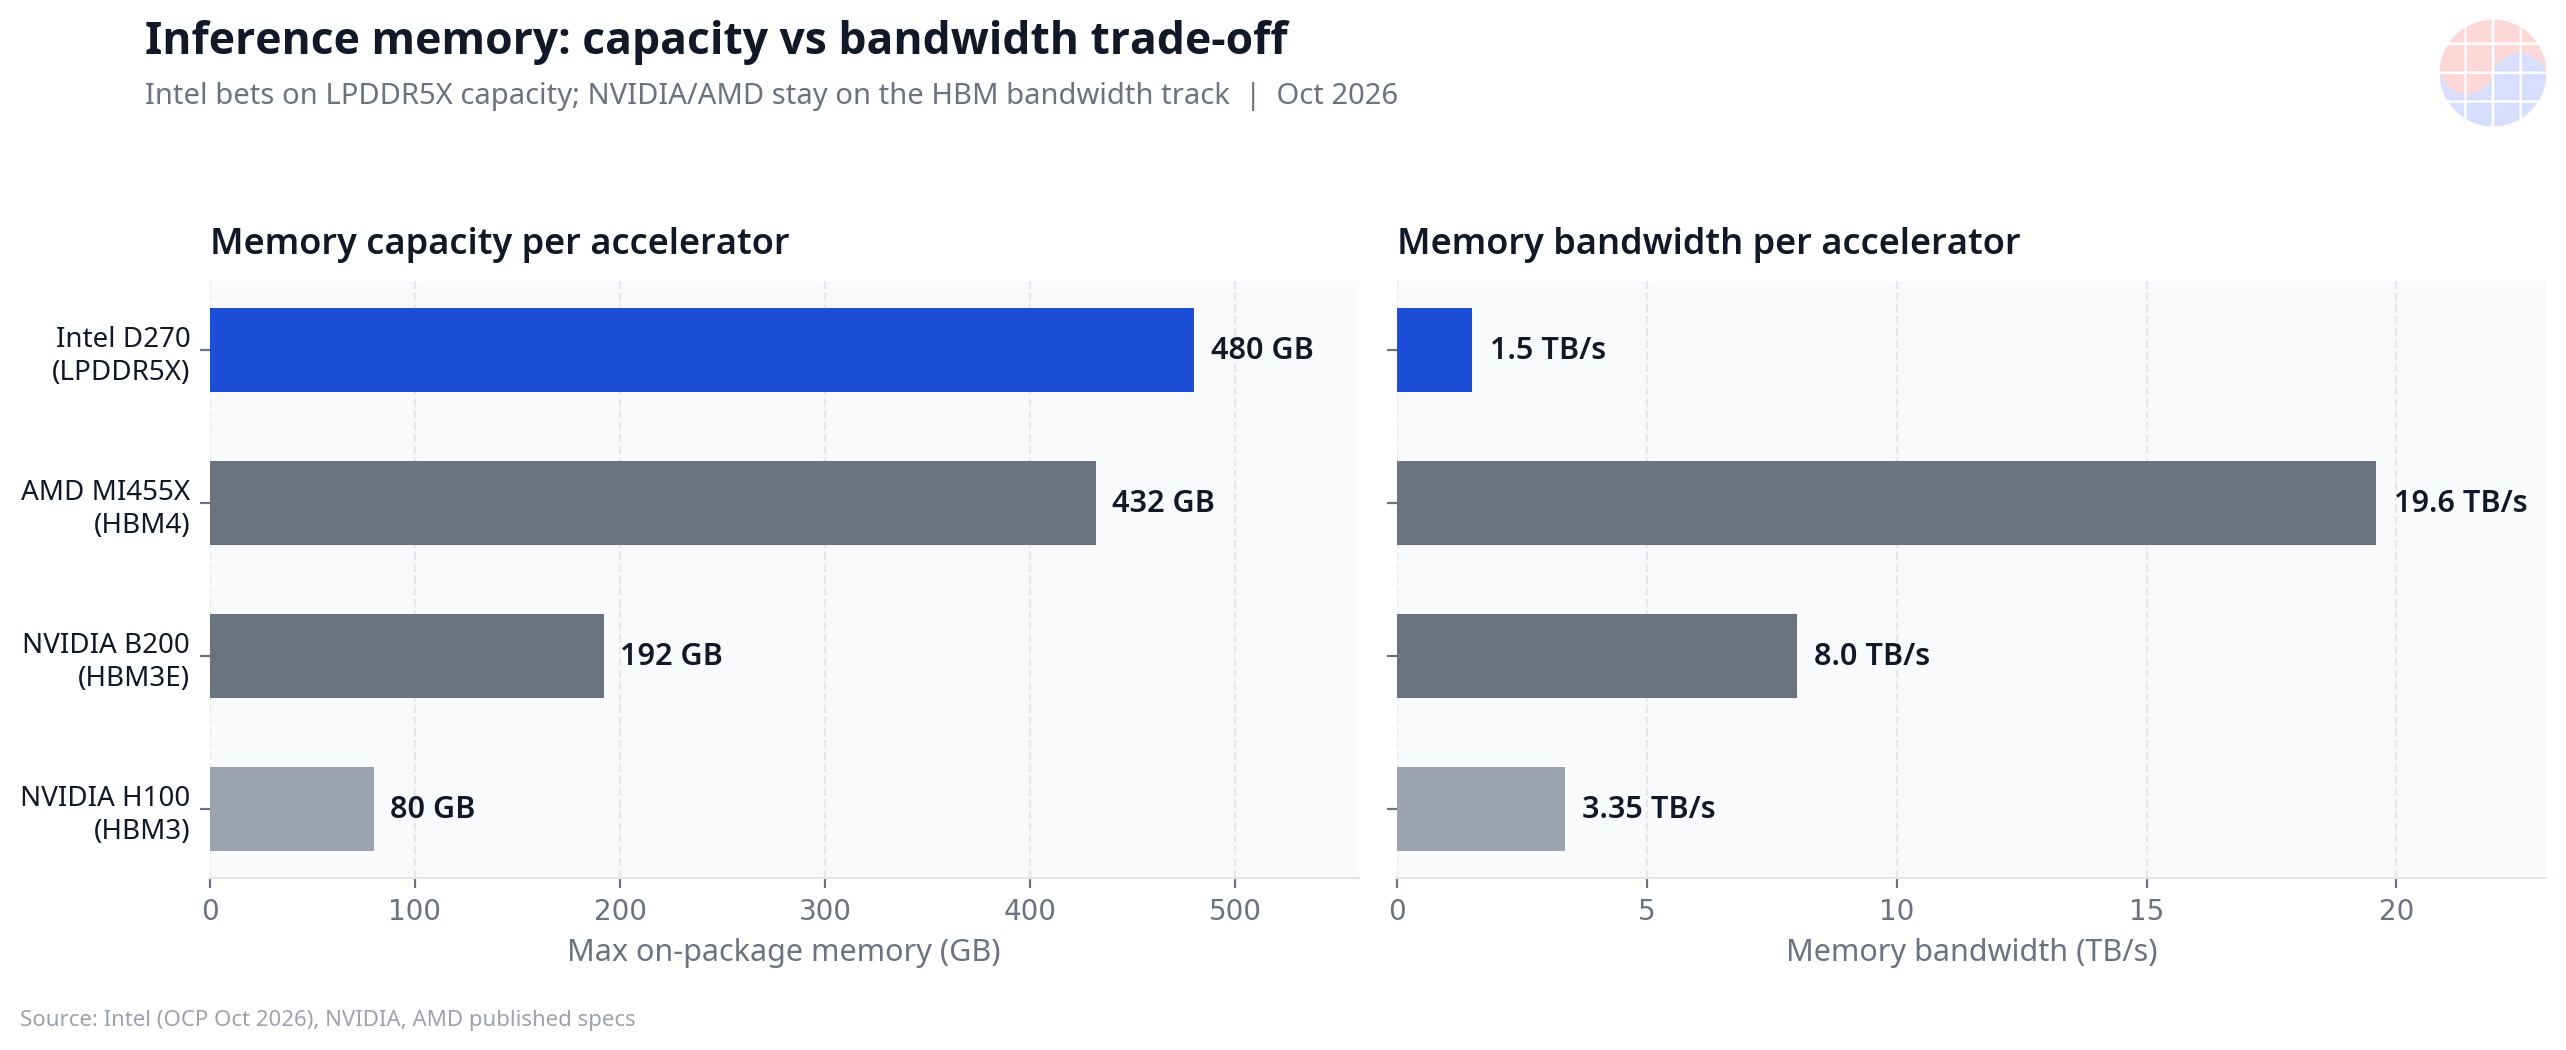
A segunda decisão é a memória: LPDDR5X em vez de HBM. Com 1,5 TB/s, a largura de banda é cerca de um quinto da de uma placa de classe HBM3E (8 TB/s). A capacidade, por outro lado, é esmagadora: os 480 GB das placas dos parceiros são cerca de 2,5 vezes os da geração flagship atual de HBM.
A matemática é simples. Em FP8, um parâmetro ocupa aproximadamente um byte. Os pesos de um modelo de 300B de parâmetros são ~300 GB, cabendo com folga em uma placa de 480 GB. Os ~180 GB restantes vão para o devorador oculto de memória da inferência, a KV cache, e para o processamento em lote (batching). Um modelo de um trilhão de parâmetros dividido em 8 placas precisa de ~125 GB por placa. O déficit de largura de banda pesa menos do que no treinamento, porque a inferência reutiliza os pesos já carregados ao longo de milhares de tokens em vez de renová-los o tempo todo.
A terceira decisão é a potência e o formato. Uma placa PCIe de 350 W refrigerada a ar se integra à infraestrutura existente dos centros de dados. Diferentemente dos aceleradores de classe 1.000 W refrigerados a líquido, não exige investimento especial em potência nem refrigeração — um fator com mais peso na matemática do TCO do que parece à primeira vista.
As ressalvas são igualmente claras. Preço não divulgado. A disponibilidade geral aparece descrita apenas como 2027 na imprensa. E não existem benchmarks independentes: os 1,3 PFLOPS são um pico teórico. (Source: VideoCardz)
2. A escassez de memória está reescrevendo as arquiteturas
Para entender a aposta da Intel é preciso olhar onde está o mercado de memória em outubro de 2026:
- HBM4 (geração atual): o volume de 2026 da Samsung está praticamente esgotado; toda a produção de DRAM e NAND de 2026 da SK hynix está vendida. Não dá para comprar o que não existe.
- HBM4E (próxima geração): interface de 2.048 bits, 14–16 Gbps por pino, até 3,6 TB/s por pilha. Amostras de 12-high (384Gb (48GB)) enviadas pela Samsung (maio) e pela SK hynix (junho). Produção em volume prevista para 2027. Ainda é uma geração definida pelos fabricantes, sem padrão JEDEC. (Source: RCR Wireless)
- Segundo relatos, a HBM4E de 12-high da Samsung teria passado nos testes de qualificação da NVIDIA, embora nem a Samsung nem a NVIDIA tenham confirmado oficialmente. (Source: HardwareBrief)
- A Micron já teria vendido 75% do seu fornecimento de memória de 2027. (Source: Tech Insider)
Em outras palavras, embarcar no roteiro da HBM significa entrar na fila pela alocação de 2027. Nesse mercado, "construir uma fazenda de inferência sem HBM" não é só redução de custos: é evitar o risco de aprovisionamento. A LPDDR5X é DRAM commodity produzida em massa para celulares e PCs. Sem o gargalo do empacotamento TSV/interposer, com uma ampla base de fornecedores e menor custo por GB. A Tesla chegou à mesma conclusão.
3. A Tesla se move na mesma direção: corte de memória no AI5/AI6
Em 1º de outubro, Elon Musk anunciou que a Tesla cortaria a memória do AI5 dos 144 GB de LPDDR5 planejados para 72 GB, e a do AI6 para 144 GB de LPDDR6 (um corte de um terço). A razão foi explícita: garantir volume suficiente para a produção do Optimus. O AI5 foi depois ajustado para 96 GB. Musk acrescentou que a largura de banda de memória, não a capacidade, é a restrição maior, de modo que o impacto no desempenho deveria ser desprezível. (Source: Wccftech)
O padrão é inconfundível: a crise de memória está mudando as próprias especificações de design. Redefinir os produtos em torno da memória que dá para conseguir está virando o procedimento padrão do hardware de IA no fim de 2026. Vale notar que o AI5 já está em produção piloto na fab da Samsung Foundry em Taylor, Texas.
4. As estratégias de memória divergem: NVIDIA x Intel
Quem confia no seu fornecimento de memória vai na direção oposta. O roteiro da NVIDIA:
- Rubin (2026): HBM4
- Rubin Ultra (2027): HBM4E
- Feynman (2028): segundo relatos, HBM personalizada — um design sob medida em vez de HBM padrão (Source)
- NVHBM (anunciada em agosto de 2026): a tecnologia de HBM personalizada da NVIDIA para o base die, codesenvolvida com os fabricantes de memória — +30% de largura de banda por pilha ante a HBM4E padrão, −15% de potência da HBM, −67% de área do PHY (Source: WeDoAny)
A AMD também segue na trilha da HBM: a MI455X integra 432GB (3,456Gb) de HBM4 a 19,6 TB/s. (Source: TweakTown)
A estratégia de memória está se bifurcando:
| Estratégia | Jogadores | Direção |
|---|---|---|
| Otimização de largura de banda e potência | NVIDIA (HBM personalizada NVHBM), AMD (HBM4/HBM4E) | Espremer mais a memória cara — treinamento e inferência flagship |
| Otimização de capacidade e custo | Intel (480 GB LPDDR5X), Tesla (LPDDR5/6) | Mais da memória barata — competição de TCO em fazendas de inferência |
Nenhuma é "a certa". As cargas de trabalho estão se dividindo. O treinamento de fronteira e a inferência premium são vorazes em largura de banda; o serviço massivo de tokens, os dispositivos e a inferência robótica dependem de capacidade e custo.
5. Decompondo o TCO: quatro alavancas por trás do custo por token
O TCO da infraestrutura de inferência se decompõe em quatro alavancas:
① Aquisição de memória. A HBM está esgotada: os compradores disputam alocação pagando prêmio. A LPDDR5X é um mercado commodity com poder de negociação e estabilidade de fornecimento. Nesta era, a capacidade de garantir o fornecimento é a primeira linha da equação do TCO.
② Potência e refrigeração. 350 W a ar contra 1.000 W a líquido não é só potência do chip: arrasta a densidade de potência por rack, o CAPEX da refrigeração líquida e a conta de energia. Por isso a Intel se gaba de "escalar sem infraestrutura especializada de rack ou refrigeração".
③ Capacidade por servidor. Um sistema de 8× D270 oferece 3,84 TB de memória para modelos de mais de um trilhão de parâmetros. Menos nós significa menos rede, menos potência e menos complexidade operacional. Capacidade é densidade de nós.
④ Utilização. Os servidores de inferência vivem limitados pela memória, não ociosos. Mesmo com menor largura de banda, caches KV grandes e tamanhos de lote amplos conseguem extrair vazão de tokens. A mesma lógica do comentário da Tesla de que "a largura de banda é a restrição maior".
Chase's Take
Se a métrica do treinamento era o FLOPS, a métrica da inferência é o dólar por token. A aposta da Intel traduz essa proposição para o silício. 1,3 PFLOPS parece modesto ante os flagships, mas reformule a pergunta de "quem é mais rápido" para "quem cunha tokens mais barato" e o jogo muda.
Dois pontos estruturais:
Primeiro, a escassez de HBM virou uma variável estrutural que força escolhas de arquitetura, não um soluço temporário de oferta. A Tesla cortando especificações e a Intel indo de LPDDR são respostas diferentes à mesma pressão. Enquanto os detentores de memória (a SK hynix, com ~57% da receita de HBM, e seus pares) exercem poder de precificação, os compradores de memória redesenham em torno da memória que conseguem obter. As notícias de hardware de IA dos próximos 2–3 anos devem ser lidas sobre essa tensão.
Segundo, os interesses da Coreia estão dos dois lados. Samsung e SK hynix são beneficiárias diretas do prêmio da HBM. Ao mesmo tempo, a Samsung Foundry está fabricando o AI5 da Tesla em Taylor, e a chinesa CXMT se aproxima na cadeia de suprimentos de LPDDR. Um mix de memória que passe de só-HBM para HBM-mais-LPDDR repercute nos portfólios do duopólio coreano de memória e no mix de clientes do seu foundry. Qualquer análise que aposte em apenas um lado é meia análise.
Os contra-argumentos, com justiça: 1,5 TB/s é pouco, e a inferência em tempo real sensível à latência (TTFT) pode sofrer. Acima de tudo, o preço não foi divulgado: a vantagem de TCO não pode ser verificada até existir a lista de preços. Declarar uma "vitória de valor em inferência" apenas com números teóricos seria prematuro.
Implications
Para investidores: - À medida que cresce a participação da inferência na carga de trabalho, o mix de memória se afasta do só-HBM. É hora de reavaliar os beneficiários estruturais da demanda por LPDDR5X e DRAM para servidores. - O prêmio da HBM provavelmente persiste até 2027: 2026 esgotado, alocação de 2027 pré-contratada e transição para uma HBM4E definida pelos fabricantes. O poder de precificação dos fabricantes de memória se mantém por ora. - A infraestrutura de potência/refrigeração (manter-se no ar contra migrar para o líquido) é uma nova variável do CAPEX dos centros de dados. Uma expansão de placas de inferência de classe 350 W pode desacelerar a transição para a refrigeração líquida.
Para operadores: - A compra de infraestrutura de IA está passando do "chip mais rápido" para a "memória que dá para conseguir". Planejem a capacidade de 2027 de trás para frente, a partir da alocação de memória. - Acompanhem as opções de inferência baseadas em LPDDR como hedge de diversificação de fornecedores. Pode ser o primeiro caso real de uma alternativa de inferência diferente da NVIDIA.
FAQ
P1. A LPDDR5X tem muito menos largura de banda que a HBM — é mesmo suficiente para inferência? R. Depende da carga de trabalho. Diferentemente do treinamento, que renova os pesos o tempo todo, a inferência carrega os pesos uma vez e gera milhares de tokens. O gargalo costuma ser a capacidade da KV cache e o tamanho do lote, não a largura de banda. O serviço em tempo real sensível à latência (TTFT) é onde o déficit de largura de banda aparece.
P2. 480 GB cabem mesmo 300B de parâmetros em uma placa? R. Em FP8, um parâmetro ≈ um byte, logo 300B de parâmetros ≈ 300 GB. Sobram ~180 GB em uma placa de 480 GB para a KV cache e o processamento em lote — matematicamente consistente com a afirmação da Intel. O comportamento real aguarda benchmarks independentes.
P3. Quanto custa? R. Não divulgado. A Intel diz que a amostragem a clientes está em andamento. A verdadeira vantagem de TCO ante as placas com HBM não pode ser calculada até existir o preço. Um debate de valor sem lista de preços é meio debate.
P4. Quando a escassez de HBM alivia? R. O volume de 2026 está praticamente esgotado e grande parte de 2027 já está pré-contratada. A produção em volume da HBM4E está prevista para 2027, mas, como geração definida pelos fabricantes, sua velocidade de rampa é a variável. Conte com condições apertadas ao longo de todo 2027.
Leituras recomendadas
- Chris Miller, Chip War — a geopolítica e as cadeias de suprimento da hegemonia dos semicondutores. Ver na Amazon
- Clayton Christensen, The Innovator's Dilemma — o clássico de MBA sobre como entrantes de baixo custo viram mercados; uma lente para ler a aposta LPDDR da Intel. Ver na Amazon
Compras através deste link podem gerar uma comissão.
Nota: os números e cronogramas baseiam-se em informações públicas até 13 de outubro de 2026. Os números de desempenho da GPU D270 da Intel são valores teóricos publicados pelo fabricante, sem verificação por benchmarks independentes. Não é recomendação de investimento.
Tags: deep-dive, inference, memory-tco, lpddr5x, hbm, portuguese