VLSI Korea
GPU de inferência da Intel, a fundo: por que o D270 troca o HBM por 480 GB de LPDDR5X
A Intel trocou o HBM pelo LPDDR5X: 160 GB na sua placa e até 480 GB em projetos ODM. Verificamos o número viral, a lógica de capacidade sobre largura de banda e o que isso significa para Samsung, SK hynix e Micron.


Resumo em 30 segundos
Em 12 de outubro de 2026, no OCP Global Summit, a Intel deu nome comercial e especificações finais à sua GPU dedicada à inferência. Com o codinome Crescent Island, a linha chama-se Intel GPU D-Series e sua primeira placa é a D270 (segundo a imprensa especializada). A manchete está na memória: esta placa não usa HBM. Vinte pacotes LPDDR5X entregam 1,5 TB/s de largura de banda e, embora a placa da própria Intel tenha 160 GB, os projetos de parceiros ODM podem escalar a capacidade até 480 GB. O número «480 GB de LPDDR5X» que circulou em análises nas redes sociais é real, mas condicional: a placa que a Intel vende tem 160 GB. O cômputo é de 1,3 PFLOPS em FP8, com 350 W numa placa PCIe refrigerada a ar. A Intel afirma que uma única placa pode servir modelos de até 300 bilhões de parâmetros e que um sistema de oito placas supera um trilhão de parâmetros. A amostragem para clientes está em curso; não há preço nem data de disponibilidade geral anunciados. Esta análise reúne todos os fatos confirmados, a lógica técnica e econômica do «por que LPDDR» e o que isso significa para Samsung Electronics, SK hynix e Micron.
O que a Intel anunciou de fato
O Crescent Island não surgiu da noite para o dia. A Intel apresentou a GPU de inferência no OCP Global Summit de outubro de 2025, com configuração de 160 GB de LPDDR5X. No Hot Chips, em agosto de 2026, detalhou a arquitetura Xe3P e, em 12 de outubro de 2026, fixou a marca GPU D-Series e as especificações finais. Também exibiu um protótipo de módulo OAM refrigerado a líquido — duas GPUs por módulo, oito módulos num chassi de 5U —, sinal de que o PCIe a ar é a cabeça de praia e os formatos densos ficam no roteiro.
A filosofia de projeto foi constante desde o início: não enfrentar de frente as GPUs bandeira de treinamento. O alvo não é o bastião HBM do Blackwell Ultra da NVIDIA ou da série MI da AMD, mas as cargas de inferência que cabem nos servidores x86 padrão que as empresas já possuem. Anil Nanduri, vice-presidente de produtos de IA e de entrada no mercado do grupo de data centers da Intel, disse sem rodeios: «A inferência está se tornando a carga de trabalho que define a IA, e as empresas precisam de infraestrutura que entregue o desempenho certo ao custo certo».
| Especificação | Intel GPU D270 (Crescent Island) |
|---|---|
| Arquitetura | Xe3P (Xe3 aprimorada) |
| Núcleos Xe | 32 (quatro slices) |
| Motores matriciais XMX | 256 |
| Cômputo FP8 (denso) | 1,3 PFLOPS |
| Cômputo vetorial FP64 | 10,2 TFLOPS |
| Cache L2 | 32 MB (unificado) |
| Memória | LPDDR5X, 20 pacotes, 80 canais, 1.280 bits |
| Velocidade da memória | 9.375 MT/s |
| Largura de banda | 1,5 TB/s |
| Capacidade | 160 GB (placa Intel) / até 480 GB (projetos ODM) |
| Interface | PCIe Gen5 x16 |
| Potência | 350 W |
| Formato / refrigeração | PCIe CEM de largura dupla, a ar |
| Estado | Amostragem para clientes (out. 2026); preço e disponibilidade não anunciados |
Fonte: divulgações da Intel no OCP Global Summit de 12 de outubro de 2026 e materiais de arquitetura do Hot Chips 2026.
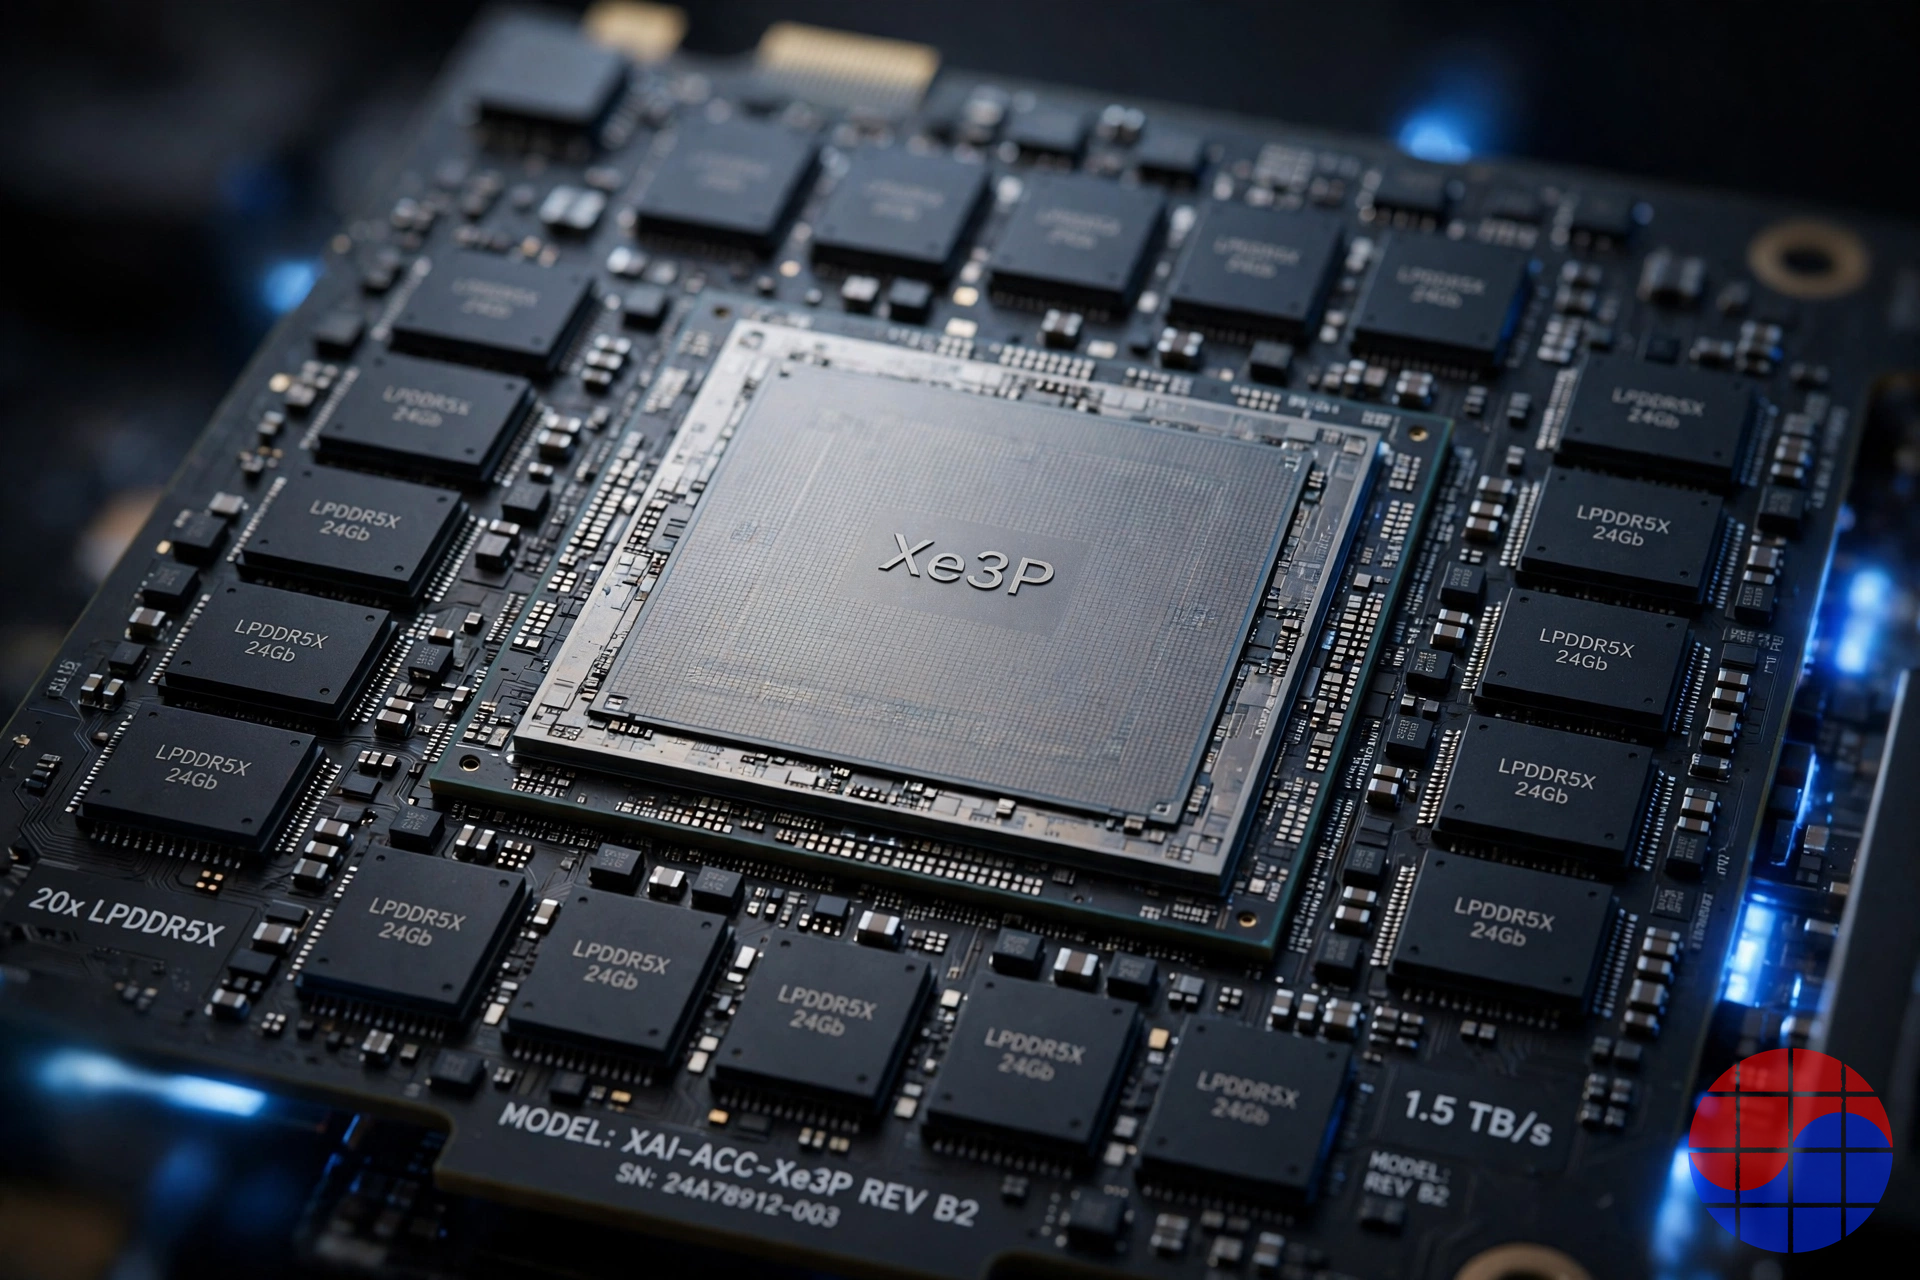
O próprio núcleo Xe3P foi recortado para inferência. A matriz sistólica XMX passou de 4 níveis de profundidade no Xe2 para 16, o arquivo de registradores gerais dobrou para 1 MB por núcleo e a memória L1/compartilhada local cresceu para 512 KB por núcleo. Os blocos de gráficos 3D e ray tracing das GPUs de jogos foram removidos por completo, cedendo cada milímetro quadrado à matemática matricial e aos tipos de dados de inferência, de FP4 a FP64. O software se apoia numa pilha aberta centrada em OpenVINO e oneAPI.
Verificação dos 480 GB: número real, rodapé ausente
Após o anúncio, «480 GB de LPDDR5X» viajou pelas análises sociais como se fosse a especificação-título da placa. O número aparece, sim, na divulgação da Intel — mas é a configuração máxima que os parceiros ODM podem construir, não a especificação da placa com a marca Intel. Sem esse rodapé, o número engana.
| Configuração | Densidade por pacote | Pacotes | Capacidade total | Quem vende |
|---|---|---|---|---|
| Placa de referência Intel | Pacotes classe 64 Gb | 20 | 160 GB | Intel (placa de marca) |
| Máximo ODM | Pacotes classe 192 Gb | 20 | 480 GB | Parceiros (placas ODM) |
O subsistema de memória é idêntico nos dois casos: um barramento de 80 canais de 16 bits (1.280 bits) a 9.375 MT/s, para 1,5 TB/s. Só muda quantos dies de DRAM são empilhados dentro de cada pacote. Assim, 480 GB é «o teto que o projeto permite» e 160 GB é «o que a Intel realmente envia». De qualquer forma, é a maior classe de capacidade anunciada para uma placa PCIe de inferência. Para comparar, a GPU Rubin da NVIDIA carrega 288 GB de HBM4 e a série MI450 da AMD é relatada em 432 GB: em capacidade bruta, o projeto LPDDR inverte a hierarquia usual.
A aritmética de tamanho de modelo exige o mesmo cuidado. Em FP8 (um byte por parâmetro), uma placa de 160 GB comporta cerca de 160 bilhões de parâmetros em pesos antes do cache KV e da sobrecarga de execução; os «300 bilhões de parâmetros numa única placa» da Intel correspondem à configuração de 480 GB. O sistema de oito placas com «mais de um trilhão de parâmetros» supõe igualmente 480 GB × 8 = 3,84 TB de memória agregada. Os números não são falsos — mas a configuração de referência precisa viajar sempre com eles.
Por que LPDDR5X (1): a inferência trava na memória, não no cômputo
Treinamento e inferência usam a memória de maneiras diferentes. O treinamento repete multiplicações matriciais enormes, então tanto FLOPS quanto largura de banda importam. A inferência — sobretudo a fase de decodificação, que emite um token por vez — é um jogo de largura de banda com lotes pequenos: cada token exige ler da memória todo o conjunto de pesos do modelo, e o tempo de transmitir esses pesos define a latência entre tokens.
Mas, no serviço em produção, a largura de banda não é o único muro. Quando a concorrência sobe e os contextos se alongam, o cache KV devora memória rapidamente. A restrição vinculante passa a ser: o modelo cabe numa placa só, e quantas requisições simultâneas e quanto contexto essa placa sustenta? Se a capacidade não basta, o modelo precisa ser fragmentado entre placas, e o tráfego entre elas e o cômputo ocioso viram custo puro. É exatamente aí que está a aposta da Intel. O D270 cede uma ordem de magnitude em largura de banda frente às bandeiras HBM, mas multiplica a capacidade por dois ou três a uma fração do preço e da potência da placa — e, nesse regime, quem ganha é o custo por token.
O enquadramento em números: 1,5 TB/s não alcança nem uma única pilha HBM4 (2,8 TB/s ou mais), muito menos as dezenas de TB/s de uma bandeira de 12 pilhas. Em troca, o D270 é uma placa de 350 W refrigerada a ar. Onde as bandeiras HBM passam de 1.000 W e forçam racks com refrigeração líquida, o D270 entra num slot PCIe livre de um servidor empresarial existente. A Intel não vende desempenho máximo; vende capacidade de inferência implantável hoje, numa infraestrutura que já existe.
Por que LPDDR5X (2): custo por GB e simplesmente conseguir comprar
O segundo argumento é dinheiro e suprimento. Fala-se do HBM4 em torno de 31–32 dólares por GB — cerca do dobro dos 17–18 dólares por GB do HBM3E (estimativas do setor). O LPDDR5X, mesmo após as altas do superciclo, era negociado em torno de 12 dólares por GB em pacotes de 12 GB: menos da metade do HBM4. O encapsulamento amplia a distância: o HBM herda o gargalo do empilhamento TSV e do interposer sobre a capacidade de encapsulamento avançado, enquanto o LPDDR5X é DRAM de consumo em massa — centenas de milhões de telefones e PCs por ano —, com ampla base de fornecedores e encapsulamento padrão.
O risco de suprimento é a realidade de 2026. A produção de HBM de 2026 da Samsung e da SK hynix está praticamente esgotada, e a Micron teria comprometido antecipadamente boa parte do seu suprimento de 2027. Entrar hoje na fila do HBM significa esperar a alocação de 2027. O LPDDR5X, ao contrário, pode ser comprado agora. Para um retardatário com baixa prioridade na fila de alocação de HBM, uma «placa de inferência sem HBM» é ao mesmo tempo corte de custo e proteção contra risco de suprimento. E a Intel não é a única a chegar a essa conclusão: os chips de inferência próprios da Meta, a família MTIA, usam memória de classe LPDDR, e o silício de inferência da Tesla fez a mesma escolha de família.
Três memórias frente a frente: HBM4 vs LPDDR5X vs GDDR7
| Dimensão | HBM4 | LPDDR5X | GDDR7 |
|---|---|---|---|
| Largura de banda por pilha/chip | 2,8+ TB/s por pilha | ~77 GB/s por pacote (1,5 TB/s por placa) | Até ~144 GB/s por chip |
| Largura de banda total por acelerador | Dezenas de TB/s (12 pilhas) | 1,5 TB/s (D270) | ~1,8 TB/s (512 bits) |
| Capacidade por acelerador | 288–432 GB | 160–480 GB | 32–96 GB |
| Custo por GB | ~31–32 dólares (estimativas) | ~12 dólares (preços da alta de 2026) | Muito abaixo do HBM (gráficos de consumo) |
| Perfil de potência | Alto, incluindo o sistema de interposer | Menor energia por bit (projeto móvel) | Energia por bit maior que a do LPDDR |
| Encapsulamento | Pilha TSV + interposer obrigatórios | Pacotes padrão, montagem em placa | Montagem em placa |
| Situação de suprimento | Produção de 2026 esgotada; corrida por alocação | DRAM de consumo; ampla base de fornecedores | Disputa com a demanda de gráficos |
| Adotantes-chave | NVIDIA Rubin, série MI450 da AMD, bandeiras TPU/Trainium | Intel GPU D-Series, Grace/Vera da NVIDIA (memória de CPU), Meta MTIA | Série GeForce RTX 50 e outras placas gráficas |
Nota: os valores de custo por GB são estimativas que variam muito conforme o momento e as condições de contrato; aparecem para ilustrar a direção — LPDDR5X a menos da metade do HBM4. Os valores de largura de banda seguem as especificações divulgadas por cada fabricante.
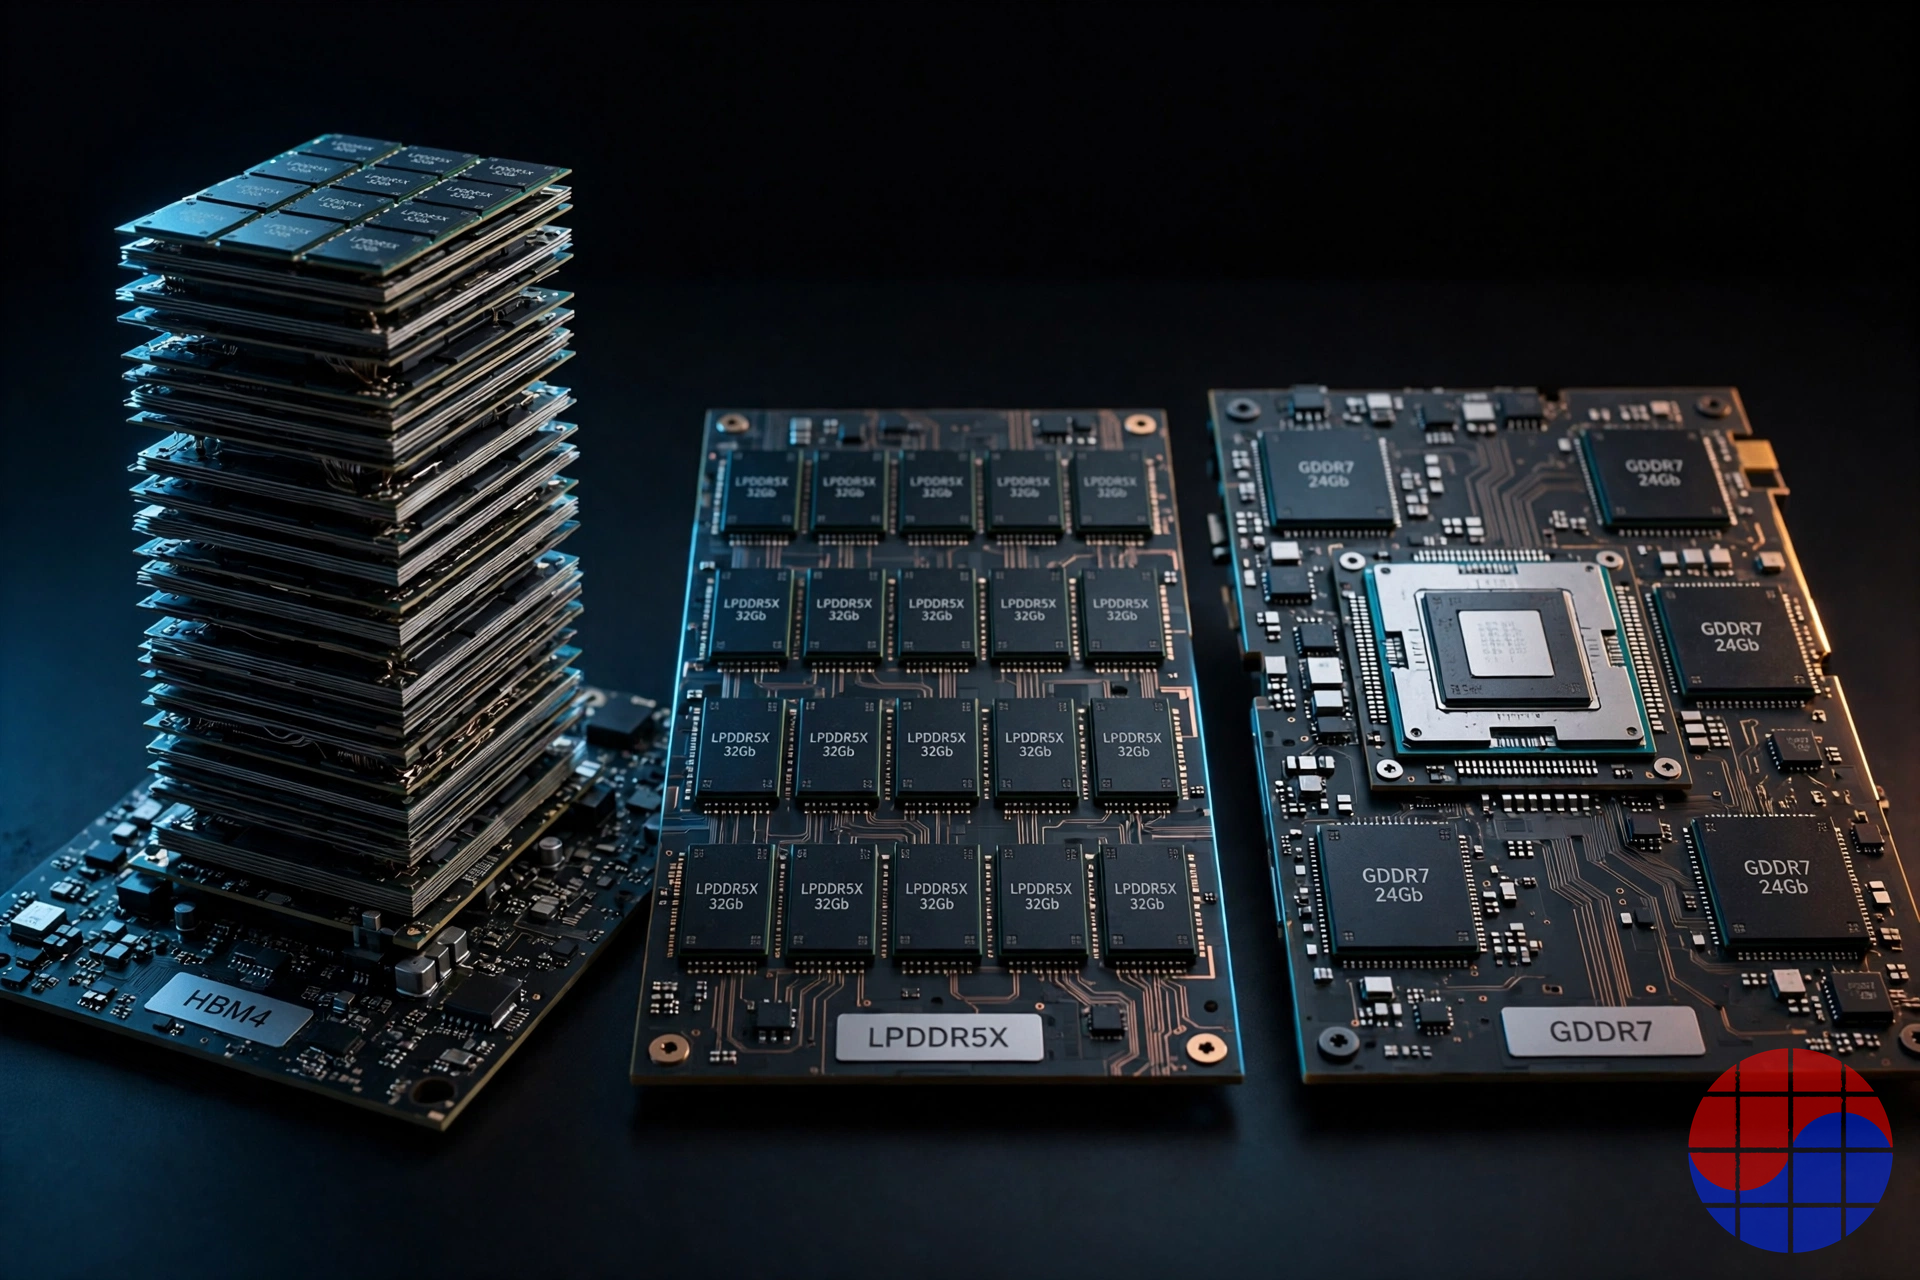
A tabela não é um ranking: é a escolha de qual restrição comprar. O HBM4 compra largura de banda e aceita custo de capacidade e risco de alocação. O GDDR7 é barato e tem largura de banda respeitável, mas sua pequena capacidade por chip dificulta colocar centenas de gigabytes numa placa só. O LPDDR5X abre mão da largura de banda e ganha em custo de capacidade, disponibilidade e potência. À medida que a demanda de inferência migra do «token mais rápido» para o «token mais barato», o centro de gravidade desta tabela se inclina para o LPDDR.
O que significa para os fornecedores: Samsung, SK hynix, Micron — e o SOCAMM
Para os três grandes da memória, o sinal é simples: a demanda de DRAM dos data centers de IA não converge só para o HBM. No lado da CPU, grandes volumes já fluem para o LPDDR. A Grace da NVIDIA carregava até 480 GB de LPDDR5X por CPU; sua sucessora Vera escala até 1,5 TB a 1,2 TB/s por meio de módulos SOCAMM2. Um único rack Vera Rubin NVL72 abriga 36 CPUs Vera — até 54 TB de memória de CPU por rack. Somando aceleradores LPDDR como o D270, o LPDDR de data center cresce de «memória ao lado da CPU» para um eixo de demanda independente.
A modularização importa. O LPDDR nasceu como componente móvel soldado à placa; o formato SOCAMM da NVIDIA o redefiniu como peça de servidor substituível e expansível. Samsung, SK hynix e Micron participam do suprimento SOCAMM, e a NVIDIA teria incluído a taiwanesa Nanya na cadeia de LPDDR da Vera — uma diversificação que, por si só, indica o tamanho do volume.
Do assento de um fornecedor coreano, a demanda é uma faca de dois gumes. De um lado, um novo fundo de demanda de IA preenche o mercado de DRAM de consumo que a conversão para HBM vem drenando; a demanda de servidores é parte do motivo pelo qual os preços do LPDDR5X saltaram dois dígitos por trimestre ao longo de 2026. Do outro, o LPDDR continua sendo DRAM de consumo: nada de margens excessivas estilo HBM, e exposição direta à competição de preços de seguidores como a CXMT. Ainda assim, a direção do volume é inequívoca. A partir de 2027, a demanda de bits LPDDR na infraestrutura de IA cresce estruturalmente dos soquetes de CPU e dos aceleradores de inferência ao mesmo tempo.
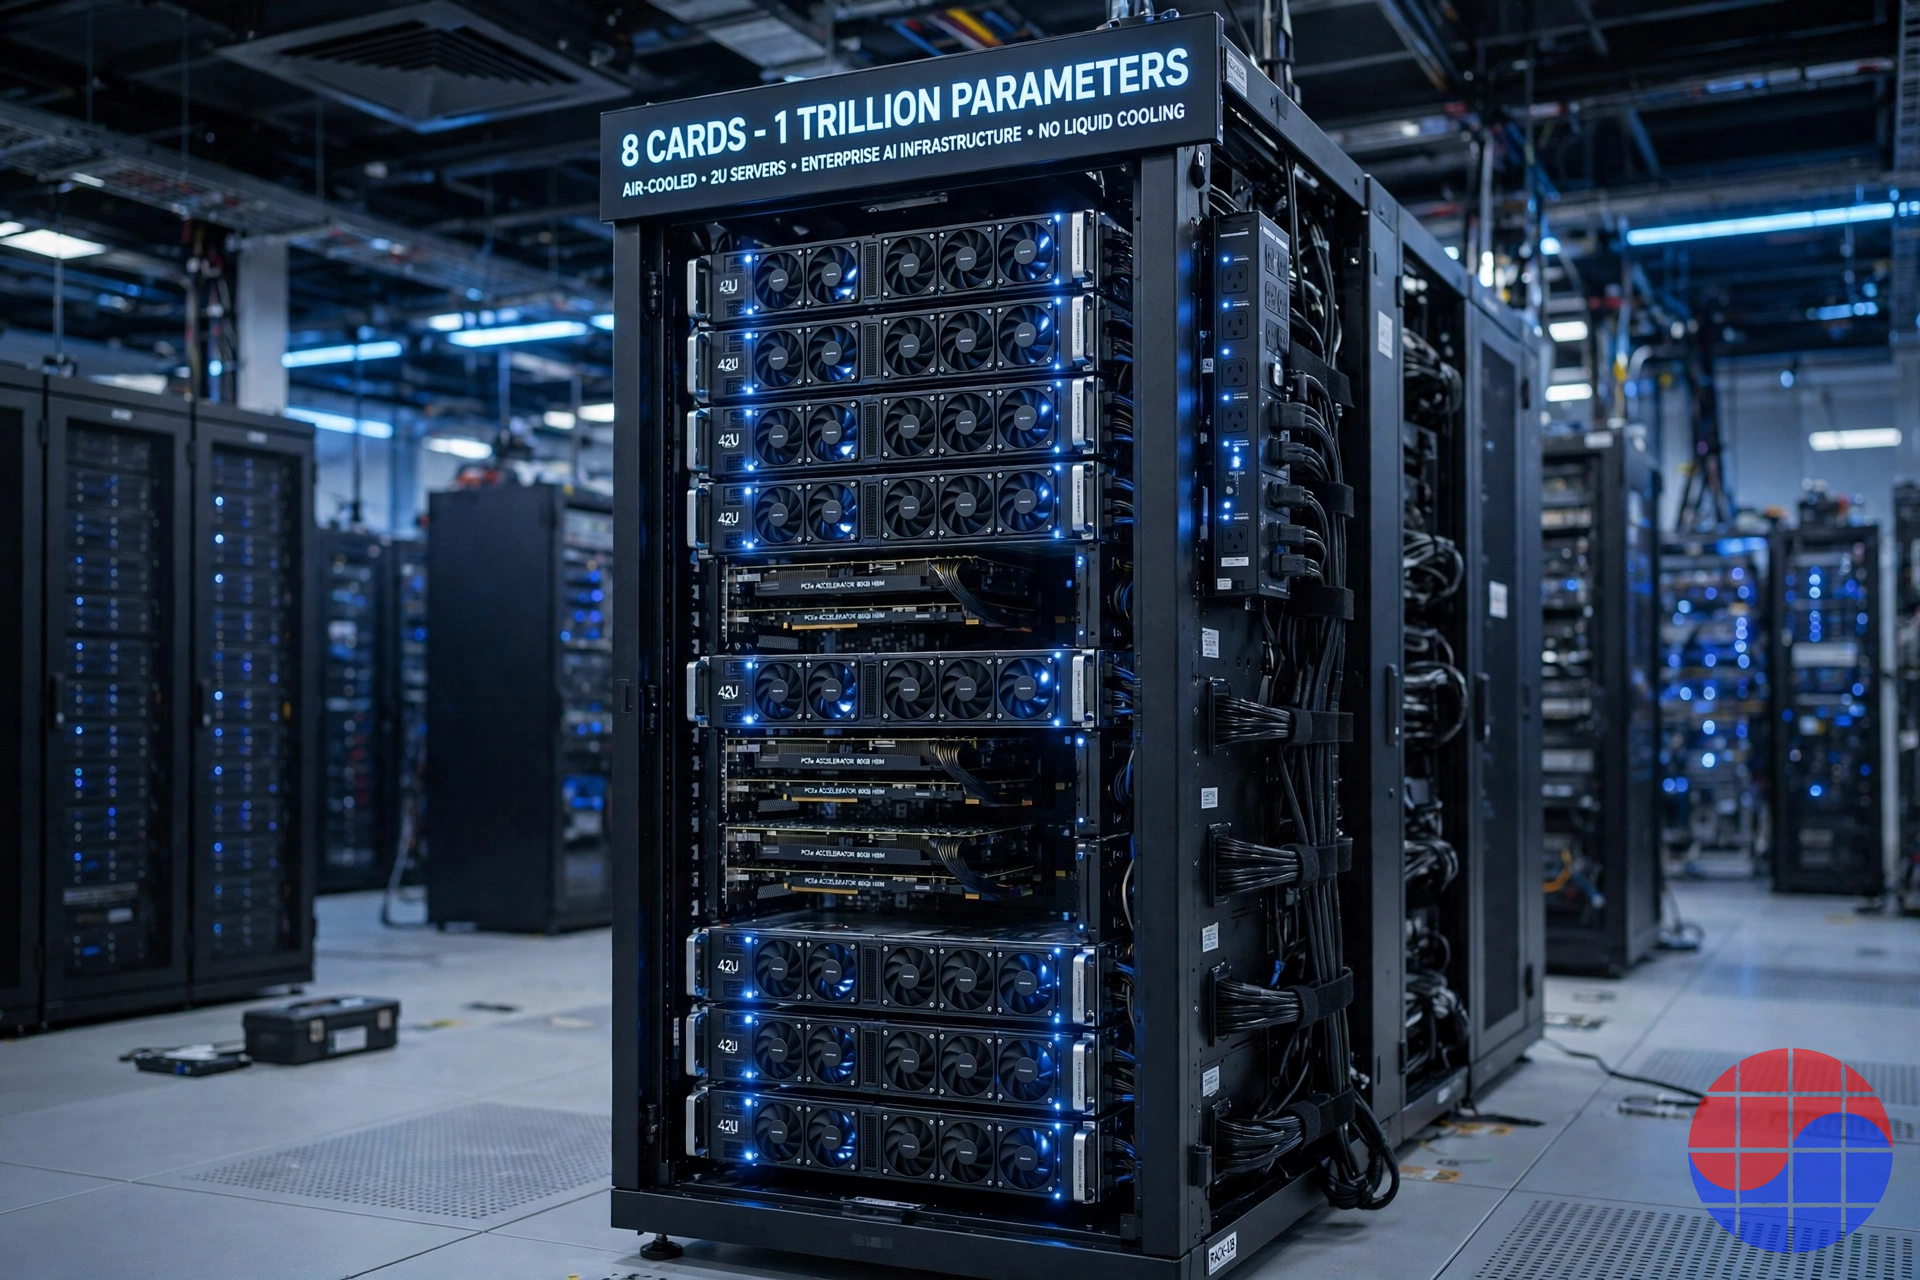
O quadro competitivo: até a NVIDIA coloca LPDDR ao lado das suas CPUs
Ler a escolha da Intel apenas como «o recurso de quem não conseguiu garantir HBM» é ver metade da história. A NVIDIA — a maior compradora de HBM do planeta — executa ela mesma uma estratégia de memória dupla: HBM4 na GPU, LPDDR5X na CPU, repartindo os papéis famintos por largura de banda e por capacidade conforme a carga. De Grace para Vera, a capacidade de memória da CPU triplicou, de 480 GB para 1,5 TB, e a largura de banda subiu de 512 GB/s para 1,2 TB/s; na visão da NVIDIA, a CPU da era da IA agêntica é uma peça que deve carregar mais memória, não menos.
A AMD sustenta o flanco oposto: a série MI mantém a linha ortodoxa de HBM em tudo e disputa a inferência pela largura de banda. Os ASICs sob medida se dividem: o TPU do Google e o Trainium da AWS pegam HBM; o MTIA da Meta pega memória de classe LPDDR. O consenso emergente do setor é uma estrutura de dois andares: HBM para treinamento e serviço de fronteira; LPDDR crescendo embaixo, na inferência em massa e na memória de CPU. O D270 é a primeira tentativa em grande escala de atacar esse andar de baixo em formato de GPU.
Chase's Take
Tire a marca e este produto é uma estratégia de compra de memória vestida de GPU. A Intel evitou uma briga de cômputo que não pode vencer e apresentou a maior capacidade de inferência construível com memória que de fato dá para comprar em 2026–2027. O número de 1,3 PFLOPS é discreto; a combinação — 480 GB numa placa de 350 W refrigerada a ar — é uma coordenada que nenhum rival ocupa.
Para os fabricantes coreanos de memória, é um vento a favor silencioso. Atrás do glamour de preços do HBM, um segundo eixo de demanda de IA — o LPDDR de servidor — está se consolidando em volume real. Quando os 1,5 TB por soquete da Vera e os até 480 GB por placa do D270 começarem a ser enviados ao mesmo tempo, o LPDDR5X será revalorizado de componente de smartphone para infraestrutura de IA. A armadilha: a alta do LPDDR corrói a própria lógica de TCO da Intel. Quanto mais caro o LPDDR, mais fina a margem da equação «memória barata, inferência barata». O destino deste produto será decidido menos pelo seu silício do que pela curva de preços da memória.
Para a estrutura de custos da memória de inferência, lida frente aos números do próprio campo HBM, veja também: No HBM Needed? Intel's 480GB LPDDR5X Bet and the Inference Memory TCO War
Riscos e o que ainda não se sabe
Primeiro, a natureza dos números de desempenho: 1,3 PFLOPS é um pico teórico, ainda sem benchmarks independentes, e o rendimento real de tokens depende muito da otimização de kernels e da maturidade da pilha. Segundo, o ecossistema de software: a gravidade do CUDA também é forte na inferência, e a fluidez com que a pilha OpenVINO/oneAPI se acoplar aos frameworks de serviço em produção vai decidir a adoção — a linha Gaudi da Intel perdeu por ecossistema mais do que por silício, um precedente impossível de ignorar. Terceiro, o teto de largura de banda: 1,5 TB/s pode ser gargalo na decodificação de modelos muito grandes com lotes altos, e a própria Intel traça a linha fora do treinamento e do serviço de fronteira. Quarto, as condições comerciais estão em branco: sem preço nem data de disponibilidade, com envios em volume discutidos para 2027 — até lá, o HBM4E terá chegado e os preços do LPDDR podem ter subido mais, redesenhando o mapa competitivo. Por fim, a primeira reação do mercado foi fria: as ações da Intel teriam fechado em baixa no dia do anúncio.
FAQ
Q: Os 480 GB de LPDDR5X do D270 são uma especificação confirmada? A: É real como configuração máxima, mas a placa da própria Intel tem 160 GB. Os 480 GB são o teto para placas ODM povoadas com pacotes de maior densidade (classe 192 Gb). A maioria das citações sociais de «480 GB» omite essa condição.
Q: Por que usar LPDDR5X em vez de HBM numa GPU de inferência? A: Porque a inferência em produção é limitada menos pelo cômputo bruto do que pela capacidade de alojar o modelo e o cache KV, e pelo custo por token. Fala-se do LPDDR5X a menos da metade do custo por GB do HBM4, ele é muito mais fácil de adquirir e consome menos. O projeto sacrifica o pico de largura de banda para ganhar em capacidade e custo.
Q: Em que nível está a largura de banda de 1,5 TB/s do D270? A: Abaixo de uma única pilha HBM4 (2,8 TB/s ou mais) e uma ordem de magnitude abaixo dos aceleradores bandeira de dezenas de TB/s — mas na mesma faixa de uma configuração GDDR7 de 512 bits (~1,8 TB/s). É um número feito para competir em capacidade por watt e por dólar, não em vazão absoluta.
Q: O que isso significa para a Samsung Electronics e a SK hynix? A: Sinaliza que a demanda de LPDDR dos data centers de IA está se expandindo das CPUs de servidor (o SOCAMM da Grace e da Vera da NVIDIA) para os aceleradores de inferência. As margens não igualarão as do HBM, mas o crescimento estrutural de volume está à vista, e as duas empresas coreanas estão dentro da cadeia de suprimento SOCAMM.
Q: Quando o D270 poderá ser comprado e a que preço? A: Em outubro de 2026, a peça está em amostragem para clientes. A Intel não divulgou preços nem data de disponibilidade geral; os envios em volume são discutidos para 2027.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.