 VLSI Korea
A queda do PC não é um presente para a IA: o paradoxo do suprimento de memória
A queda do PC libera wafers maduros, mas a IA precisa de HBM, não de silício genérico. Análise de 2026: crowding-out do HBM, disciplina dos fornecedores, LTA renegociados para cima e a corrida do capex rumo ao trilhão anual.


Resumo em 30 segundos
A queda do PC está liberando wafers de nós maduros — e isso não significa nada para a IA. Um acelerador não roda com DRAM genérica: ele exige HBM, e silício maduro não vira HBM. A história real de oferta de 2026 tem três atos: (1) o HBM está expulsando a DRAM e a NAND commodity das fabs, consumindo múltiplos dos recursos por bit entregue e travando o crescimento da oferta de commodity; (2) os fornecedores, disciplinados pelo tombo de 2023–2024, estão cortando exposição ao commodity, elevando preços de contrato, renegociando LTA para cima e priorizando clientes por nível; (3) o capex de IA caminha para a casa de US$ 1 trilhão ao ano, e o mercado de crédito começou a precificar a pergunta incômoda — quem paga a conta. Por trás de tudo, o paradoxo de Jevons dos tokens: token mais barato torna a computação mais valiosa, sustentando a demanda por HBM. Em 14 de outubro de 2026, o poder de precificação mora do lado da oferta de memória — e é lá que o investidor deve olhar.
Contexto: o PC esfria, os wafers "sobram"
Os dados públicos de embarques de PCs e notebooks desenham, em outubro de 2026, um dos períodos mais fracos do ciclo: reposição adiada, digestão do último grande ciclo corporativo ainda em curso e consumidor sem pressa. Linhas de fabricação em nós maduros — DDR4, NAND de gerações iniciais — operam abaixo da utilização ideal.
Desse quadro nasceu uma leitura preguiçosa: se o PC consome menos, esses wafers "ficam livres" para a IA. É uma aritmética sedutora e errada. Confunde wafer com wafer útil. A IA não precisa de wafers; precisa de largura de banda de memória empacotada de um jeito muito específico. Esse jeito tem nome: HBM.
Análise aprofundada
O equívoco do silício "liberado"
Uma pilha de HBM não é DRAM comum empilhada. Ela exige dies DRAM de classe avançada (nós 1-alpha/1-beta e equivalentes), formação de TSV através de cada die, um logic base die que orquestra a pilha e capacidade de encapsulamento avançado da classe CoWoS. Cada etapa demanda ferramentas, receitas de processo e rendimento (yield) que uma linha de nó maduro não possui — e não adquire com um ajuste de máscara.
Em termos práticos: a capacidade liberada pelo PC é o silício errado, com a especificação errada, no nó errado. Uma linha otimizada para DDR4 em classe de 20 nm não se converte em linha de HBM; o capex de reconversão supera em muito o valor do commodity que ela produziria. O "suprimento liberado" é um erro de categoria, não uma arbitragem.
O que a queda do PC realmente faz é mais sutil — e mais importante: ela enfraquece o comprador tradicional de commodity. O OEM de PC, por décadas o cliente-âncora da DRAM genérica, chega à negociação de 2026 com menos volume e menos poder. Do outro lado da mesa estão fornecedores que aprenderam a lição do último colapso.
Crowding-out: o HBM está comendo a fab
Este é o mecanismo central de 2026. Uma pilha HBM4 de 12-high, montada com dies de 24 Gb, soma 288 Gb por pilha; a variante de 16-high chega a 384 Gb. Para entregar esses bits é preciso fabricar 12 ou 16 dies DRAM, perfurá-los com TSV, empilhá-los com precisão micrométrica, acoplar o base die e testar o conjunto — descartando uma fração relevante de material a cada etapa.
A conta de recursos é implacável: por bit entregue, o HBM consome múltiplos da área de wafer, das horas de equipamento e da capacidade de teste que a DRAM commodity exige. Cada ponto percentual de mix que o HBM ganha na produção de bits dos grandes fornecedores é capacidade que não vai para o commodity. Como espaço de fab, horas de litografia e capex são finitos, o crescimento da oferta de DRAM e NAND commodity fica mecanicamente limitado — não por falta de demanda, mas por deslocamento interno.
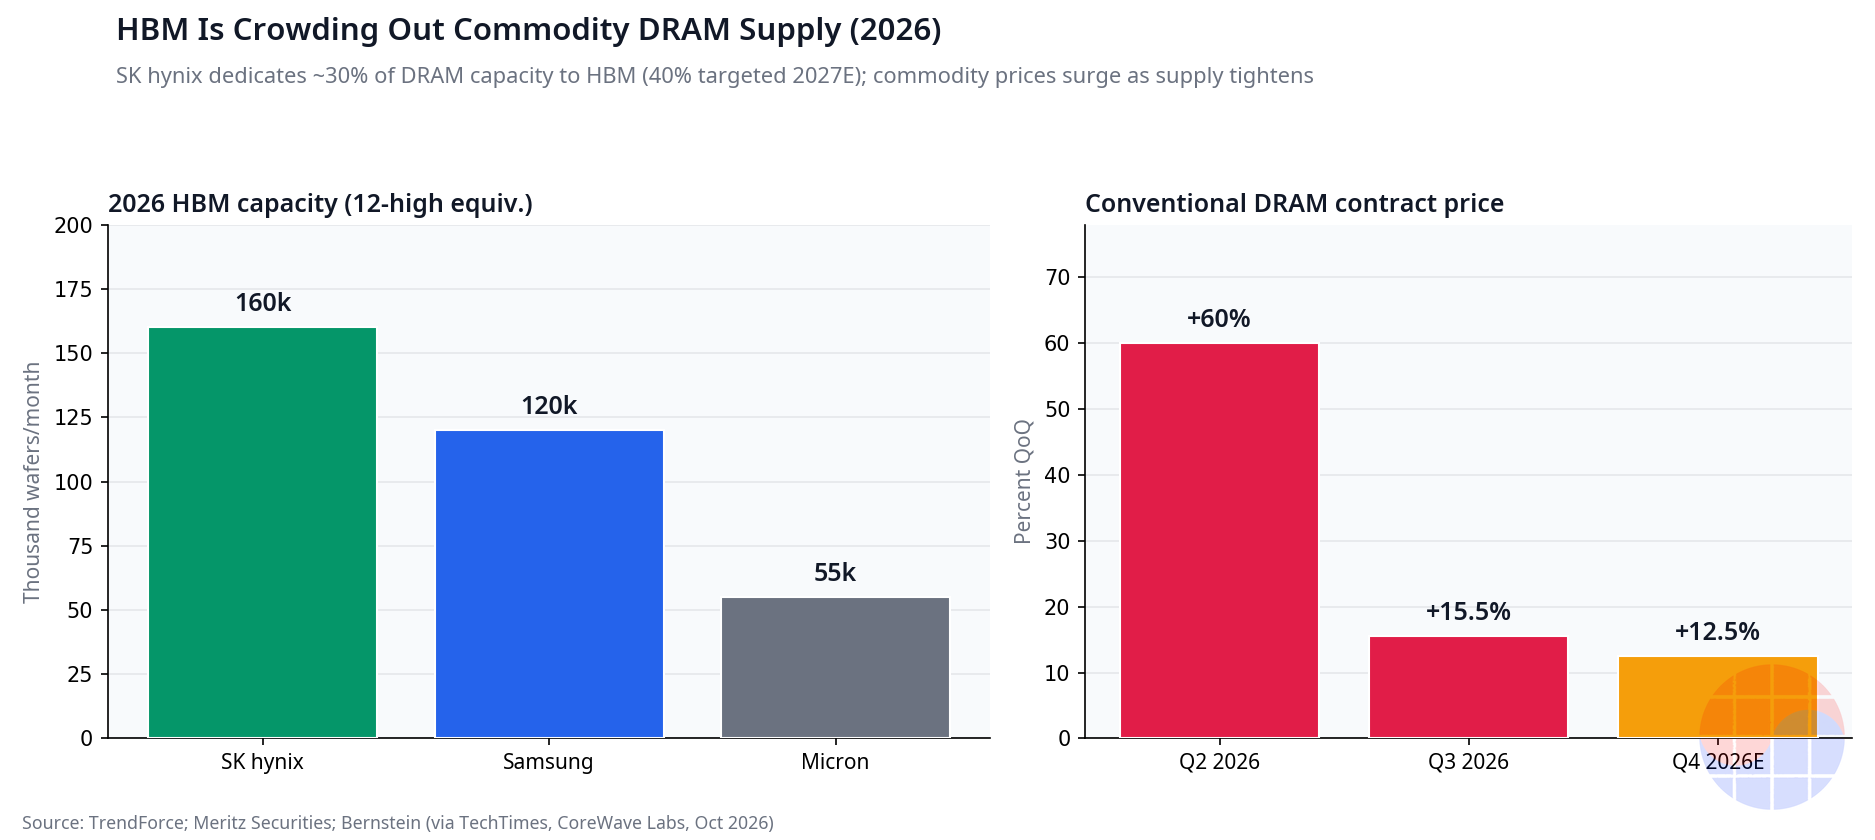
Esse é o crowding-out: a IA não está "aproveitando" a ociosidade do PC; ela está expulsando o commodity das fabs avançadas. Os dados públicos de mix de produto dos três grandes de memória apontam na mesma direção em outubro de 2026: a fatia HBM da produção de bits cresce trimestre após trimestre, enquanto o investimento incremental se concentra de forma desproporcional em capacidade habilitada para HBM. O commodity recebe manutenção — não expansão.
Disciplina do fornecedor: menos commodity, preço maior, cliente por nível
O colapso de 2023–2024 mudou o DNA da indústria de memória. Os três grandes aprenderam, a um custo brutal, que inundar o mercado de commodity destrói a margem de todos. Em 2026, operam como o que são: um oligopólio disciplinado.
Quatro movimentos, todos visíveis em 14 de outubro de 2026:
- Corte de exposição ao commodity. O capex prioriza capacidade HBM e nós avançados; linhas de commodity são mantidas, não ampliadas.
- Preços de contrato em alta. As referências públicas de preço de contrato de DRAM exibem trajetória ascendente ao longo de 2026, com fornecedores empurrando reajustes trimestre a trimestre.
- LTA renegociados para cima. Os contratos de longo prazo (LTA, long-term agreements) — o instrumento com que grandes compradores travavam volume e preço — estão sendo renovados em termos mais duros: preços maiores, durações favoráveis ao vendedor e cláusulas de volume mais rígidas.
- Priorização de clientes (tiering). A alocação de suprimento privilegia compradores de IA — hiperescaladores e fabricantes de aceleradores — enquanto compradores tradicionais de commodity negociam em posição mais fraca.
O efeito líquido: preços mais altos e mais rígidos para baixo. O ciclo de memória de 2026 não se parece com os de 2018 ou 2021; a oferta está gerenciada.
Quem paga: a corrida do capex rumo ao trilhão anual
A outra metade da história está na demanda. Somando as projeções públicas de capex dos grandes hiperescaladores e construtores de infraestrutura de IA, o gasto agregado caminha para a faixa de US$ 1 trilhão ao ano no fim de 2026 — número sem precedente na história da infraestrutura tecnológica.
O financiamento mistura geração de caixa operacional, emissão de dívida corporativa, estruturas de SPV e veículos fora do balanço. E surge a pergunta que o mercado de crédito começou a fazer: quem absorve de fato o risco se a construção correr à frente da receita? Os spreads de crédito dos emissores mais expostos à construção de IA e as referências de CDS passaram a discriminar, em outubro de 2026, entre balanços capazes de atravessar o ciclo e balanços que estão apostando o próprio balanço.
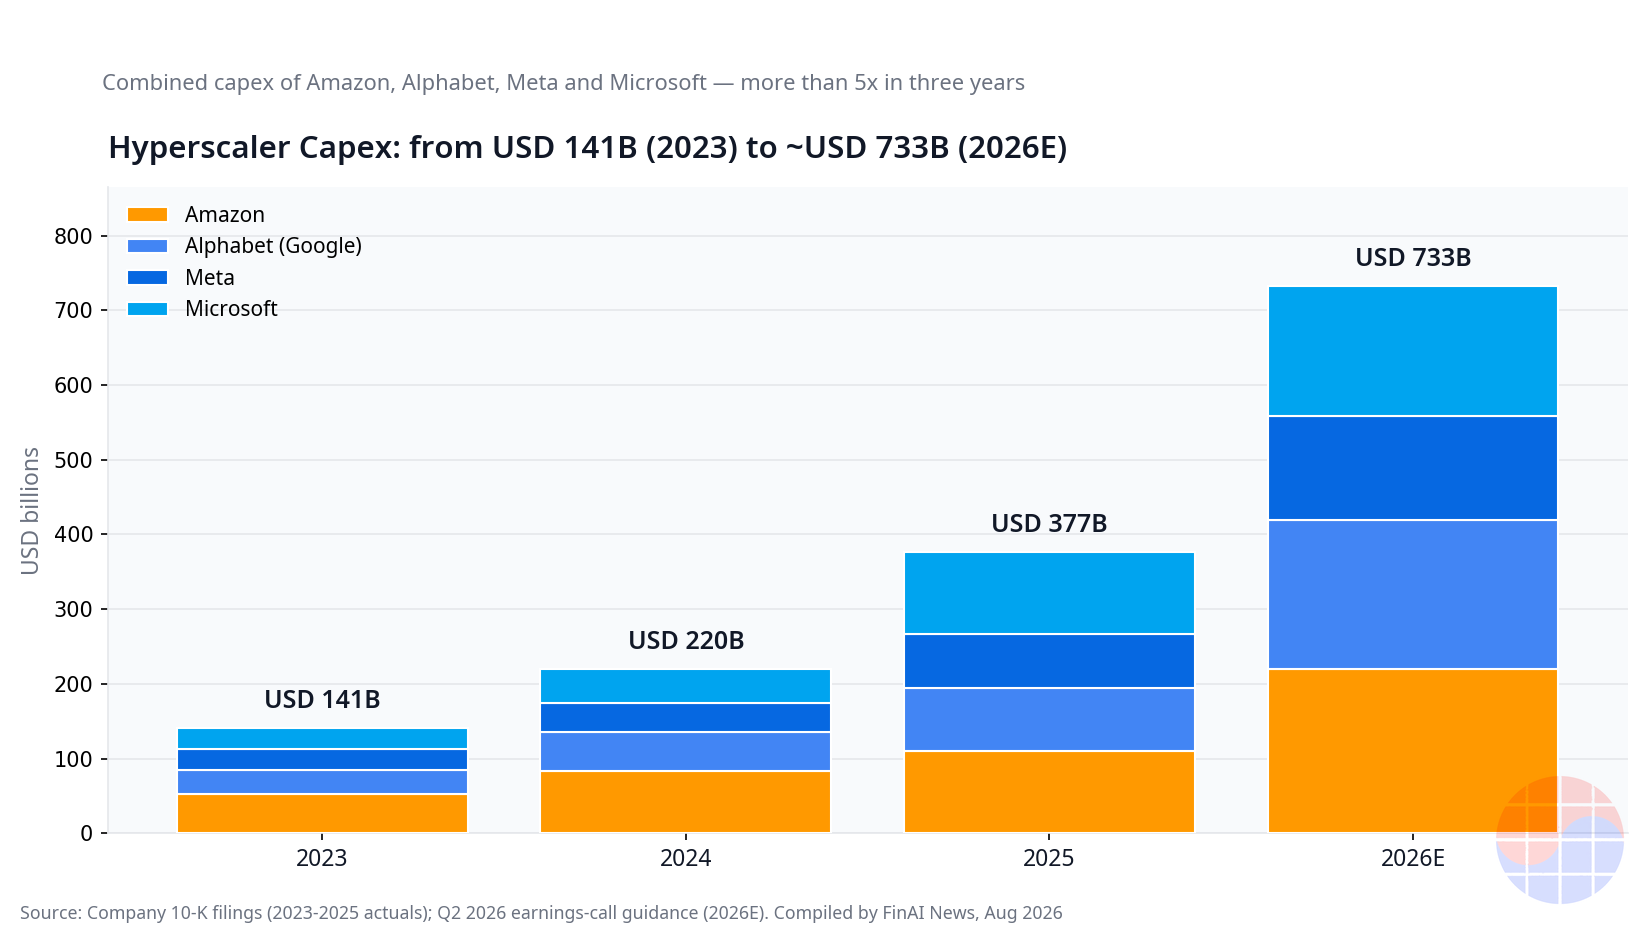
Para os fornecedores de memória, a dinâmica é relativamente benigna: eles vendem as picaretas (HBM) com preços protegidos por LTA. O risco de sobreconstrução recai sobre compradores e construtores. Para o investidor, a leitura é direta: na cadeia de valor da IA, a memória com liderança em HBM é o elo de oferta com a melhor relação risco-retorno.
O paradoxo de Jevons dos tokens
Falta a peça que explica por que a demanda por HBM não se esgota mesmo com a inferência barateando. Nos últimos dois anos, o custo por token despencou — ganhos de eficiência dos modelos, concorrência entre provedores, otimização de infraestrutura. A intuição diria: token mais barato, menos gasto com computação. A economia diz o contrário: quando um insumo barateia, seu uso se expande mais que proporcionalmente.
Tokens baratos viabilizam casos de uso antes impossíveis — agentes autônomos, inferência sempre ativa, vídeo gerado em escala — e cada um deles demanda mais aceleradores; cada acelerador, mais HBM. É o paradoxo de Jevons aplicado aos tokens: quanto mais barato o token, mais valiosa a computação, mais sustentada a demanda por memória de alta largura de banda. As narrativas de "pico da demanda de IA" erram o mecanismo: confundem preço unitário com gasto agregado.
Chase's Take
Isto não é uma história de demanda; é uma história de oferta com fosso estrutural. Três vantagens compõem o fosso, e nenhuma se improvisa:
Primeiro, o HBM é um fosso composto: processo DRAM avançado mais TSV mais empilhamento de precisão mais encapsulamento avançado mais qualificação junto ao cliente. Cada camada filtra concorrentes; a combinação os elimina. Não se compra com dinheiro rápido.
Segundo, o oligopólio aprendeu disciplina. O trauma de 2023–2024 ensinou os três grandes a cortar antes de inundar. Essa memória institucional — literalmente — é o que mantém os preços de contrato firmes em 2026 apesar da fraqueza do PC.
Terceiro, a pilha de clientes se inverteu. Há uma década, o OEM de PC ditava condições; hoje o hiperescalador implora por alocação de HBM. Quando o cliente com mais dinheiro é o que tem menos poder, o poder de precificação vive na oferta.
Para a Coreia, a leitura é duplamente favorável. A Samsung traz a amplitude do IDM — DRAM, NAND, foundry e encapsulamento sob o mesmo teto — e a SK hynix traz a melhor execução em HBM da indústria. São, em outubro de 2026, os dois nomes de memória mais bem posicionados do mundo para este ciclo. E atrás deles, o ecossistema doméstico de equipamentos e materiais — teste, manuseio de wafers adelgaçados, TSV, materiais avançados — surfa a mesma onda de capex do HBM.
O risco existe e precisa ser nomeado: se o capex de IA parasse de repente, o prêmio do HBM se comprimiria. Mas os LTA e o tiering de clientes adiam e amortecem esse cenário de um jeito que o ciclo de 2023 não tinha. A correção, se vier, tende a ser mais curta e menos profunda.
Implicações
Para investidores
- Prefira fornecedores de memória com liderança em HBM a compradores de commodity. O poder de precificação está na oferta.
- Monitore três sinais: direção dos preços de contrato de DRAM, duração e preço dos LTA renovados, e o mix de bits HBM na produção dos grandes. São os indicadores antecedentes do ciclo.
- A pergunta "quem paga" é uma pergunta de crédito. Subpondere os construtores de IA mais alavancados ou exija compensação em spread; spreads de crédito e referências de CDS são o termômetro da sustentabilidade do capex.
- Não confunda PC fraco com memória fraca. São ciclos distintos desde 2024; o PC fraco até reforça o pricing do commodity ao enfraquecer o comprador.
Para a Coreia e seus players
- Samsung e SK hynix capturam tanto o poder de precificação do commodity quanto o prêmio de mix do HBM — a melhor combinação possível do ciclo.
- O ecossistema doméstico de equipamentos e materiais — teste de HBM, TSV, materiais avançados — recebe um vento de cauda direto e sustentado.
- Ângulo de política industrial: a memória segue sendo a alavanca estratégica da Coreia na pilha de IA. Todo acelerador do mundo carrega memória coreana; essa é uma posição de negociação que transcende o ciclo.
Perguntas frequentes
A queda do PC libera capacidade para a IA? Não. Ela libera wafers de nó maduro com especificação de commodity (DDR4, NAND inicial), que não podem virar HBM: faltam ferramentas, processos de TSV, empilhamento de precisão e qualificação. É o silício errado. O que a queda do PC faz é enfraquecer o comprador tradicional de commodity na mesa de negociação.
O que é o crowding-out do HBM e por que ele importa para os preços? Cada pilha HBM4 de 12-high usa 12 dies de 24 Gb (288 Gb por pilha) mais TSV, base die e encapsulamento avançado, com perdas de rendimento a cada etapa. Por bit entregue, o HBM consome múltiplos dos recursos de fab que a DRAM commodity. Como a capacidade de fab é finita, o crescimento do HBM limita mecanicamente o crescimento da oferta de commodity — e essa restrição sustenta os preços.
O que são LTA e tiering de clientes? LTA (long-term agreements) são contratos plurianuais de volume e preço entre fornecedores de memória e grandes compradores. Em 2026 estão sendo renovados para cima, em condições mais duras para o comprador. Tiering é a alocação prioritária de suprimento: compradores de IA (hiperescaladores, fabricantes de aceleradores) têm preferência; o restante negocia com menos poder.
Quem paga a construção da IA e como o mercado de crédito mostra isso? O capex agregado de IA caminha para US$ 1 trilhão ao ano no fim de 2026, financiado por caixa, dívida e estruturas de SPV. O mercado de crédito — spreads de emissores expostos e referências de CDS — passou a discriminar quais balanços absorvem o ciclo. Fornecedores de memória estão relativamente isolados porque vendem com LTA; o risco de sobreconstrução recai sobre compradores e construtores.
Nota: análise baseada em dados públicos e estimativas da indústria em 14 de outubro de 2026; termos contratuais específicos e números internos de capex não são integralmente divulgados, de modo que as projeções devem ser lidas como direcionais.


