 VLSI Korea
Análise aprofundada da parceria Samsung e Mistral AI: IA on-premise dentro da fab (HBM, yield de foundry)
A Samsung liderou a Série D de 3 bilhões de euros da Mistral em 8 de setembro de 2026. A IA on-premise entra na fab para dados, defeitos e rendimento (yield) em HBM e lógica, sem retirar dados de processo.


Análise aprofundada da parceria Samsung e Mistral AI: IA on-premise dentro da fab (HBM, yield de foundry)
A conclusão é direta: a Samsung não compra apenas um modelo de IA, compra uma camada de inteligência que precisa operar dentro da fab sem que nenhum dado sensível de processo saia da sua infraestrutura.
Resumo em 30 segundos
- Em 8 de setembro de 2026, no Palácio do Eliseu, durante a cúpula Coreia-França, a Samsung Electronics anunciou que liderava a rodada Série D da Mistral AI, segundo o anúncio conjunto das duas empresas de 8 de setembro de 2026.
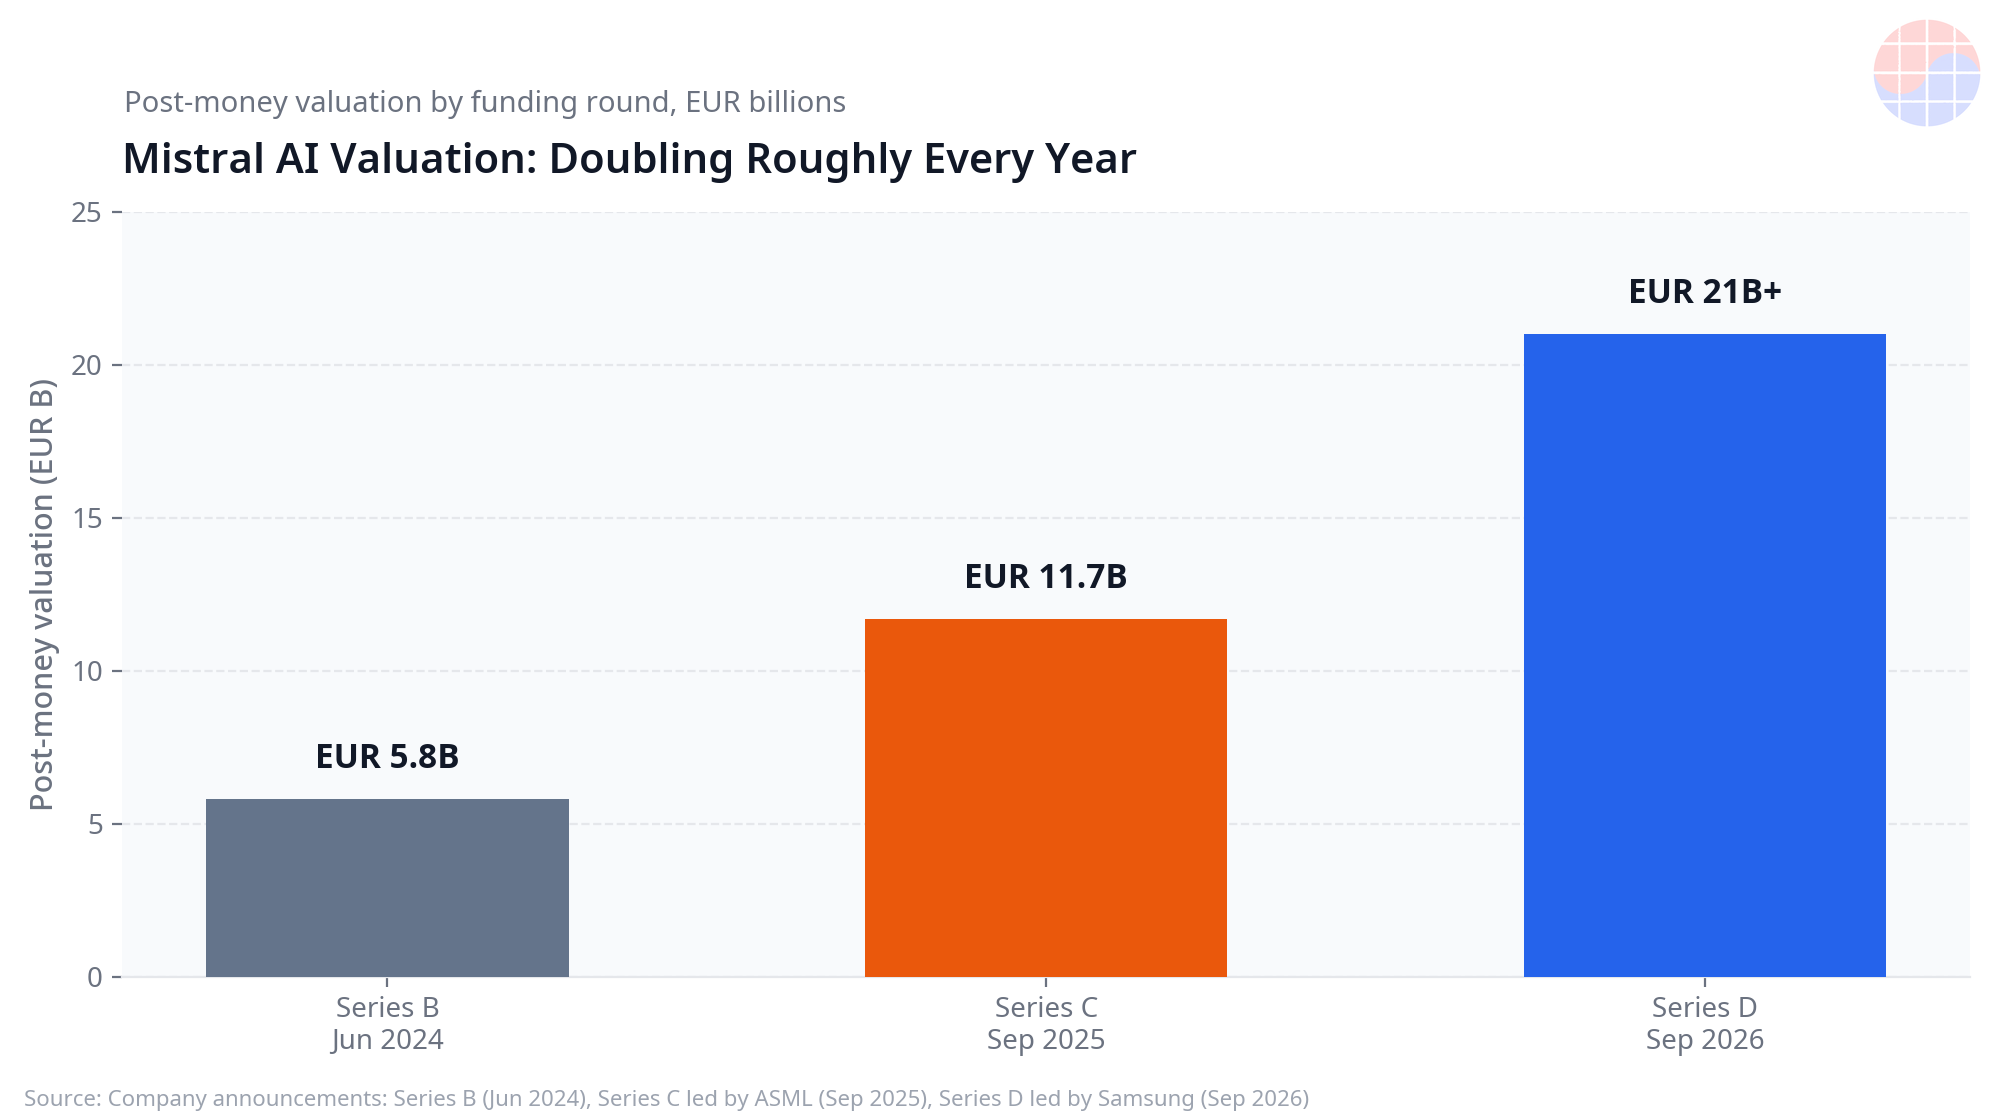
- A Série D somou 3 bilhões de euros, com avaliação post-money acima de 21 bilhões de euros, a maior captação de capital de uma empresa de tecnologia europeia até aquela data, segundo o anúncio da Mistral de 8 de setembro de 2026.
- A parceria integra os serviços da Mistral, incluindo o modelo principal Mistral Large, nas operações da divisão DS de semicondutores da Samsung, segundo o anúncio da Samsung de 8 de setembro de 2026.
- A implantação será on-premise e personalizada: análise de dados, previsão e detecção de defeitos e otimização de processos e equipamentos, com o objetivo de encurtar ciclos de projeto e estabilizar o rendimento (yield) em memória avançada e lógica, segundo o anúncio da Samsung de 8 de setembro de 2026.
- Ainda não existe nenhum ganho de rendimento (yield) verificado publicamente: o valor econômico potencial é enorme no cálculo ilustrativo da VLSI Korea, mas o resultado operacional ainda precisa ser demonstrado, segundo a revisão da VLSI Korea de 21 de outubro de 2026.
Contexto: por que o acordo foi anunciado em uma cúpula
O anúncio não foi feito em uma feira de semicondutores. Foi feito em 8 de setembro de 2026 no Eliseu, no contexto da cúpula entre Coreia do Sul e França, segundo o anúncio da Samsung de 8 de setembro de 2026. Esse detalhe importa porque coloca a operação em três planos ao mesmo tempo: industrial, tecnológico e geopolítico. Para a França, a Mistral é a campeã europeia de modelos de linguagem. Para a Coreia, a Samsung é a maior fabricante de memória do mundo e um dos dois atores relevantes em lógica avançada. Reunir as duas em uma mesma foto oficial transforma um contrato comercial em um sinal estratégico.
A trajetória de avaliação ajuda a entender a ambição. Em junho de 2024, a Série B avaliou a Mistral em 5,8 bilhões de euros, segundo os dados da empresa citados em seu anúncio de 8 de setembro de 2026. Em setembro de 2025, a Série C, liderada pela ASML com 1,7 bilhão de euros, elevou a avaliação para 11,7 bilhões de euros, segundo o anúncio da empresa de setembro de 2025. Em 8 de setembro de 2026, a Série D levou esse número para acima de 21 bilhões de euros, segundo o anúncio da Mistral de 8 de setembro de 2026. Em pouco mais de dois anos, a avaliação multiplicou por mais de 3,6 vezes.
A Samsung não atuou sozinha na rodada. A Série D contou com o Scaleup Europe Fund, gerido pela EQT, e a PSG Equity como colíderes, e com Advent, fundos geridos pela BlackRock e o Grão-Ducado de Luxemburgo como novos investidores, além da participação renovada de investidores existentes como ASML e NVIDIA, segundo o anúncio da Mistral de 8 de setembro de 2026. O valor concreto investido pela Samsung não foi revelado, segundo o anúncio da Samsung de 8 de setembro de 2026. Algumas reportagens na Coreia situaram esse valor abaixo de um trilhão de wons, mas esse número só pode ser citado como informação de imprensa, não como dado confirmado pela empresa, segundo a revisão da VLSI Korea de 21 de outubro de 2026.
O precedente da ASML é a peça que dá credibilidade industrial ao movimento. A ASML liderou a Série C em setembro de 2025 e já colaborava com a Mistral em inteligência artificial para pesquisa e desenvolvimento, engenharia e operações, segundo o anúncio da Série C de setembro de 2025. Primeiro entrou a fabricante de equipamentos de litografia EUV. Depois entrou a fabricante de chips. A sequência sugere que a Mistral não busca apenas clientes de software empresarial, mas posições dentro da cadeia de suprimentos de semicondutores, da máquina de litografia até a fab.
Análise aprofundada 1: o que on-premise realmente significa dentro de uma fab
Na maioria das empresas, usar um LLM significa enviar documentos para uma nuvem externa. Em uma fab avançada, essa lógica se rompe. Os dados de processo contêm receitas, parâmetros de equipamentos, mapas de defeitos, correlações entre etapas e resultados de rendimento (yield). Em conjunto, esses dados descrevem como são fabricados chips de HBM e de lógica que valem milhares de dólares por wafer. Retirá-los do perímetro, mesmo sob contrato, cria um risco de vazamento que nenhuma cláusula elimina por completo.
Por isso, o centro do acordo anunciado em 8 de setembro de 2026 não é o Mistral Large em si, mas o desenvolvimento conjunto de modelos on-premise personalizados para os dados da divisão DS da Samsung, segundo o anúncio da Samsung de 8 de setembro de 2026. On-premise significa que o modelo roda dentro da infraestrutura da Samsung. Os dados sensíveis de tecnologia e operações são processados apenas dentro desse limite, sem transmissão para uma nuvem externa, segundo o anúncio da Samsung de 8 de setembro de 2026.
Essa decisão tem um custo deliberado. Um modelo on-premise não se atualiza com a mesma facilidade de um serviço em nuvem. Exige infraestrutura própria de GPU, controle de versões, avaliação interna, gestão de segurança e equipes que mantenham a plataforma funcionando todos os dias. A Samsung aceita esse ônus operacional em troca de controle, segundo a análise da VLSI Korea de 21 de outubro de 2026. Em uma indústria em que uma única receita de processo pode sustentar uma vantagem de anos, essa troca faz sentido.
Também muda o tipo de fornecedor que a Mistral precisa ser. Não basta oferecer uma API. É preciso entregar modelos que possam se adaptar à documentação interna, aos registros de equipamentos, aos históricos de manutenção e às bases de conhecimento de engenharia, mantendo rastreabilidade e permissões. Esse trabalho se parece mais com uma plataforma de dados e engenharia do que com um chatbot generalista, segundo a análise da VLSI Korea de 21 de outubro de 2026.
Análise aprofundada 2: onde o LLM pode gerar valor e onde não pode
O anúncio de 8 de setembro de 2026 identifica três famílias de aplicação: análise de dados, previsão e detecção de defeitos e otimização de processos e equipamentos, segundo o anúncio da Samsung de 8 de setembro de 2026. Os objetivos declarados são reduzir os ciclos de projeto, melhorar a precisão e a qualidade de fabricação e estabilizar o rendimento (yield) em memória avançada e lógica, segundo o mesmo anúncio.
Convém separar as camadas. A classificação de imagens de defeitos, a inspeção de defeitos e a metrologia já usam modelos de visão especializados, treinados para padrões visuais muito concretos. Um LLM não substitui naturalmente esses modelos. Sua força está em outra camada: unir fontes dispersas, resumir registros, buscar precedentes na documentação, gerar hipóteses, preparar relatórios e atuar como interface de agentes que consultam ferramentas de análise, segundo a análise da VLSI Korea de 21 de outubro de 2026.
Um exemplo prático ajuda a enxergar. Quando o rendimento (yield) cai em um lote, o problema raramente vive em um único gráfico. Pode estar em uma deriva de um equipamento de deposição, em uma mudança de fotorresiste, em uma variação térmica da sala limpa ou em uma interação entre corrosão (etching) e deposição que só aparece ao cruzar várias semanas de dados. Um sistema baseado em LLM, conectado às bases internas, pode acelerar a busca do padrão e a redação da análise, embora a verificação final continue sendo trabalho de engenheiros de processo e de equipes de verificação, segundo a análise da VLSI Korea de 21 de outubro de 2026.
No projeto, a lógica é semelhante. A síntese, o posicionamento e roteamento, o STA e a verificação geram documentação, registros de erros e conhecimento repetido entre projetos. Um modelo adaptado ao domínio pode reduzir o tempo que os engenheiros gastam buscando informação e preparando material, sem substituir as ferramentas de EDA nem as regras de projeto do PDK, segundo a análise da VLSI Korea de 21 de outubro de 2026. O responsável pela divisão DS, Jeon Young-hyun, observou no anúncio de 8 de setembro de 2026 que a crescente complexidade do projeto e da fabricação de chips de IA exige inovação contínua, segundo a citação registrada no anúncio da Samsung.
| Camada de aplicação | Função principal | Papel plausível do LLM | Limite |
|---|---|---|---|
| Dados da fab | Unir registros de equipamentos, processo e qualidade | Busca, resumo e correlação orientada | Depende da qualidade e do acesso aos dados |
| Defeitos | Previsão e detecção de defeitos | Triagem, explicação e relatórios sobre modelos de visão | Não substitui a visão especializada |
| Processo e equipamentos | Otimização de parâmetros e manutenção | Hipóteses, precedentes e planos de análise | Toda recomendação exige validação na fab |
| Projeto | Documentação e conhecimento de engenharia | Assistência em EDA, registros e verificação | Não substitui STA nem regras do PDK |
Fonte: aplicações citadas no anúncio da Samsung de 8 de setembro de 2026 e classificação da VLSI Korea de 21 de outubro de 2026.
Análise aprofundada 3: a economia de um ponto percentual de rendimento
A razão pela qual as empresas aceitam projetos longos de IA na fab se entende com uma única operação. Em memória avançada e em foundry, o rendimento (yield) converte diretamente capacidade em receita. Se uma linha produz mais chips bons por wafer, vende mais sem construir outra fab. Se perde um ponto percentual, perde produto vendável todos os meses.
A VLSI Korea propõe um cálculo ilustrativo, não uma previsão da Samsung, com premissas explícitas: preço médio de 9.000 dólares por wafer, produção mensal constante e um ponto percentual de rendimento (yield) aplicado sobre o valor dessa produção durante doze meses, segundo o cálculo da VLSI Korea de 21 de outubro de 2026. Com 50.000 wafers por mês, um ponto equivale a cerca de 54 milhões de dólares por ano. Com 100.000 wafers por mês, equivale a cerca de 108 milhões de dólares por ano. Com 150.000 wafers por mês, equivale a cerca de 162 milhões de dólares por ano.
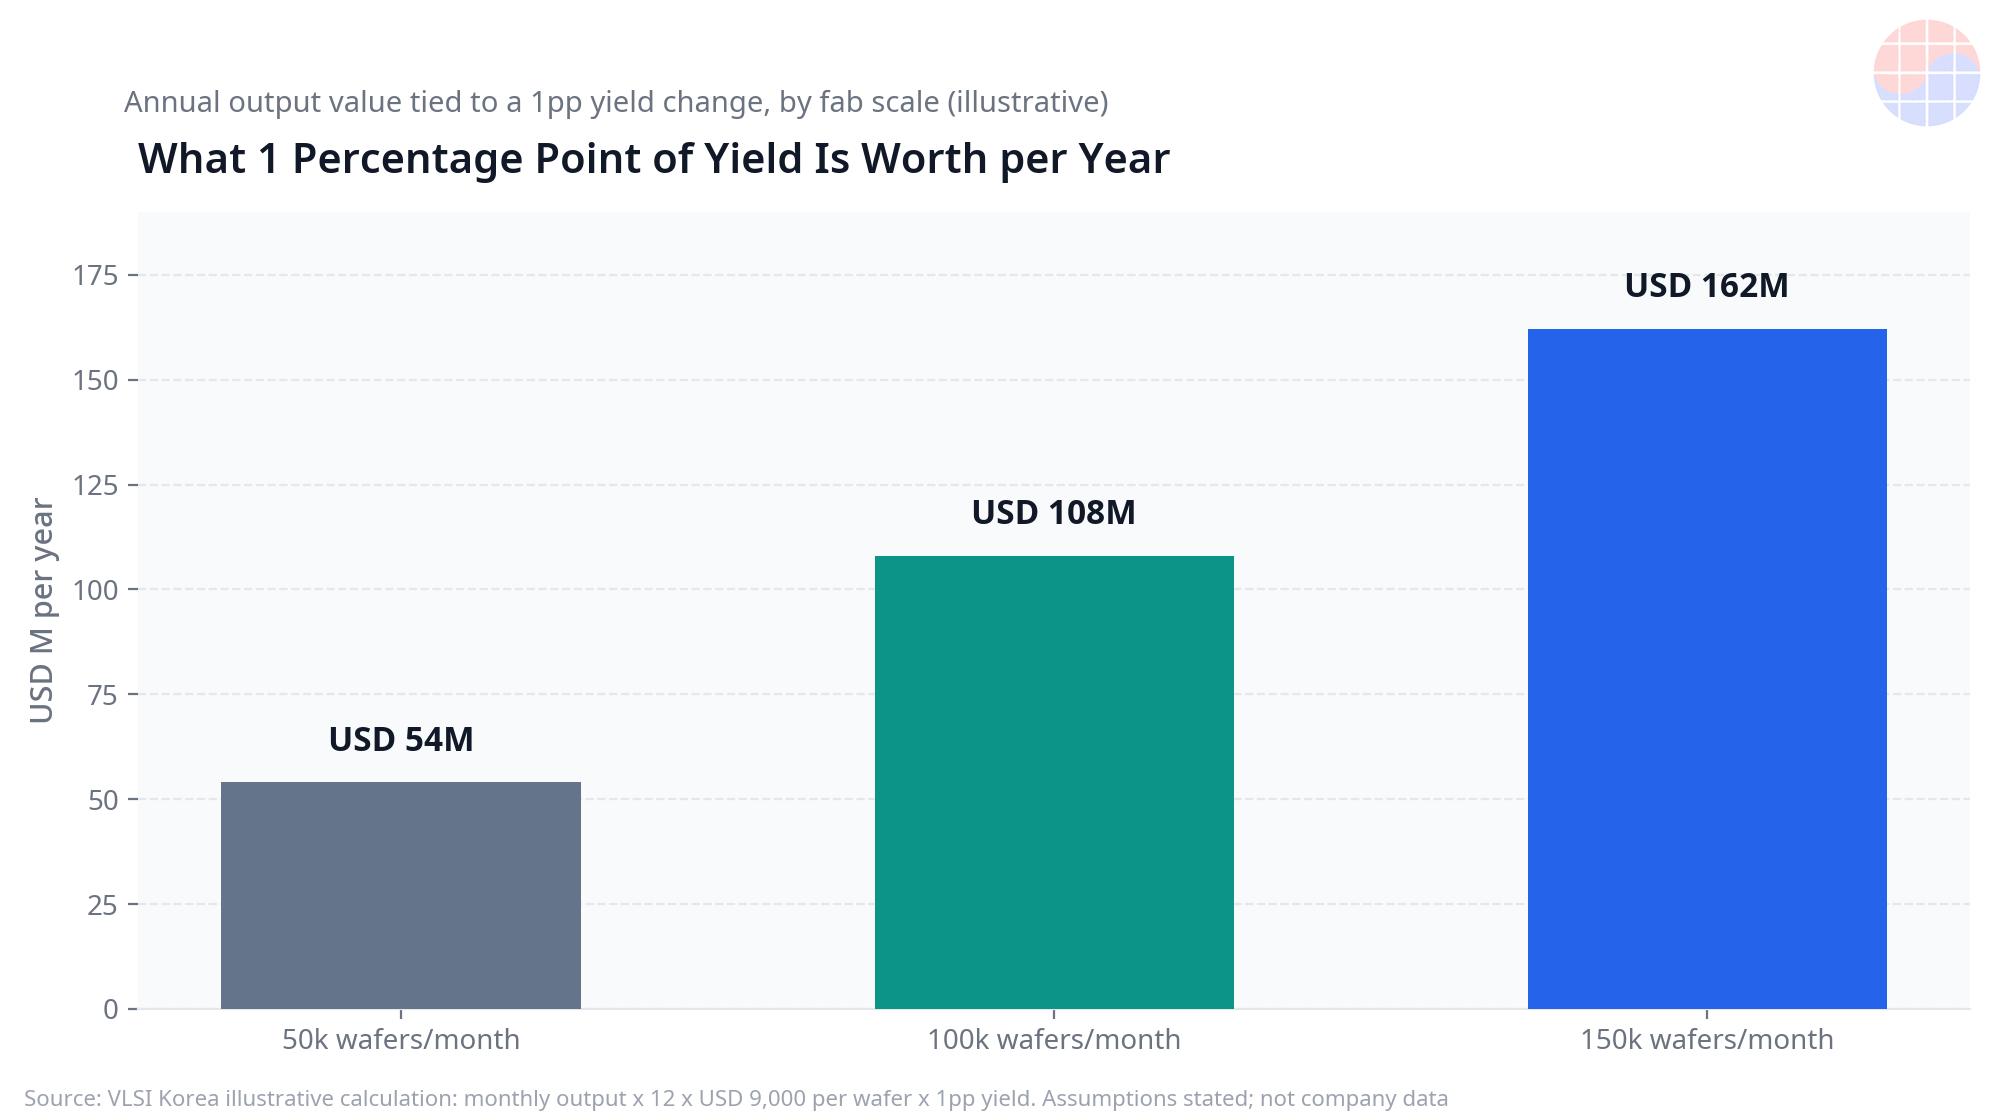
| Produção mensal | Premissa por wafer | Valor anual de 1 ponto de rendimento (yield) |
|---|---|---|
| 50.000 wafers | 9.000 USD | 54 milhões USD |
| 100.000 wafers | 9.000 USD | 108 milhões USD |
| 150.000 wafers | 9.000 USD | 162 milhões USD |
Fonte: cálculo ilustrativo da VLSI Korea de 21 de outubro de 2026. Premissas: 12 meses, 9.000 USD por wafer e 1 ponto percentual. Não é um número divulgado pela Samsung.
Essa aritmética explica a paciência estratégica. Mesmo uma melhoria pequena e sustentada em HBM, em que o encapsulamento avançado, o interposer e o substrato adicionam etapas e custo, pode pagar uma plataforma completa de IA. Também explica o ceticismo necessário: como o prêmio é tão grande, qualquer afirmação de melhoria deve exigir uma linha de base, um período de medição e uma atribuição clara entre o modelo, o processo e outras mudanças simultâneas, segundo a análise da VLSI Korea de 21 de outubro de 2026. Até 21 de outubro de 2026, nenhuma das duas empresas publicou um ganho de rendimento (yield) verificado atribuível a esta parceria, segundo a revisão da VLSI Korea.
O efeito não se limita à margem bruta. Um rendimento (yield) mais estável reduz a incerteza de entrega, melhora o planejamento de capacidade e ajuda a negociar com clientes de foundry que precisam de previsibilidade. Em HBM, em que a demanda por acelerador de IA mantém pressão sobre a cadeia de suprimentos, a estabilidade pode valer tanto quanto o pico de produção, segundo a análise da VLSI Korea de 21 de outubro de 2026.
Análise aprofundada 4: os limites que o anúncio não resolve
O primeiro limite é a evidência. A parceria anunciada em 8 de setembro de 2026 é uma declaração de direção e um investimento, não um resultado operacional, segundo o anúncio da Samsung de 8 de setembro de 2026. Ainda não há uma métrica pública de redução de defeitos, de tempo de ciclo ou de estabilização de rendimento (yield) que um terceiro possa auditar.
O segundo limite é a arquitetura técnica. Como observado, o LLM precisa conviver com modelos de visão para inspeção de defeitos, com sistemas de controle de equipamentos e com ferramentas estatísticas de processo que já existem. O valor aparecerá na integração, não na substituição, segundo a análise da VLSI Korea de 21 de outubro de 2026. Integrar em uma fab real, com permissões, latência e requisitos de sala limpa, é mais lento do que demonstrar um protótipo.
O terceiro limite é operacional. O modelo on-premise protege os dados, mas transfere para a Samsung o ônus de infraestrutura, atualização e segurança, segundo a análise da VLSI Korea de 21 de outubro de 2026. Cada melhoria do modelo base precisa ser avaliada novamente antes de entrar em um ambiente que afeta a produção. Esse atrito é o preço da soberania de dados.
O quarto limite diz respeito aos números de tração da Mistral. A empresa declara mais de 125 clientes empresariais em 20 países, com nomes como Airbus, ASML e HSBC, e receita recorrente anual acima de 400 milhões de dólares em fevereiro de 2026, com a meta de alcançar 1 bilhão até o final de 2026, segundo declarações da própria empresa registradas em 8 de setembro de 2026. São números autodeclarados, não auditados, e devem ser lidos como tal, segundo a revisão da VLSI Korea de 21 de outubro de 2026. Isso não os invalida, mas impede tratá-los como resultados verificados.
Chase's Take
Minha leitura é que a Samsung está comprando uma opção sobre a camada de conhecimento da sua própria fab. O ativo escasso não é apenas o modelo. É a combinação de dados de processo que nenhum concorrente pode copiar, engenheiros que sabem quais perguntas fazer e um modelo que vive dentro do perímetro onde esses dados podem ser usados sem medo. Se essa combinação funcionar, a vantagem não se mede apenas em rendimento (yield). Mede-se em velocidade de aprendizado: cada excursão de processo, cada lote difícil e cada ajuste de equipamento deixam uma memória institucional que a próxima equipe pode consultar.
Mas eu ainda não compraria a narrativa de uma fab autônoma. A fab real continuará dependendo de modelos de visão especializados, de controle estatístico, de EDA e de engenheiros que assinam decisões com consequências de milhões de dólares. O LLM que importa aqui é aquele que reduz o tempo entre um sinal fraco e uma hipótese testável. Esse é um objetivo menos espetacular e muito mais valioso.
Também vejo uma lição para o resto da indústria. O debate sobre IA em semicondutores se concentrou em projetar chips para centros de dados. Este acordo desloca o foco para usar IA para fabricar esses chips. Nesse terreno, o vencedor não será necessariamente quem tiver o maior modelo, mas quem resolver melhor o acesso seguro aos dados, a integração com equipamentos e a medição honesta de resultados.
Implicações
- Para a Samsung, o sucesso deve ser medido com métricas públicas ou auditáveis em 12 a 24 meses: tempo de ciclo de projeto, taxa de defeitos e estabilidade do rendimento (yield) em memória avançada e lógica, segundo o marco de acompanhamento da VLSI Korea de 21 de outubro de 2026.
- Para a Mistral, a Samsung valida uma rota industrial on-premise mais exigente do que o software empresarial generalista, apoiada no precedente da ASML de setembro de 2025, segundo o anúncio da Série C.
- Para clientes de foundry e de HBM, maior estabilidade de rendimento (yield) significaria melhor previsibilidade de entrega, embora o acordo anunciado em 8 de setembro de 2026 não garanta por si só mais capacidade disponível.
- Para outras fabricantes de chips, a pressão se desloca para a soberania de dados: modelos potentes sem enviar dados de processo para fora da fab, segundo a análise da VLSI Korea de 21 de outubro de 2026.
- Para investidores, a avaliação acima de 21 bilhões de euros de 8 de setembro de 2026 já precifica execução: a Mistral precisa converter parcerias emblemáticas em receita recorrente verificável, segundo a revisão da VLSI Korea de 21 de outubro de 2026.
Nota: este artigo utiliza números de avaliação, clientes e receita recorrente autodeclarados pelas empresas em seus anúncios de 8 de setembro de 2026, e o cálculo de rendimento é uma ilustração da VLSI Korea com premissas explícitas, não uma previsão da Samsung.
Perguntas frequentes
Quando a parceria entre Samsung e Mistral AI foi anunciada e quem liderou o investimento?
A parceria foi anunciada em 8 de setembro de 2026 no Eliseu, durante a cúpula Coreia-França, e a Samsung Electronics liderou a rodada Série D da Mistral AI, segundo o anúncio conjunto de 8 de setembro de 2026.
Por que a implantação de IA da Samsung na fab é on-premise?
Porque os dados sensíveis de processo e de rendimento (yield) são processados apenas dentro da infraestrutura de semicondutores da Samsung, sem enviá-los para uma nuvem externa, segundo o anúncio da Samsung de 8 de setembro de 2026.
Quanto vale um ponto percentual de rendimento (yield) em uma fab grande?
No cálculo ilustrativo da VLSI Korea de 21 de outubro de 2026, com 100.000 wafers por mês e 9.000 dólares por wafer, um ponto percentual equivale a cerca de 108 milhões de dólares por ano.
Já foi demonstrada uma melhoria de rendimento (yield) graças à Mistral?
Não. Até 21 de outubro de 2026, nenhuma das duas empresas publicou um ganho de rendimento (yield) verificado e atribuível a esta parceria, segundo a revisão da VLSI Korea.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.


