 VLSI Korea
Toán học sản xuất Vera Rubin: 576 stack HBM4 trong mỗi rack, 300.000 wafer cho mỗi triệu GPU (TSMC, SK hynix, Samsung, Micron)
Vera Rubin đã sản xuất hàng loạt: một rack NVL72 dùng 576 stack HBM4 và ~21,5 wafer. Một triệu GPU cần ~300.000 wafer, và nút thắt năm 2027 là HBM4, không phải GPU.


Kết luận một dòng — Tốc độ sản xuất Vera Rubin được quyết định không phải bởi GPU, mà bởi bit HBM4. Trong một cấu trúc mà một rack tiêu thụ 576 stack HBM4 và hơn 21 tấm wafer, trần tăng trưởng năm 2027 được vẽ bởi wafer của các nhà sản xuất bộ nhớ.
Tóm tắt 30 giây
- Vào ngày 21 tháng 10 năm 2026, tại bài phát biểu chính GTC Berlin, CEO Jensen Huang tuyên bố Vera Rubin "hiện đã sản xuất hàng loạt toàn diện." Thời gian lắp ráp node giảm từ hai giờ với Grace Blackwell xuống dưới năm phút, và làm mát 100% bằng chất lỏng.
- Một rack NVL72 chứa 72 GPU Rubin, 36 CPU Vera và 576 stack HBM4 (20,7 TB = 165.888 Gb). Mỗi GPU, HBM4 gồm tám stack 12-high 36 GB, 288 GB (2.304 Gb).
- Khối lượng chỉ tồn tại dưới dạng ước tính. Kịch bản cơ sở hiện tại của thị trường là 5.000–7.000 rack trong nửa cuối 2026 (ước tính chuỗi cung ứng) và 11.000–21.000 rack trong năm 2027 (0,8–1,5 triệu GPU).
- Quy đổi sang wafer, một GPU tiêu thụ 0,037 wafer logic + 0,143 wafer CoWoS + 0,118 wafer DRAM HBM — tổng cộng khoảng 0,30 wafer. Một triệu GPU có nghĩa là khoảng 300.000 wafer.
- Kết luận nút thắt: thứ nhất, HBM4 (khối lượng 2026 về cơ bản đã được phân bổ hết, có báo cáo cắt giảm phân bổ, triển vọng giá hợp đồng 2027 tăng mạnh); thứ hai, CoWoS. Wafer logic và lắp ráp rack không phải là ràng buộc.
1. Tuyên bố Berlin — Sự kiện đã xác nhận trước tiên
Vào ngày 21 tháng 10 năm 2026, Jensen Huang giơ lên một node Vera Rubin tại bài phát biểu chính GTC Berlin và xác nhận ba điều. Thứ nhất, Vera Rubin hiện đã sản xuất hàng loạt toàn diện. Thứ hai, thời gian lắp ráp node đã giảm từ hai giờ ở thế hệ Grace Blackwell xuống dưới năm phút — kết quả của việc loại bỏ cáp và dây. Thứ ba, làm mát 100% bằng chất lỏng, tăng từ 80% bằng chất lỏng ở thế hệ trước, với nhiệt độ đầu vào chất làm mát 45°C.
Bản thân việc sản xuất không phải là tin mới. NVIDIA đã công bố bước vào sản xuất tại CES vào tháng 1 năm 2026, và thông cáo GTC Taipei ngày 31 tháng 5 đặt lịch giao hàng sản xuất vào mùa thu. Vào ngày 1 tháng 6, nhà vận hành cloud CoreWeave đã hoàn thành bring-up rack NVL72 đầu tiên và xác nhận vận hành trực tiếp. Điều Berlin xác nhận là "đang sản xuất" giờ có nghĩa là tăng trưởng toàn diện, không phải mẫu và đơn vị đầu tiên. Huang cũng lưu ý rằng 150 đối tác chuỗi cung ứng Đài Loan đứng sau Vera Rubin.
Bài viết này phân tích tuyên bố đó bằng con số: bao nhiêu hệ thống được xây dựng, những gì đi vào một rack và với số lượng bao nhiêu, khối lượng đó quy đổi thành wafer như thế nào, và công ty nào cung cấp gì, và bao nhiêu. Các con số từ công bố chính thức và báo cáo đều ghi nguồn; các con số suy ra bằng tính toán được ghi nhãn ước tính với các giả định được trình bày.
2. Giải phẫu một rack — Bên trong NVL72
Đơn vị bán hàng của Vera Rubin không phải là chip GPU mà là một rack. Một NVL72 gồm 18 khay tính toán và 9 khay switch NVLink, với 72 GPU được liên kết bởi fabric NVLink 6 thành một thứ hoạt động như một bộ tăng tốc khổng lồ duy nhất.
| Thành phần | Số lượng / Thông số | Ghi chú |
|---|---|---|
| GPU Rubin | 72 | 336B transistor mỗi GPU (hai die), TSMC 3nm |
| CPU Vera | 36 | Arm 88 lõi, NVLink-C2C tới GPU |
| HBM4 | 576 stack, 20,7 TB | 8 stack × 36 GB mỗi GPU |
| LPDDR5X (cho CPU) | Tối đa 54 TB | Tối đa 1,5 TB mỗi CPU, mô-đun SOCAMM2 (theo phân tích của công ty chứng khoán) |
| Fabric NVLink 6 | 260 TB/s mỗi rack | 3,6 TB/s mỗi GPU |
| Mạng | NIC ConnectX-9, DPU BlueField-4 | Scale-out qua Spectrum-X Ethernet |
| Làm mát | 100% bằng chất lỏng | Nhiệt độ đầu vào chất làm mát 45°C |
| Mức tiêu thụ điện năng | ~190–230 kW | Ước tính chuỗi cung ứng |
| Giá rack | $5M–$7,8M | Báo cáo tháng 3 năm 2026 và phân tích BOM của công ty chứng khoán |
Nguồn: Thông số NVL72 do NVIDIA công bố, tường thuật bài phát biểu chính GTC Berlin 2026 (21 tháng 10 năm 2026), phân tích danh mục vật tư (BOM) của công ty chứng khoán.
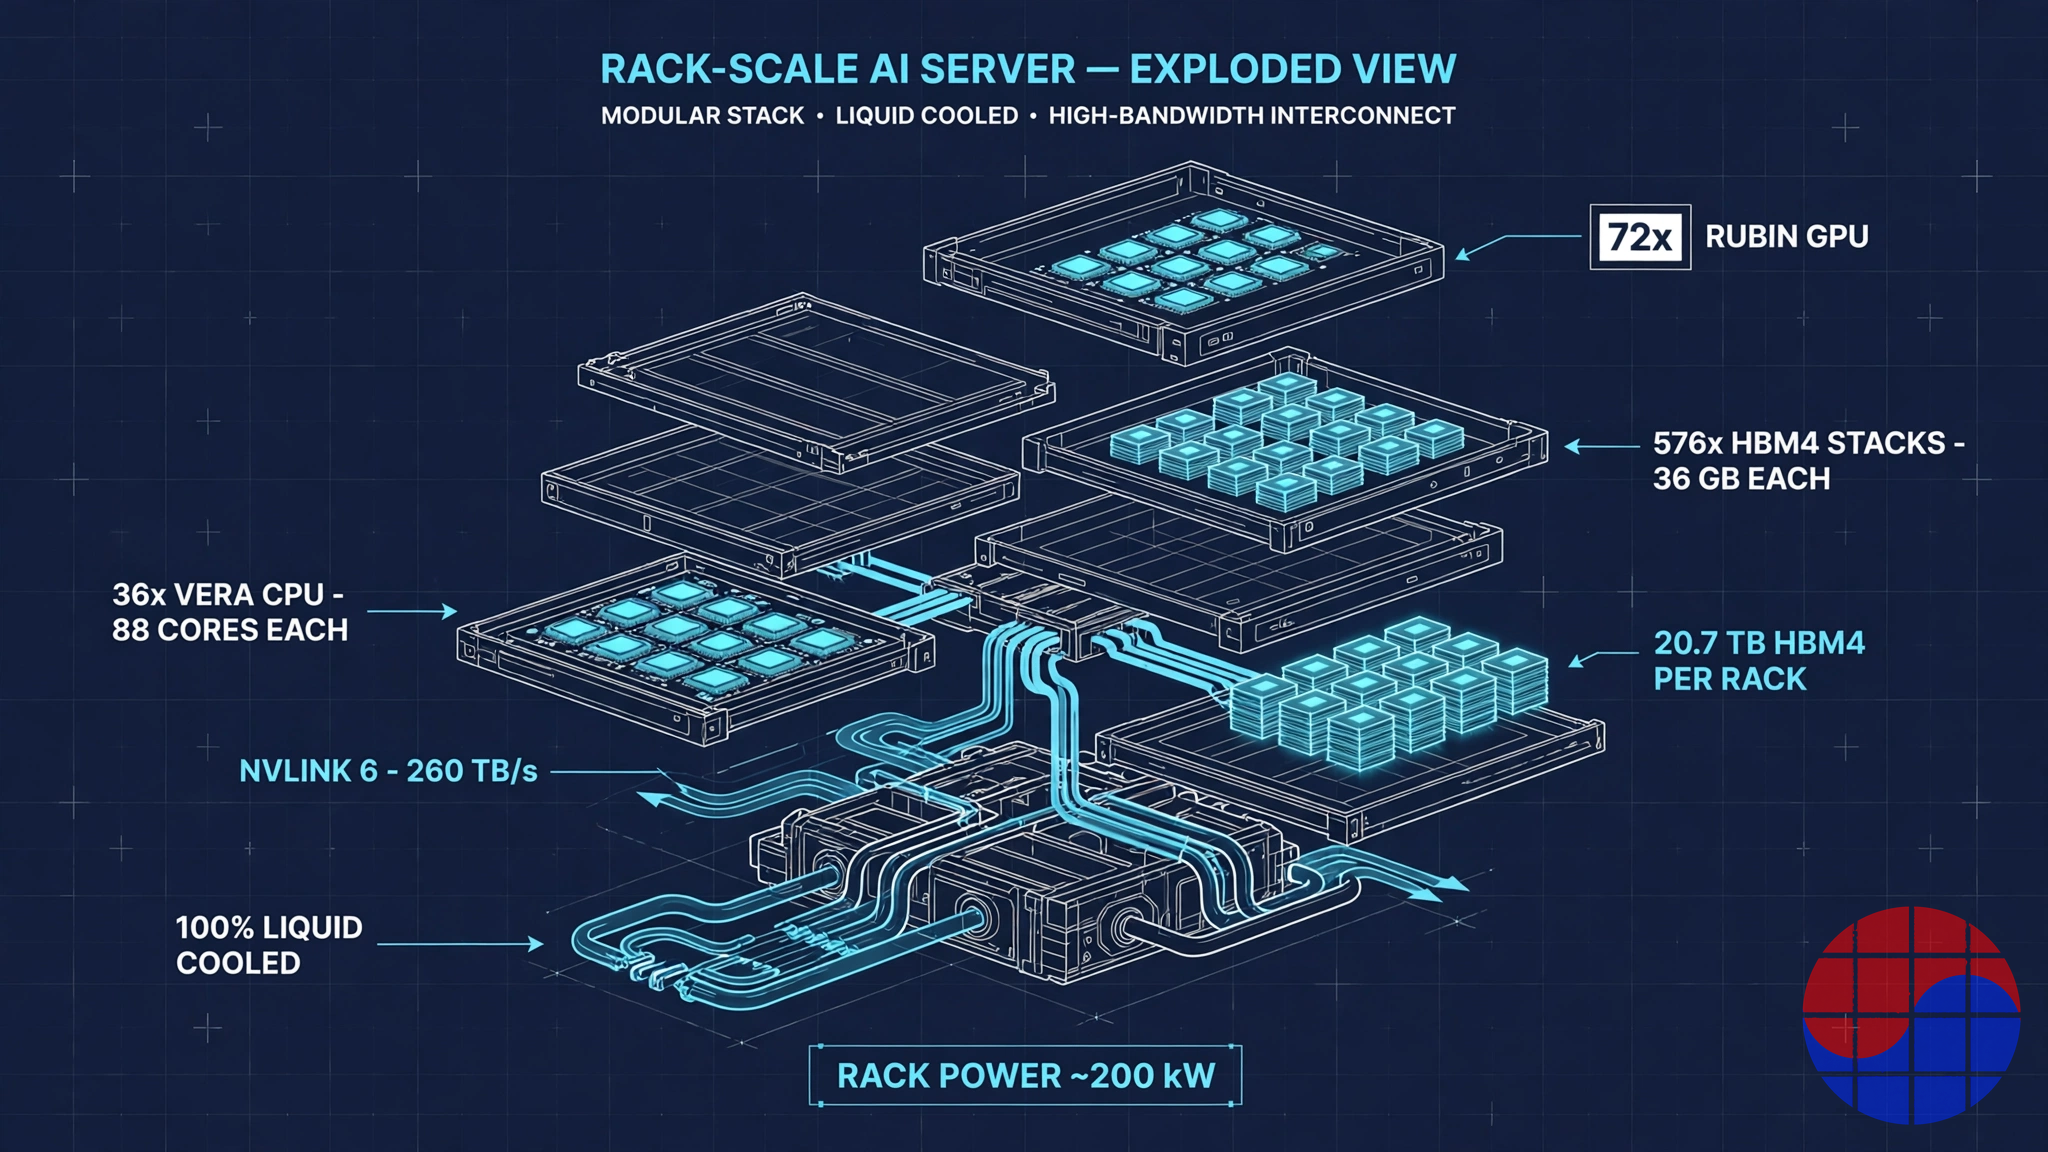
Giải phẫu một rack Vera Rubin NVL72 — 72 GPU và 576 stack HBM4 trong một rack duy nhất. Source: VLSI Korea
Số học HBM4
Nền tảng này, về cốt lõi, là một hệ thống bộ nhớ. Phân tích HBM4 của một GPU theo bit:
| Hạng mục | Giá trị | Phép tính |
|---|---|---|
| Một stack HBM4 | 36 GB (288 Gb) | Mười hai die 24 Gb xếp chồng |
| Stack mỗi GPU | 8 | Thông số NVIDIA |
| HBM4 mỗi GPU | 288 GB (2.304 Gb) | 8 × 36 GB |
| Băng thông bộ nhớ mỗi GPU | 22 TB/s | Thông số NVIDIA |
| Stack mỗi rack | 576 | 72 × 8 |
| HBM4 mỗi rack | 20,7 TB (165.888 Gb) | 72 × 288 GB |
| Die DRAM HBM mỗi rack | 6.912 | 576 stack × 12 die |
So với Blackwell, dung lượng HBM mỗi GPU tăng 1,5×, từ 192 GB lên 288 GB, và băng thông 2,75×, từ 8 TB/s lên 22 TB/s. Số stack giữ nguyên ở tám, nhưng mỗi stack tăng từ 24 GB lên 36 GB và tốc độ pin tăng lên. Điều quan trọng đối với sản xuất là toàn bộ mức tăng dung lượng được tính bằng wafer DRAM bổ sung: mỗi stack cần mười hai die 24 Gb, và tính đến tỷ lệ đạt (yield) của die, mức tiêu thụ wafer thực tế còn cao hơn nữa.
3. Bao nhiêu được xây dựng — Các kịch bản khối lượng
NVIDIA không công bố số lượng đơn vị Rubin xuất xưởng. Mọi con số lưu hành đều là ước tính, và bài viết này chỉ sử dụng những con số có phương pháp minh bạch.
Suy ngược 1: Từ doanh thu
Thảo luận thị trường, dựa trên hướng dẫn của NVIDIA và bình luận của ban điều hành, xem xét một tốc độ vận hành mà Vera Rubin đóng góp khoảng $20 tỷ doanh thu hàng quý. Chia cho khoảng giá rack được báo cáo ($5M–$7,8M) cho ra 2.550–3.975 rack mỗi quý, hoặc khoảng 10.000–16.000 rack theo năm. Lưu ý rằng phép suy ngược này giả định toàn bộ doanh thu Rubin đến từ rack NVL72, khiến nó trở thành tham chiếu giới hạn trên — doanh số cấp bo mạch và mô-đun cùng doanh thu Blackwell song song được trộn vào, trong thực tế.
Suy ngược 2: Ước tính chuỗi cung ứng
Các nhà phân tích theo dõi chuỗi cung ứng Đài Loan đặt lượng rack VR200 xuất xưởng nửa cuối 2026 ở mức 5.000–7.000 đơn vị (được báo cáo là ước tính của Ming-Chi Kuo), quy đổi thành 360.000–500.000 GPU. Với các báo cáo cắt giảm phân bổ HBM4 trong hỗn hợp, một đồng thuận song song đặt tổng GPU Rubin năm 2026 ở mức 250.000–350.000. Đối với năm 2027, năm mở rộng quy mô, kịch bản cơ sở là 0,8–1,5 triệu GPU (11.000–21.000 rack). Ước tính ngành cũng dự báo lượng rack lớp NVL72 xuất xưởng tổng thể (GB300 + VR200 + VR300) tăng hơn 50% so với cùng kỳ năm trước trong năm 2027, với VR200 chiếm thị phần lớn nhất.
| Giai đoạn | Rack (ước tính) | GPU (ước tính) | Stack HBM4 (ước tính) | Cơ sở |
|---|---|---|---|---|
| Nửa cuối 2026 | 3.500–7.000 | 250K–500K | 2,0M–4,0M | Ước tính chuỗi cung ứng; bắt đầu giao hàng mùa thu |
| Mỗi quý ở đỉnh tăng trưởng | 2.550–3.975 | 180K–290K | 1,47M–2,29M | Suy ngược từ doanh thu hàng quý ~$20B |
| 2027 | 11.000–21.000 | 0,8M–1,5M | 6,4M–12,0M | Khoảng kịch bản cơ sở |
Mọi con số trong bảng này đều là ước tính, không phải con số đã xác nhận. Điều đã xác nhận là bản thân việc sản xuất, và việc bắt đầu giao hàng vào mùa thu.
Quy đổi sang bit HBM4, bức tranh thay đổi quy mô. Ngay cả mức thấp của kịch bản cơ sở 2027 (0,8 triệu GPU) cũng cần 230 PB (230.400 TB) HBM4; mức cao (1,5 triệu GPU) đạt 432 PB. Một nền tảng duy nhất hấp thụ một phần đáng kể trong toàn bộ sản lượng HBM của thế giới.
4. Quy đổi wafer — Một GPU = 0,30 wafer
Việc quy đổi khối lượng thành wafer cho thấy nút thắt nằm ở đâu. Mô hình dưới đây là của chúng tôi, với mọi giả định được công bố; hãy đọc kết quả dưới dạng khoảng.
Giả định
| Loại wafer | Giả định | Kết quả |
|---|---|---|
| Logic (TSMC 3nm) | Diện tích die ~800 mm² × 2 (gần giới hạn reticle 858 mm²), ~65 die thô mỗi tấm wafer 300 mm, tỷ lệ đạt (yield) die 85% | ~55 die tốt mỗi wafer = ~27 GPU |
| Đóng gói CoWoS | Diện tích gói ~4.700 mm² (lớp 5,5-reticle năm 2026), 6–8 gói mỗi wafer | ~7 GPU mỗi wafer |
| DRAM HBM4 | Die 24 Gb ~60 mm², ~1.090 die thô mỗi wafer, tỷ lệ đạt (yield) hiệu dụng KGD/xếp chồng 75% | ~820 die mỗi wafer = ~8,5 GPU |
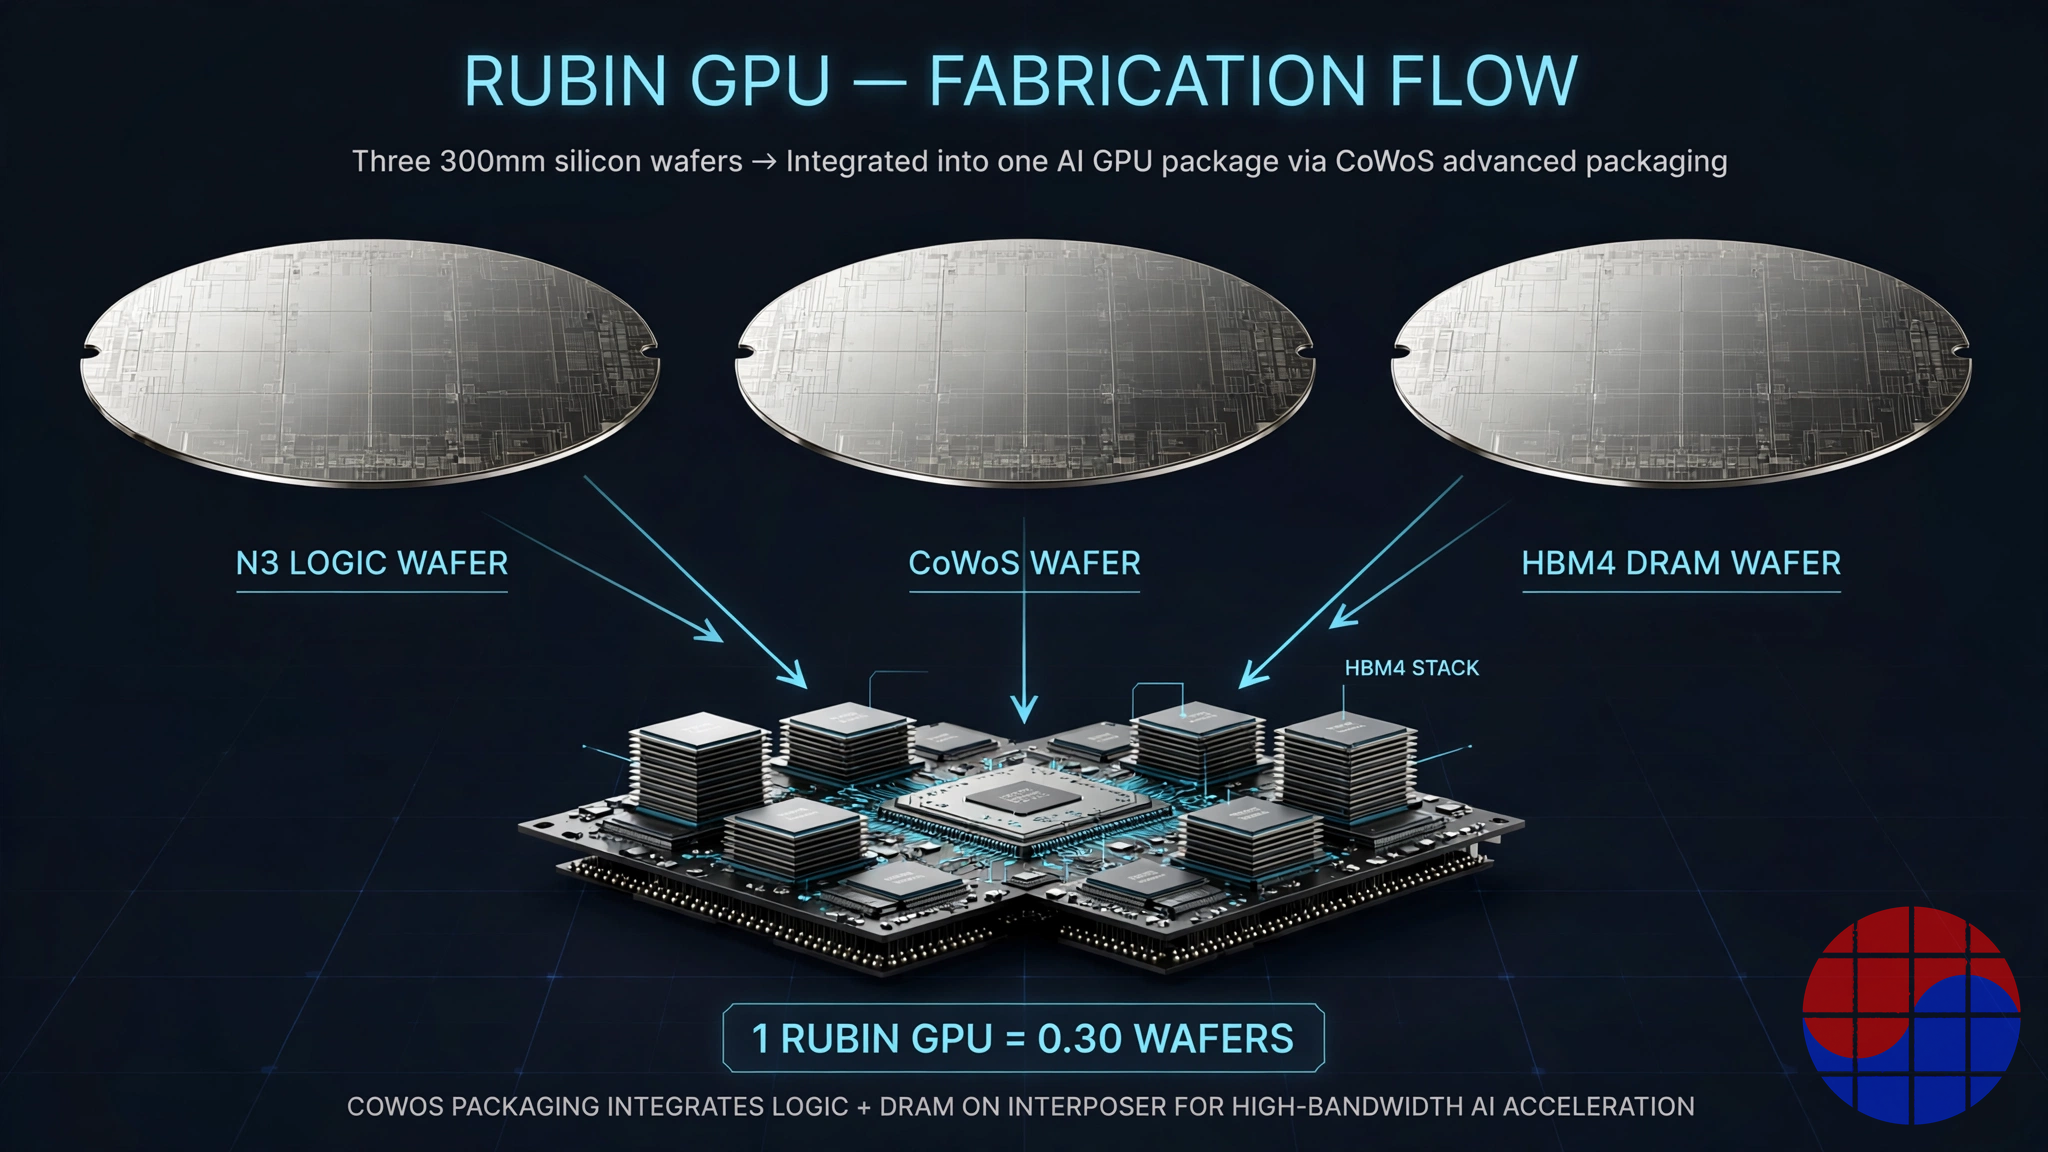
Ba loại wafer mà một GPU tiêu thụ — logic, CoWoS và DRAM HBM. Source: VLSI Korea
Kết quả quy đổi
| Danh mục | Mỗi GPU | Mỗi rack (72 GPU) | 2027 (0,8M–1,5M GPU) |
|---|---|---|---|
| Wafer logic (3nm) | 0,037 | ~2,7 | 30K–56K |
| Wafer CoWoS | 0,143 | ~10,3 | 114K–214K |
| Wafer DRAM HBM4 | 0,118 | ~8,5 | 94K–176K |
| Tổng | ~0,30 | ~21,5 | ~240K–450K |
Kết luận rõ ràng. Xây dựng một triệu GPU cần khoảng 300.000 wafer trên cả ba loại, và gần 90% trong số đó là wafer đóng gói (CoWoS) và bộ nhớ (DRAM). Wafer logic thuần túy chỉ khoảng 12% tổng số. Báo cáo cũng cho thấy bốn nhà thiết kế chip AI hàng đầu chỉ tiêu thụ khoảng 12% sản lượng logic nút công nghệ tiên tiến — chính là lý do tại sao các fab logic không phải là ràng buộc đối với tăng trưởng AI.
Đặt so với nguồn cung: TSMC đạt ước tính 120.000–150.000 wafer CoWoS mỗi tháng vào cuối năm 2026, và với công suất đối tác OSAT, tổng ngành tiếp cận khoảng 200.000 mỗi tháng. NVIDIA được cho là đã đặt trước khoảng 60% CoWoS năm 2026 của TSMC. Nhu cầu CoWoS của Rubin năm 2027 (114K–214K wafer mỗi năm) là một tỷ lệ phần trăm một chữ số trong công suất hàng năm của TSMC, vì vậy phép tính vẫn đúng ngay cả khi chia sẻ với Blackwell — vấn đề là tăng trưởng gói: khi diện tích gói mở rộng, số gói mỗi wafer giảm, và việc mở rộng liên tục bị diện tích ăn mất.
5. Bản đồ nhà cung cấp — Ai cung cấp gì, và bao nhiêu
Đằng sau một rack Vera Rubin là hàng trăm nhà cung cấp, bao gồm 150 đối tác Đài Loan mà Huang đã nêu. Bản đồ cốt lõi:
| Công ty | Cung cấp gì | Khối lượng / vai trò |
|---|---|---|
| TSMC | Die GPU 3nm, đóng gói CoWoS-L | Toàn bộ die GPU. NVIDIA được cho là đã đặt ~60% công suất CoWoS 2026 |
| SK hynix | HBM4, LPDDR5X SOCAMM2 | Khoảng giữa 50% phân bổ HBM4 ban đầu (được báo cáo). Stack 12-high 36 GB; SOCAMM2 được trình diễn cho CPU Vera |
| Samsung | HBM4 | Khoảng giữa 20% phân bổ ban đầu (được báo cáo). DRAM 1c + base die 4nm; thông số nhanh nhất lên tới 3,0 TB/s mỗi stack, 11,7 Gbps. Mẫu HBM4E nhắm tới Rubin Ultra |
| Micron | HBM4 | ~20% phân bổ ban đầu (được báo cáo). 36 GB 12-high xuất xưởng khối lượng lớn từ Q1 2026; >2,8 TB/s mỗi stack |
| Ibiden, Shinko, Unimicron, Nan Ya PCB | Đế ABF | Đế build-up cho các gói lớp 5,5-reticle; diện tích đế là công suất |
| ASE, Amkor | Back-end (tràn CoWoS) | Ước tính 50K–60K WPM công suất OSAT mới hấp thụ phần tràn của TSMC |
| Foxconn, Quanta, Wistron, Inventec | Lắp ráp & tích hợp rack | Foxconn được nêu là nhà lắp ráp lớn nhất; thiết kế node 5 phút đặt ra thông lượng |
| Dell, HPE, Lenovo, Supermicro, GIGABYTE | Giao hệ thống | Rack hoàn chỉnh tới CSP và doanh nghiệp |
| Vertiv, Schneider Electric, Delta | Nguồn & làm mát | CDU và nguồn cho rack ~200 kW; đối tác DSX POD |
| NVIDIA (nội bộ) | ConnectX-9, BlueField-4, switch NVLink, Spectrum-X Photonics | Thị phần BOM nội bộ tăng — phần của NVIDIA trong doanh thu rack tăng mỗi thế hệ |
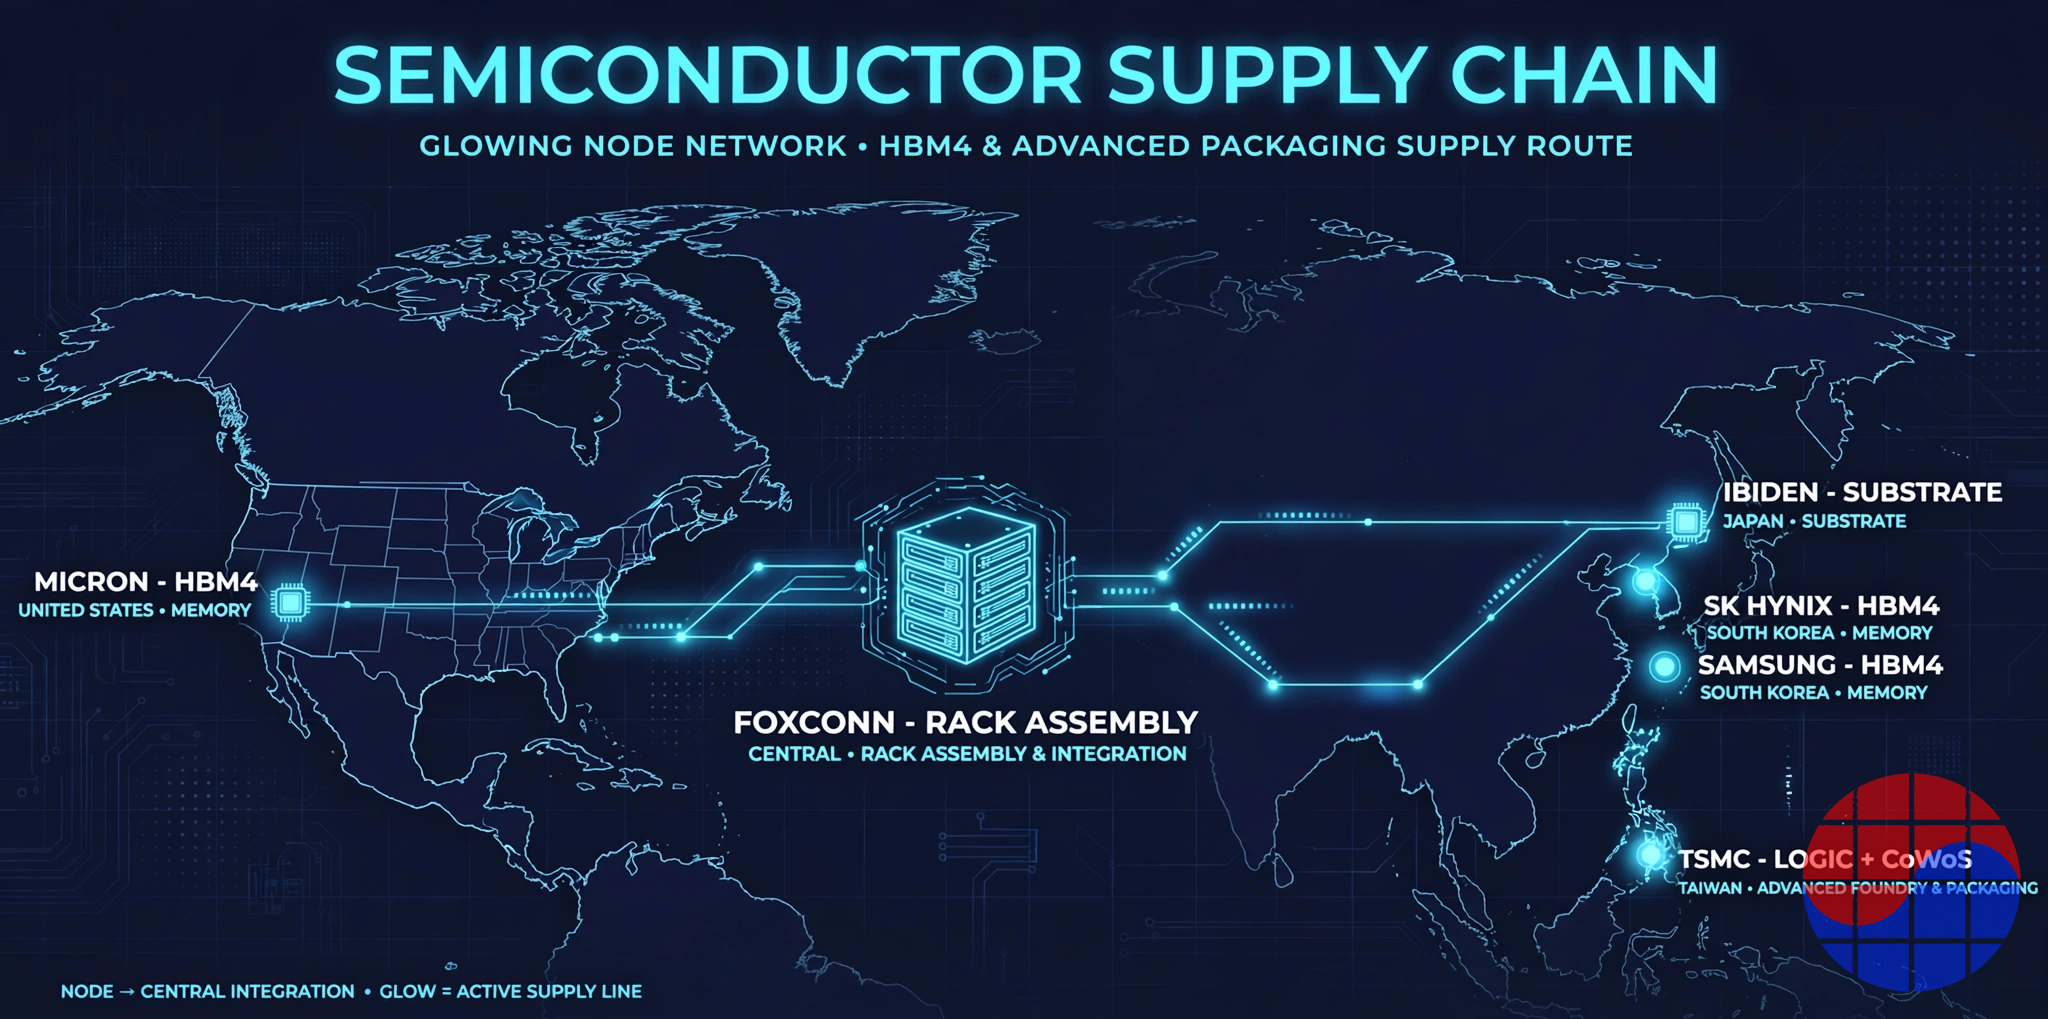
Chuỗi cung ứng Vera Rubin — logic và đóng gói ở Đài Loan, HBM4 chia giữa Hàn Quốc và Mỹ, đế ở Nhật Bản. Source: VLSI Korea
Phân bổ HBM4 dựa trên báo cáo về việc phân công khối lượng cuối năm 2025 của NVIDIA: SK hynix lớn nhất ở khoảng giữa 50%, Samsung ở khoảng giữa 20%, Micron khoảng 20%. Sự phân chia này không cố định. Samsung đã bắt đầu các lô hàng sản xuất hàng loạt HBM4 đầu tiên của ngành vào tháng 2 năm 2026 và dẫn đầu về thông số tốc độ, trong khi báo cáo vào tháng 4 cho thấy SK hynix cân nhắc cắt giảm lượng HBM4 xuất xưởng năm 2026 cho NVIDIA từ 20–30% giữa thời điểm tăng trưởng — một cấu trúc mà phân bổ hàng quý có thể thay đổi.
Kinh tế lắp ráp rack cũng thay đổi. Với lắp ráp node giảm từ hai giờ xuống năm phút, công suất lắp ráp không còn là vấn đề lao động mà là vấn đề linh kiện đến nơi. Đối với các nhà lắp ráp, Vera Rubin là một rack xuất xưởng với tốc độ linh kiện đến — nghĩa là HBM4 và các gói CoWoS hoàn thiện quyết định tỷ lệ sử dụng công suất dây chuyền. Bài viết đồng hành của chúng tôi về thiết kế nhà máy AI mô-đun của NVIDIA, phân tích chuyên sâu Vera Rubin DSX POD, đề cập tới tốc độ triển khai; bài viết này tập trung vào bao nhiêu hệ thống được xây dựng, và từ bao nhiêu wafer.
6. Kết luận nút thắt — Điều gì thực sự kiểm soát tăng trưởng
| Quy trình | Kết luận | Bằng chứng |
|---|---|---|
| HBM4 | Ràng buộc chính | Khối lượng 2026 về cơ bản đã bán hết. Báo cáo xem xét cắt giảm xuất xưởng. Một stack 12-high 36 GB được dự báo tăng từ ~$600 năm 2026 lên ~$1.300 năm 2027 (ước tính giá hợp đồng +121% YoY, được báo cáo) |
| CoWoS | Chặt, có thể quản lý | Công suất tăng ~8× trong ba năm, nhưng tăng trưởng diện tích gói bù đắp việc mở rộng. Thiếu hụt cung ngành 10–20% vẫn tồn tại trong ước tính |
| Đế ABF | Theo dõi | Tiếp xúc trực tiếp với tăng trưởng diện tích gói lớn; từng âm thầm trở thành nút thắt trước đây |
| Wafer logic 3nm | Không phải ràng buộc | 4 nhà thiết kế AI hàng đầu tiêu thụ ~12% sản lượng logic nút công nghệ tiên tiến (được báo cáo) |
| Lắp ráp rack | Không phải ràng buộc | Lắp ráp node 5 phút, thiết kế mô-đun; ràng buộc là linh kiện đến nơi |
| Nguồn & địa điểm | Ràng buộc phía khách hàng | 190–230 kW mỗi rack; chuyển đổi 800VDC và hạ tầng làm mát bằng chất lỏng là thách thức địa điểm |
Kết luận đơn giản. Hàm sản xuất của Vera Rubin đọc là min(stack HBM4 ÷ 576, gói CoWoS ÷ 72, die logic ÷ 144), và trong 2026–2027 hạng mục đặt ra mức tối thiểu là HBM4. Nếu doanh thu Rubin không đạt hướng dẫn trong một bản in thu nhập của NVIDIA, hãy nghi ngờ việc giao HBM4 trước nhu cầu. Ngược lại, nếu giá hợp đồng HBM4 thực sự gần gấp đôi vào năm 2027, đó là tín hiệu bộ ba bộ nhớ đã bắt đầu thu phần của mình trong kinh tế tăng trưởng.
Góc nhìn của Chase
Với tất cả các con số được bày ra, Vera Rubin ít giống một sản phẩm GPU hơn là hình thức vật lý của một hợp đồng mua bộ nhớ. Trong mức giá rack $5M–$7,8M, chi phí wafer của chính die GPU chiếm thị phần nhỏ hơn trực giác gợi ý; tiền và công suất bị khóa trong 576 stack HBM4 và diện tích CoWoS.
Từ góc nhìn Hàn Quốc, hãy theo dõi độ dốc của phân bổ. Khoảng giữa 50% của SK hynix là sự tiếp nối từ thế hệ Blackwell, nhưng khoảng giữa 20% của Samsung trông như một sàn cho sự trở lại — nếu các quân bài tốc độ và HBM4E của hãng phát huy tại đợt đặt lại phân bổ 2027, độ dốc sẽ thay đổi. Và điều quyết định độ dốc đó không phải là tiếp thị; đó là tỷ lệ đạt (yield) KGD theo từng quý và thông lượng xếp chồng.
Cuối cùng, con số 0,30 wafer đáng nhớ. Cạnh tranh bộ tăng tốc AI giờ đây đồng thời là một cuộc thi thiết kế và một cuộc thi phân bổ trên ba loại wafer. Lộ trình của TSMC, hướng tới HBM5 và các gói lớp 14-reticle cho thế hệ tiếp theo, cho thấy cuộc thi phân bổ này không kết thúc — nó chỉ trở nên đắt đỏ hơn.
Nguồn: Thông số do NVIDIA công bố và tường thuật bài phát biểu chính GTC Berlin 2026 (21 tháng 10 năm 2026), báo cáo chuỗi cung ứng và thu nhập Hàn Quốc và quốc tế, phân tích danh mục vật tư (BOM) của công ty chứng khoán. Quy đổi khối lượng và wafer là ước tính của chúng tôi theo các giả định đã nêu và có thể khác với lượng xuất xưởng thực tế. Bài viết này không phải là lời khuyên đầu tư.
FAQ
Q: Có bao nhiêu stack HBM4 đi vào một rack Vera Rubin? A: 576. Mỗi GPU mang tám stack 12-high 36 GB (288 GB), và một rack chứa 72 GPU, vì vậy 72 × 8 = 576 stack — tổng cộng 20,7 TB (165.888 Gb).
Q: Bao nhiêu hệ thống Vera Rubin sẽ được sản xuất vào năm 2027? A: Không có con số đã xác nhận. Kết hợp ước tính chuỗi cung ứng và suy ngược doanh thu, kịch bản cơ sở cho năm 2027 là 11.000–21.000 rack, hoặc 0,8–1,5 triệu GPU. Nửa cuối 2026 được ước tính khoảng 3.500–7.000 rack.
Q: Cần bao nhiêu wafer để xây dựng một GPU? A: Khoảng 0,30 wafer trên ba loại: 0,037 wafer logic 3nm, 0,143 wafer CoWoS và 0,118 wafer DRAM HBM4 — ước tính của chúng tôi theo các giả định được công bố trong bài viết này (diện tích die, tỷ lệ đạt (yield), diện tích gói). Mỗi rack, đó là khoảng 21,5 wafer.
Q: Nút thắt thực sự trong sản xuất Vera Rubin là gì? A: HBM4. Khối lượng 2026 về cơ bản đã được phân bổ hết, và các báo cáo xem xét cắt giảm xuất xưởng cùng triển vọng giá hợp đồng 2027 tăng mạnh ủng hộ kết luận đó. CoWoS chặt nhưng đang mở rộng; wafer logic 3nm và lắp ráp rack khó có thể gọi là ràng buộc.
Q: Những công ty nào cung cấp HBM4, và với thị phần bao nhiêu? A: Theo báo cáo phân bổ cuối năm 2025, SK hynix nắm khoảng giữa 50%, Samsung khoảng giữa 20%, và Micron khoảng 20%. Samsung mang đến các lô hàng sản xuất hàng loạt đầu tiên của ngành (tháng 2 năm 2026) và thông số nhanh nhất, SK hynix phân bổ lớn nhất và SOCAMM2, và Micron xuất xưởng khối lượng lớn từ Q1 2026 — và phân bổ có thể được điều chỉnh theo từng quý.
📩 Đăng ký bản tin VLSI Korea
Nhận phân tích bán dẫn chuyên sâu mỗi ngày qua email trước tiên. Đăng ký miễn phí.


