VLSI Korea
Google TPU一年回本——客製化晶片經濟學改寫AI晶片版圖
Google TPU伺服器一年內就能收回投資。TPUv7 Ironwood的推論效能價格比最高比B200/B300高出50%。當回收期只有一年,自研晶片就不是選項而是財務上的必然——從Broadcom到MediaTek的ASIC價值鏈已進入結構性成長。


摘要:Google TPU伺服器一年內就能收回投資。TPUv7 Ironwood的推論效能價格比最高比B200/B300高出50%。當回收期只有一年,自研晶片就不是選項而是財務上的必然——從Broadcom到MediaTek的ASIC價值鏈已進入結構性成長。
30秒摘要(AEO)
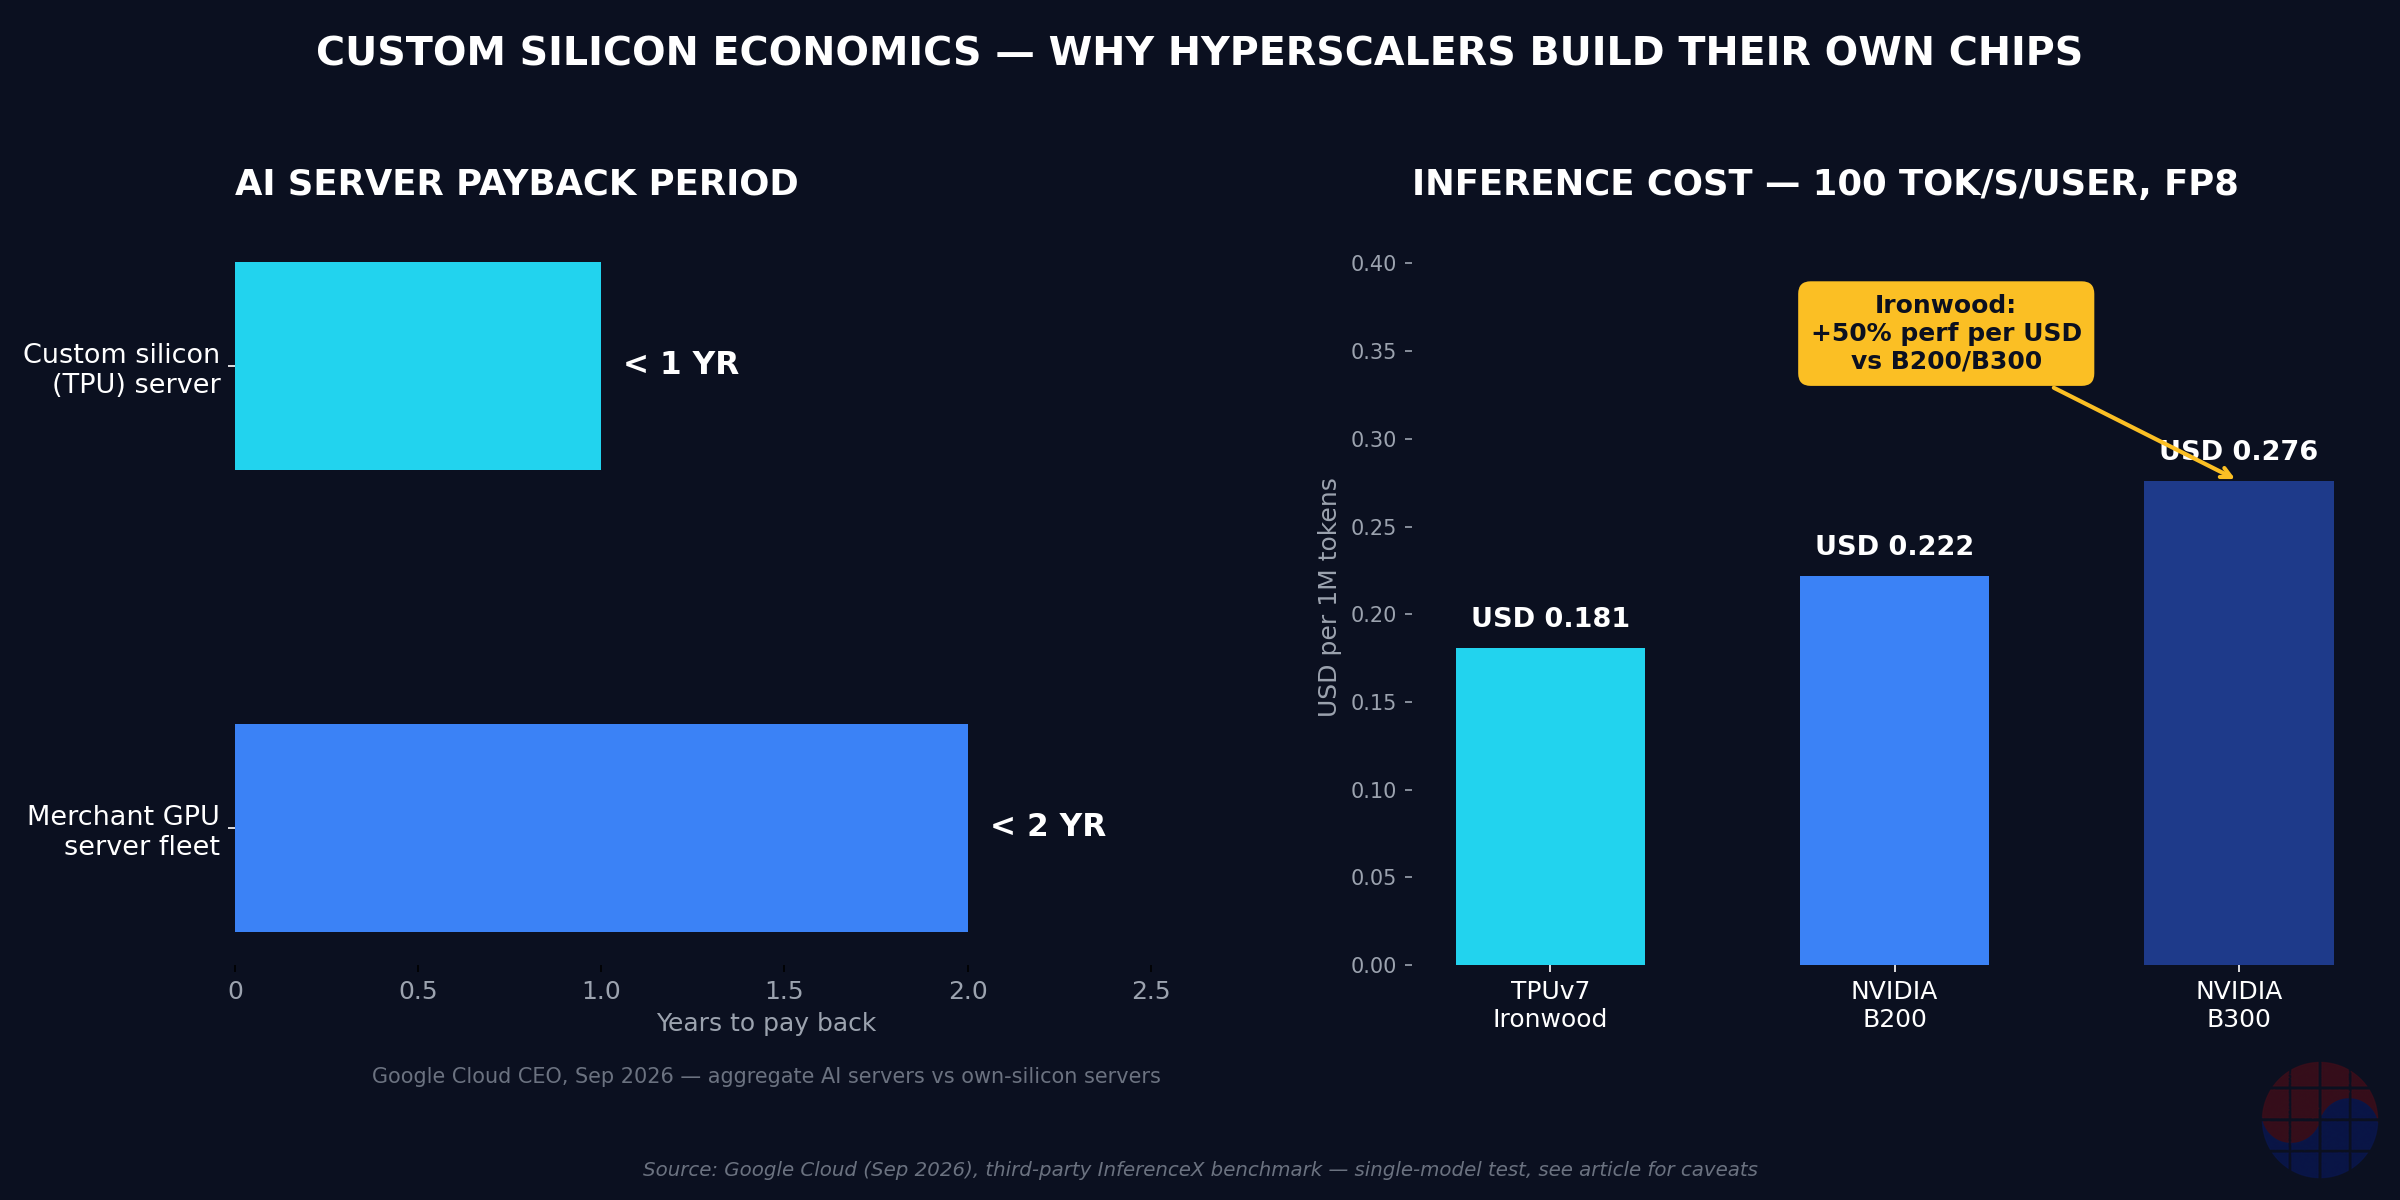
- Google Cloud執行長Thomas Kurian於2026年9月披露:AI伺服器整體投資回收期不到兩年,採用自研晶片(TPU)的伺服器約為其一半。一年的回收期讓客製化晶片從「策略選擇」變成財務上的必然。(來源)
- 第三方基準測試(InferenceX)顯示,TPUv7 Ironwood在同等條件推論下「效能價格比最高比B200/B300高出50%」,但須注意這是單一模型(Qwen 3.5 397B、FP8)的廠商測試。(來源)
- Anthropic在2026年10月IPO文件中披露了1,252億美元的五年TPU產能租賃承諾,Broadcom則同意提供最高420億美元的可轉債融資。晶片銷售與金融結合,是一種全新的業務模式。(來源)
- MediaTek將2026年ASIC營收預測翻倍至20億美元以上,首款為Google設計的AI ASIC將於2026年第四季量產。(來源)
- 結論:在超大規模雲端業者(hyperscaler)的世界裡,自製還是外購的爭論已經結束,回收期決定答案。
Background:為什麼是現在、為什麼是客製化晶片
AI晶片之爭的焦點長期是「誰更快」。但2026年下半年,問題變了。Alphabet預告2026年資本支出高達1,950億至2,050億美元(來源),股東的問題從FLOPS變成了「錢什麼時候回來」。
Kurian的回答異常具體。2026年9月8日,他在Goldman Sachs Communacopia + Technology Conference上表示,AI伺服器整體回收期不到兩年,自研晶片約為其一半。Google Cloud在9月11日的官方回顧中再次確認。他還宣稱Google Cloud訓練的性價比達2.7倍、推論達80%優勢,自研加速器業務規模是次大超大規模業者的兩倍以上。(來源)
這番話真正的份量不在「兩年」這個數字,而在於:一旦回收期掉到一年級別,自研晶片的經濟學就徹底翻轉。先進製程AI ASIC的NRE(設計、光罩、驗證費用)約1億至2億美元。用100萬顆晶片攤提,每顆僅100至200美元。對比merchant GPU的通路利潤(NVIDIA毛利率超過70%),只要量夠大,自研晶片無條件更便宜。Kurian的發言,等於Google Cloud執行長親自宣告「量夠大」。
Business Deep Dive
市場規模:2027年800億美元的客製化AI晶片市場
券商估計,客製化AI晶片TAM到2027年約700億至800億美元。MediaTek在2026年7月法說會上提出目標:拿下其中15%至20%。(來源)
超大規模業者的動作已經反映在數字上:
- Google:2026年4月Google Cloud Next發表第八代TPU(訓練用8t、推論用8i),新的Virgo網路架構可在單一資料中心串連134,000顆TPU、跨站點超過100萬顆成為單一邏輯叢集。(來源)瓶頸已不再是晶片供給而是電力——在數十萬顆的規模下,能餵給機櫃多少電力決定了成長天花板。(來源)
- Anthropic:2025年10月與Google簽下多年期合約,引進最高100萬顆Ironwood TPU(傳聞金額達數百億美元);2026年10月1日IPO文件披露1,252億美元的五年TPU產能租賃。(來源)
- Meta:與Broadcom共同設計的MTIA計畫「Iris」晶片於2026年9月在台積電3奈米量產。Meta計畫將AI算力從2026年的7GW翻倍至2027年底的14GW。(來源)
- OpenAI:2026年6月與Broadcom共同發表首款客製化晶片「Jalapeño」,10GW共同開發進行中。機櫃部署2026年底開始,延續至2029年。(來源)
成本結構:TCO在哪裡分岔
拆解Ironwood的經濟學,有三個槓桿:
1. 每美元推論效能。InferenceX基準測試(Qwen 3.5 397B、FP8、每用戶100 tokens/s條件)中,Ironwood每百萬token成本0.181美元,B200為0.222美元,B300為0.276美元——「最高50%更好的效能價格比」的依據在此。以內部TCO計算,Ironwood伺服器比同級GB200 Blackwell伺服器便宜約44%;Anthropic這類外部客戶也能比NVIDIA便宜約30%。(來源)但須注意:這是單一模型、單一條件的廠商測試。較具獨立性的反證是新創Inferact用相同vLLM引擎測試Moonshot AI的Kimi K3——16顆TPUv7達709 tokens/s,16顆GB200為452 tokens/s,領先57%(含軟體堆疊最佳化)。(來源)
2. 去除merchant利潤楔子。Google對外銷售或出租自研晶片時,價格中沒有NVIDIA式的merchant利潤。垂直整合硬體(晶片、互連、軟體堆疊)以內部成本加上雲端服務費出售——同樣的FLOPS,帳單結構完全不同。
3. 電力與規模經濟。資料中心TCO中電力與冷卻佔比逼近40%。單顆晶片的每瓦效能固然重要,但在百萬顆規模下,網路架構效率(goodput)決定金錢流向——這就是Google強調TPU 8t「goodput超過97%」的原因。這和記憶體業者用良率決勝負是同一結構:比的不是單位效能,而是「存活週期」的經濟學。
競爭定位:四個軸線
| 軸線 | 代表業者 | 定位 |
|---|---|---|
| 超大規模業者自研晶片 | Google TPU、Meta MTIA、Amazon Trainium、Microsoft Maia、OpenAI Jalapeño | 針對工作負載特化,去除merchant利潤 |
| ASIC設計夥伴 | Broadcom、MediaTek、Marvell、Alchip | 以設計、CoWoS、HBM整合能力拿單 |
| 晶圓代工 | 台積電(實質壟斷) | 先進產能的分配者 |
| 記憶體 | SK海力士、三星、美光(HBM) | 每顆晶片的HBM堆疊數(每顆數百Gb級)是成本的重要軸線 |
Broadcom的位置最耐人尋味。2026年4月與Google簽下至2031年的長期TPU與網路供應合約(來源),4月14日擴大與Meta的MTIA合作(超過1GW),與OpenAI則是10GW共同開發。換言之,Broadcom同時為三個互相競爭的AI陣營設計晶片——成了客製化晶片戰爭的「兵工廠」。
MediaTek從另一個角度切入:把智慧手機時代累積的CPU、GPU、NPU矽智財與低功耗設計資產,轉用於資料中心ASIC。2026年第二季,含ASIC的Smart Device Platform部門史上首次超越智慧手機晶片,成為最大營收來源。4月與7月法說會將2026年ASIC營收預測翻倍至20億美元以上,首款為Google設計的AI加速器ASIC將於2026年第四季量產。(來源)但市場上也有樣品交期與良率的雜音,第四季量產能否上軌道是觀察重點。
策略選項:三種情境
- 垂直整合加速(基準情境):若TPU externalization成功,2027年將有20%至30%的推論工作負載跑在客製化晶片而非merchant GPU上。ASIC設計夥伴迎來本益比重估。
- merchant反擊:NVIDIA可在Rubin世代以價格與綁售策略縮小TCO差距。CUDA生態系的轉換成本仍是護城河。Ironwood僅原生支援FP8(TPUv8i才加入FP4)限制了比較的有效範圍。
- 金融風險爆發(悲觀情境):Broadcom式的客戶融資,結構上酷似2001年電信設備泡沫時Nortel與Lucent的vendor financing——當年設備商支撐客戶採購,最終隨客戶信用崩潰一同墜落。Anthropic揭露的資訊(租賃擔保最高290億美元曝險)本身就展現了這種結構的兩面性。(來源)
Chase's Take
用MBA個案來讀,重點只有一個:自製還是外購,答案不是技術而是回收期。
傳統製造業的自製外購分析,就是把固定成本(NRE)除以量。但在AI晶片世界,分母(量)正指數成長,分子(NRE)雖隨先進製程膨脹,卻追不上量的增速。100萬顆晶片×每顆數千美元的節省=數十億美元。這個算式成立的瞬間,財務長就會問工程師「為什麼不自己做」。Kurian的發言,正是對這個問題的執行長級回答。
第二,Broadcom的GTM創新。賣晶片的公司借給客戶420億美元——這不是折扣,而是「金融即業務」的模式。正面看是進入障礙(客戶鎖定)的極大化,負面看是信用風險的內部化。投資人該用「準金融機構」而非晶片公司的眼光看Broadcom的資產負債表。
第三,對台灣與亞洲的啟示。台積電在這場遊戲中的位置無可取代:所有客製化晶片最終都流向先進製程產能。MediaTek證明了「手機IP轉用」的路徑——把既有矽智財組合搬到資料中心,這對台灣IC設計業者是現成的劇本。而HBM端,隨著每顆客製化晶片搭載8至12層HBM(每顆數百Gb級),ASIC放量就是HBM放量。
Implications:投資與經營啟示
- 投資:ASIC設計夥伴(Broadcom、MediaTek、Marvell、Alchip)進入結構性成長。但本益比可能已反映不少,須按季追蹤MediaTek第四季量產進度與Broadcom的融資曝險。晶圓代工方面,台積電先進產能的分配直接決定客戶組合的品質。
- 經營:雲端採購者不該再用merchant GPU單一報價來編2027年推論TCO預算。務必把TPU externalization報價納入平行議價——光是議價槓桿就曾把既有GPU價格壓低近30%(OpenAI案例)。(來源)
- 風險:客戶融資結構崩壞的情境,不會來自晶片需求斷崖,而是「信用緊縮」。AI基礎設施融資規模已達數千億美元,監控指標是利差與違約交換,而非晶片出貨量。
FAQ
Q1. TPU真的能一年回本嗎? 這是Google Cloud執行長在2026年9月會議上的官方說法:AI伺服器整體不到兩年,自研晶片約為其一半。但這是Google內部會計基準,不代表外部客戶能複製相同條件。(來源)
Q2. Ironwood「效能價格比50%優勢」是公平比較嗎? 有單一模型、單一條件、廠商測試的侷限。但獨立新創(Inferact)的第三方測試也顯示TPUv7領先GB200,內部TCO分析方向一致。反方論點是僅原生支援FP8的限制。(來源)
Q3. Broadcom借給Anthropic 420億美元為何重要? 這是晶片銷售與金融結合的新業務模式:廠商直接支撐客戶購買力以確保訂單,代價是承擔客戶信用風險。結構酷似2001年電信泡沫的vendor financing,須看見兩面性。(來源)
Q4. 對台灣企業的影響? 台積電的先進製程是所有客製化晶片的必經之路,產能分配就是權力。MediaTek的「手機IP轉用」策略則是台灣IC設計業者的現成劇本。
延伸閱讀
- AI晶片霸權之爭的全貌:Chip War — Chris Miller (Amazon)
- NVIDIA商業模式剖析:The Nvidia Way — Tae Kim (Amazon)
透過此連結購買可能產生佣金。
本文為基於公開新聞稿、法說會與媒體報導的分析,非投資建議。引用的數據以各來源發表時點(2026年4月至10月)為準,之後可能已有變化。