VLSI Korea
不用HBM也能做AI推論?英特爾480GB LPDDR5X豪賭與推論記憶體TCO之戰
英特爾在OCP 2026發表推論專用GPU D270,放棄HBM,改以LPDDR5X提供最高480GB容量。2026年HBM幾近完售、2027年產能也大多被預訂,誰拿得到記憶體、誰就決定架構。推論戰場的勝負不在頻寬,而在每個詞元的總持有成本(TCO)。


Excerpt: 英特爾在OCP 2026發表推論專用GPU D270,放棄HBM,改以LPDDR5X提供最高480GB容量。2026年HBM幾近完售、2027年產能也大多被預訂,誰拿得到記憶體、誰就決定架構。推論戰場的勝負不在頻寬,而在每個詞元的總持有成本(TCO)。
Slug: inference-memory-tco-lpddr5x-hbm-zh-tw
30秒摘要: 英特爾在OCP 2026發表推論專用GPU D270(代號Crescent Island):FP8算力1.3 PFLOPS、記憶體頻寬1.5 TB/s、350W空冷PCIe介面卡。真正的爆點不是HBM,而是LPDDR5X——英特爾自家卡搭載160GB,ODM夥伴卡最高可達480GB。FP8精度下一張卡就能跑3000億參數的模型,八卡系統可支援1兆參數以上。價格未公布,也還沒有任何獨立測試。同時,HBM的2026年產能幾乎完售,2027年也有大半被鎖定。誰拿得到記憶體,誰就決定架構——在推論的世界裡,決勝點不是頻寬,而是每個詞元的總持有成本(TCO)。
Background
AI基礎設施的重心,正從訓練(training)轉向推論(inference)。訓練是一次性的巨型算力競賽;推論卻是每天產出數十億詞元的持續性服務。當工作負載變成服務,成本結構本身就是策略。
但在2026年下半年,規劃推論基礎設施的人第一個撞上的牆,不是GPU的FLOPS,而是記憶體採購。三星電子表示2026年HBM4產能幾近完售;SK海力士2026年DRAM與NAND產能全數售罄;美光2027年記憶體供應也有大半已用高價被預訂。(相關報導)
就在這個背景下,英特爾在10月12日的OCP Global Summit給出的答案格外引人注目:不加入HBM搶購戰,直接用另一種記憶體重寫遊戲規則。
Business Deep Dive
1. 拆解D270——為什麼是LPDDR5X
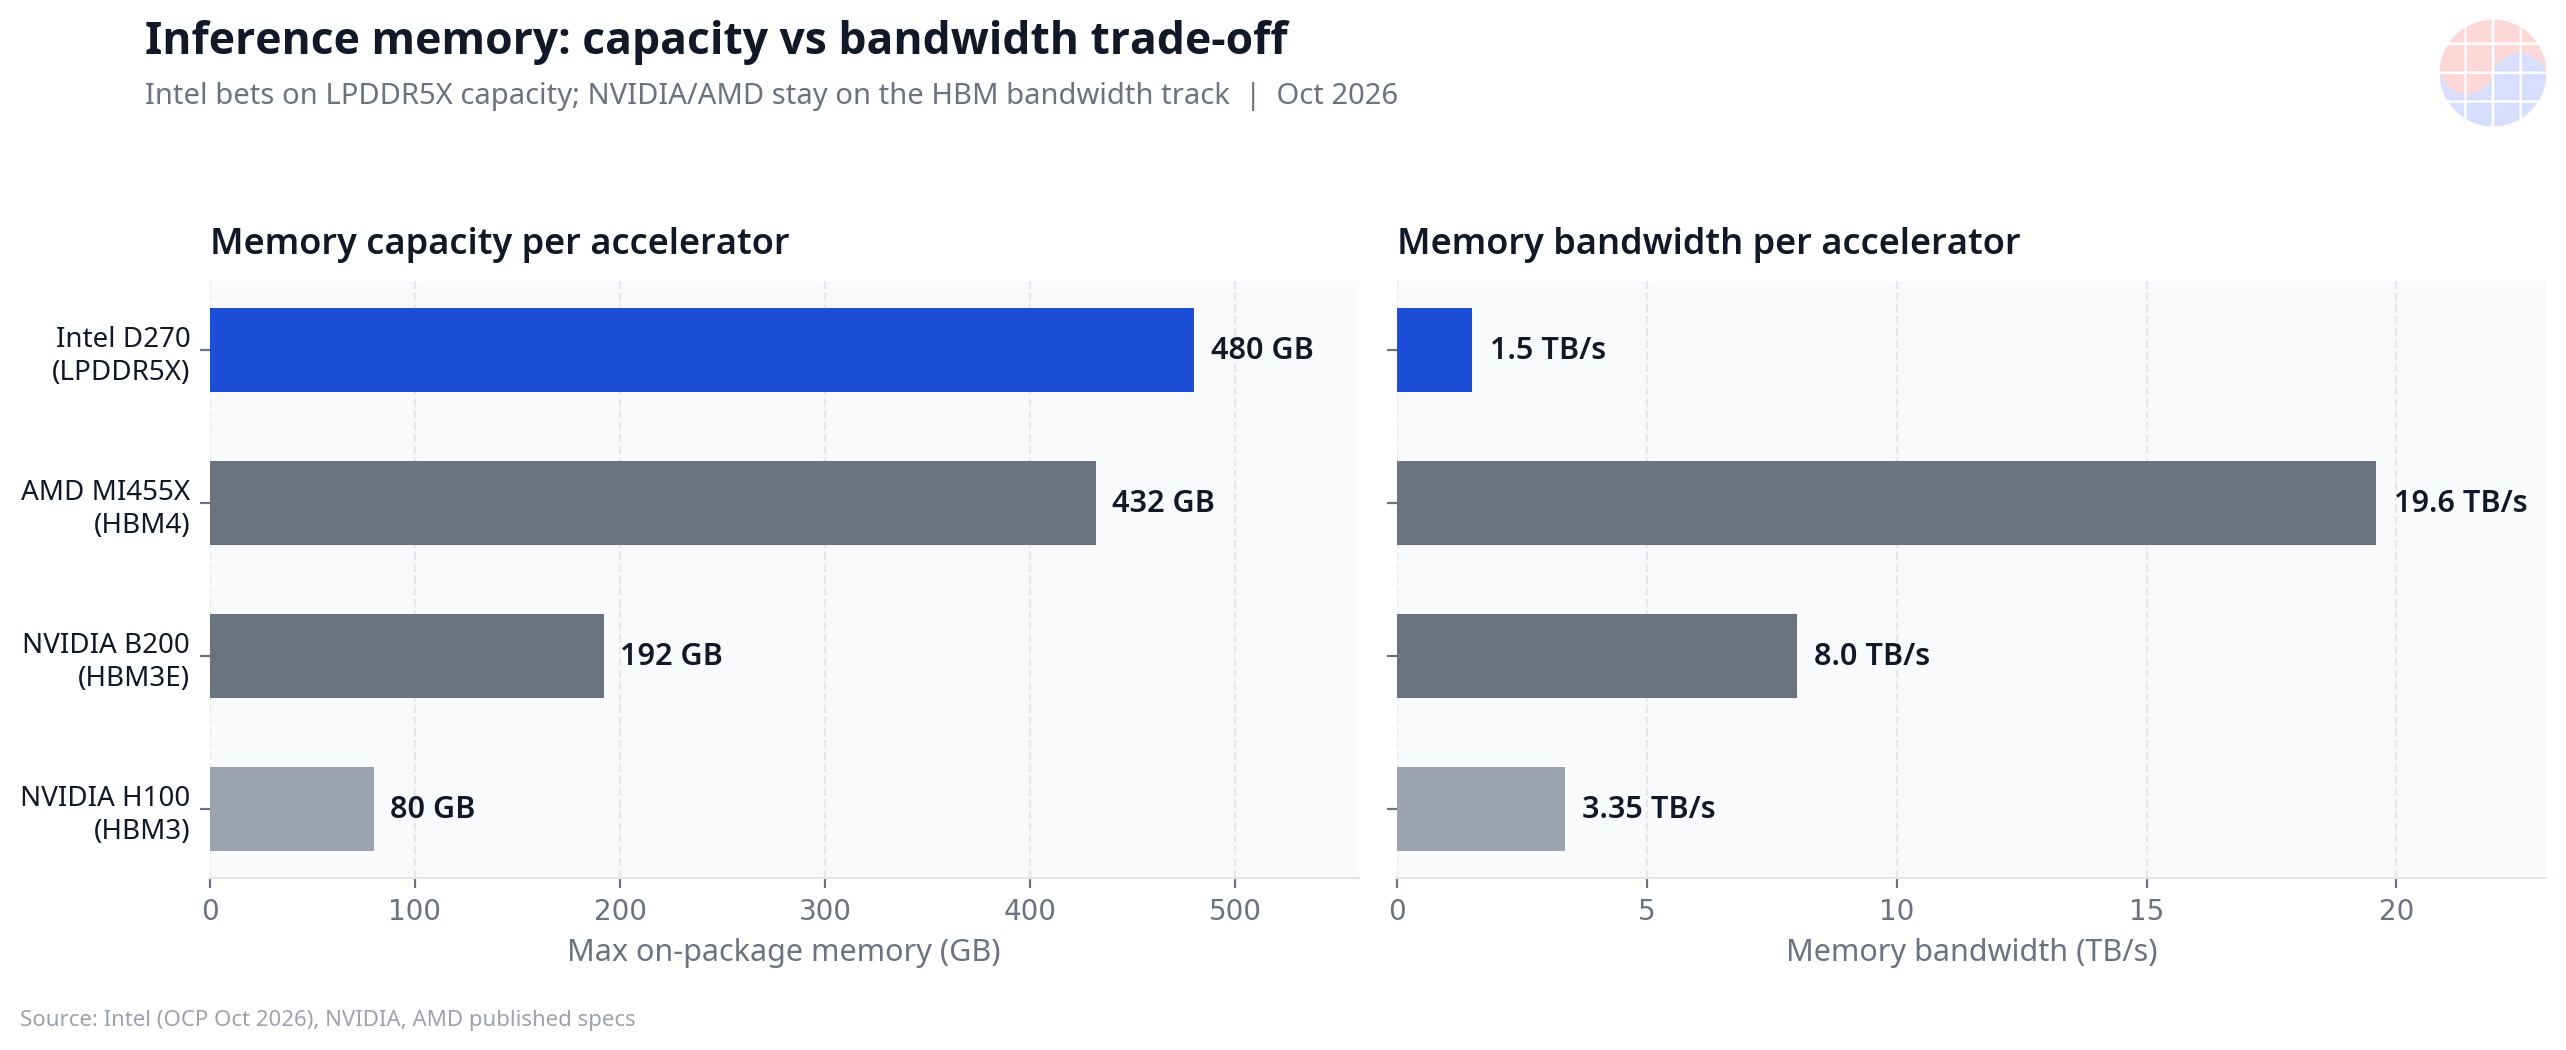
英特爾公開的GPU D270(前代號Crescent Island)規格如下。(英特爾官方新聞)
| 項目 | 規格 |
|---|---|
| 架構 | Xe3P —— 32顆Xe3P核心、256顆XMX矩陣運算引擎、32MB統一L2快取 |
| 算力 | FP8 1.3 PFLOPS |
| 記憶體 | LPDDR5X —— 英特爾自家卡160GB / ODM夥伴卡最高480GB |
| 記憶體頻寬 | 1.5 TB/s |
| 功耗與散熱 | 350W,空冷 PCIe 5.0 x16 |
| 模型支援 | 單卡3000億參數、八卡系統1兆參數以上 |
最能說明問題的設計決策,是把傳統3D繪圖與光線追蹤硬體整個拿掉。原本固定功能繪圖單元佔用的晶粒面積,全部轉給AI運算。「推論專用」四個字,直接刻進了矽裡。
第二個決策是記憶體。選LPDDR5X,不選HBM。1.5 TB/s的頻寬大約是HBM3E級卡(8 TB/s)的五分之一;但容量是碾壓級的——夥伴卡的480GB,約為現行世代HBM旗艦的2.5倍。
數學很簡單。FP8精度下,一個參數約等於一個位元組。3000億參數的模型權重大約300GB——一張480GB的卡綽綽有餘。剩下的約180GB,可以給推論的隱形記憶體大戶KV快取和批次處理用。一兆參數的模型拆到八張卡上,每卡只要約125GB。至於頻寬不足,由於推論是權重載入一次、生成數千上萬個詞元,其殺傷力遠不如訓練那麼致命。
第三個決策是功耗與外形。350W空冷PCIe卡可以直接插進現有的資料中心。不像千瓦級液冷加速器需要特殊的電力與散熱建設——這筆帳在TCO裡比看起來大得多。
但限制也同樣清楚。價格未公布。量產時間只有「2027年」這種媒體層級的說法。更重要的是,完全沒有獨立測試——1.3 PFLOPS只是理論峰值。(相關報導)
2. 記憶體荒正在改寫架構
要理解D270這場賭注,得先看2026年10月的記憶體市場站在什麼位置。
- HBM4(現行世代):三星電子2026年產能幾近完售;SK海力士2026年DRAM與NAND全量完售。想買也買不到。
- HBM4E(下一代):2048位元介面、每腳位14–16 Gbps、每堆疊最高3.6 TB/s。12層堆疊(384Gb / 48GB)樣品已於5月(三星)、6月(SK海力士)出貨。量產目標2027年。目前還沒有JEDEC標準,是供應商定義的世代。(相關報導)
- 三星12層HBM4E傳出已通過輝達認證測試,但三星與輝達都沒有官方證實——仍停留在報導階段。(相關報導)
- 美光2027年記憶體供應的75%已傳出售罄。(相關報導)
換句話說,想上HBM路線圖,就得從2027年產能開始排隊。在這種市場裡,「不用HBM建推論伺服器群」不只是省成本,更是採購風險的規避。LPDDR5X是手機、PC大量生產的商品型DRAM,沒有HBM那種TSV、矽中介層封裝瓶頸,供應商池廣,每GB採購單價也低。特斯拉得出了同樣的結論。
3. 特斯拉也往同一個方向走——AI5/AI6記憶體規格下修
10月1日,馬斯克宣布特斯拉AI5記憶體從原定的144GB LPDDR5砍半到72GB,AI6也從原規劃削減三分之一、降到144GB LPDDR6。理由說得很直白:為了確保Optimus量產所需的數量。之後AI5又調整為96GB。他補充說,記憶體頻寬比容量是更大的限制,所以對性能的影響可以忽略。(相關報導)
浮現的模式再清楚不過:記憶體荒正在改變設計規格本身。圍繞「拿得到的記憶體」重新定義產品——這已成為2026年下半年AI硬體的標準動作。值得一提的是,AI5已在三星晶圓代工德州泰勒廠進入試產。
4. 分岔的記憶體策略——輝達 vs 英特爾
相反,對記憶體供應有把握的一方,則往反方向走。輝達的路線圖:
- Rubin(2026年):搭載HBM4
- Rubin Ultra(2027年):搭載HBM4E
- Feynman(2028年):傳出採用客製化HBM——不是標準HBM,而是量身設計 (相關報導)
- NVHBM(2026年8月發表):輝達的客製化HBM基礎裸晶技術,與記憶體廠共同設計驗證,號稱比標準HBM4E每堆疊頻寬+30%、HBM功耗−15%、PHY面積−67%。(相關報導)
超微也維持HBM路線。MI455X搭載432GB(3,456Gb)HBM4,頻寬19.6 TB/s。(相關報導)
總結下來,記憶體策略正在分岔成兩條路。
| 策略 | 代表玩家 | 方向 |
|---|---|---|
| 頻寬與功耗最佳化 | 輝達(NVHBM客製化HBM)、超微(HBM4/HBM4E) | 把昂貴的記憶體榨得更乾——旗艦級訓練與推論 |
| 容量與成本最佳化 | 英特爾(480GB LPDDR5X)、特斯拉(LPDDR5/6) | 便宜的記憶體用更多——推論伺服器群的TCO競爭 |
沒有哪一邊是「正確答案」。工作負載在分化:前沿模型訓練和高階推論吃頻寬;大規模詞元服務、裝置端、機器人推論看的是容量與成本。
5. 拆解TCO——決定每詞元成本的四個槓桿
推論基礎設施的TCO,可以拆成四個槓桿。
① 記憶體採購。 HBM完售——就算加價也得搶配額。LPDDR5X是商品市場,議價能力與供應穩定性完全不同。「拿不拿得到」成了TCO的第一個變數。
② 電力與散熱。 350W空冷卡和千瓦級液冷加速器的差別,不只是晶片功耗。機櫃電力密度、液冷設備投資、電費全都跟著走。這就是英特爾主打「不需特殊機櫃與散熱基礎設施即可擴充」的原因。
③ 每台伺服器的容量。 八張D270的系統總記憶體3.84TB,可承載一兆參數以上的模型。節點數一少,網路、電力、維運複雜度跟著降。容量就是節點密度。
④ 利用率。 推論伺服器不是閒著,而是一直處在記憶體瓶頸狀態下運轉。就算頻寬較低,只要KV快取夠大、批次拉得夠多,詞元吞吐量照樣拉得起來。和特斯拉那句「頻寬比容量是更大的限制」是同一個邏輯。
Chase's Take
如果訓練時代的指標是FLOPS,那麼推論時代的指標就是每個詞元幾塊錢。英特爾的賭注,就是把這個命題翻譯成矽。1.3 PFLOPS這個數字跟旗艦比起來顯得不起眼,但把問題從「誰更快」換成「誰能把詞元印得更便宜」,遊戲就變了。
結構性的重點有兩個。
第一,HBM短缺已經從暫時性供需失衡,變成強迫架構選擇的結構變數。特斯拉砍規格、英特爾轉向LPDDR,是對同一股壓力的不同回應。在握有記憶體的一方(SK海力士佔HBM營收約57%等)掌握價值鏈定價權的同時,用記憶體的一方就改按「拿得到的記憶體」重新設計。未來兩三年的AI硬體新聞,都要放在這層張力之上來讀。
第二,韓國的利益橫跨兩邊。HBM溢價的直接受益者是三星電子和SK海力士;同時,三星晶圓代工在泰勒廠試產特斯拉AI5,而在LPDDR供應鏈上,中國長鑫存儲的追趕正猛。一旦記憶體組合從純HBM轉向HBM加LPDDR並行,韓國記憶體雙雄的產品組合和代工客戶結構都會受到波及。只押一邊的分析,只看了半幅圖。
公允地列出反方意見:1.5 TB/s的頻寬確實低,對延遲敏感的即時推論(TTFT)可能吃虧。更重要的是,價格還沒公布——沒有價格表,TCO優勢就無法驗證。只憑理論值就宣告「推論性價比勝利」,為時尚早。
Implications
給投資人的啟示: - 推論工作負載佔比越高,記憶體組合就越偏離純HBM。是時候重新盤點LPDDR5X與伺服器DRAM需求的結構性受益者了。 - HBM溢價大概率延續到2027年——2026年完售、2027年產能被預訂、HBM4E供應商定義世代的過渡期。記憶體廠的定價權短期內還在。 - 電力與散熱基礎設施(維持空冷還是轉向液冷)是資料中心資本支出的新變數。350W級推論卡的普及,可能放慢液冷轉型的速度。
給經營者的啟示: - AI基礎設施採購的標準,正從「最快的晶片」變成「拿得到的記憶體」。2027年產能規劃要從記憶體配額倒推回去。 - 從避免供應商鎖定的角度,該開始追蹤LPDDR架構推論選項的成熟度。這可能是非輝達推論方案的第一個實戰測試案例。
FAQ
Q1. LPDDR5X頻寬比HBM低這麼多,推論真的沒問題嗎? A. 要看工作負載。不像訓練要不斷翻動權重,推論是權重載入一次、生成數千上萬個詞元。瓶頸往往不是頻寬,而是KV快取的容量和批次大小。不過,對首次詞元延遲(TTFT)敏感的即時服務,頻寬劣勢就會浮現。
Q2. 480GB真的能把3000億參數的模型塞進一張卡嗎? A. FP8精度下一個參數約等於一個位元組,所以3000億參數約300GB。一張480GB的卡放下權重後還剩約180GB,KV快取和批次處理都夠用——和英特爾的說法在數學上自洽。但實際跑起來如何,還沒有獨立測試驗證。
Q3. 價格多少? A. 未公布。英特爾只說客戶送樣正在進行。沒有價格表,就無法算出相對HBM卡真正的TCO優勢。沒有價格的性價比之爭,只爭了一半。
Q4. HBM短缺什麼時候緩解? A. 2026年產能幾近完售,2027年也有大半被預訂。HBM4E量產目標是2027年,但它是供應商定義的世代,爬坡速度是變數。2027年整年都要預留緊張的可能性。
Further Reading
- Chris Miller,《Chip War》——半導體霸權的地緣政治與供應鏈,一本必讀。在Amazon查看
- Clayton Christensen,《The Innovator's Dilemma》——解釋低端進入者如何顛覆市場的MBA經典;用來解讀英特爾LPDDR賭注的一副鏡片。在Amazon查看
透過此連結購買可能會產生佣金
免責聲明:本文數據與時程依據截至2026年10月13日的公開資料;英特爾D270性能數據為廠商公布的理論值,未經獨立測試驗證。請勿作為投資判斷依據。
Tags: deep-dive, inference, memory-tco, lpddr5x, hbm, chinese-traditional