VLSI Korea
Intel 推論 GPU 深度解析:為何跳過 HBM、改用 480GB LPDDR5X — Crescent Island D270 全解讀
Intel 跳過 HBM,改用 LPDDR5X:自家卡 160GB、ODM 最高 480GB。查證社群瘋傳的 480GB、推論中容量勝過頻寬的區間,以及對三星、SK 海力士與美光的意涵。


30 秒摘要
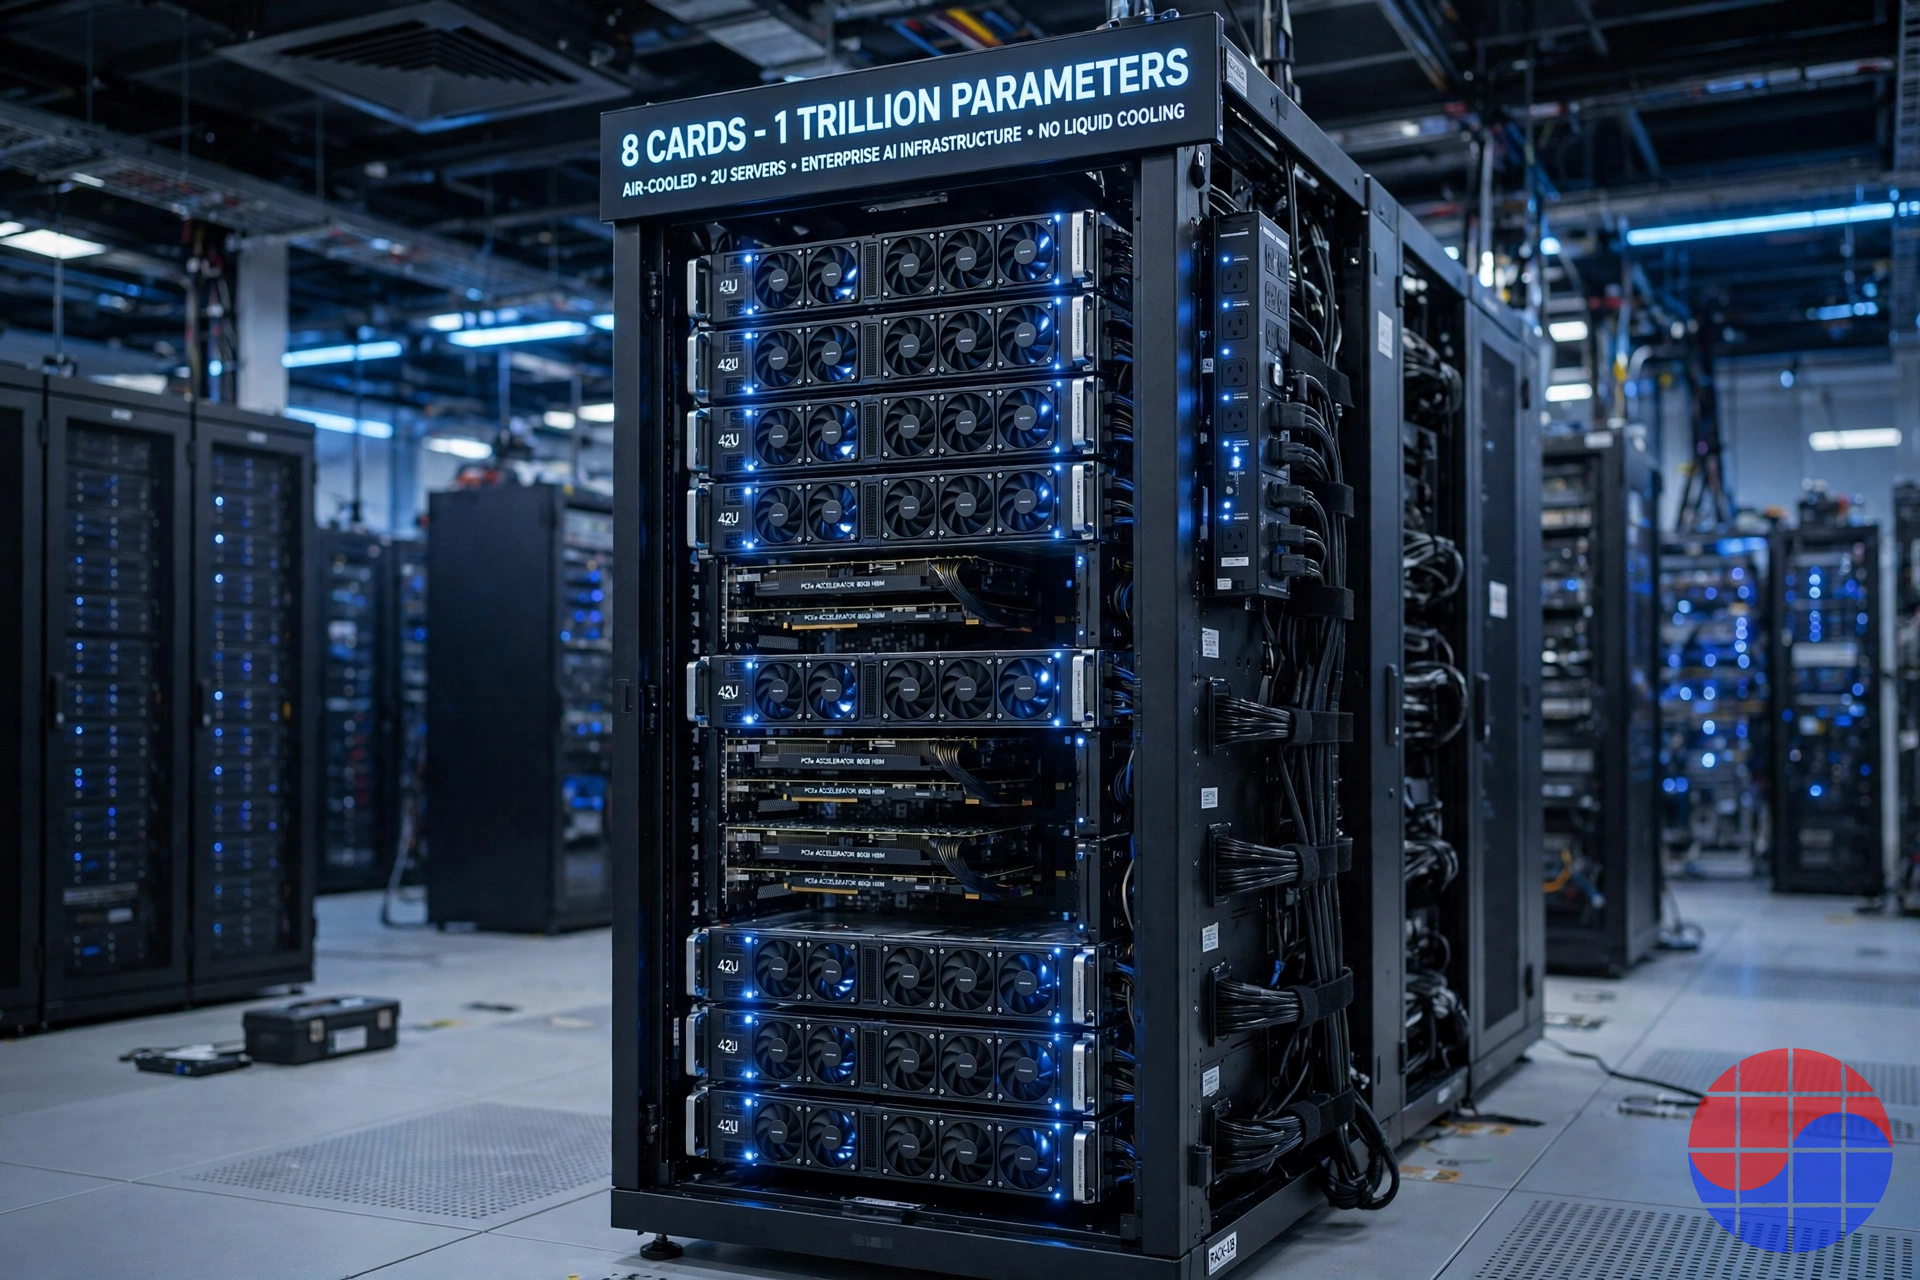
Intel 於 2026 年 10 月 12 日在 OCP 全球峰會上,為其純推論 GPU 公布了正式產品名稱與最終規格。代號 Crescent Island,產品線定名為 Intel GPU D-Series,首款產品為 D270(依媒體報導)。焦點在記憶體:這張卡完全不用 HBM,而是以 20 顆 LPDDR5X 封裝構成 1.5 TB/s 頻寬;Intel 自家卡的容量為 160GB,ODM 合作夥伴的設計則可擴充至 480GB。社群分析文章中流傳的「LPDDR5X 480GB」是真數字,但附帶條件 — Intel 自己賣的卡是 160GB。運算性能為 FP8 1.3 PFLOPS,功耗 350W,採氣冷 PCIe 卡形式。Intel 表示,單卡可服務高達 3,000 億參數的模型,八卡系統可超過 1 兆參數。目前正進行客戶送樣,價格與正式上市日期尚未公布。本篇深度解析將攤開全部已確認的事實、「為什麼是 LPDDR」的技術與經濟邏輯,以及對三星電子、SK 海力士與美光的意涵。
Intel 實際公布了什麼
Crescent Island 並非一夜之間冒出的產品。Intel 早在 2025 年 10 月的 OCP 全球峰會就首次揭露這款推論 GPU,當時公布的配置為 160GB LPDDR5X。2026 年 8 月的 Hot Chips 上,Intel 詳細說明了 Xe3P 架構;2026 年 10 月 12 日,則正式定名 GPU D-Series 並鎖定最終規格。Intel 同時展示了液冷 OAM 模組原型(每個模組 2 顆 GPU、5U 機箱可放 8 個模組),顯示氣冷 PCIe 是灘頭堡,更高密度的形式則留在路線圖上。
設計哲學從一開始就很一致:不與旗艦訓練 GPU 正面對決。目標不是 NVIDIA Blackwell Ultra 或 AMD MI 系列以 HBM 築起的訓練與超大規模服務市場,而是能裝進企業既有標準 x86 伺服器的推論工作負載。Intel 資料中心事業群 AI 產品與市場副總裁 Anil Nanduri 在會上直言:「推論正在成為定義 AI 的工作負載,企業需要的是能以合適成本提供合適效能的基礎設施。」
| 項目 | Intel GPU D270 (Crescent Island) |
|---|---|
| 架構 | Xe3P (Xe3 強化版) |
| Xe 核心 | 32 個 (4 個 slice) |
| XMX 矩陣引擎 | 256 個 |
| FP8 運算 (dense) | 1.3 PFLOPS |
| FP64 向量運算 | 10.2 TFLOPS |
| L2 快取 | 32MB (統一) |
| 記憶體 | LPDDR5X,20 顆封裝,80 通道,1,280-bit |
| 記憶體速率 | 9,375 MT/s |
| 記憶體頻寬 | 1.5 TB/s |
| 記憶體容量 | 160GB (Intel 自家卡) / 最高 480GB (ODM 設計) |
| 主機介面 | PCIe Gen5 x16 |
| 功耗 | 350W |
| 形式與散熱 | 雙寬 PCIe CEM,氣冷 |
| 狀態 | 客戶送樣中 (2026 年 10 月),價格與上市日未公布 |
資料來源:Intel 2026 年 10 月 12 日 OCP 全球峰會發布內容與 Hot Chips 2026 架構資料。
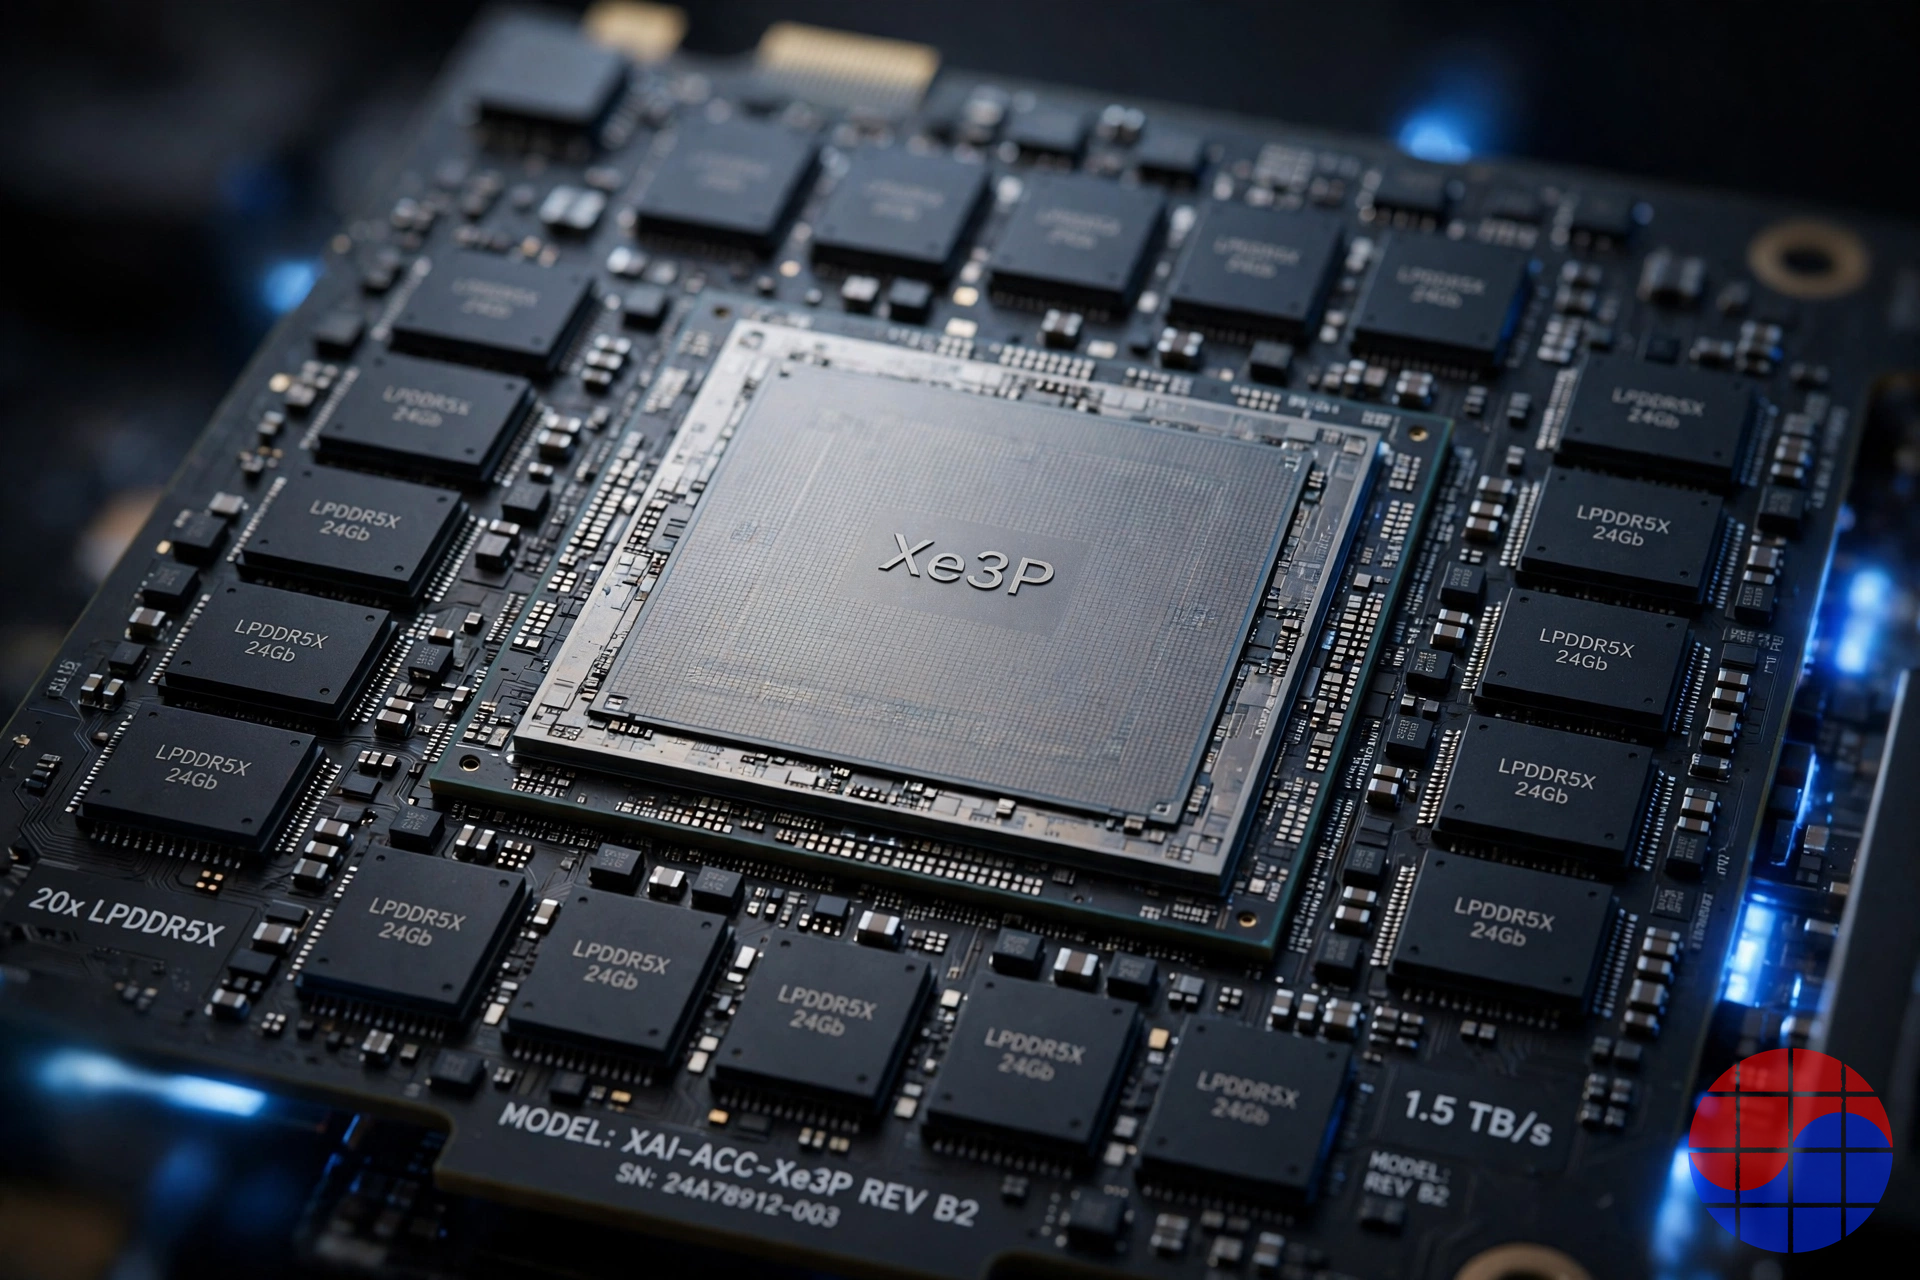
Xe3P 核心本身也為推論重新裁切。XMX 收縮陣列從 Xe2 的 4-deep 加深到 16-deep,每核心通用暫存器檔案倍增至 1MB,L1/共享本地記憶體增至每核心 512KB。遊戲 GPU 上的 3D 圖形與光線追蹤區塊則被完全移除,每一平方毫米都讓給矩陣運算與 FP4 到 FP64 的推論資料型態。軟體則以 OpenVINO 與 oneAPI 為核心的開放堆疊為主軸。
480GB 查證:數字是真的,但少了註腳
發布之後,「LPDDR5X 480GB」在社群分析文章中被當成這張卡的頭條規格傳播。這個數字確實出現在 Intel 的官方發布中 — 但它指的是 ODM 夥伴能做出的最大配置,而不是 Intel 品牌卡的規格。拿掉這個註腳,數字就會誤導人。
| 配置 | 每封裝密度 | 封裝數 | 總容量 | 販售方 |
|---|---|---|---|---|
| Intel 參考卡 | 64Gb 級封裝 | 20 顆 | 160GB | Intel (品牌卡) |
| ODM 最大配置 | 192Gb 級封裝 | 20 顆 | 480GB | 合作夥伴 (ODM) 設計板卡 |
兩個配置的記憶體子系統完全相同:80 條 16-bit 通道組成 1,280-bit 匯流排,以 9,375 MT/s 運作,得到 1.5 TB/s。差別只在每顆封裝裡堆了幾顆 DRAM 晶粒。換句話說,480GB 是「設計允許的上限」,160GB 是「Intel 實際出貨的配置」。無論哪一個,這都是 PCIe 推論卡已公布容量中的頂級水準。相較之下,NVIDIA 的 Rubin GPU 搭載 288GB HBM4,AMD MI450 系列據報為 432GB — 只比容量,LPDDR 設計反而反超 HBM 旗艦。
模型規模的算術也要用同樣的標準看。以 FP8(每參數 1 位元組)計算,160GB 卡在扣除 KV 快取與執行開銷前,理論上可放約 1,600 億參數的權重;Intel 所說的「單卡 3,000 億參數」對應的是 480GB 配置。八卡「超過 1 兆參數」同樣以 480GB × 8 = 3.84TB 的總記憶體為前提。數字不假,但引用時必須連同基準配置一起看。
為什麼是 LPDDR5X (一):推論的瓶頸是記憶體,不是運算
訓練與推論使用記憶體的方式不同。訓練反覆進行巨型矩陣乘法,FLOPS 與頻寬都重要。推論 — 尤其是逐一吐出 token 的解碼階段 — 在小批次時本質上是頻寬之戰:每產生一個 token,就要把整組模型權重從記憶體讀過一遍,讀完權重的時間決定了 token 間延遲。
但在實際服務營運中,頻寬不是唯一的牆。並發量上升、上下文拉長時,KV 快取會快速吃掉記憶體。真正的約束收斂為:這個模型能不能放上單一張卡?一張卡能扛多少並發請求、多長的上下文?容量不夠,就得把模型切到多張卡上,卡間通訊與閒置運算全都是額外成本。Intel 賭的正是這一點。D270 在絕對頻寬上比 HBM 旗艦落後一個數量級,但容量放大 2 到 3 倍,卡價與功耗卻大幅降低 — 在這個區間,勝負由每 token 成本決定。
用數字看:D270 的 1.5 TB/s 連單顆 HBM4 堆疊(2.8 TB/s 以上)都不到,更別說 12 堆疊旗艦的數十 TB/s。但 D270 是一張 350W 的氣冷卡。當 HBM 旗艦動輒突破 1,000W、強迫使用液冷機櫃時,D270 可以直接插進既有企業伺服器的空 PCIe 槽。Intel 賣的不是峰值性能,而是今天就能部署、裝進既有基礎設施的推論容量。
為什麼是 LPDDR5X (二):每 GB 成本,以及根本買不買得到
第二個論點是錢與供給。HBM4 的每 GB 價格被討論在約 31~32 美元,約為前一代 HBM3E 17~18 美元的兩倍(業界估計)。LPDDR5X 即使經歷超級循環漲價,以 12GB 封裝換算每 GB 約 12 美元,仍不到 HBM4 的一半。封裝差距更大:HBM 繼承了 TSV 堆疊與中介層的先進封裝產能瓶頸;LPDDR5X 則是手機與 PC 每年消耗數億顆的通用 DRAM,供應商池廣、封裝也是標準製程。
採購風險是 2026 年的現實。三星與 SK 海力士 2026 年的 HBM 產量實質上已售罄,美光也據報已預先承諾 2027 年供給的很大一部分。今天才加入 HBM 排隊行列,意味著等 2027 年的配額。LPDDR5X 則是現在就買得到的記憶體。對在 HBM 配額順位靠後的後進者來說,「不用 HBM 的推論卡」既是降本,也是避開採購風險的對沖。而且得出相同結論的不只 Intel:Meta 的自研推論晶片 MTIA 系列採用 LPDDR 等級記憶體,Tesla 的推論晶片也做了同一家族的選擇。
三種記憶體比較:HBM4 vs LPDDR5X vs GDDR7
| 面向 | HBM4 | LPDDR5X | GDDR7 |
|---|---|---|---|
| 每堆疊/每晶片頻寬 | 每堆疊 2.8 TB/s 以上 | 每封裝約 77 GB/s (整卡 1.5 TB/s) | 每晶片最高約 144 GB/s |
| 每加速器總頻寬 | 數十 TB/s (12 堆疊) | 1.5 TB/s (D270) | 約 1.8 TB/s (512-bit) |
| 每加速器容量 | 288~432GB | 160~480GB | 32~96GB |
| 每 GB 成本 | 約 31~32 美元 (業界估計) | 約 12 美元 (2026 年漲價後行情) | 遠低於 HBM (圖形用通用品) |
| 功耗特性 | 含中介層系統,功耗高 | 每位元能耗最低 (行動設計) | 每位元能耗高於 LPDDR |
| 封裝 | 必須 TSV 堆疊 + 中介層 | 標準封裝,板上直焊 | 板上直焊 |
| 供給狀況 | 2026 年產量售罄,配額競爭 | 通用 DRAM,供應商池廣 | 與圖形需求競逐 |
| 主要採用者 | NVIDIA Rubin、AMD MI450 系列、TPU/Trainium 旗艦 | Intel GPU D-Series、NVIDIA Grace/Vera (CPU 記憶體)、Meta MTIA | GeForce RTX 50 系列等顯示卡 |
註:每 GB 成本為隨時點與合約條件大幅變動的估計值,此處僅用以呈現方向 — LPDDR5X 不到 HBM4 的一半。頻寬依各家公布規格。
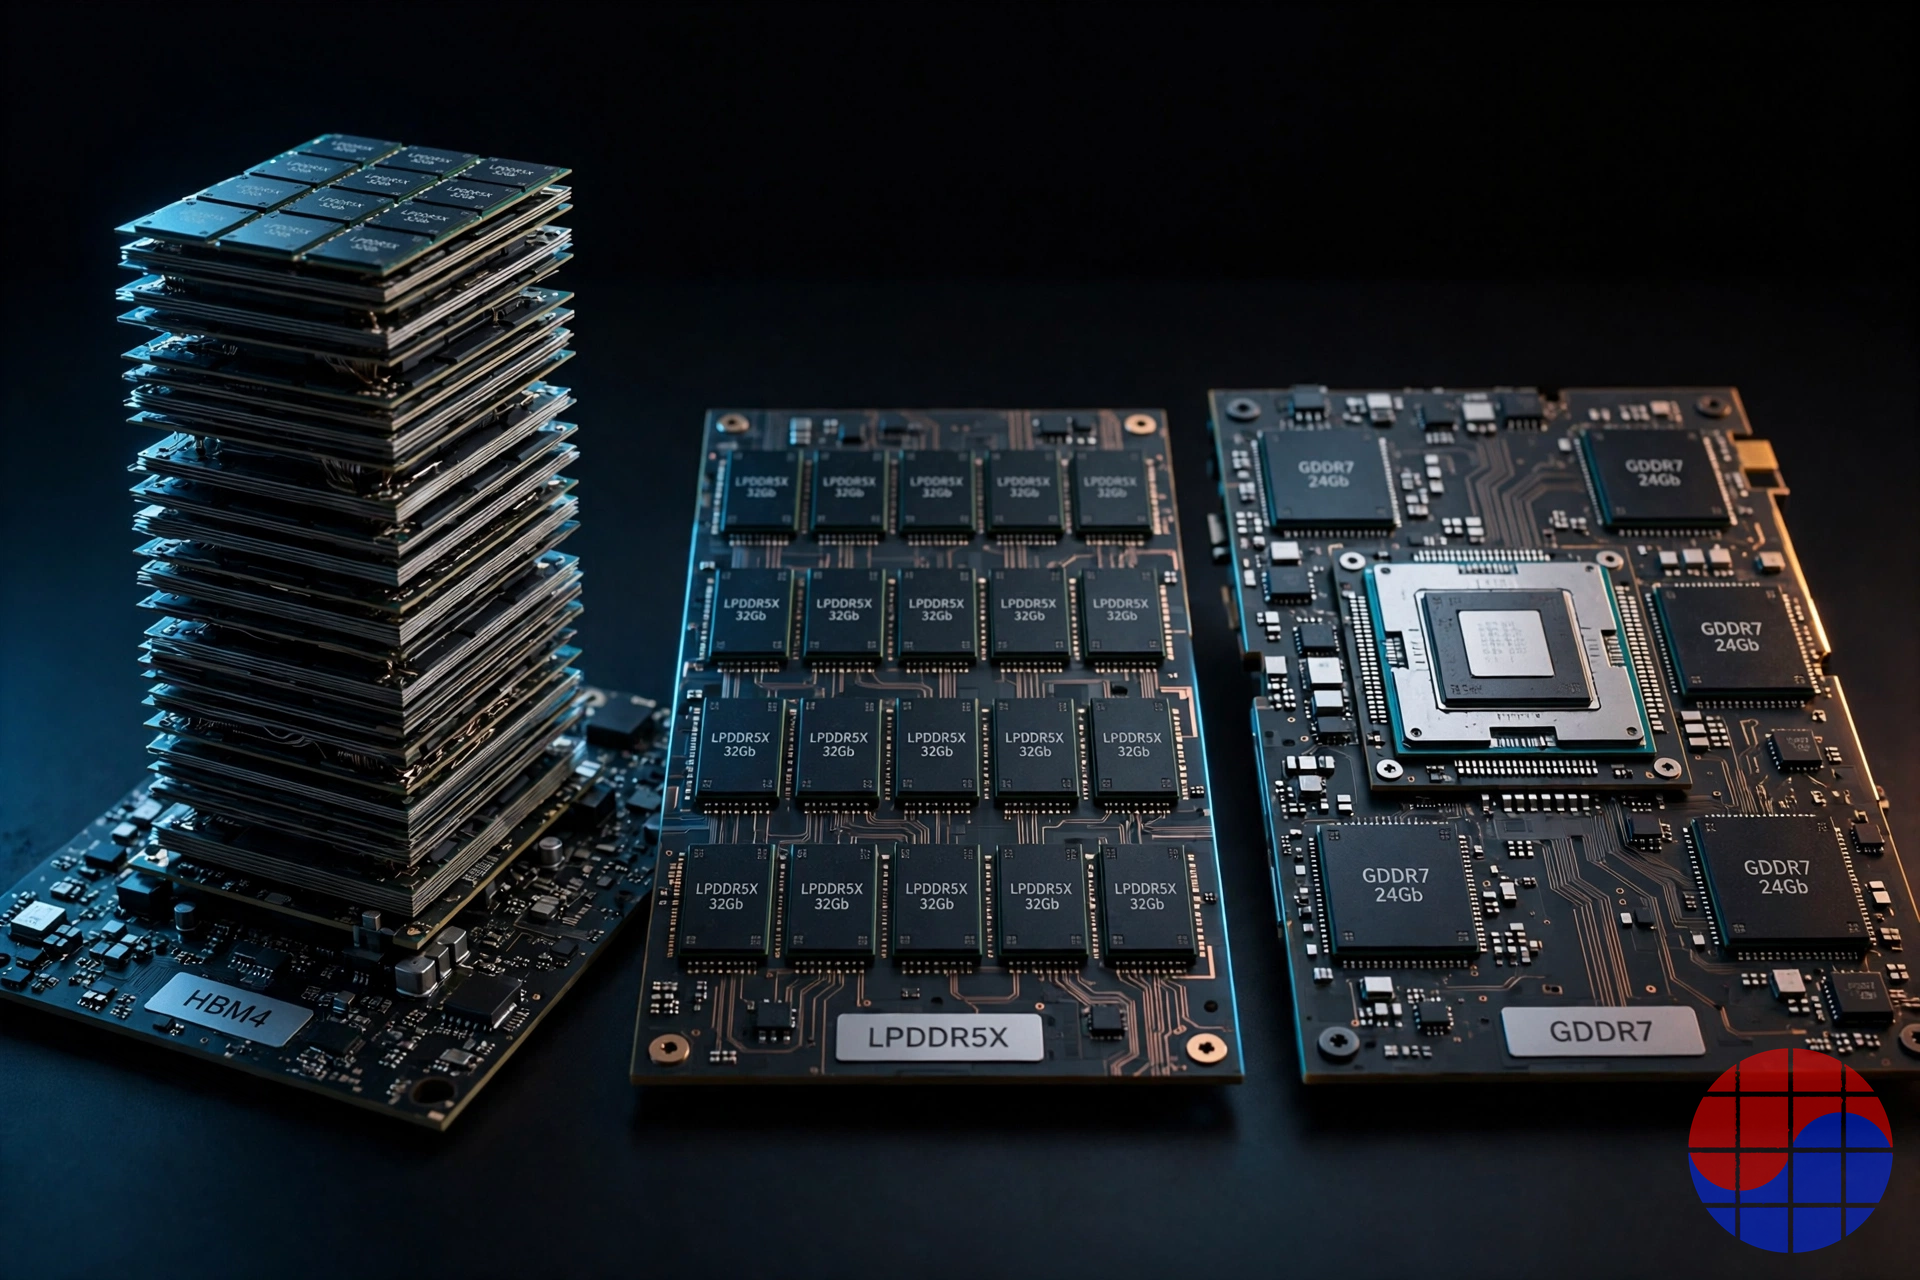
這張表不是排名,而是「用錢買掉哪個約束」的選擇題。HBM4 買頻寬,代價是容量單價與配額風險。GDDR7 便宜、頻寬也不差,但每晶片容量小,難以在單卡放下數百 GB 的模型。LPDDR5X 放棄頻寬,換取容量成本、可得性與功耗。當推論需求從「最快的 token」移向「最便宜的 token」,這張表的重心就往 LPDDR 傾斜。
對供應商的意涵:三星、SK 海力士、美光,以及 SOCAMM
對三大記憶體廠來說,訊號很簡單:AI 資料中心的 DRAM 需求不會只收斂到 HBM。CPU 側早已有大量 LPDDR 在流動。NVIDIA Grace 每顆 CPU 搭載最高 480GB LPDDR5X;後繼者 Vera 透過 SOCAMM2 模組擴充到最高 1.5TB、頻寬 1.2 TB/s。一座 Vera Rubin NVL72 機櫃有 36 顆 Vera CPU,光 CPU 記憶體就高達 54TB。當 D270 這類 LPDDR 加速器再加入,LPDDR 在資料中心的角色就從「CPU 旁邊的輔助記憶體」長成獨立的需求軸。
關鍵在模組化。LPDDR 本是焊死在板上的行動 零件,NVIDIA 以 SOCAMM 規格將其重新定義為可更換、可擴充的伺服器 零件。三星、SK 海力士與美光都參與 SOCAMM 供應,據報 NVIDIA 更把台灣的南亞科納入 Vera 的 LPDDR 供應鏈 — 供應商多元化本身,就是量體變大的證據。
從韓國業者的角度,這股需求是雙面刃。一方面,HBM 產能轉換掏空的通用 DRAM 市場,迎來了 AI 驅動的新需求池;2026 年 LPDDR5X 價格每季以兩位數百分比上漲,背後就有伺服器需求。另一方面,LPDDR 終究是通用 DRAM,沒有 HBM 式的超額利潤,還要直接面對 CXMT 等後進者的價格競爭。不過,量的方向毫無疑問:2027 年之後,AI 基礎設施的 LPDDR 位元需求,將從 CPU 插槽與推論加速器兩端結構性成長。
競爭格局:連 NVIDIA 都在 CPU 旁用 LPDDR
把 Intel 的選擇只讀成「搶不到 HBM 的公司的備案」,只看對了一半。地球上最大的 HBM 買家 NVIDIA,自己就採雙軌記憶體策略:GPU 用 HBM4,CPU 用 LPDDR5X,依工作負載性格把「需要頻寬」與「需要容量」的角色分開。從 Grace 到 Vera,CPU 記憶體容量由 480GB 增至 1.5TB、頻寬由 512 GB/s 升至 1.2 TB/s;在 NVIDIA 的判斷裡,代理型 AI 時代的 CPU 是該背更多記憶體的零件。
AMD 站在對面:MI 系列維持 GPU 全面 HBM 的正統路線,推論也以頻寬決勝負。客製 ASIC 陣營則兩邊都有 — Google TPU 與 AWS Trainium 選 HBM,Meta MTIA 選 LPDDR 等級記憶體。業界正在形成的共識是兩層結構:訓練與前沿服務用 HBM;其下的大規模推論與 CPU 記憶體,則由 LPDDR 成長。Intel D270 是第一個以 GPU 形式大規模攻打下層的嘗試。
Chase's Take
拿掉品牌包裝,這款產品的本質是一套穿上 GPU 外衣的記憶體採購策略。Intel 避開了運算上贏不了的戰場,端出用 2026~2027 年真正買得到的記憶體所能做出的最大推論容量。1.3 PFLOPS 這個數字平平無奇,但「350W 氣冷卡上的 480GB」這個組合,是對手產品清單上不存在的座標。
對韓國記憶體業而言,這是安靜的順風。在 HBM 華麗單價的背後,伺服器 LPDDR 這個第二條 AI 需求軸,正凝固成真實量體。當 Vera 每插槽 1.5TB 與 D270 每卡最高 480GB 同時開始出貨,LPDDR5X 的價格表將從手機零件被改寫為 AI 基礎設施零件。但要留意:LPDDR 漲價會反噬 Intel 自己的 TCO 邏輯。LPDDR 越貴,「便宜記憶體造就便宜推論」方程式的利潤就越薄。這款產品的成敗,將由記憶體價格曲線決定,而不是由矽晶本身。
想一併看推論記憶體成本結構與 HBM 陣營數字的對照分析,可參考:No HBM Needed? Intel's 480GB LPDDR5X Bet and the Inference Memory TCO War
風險與尚未確認事項
第一,性能數字的性質:1.3 PFLOPS 是理論峰值,尚無獨立基準測試;實際 token 吞吐量高度取決於核心最佳化與軟體堆疊成熟度。第二,軟體生態:CUDA 的慣性在推論市場同樣強大,OpenVINO/oneAPI 堆疊能否順暢銜接生產級服務框架,將是採用與否的關卡 — Intel 前作 Gaudi 輸在生態而非矽晶的前例不能忽視。第三,頻寬天花板:1.5 TB/s 在超大模型的高批次解碼下可能成為瓶頸,Intel 自己也劃清界線,不以訓練與前沿服務為競爭領域。第四,商業條件仍是空白:價格與正式上市日未公布,大量出貨被討論在 2027 年;屆時 HBM4E 已登場、LPDDR 價格可能再漲,競爭地圖會被重畫。最後,市場的第一反應偏冷淡 — 據報 Intel 股價在發布當日收跌。
FAQ
Q: Intel GPU D270 的 LPDDR5X 480GB 是確定規格嗎? A: 作為最大配置是事實,但 Intel 自家卡的容量是 160GB。480GB 是 ODM 以高密度封裝(192Gb 級)實裝的板卡才能達到的上限。社群上多數「480GB」的引用都漏了這個條件。
Q: 為什麼推論 GPU 用 LPDDR5X 而不用 HBM? A: 因為生產級推論的約束不在原始運算,而在放下模型與 KV 快取的容量,以及每 token 成本。LPDDR5X 的每 GB 成本被討論為不到 HBM4 的一半,採購容易得多,功耗也更低。這是犧牲峰值頻寬、贏在容量與成本的設計。
Q: D270 的 1.5 TB/s 頻寬是什麼水準? A: 低於單顆 HBM4 堆疊(2.8 TB/s 以上),與旗艦加速器的數十 TB/s 差了一個數量級;但與 512-bit GDDR7 配置(約 1.8 TB/s)處於相近區間。這是為每瓦與每美元容量而戰的數字,不是為絕對吞吐而戰。
Q: 這對三星電子與 SK 海力士意味著什麼? A: 意味著 AI 資料中心的 LPDDR 需求正從伺服器 CPU(NVIDIA Grace 與 Vera 的 SOCAMM)擴散到推論加速器。利潤比不上 HBM,但結構性量體成長可期,且兩家公司都在 SOCAMM 供應鏈之內。
Q: D270 何時上市、售價多少? A: 截至 2026 年 10 月,產品處於客戶送樣階段。Intel 尚未公布價格與正式上市日期,大量出貨時點被討論在 2027 年。
📩 訂閱 VLSI Korea 電子報
每日半導體深度分析,第一時間寄到您的信箱。免費訂閱。