 VLSI Korea
推理走SRAM、训练靠HBM:5个事实 (Groq 3 LPX·Trainium3)
AI 推理正在分裂。解码转向没有 HBM 的 SRAM 芯片 Groq 3 LPX,训练则靠每颗芯片 HBM3e 144GB 的 Trainium3。用带宽约 57 倍与容量约 162 倍的不对称,以及站在两侧的 Samsung,整理 5 个事实。(截至 2026 年 10 月 24 日)


AI 推理正在分裂为两条路线。对延迟敏感的解码正在转向没有 HBM 的 SRAM 芯片,训练和预填充则继续留在 HBM 容量之上。(截至 2026 年 10 月 24 日)
30秒摘要
- NVIDIA Groq 3 LPX 已进入量产阶段。LP30 芯片没有 HBM,每颗芯片提供 SRAM 500MB 和 150 TB/s 带宽(NVIDIA 发布,Hot Chips 2026,2026 年 8 月 24-25 日)。
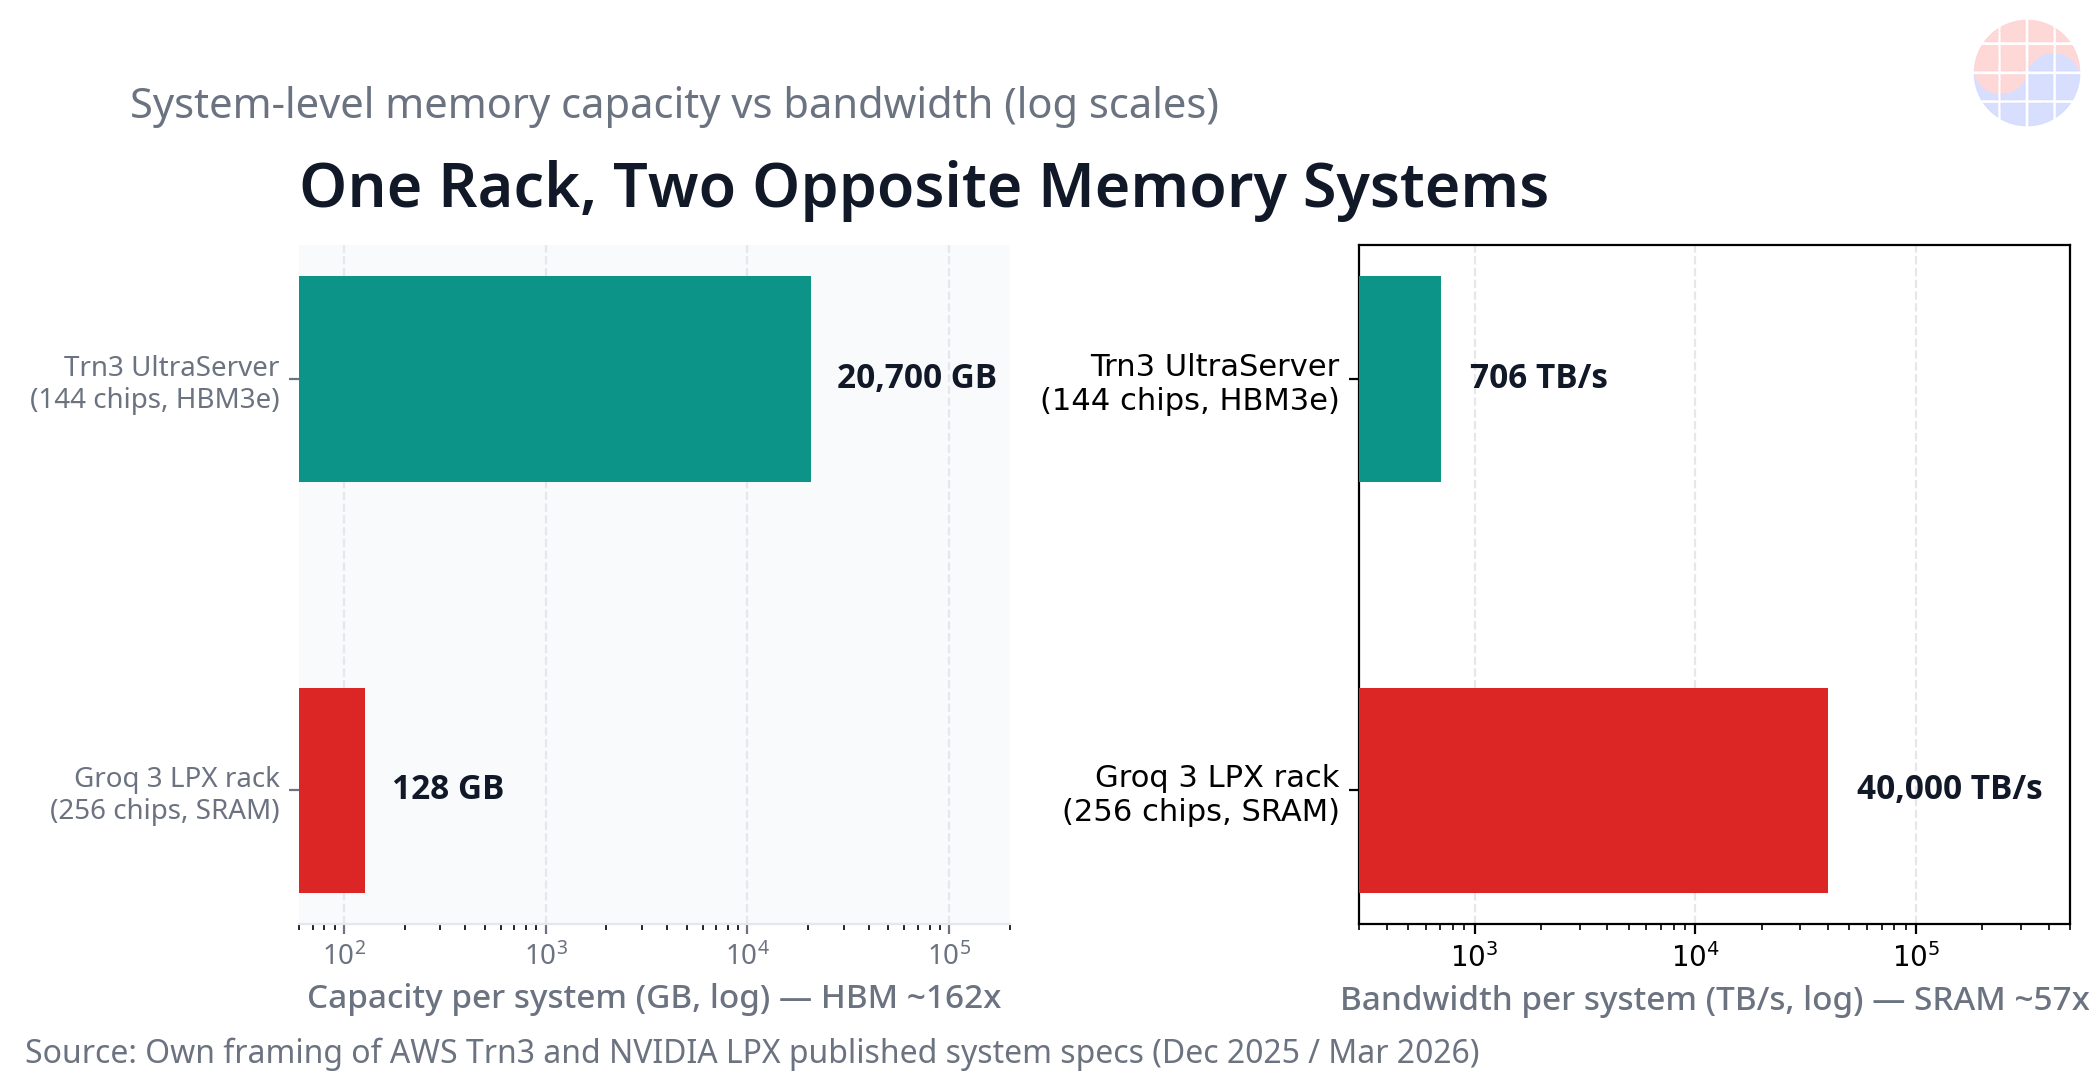
- 根据自行计算,以机架为单位,SRAM 一侧的内存带宽约大 57 倍,HBM 一侧的内存容量约大 162 倍。这种不对称正是分裂的本质。
- 训练阵营正在以 HBM 容量固化。AWS Trainium3 每颗芯片搭载 HBM3e 144GB,2026 年 10 月 19 日发布的 TorchNeuron 降低了 PyTorch 移植门槛(AWS 发布)。
- Samsung 站在分裂的两侧。它既谋求 HBM 供应,同时也是没有 HBM 的 LP30 的独家代工厂。
- SK hynix 纯粹暴露在 HBM 一侧,但短期 HBM 需求由训练支撑。SRAM 所限制的,只是推理中对延迟支付溢价的解码片段。
背景
推理分为性质不同的两个阶段。预填充是一次性读入长输入上下文的阶段,计算量和内存容量至关重要。解码是逐个吐出 token 的阶段,每生成一个 token,都必须重新读取整个模型权重。因此,解码的速度实际上由内存带宽和延迟决定。
迄今为止,GPU 与 HBM 的组合一直承担着这两个阶段。HBM 容量大,但它是位于芯片之外的内存,带宽和延迟存在物理极限。相反,SRAM 位于芯片内部,带宽压倒性地快,但容量小,且占用大量裸晶面积。这种权衡早已为人所知。第 1 代 GroqChip 主打 SRAM 230MB 和最高 80 TB/s 的片上带宽(Groq 2022 年产品简报,厂商规格),Cerebras WSE-3 则以片上 SRAM 44GB 和 21 PB/s 带宽,把同样的理念推向了晶圆级规模的极致(Cerebras 2024 年公开规格)。
改变格局的契机是一笔许可交易。Groq 于 2025 年 12 月 24 日宣布与 NVIDIA 达成非独占许可协议,包括创始人 Jonathan Ross 和总裁 Sunny Madra 在内的核心团队加入了 NVIDIA。Groq 本身仍保持独立公司地位,由 Simon Edwards 担任 CEO,GroqCloud 不在交易范围内(Groq 发布,2025 年 12 月 24 日)。交易规模约 200 亿美元这一数字属于报道内容,并非 NVIDIA 官方公开的金额。
深度解析:5个事实
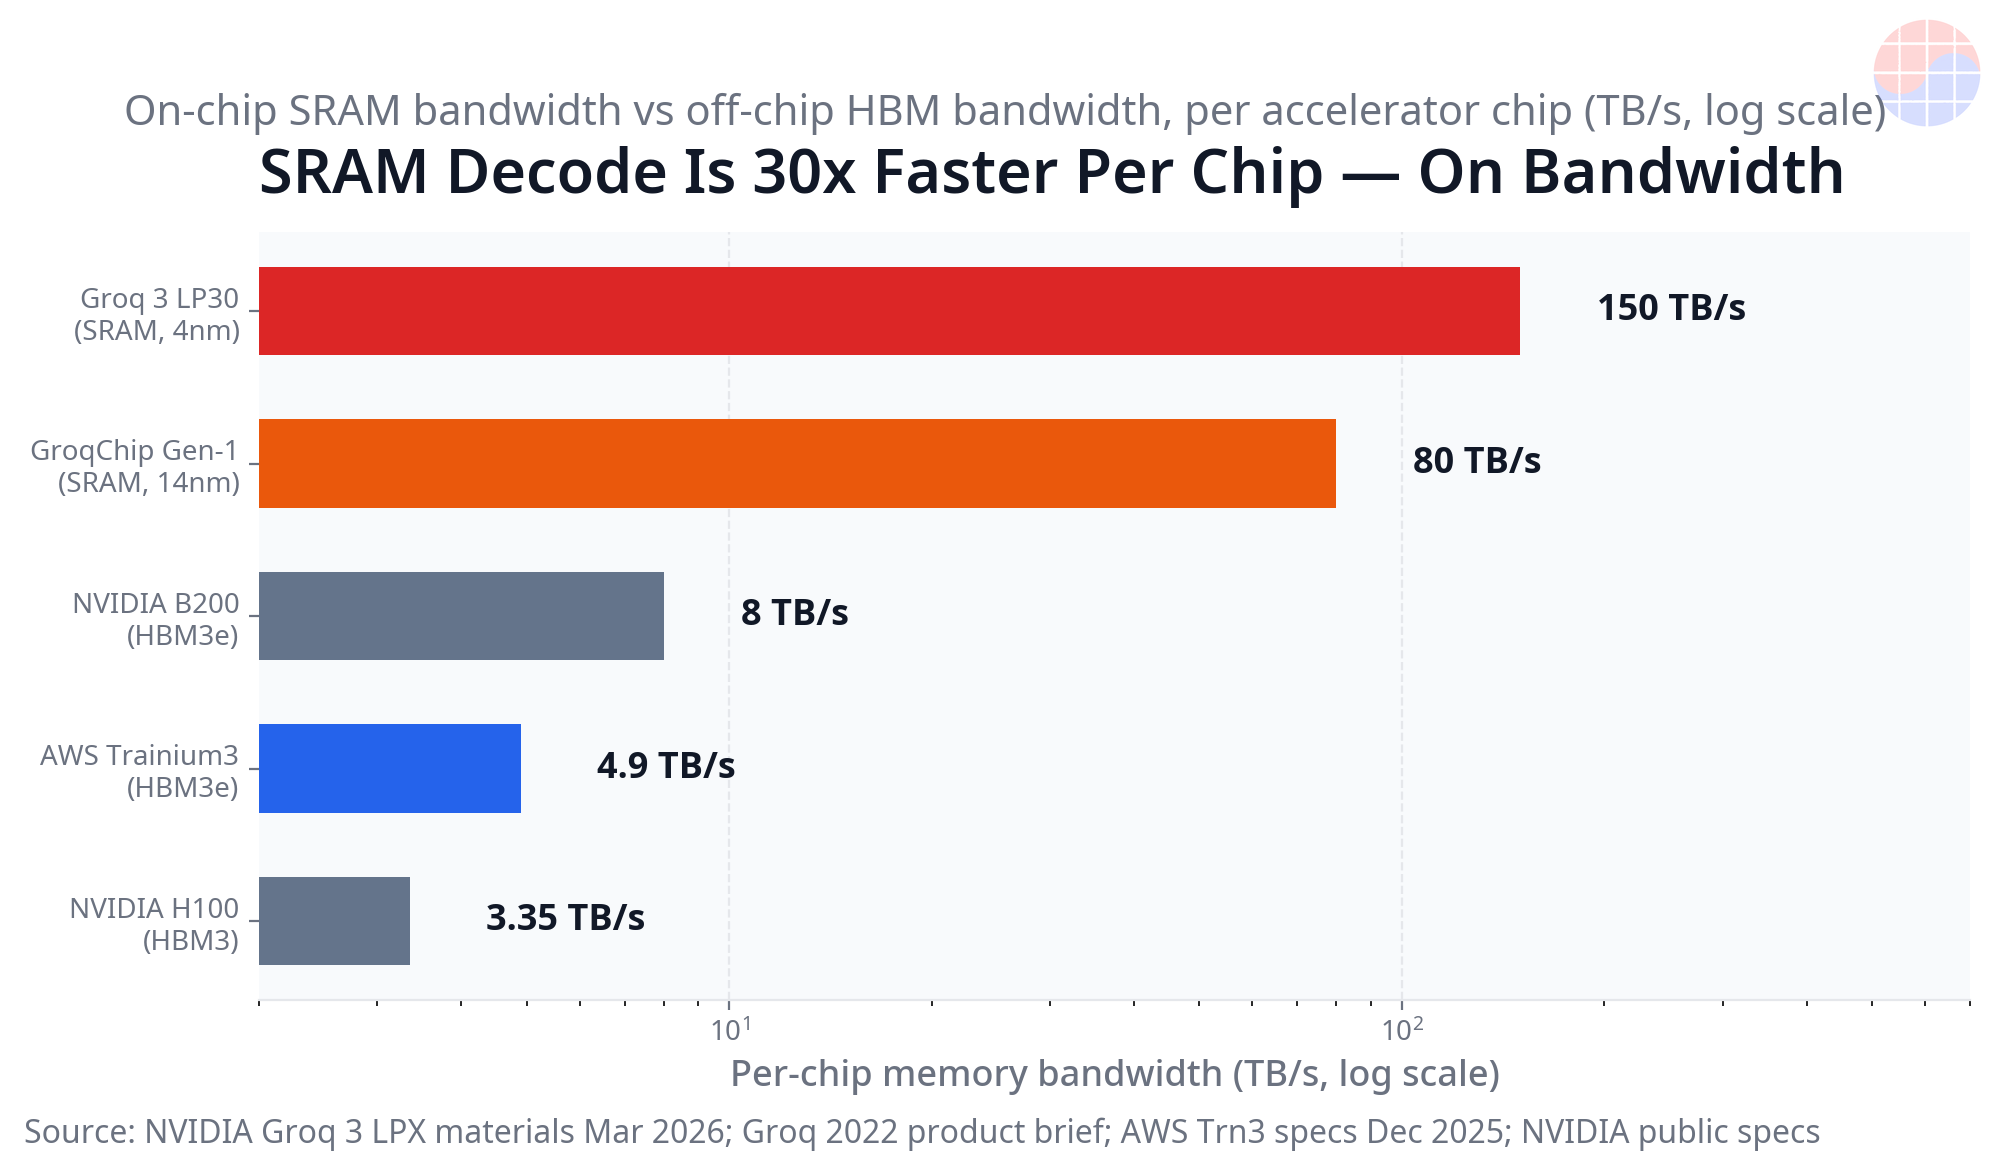
- LPX 已进入量产阶段,芯片上没有 HBM。 NVIDIA 在 GTC 2026 年 3 月公开了 Groq 3 LPX,并在 Hot Chips 2026(2026 年 8 月 24-25 日)宣布全面量产。LP30 芯片提供每颗芯片 SRAM 500MB、SRAM 带宽 150 TB/s、96 条芯片间链路且每条 112 Gbps、每颗芯片扩展带宽 2.5 TB/s、芯片间延迟 350ns(NVIDIA 产品及技术资料)。以机架为单位,它将 32 个托盘中的 256 颗芯片组合在一起,提供 SRAM 合计 128GB、合计 SRAM 带宽 40 PB/s、扩展带宽 640 TB/s、FP8 推理算力 315 PFLOPS。在平台设计上,这是一种异构配置:Rubin GPU 负责长上下文预填充和解码注意力,LPU 负责解码中对延迟敏感的前馈和 MoE 运算(NVIDIA 设计)。按照厂商的说法,NVIDIA 表示,将 LPX 与 Vera Rubin NVL72 结合时,在万亿参数模型上,每兆瓦推理吞吐量最高可提升到 35 倍。在第三方基准测试中,以预发布的 Gemma 4 31B 端点(Google Cloud,上下文 100k token,并发 1,50 次顺序请求的中位数)为基准,每秒输出 token 达 3,400 个,约为该测试中最接近的替代平台的 4 倍(Artificial Analysis 测量,NVIDIA 引用的结果)。需要明确指出,这一数字是单用户延迟测试结果,并非批处理吞吐量测试。首个客户是 Nebius,NVIDIA 表示,云供应将于 2026 年下半年通过 AWS、Google Cloud、Microsoft Azure、Oracle 开始。制造由 Samsung Foundry 4nm 独家承担。Jensen Huang 在 GTC 2026 年 3 月的舞台上表示,Samsung 正在制造 Groq 3 LPU 芯片,出货将于下半年、大约第 3 季度开始,Samsung 在 2026 年 6 月确认 LP30 正在生产中。根据 2026 年 10 月 13 日的报道,Samsung 在 OCP 2026 上展出了 Groq LPU 晶圆,芯片正在平泽量产。
- 带宽与容量的不对称是这种分裂的本质(自行计算)。 以芯片为单位比较,LP30 的 SRAM 带宽 150 TB/s 约为 Trainium3 的 HBM3e 带宽 4.9 TB/s 的 31 倍,约为 H100 的 3.35 TB/s 的 45 倍。扩大到机架单位,LPX 的 40 PB/s,即 40,000 TB/s,约为 Trn3 UltraServer 合计带宽 706 TB/s 的 57 倍。然而在容量上,图景恰好反转。Trn3 UltraServer 的 HBM 20.7 TB 约为 LPX 机架 SRAM 128GB 的 162 倍。仅看权重的适配计算(以 FP8 为准,每参数 1 字节,不含 KV 缓存)同样清楚地显示了这种不对称。70B 模型的权重为 70GB,可以放入 1 台 LPX 机架,但 405B 模型为 405GB,至少需要 4 台,1 万亿参数模型为 1,000GB,至少需要 8 台。相反,这三个模型全都可以放入 1 台 Trn3 UltraServer,且留有很大余量。与第 1 代 GroqChip(SRAM 230MB)仅权重就需要约 305 颗芯片才能装下 70B 模型相比,LP30 的 500MB 在容量的壁垒面前仍然很小。总之,SRAM 赢在带宽,HBM 赢在容量,两者并非一方替代另一方的关系(截至 2026 年 10 月 24 日的自行计算)。
- 训练阵营正在以 HBM 容量固化,软件门槛已经降低。 AWS 在 re:Invent 上于 2025 年 12 月 2 日正式发布了 Trainium3。TSMC 3nm 工艺、每颗芯片 FP8 算力 2.52 PFLOPS、HBM3e 144GB、带宽 4.9 TB/s 为官方规格(AWS Trn3 官方页面)。由 144 颗芯片组成的 Trn3 UltraServer 提供 FP8 362 PFLOPS、HBM3e 20.7 TB、合计带宽 706 TB/s。AWS 声称,与 Trainium2 相比,算力提升 4.4 倍,内存带宽提升约 4 倍,这是厂商的说法。在量产规模方面,AWS 与 Anthropic 的 Project Rainier 于 2025 年下半年开始运行,使用约 50 万颗 Trainium2 训练 Claude,并正在扩展到约 100 万颗的规模。据 2026 年 10 月的报道,Anthropic 签订了 10 年内超过 1,000 亿美元的 AWS 容量承诺,OpenAI 的 380 亿美元规模 AWS 合同中包括约 2GW 的 Trainium 容量,据报道。这两个数字均为报道内容。与此同时,软件层面的变化叠加了进来。Amazon 于 2026 年 10 月 19 日发布了 TorchNeuron,并于 2026 年 10 月 20 日在 PyTorch Conference North America 开始公开测试。TorchNeuron 是 Apache 2.0 开源软件,它放弃了既有的 XLA 路径,采用 PyTorch 原生设备后端,支持 eager 模式和 torch.compile、FSDP 和 DTensor。AWS 将其定位为消除转向 Trainium 训练时的软件移植门槛的手段。
- Samsung 站在分裂的两侧,SK hynix 站在 HBM 一侧。 Samsung 在谋求恢复在 NVIDIA GPU 平台上的 HBM 份额的同时,也是根本没有 HBM 的 LP30 的独家代工厂。因此,解码向 SRAM 的迁移对 Samsung 来说并不只是损失。因为这是 HBM 一侧的部分风险转化为平泽 4nm 代工量的结构。为了把握量级感的一个示例计算(自行计算,示例)是,1 台 LPX 机架由 Samsung 制造的 256 颗 4nm LPU 组成,1,000 台机架就需要 256,000 颗 LPU。相反,SK hynix 是纯粹暴露在 HBM 一侧的结构。但这并不意味着 HBM 需求会立即减少。训练和预填充会继续消耗 HBM。只要 Rainier 从约 50 万颗扩展到约 100 万颗芯片,且每一颗下一代 Trainium3 芯片都搭载 HBM3e 144GB,近期 HBM 需求就没有理由因 SRAM 解码而被削弱。截至 2026 年 10 月 24 日的解读是,SRAM 所限制的,只是 HBM 增长叙事中的推理区间,其中也仅限于为延迟支付溢价的解码片段。
- 能够反驳这种分裂的条件也已经显现。 第一,NVIDIA 自身的设计就把解码注意力留在了 Rubin GPU,即 HBM 一侧。分裂发生在机架内部,并非赢家通吃。第二,容量计算在万亿级模型上对 SRAM 一侧不利。1 万亿参数模型仅 FP8 权重就需要至少 8 台 LPX 机架,再加上长上下文下膨胀的 KV 缓存,所需台数还会进一步增加。也就是说,上下文越长,容量的壁垒就越大。第三,是中国变量。SRAM 解码路线理论上不需要高端 HBM,可以绕开 HBM 出口管制的瓶颈,但截至 2026 年 10 月 24 日,尚无已公开量产的中国产 SRAM 解码加速器。原因在于结构层面。以 SRAM 为主的裸晶占用面积大(LP30 在 4nm 上每颗芯片 SRAM 500MB),其先进逻辑工艺本身就是受限制对象,而真正的护城河不在于内存单元,而在于使确定性执行成为可能的编译器。本段关于中国的评价属于解读。
Chase 的观点
解码是延迟的生意,训练是容量的生意。曾被称为一道内存墙的东西,实际上分裂成了两道墙。一道是阻挡解码的带宽之墙,另一道是阻挡训练、预填充和长上下文的容量之墙。每一道墙,胜出的硅片都不同。
从业者视角下有趣的点在别处。由编译器预先决定执行顺序的确定性芯片,把难题从运行时硬件仲裁转移到了编译时调度。一台由 256 颗芯片以 350ns 链路连接的机架,整体与一个巨大的 static timing 问题无异。归根结底,掌握编译器的一方,就掌握了架构。
接下来要确认的有四件事。第一,在 2026 年第 4 季度业绩发布中,LPX 机架出货量是否会以数字形式出现。第二,作为独立公司留存的 Groq,在与 NVIDIA 内部自有许可设计竞争的同时,能否守住云推理份额。第三,在 TorchNeuron 之后,继 Anthropic 和 OpenAI 的承诺之后,是否会有第二家前沿实验室加入 Trainium 训练。第四,在下一代 Rubin 中,GPU 一侧的解码比重是变大还是变小。
启示
看待内存供需的问题本身变了。不再只是 HBM 有多快,而是要区分内存附着在哪一个区间。用于训练和预填充的 HBM 需求曲线,与用于解码的 SRAM 及代工需求曲线,以不同的速度移动。
从代工的视角看,正如平泽案例所示,并非最先进的 4nm 级产线也可以站在 AI 量的中心。解码芯片的竞争力,不由最新工艺决定,而由 SRAM 密度和良率,以及与编译器的共同优化决定。
对模型服务运营商来说,混合配置会改变成本结构。其方式是,只把为延迟支付溢价的区间剥离给 SRAM,其余部分留在 GPU 上。但正如万亿级模型至少需要 8 台机架这一计算所显示的那样,在小规模服务中,GPU 默认值并不容易被推翻。
收窄到韩国供应链,Samsung 是具备双面对冲的一方,SK hynix 是暴露在训练周期下的一方。截至 2026 年 10 月 24 日的解读是,即使在同一个内存分岔点,两家公司的风险画像也会以不同的方式移动。
常见问题
Q. 如果 SRAM 解码扩散,HBM 需求会减少吗? A. 短期内不会减少。截至 2026 年 10 月 24 日,训练、预填充以及解码注意力仍留在 HBM 上,SRAM 承担的区间只是对延迟敏感的解码的一部分。AWS Project Rainier 正在从约 50 万颗 Trainium2 扩展到约 100 万颗,Trainium3 每颗芯片搭载 144GB 的 HBM3e。SRAM 所限制的,只是 HBM 增长叙事中的推理,其中也仅限于延迟溢价解码片段。
Q. 一台 Groq 3 LPX 机架能运行 1 万亿参数模型吗? A. 仅凭权重不行。根据自行计算,以 FP8 为准,1 万亿参数权重为 1,000GB,因此 SRAM 128GB 的机架至少需要 8 台。70B 模型为 70GB,可以放入 1 台机架,405B 模型至少需要 4 台。相反,搭载 HBM 20.7 TB 的 AWS Trn3 UltraServer 可以在 1 台内宽裕地容纳这三个模型。
Q. Samsung 在这种分裂中是受损还是受益? A. 因为它站在两侧,所以并非简单的受损。Samsung 在谋求恢复在 NVIDIA GPU 平台上的 HBM 份额的同时,也是没有 HBM 的 Groq 3 LP30 的独家代工厂。如果解码转向 SRAM,HBM 风险的一部分就会转化为平泽 4nm 代工量。根据自行计算,1 台 LPX 机架是 Samsung 制造的 256 颗 LPU,1,000 台就是 256,000 颗。
Q. 中国能通过 SRAM 解码绕开 HBM 出口管制吗? A. 理论上是一条可能的路径,但截至 2026 年 10 月 24 日,尚无已公开量产的中国产 SRAM 解码加速器。这是因为以 SRAM 为主的裸晶占用面积大,本身就需要受约束的先进逻辑工艺,而真正的护城河不在于内存单元,而在于编译器调度。本段的评价属于解读。
本文是基于截至 2026 年 10 月 24 日的公开发布和报道的分析,并非投资建议。厂商数字以各公司发布为准,报道的交易规模和承诺规模并非官方确认的数字。
📩 今天错过的分析,明天早上发到您的邮箱
每天10:30(KST)Daily Silicon与财报·机构报告核心解读抢先送达。订阅后可选择韩语/英语/日语新闻通讯,中文深度分析每日在网站更新。
免费订阅 →
免费 · 无垃圾邮件 · 随时退订


