VLSI Korea
Pabrik AI dalam 14 Hari, Bukan 6 Bulan: Produksi Vera Rubin dan Strategi Kecepatan DSX POD (HBM4)
Vera Rubin sudah produksi penuh dan DSX POD memangkas penerapan di situs yang disiapkan dari sekitar 6 bulan menjadi 14 hari. Satu kontainer: 7 rak NVL72, 504 GPU. Kecepatan kini adalah pendapatan.


Hambatan infrastruktur AI kini bukan lagi chip. Hambatannya adalah lokasi konstruksi — dan NVIDIA baru saja memindahkan pabrik itu ke dalam pabrik.
Ringkasan 30 Detik
- Vera Rubin sudah masuk produksi penuh. Di GTC Berlin pada 21 Oktober 2026, CEO Jensen Huang mengumumkan bahwa platform AI NVIDIA berikutnya telah memasuki produksi penuh (full production).
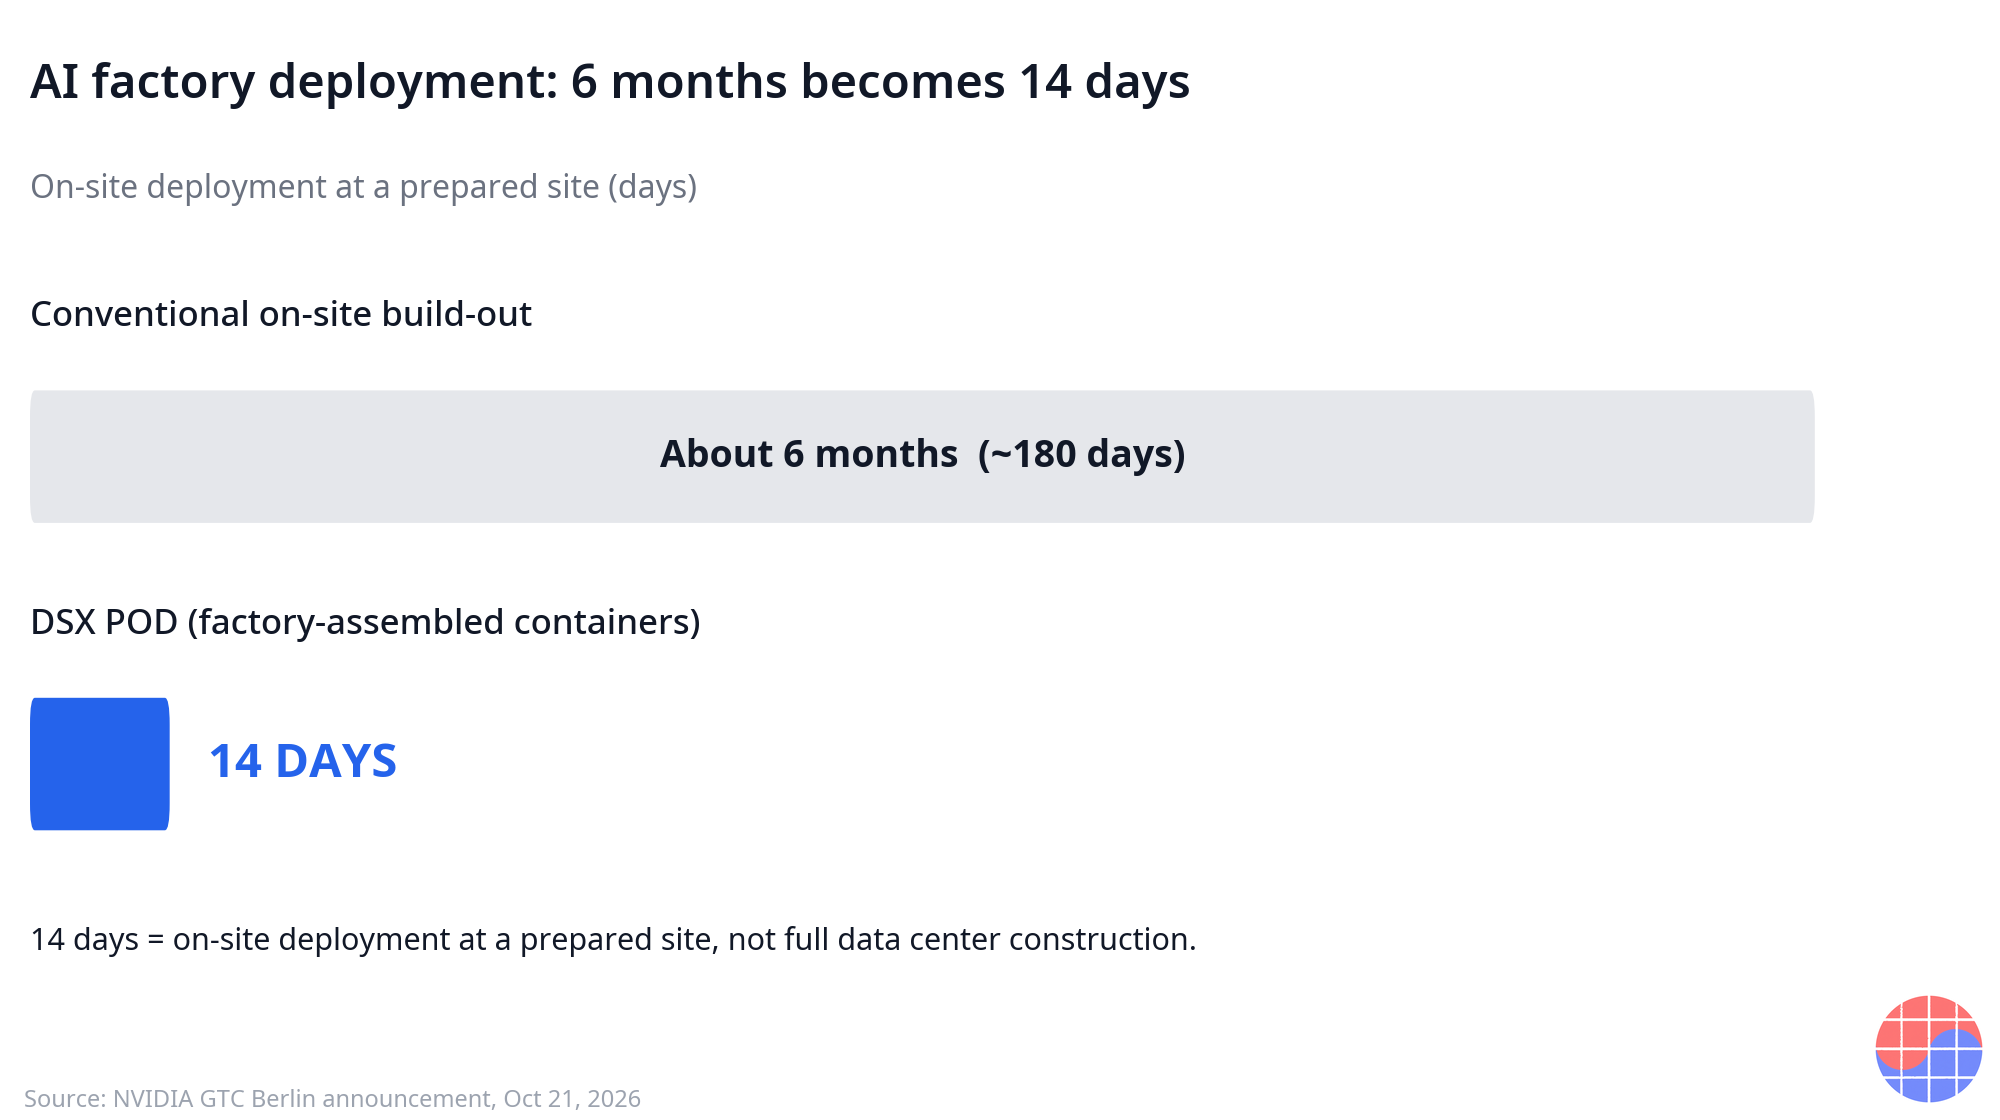
- DSX POD mengubah pabrik AI menjadi produk yang bisa dikirim. Desain referensi ini merakit dan menguji seluruh pabrik AI Vera Rubin di dalam kontainer modular di pabrik, lalu mengirimkannya. Penerapan di lokasi, pada situs yang sudah disiapkan, turun dari sekitar 6 bulan menjadi paling cepat 14 hari.
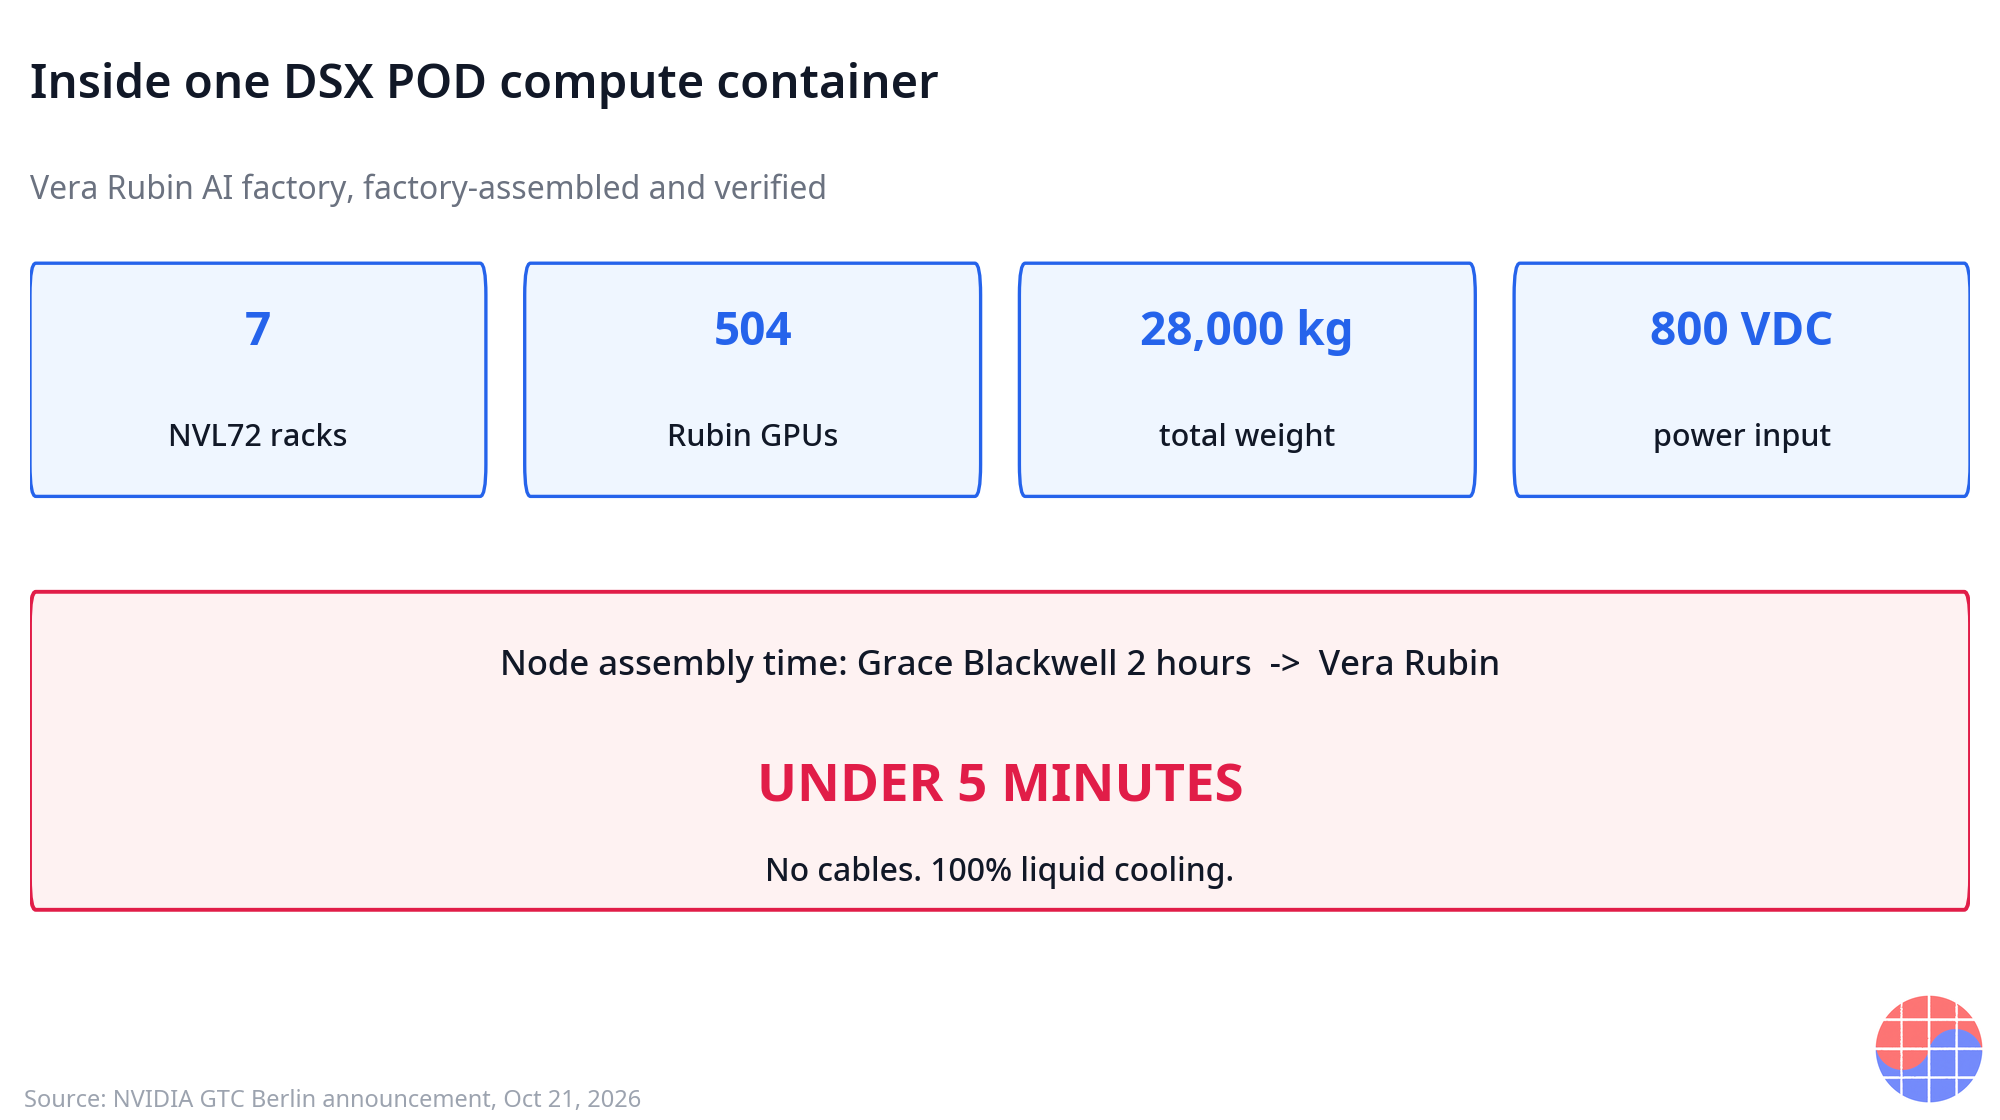
- Satu kontainer komputasi adalah mesin yang serius: 7 rak Vera Rubin NVL72, 504 GPU Rubin, sekitar 28.000 kg, dialiri daya 800 VDC. Satu kontainer bukan lagi sekadar kotak. Ia adalah blok penyusun sebuah pusat data.
- Node itu sendiri didesain ulang demi kecepatan perakitan. Node Vera Rubin tidak memiliki kabel, 100% berpendingin cairan, dan memangkas waktu perakitan node dari 2 jam pada Grace Blackwell menjadi di bawah 5 menit.
- 17 mitra mendukung desain ini, termasuk Dell, HPE, Lenovo, Schneider Electric, Vertiv, Eaton, dan Foxconn (Ingrasys), dengan pengiriman direncanakan mulai awal 2027. Angka 14 hari perlu dibaca dengan cermat: itu adalah penerapan di lokasi pada situs yang infrastruktur daya dan pendinginnya sudah disiapkan — bukan masa konstruksi sebuah pusat data secara keseluruhan.
Latar Belakang
Antrean berpindah dari fab ke lapangan
Selama tiga tahun, kisah infrastruktur AI adalah kisah pasokan chip. GPU langka, HBM langka, pengemasan lanjutan langka, dan siapa pun yang mengamankan wafer dan memori mengamankan pendapatan. Kelangkaan itu belum hilang, tetapi di belakangnya terbentuk antrean kedua: pekerjaan fisik mengubah perangkat keras yang sudah dikirim menjadi pabrik AI yang berjalan. Rak tiba, lalu dimulailah integrasi di lokasi selama berbulan-bulan — distribusi daya, loop pendingin, jaringan, perakitan node demi node, pengujian, dan debugging, sebagian besar dikerjakan oleh insinyur lapangan yang langka di gedung yang sendiri masih dibangun.
Pengumuman NVIDIA pada 21 Oktober 2026 di GTC Berlin menyerang antrean kedua itu secara langsung. Berita platformnya adalah bahwa Vera Rubin, arsitektur penerus Grace Blackwell, telah masuk produksi penuh, menurut kata-kata CEO Jensen Huang. Berita bisnisnya adalah DSX POD: desain referensi di mana seluruh pabrik AI Vera Rubin dirakit dan diverifikasi dalam kontainer modular sebelum meninggalkan pabrik, sehingga situs menerima sistem yang sudah teruji, bukan tumpukan komponen.
Apa sebenarnya DSX POD itu
DSX POD paling mudah dipahami sebagai perubahan tempat integrasi terjadi. Dalam model konvensional, integrasi terjadi di tujuan, di bawah kondisi lokasi konstruksi dan variasinya. Dalam model POD, integrasi terjadi di asal, di bawah kondisi pabrik, tempat tugas yang sama diulang, diukur, dan diperbaiki. Kontainer adalah unit pengiriman: kontainer komputasi membawa rak, dan desainnya dispesifikasikan cukup ketat sehingga isi sebuah kontainer sudah diketahui hingga kilogram dan volt sebelum dikirim.
| Kontainer komputasi DSX POD | Spesifikasi |
|---|---|
| Rak per kontainer | 7 rak Vera Rubin NVL72 |
| GPU per kontainer | 504 GPU Rubin |
| Berat | Sekitar 28.000 kg |
| Input daya | 800 VDC |
| Desain node | Tanpa kabel, 100% pendingin cairan |
| Waktu perakitan node | Di bawah 5 menit (Grace Blackwell: 2 jam) |
Sumber: pengumuman NVIDIA di GTC Berlin, 21 Oktober 2026. Tautan ada di catatan kaki.
Angka perakitan node layak untuk direnungkan. Memangkas perakitan dari 2 jam menjadi di bawah 5 menit bukanlah fitur kenyamanan. Itu adalah hasil ketika sebuah platform didesain mundur dari proses penerapannya: perkabelan, yang secara historis menyumbang porsi besar waktu perakitan sekaligus kesalahan lapangan, dihilangkan sepenuhnya dari node, dan pendinginan beralih sepenuhnya ke cairan. Node yang dirakit dalam hitungan menit juga adalah node yang diganti dalam hitungan menit, dan itu mengubah ekonomi pemeliharaan seluruh basis terpasang selama satu dekade.
Angka 14 hari, dinyatakan dengan tepat
Angka yang paling banyak dikutip dari pengumuman ini — penerapan paling cepat 14 hari, berbanding sekitar 6 bulan pembangunan konvensional di lokasi — memerlukan syaratnya dicantumkan, karena syarat itulah tempat model bisnisnya hidup. 14 hari adalah masa penerapan di lokasi pada situs yang sudah disiapkan: situs yang infrastruktur daya, pendingin, dan gedungnya sudah tersedia. Itu bukan masa konstruksi sebuah pusat data secara keseluruhan. Lahan, perizinan, sambungan jaringan listrik, dan kerangka gedung tetap memakan waktu selama yang dibutuhkan.
Perbedaan itu tidak melemahkan pengumuman ini. Ia justru memperjelas siapa yang menangkap nilai. POD memampatkan segmen jadwal yang berada di antara "infrastruktur siap" dan "pabrik AI menghasilkan token" — segmen yang menentukan kapan modal pelanggan mulai menghasilkan uang. Semua yang berada sebelum situs yang disiapkan tetap merupakan persoalan konstruksi dan utilitas, dan justru karena itulah daftar mitra sama pentingnya dengan kontainer itu sendiri.
Penyelaman Bisnis
Kecepatan adalah pengakuan pendapatan
Dalam infrastruktur AI, kecepatan penerapan bukanlah hal kecil dalam operasional. Ia adalah kemiringan kurva pendapatan. Hyperscaler atau operator pabrik AI yang mengaktifkan kapasitas beberapa bulan lebih awal mulai menjual token, pekerjaan pelatihan, dan instans cloud beberapa bulan lebih awal, pada perangkat keras yang paruh waktu kompetitifnya diukur dalam kuartal. Ketika satu generasi platform bertahan kira-kira satu tahun di garis depan, ekor integrasi selama 6 bulan dapat menghabiskan separuh umur ekonomi aset sebelum aset itu menghasilkan dolar pertamanya pada utilisasi penuh.
Itulah lensa untuk DSX POD. Memperpendek penerapan di situs yang disiapkan dari sekitar 6 bulan menjadi paling cepat 14 hari menarik pendapatan maju beberapa bulan per situs, dan itu terjadi tepat pada saat permintaan komputasi AI sedang mengantre. Yang dibeli pelanggan bukanlah kontainer. Yang dibeli pelanggan adalah waktu kalender — input paling langka dalam seluruh pembangunan AI, lebih langka daripada chip, karena chip bisa dipercepat, kalender tidak.
| Model penerapan | Penerapan di lokasi, pada situs yang disiapkan | Ke mana waktu habis |
|---|---|---|
| Pembangunan konvensional | Sekitar 6 bulan (sekitar 180 hari) | Integrasi rak di lokasi, perkabelan, penyambungan pendingin, perakitan node, pengujian bertahap |
| DSX POD | Paling cepat 14 hari | Penempatan kontainer yang sudah dirakit dan diverifikasi di pabrik, serta komisioning akhir |
Sumber: pengumuman NVIDIA di GTC Berlin, 21 Oktober 2026. Tautan ada di catatan kaki.
Tumpukan NVIDIA naik satu tingkat lagi
Pola strategisnya kini sudah dikenal, tetapi POD memperluasnya. NVIDIA naik dari chip ke papan, dari papan ke rak (NVL72), dari rak ke sistem berjaringan — dan kini, dengan desain referensi DSX POD, dari sistem ke pabrik itu sendiri. Setiap kenaikan memperbesar pendapatan yang dapat dilekatkan NVIDIA dan ekosistemnya pada satu gigawatt kapasitas AI, dan setiap kenaikan memperdalam ketergantungan pelanggan pada desain referensi yang mendefinisikan tingkat tersebut.
Desain referensi adalah bentuk kekuasaan yang khas. NVIDIA tidak perlu memproduksi kontainer untuk mengendalikan lapisan kontainer; ia perlu industri membangun mengikuti spesifikasinya, sehingga spesifikasi itu menjadi antarmuka yang harus dipenuhi semua pihak lain. Ke-17 mitra peluncuran — Dell, HPE, dan Lenovo di sistem; Schneider Electric, Vertiv, dan Eaton di infrastruktur daya dan pendingin; Foxconn (melalui Ingrasys), Delta, GIGABYTE, Pegatron, QCT, Wistron, dan lainnya di basis ODM dan komponen — bukan sekadar pemasok. Mereka adalah distribusi dari standar itu. Pengiriman direncanakan mulai awal 2027.
Integrasi pabrik memindahkan hambatan, bukan menghapusnya
Pra-integrasi adalah strategi manufaktur yang diterapkan pada persoalan konstruksi, dan ekonominya mengikuti logika manufaktur. Perakitan di pabrik mengubah tenaga kerja lapangan yang bervariasi menjadi pekerjaan lini yang dapat diulang: kualitas diperiksa di tempat peralatan uji berada, kesalahan ditemukan di tempat para insinyur perancang node berada, dan kurva pembelajaran terakumulasi pada setiap kontainer yang dibangun, bukan dimulai ulang di setiap situs. Desain ulang node — tanpa kabel, berpendingin cairan penuh, dirakit di bawah 5 menit — adalah platform yang dibentuk agar cocok dengan lini tersebut.
Namun hambatan berpindah, bukan lenyap. Jika kontainer dapat diterapkan dalam 14 hari di situs yang disiapkan, maka situs yang disiapkan itu sendiri menjadi kendala: interkoneksi jaringan listrik, waktu tunggu peralatan daya, infrastruktur pendingin, dan perizinan. Kehadiran Schneider Electric, Vertiv, dan Eaton dalam daftar mitra adalah pengakuan persis atas hal itu — antrean berikutnya bersifat elektrikal. Itu juga alasan pembacaan yang jujur atas pengumuman ini memasangkan angka 14 hari dengan syaratnya. Di antara para pemenang fase berikutnya adalah pihak yang dapat menghadirkan situs yang disiapkan secepat kontainer kini dapat diisi.
Lapisan perangkat lunak: DSX MaxLPS dan klaim efisiensi
NVIDIA juga mengumumkan perangkat lunak DSX MaxLPS, yang menurut perusahaan menghasilkan output AI yang sama dengan daya hingga 30% lebih rendah. Di industri yang kendala pengikatnya semakin berupa megawatt, bukan rak, klaim efisiensi tingkat perangkat lunak sebesar itu bermuatan strategis: jika output per watt naik, sambungan jaringan listrik yang sama mendukung lebih banyak komputasi yang dapat dijual, dan kapasitas efektif setiap situs yang disiapkan naik tanpa konstruksi baru. Klaim tersebut adalah klaim NVIDIA, dinyatakan sebagai angka pengumuman, dan pasar akan memverifikasinya dalam penerapan — tetapi arahnya pun penting, karena efisiensi daya berlipat ganda bersama kecepatan penerapan: lebih cepat dipasang, dan lebih banyak output per megawatt yang terpasang.
Sinyal ekosistem meluas juga ke lapisan cloud: A5X dari Google Cloud, yang dibangun di atas Vera Rubin, dijadwalkan tersedia secara umum pada November. Platform garis depan kini diluncurkan serentak sebagai produk yang dibeli, kontainer yang diterapkan, dan instans cloud yang disewa — tiga kanal, satu rantai pasok, dan satu antrean alokasi di belakang semuanya.
Kaitan dengan HBM4
Setiap rak Vera Rubin yang dikirim juga merupakan pengiriman HBM4. Memori platform ini adalah HBM4, yang berarti ramp produksi Vera Rubin dan pengiriman POD awal 2027 diterjemahkan langsung menjadi volume HBM4 bagi para pembuat memori yang terkualifikasi ke dalam platform. Inilah kaitan senyap antara pengumuman kecepatan penerapan di Berlin dan buku pesanan industri memori: kecepatan penerapan menentukan seberapa cepat rak berubah menjadi sistem yang berjalan, dan sistem yang berjalanlah yang menarik putaran pesanan GPU dan HBM berikutnya. Model penerapan yang lebih cepat tidak hanya menarik pendapatan NVIDIA ke depan. Ia juga mengencangkan irama seluruh rantai — pengemasan, HBM, substrat, dan peralatan daya — yang memberi makan pabrik.
Pandangan Chase
Pembacaan malas atas DSX POD adalah "NVIDIA menemukan pusat data yang lebih cepat". Pembacaan yang benar adalah tentang segmen mana dari pembangunan AI yang masih menyisakan kelonggaran berbulan-bulan — dan siapa yang baru saja mengklaimnya.
Chip menjadi tajuk utama selama tiga tahun karena chip adalah kendalanya. Namun rak yang sudah dikirim dan menghabiskan berbulan-bulan dalam integrasi lapangan adalah inventaris, bukan kapasitas, dan industri ini diam-diam menanggung keduanya dalam jumlah yang sangat besar. POD menyerang posisi inventaris itu. Verifikasi pabrik, node tanpa kabel yang dirakit di bawah 5 menit, kontainer yang dispesifikasikan hingga kilogram — setiap elemen membidik celah antara "perangkat keras terkirim" dan "perangkat keras menghasilkan". NVIDIA meneliti kalender pembangunan, menemukan blok waktu mati terbesar yang secara masuk akal dapat dimilikinya, dan mengubahnya menjadi produk.
Dua implikasi kurang dihargai. Pertama, desain referensi mendistribusikan ulang margin tanpa mendistribusikan ulang kendali. Ke-17 mitra memperoleh pasar yang nyata — pabrik AI berkontainer yang dikirim mulai awal 2027 — tetapi mereka memperolehnya di dalam spesifikasi milik NVIDIA, yang berarti pertumbuhan ekosistem dan penguncian platform NVIDIA adalah peristiwa yang sama yang dilihat dari dua sisi. Kedua, pengumuman ini diam-diam mendefinisikan ulang arti "siap" sebagai aset kompetitif. Ketika penerapan memakan waktu 6 bulan, situs yang siap dan yang belum siap berbeda satu fase konstruksi. Ketika penerapan memakan waktu 14 hari, keduanya berbeda hampir seluruh jadwal — dan situs, posisi daya, serta perizinan menjadi aset strategis yang dapat diperdagangkan dengan cara yang sebelumnya tidak.
Pertanyaan terbukanya adalah irama eksekusi. Desain referensi adalah janji sampai kontainer dikirim dalam volume, dan awal 2027 adalah saat janji itu mendapat ujian keras pertamanya: berapa banyak POD, dengan yield berapa, ke berapa banyak situs yang benar-benar siap. Yang perlu dipantau adalah laporan pengiriman para mitra, bukan pidato utama. Jika penerapan 14 hari bertahan di lapangan meski hanya kurang lebih, setiap platform pesaing akan dipaksa menjawab pertanyaan yang sebelumnya tidak perlu dijawab: bukan seberapa cepat chipnya, melainkan seberapa cepat pabriknya dirakit.
Implikasi
- Bagi hyperscaler dan operator pabrik AI: kecepatan penerapan kini merupakan kriteria pembelian yang setara dengan kinerja per watt. Platform yang mencapai produksi beberapa bulan lebih awal menghasilkan uang beberapa bulan lebih awal — nilai interval dari situs siap ke produksi, bukan hanya silikonnya.
- Bagi mitra NVIDIA: POD menciptakan pasar lapisan kontainer mulai awal 2027, di dalam spesifikasi NVIDIA. Kesempatannya nyata; begitu pula ketergantungannya. Mitra dengan posisi daya dan pendingin (lapisan situs yang disiapkan) memegang kartu paling langka ketika hambatan beralih ke elektrikal.
- Bagi pembuat memori: Vera Rubin dalam produksi penuh, ditambah pengiriman POD mulai awal 2027, adalah sinyal volume HBM4. Kecepatan penerapan di hulu menentukan irama pesanan di hilir.
- Bagi penyedia platform pesaing: kontes telah meluas dari chip ke sistem penerapan. Rak pesaing kini bersaing bukan hanya dalam komputasi, tetapi juga dalam waktu menuju produksi di situs yang disiapkan.
- Bagi investor: pantau tiga titik verifikasi — pengiriman POD para mitra pada awal 2027, laporan lapangan tentang klaim penerapan 14 hari, dan hasil terukur dari klaim daya hingga 30% lebih rendah milik DSX MaxLPS. Pengumuman menetapkan narasi; pengiriman menetapkan angka.
FAQ
Apa sebenarnya NVIDIA DSX POD itu?
Ia adalah desain referensi yang mengubah seluruh pabrik AI Vera Rubin menjadi kontainer modular: pabrik dirakit dan diverifikasi di pabrik, lalu dikirim. Satu kontainer komputasi menampung 7 rak Vera Rubin NVL72 dengan 504 GPU Rubin, berbobot sekitar 28.000 kg, dan menerima input daya 800 VDC. NVIDIA mengumumkannya di GTC Berlin pada 21 Oktober 2026, dengan 17 mitra dan pengiriman direncanakan mulai awal 2027.
Apakah angka 14 hari berarti pusat data dapat dibangun dalam 14 hari?
Tidak. 14 hari adalah masa penerapan di lokasi pada situs yang sudah disiapkan — situs yang daya, pendingin, dan infrastruktur gedungnya sudah tersedia — turun dari sekitar 6 bulan pembangunan konvensional di lokasi. Membangun situs itu sendiri, termasuk sambungan jaringan listrik dan perizinan, tetap memakan waktu jauh lebih lama. POD memampatkan segmen antara "situs siap" dan "pabrik AI berjalan".
Apa yang berubah pada node Vera Rubin sehingga perakitannya begitu cepat?
NVIDIA menyatakan node Vera Rubin tidak memiliki kabel, 100% berpendingin cairan, dan memangkas waktu perakitan node dari 2 jam pada Grace Blackwell menjadi di bawah 5 menit. Menghilangkan perkabelan menghilangkan sekaligus waktu perakitan dan sumber utama kesalahan lapangan, dan juga membuat node cepat diganti saat servis, bukan hanya cepat dipasang.
Mengapa produksi Vera Rubin penting bagi HBM4?
Sistem Vera Rubin menggunakan memori HBM4, sehingga ramp produksi penuh platform — dan pengiriman DSX POD yang direncanakan mulai awal 2027 — diterjemahkan langsung menjadi permintaan HBM4. Kecepatan penerapan penting bagi pembuat memori karena penerapan yang lebih cepat menarik putaran pesanan GPU dan HBM berikutnya ke depan.
Sumber: liputan pengumuman penerapan DSX POD dari NVIDIA; laporan GTC Berlin tentang Vera Rubin dan DSX POD; laporan penerapan 14 hari DSX POD (semuanya melaporkan pengumuman NVIDIA di GTC Berlin pada 21 Oktober 2026). Artikel ini adalah analisis, bukan nasihat investasi.
📩 Berlangganan VLSI Korea
Dapatkan analisis semikonduktor harian kami lebih dulu di email Anda. Berlangganan gratis.