 VLSI Korea
スウェーデンのデータセンターが選んだ韓国のAIチップ ― FuriosaAI RNGD 7,000基導入の意味
スウェーデンのストックホルムに建設される15MWのAIデータセンターが、韓国のFuriosaAI RNGDを選定。第1フェーズ1,800基から累計8,800基超へ拡大し、GPUと混在配置される。180Wの電力経済性が欧州での選定理由となった。


🆓 無料記事 · どなたでも無料でお読みいただけます

30秒サマリー
- 2026年8月、韓国のファブレススタートアップFuriosaAI、米国のインフラ企業I/ONX HPC、データセンター開発事業者Veloxは、FuriosaAIのRNGD推論アクセラレータを中核とする15MWのAIデータセンターをスウェーデンのストックホルムに建設すると発表した。
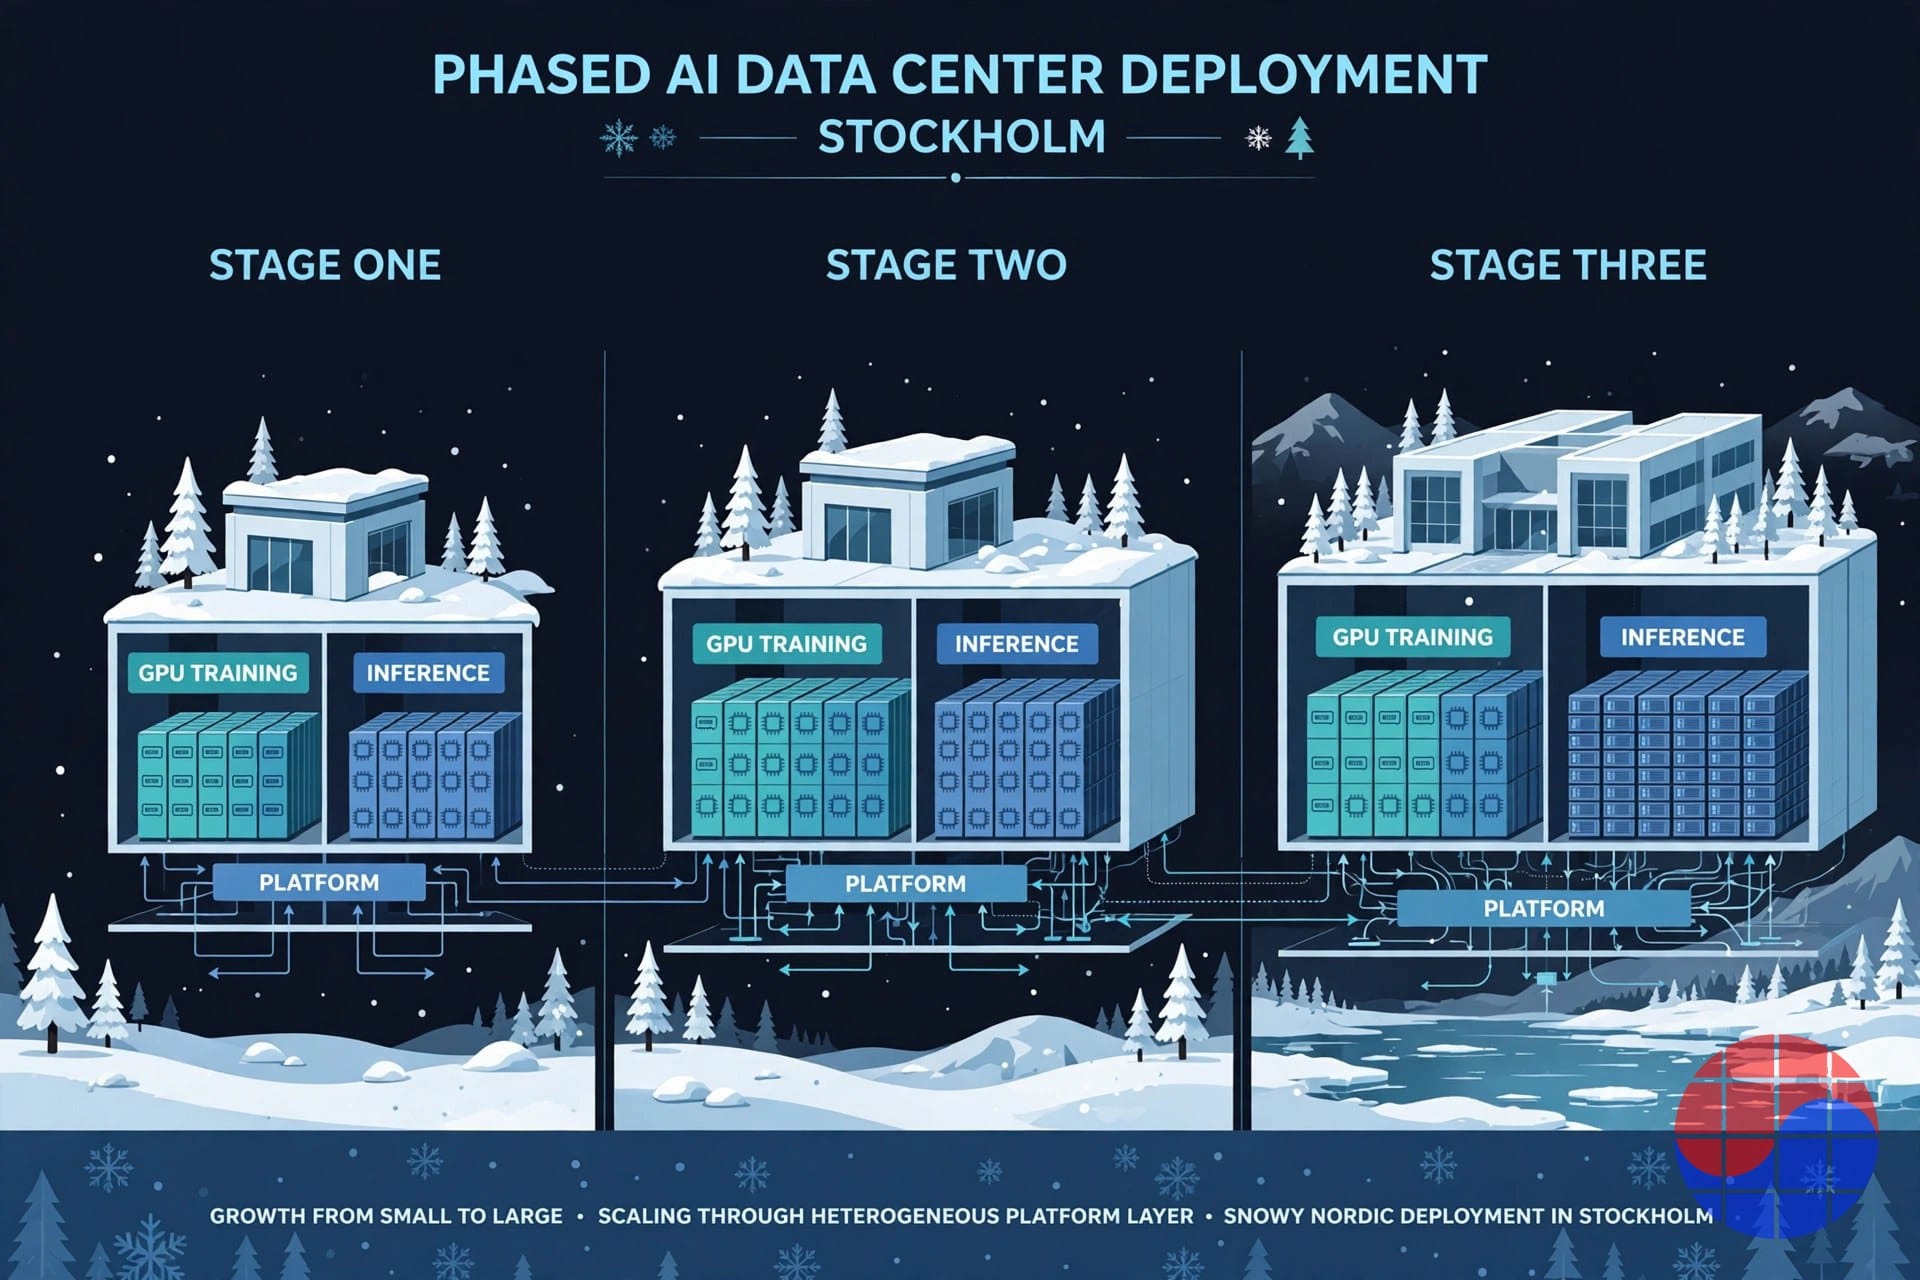
- 導入は段階的に進む。第1フェーズではRNGD 1,800基を導入し、2027年初めに最初の2MWの容量で稼働を開始する。その後の拡張フェーズで7,000基超を追加し、フルビルドアウト時点では累計8,800基超のアクセラレータを計画する。
- RNGDフリートはGPUを置き換えるものではない。I/ONXのSymphony SixtyFourプラットフォームの中で、約7,000基のNVIDIAおよびAMDのGPUと並んで配置される。GPUが学習を担い、RNGDがLLMとエージェント型AIの推論を担う。
- 選定の論理は電力経済性にある。RNGDは180Wの空冷PCIeカードで、独立した測定でGPUベースの代替案より2.25倍優れたワット当たり性能を示した。電気料金が米国や中国の2〜3倍で、大半の施設が空冷である欧州では決定的な特性である。
- FuriosaAIにとってストックホルムは、国内での検証を輸出事業へ転換するスケール面のリファレンスであり、報道で伝えられる3億〜5億ドルのプレIPO資金調達ラウンドを進めるタイミングと重なる。
背景
2026年8月4日に発表されたストックホルムプロジェクトは、3社による共同構築である。Velox DCI Europeは、2025年2月に立ち上げられたテキサス州拠点のモジュール型データセンター企業の欧州部門であり、物理施設を開発・管理・運営し、Infrastructure-as-a-Serviceモデルで容量を販売する。I/ONX HPCは2020年設立のラスベガス拠点のヘテロジニアスAIインフラ企業で、システムインテグレータおよびプラットフォームパートナーを務める。FuriosaAIはRNGDアクセラレータ、ドライバ、ソフトウェアスタック、アーキテクチャ支援を提供する。各社は今後数カ月を、最初の導入フェーズに先立つ技術検証、ソフトウェア統合、供給計画に充てるとしている。
| フェーズ | 施設容量 | RNGDアクセラレータ | 時期 |
|---|---|---|---|
| 第1フェーズ | 2MW | 1,800基 | 2027年初め |
| 拡張 | +8MW(累計10MW) | 7,000基超を追加 | 2027年後半 |
| フルビルドアウト | 15MW | 合計8,800基超 | 後続フェーズ |
ワークロードの分担は明確である。RNGDアクセラレータが大規模言語モデルとエージェント型AIの推論を担い、GPUフリートがモデル学習と汎用コンピューティングを担う。チップはI/ONXのSymphony SixtyFour高密度サーバーに搭載され、最大64基のアクセラレータを単一ノードに集約する。エンド顧客はハードウェアではなく推論容量を購入する欧州の企業およびクラウドサービスプロバイダである。
ストックホルムはFuriosaAIにとって欧州での最初のステップではない。2026年7月には、ポルトガルのリスボンにあるEquinixのデータセンターにRNGDサーバーが導入された。単一拠点の橋頭堡である。韓国では、サムスンSDSがRNGDベースのNPU-as-a-Serviceを提供開始し、LG AI ResearchはEXAONEモデルをRNGDインフラ上で運用している。スウェーデンで変わるのはスケールである。ハードウェアの性能に事業が懸かる第三者事業者が運営する、数千基規模・複数フェーズのコミットメントである。
ビジネス深掘り
1. 欧州はソブリンを買っている ― そしてソブリンには電気代がかかる
この取引の需要側は構造的である。欧州連合はInvestAIイニシアチブを通じて、2,000億ユーロのAI投資の動員を目指す。2026年7月、欧州委員会は7つのAIギガファクトリーに100億ユーロの公的資金を投じ、さらに200億ユーロの民間資本を呼び込むことを見込んだ。各施設は少なくとも10万個の先進AIチップを収容し、採択コンソーシアムは2027年初めに発表される予定である。技術ソブリン担当の欧州委員会上級副委員長Henna Virkkunenは、生の計算能力へのアクセスを「欧州にとって戦略的必需」と呼んだ。
欧州が実際に買えるものを形作る制約は2つある。第一に、欧州委員会自身の分析では、EUの電気料金は米国と中国の2〜3倍である。欧州では、ワット当たり性能は最適化の目標ではなく、容量を追加すること自体の実現可能性の条件である。第二に、ソブリン需要は支配的な単一の米国GPUベンダー以外への供給多様化を意味する。それでも最上位では依然として既定の選択肢が支配的であり、NVIDIA、AMD、クアルコムはギガファクトリープログラムへの供給に関する基本合意書に署名している。挑戦者側のシリコンが最初に勝つのは市場の独立した周縁、すなわちストックホルムの構築とまさに同じ商業主導のIaaS施設であり、そこでは補助金委員会ではなく事業者自身のマージンがチップの決定を行う。
2. 置き換えではなく補完:実際に機能する楔
GPUの既存事業者に対するすべての挑戦者は同じ導入の壁に直面する。稼働中のGPU資産を引き剥がし、実績のないスタックに事業を賭けたい事業者はいない。FuriosaAIのストックホルム設計は、その壁を登るのではなく回避する。約7,000基のGPUは施設内に残る。RNGDが求めるのは推論レイヤーのみである。トークンが提供され、稼働率が継続的で、ワット当たり性能が事業者の粗利益に直接転換されるレイヤーである。
採用障壁をさらに下げるパッケージ上の選択が2つある。ヘテロジニアス統合のリスクはI/ONXのSymphony SixtyFourプラットフォームが吸収する。同プラットフォームは、最大64基のアクセラレータをノード当たりに集約することで、ラックスケールで50%以上のTCO削減を主張しており、顧客が混在フリートを管理する必要はない。そしてVeloxがInfrastructure-as-a-Serviceを販売するため、欧州企業は韓国のスタートアップのシリコンを自ら評価するのではなく、推論の成果を借りる。チップの決定は1事業者のTCO計算となり、数千件の個別のデザインウィンよりはるかに容易な販売となる。
3. 180Wの経済性
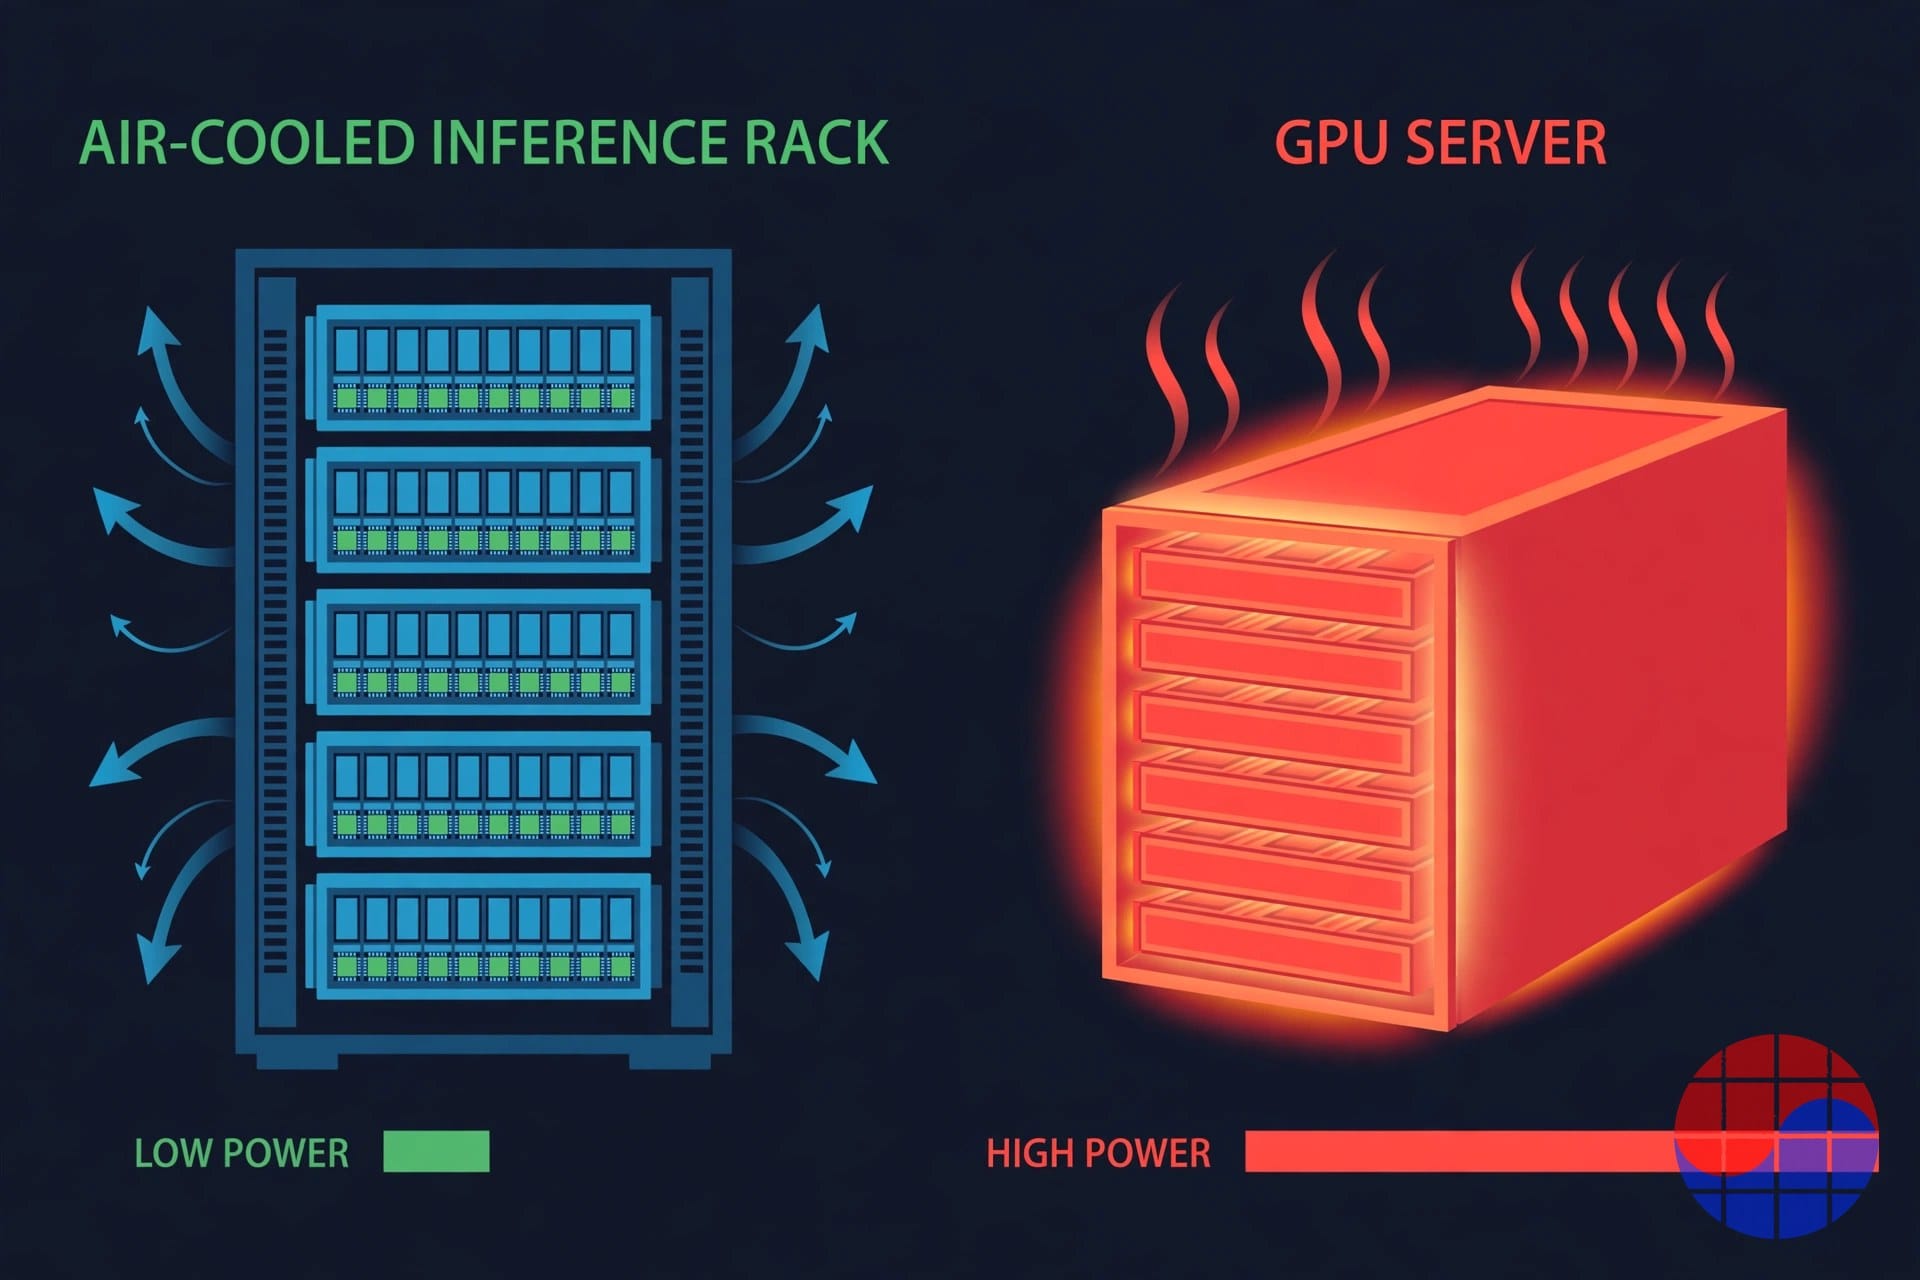
RNGDはTSMCの5nmプロセスで製造され、FuriosaAIのTensor Contraction Processorアーキテクチャを基盤とする。各PCIeカードは、カードレベルのTDP 180W、パッシブ冷却で、512 TFLOPSのFP8演算性能と48GBのHBM3メモリを提供する。同社のNXT RNGDサーバーは、標準的な空冷4Uシャーシに8枚のカードを搭載し、約3kW/サーバーで4ペタフロップスのFP8と384GBのHBM3を実現する。これに対し、NVIDIA DGX H100サーバーは最大10.2kWである。したがって、標準的な15kWの空冷ラックには、DGXなら1台のところにNXT RNGDサーバーを最大5台収容できる。FuriosaAIは、データセンターの80%以上が依然としてラック当たり8kW以下の空冷で運用されており、これは施設を再構築しなければ高密度GPUの改修では対応できない既設基盤であると指摘する。
効率の主張には第三者の裏付けがある。LG AI Researchは、自社の大規模言語モデルEXAONEをRNGDインフラ上で運用し、GPUベースのソリューションより2.25倍優れたワット当たり推論性能と、同じ電力予算に抑えたラックから3.75倍多いトークンを測定した。フリートの計算も同様に単純である。180Wのカード8,800枚はフルビルドアウト時に約1.6MWのアクセラレータ電力を消費する。これはストックホルム施設の15MWの枠の約10分の1であり、欧州の系統接続が実際に許容する電力予算の中で、GPUフリート、ネットワーキング、冷却のための余裕を残す。
4. リファレンス導入の価値
AIチップのスタートアップが死ぬのはシリコンの品質が原因であることはまれで、リファレンス段階、すなわちスケール面で最初になりたい事業者がいない段階で死ぬ。FuriosaAIは今やリファレンスを順に積み上げてきた。モデルレベルの検証としてのLG AI Research、韓国でのサービスパッケージングとしてのサムスンSDS、欧州の橋頭堡としてのEquinixリスボン、そして第三者事業者の下での数千基規模としてのストックホルムである。各ステップが、異なる種類の買い手の異議を取り除く。
タイミングも重要である。FuriosaAIは2025年7月に、韓国の政策系・戦略系投資家が主導する1億2,500万ドルのシリーズCブリッジラウンドを完了し、2026年1月にはIPOを見据えて3億〜5億ドルを求めていると報じられた。同社はMetaからの8億ドルの買収提案を断り、独立を選んだ企業でもある。欧州のフラッグシップリファレンス ― 実機、名前のある施設、日付のある稼働開始 ― は、まさにプレIPOの資金調達においてその独立の物語を支える資産である。一方、2026年5月のBroadcomとの第3世代・チップレットベースのラックスケールプラットフォームに関する提携は、次世代が構築される間にストックホルムが現行世代のリスクを下げることを意味する。
Chase's Take
この取引で示唆に富むのは、韓国のチップが欧州で勝ったことではない。どのように勝ったかである。学習レイヤーを巡る戦いを辞退したことによってである。学習は、定着したソフトウェアの堀を持つ威信の市場であり、推論は買い手のスプレッドシートが決めるコストの市場である。ワット当たり2.25倍の性能を提供する180Wの空冷カードは、愛される必要はない。事業者がすでに所有する施設の中で、トークン当たりでより安くある必要がある。それはベンチマークの議論ではなくビジネスの議論であり、挑戦者側のシリコンで一貫して機能してきた唯一の楔である。
3つのリスクも同じだけ取り上げるに値する。第一に実行である。これは技術検証に入る発表済みの計画であり、拡張フェーズに信頼性を持たせるには第1フェーズが2027年初めに予定通り着地しなければならない。第二に既存事業者の対応である。GPUのリーダーは世代ごとに推論効率を改善し、ソフトウェアエコシステムを所有している。効率の差は動く標的である。第三に集中である。1つの施設と1つのインテグレータが欧州の物語を担うため、いかなる遅れも目立ちやすい。これらのいずれも構造的な論点を消すものではない。ソブリン需要と電力制約と補完としての位置付けの組み合わせは再現可能なプレイブックであり、FuriosaAIは韓国のAIチップスタートアップがこれまで到達したことのないスケールでそれを実行したばかりである。
インプリケーション
- 韓国のファブレスエコシステムにとって: ストックホルムは、国内のAIチップが韓国の企業アンカーの内側だけでなく、外国の商業施設でTCOで勝てることを示す輸出の証明である。ソブリンAIとしての位置付けが、韓国のアクセラレータスタートアップにとって標準的な市場開拓の動きになると予想される。
- 欧州の事業者にとって: このプロジェクトは、空冷で電力に制約のある施設からAI容量を引き出すための再現可能なテンプレートである。2027年初めのギガファクトリーの採択は、挑戦者側のシリコンが商業施設だけでなく補助金を受けた構築にも浸透できるかどうかを示すだろう。
- 投資家にとって: 重要なマイルストーンは、2027年初めに予定通り第1フェーズが稼働すること、プレIPOラウンドの完了、そしてBroadcomとの第3世代プログラムからの進捗のシグナルである。
- 既存事業者を見守る者にとって: 同じ建物内に約7,000基のGPUがあることから、この取引は既存事業者のシェアを縮小させるよりも、アクセラレータ市場全体を拡大させる度合いの方が、今のところ大きい。戦略的な問いは、一度譲った推論レイヤーが、譲ったままにとどまるかどうかである。
FAQ
ストックホルムにはFuriosaAI RNGDアクセラレータが何基導入されますか? 各社の2026年8月の発表によると、第1フェーズで1,800基、拡張フェーズで7,000基超を追加し、フルビルドアウト時には合計8,800基超となります。
スウェーデンのデータセンターは、なぜGPUを増やすのではなく韓国の推論チップを選んだのですか? 電力とTCOのためです。RNGDは空冷PCIeフォームファクタで、カード当たり180Wで512 TFLOPSのFP8演算性能を提供し、測定でGPUベースの代替案より2.25倍優れたワット当たり性能を示しました。電気料金が高く、大半が空冷施設である欧州に適合します。GPUは学習用として同じ施設内に残ります。
I/ONXのSymphony SixtyFourプラットフォームとは何ですか? 最大64基のアクセラレータを単一ノードに集約する高密度AIサーバープラットフォームで、FuriosaAI RNGD NPUとNVIDIAおよびAMDのGPUをヘテロジニアスシステムの中で混在させます。I/ONXは、ラックスケールのTCOを50%以上削減すると主張しています。
ストックホルム施設はいつ稼働を開始しますか? 最初の2MWの計算容量は2027年初めに稼働開始予定で、2027年後半にさらに8MWが追加され、全体の目標容量は15MWです。
注:導入数値、電力データ、ワット当たり性能の結果は、各社の2026年8月の発表とLG AI Researchの公表評価に基づきます。本記事は業界分析であり、投資助言ではありません。
出典:FuriosaAI発表に関する報道(Korea Herald、2026年8月5日);欧州委員会InvestAIおよびAIギガファクトリープログラム文書(2026年7月);I/ONX HPC Symphony SixtyFourプラットフォーム資料。
📩 VLSI Korea ニュースレター
毎日配信の半導体ディープダイブを、メールでいち早くお届けします。購読は無料です。


