VLSI Korea
NVIDIA Vera CPU徹底分析 — 88コアより重要な1.2TB/sメモリ帯域幅
Veraはソケット当たり1.5TBのSOCAMM2 LPDDR5Xと1.2TB/sの帯域幅、コア当たり約13.6GB/sを提供する。GraceとEPYC Turinの比較、ベンダー主張の限界、サムスン電子・SKハイニックス・マイクロンのSOCAMM2競争まで分析する。


TL;DR
- NVIDIA VeraはArmv9.2-A互換のカスタムOlympusコア88基を搭載したデータセンターCPUで、2025年3月のGTCでVera Rubinプラットフォームとともに公開され、アーキテクチャの詳細は2026年7月のNVIDIA公開資料で確認された(NVIDIAアーキテクチャ公開、2026年7月)。
- 核心となる数値はコア数ではない。Veraソケット1基は最大1.5TBのSOCAMM2 LPDDR5Xと最大1.2TB/sのメモリ帯域幅をサポートし、単純な割り算基準ではコア当たり約13.6GB/sとなる(NVIDIAアーキテクチャ公開、2026年7月;公開数値に基づく計算、2026年10月20日)。
- コア当たり帯域幅は前世代Graceの約1.8倍、12チャネルDDR5-6400基準の128コアAMD EPYC Turinフラッグシップ計算値の約2.8倍である(ベンダースペックに基づく計算、2026年10月20日)。
- NVIDIAはAI関連ワークロードでTurinに対してIPC最大1.9倍を主張するが、これはベンダーの主張であり、これまでに公開されたパートナーベンチマークは全体の設定とTDPを公開していない(NVIDIA公開、2026年7月)。
- 戦略的な変化はソケット当たりのメモリ搭載量である。VeraはGraceの3倍の容量をソケットに載せるため、CPUソケットがサムスン電子・SKハイニックス・マイクロンのLPDDR5X供給競争の舞台となる(NVIDIAアーキテクチャ公開、2026年7月)。
Background
過去20年間、データセンターCPUのマーケティングは大部分がコア数競争だった。コアが多ければ仮想マシンも、コンテナも、ラック当たりのスレッドも多くなるという論理だった。汎用ワークロードが主に演算スループットで律速していた時代には正しい話だった。しかしエージェント型AI時代にはこの論理は弱くなる。AIシステムのCPUはもはやGPUの隣で待機するhostではない。Tool呼び出しを調整し、データを準備・移動させ、retrievalとrankingの段階を実行し、ネットワークとストレージのトラフィックを処理し、データの到着が遅れれば直ちに停止するアクセラレータにデータを供給する。
NVIDIAはGraceでこの市場に参入した。GraceはArm Neoverse V2コア72基、最大480GB LPDDR5X、546GB/sのメモリ帯域幅を備えたCPUだった(2026年7月のVera公開以前に公開されたNVIDIA Graceスペック基準)。GraceはArm CPUがNVIDIAラックの中心に立てることを証明した。同時に次のボトルネックも明らかにした。GPUシステムが高速化するほど、host CPUにはより多くのメモリ容量、スレッド当たりより多くの帯域幅、GPUとのより高速なcoherent接続が必要になった。
Veraはその答えである。2025年3月のGTCでVera Rubinプラットフォームの一部として公開され、2026年7月のアーキテクチャ公開で詳細が出た(GTC、2025年3月;NVIDIAアーキテクチャ公開、2026年7月)。VeraはライセンスされたNeoverse設計を捨て、カスタムOlympusコア88基に変えた。NVIDIAによれば、Spatial Multithreadingで176スレッドを提供し、monolithic compute die、コア当たりL2 2MB、L3 164MB、第2世代Scalable Coherency Fabricを備えた(NVIDIAアーキテクチャ公開、2026年7月)。
コア周辺のプラットフォーム数値も重要である。VeraはcoherentなCPU-GPU通信のためのNVLink-C2C 1.8TB/s、PCIe Gen6、CXL 3.1を提供し、TDPは250〜450Wで設定可能である(NVIDIAアーキテクチャ公開、2026年7月)。Vera 2基で構成するSuperchipは176コア、352スレッド、SOCAMM2モジュール16個、合計メモリ帯域幅2.4TB/s、メモリ3TBを提供する。Superchip 128基のラックリファレンスデザインは22,528コアと384TBメモリに到達する(NVIDIAアーキテクチャ公開、2026年7月)。単体CPU販売と初期顧客出荷は2026年の報道で伝えられたため、本稿の可用性に関する記述はNVIDIAの直接の出荷確認ではなく報道基準で表記する(業界報道、2026年)。
Deep Dive 1: メモリシステム — ソケット当たり1.5TBと1.2TB/s
Veraを規定する選択はメモリシステムである。ソケット1基は最大9,600MT/sのSOCAMM2 LPDDR5X最大1.5TBをサポートし、最大1.2TB/sのメモリ帯域幅を提供する(NVIDIAアーキテクチャ公開、2026年7月)。SOCAMM2はNVIDIAが主導したソケット型LPDDRモジュール規格である。はんだ付けされたLPDDRとは異なり、ソケット型モジュールはシステム設計に応じて構成・交換・拡張が可能でありながら、一般的なDDR5サーバーメモリよりもLPDDR5Xの電力効率の利点を維持する。
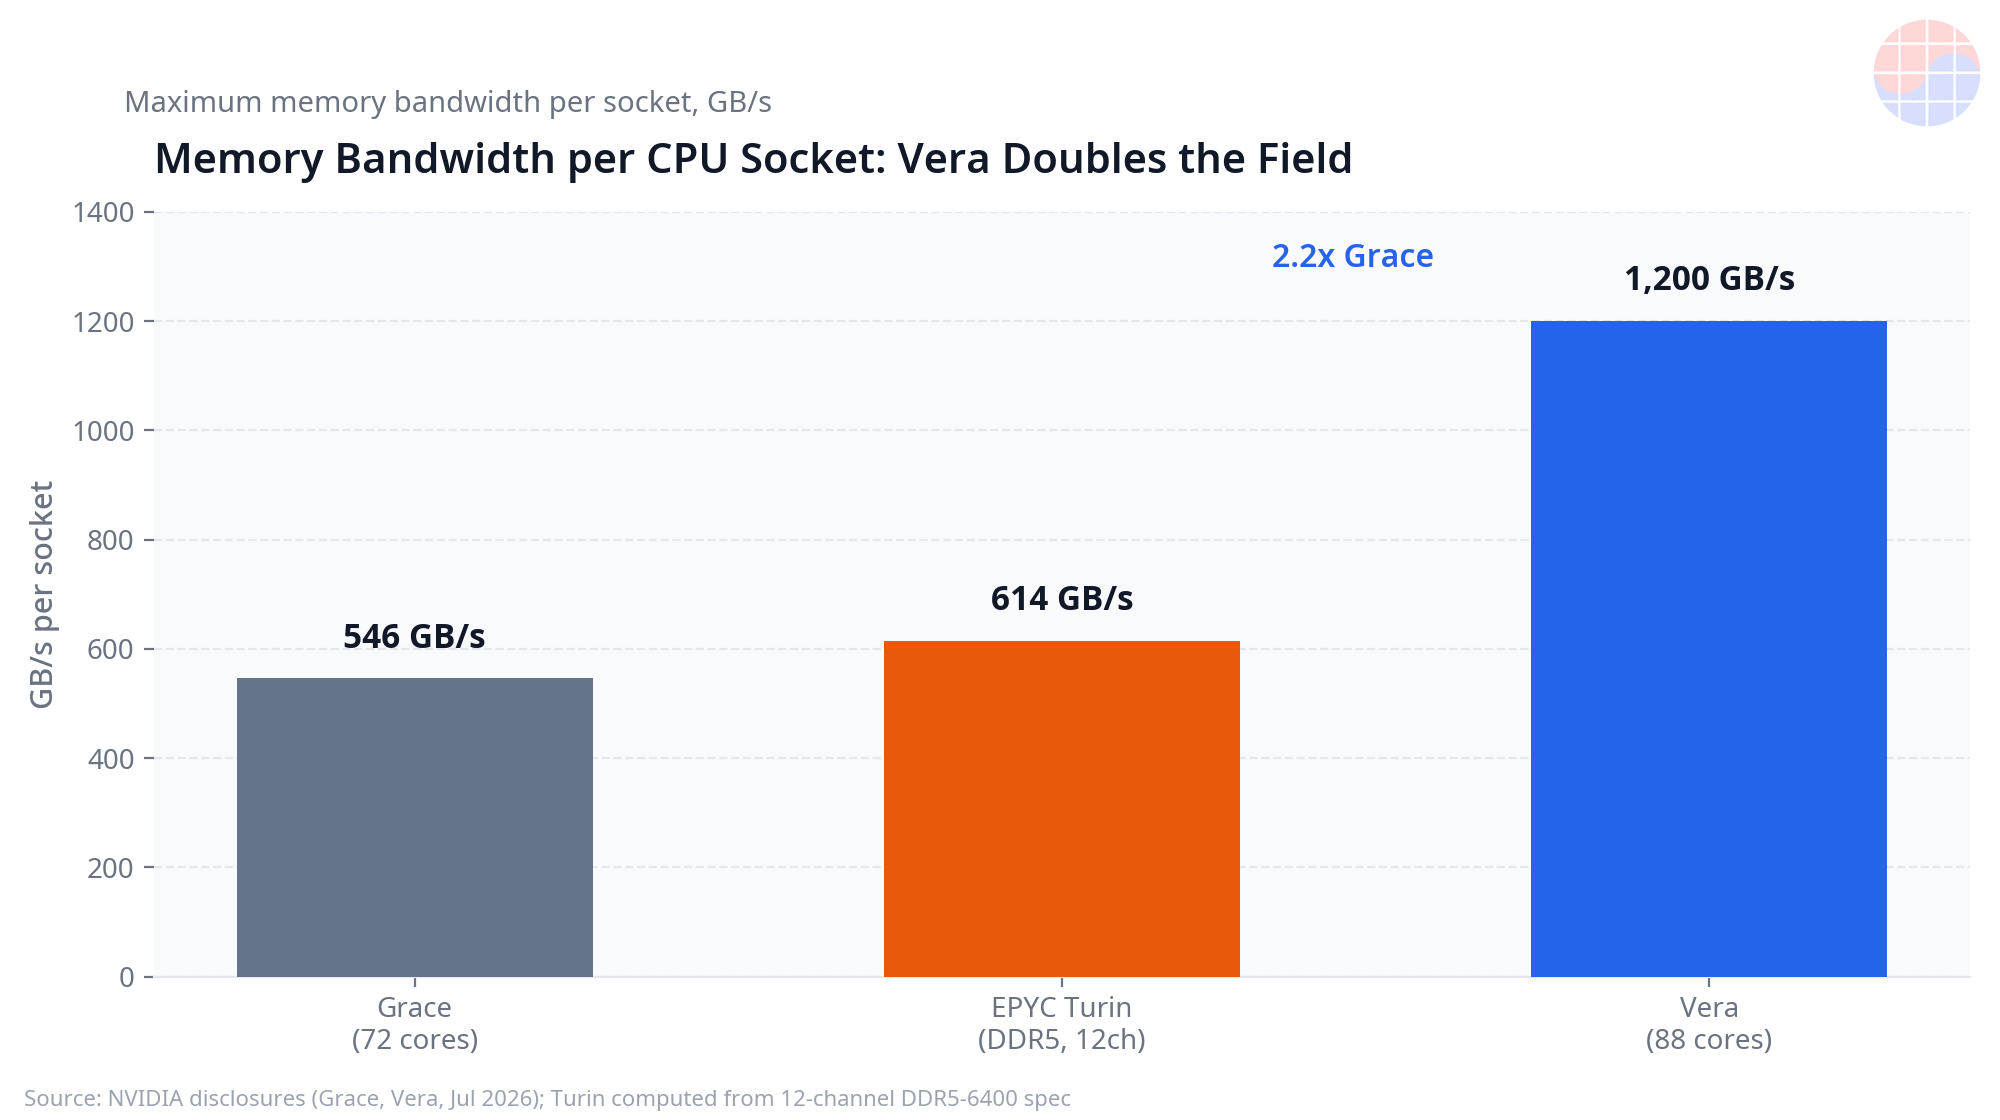
Graceと比較すると1世代の移行幅が見える。Graceはソケット当たり最大480GB LPDDR5Xと546GB/sの帯域幅を提供した(NVIDIA Graceスペック)。Veraは容量を1.5TBへ3倍に増やし、帯域幅は1,200GB/sへ約2.2倍に高めた(NVIDIAアーキテクチャ公開、2026年7月;計算、2026年10月20日)。実務的には、Veraソケットはより大きなworking setをローカルメモリに置くことができる。より大きなkey-valueキャッシュ、より大きなembeddingテーブル、より多くの同時agentセッション、GPUが消費するデータを遅いストレージやリモートメモリに落とさずにより多く準備しておけるという意味である。
容量と帯域幅は共に上がらなければならない。容量だけが大きく帯域幅が不足すれば、コアは混雑したメモリ経路で待つ。帯域幅だけが大きく容量が不足すれば、頻繁なevictionとrefetchが発生する。Veraの設計点である1.5TBと1.2TB/sは、多くのスレッドが大きく絶えず変わるデータセットを同時に触るワークロードを狙う。Retrievalパイプライン、feature serving、vector searchの前処理、データローディング、大規模モデル推論を巡る制御ロジックがまさにそのプロファイルに該当し、伝統的な整数演算ベンチマークとは距離がある。
サプライチェーン次元の結果もある。ソケット型LPDDR5Xモジュール規格は、システムビルダーが大量に購入する、交換可能な標準メモリcontent単位を作る。ソケット1基が480GBではなく1.5TBを載せれば、GPUに付くHBMを数える前に、CPUに付くLPDDR5X contentだけでVeraシステム1台のメモリ搭載量が倍増する。4番セクションで、この点がサムスン電子・SKハイニックス・マイクロンに何を意味するかを扱う。
Deep Dive 2: コア当たり帯域幅とx86比較
メモリ帯域幅が追いつかなければ、コア数は誤解を招く。ソケット帯域幅をコア数で割ると、すべてのコアが忙しいときにコア1基が引き出せるメモリスループットの大まかな指標となる。Veraは1,200GB/sを88コアで割るとコア当たり約13.6GB/sとなり、NVIDIAが表記するコア当たり約14GB/sと一致する(NVIDIAアーキテクチャ公開、2026年7月;計算、2026年10月20日)。Graceは546GB/sを72コアで割るとコア当たり約7.6GB/sである。
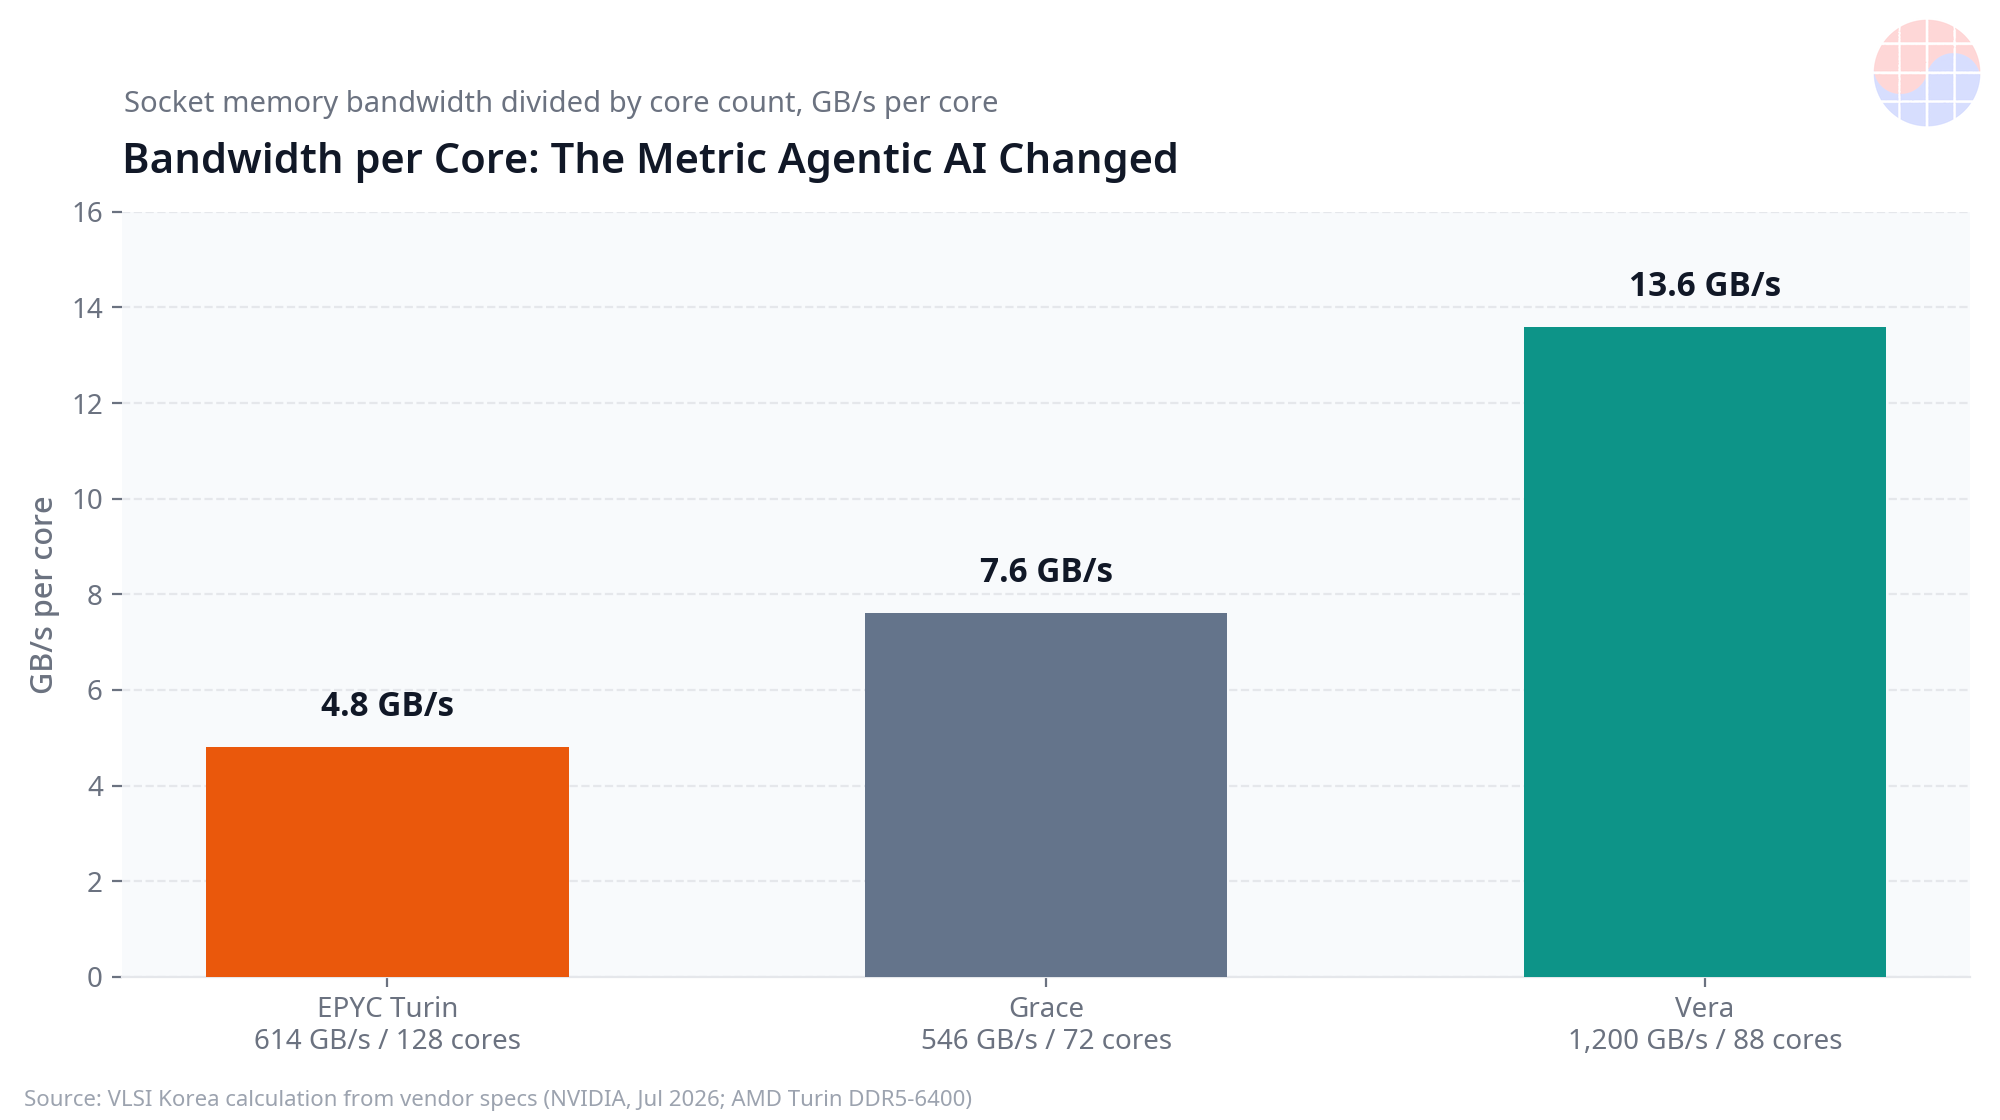
x86比較には透明な方法論が必要である。12チャネルDDR5-6400を使うAMD EPYC Turinシステムの理論上の最大値は、12チャネル × 6,400MT/s × 転送当たり8バイトで計算した614GB/sである(AMD EPYC Turinメモリスペックに基づく計算、2026年10月20日)。これを128コアフラッグシップ構成で割ると、コア当たり約4.8GB/sである。この比較のすべてのプラットフォームで実際の持続帯域幅は理論上の最大値より低いため、数値は測定されたアプリケーション結果ではなくスペック基準の比率として読むべきである。
この基準で、Veraは当該Turin構成の約2.8倍、Graceの約1.8倍のコア当たり帯域幅を提供する(計算、2026年10月20日)。これがNVIDIAの主張の中で最も強い部分である。エージェント型ワークロードとデータ集約型ワークロードは、データをstreaming、filtering、transformingする多くのスレッドを回す場合が多い。コア当たり帯域幅が低ければ、コアを増やしても固定されたメモリパイプを分け合うため効果が止まる。コア当たり帯域幅が高ければ、スレッド拡張がより長く効く。
NVIDIAはAI関連ワークロードでEPYC Turinに対してIPC最大1.9倍も主張する(ベンダーの主張、NVIDIA公開、2026年7月)。この主張は慎重に扱うべきである。IPCはワークロード、コンパイラ、命令ミックスに大きく左右され、Armカスタムコアとx86コアは同一の命令フローを実行しない。この主張は、より広く効率的なコアにより多くの帯域幅を供給するというNVIDIAの設計意図を示すが、独立した測定値ではなく、購入決定に使うには設定が公開された再現可能なベンチマークを待つべきである。
Deep Dive 3: Olympusコア、Coherency、Superchip
VeraのOlympusコア88基はArmv9.2-A互換のカスタム設計で、GraceのライセンスされたNeoverse V2コアから一歩進んだ(NVIDIAアーキテクチャ公開、2026年7月)。コア設計を直接保有すれば、NVIDIAラックシステムが実際に回すワークロードに合わせてvectorスループット、分岐動作、キャッシュ階層を調整できる。コア当たりL2 2MB、チップ全体でL3 164MBという数値も重要である。キャッシュが大きいほど、スレッドがメインメモリで待つ頻度が減るためである(NVIDIAアーキテクチャ公開、2026年7月)。
Spatial Multithreadingは露出スレッド数をソケット当たり176個へ2倍にする(NVIDIAアーキテクチャ公開、2026年7月)。スレッド2倍は、メモリシステムが追加スレッドを養えるときにのみ効果がある。そのため1.2TB/sという数値とスレッド数は別々のスペックではなく、1つの設計決定として読むべきである。
2番目の軸はcoherencyである。Veraの第2世代Scalable Coherency Fabricと1.8TB/sのNVLink-C2Cは、一般的なPCIeリンクを大きく上回る速度でCPUとGPUがデータをcoherentに共有できるようにする(NVIDIAアーキテクチャ公開、2026年7月)。VeraはPCIe Gen6とCXL 3.1もサポートし、一般的なアクセラレータ、ネットワークアダプタ、メモリ拡張装置を接続できる(NVIDIAアーキテクチャ公開、2026年7月)。AIラックにおいてcoherent共有は明示的なコピーのオーバーヘッドを減らす。CPUが準備したデータ構造をGPUが直接消費し、中間結果もソフトウェアが管理する転送を減らして移動できる。
Superchip構成は同じアイデアを拡張する。Vera CPU 2基は176コア、352スレッド、2.4TB/sのメモリ帯域幅、SOCAMM2モジュール16個でメモリ3TBを提供する(NVIDIAアーキテクチャ公開、2026年7月)。ラック規模では、Superchip 128基基準の22,528コアと384TBメモリというリファレンス総量が、NVIDIAがCPUレイヤーをGPUを補助する最小構成ではなく、agent fleetとデータパイプラインのためのpooledインフラとして設計していることを示す(NVIDIAアーキテクチャ公開、2026年7月)。
電力はTDP 250〜450Wの範囲で設定可能である(NVIDIAアーキテクチャ公開、2026年7月)。この範囲はすべてのベンチマーク解釈に重要である。450Wの結果と250Wの結果は異なる動作点を説明し、設定を明示しない比較は不完全である。
Deep Dive 4: 正直な限界 — ベンチマーク、x86の対応、Monolithicコスト
直接指摘すべき限界は3つある。第一に、公開ベンチマークの根拠が薄い。Redpandaと関連したstreamingデータ結果を含むパートナー結果は、設定とTDPを全体公開しないまま発表された(パートナーベンチマーク発表、2026年)。テスト時点のコア数、メモリ構成、ファームウェア、電力設定がなければ、外部の読者は数値を再現することも、比較が公正だったか判断することもできない。NVIDIAのIPC最大1.9倍の主張も同じ地位を持つ。公開された方法で独立テストが確認するまではベンダーの主張である(NVIDIA公開、2026年7月)。
第二に、x86ベンダーは止まっていない。サーバープラットフォームは、より高速なDDR5、チャネル当たりの有効帯域幅を高めるMRDIMMメモリ、メモリチャネルを増やした新世代へ移行している。MRDIMMと次世代x86プラットフォームは、上で使った614GB/sのスペック基準線からコア当たり帯域幅の格差を狭めるだろうし、特にコア数と帯域幅をトレードオフする構成でそうなる。Veraの優位は2026年10月20日基準の公開スペックでは実在するが、一時点の優位であり、永続的な構造的格差ではない。
第三に、Veraのmonolithic compute dieにはコスト構造がある。大きなmonolithic dieは一般的に、欠陥のある小さなdieだけを捨てて正常なdieを複数の製品に再利用できるchiplet設計よりも歩留まりの経済性が難しい(一般的な半導体製造原則、2026年10月20日記述)。NVIDIAはVeraの歩留まりや単位コストを公開していないため、本稿では具体的なコスト主張はしない。方向性の指摘である。Latencyとcoherencyに有利な設計選択は製造リスクも集中させ、価格はそれを反映するだろう。
最後に、ハードウェアの優位のうちどれだけが実際の運用で生き残るかはソフトウェアが決める。エンタープライズツーリング、可観測性、レガシーミドルウェアでArmエコシステムの成熟度は改善されたが、大規模なx86資産を持つ運用者にとって移行コストは依然として実在する。帯域幅はベンチマークで勝ち、総所有コストは購入発注で勝つ。
Chase's Take
重要な変化は、NVIDIAが88コアCPUを作ったという事実ではない。ボトルネックが移動したという事実である。エージェント型AIシステムでCPUはオーケストレーションを担当する。Planning loop、tool呼び出し、retrieval、長いcontextのためのメモリ管理、ストレージ・ネットワーク・GPUの間のデータ移動である。こうした作業はスレッドが多く、メモリを多く使う。制限資源は通常、最大浮動小数点スループットではない。各スレッドが他のすべてのスレッドの後ろで並ばずに、どれだけ多くのデータにどれだけ速く触れられるかである。Veraはその現実に合わせて設計された。コア数よりも先に、コア当たり帯域幅とソケット当たりメモリ容量である。
ビジネスの観点では、SOCAMM2がOlympusコアよりもさらに重要かもしれない。NVIDIAはCPUソケット用のソケット型LPDDR5Xモジュールを規定することで、hostメモリを標準化された大量contentスロットにした。Veraはソケット当たり1.5TBを載せ、Graceの480GBに対して3倍のメモリcontentを載せる(NVIDIAアーキテクチャ公開、2026年7月)。Veraを採用するラックは、それだけはるかに多くのLPDDR5Xをサプライチェーンから引き込む。
そのためCPUソケットはメモリcontent競争の舞台となる。サムスン電子、SKハイニックス、マイクロンはすべてLPDDR5X供給で競争し、大量プラットフォームであるNVIDIAプラットフォームの資格確保は単一のdesign win以上の価値がある。物量、価格交渉力、次のモジュール改訂での位置を固定するためである。韓国サプライヤーにとっては格別な意味がある。LPDDRのリーダーシップは歴史的に韓国の強みであり、SOCAMM2はその強みにスマートフォンを超えるサーバー側の出口を新たに開くためである。ソウルで読むVeraの物語は、半分はCPUの物語であり、半分はCPUを囲むメモリを誰が売るかの物語である。
私の判断はこうである。Veraは88コアというヘッドラインでも、設定が公開されていないベンチマークでもなく、実際のagentワークロードでdeliveredされるコア当たり帯域幅で評価すべきである。独立テストがスペック優位の大部分だけを確認しても、x86ロードマップに加わる圧力 — チャネル拡大、MRDIMM採用、帯域幅グレード別のコア数縮小 — が、Veraが市場を変えたという最も明確なシグナルになるだろう。
Implications
- AIシステム購入者: 自社のagent、retrieval、データローディングのワークロード基準で、ソケット当たりのコア当たり帯域幅とメモリ容量を評価し、すべてのベンダーベンチマークにTDPとメモリ構成の公開を要求すること(根拠:NVIDIAアーキテクチャ公開、2026年7月)。
- x86プラットフォーム企画: スペック格差 — Veraのコア当たり約13.6GB/s対DDR5-6400基準128コアTurin構成のコア当たり約4.8GB/s — は、MRDIMMとチャネル拡大設計を選択ではなくロードマップの優先順位にする(計算、2026年10月20日)。
- メモリサプライヤー: SOCAMM2はCPU側のLPDDR5X contentをソケット当たり1.5TB、Graceの3倍に引き上げるため、サムスン電子・SKハイニックス・マイクロンはより大きく、より戦略的なソケットを巡って競争する(NVIDIAアーキテクチャ公開、2026年7月)。
- 運用者: 移行コスト、ソフトウェアエコシステムの適合性、monolithic dieの価格はハードウェア優位の一部を相殺しうる。ヘッドラインのIPC主張よりも総所有コストのテストが重要である。
- CPU市場: エージェント型ワークロードが成長し続ければ、コア当たり帯域幅はコア数と並ぶ一次購入基準となり、コアだけを前面に出すCPUマーケティングは速く古くなるだろう。
本稿は2025年3月と2026年7月のNVIDIA公開資料と2026年10月20日基準のスペック計算に基づき、ベンダーの性能数値はベンダーの主張として表記し、独立検証されていない。
FAQ
Q1. NVIDIA Vera CPUとは何で、いつ公開されましたか? VeraはArmv9.2-A互換のカスタムOlympusコア88基とSpatial Multithreading基準176スレッドを備えたNVIDIAのデータセンターCPUです。2025年3月のGTCでVera Rubinプラットフォームとともに公開され、NVIDIAは2026年7月に詳細なアーキテクチャ資料を公開しました。
Q2. Veraはソケット当たりどれだけのメモリ帯域幅と容量を提供しますか? Veraソケット1基は最大9,600MT/sのSOCAMM2 LPDDR5X最大1.5TBと最大1.2TB/sのメモリ帯域幅をサポートし、88コア基準でコア当たり約13.6GB/sです(NVIDIAアーキテクチャ公開、2026年7月)。
Q3. コア当たり帯域幅基準で、VeraはGraceおよびAMD EPYC Turinとどのように比較されますか? Graceは72コアに546GB/sでコア当たり約7.6GB/sです。12チャネルDDR5-6400基準の128コアEPYC Turin構成は理論上614GB/sでコア当たり約4.8GB/sです。Veraのコア当たり約13.6GB/sはスペック基準でGraceの約1.8倍、当該Turin構成の約2.8倍です(計算、2026年10月20日)。
Q4. Veraの主な限界と残る問いは何ですか? Turinに対してIPC最大1.9倍というNVIDIAの数値はベンダーの主張であり、Redpandaなどのパートナーベンチマークは全体の設定とTDPを公開しておらず、x86プラットフォームはMRDIMMと次世代メモリ設計で対応中であり、Veraのmonolithic dieはchipletの代替案よりも製造コストが高い可能性がある。方法が公開された独立ベンチマークが依然として必要である(2026年10月20日基準)。
📩 今日の分析を見逃したら、明日の朝はメールで
毎日10:30(KST)のDaily Siliconと、決算・レポートの核心解説をいち早くお届けします。Samsung・SK hynix・TSMC・HBM需給を現役エンジニアの視点で整理。すでに300名以上が購読中です。
無料で購読する →
無料 · スパムなし · いつでも解除可能