VLSI Korea
推論はSRAM、学習はHBM:5つの事実 (Groq 3 LPX・Trainium3)
AI推論が二つに分かれる。デコーディングはHBMなしのSRAMチップGroq 3 LPXへ、学習はチップ当たりHBM3e 144GBのTrainium3へ。帯域幅57倍と容量162倍の非対称、そして両側に立つSamsungまでを5つの事実で整理した。(2026年10月24日時点)


AI推論は二つの方向に分かれつつある。レイテンシが重要なデコーディングはHBMなしのSRAMチップへ移り、学習とプリフィルはHBMの容量の上にそのまま残る。(2026年10月24日時点)
30秒要約
- NVIDIA Groq 3 LPXは量産段階に入った。LP30チップはHBMなしでチップ当たりSRAM 500MBと150 TB/sの帯域幅を提供する(NVIDIA発表、Hot Chips 2026、2026年8月24-25日)。
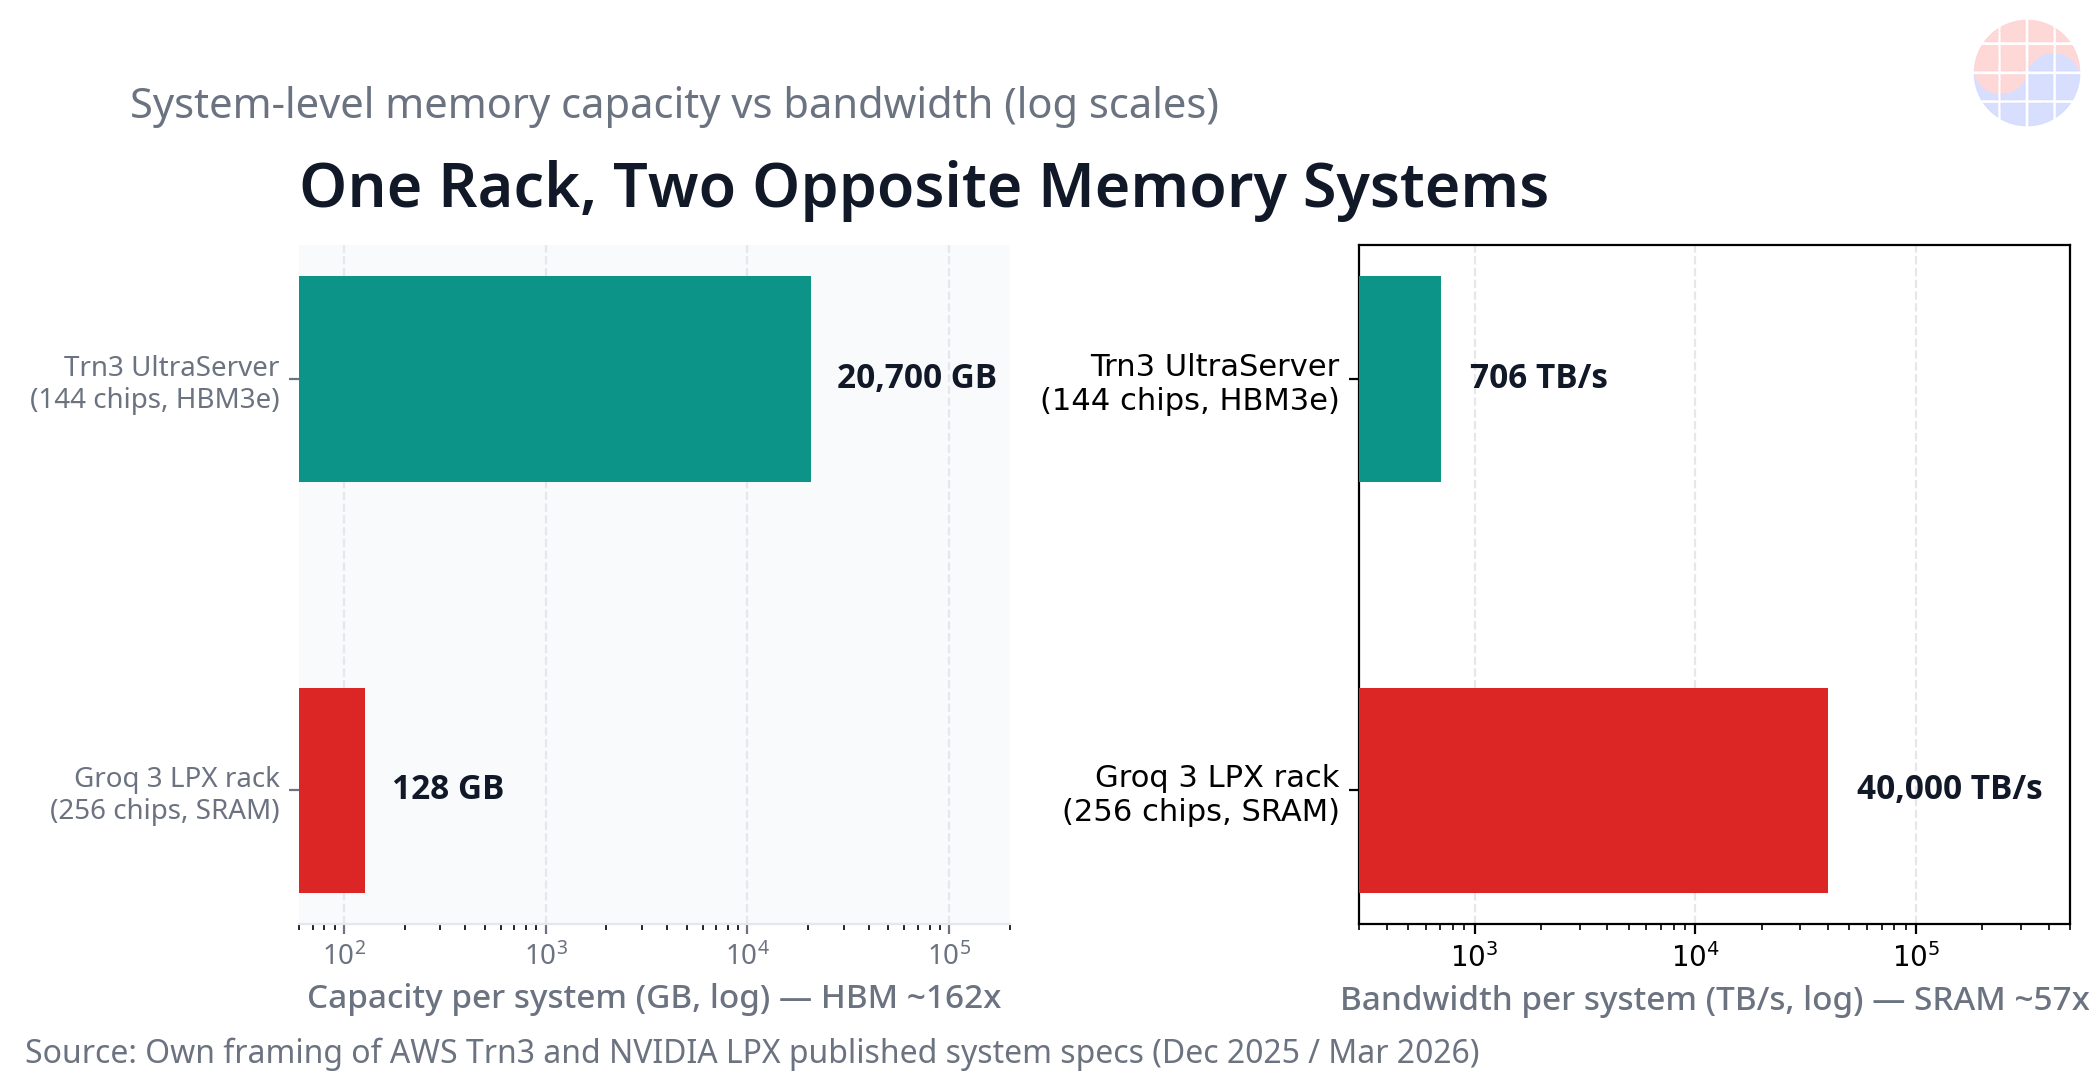
- 独自計算では、ラック基準のメモリ帯域幅はSRAM側が約57倍大きく、メモリ容量はHBM側が約162倍大きい。この非対称が分離の本質だ。
- 学習陣営はHBM容量で固まりつつある。AWS Trainium3はチップ当たりHBM3e 144GBを搭載し、2026年10月19日に発表されたTorchNeuronがPyTorch移植の障壁を下げた(AWS発表)。
- Samsungは分離の両側に立っている。HBM供給を狙いながら、HBMがないLP30の単独ファウンドリでもある。
- SKハイニックスは純粋にHBM側にエクスポージャーがあるが、短期のHBM需要は学習が支える。SRAMが制限するのは推論のうちレイテンシ・プレミアムが付くデコーディングの断片だけだ。
背景
推論は性質の異なる二つの段階に分かれる。プリフィルは長い入力コンテキストを一度に読み込む段階で、演算量とメモリ容量が重要だ。デコーディングはトークンを一つずつ吐き出す段階で、トークンが生成されるたびにモデル重み全体を読み直さなければならない。そのためデコーディングの速度は事実上、メモリ帯域幅とレイテンシが決める。
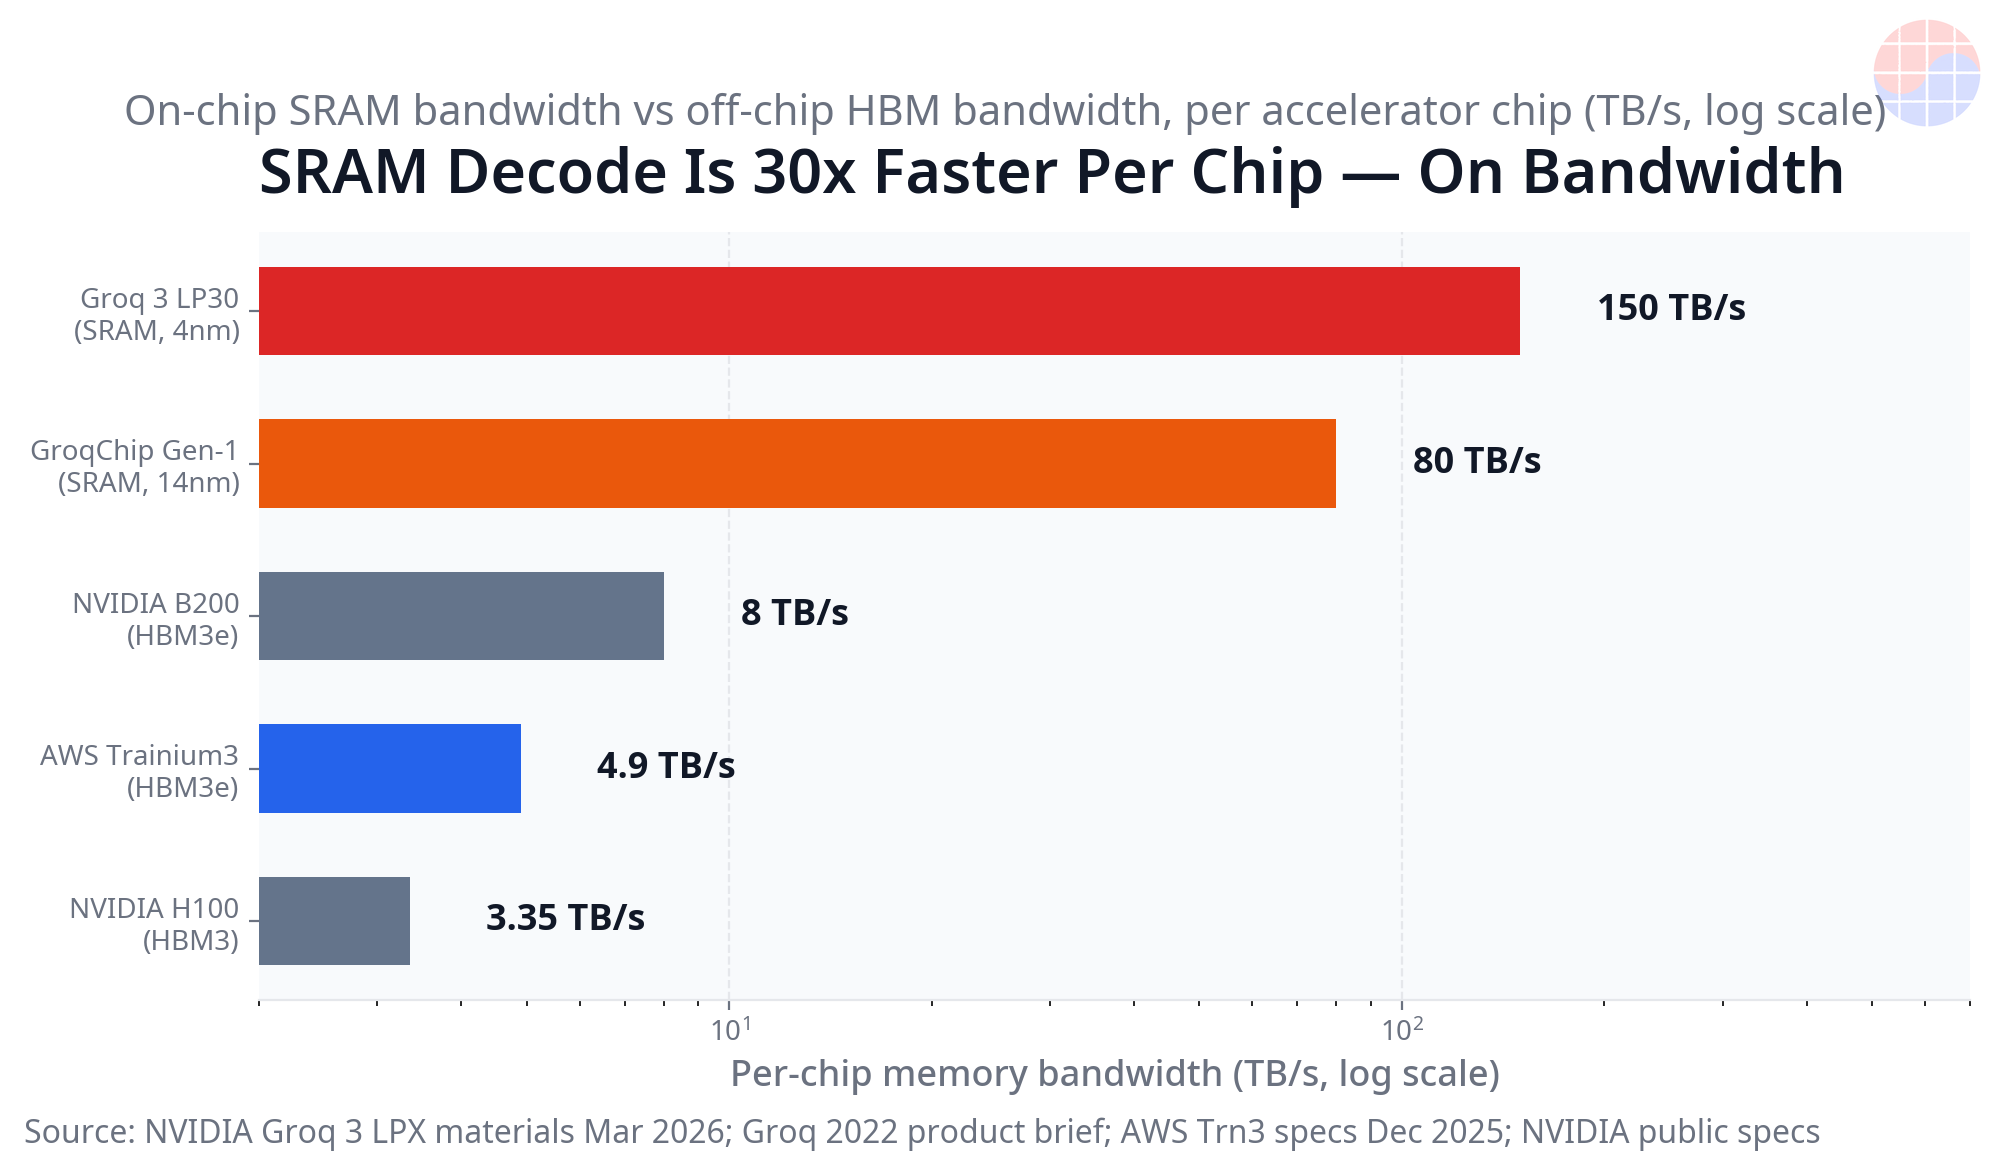
これまではGPUとHBMの組み合わせが二つの段階をともに担ってきた。HBMは容量が大きいがチップの外にあるメモリであるため、帯域幅とレイテンシに物理的な限界がある。反対にSRAMはチップの中にあるため帯域幅が圧倒的に速いが、容量が小さくダイ面積を多く占める。このトレードオフは以前から知られていた。第1世代GroqChipはSRAM 230MBと最大80 TB/sのオンダイ帯域幅を掲げ(Groq 2022年製品ブリーフ、ベンダー仕様)、Cerebras WSE-3はオンチップSRAM 44GBと21 PB/sの帯域幅で同じ哲学をウェハースケールの極限まで推し進めた事例だ(Cerebras 2024年公開仕様)。
構図が変わるきっかけはライセンス取引だった。Groqは2025年12月24日にNVIDIAとの非独占ライセンス契約を発表し、創業者Jonathan Rossと社長Sunny Madraをはじめとする中核チームがNVIDIAに合流した。Groq自体は独立企業として残り、Simon EdwardsがCEOを務め、GroqCloudは取引対象に含まれなかった(Groq発表、2025年12月24日)。取引規模が約200億ドルという数値は報じられた内容であり、NVIDIAが公式に公開した金額ではない。
ディープダイブ:5つの事実
- LPXは量産段階に入り、チップにHBMがない。 NVIDIAはGTC 2026年3月にGroq 3 LPXを公開し、Hot Chips 2026(2026年8月24-25日)で本格量産を発表した。LP30チップはチップ当たりSRAM 500MB、SRAM帯域幅150 TB/s、チップ間リンク96本に各112 Gbps、チップ当たりスケールアップ帯域幅2.5 TB/s、チップ間レイテンシ350nsを提供する(NVIDIA製品および技術資料)。ラック単位ではトレイ32台にチップ256個を束ねてSRAM合計128GB、合計SRAM帯域幅40 PB/s、スケールアップ帯域幅640 TB/s、FP8推論演算315 PFLOPSを出す。プラットフォーム設計上、Rubin GPUが長いコンテキストのプリフィルとデコーディング・アテンションを担い、LPUがデコーディングでレイテンシに敏感なフィードフォワードとMoE演算を担う異種構成だ(NVIDIA設計)。ベンダー主張として、NVIDIAはLPXをVera Rubin NVL72と組み合わせれば、兆単位パラメータモデルでメガワット当たり推論スループットが最大35倍まで上がると述べた。第3者ベンチマークでは、事前リリースされたGemma 4 31Bエンドポイント(Google Cloud、コンテキスト100kトークン、同時実行1、逐次リクエスト50回の中央値)基準で毎秒出力トークン3,400個を記録し、当該テストで最も近い代替プラットフォームの約4倍となった(Artificial Analysis測定、NVIDIAが引用した結果)。この数値は単一ユーザーのレイテンシテスト結果であり、バッチスループットテストではない点を明確にしておく必要がある。最初の顧客はNebiusで、クラウド供給はAWS、Google Cloud、Microsoft Azure、Oracleを通じて2026年下半期に始まるとNVIDIAは述べた。製造はSamsung Foundry 4nmが単独で担う。Jensen HuangはGTC 2026年3月のステージで、SamsungがGroq 3 LPUチップを製造しており、出荷は下半期、おおむね第3四半期に始まるだろうと述べた。またSamsungは2026年6月にLP30を生産中であると確認した。2026年10月13日の報道によると、SamsungはOCP 2026でGroq LPUウェハーを展示し、チップは平沢で量産されている。
- 帯域幅と容量の非対称がこの分離の本質だ(独自計算)。 チップ単位で比較すると、LP30のSRAM帯域幅150 TB/sはTrainium3のHBM3e帯域幅4.9 TB/sの約31倍、H100の3.35 TB/sの約45倍だ。ラック単位に広げると、LPXの40 PB/s、すなわち40,000 TB/sはTrn3 UltraServerの合計帯域幅706 TB/sの約57倍に上る。ところが容量では図が正確に逆転する。Trn3 UltraServerのHBM 20.7 TBはLPXラックのSRAM 128GBの約162倍だ。重みだけを置いた適合計算(FP8基準でパラメータ当たり1バイト、KVキャッシュ除く)でもこの非対称はそのまま表れる。70Bモデルの重みは70GBなのでLPXラック1台に入るが、405Bモデルは405GBなので最低4台、1兆パラメータモデルは1,000GBなので最低8台が必要だ。反対に3モデルともTrn3 UltraServer 1台に大きな余裕を残して入る。第1世代GroqChip(SRAM 230MB)では70Bモデルの重みだけでも約305個のチップが必要だった点と比較すると、LP30の500MBも依然として容量の壁の前では小さい。要するにSRAMは帯域幅で勝ち、HBMは容量で勝ち、どちらか一方が他方を代替する関係ではない(2026年10月24日時点の独自計算)。
- 学習陣営はHBM容量で固まりつつあり、ソフトウェアの障壁が下がった。 AWSはre:Inventで2025年12月2日にTrainium3を正式に発売した。TSMC 3nmプロセス、チップ当たりFP8演算2.52 PFLOPS、HBM3e 144GB、帯域幅4.9 TB/sが公式仕様だ(AWS Trn3公式ページ)。チップ144個を束ねたTrn3 UltraServerはFP8 362 PFLOPS、HBM3e 20.7 TB、合計帯域幅706 TB/sを提供する。AWSはTrainium2比で演算4.4倍、メモリ帯域幅約4倍の向上を主張しているが、これはベンダー主張だ。物量面では、AWSとAnthropicのProject Rainierが2025年後半に稼働を開始してTrainium2約50万個でClaudeを学習させており、約100万個規模へ拡張中だ。2026年10月の報道によると、Anthropicは10年間で1,000億ドルを超えるAWS容量コミットメントを結び、OpenAIの380億ドル規模のAWS契約にはTrainium容量約2GWが含まれたと報じられた。二つの数値とも報じられた内容だ。ここにソフトウェアの変化が重なった。Amazonは2026年10月19日にTorchNeuronを発表し、2026年10月20日にPyTorch Conference North Americaで公開ベータを開始した。Apache 2.0オープンソースのTorchNeuronは従来のXLA経路を捨ててPyTorchネイティブ・デバイスバックエンドを使い、eagerモードとtorch.compile、FSDPとDTensorをサポートする。AWSはこれをTrainium学習へ移る際のソフトウェア移植障壁を取り除く手段として打ち出している。
- Samsungは分離の両側に立ち、SKハイニックスはHBM側に立つ。 SamsungはNVIDIA GPUプラットフォームでHBMシェアの回復を狙うと同時に、HBMがまったくないLP30の単独ファウンドリだ。そのためデコーディングのSRAM移行はSamsungにとって単純な損失ではない。HBM側リスクの一部が平沢の4nmファウンドリ物量へ転換される構造だからだ。物量感覚をつかむための試算(独自計算、試算)として、LPXラック1台はSamsungが作った4nm LPU 256個で構成され、ラック1,000台ならLPU 256,000個になる。反対にSKハイニックスは純粋にHBM側にエクスポージャーがある構造だ。ただし、これは直ちにHBM需要の減少を意味しない。学習とプリフィルは引き続きHBMを消費する。Rainierが約50万個から約100万個のチップへ拡張され、次世代Trainium3チップごとにHBM3e 144GBが搭載される限り、近い時期のHBM需要がSRAMデコーディングのために折れる理由は弱い。SRAMが制限するのはHBM成長ストーリーのうち推論区間、その中でもレイテンシにプレミアムを支払うデコーディングの断片だけだというのが、2026年10月24日時点の解釈だ。
- この分離を反証する条件もすでに見える。 第一に、NVIDIAの設計自体がデコーディング・アテンションをRubin GPU、すなわちHBM側に残しておく。分離はラックの中で起きることであり、勝者総取りではない。第二に、容量計算が兆単位モデルではSRAM側に不利に働く。1兆パラメータモデルはFP8重みだけでLPXラック最低8台が必要で、長いコンテキストで膨らむKVキャッシュまで加えれば必要台数はさらに増える。コンテキストが長くなるほど容量の壁が再び大きくなるということだ。第三に、中国変数だ。SRAMデコーディング経路は理論上、高級HBMを必要としないためHBM輸出管理のボトルネックを迂回できるが、2026年10月24日時点で量産が公開された中国製SRAMデコーディングアクセラレータはない。理由は構造的だ。SRAM主体のダイは面積を多く占め(LP30は4nmでチップ当たりSRAM 500MB)、その先端ロジックプロセス自体が制約対象であり、本当の堀はメモリセルではなく決定的実行を可能にするコンパイラにあるからだ。この段落の中国に関する評価は解釈だ。
Chaseの見方
デコーディングはレイテンシ事業であり、学習は容量事業だ。一つのメモリウォールと呼んできたものは、実は二つの壁に分かれた。デコーディングを阻む帯域幅の壁と、学習とプリフィル、長いコンテキストを阻む容量の壁だ。壁ごとに勝つシリコンが異なる。
実務者の観点で興味深い点は別にある。コンパイラが実行順序をあらかじめ決める決定的チップは、難しい問題をランタイム・ハードウェア調停からコンパイル時点のスケジューリングへ移し替える。チップ256個が350nsリンクで束ねられたラックは、全体が一つの巨大なstatic timing問題と変わらない。結局、コンパイラを持つ側がアーキテクチャを持つ。
今後確認すべきことは四つだ。第一に、2026年第4四半期の決算発表でLPXラック出荷台数が数字として登場するか。第二に、独立企業として残ったGroqがNVIDIA内部の自社ライセンス設計と競いながらもクラウド推論シェアを守り抜けるか。第三に、TorchNeuron以降、AnthropicとOpenAIのコミットメントに続いて二つ目のフロンティアラボがTrainium学習に付くか。第四に、次のRubin世代でGPU側のデコーディング比重が大きくなるか小さくなるかだ。
示唆
メモリ需給を見る問い自体が変わる。どれだけ速いHBMかではなく、どの区間に付くメモリかを分けて見なければならない。学習とプリフィル用HBM需要曲線と、デコーディング用SRAMおよびファウンドリ需要曲線は異なる速度で動く。
ファウンドリの観点では、平沢の事例が示すように、最先端ではない4nm級ラインもAI物量の中心に立てる。デコーディングチップは最新プロセスよりもSRAM密度と歩留まり、そしてコンパイラとの共同最適化が競争力を分ける。
モデルサービング事業者にとっては、ハイブリッド構成が原価構造を変える。レイテンシにプレミアムが付く区間だけをSRAMで切り離し、残りはGPUに残す方式だ。ただし、兆単位モデルでラック最低8台という計算が示すように、小規模サービングではGPUのデフォルトが簡単に崩れない。
韓国サプライチェーンに絞れば、Samsungは両面ヘッジを備えた側であり、SKハイニックスは学習サイクルにエクスポージャーがある側だ。同じメモリ分岐点でも二社のリスクプロファイルは異なる動きをするというのが、2026年10月24日時点の解釈だ。
よくある質問
Q. SRAMデコーディングが広がればHBM需要は減りますか? A. 短期的には減りません。2026年10月24日時点で学習とプリフィル、そしてデコーディング・アテンションはHBMに残っており、SRAMが担う区間はレイテンシに敏感なデコーディングの一部です。AWS Project RainierはTrainium2約50万個から約100万個へ拡張中であり、Trainium3はチップ当たり144GBのHBM3eを搭載します。SRAMが制限するのはHBM成長ストーリーのうち推論、その中でもレイテンシ・プレミアムが付くデコーディングの断片だけです。
Q. Groq 3 LPXラック1台で1兆パラメータモデルを動かせますか? A. 重みだけではできません。独自計算では、FP8基準で1兆パラメータの重みは1,000GBなので、SRAM 128GBラックが最低8台必要です。70Bモデルは70GBなのでラック1台に入り、405Bモデルは最低4台が必要です。反対にHBM 20.7 TBを搭載したAWS Trn3 UltraServerは3モデルとも1台に余裕を持って入ります。
Q. Samsungはこの分離で損ですか、得ですか? A. 両側に立っているため、単純な損ではありません。SamsungはNVIDIA GPUプラットフォームでHBMシェアの回復を狙うと同時に、HBMがないGroq 3 LP30の単独ファウンドリです。デコーディングがSRAMへ移れば、HBMリスクの一部が平沢4nmファウンドリ物量へ転換されます。独自計算では、LPXラック1台はSamsungが作ったLPU 256個であり、1,000台なら256,000個です。
Q. 中国がSRAMデコーディングでHBM輸出管理を迂回できますか? A. 理論上は可能な経路ですが、2026年10月24日時点で量産が公開された中国製SRAMデコーディングアクセラレータはありません。SRAM主体のダイは面積を多く占め、それ自体に制約がある先端ロジックプロセスが必要であり、本当の堀はメモリセルではなくコンパイラのスケジューリングにあるからです。この段落の評価は解釈です。
本記事は2026年10月24日時点の公開発表と報道に基づく分析であり、投資勧誘ではありません。ベンダー数値は各社の発表基準であり、報じられた取引規模とコミットメント規模は公式に確認された数値ではありません。
📩 今日の分析を見逃したら、明日の朝はメールで
毎日10:30(KST)のDaily Siliconと、決算・レポートの核心解説をいち早くお届けします。Samsung・SK hynix・TSMC・HBM需給を現役エンジニアの視点で整理。すでに300名以上が購読中です。
無料で購読する →
無料 · スパムなし · いつでも解除可能