 VLSI Korea
即使在 DRAM 裡計算,資料重排慢了還是會輸
記憶體內部運算的效能,不只由算術電路決定。本文以 RAPID 研究為出發點,探討資料配置與 CPU 往返成本如何改變 PIM 的勝負條件。


🆓 免費文章 · 任何人都可以免費閱讀
即使 DRAM 內部的計算很快,如果把資料還原成 CPU 能讀取的形式需要很長時間,應用程式還是會變慢。移動運算位置,與消除資料移動,是不同的設計課題。
2026-10-01 提交的 RAPID 預印本正是針對這個落差。作者們報告在 DDR4 配置下,相較於 SIMDRAM 有 5.9 倍的效能,但同一篇論文中若只比較記憶體內部運算,SIMDRAM 的吞吐量更高。造成差異的核心,是比較中包含的資料轉置成本。RAPID, §VI–VII
VLSI Korea view: 評估 PIM 時的單位不是單一命令,而是從主機交出輸入的時點,到下一個運算能使用結果的時點為止。
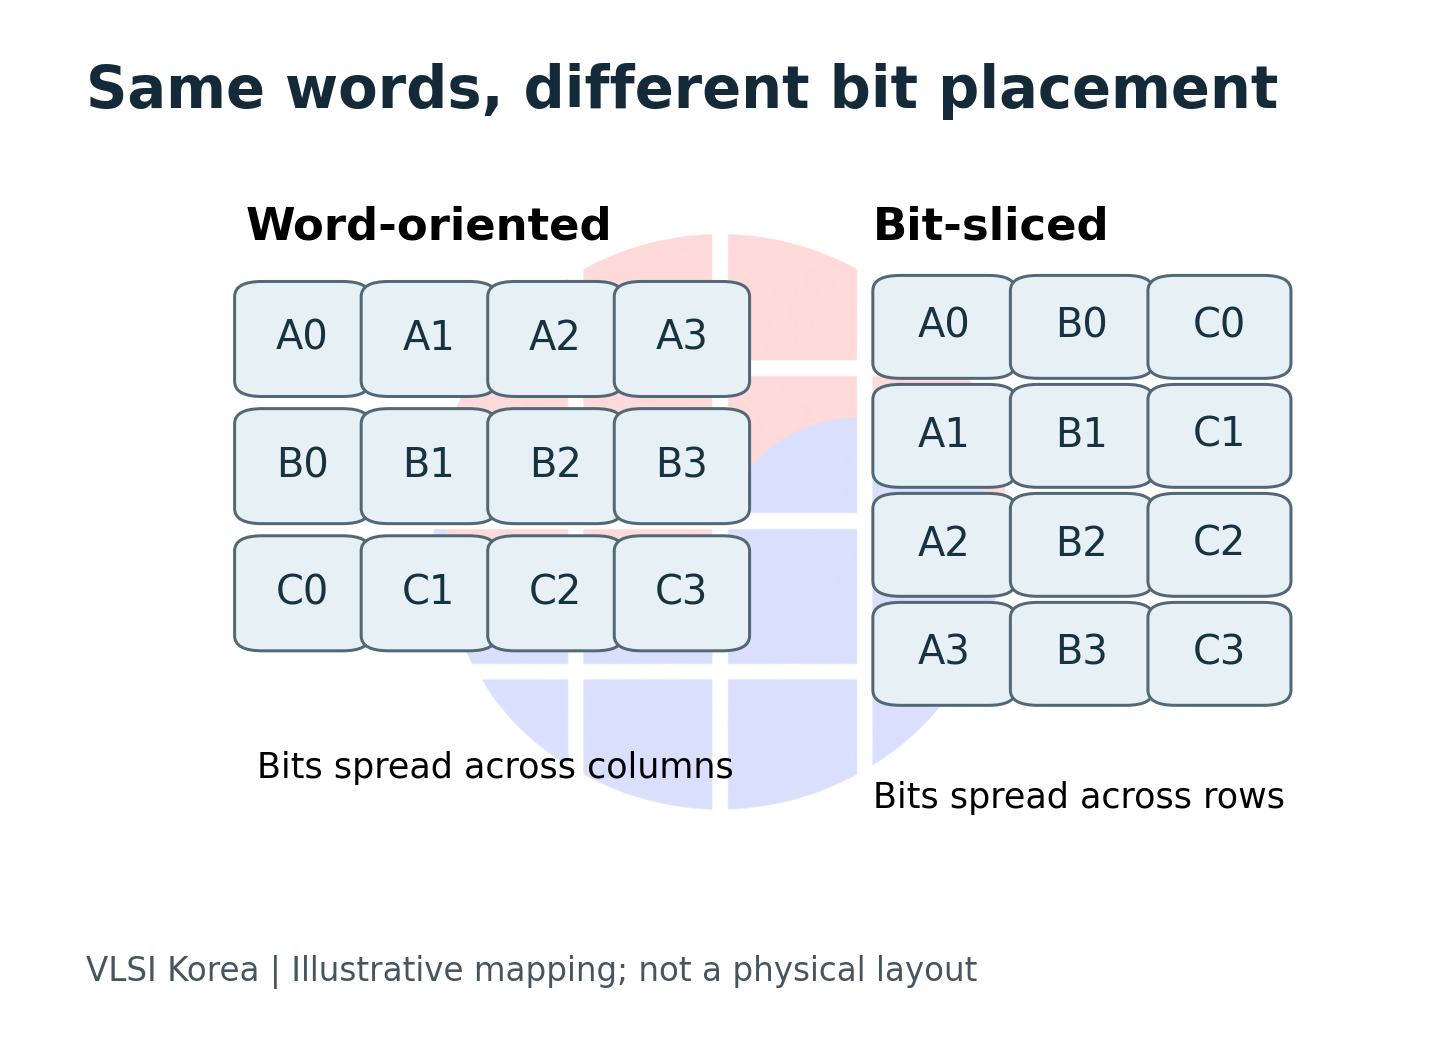
相同的資料,位元放置的方向也不同
CPU 處理整數時,會把一個值的多個位元綁在一起讀取。相對地,bit-serial DRAM 運算則把資料配置成方便同時處理不同值的相同位階位元的樣子。這裡的橫向與縱向,不只是指 C 陣列的列優先、行優先儲存順序。一個值的位元,是分散在 DRAM 的多條 bitline 上,還是分散在同一條 bitline 的多個 row 上,才是核心。
SIMDRAM 是一項把每個 DRAM column 當作獨立 SIMD lane 使用,串連位元單位運算來執行複雜計算的研究。它能同時處理多個值,但如果主機與運算器期待的配置不同,就必須考慮輸入與輸出的轉換。SIMDRAM,作者摘要
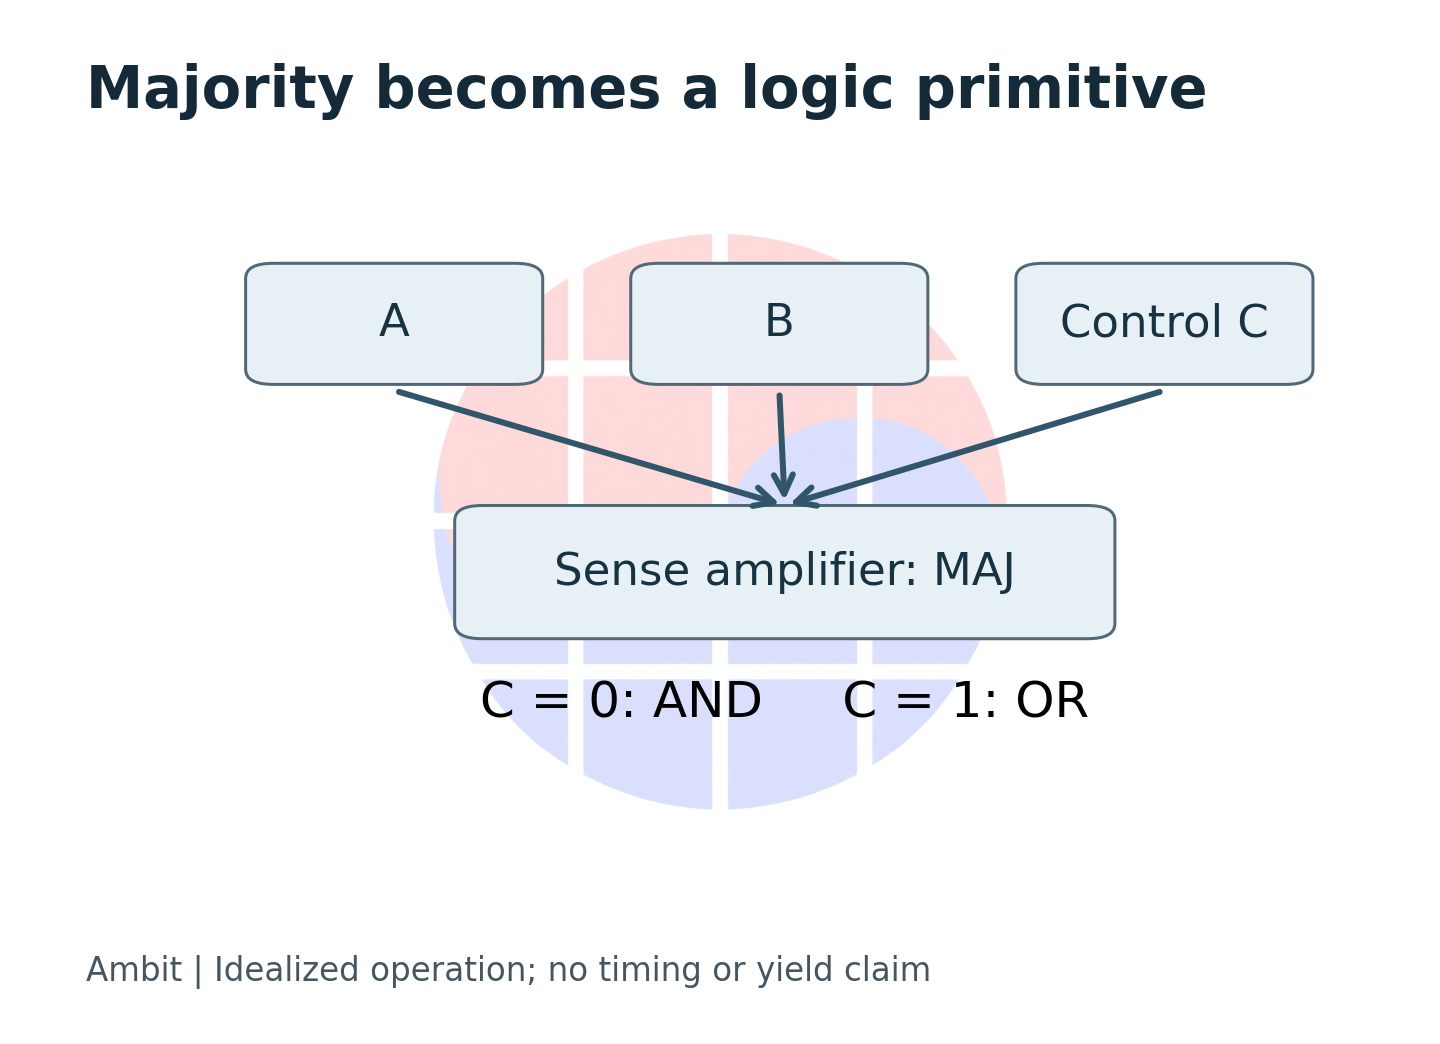
這類運算的出發點,是 DRAM 擁有的電荷與 sense amplifier。Ambit 提出了同時啟用共享同一個 sense amplifier 的多個 row,來執行 bitwise 運算的結構。若想三個輸入的多數決,當把一個輸入固定為低時是 AND、固定為高時是 OR 的關係,就能理解。Ambit, MICRO 2017
但是,在同一條 bitline 上結合電荷的能力,並不會同時給予把 carry 傳到旁邊 column 的能力。要做出算術運算,必須一起設計位元的位階移動、中間結果的儲存與輸入的保存。能計算邏輯式這個事實,與能得到想要的吞吐量這個主張,是兩回事。
| Approach | Main operation site | Layout question |
|---|---|---|
| Host CPU | Processor logic | How are words fetched and reused? |
| Bit-serial PUM | DRAM bitlines and sense amplifiers | How are word bits distributed across rows? |
| Row-parallel PUM | Modified DRAM array | How do adjacent bit positions communicate? |
| HBM-PIM with PCU | Added computing units in memory | How are operands delivered to the units? |
Table 1. Architectural distinctions, not a performance ranking. Sources: SIMDRAM, RAPID and Samsung.
要橫向計算,就必須能橫向移動
RAPID 增加了協助相鄰 bitline 之間移動的 migration cell,以及用於反轉的 cell。透過這些,它試圖在把同一個值的位元放在橫向的同時,構成算術運算。這不是只在既有 DRAM 模組上安裝軟體的提案,而是改變 DRAM 內部結構的研究。RAPID, §III
內部複製是它的基礎。RowClone 的 Fast Parallel Mode 是在同一個 subarray 內,依序啟用 source 與 destination row 來複製資料的方式。利用這個原理,可以減少把全部資料讀到 CPU 再寫回去的路徑。不過,row 複製與位元轉置並不是同一個運算。RowClone,作者摘要
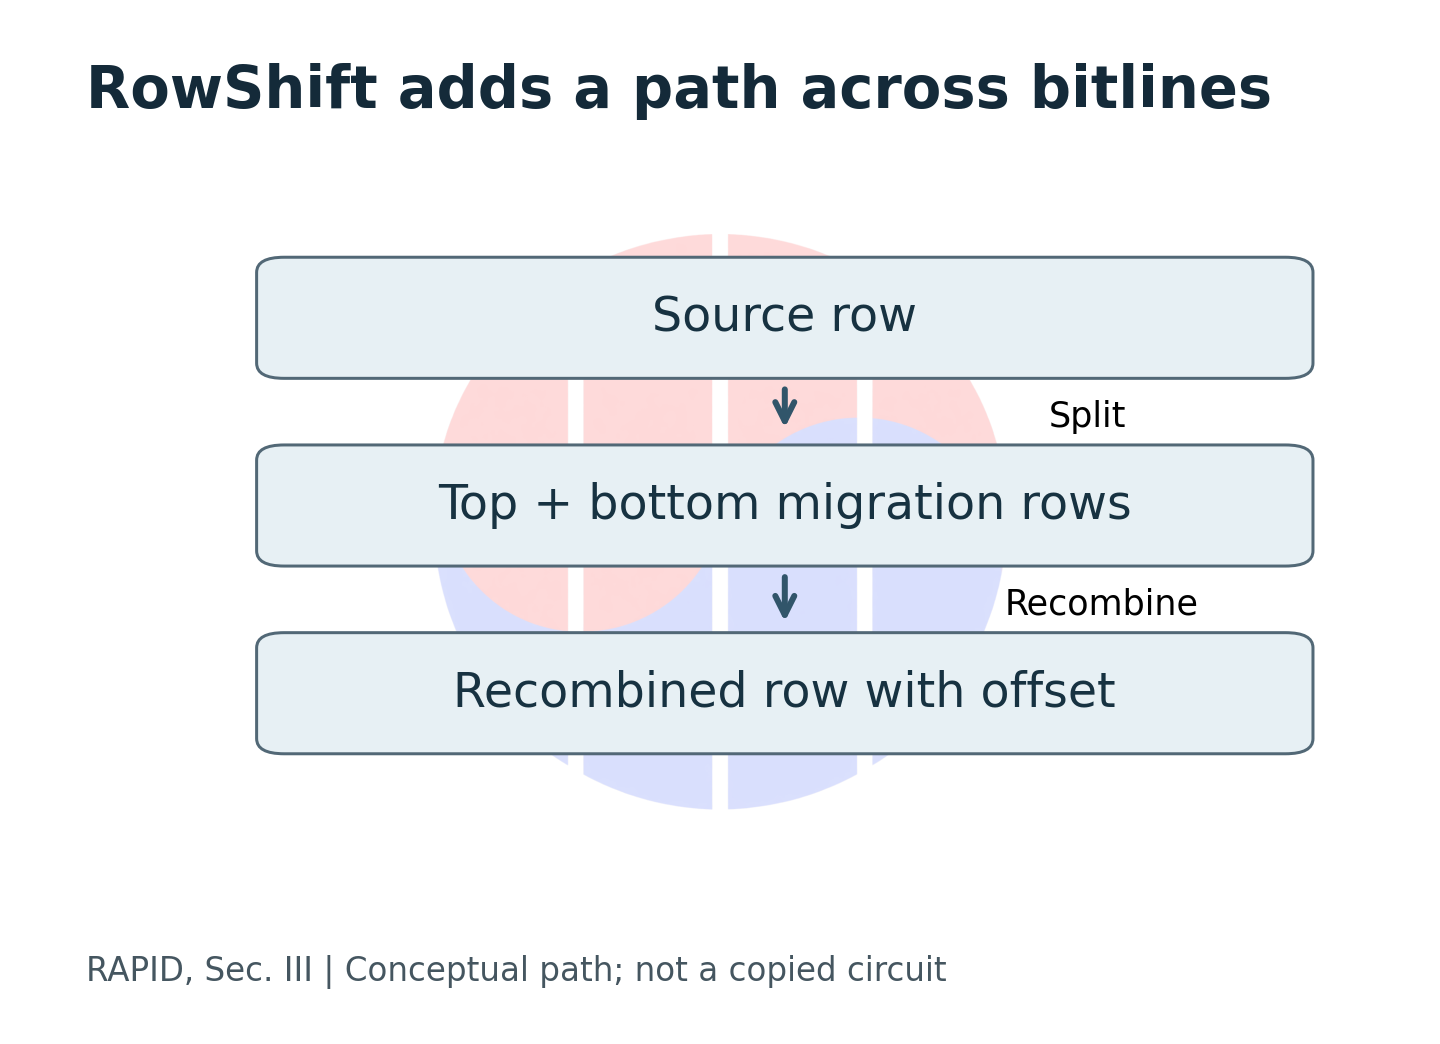
即使橫向移動成為可能,成本也不會消失。如果把由多個位元組成的值貼在一個 row 上,就必須設置邊界,讓跨越值的移動不會污染旁邊的 operand。電路設計者必須一起計算允許移動的空間,以及因此減少的有效資料空間。
同樣的理由,「bit-parallel 的平行性很高」這種說法也不充分。一個值的計算很快結束,與一次能計算很多個值,是不同的事。如果一個值佔用了更多 column 與保護空間,能同時容納的值的數量就會減少。
最上方的 Micron MT4C1024 照片,是把這些討論與實際 DRAM 陣列連結起來的歷史參考。可以看到重複的記憶體區域與周邊電路,但無法從照片推測個別運算路徑或新 cell 的配置。這張照片不是 RAPID 實現晶片的證據。照片原始來源
| Evidence layer | What it supports | What it does not establish |
|---|---|---|
| Circuit simulation | Feasibility under modeled conditions | Production yield and retention |
| Host conversion measurement | Cost on the tested host | Cost on every processor |
| Composed GEMV evaluation | Comparison within the modeled workload | Full-model silicon speedup |
Table 2. Keep evidence layers separate when interpreting RAPID. Source: RAPID §VI; VLSI Korea.
效能逆轉會在擴大量測區間時出現
在 RAPID 的 32-bit 比較中,SIMDRAM 的 PUM-only 吞吐量高出 2.7–2.8 倍,但在 DDR4 中包含轉置的比較結果則相反。本文的評估對象,是從 19 個模型中抽出的 GEMV 運算,結合了電路與架構模擬,以及 ARM 主機的轉置量測值。因此,不能把結果移轉讀成已完成的商用 AI 伺服器或整個模型的實測加速率。RAPID, §VI-D·VII-C
這項研究提出的實務問題很清楚。資料格式轉換會拿走多少在算術部分贏得的時間?轉置不是改變結果值的計算,而是改變相同位元位置的工作,因此在只計算運算次數的效能指標中很容易消失。
設計範例:只考慮依序執行,假設 bit-serial 計算時間 C 為 100 µs、配置相容方式的計算時間 H 為 280 µs、每發生一次配置改變的邊界成本 X 為 25 µs。當邊界數為 N 時,前者的總時間是 C + N × X。這些數值不是論文的重現值,也不是產品規格。
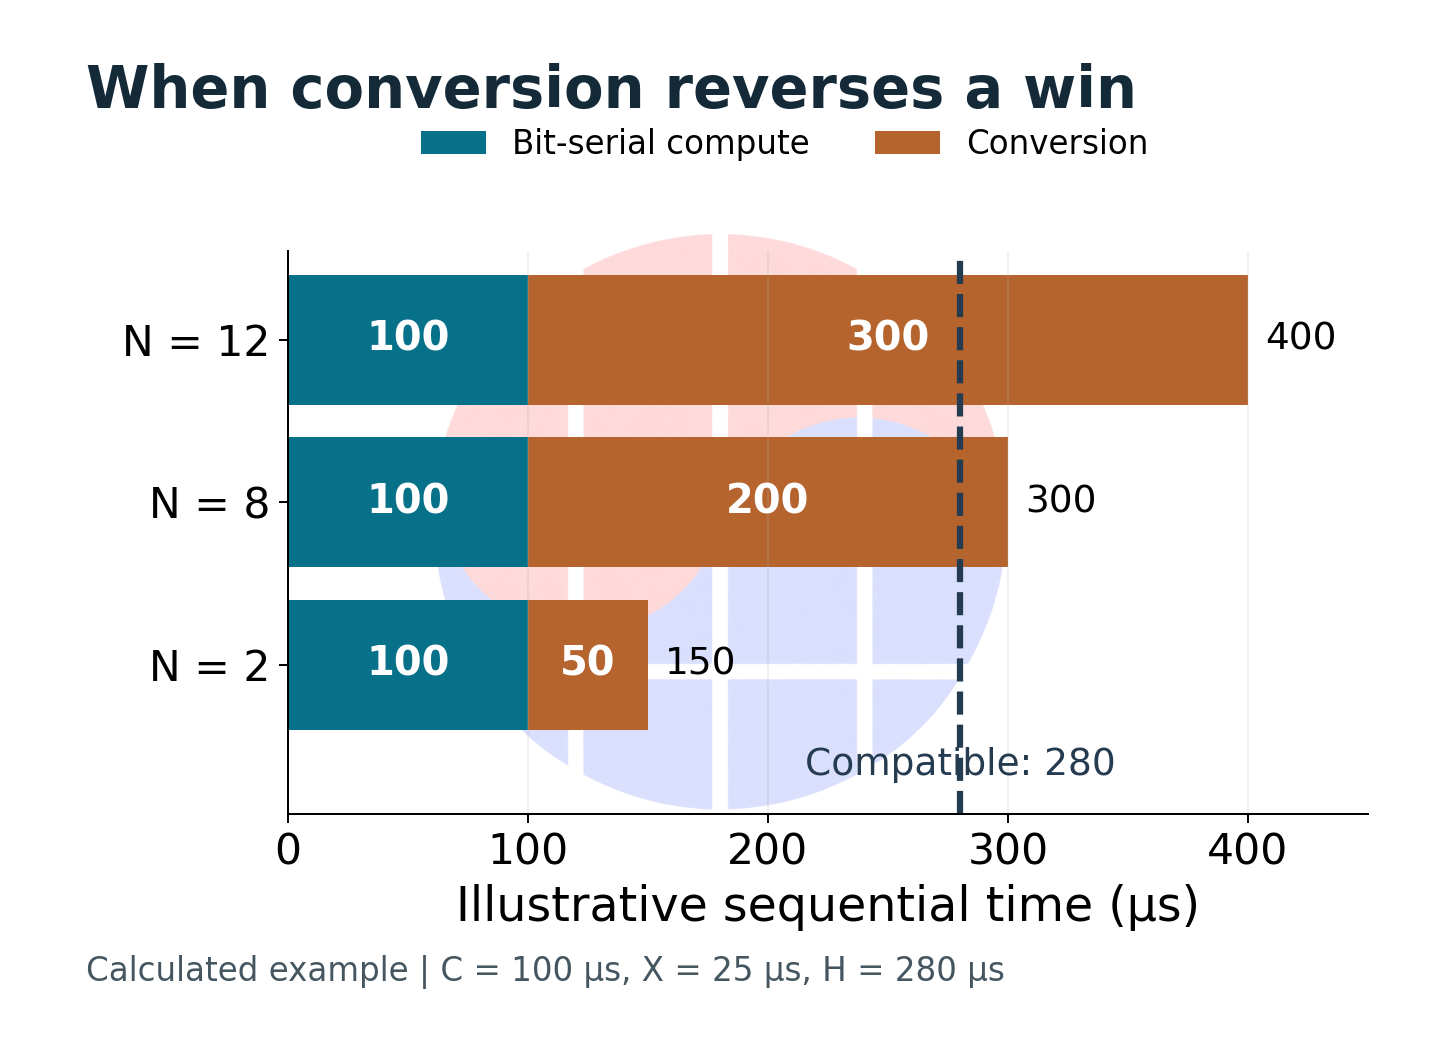
在這個條件下,當 N 大於 7.2 時,配置相容方式較有利。由於邊界數是整數,至少需要 8 次轉換。反過來說,如果讓中間結果長時間維持相同格式,減少邊界數,bit-serial 方式可能又變得有利。
| Layout boundaries N | Bit-serial total (microseconds) | Compatible total (microseconds) | Lower latency |
|---|---|---|---|
| 2 | 150 | 280 | Bit-serial |
| 8 | 300 | 280 | Compatible layout |
| 12 | 400 | 280 | Compatible layout |
Table 3. Calculated illustration, not measured hardware. Boundary count is the number of actual layout changes, not the number of operators.
在同一個範例中,如果一次轉換的成本降到 10 µs,臨界值就變成 18 次,實際收益從第 19 次起才出現。能讓轉換變快的主機命令或專用引擎,也會改變記憶體運算器的競爭力。如果只把更快的外部介面假設為解法,可能會錯過位元重排本身的成本。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
在實際系統中,轉換與計算也可能重疊。這時不應該用單純的總和,而要量測 critical path 與緩衝區佔用。另外,如果不送到 PUM 的運算佔了整體執行時間的大部分,即使消除邊界成本,整個應用程式的改善幅度也會很小。
VLSI Korea view: 如果主機能幾乎不取回資料、長時間延續運算,那麼為了配置相容性而增加的硬體的好處就會減少。在這個條件下得到的比較結果,就是對主張的反證試驗。
編譯器要選擇的對象,是運算器與資料格式的配對
如果逐一對每個運算子獨立決定 PIM offload,即使串連了快速的 kernel,也可能產生緩慢的程式。因為每當生產者輸出的格式與消費者要求的格式不同時,轉換就會插進來。這就是為什麼資料配置不能只當作一個簡單的儲存選項,而必須當作運算之間的契約來處理。
編譯器必須知道的狀態包括值的位置、位元配置、有效範圍與下一個消費者。即使算術結果相同,如果一方主機能直接讀取,另一方需要重排,兩者可以使用的時點也不同。不能只把完成訊號做成相同,來隱藏這個差異。
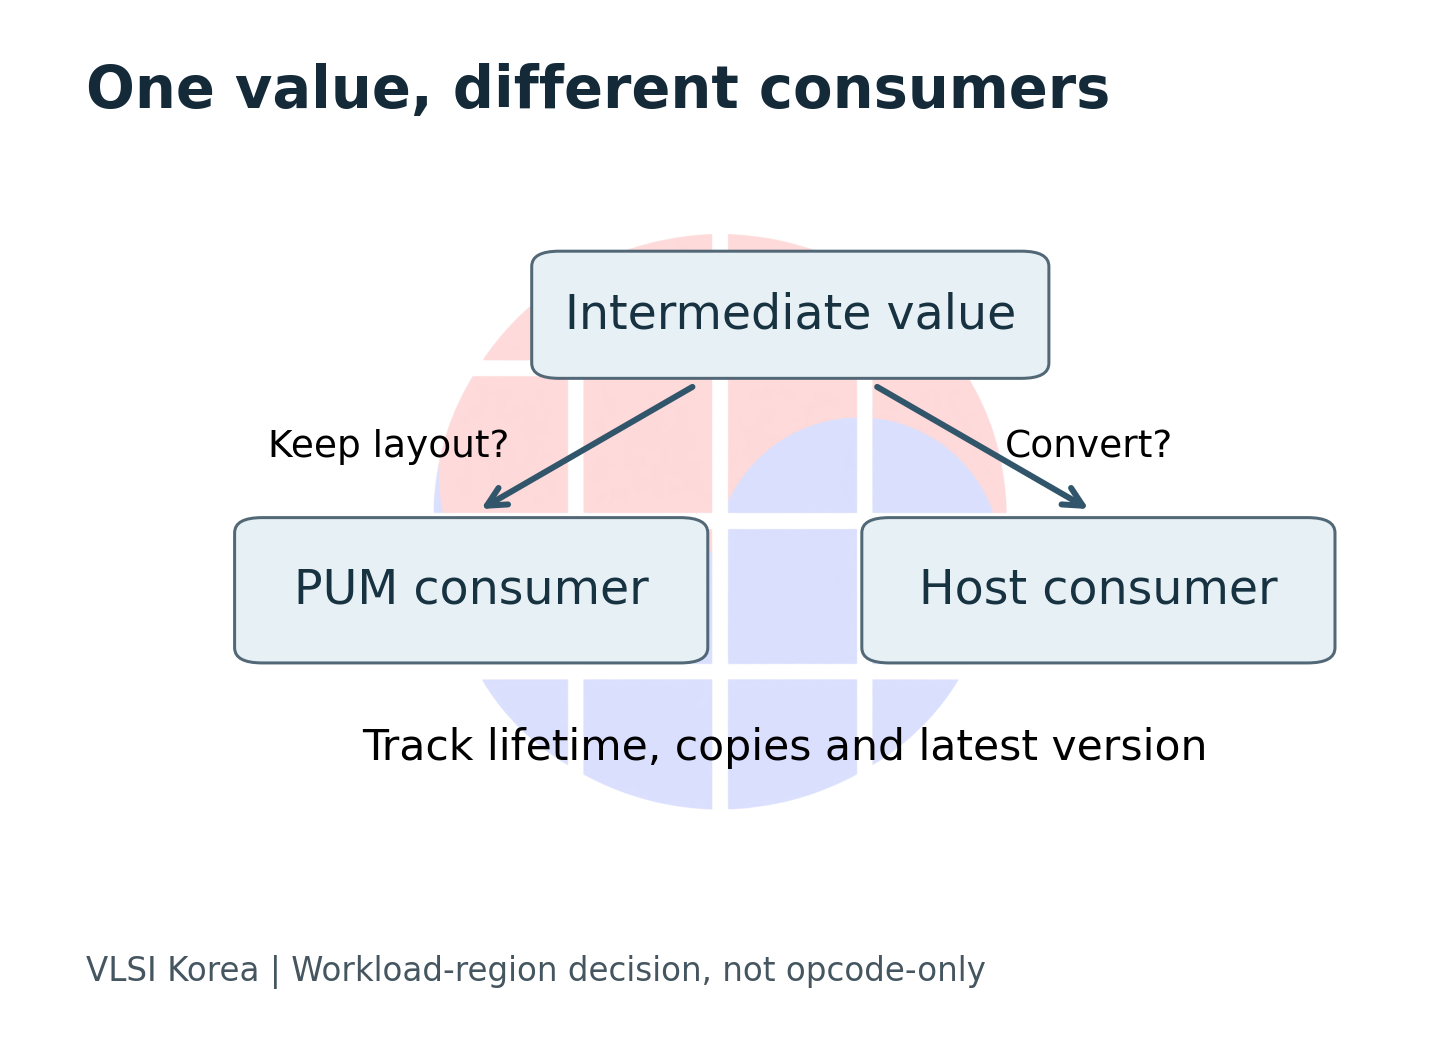
例如,如果在兩個記憶體運算之間有一個短暫的主機處理,選擇就有多種。可以把主機處理移到記憶體那一側、把運算綑綁起來減少往返,或是乾脆把整個區間留在 CPU 上。哪一種有利,必須以該區間的實際輸入大小與重複使用次數來判斷。
當輸入分流到多個消費者時,情況更複雜。如果為一個消費者製作的轉換版本也能供另一個消費者使用,就能共享成本,但若要長時間保存,就需要額外容量。如果維持不同格式的副本,還需要追蹤哪個副本是最新的規則。
因此,優化報告中除了 kernel 時間之外,還必須包含轉換次數、轉換的 byte 數、中間緩衝區的壽命與最大佔用量。如果算術吞吐量改善了,但這些數值惡化,就很難判斷這是系統觀點上的進步。所有項目都必須在相同條件下量測,比較才成立。
| Decision | Potential benefit | Cost to measure |
|---|---|---|
| Keep bit-sliced data | Fewer repeated conversions | Host access and output conversion |
| Preserve word-oriented data | Easier host handoff | Array occupancy and local movement |
| Fuse operators | Fewer execution boundaries | Scratch capacity and supported operations |
| Retain host execution | Avoid offload overhead | External traffic and CPU time |
Table 4. Decisions belong to a workload region, not just to one arithmetic opcode. Source: VLSI Korea.
在配置相容性之後,還剩下記憶體的正常運作
確認陣列運算的結果是否正確,與把它安全地用作系統記憶體,是另一個層次。如果主機 cache 還持有舊值時,就在記憶體內部完成計算,CPU 可能會讀到未更新的值。計算開始與結束時點的擁有權與可見性,必須包含在介面契約中。
ECC 也要用同樣的觀點來看。如果在記憶體內部改變了資料,但保護資訊沒有反映那個改變,之後的讀取就可能發生問題。要以什麼單位的資料與保護位元一起更新、是否需要原子性、發生例外時如何復原,都是設計上的問題。
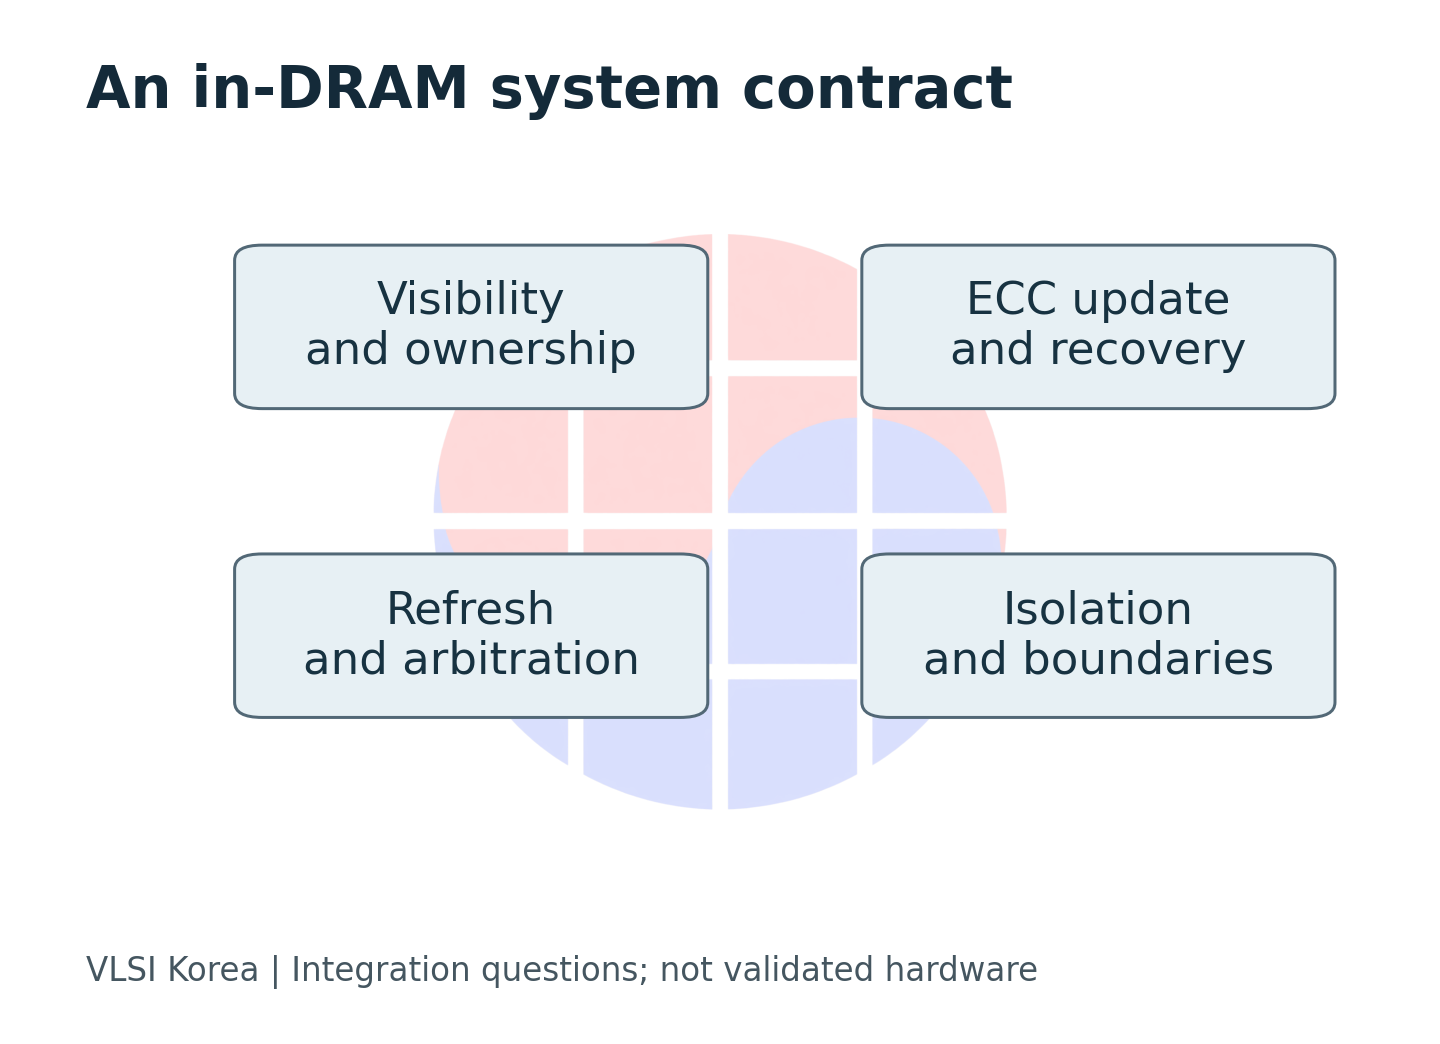
此外還有 refresh 與一般讀寫的仲裁。如果把特定 bank 長時間佔用在計算上,其他請求的延遲可能增加。即使平均吞吐量改善,也必須把對延遲敏感的請求的等待時間惡化的情況分開來看。測試需要的不只是專用於計算的狀態,還需要一般記憶體流量共存的狀態。
額外 cell 的動作驗證,也必須與可量產 DRAM 製程的證據區分開來。RAPID 提出了使用 45 nm FreePDK layout 與萃取寄生元件的 SPICE 驗證。這個結果是檢視研究結構之電路可行性的依據,並不表示在特定製造商的 DRAM 製程中,良率、retention 與 repair 已經被驗證。RAPID, §VI-A·VI-G
韓國記憶體產業要確認的,是邊界成本而非運算位置
如果把所有結構都放在 PIM 這個名字下綁成一捆,設計選擇就會變得模糊。三星電子說明的 HBM-PIM,是在記憶體內部放入 Programmable Computing Unit 的方法。與把 DRAM cell 的電荷共享用作算術基本材料的 PUM 相比,運算實現的位置不同。三星電子技術說明
對韓國記憶體、加速器與系統團隊共通的判斷基準,是跨越那個邊界的成本。記憶體業者必須看需要的陣列改變與有效容量,加速器業者看資料配置與命令介面,軟體團隊看在實際能省略轉換的執行區間,在同一個 workload 上對齊。
| Evidence to request | Decision it supports |
|---|---|
| Measured conversion time and boundary count | Whether layout compatibility pays off |
| Equal arithmetic semantics and precision | Whether outputs are actually comparable |
| Mixed host and PUM traffic | Whether memory service remains acceptable |
| Capacity and scratch-space accounting | Whether the useful system still fits |
| Silicon results across operating conditions | Whether simulation gains survive implementation |
Table 5. Evidence requests for a joint memory, accelerator and compiler evaluation. Source: VLSI Korea.
未來 6–12 個月的觀察重點,比起新的最高倍數,更是可重現的比較。需要確認獨立團隊是否以相同輸入、精度與輸出條件量測轉換時間,並公開主機與 PUM 混合區間的執行時間。如果出現把研究電路在實際 DRAM 環境中驗證的結果,設計判斷的份量也會改變。
反過來說,在只執行一次轉換、之後長時間重複使用資料的工作中,如果既有結構持續有利,配置相容方式的目標市場就會變得更窄。先找到這個邊界,比針對所有 AI 工作主張最大效能更有用。
PIM 的效能表不應該在運算器就結束。必須確認在配置輸入、計算、交給下一個消費者的整條路徑上,收益是否還存在。把計算帶進 DRAM 的下一場競爭,取決於能把那條路徑做得多短、多一致。
Sources and evidence note
RAPID v1, 2026-10-01:已確認提交紀錄的預印本,學會接受尚未確認。已閱讀正文與評估方法,結果為作者報告。未當作新商用產品發表處理。
SIMDRAM、RowClone、Ambit:本文使用該等作者摘要與機構說明中的機制。未把他們過去的效能數值,當作今天相同條件的比較重新使用。它們是彼此相關的研究脈絡,不計為獨立的 RAPID 重現實驗。
Samsung HBM-PIM:用於區分公司所說明結構的資料。ZeptoBars 照片與原始來源、使用權:歷史 DRAM 實物照片,並未展示新的研究硬體。
Disclosure: 電路概念圖與損益平衡範例,是 VLSI Korea 撰寫的說明與計算。數值範例不是量測值,圖與表也不代表效能排名或產品推薦。
相關文章
- Daily Silicon:DRAM 缺貨擴散到舊世代產品
- Daily Silicon:三星電子 2nm 與 DRAM 20%:AI 半導體價格重組
- Daily Silicon:Micron DRAM、HBM 與 AI 半導體 6 個訊號
- 無電容 DRAM — 中國研究團隊以垂直雙閘極 IGZO 實證 4F2 2T0C
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂


