VLSI Korea
구리의 마지막 저항: 448G PAM6·PTFE가 광 전환점을 늦추는 이유
576개 GPU가 한 랙에 들어가는 시대, 진짜 승부처는 신호 무결성이다. 448G PAM6·PTFE 기판·액티브 구리가 구리에 1~2세대를 더 벌어주며 CPO의 경제성을 2028~2030년 크로스오버 구간으로 밀어낸다.


구리의 마지막 저항: 448G PAM6·PTFE가 광 전환점을 늦추는 이유
30초 요약
- AI 인프라 논쟁의 초점은 늘 GPU와 HBM에 맞춰져 있다. 하지만 576개 GPU가 한 랙에 들어가는 시대 — NVIDIA Vera Rubin Ultra NVL576(2027년 출시 예정) — 가 오면 진짜 승부처는 연산이 아니라 신호 무결성(signal integrity) 이 된다.
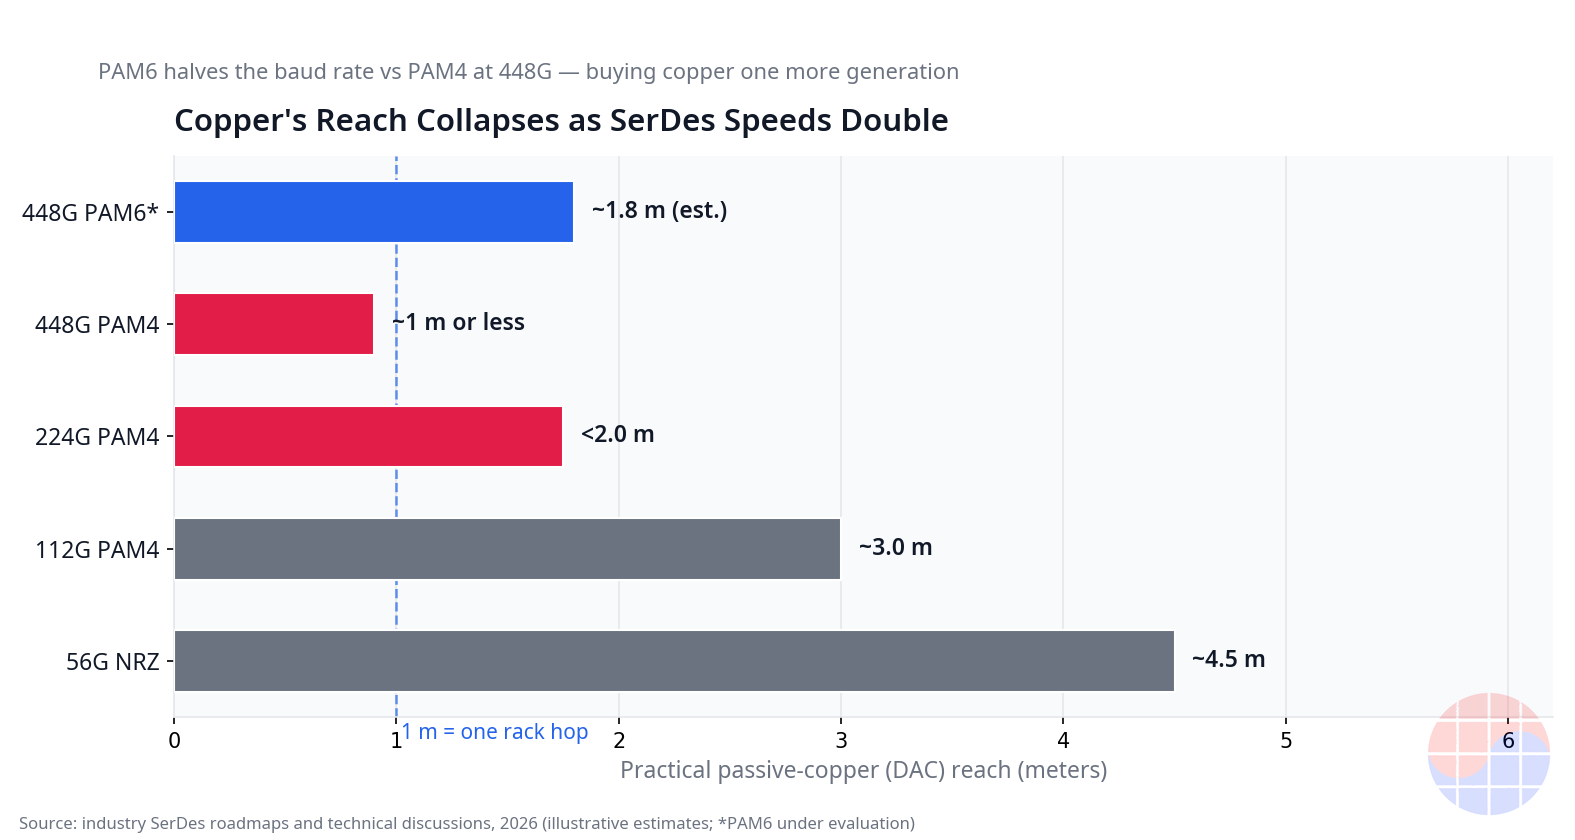
- 물리학은 냉정하다. 224G SerDes에서 수동 구리 케이블(DAC)의 실효 도달거리는 2m 미만, 448G에서는 1m 이하로 추정된다(2026년 업계 기술 논의 기준). 스킨 이펙트(skin effect)와 나이퀴스트(Nyquist) 주파수가 정한 한계다. 랙 하나를 연결하기도 버거운 거리다.
- 그래서 업계는 항복이 아니라 연장을 택했다. 448G 구리를 살리는 세 가지 무기 — PAM6 변조, 저손실 고주파 기판 소재 PTFE, 고밀도 케이블 어셈블리 — 가 2026년 10월 OCP Global Summit의 NVIDIA MGX 생태계 전시에 집결했다.
- 광 진영도 가속 페달을 밟는다. MACOM의 448G/lane PAM4 드라이버(120GHz 이상 RF 대역폭, 2026년 3월 발표), Keysight·NTT Innovative Devices·Lumentum의 224GBaud PAM4 기반 448G 광전송 데모(OFC 2025), TSMC COUPE의 2026년 CoWoS 기반 CPO 통합 목표가 대표적이다.
- 그러나 이 글의 핵심 테제는 하나다. CPO 양산의 관문은 포토닉스 자체가 아니라 테스트 처리량이다. 웨이퍼 레벨 PIC 테스트, 양면 프로빙(double-sided probing), 파이버 어태치(fiber attach)가 양산 ramp의 기울기를 결정한다.
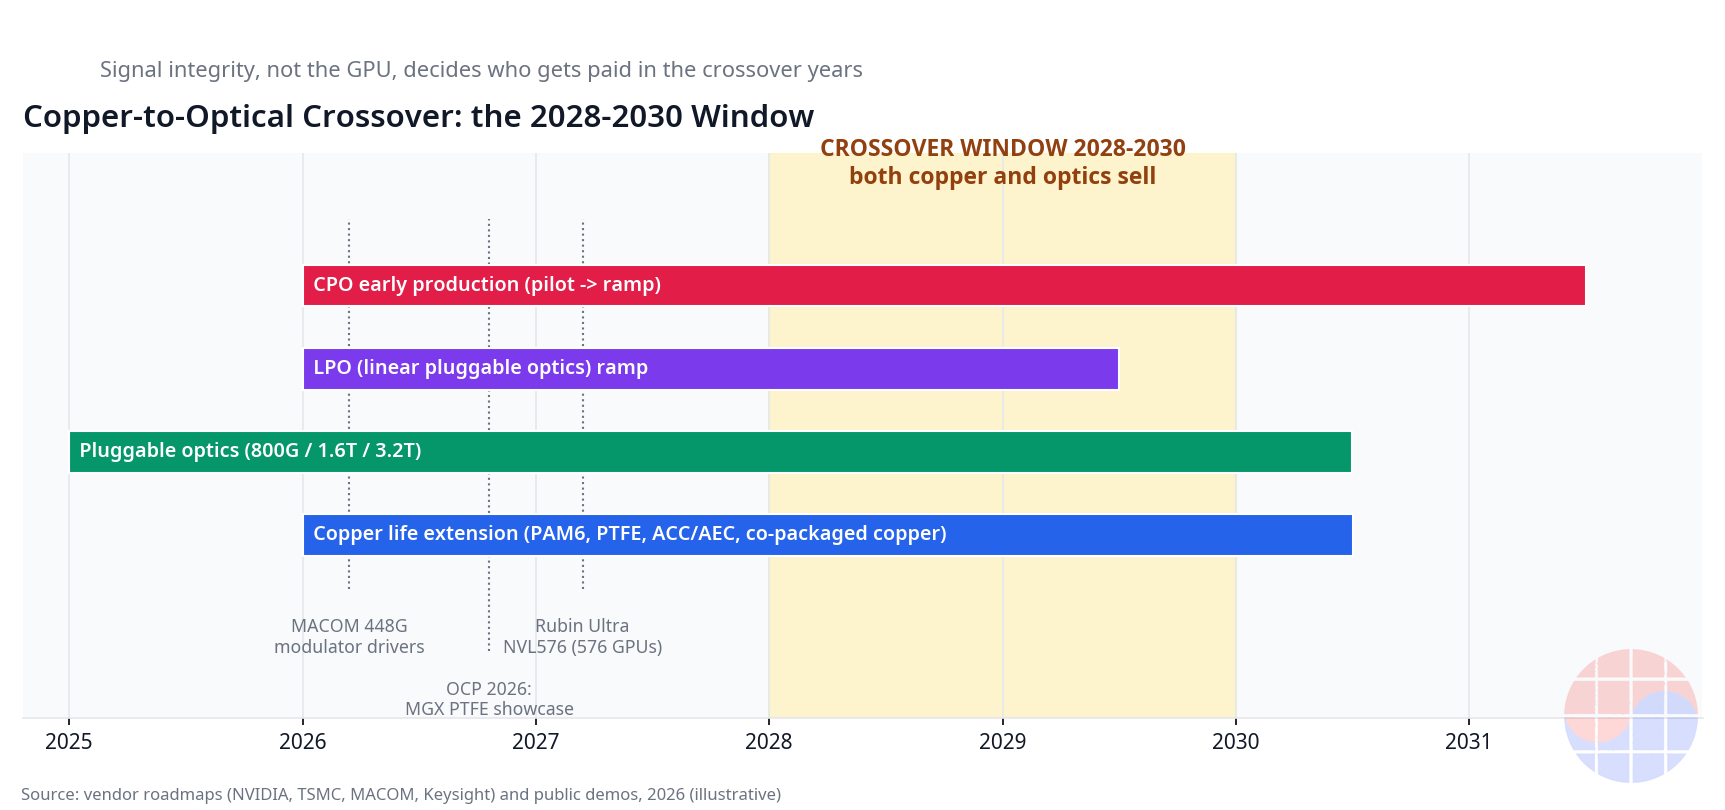
- 결론: 구리에서 광으로의 경제성 전환점(crossover)은 2028~2030년의 '크로스오버 구간'으로 밀리고 있다. 이 구간에서 돈을 버는 곳은 GPU 회사가 아니라 신호를 살리는 회사들 — SerDes, 저손실 소재, 액티브 구리, 광 테스트 장비 진영이다.
Background: 랙이 곧 컴퓨터가 된 시대
2020년 데이터센터 랙 한 개의 평균 전력은 8.2kW였다. 2025년 NVIDIA GB200 NVL72(72개 GPU)는 랙당 132kW를 찍으며 '역대 최고 전력 서버'라는 타이틀을 가져갔다. 그리고 로드맵은 멈추지 않는다. Rubin NVL144(2026년)를 거쳐 Rubin Ultra NVL576(2027년) 은 랙 하나에 576개 GPU를 넣는다. 4개 포드, 포드당 18개 블레이드, 블레이드당 8개 GPU의 구조다. 업계 분석(2026년)은 이 랙의 피크 전력이 메가와트급에 이를 것으로 본다.
동시에 추론 아키텍처도 바뀌고 있다. 프롬프트를 읽어들이는 prefill(연산 집약)과 토큰을 한 개씩 뽑아내는 decode(메모리 대역폭 집약)를 서로 다른 GPU 그룹에 분리 배치하는 disaggregated inference가 2026년의 표준 설계 언어가 됐다. NVIDIA Dynamo, AWS SageMaker HyperPod의 2026년 업데이트, 각종 추론 스택이 모두 이 방향이다. prefill 노드가 계산한 KV 캐시를 RDMA로 decode 노드에 넘기는 구조라, 랙 내부와 랙 간에 오가는 데이터량은 폭발적으로 늘어난다.
여기에 SerDes 로드맵이 겹친다. 56G NRZ에서 112G PAM4로, 다시 224G PAM4(IEEE 802.3dj 표준화 진행 중)로. 다음은 448G다. 경험칙은 단순하다. 속도가 2배가 되면 구리의 도달거리는 대략 절반이 된다. 신호가 도체 표면에 몰리는 스킨 이펙트 손실은 주파수가 올라갈수록 가팔라지고, 그 주파수의 상한을 정하는 것이 변조 방식에 묶인 나이퀴스트 주파수이기 때문이다.
정리하면, AI 인프라는 지금 세 개의 파도가 동시에 부딪히는 지점에 있다. (1) 랙당 GPU 수의 폭증, (2) prefill/decode 분리에 따른 패브릭 대역폭 폭증, (3) SerDes 속도 doubling에 따른 구리 도달거리 붕괴. 이 교차점에서 "GPU 다음의 병목은 무엇인가"라는 질문에 대한 답이 바로 신호 무결성이다.
여기에 패브릭의 이중 구조를 얹어야 한다. GPU끼리 직접 묶는 scale-up(NVLink)은 오늘날 구리의 영토다. 랙을 엮는 scale-out(Ethernet·InfiniBand)은 이미 광의 영토다. 224G 세대에서 구리가 버텨온 것은 scale-up 거리가 랙 안에 갇혀 있었기 때문이다. 그러나 576 GPU 랙과 멀티랙 NVLink 도메인이 열리면, scale-up의 거리도 늘어난다. 구리의 영토가 광의 영토를 침범당하는 지점 — 바로 그 경계선에서 이 글의 경제학이 시작된다.
Deep Dive
1. 구리가 버티는 법: 세 가지 무기
구리가 448G에서 살아남으려면 채널 손실과의 전쟁에서 이겨야 한다. 업계가 꺼내 든 무기는 세 가지다.
첫째, 변조: PAM6의 진지한 검토. 448G를 PAM4로 전송하면 보드레이트는 224GBaud, 나이퀴스트 주파수는 112GHz다. 같은 448G를 PAM6로 보내면 약 149GBaud, 나이퀴스트 약 74.5GHz로 내려간다. 채널 손실이 주파수에 비례해 커지므로, 보드레이트를 낮추는 것은 구리 채널 입장에서 직접적인 손실 절감이다. 대가도 명확하다. 레벨이 4개에서 6개로 늘면 신호 대 잡음비(SNR) 마진이 줄고, FEC(forward error correction)와 DSP의 부담이 커진다. 특히 강한 FEC는 레이턴시를 늘리는데, scale-up 패브릭에서 레이턴시는 곧 GPU 유휴 시간이다. PAM6는 "손실은 줄이고 레이턴시는 조금 내주는" 거래인 셈이다. Keysight는 2025년 4월 보도자료에서 "448Gbps 초기 R&D 단계에서 PAM4, PAM6, PAM8을 포함한 다양한 변조 방식을 탐색하고 있다"고 밝혔다. 즉 448G 구리의 변조 방식은 아직 정해지지 않았다. 미정이 곧 기회다. 표준이 굳기 전 1~2세대의 설계 윈도우가 열리는 셈이다.
둘째, 소재: PTFE. 224G/448G 레인에서는 커넥터나 케이블보다 PCB 트레이스 자체가 채널 손실의 큰 비중을 차지한다. 일반 FR-4의 유전체 손실계수(Df)로는 100GHz급 신호를 몇십 cm도 보내기 어렵다. 유전율(Dk)은 신호 속도와 임피던스를, 손실계수(Df)는 열로 새는 에너지의 비율을 정한다. 둘 다 낮을수록 고주파에 유리하고, 이 두 값을 동시에 낮춘 대표 주자가 불소수지계 저손실 라미네이트인 PTFE다. 대안은 Megtron급 저손실 FR-4 계열이지만, 224G를 넘어 448G로 가면 PTFE급 소재가 아니면 채널 예산을 맞추기 어렵다는 것이 업계의 중론이다. 2026년 10월 OCP Global Summit에서 NVIDIA MGX 생태계 전시의 한 축이 "NVLink PTFE Board" 였다는 것은 상징적이다. PCB·첨단 소재·커넥터·케이블 어셈블리 13개사가 이름을 올린 이 전시는, AI 인프라의 경쟁이 GPU를 넘어 기판 소재와 인터커넥트로 확장되고 있음을 선언한 자리였다. 기판 소재 선정이 곧 랙 설계 경쟁력의 일부가 된 것이다.
셋째, 커넥터와 케이블: 구리를 칩 가까이. 같은 전시의 다른 한 축은 "Ultra Dense Interconnect Cable Cartridge" 였다. 개념은 단순하고 강력하다. 고밀도 near-chip 커넥터로 PCB 트레이스 길이를 최소화하고, twinax 기반 고밀도 케이블로 칩 근처까지 구리를 직접 끌고 오는 것이다. 이를 co-packaged copper라 부른다. 채널 손실의 주범인 PCB 트레이스를 아예 우회하는 발상이다. Molex의 Impress co-packaged copper 솔루션은 224Gbps PAM4를 지원하며 336G·448G를 향해 개발 중이다. 여기에 액티브 구리(ACC/AEC) 가 리치를 연장한다. 리타이머·리 드라이버 DSP를 케이블 양단에 넣어 수 m를 더 버티는 대신 전력을 더 쓰는 거래다. 전력을 치르고 구리의 수명을 사는 셈이다. 수동 구리가 "0W 추가"의 미덕으로 버텨온 것과 정반대의 철학이지만, 광 모듈의 DSP 전력과 비교하면 여전히 쌀 수 있다는 계산이 깔려 있다.
이 연장 전략이 허황된 것만은 아니다. Alchip과 Synopsys는 2026년 9월 공동 발표에서 224Gbps SerDes 속도의 scale-up 인터커넥트에서 다이 엣지 혼잡(escape routing)과 패키지 브레이크아웃 문제를 시스템 레벨 최적화로 풀어냈고, 이 방법론이 448G SerDes까지 확장 가능한 기반이라고 밝혔다. 구리 진영은 아직 손에 카드가 있다.
2. 광 진영의 반격: 448G 광전송은 이미 실험실을 나왔다
구리가 버티는 동안 광은 기다려주지 않는다.
Keysight·NTT Innovative Devices·Lumentum(2025년 4월, OFC 2025) 은 224GBaud PAM4 광 기술로 448Gbps 데이터 전송 데모에 성공했다. Keysight의 M8199B 임의 파형 발생기 2대와 NTT의 주파수 영역 인터리버로 448Gbps 전기 신호를 만들고, Lumentum의 InP EML(외부 변조 레이저)로 광전송한 것이다. 같은 하드웨어로 240GBaud PAM4 생성도 시연했다. 목표는 명확하다. 전력 효율적인 3.2T 광 인터페이스다.
MACOM(2026년 3월 17일, OFC 2026) 은 448G/lane PAM4 변조기 드라이버 2종 — MAOM-025408(Mach-Zehnder 드라이버)과 MAOM-022404(EML 드라이버) — 을 발표했다. 두 제품 모두 120GHz를 넘는 RF 대역폭을 제공하며, 실리콘 포토닉스·EML·TFLN 변조기를 모두 지원한다. 1.6T와 3.2T 광 트랜시버의 시장 진입을 앞당기기 위한 부품이다. 광의 레인당 속도가 구리의 다음 세대와 같은 448G에 도달했다는 것은, 두 진영이 같은 SerDes 물리 위에서 싸우게 됐다는 뜻이다.
중간 지대도 열리고 있다. LPO(linear pluggable optics) 는 DSP를 빼고 리니어 다이렉트 드라이브로 전력을 낮춘 플러그형 광 모듈이다. 기존 플러그형 생태계(현장 교체 가능, 공급망 성숙)를 유지하면서 전력만 깎는 타협안이다. DSP는 광 모듈 전력의 큰 비중을 차지하므로, 이를 스위치 ASIC 쪽으로 넘기거나 리니어 체인으로 대체하면 모듈 전력을 크게 낮출 수 있다. CPO가 "패키지 안에 광 엔진을 넣는" 혁명이라면, LPO는 "플러그형은 두되 전력은 낮추는" 개량이다. 혁명이 늦어지는 구간에서 개량이 돈을 번다는 것이 이 글의 일관된 주장이다.
그리고 CPO(co-packaged optics) 의 큰 그림. TSMC COUPE(Compact Universal Photonic Engine) 는 SoIC-X 칩 스태킹으로 전기 다이(EIC)를 포토닉 다이(PIC) 위에 직접 올린다. 로드맵은 2025년 small-form-factor 플러그형 qualification, 2026년 CoWoS 기반 CPO 통합이다. TSMC가 제시한 수치는 5~10배의 전력 효율 개선과 10~20배 낮은 레이턴시다. NVIDIA(GTC 2025) 는 Quantum-X·Spectrum-X라는 CPO 네트워킹 스위치로 맞불을 놨다. Mach-Zehnder 대신 micro-ring modulator를 써서 밀도를 올렸고, 기존 네트워크 대비 3.5배 전력 효율·10배 복원력을 주장한다. 삼성전자도 OFC 2026에서 2027년 광 엔진, 2029년 턴키 CPO 서비스를 언급하며 전선에 합류했다.
심지어 플러그형 진영도 마지막 카드를 꺼냈다. OCP 2026(2026년 10월) 에서 NVIDIA와 Cisco가 발표한 USFP(Ultra-Dense Small Form Factor Pluggable) 는 400G/lane, 모듈당 16레인(6.4T), 향후 32레인(12.8T) 확장을 노리는新規격이다. 프론트 패널 밀도가 한계에 달하자 모듈 자체를 재설계한 것이다. 주목할 점은 USFP가 여전히 '플러그형'을 고수한다는 사실이다. NVIDIA조차 당장은 "광은 가되, CPO는 천천히"라는 중간 경로를 열어둔 셈이다.
3. 진짜 관문은 테스트다
CPO 논쟁에서 가장 과소평가되는 변수가 있다. 포토닉스 다이의 물리가 아니다. 테스트 처리량(throughput) 이다.
TSMC의 패키징 리더십은 공개 석상에서 CPO 양산의 3대 난제를 지목했다. 웨이퍼 레벨 테스트, 파이버 어레이 유닛(fiber array unit) 통합, 고속 광 패키징 어셈블리. 셋 중 첫 번째가 ramp의 목을 죈다.
이유는 구조적이다. COUPE식 스택에서 전기 다이와 포토닉 다이를 붙이는 하이브리드 본딩은 rework가 불가능하다. 불량 엔진을 수백~수천만 원짜리 스위치·GPU 패키지에 올린 뒤에야 불량을 알면 수율은 산산조각 난다. 그래서 본딩 전에 두 다이를 각각 테스트하고, 엔진 단위로 광학 프로빙을 해야 한다. 엔진 수율은 EIC 수율 × PIC 수율 × 본딩 수율 × 커플링 수율의 곱이다. 곱셈의 저주다.
테스트 장비 업계는 이미 움직이고 있다. FormFactor와 Advantest는 실리콘 포토닉스·CPO용 웨이퍼 레벨 테스트 셀 개발에 전략적 제휴를 맺었다. 9축 나노 정밀 자동 광 정렬, Advantest V93000 ATE와 FormFactor Velox 프로브 스테이션의 통합이 골자다. FormFactor는 2026년 CPO 관련 매출이 2,000만 달러를 "크게 상회(significantly exceed)"할 것으로 전망했다(2026년 2분기 실적 콜). Teradyne는 OFC 2026에서 Photon 100을 내놨다. COUPE식 스택 — 전기 접점은 한 면에, 광 포트는 다른 면에 있는 구조 — 에 대응하는 양면 프로빙 장비다.
정리하면, CPO의 양산 ramp 기울기는 "포토닉스가 되느냐"가 아니라 "테스트 장비가 얼마나 빨리 깔리느냐" 로 정해진다. 테스트 처리량이 곧 CPO 출하량이다. 이 문장은 뒤의 투자 시사점에서 다시 등장한다.
4. 크로스오버 경제학: 전환점은 기술이 아니라 곡선의 교차점에서 온다
기술 전환의 역사가 가르치는 것은 하나다. 이기는 것은 "더 좋은 기술"이 아니라 "비트당 비용·전력 곡선이 먼저 교차하는 쪽" 이다.
구리 곡선을 아래로 누르는 힘: PAM6(보드레이트를 낮춰 채널 손실 절감), PTFE(유전체 손실 절감), ACC/AEC(전력을 치르고 리치 연장). 광 곡선을 아래로 누르는 힘: LPO(DSP 제거로 전력 절감), CPO(패키지 통합으로 전력·밀도 혁신), USFP(플러그형 밀도 혁신).
여기서 핵심 질문. 구리가 448G 세대에서 1~2세대를 더 버티면 무슨 일이 벌어지는가? 답: 광의 경제성 전환점(crossover)이 뒤로 밀린다. CPO가 "구리보다 싸고 전력 효율적"이 되는 시점이 2028~2030년의 '크로스오버 구간' 으로 이동하는 것이다. 이 구간은 "둘 다 팔리는" 구간이다. 구리 진영의 마지막 수확기이자, 광 테스트 장비의 황금기다. LPO는 이 구간의 와일드카드다. 플러그형 생태계를 유지하면서 전력을 깎으므로, CPO보다 먼저 크로스오버를 앞당길 수 있다.
반론: "CPO가 더 빨리 온다"는 진영의 논거
공정성을 위해 반대 진영의 논거를 정리한다.
첫째, 전력. 랙당 수백 kW, 머지않아 메가와트급 시대에 인터커넥트가 먹는 전력 비중은 무시할 수 없다. ACC/AEC처럼 "전력을 치르고 구리를 사는" 거래가 반복되면, 어느 순간 광이 전력 기준으로 이긴다. CPO의 5~10배 전력 효율 주장(TSMC)이 사실에 가깝다면, 전력은 CPO의 가장 강한 무기다.
둘째, 밀도. 576개 GPU를 한 랙에 넣으면 프론트 패널의 물리적 면적이 한계에 부딪힌다. USFP 같은 플러그형 혁신으로도 모자라면, 패키지 안에 광 엔진을 넣는 CPO가 유일한 답이 된다. NVIDIA가 OCP 2026에서 Rubin Ultra를 "CPO 기반 NVLink 패브릭으로 576개 GPU를 연결"하는 아키텍처로 프리뷰한 것이 이 논거의 정점이다.
반론에 대한 반론. 로드맵은 양산이 아니다. CPO는 "된다"와 "수율 있게 찍어낸다" 사이에 테스트라는 협곡이 있다. 그리고 NVIDIA조차 USFP라는 플러그형 카드를 동시에 꺼냈다는 것은, 그들도 전환 구간의 길이를 알고 있다는 뜻이다. CPO 조기론이 틀렸다는 게 아니라, 조기론의 시계는 테스트 처리량에 맞춰 다시 맞춰야 한다는 것이다.
Chase's Take
PrimeTime으로 signoff를 해본 엔지니어라면 이 문장에 고개를 끄덕일 것이다. "커버리지 없는 타이밍 패스는 테이프아웃할 수 없다."
CPO도 정확히 같다. 포토닉스 다이의 물리가 문제가 아니다. "테스트로 증명된 엔진 수율"이 양산을 가른다. CPO의 signoff는 이중 구조다. 전기적 신호 무결성 signoff에 광학 수율 signoff가 하나 더 얹힌다. 테스트 커버리지 없는 광 I/O는 타이밍 클로저 안 된 넷리스트와 같다. 출하할 수 없다. 테이프아웃의 문법이 패키징의 문법이 되는 순간이다.
MBA의 눈으로 보면, 이건 크로스오버 경제학의 교과서적 사례다. 승자는 "가장 앞선 기술"이 아니라 "전환 구간의 현금흐름을 먹는 자"다. 구리 연장 1~2세대는 SerDes·DSP, PTFE 라미네이트, 액티브 케이블 업계의 마지막 슈퍼사이클이다. CPO 테스트 장비는 광 전환의 삽과 곡괭이(picks and shovels)다. 이 구간의 경제적 지대(economic rent)는 GPU 회사가 아니라 신호를 살리는 회사들에게 돌아간다. 투자자와 설계자가 봐야 할 곳은 GPU 로드맵의 다음 장이 아니라, 신호 무결성의 손익분기점이다.
Implications: 투자와 경영의 시사점
투자자에게.
- 구리 연장 수혜. SerDes IP·DSP, 리타이머, 액티브 케이블, 저손실 소재(PTFE 라미네이트). 촉매는 448G PAM6 표준화의 향방이다. PAM6가 굳어지면 구리 수명은 한 세대 더 늘어난다.
- 광 테스트 장비. CPO ramp의 선행지표이자 직접 수혜주. 테스트 처리량이 곧 CPO 출하량이므로, 테스트 셀 가동률과 장비 수주가 CPO 본체보다 먼저 움직인다.
- CPO 본체. 2028년 이전의 공격적 베팅은 '크로스오버 구간'에서 자본이 묶일 리스크가 있다. LPO는 중간 지대의 와일드카드로 별도 트래킹 가치가 있다.
설계자와 경영자에게. 448G 레인 설계에서는 도달거리 1m 가정을 아키텍처 초기부터 반영해야 한다. PCB 스택업과 소재(PTFE 등) 선정은 더 이상 후순위 결정이 아니라 랙 경쟁력의 일부다. CPO 채택 로드맵의 선행 조건은 "광 엔진 확보"가 아니라 "테스트 공급망 확보" 다.
한국 관점에서. 2026년은 한국 AI 인프라의 원년 격이다. 국가AI컴퓨팅센터(삼성SDS 컨소시엄, 과기정통부 2026년 5월 발표 — 총 2.5조원 규모, 2028년까지 AI 반도체 1.5만 장 도입 목표), 삼성 춘천 모듈러 AIDC(2026년 7월 보도 — NVIDIA Blackwell GPU 수용 설계, 2027년 10월 완공 목표), SK-AWS 울산(103MW, GPU 약 6만 장, 2029년 완공 목표), 네이버 각 세종(최대 270MW). AI 데이터센터 특별법(2026년 5월 국회 처리)으로 비수도권 구축도 가속된다.
한국은 당분간 '랙을 수입·구축하는' 입장이지만, 바로 그 지점에 기회가 있다. Blackwell·Rubin급 랙이 요구하는 고주파 대응 — 고다층 PCB의 저손실 소재 적용, 고밀도 케이블 어셈블리, 신호 무결성 검증 — 은 '크로스오버 구간'의 직접 수혜 영역이다. 구리가 1~2세대 더 버틴다는 것은, 국내 인터커넥트 공급망이 광 전환 전에 현금흐름을 만들 시간을 번다는 뜻이기도 하다. 이 시간을 어떻게 쓰는지가 다음 5년의 갈림길이다.
FAQ
Q1. PAM6가 448G 구리에 왜 유리한가요? PAM4로 448G를 보내면 224GBaud가 필요하지만, PAM6로는 약 149GBaud면 된다. 보드레이트가 낮아지면 나이퀴스트 주파수가 내려가고, 주파수에 비례하는 채널 손실(스킨 이펙트·유전체 손실)이 줄어든다. 대가는 신호 레벨이 6개로 늘며 SNR 마진이 줄고, FEC와 DSP의 부담이 커진다는 점이다. 2026년 현재 448G 구리의 변조 방식은 업계 논의 중이며 확정되지 않았다.
Q2. PTFE 기판이 왜 갑자기 중요해졌나요? 224G/448G 레인에서는 커넥터·케이블보다 PCB 트레이스 자체가 채널 손실의 큰 비중을 차지한다. PTFE는 불소수지계 저손실 고주파 라미네이트로, 낮은 유전율(Dk)과 낮은 손실계수(Df)로 100GHz급 신호의 유전체 손실을 크게 줄인다. 2026년 10월 OCP Global Summit의 NVIDIA MGX 생태계 전시에 'NVLink PTFE Board'가 등장한 것은, 기판 소재 선정이 AI 랙 설계 경쟁력의 일부가 됐음을 보여준다.
Q3. LPO와 CPO의 차이는 무엇인가요? LPO(linear pluggable optics)는 DSP를 제거하고 리니어 다이렉트 드라이브로 전력을 낮춘 플러그형 광 모듈이다. 기존 플러그형 생태계(현장 교체 가능, 성숙한 공급망)를 유지하는 개량안이다. CPO(co-packaged optics)는 광 엔진을 스위치·GPU 패키지 안에 직접 넣는 방식으로, 전력·밀도의 혁신이 크지만 웨이퍼 레벨 테스트와 파이버 어태치 등 양산 난제가 크다.
Q4. CPO는 언제쯤 본격 양산되나요? TSMC COUPE는 2026년 CoWoS 기반 CPO 통합을 목표로 하며, NVIDIA·삼성도 CPO 로드맵을 공개했다. 그러나 하이브리드 본딩의 rework 불가 특성상 웨이퍼 레벨 테스트와 양면 프로빙, 파이버 어태치의 처리량이 양산 ramp를 가른다. 테스트 장비(FormFactor·Advantest·Teradyne 등)의 보급 속도를 감안하면, 본격적인 물량은 2028년 이후로 보는 것이 합리적이다.
본 글의 도달거리·전력 수치와 시점은 2026년 10월 기준 공개 자료와 업계 기술 논의를 바탕으로 한 추정치이며, 실제 제품 사양과 양산 일정은 업체별로 다를 수 있습니다.
Sources
- MACOM, "Two New 448G per Lane Drivers for 3.2T Data Center Connectivity" (2026-03-17, 공식 보도자료)
- Keysight·NTT Innovative Devices·Lumentum, "448 Gbps Data Transmission" joint demo (OFC 2025, 2025-04-02, 공식 보도자료)
- Alchip·Synopsys, "Address Scale Up and Out Bandwidth Constraints" (2026-09-23, 공동 보도자료)
- FormFactor·Advantest, silicon photonics wafer-level test cell 전략적 제휴 (공동 발표)
- NVIDIA OCP Global Summit 2026 발표: MGX 1.2 기여, Vera Rubin Ultra 프리뷰, USFP(NVIDIA·Cisco)
- 강원일보, "삼성, 춘천에 AI데이터센터 짓는다" (2026-07-06)
- 아시아경제, "국가인공지능계산센터 사업자 삼성SDS 컨소시엄 확정" (2026-05-11)