VLSI Korea
구글 TPU 1년 만에 본전 회수 — 커스텀 실리콘 경제학이 바꾸는 AI 칩 판도
구글 TPU 서버는 1년 만에 투자금을 회수한다. TPUv7 Ironwood는 B200/B300 대비 달러당 추론 성능이 최대 50% 높다. 회수 기간이 1년이면 자체 칩은 선택이 아니라 재무적 자명함 — Broadcom·MediaTek으로 이어지는 ASIC 밸류체인이 구조적 성장을 시작한다.


발췌문: 구글 TPU 서버는 1년 만에 투자금을 회수한다. TPUv7 Ironwood는 B200/B300 대비 달러당 추론 성능이 최대 50% 높다. 회수 기간이 1년이면 자체 칩은 선택이 아니라 재무적 자명함 — Broadcom·MediaTek으로 이어지는 ASIC 밸류체인이 구조적 성장을 시작한다.
30초 요약 (AEO)
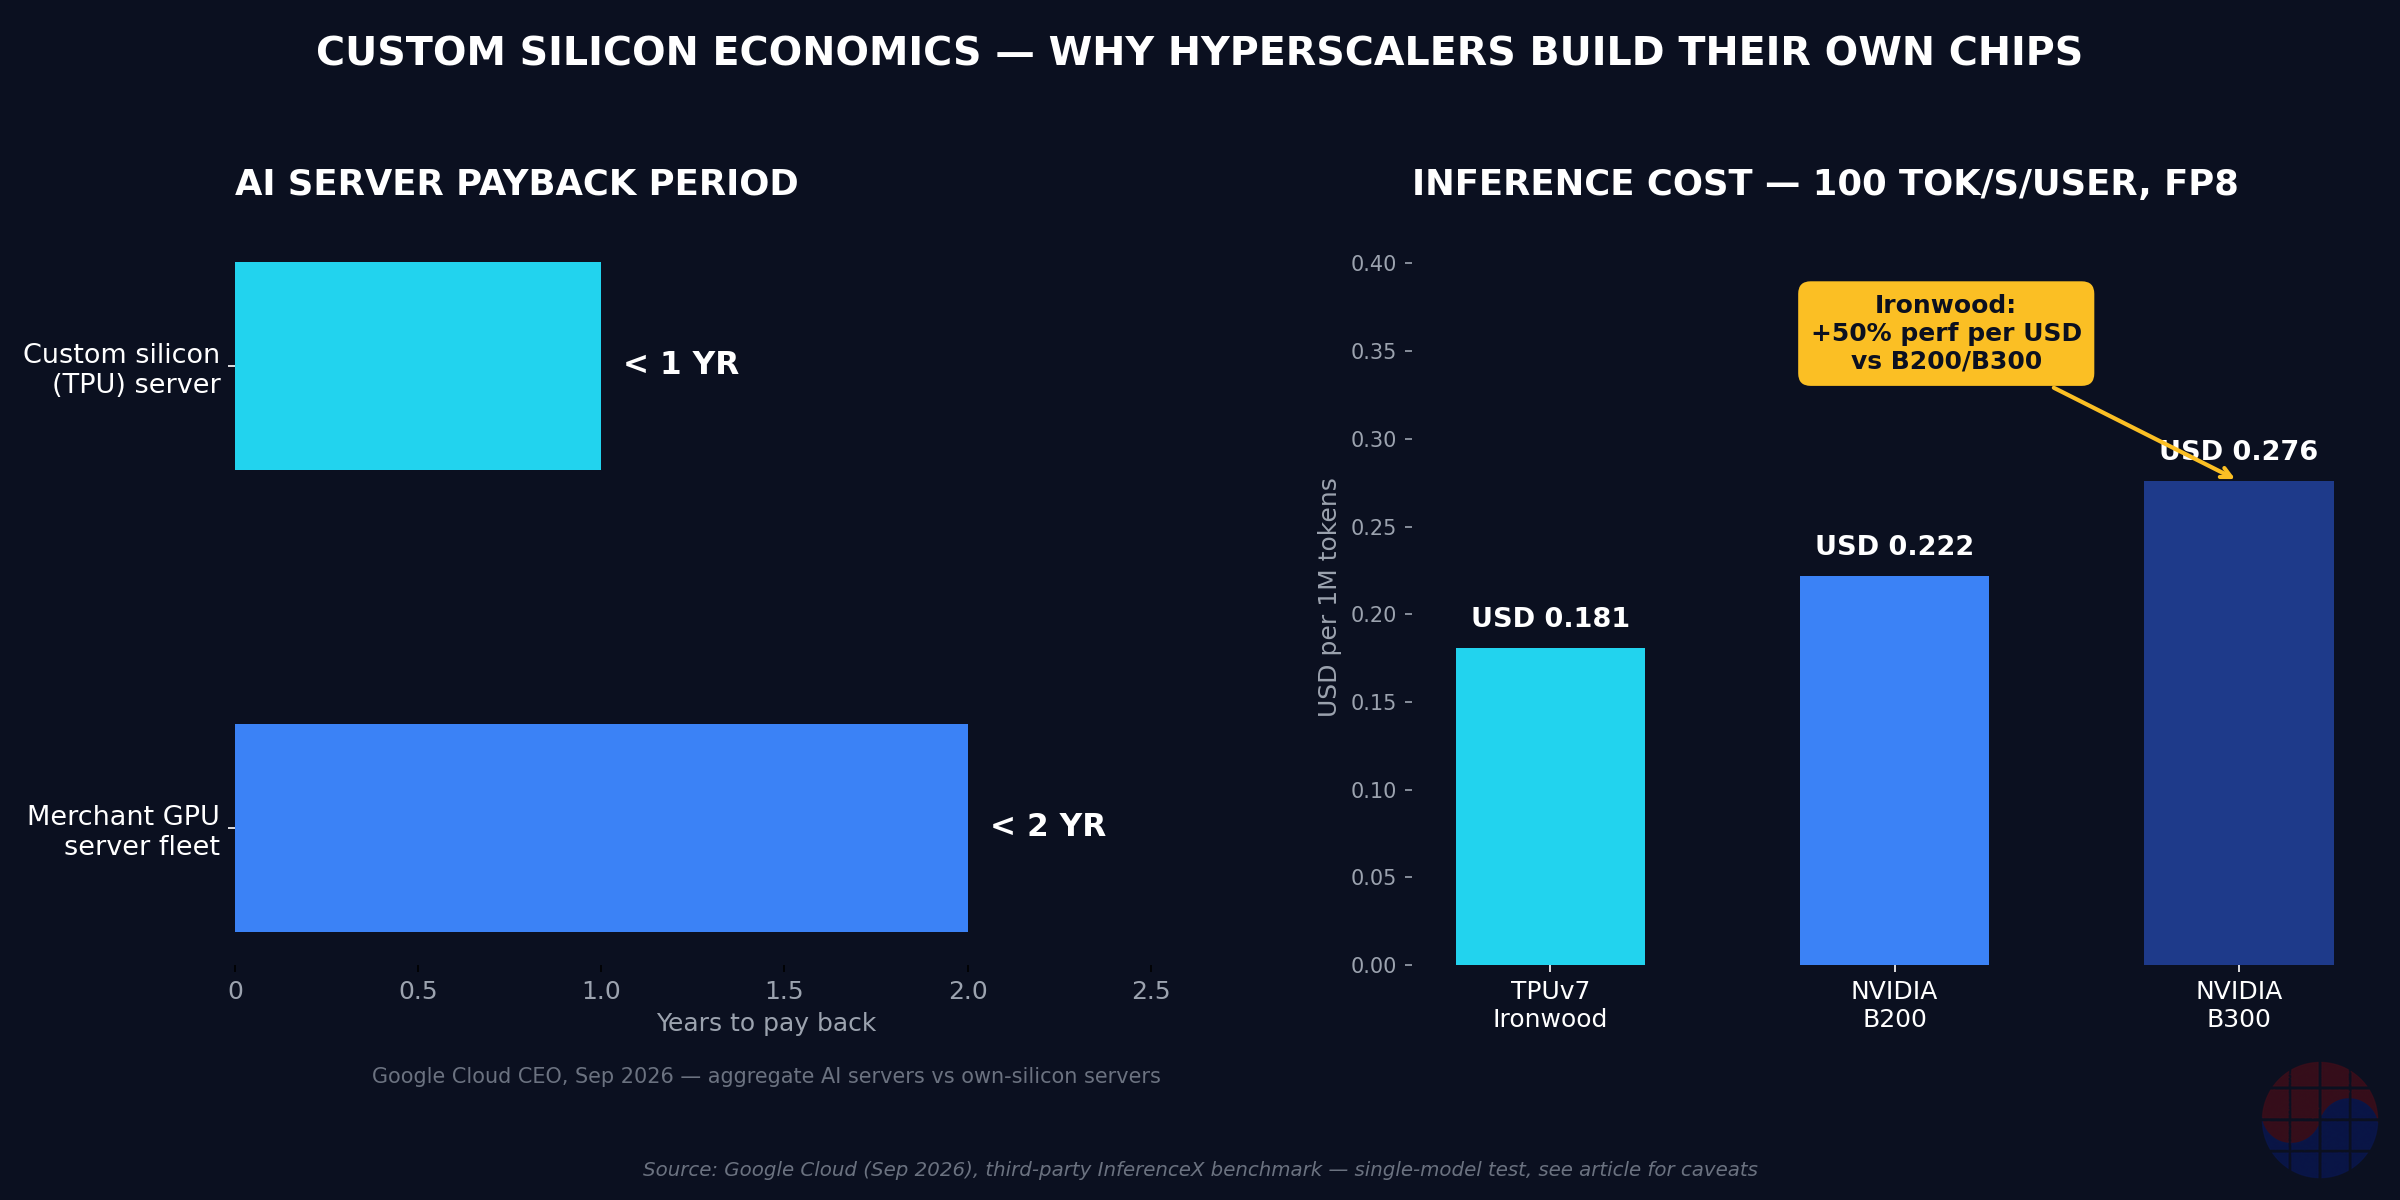
- Google Cloud CEO Thomas Kurian이 2026년 9월 밝힌 수치: AI 서버 투자 회수 기간은 전체 평균 2년 미만, 자체 실리콘(TPU) 적용 서버는 그 절반 수준. 1년짜리 회수 기간은 자체 칩을 '전략적 선택'이 아닌 '재무적 자명함'으로 만든다. (출처)
- 제3자 벤치마크(InferenceX) 기준 TPUv7 Ironwood는 동일 조건 추론에서 B200/B300 대비 토큰당 비용이 낮아 "최대 50% 더 나은 달러당 성능"을 기록했다. 단, 단일 모델(Qwen 3.5 397B, FP8) 테스트 결과다. (출처)
- Anthropic은 2026년 10월 IPO 서류에서 TPU 용량 5년 리스 1,252억 달러를 공개했고, Broadcom은 최대 420억 달러 전환사채 파이낸싱에 합의했다. 칩 판매와 금융이 결합된 새로운 영업 방식이다. (출처)
- MediaTek은 2026년 ASIC 매출 전망을 20억 달러 이상으로 2배 상향했고, Google용 첫 AI ASIC은 2026년 4분기 양산에 들어간다. (출처)
- 결론: hyperscale에서 make-vs-buy 논쟁은 끝났다. 회수 기간이 답을 정한다.
Background: 왜 지금 커스텀 실리콘인가
AI 칩 논쟁의 중심은 오랫동안 '누가 더 빠른가'였다. 그러나 2026년 하반기 들어 질문이 바뀌었다. Alphabet이 2026년 설비투자(CapEx)로 1,950억~2,050억 달러를 예고한 상황에서(출처), 주주들의 질문은 "그 돈이 언제 돌아오느냐"다.
Kurian의 답은 이례적으로 구체적이었다. 2026년 9월 8일 Goldman Sachs Communacopia + Technology Conference에서 그는 AI 서버 전체의 투자 회수 기간이 2년 미만이며, 자체 실리콘은 그 절반 수준이라고 밝혔다. Google Cloud는 9월 11일 공식 recap을 통해 같은 내용을 재확인했다. 추가로 그는 Google Cloud의 학습용 가격 대비 성능이 2.7배, 추론용이 80% 우위라고 주장했고, 자체 가속기 사업 규모가 가장 가까운 하이퍼스케일러 경쟁사의 2배 이상이라고 말했다. (출처)
이 발언의 진짜 무게는 '2년'이라는 숫자 자체가 아니다. 핵심은 회수 기간이 1년대로 떨어지면 자체 칩 개발의 경제학이 근본적으로 뒤집힌다는 점이다. 선단 공정 AI ASIC의 NRE(설계·마스크·검증 비용)는 1억~2억 달러 수준으로 추산된다. 칩 100만 개를 찍으면 칩당 100~200달러에 불과하다. merchant GPU에 붙는 유통 마진(NVIDIA의 매출총이익률은 70%대를 넘나든다)과 비교하면, 물량만 받쳐주면 자체 칩이 무조건 싸다. Kurian의 발언은 "물량이 받쳐준다"는 것을 Google Cloud CEO가 직접 선언한 셈이다.
Business Deep Dive
시장 규모: 2027년 800억 달러 커스텀 AI 칩 시장
증권가 추정치에 따르면 커스텀 AI 칩 시장(TAM)은 2027년 약 700억~800억 달러에 이를 전망이다. MediaTek은 이 시장의 15~20%를 차지하겠다는 목표를 2026년 7월 실적 발표에서 제시했다. (출처)
하이퍼스케일러들의 움직임은 이미 숫자 위에 올라가 있다.
- Google: 2026년 4월 Google Cloud Next에서 8세대 TPU(학습용 8t, 추론용 8i)를 공개했고, 새 Virgo 네트워크 패브릭으로 단일 데이터센터에서 13만 4,000개, 멀티 사이트로 100만 개 이상의 TPU를 하나의 논리 클러스터로 묶는다고 밝혔다. (출처) 한계 변수는 이제 실리콘 공급이 아니라 전력이다 — 수십만 개 규모에서는 conditioned power를 얼마나 먹일 수 있느냐가 성장의 천장이 된다. (출처)
- Anthropic: 2025년 10월 최대 100만 개 Ironwood TPU 도입을 골자로 한 수년 계약을 Google과 체결했고(수백억 달러 규모로 보도), 2026년 10월 1일 IPO 서류에서는 TPU 용량 5년 리스 1,252억 달러를 공개했다. (출처)
- Meta: Broadcom과 공동 설계한 MTIA 프로그램의 'Iris' 칩이 2026년 9월 TSMC 3nm에서 양산에 들어갔다. Meta는 AI 연산 용량을 2026년 7GW에서 2027년 말 14GW로 늘릴 계획이다. (출처)
- OpenAI: 2026년 6월 Broadcom과 함께 첫 커스텀 칩 'Jalapeño'를 공개했고, 10GW 규모의 공동 개발을 진행 중이다. 랙 배치는 2026년 말 시작, 2029년까지 이어진다. (출처)
원가 구조: TCO는 어떻게 갈리는가
Ironwood의 경제학을 뜯어보면 세 개의 레버가 있다.
1. 달러당 추론 성능. InferenceX 벤치마크(Qwen 3.5 397B, FP8, 사용자당 100 tokens/s 조건)에서 Ironwood는 백만 토큰당 0.181달러를 기록했다. B200은 0.222달러, B300은 0.276달러. "최대 50% 더 나은 달러당 성능"이라는 결론이 여기서 나온다. 내부 TCO 기준으로는 GB200 Blackwell 서버 대비 약 44% 낮고, 외부 고객(Anthropic 같은) 기준으로는 NVIDIA 대비 약 30% 저렴하다는 분석도 있다. (출처) 단, 이 수치는 단일 모델·단일 조건 테스트이며 벤더가 직접 수행한 측정이라는 한계가 있다. 반론 측 근거로는 제3자 스타트업 Inferact가 Moonshot AI의 Kimi K3를 vLLM 동일 엔진에서 돌린 결과 — 16개 TPUv7 칩이 709 tokens/s로 16개 GB200(452 tokens/s) 대비 57% 앞섰다. 소프트웨어 스택 최적화(메가커널)까지 포함한 결과지만, 독립 벤치마크라 의미가 있다. (출처)
2. merchant 마진 제거. Google이 자사 칩을 외부에 팔거나 빌려줄 때, 가격에는 NVIDIA가 모든 GPU에 붙이는 merchant 마진 웨지가 없다. 수직 계열화된 하드웨어(칩·인터커넥트·소프트웨어 스택)를 내부 원가에 클라우드 서비스 수수료만 얹어 파는 구조다. 같은 FLOPS라도 청구서 구조가 다르다.
3. 전력·규모의 경제. 데이터센터 TCO에서 전력·냉각이 차지하는 비중은 40%에 육박한다. 칩 자체의 와트당 성능도 중요하지만, 100만 개 규모로 스케일할 때 패브릭 효율(goodput)이 돈을 가른다. Google이 TPU 8t에서 "97% 이상 goodput"을 내세우는 이유다. 한국 독자에게 익숙한 비유로, 이는 메모리 업계가 수율(yield)로 승부를 보는 것과 같은 구조다 — 단위 성능이 아니라 '살아남는 사이클'의 경제학이다.
경쟁 포지셔닝: 네 개의 축
커스텀 실리콘 전쟁의 플레이어는 네 축으로 나뉜다.
| 축 | 대표 플레이어 | 포지션 |
|---|---|---|
| 하이퍼스케일러 자사 칩 | Google TPU, Meta MTIA, Amazon Trainium, Microsoft Maia, OpenAI Jalapeño | 워크로드 특화, merchant 마진 제거 |
| ASIC 설계 파트너 | Broadcom, MediaTek, Marvell, Alchip | 설계·CoWoS·HBM 통합 역량으로 수주 |
| 파운드리 | TSMC (사실상 독점) | 3nm급 선단 캐파의 배분자 |
| 메모리 | SK하이닉스·삼성전자·마이크론 (HBM) | 칩당 HBM 스택 수(192Gb~288GB→Gb 환산 1,536~2,304Gb)가 원가의 큰 축 |
Broadcom의 위치가 특히 흥미롭다. 2026년 4월 Google과 2031년까지의 장기 TPU·네트워킹 공급 계약을 맺었고(출처), 4월 14일에는 Meta MTIA 협력도 확대했다(1GW 이상). OpenAI와는 10GW 공동 개발. 즉 Broadcom은 서로 경쟁하는 세 AI 진영의 칩을 동시에 설계하는 '커스텀 실리콘의 병기창'이 되었다.
MediaTek은 다른 각도에서 치고 들어온다. 스마트폰 칩에서 다져온 CPU·GPU·NPU IP와 저전력 설계 자산을 데이터센터 ASIC에 재활용하는 전략이다. 2026년 2분기에는 ASIC을 포함한 Smart Device Platform 부문이 사상 처음으로 스마트폰 칩을 제치고 최대 매출원이 되었다. 4월과 7월 실적 발표에서 2026년 ASIC 매출 전망을 20억 달러 이상으로 2배 상향했고, Google용 첫 AI 가속기 ASIC은 2026년 4분기 양산에 들어간다. (출처) 다만 시장 일각에서는 샘플 납기·수율 관련 루머도 돌고 있어, 4분기 양산이 실제로 궤도에 오르는지가 관전 포인트다.
전략 옵션: 세 가지 시나리오
- 수직 통합 가속 (base case): TPU externalization이 성공하면 2027년에는 추론 워크로드의 20~30%가 merchant GPU가 아닌 커스텀 실리콘에서 돈다. ASIC 설계 파트너들의 멀티플이 리레이팅된다.
- merchant 반격: NVIDIA는 Rubin 세대에서 TCO 격차를 좁히는 방향으로 가격·번들 전략을 조정할 수 있다. CUDA 생태계의 전환 비용이 여전히 방파제다. Ironwood가 FP8까지만 네이티브 지원하는 점(TPUv8i에서 FP4 추가 예정)은 비교의 유효 범위를 제한한다.
- 금융 리스크 발현 (bear case): Broadcom식 고객 파이낸싱은 2001년 통신장비 버블 당시 Nortel·Lucent의 vendor financing과 구조가 닮았다. 당시에도 장비 업체가 고객의 구매를 떠받치다 고객 신용이 무너지면서 동반 추락했다. Anthropic의 10-Q급 공시(리스 백스톱 최대 290억 달러 노출) 자체가 이 구조의 양면성을 보여준다. (출처)
Chase's Take
여기서 MBA 케이스로 읽어야 할 포인트는 하나다. make-vs-buy의 답은 기술이 아니라 회수 기간이 정한다.
전통적인 제조업 make-vs-buy 분석에서는 고정비(NRE)를 물량으로 나누는 게 전부다. 그런데 AI 칩에서는 분모(물량)가 기하급수적으로 커지는 중이고, 분자(NRE)는 선단 공정으로 갈수록 커지지만 물량 증가 속도를 못 따라간다. 100만 칩 × 칩당 수천 달러 절감 = 수십억 달러. 이 산식이 성립하는 순간, CFO는 엔지니어에게 "왜 안 만드냐"고 묻는다. Kurian의 발언은 바로 그 질문에 대한 CEO급 답변이다.
두 번째 포인트는 Broadcom의 GTM 혁신이다. 칩을 파는 회사가 고객에게 420억 달러를 빌려주는 구조 — 이는 단순한 할인이 아니라 '금융이 곧 영업'인 모델이다. 긍정적으로 보면 진입장벽(고객 락인)의 극대화고, 부정적으로 보면 신용 리스크의 내부화다. 투자자라면 Broadcom의 대차대조표를 칩 회사가 아니라 '준(準) 금융사'의 눈으로 봐야 한다.
세 번째는 한국 관점이다. 이 게임에서 한국의 자리는 두 군데다. 하나는 HBM — 커스텀 칩 한 개당 HBM 스택이 8~12단(칩당 수백 Gb급)으로 붙는 구조에서, ASIC 물량 증가는 곧 HBM 수요 증가다. SK하이닉스·삼성전자에게는 merchant GPU용이든 커스텀 ASIC용이든 HBM이 팔리면 된다. 다른 하나는 팹리스의 교본 — MediaTek이 스마트폰 IP를 데이터센터로 이식한 것처럼, 한국 팹리스도 특정 워크로드(추론·엣지)에 특화된 ASIC으로 파고들 여지가 있다. 다만 MediaTek과 달리 한국 팹리스가 가진 건 IP 포트폴리오가 아니라 설계 인력이라는 점에서, '누구의 물량을 받을 것인가'가 관건이다. 삼성 파운드리의 2nm급 선단 캐파가 이들과 만나는 지점이 다음 2년의 한국 반도체 스토리다.
Implications: 투자·경영 시사점
- 투자: ASIC 설계 파트너(Broadcom·MediaTek·Marvell·Alchip)는 구조적 성장 구간. 다만 멀티플은 이미 상당 부분 반영됐을 수 있어, 4분기 MediaTek 양산 궤도 진입 여부와 Broadcom의 파이낸싱 노출 규모를 분기별로 체크해야 한다. 파운드리는 TSMC의 선단 캐파 배분이 곧 고객 포트폴리오의 질을 결정한다.
- 경영: 클라우드 구매자라면 2027년 추론 워크로드의 TCO를 merchant GPU 단일 기준으로 짜면 안 된다. TPU externalization 견적을 반드시 병행 입찰에 넣을 것. 협상 레버리지 효과만으로도 기존 GPU 단가를 30% 가까이 낮춘 사례(OpenAI)가 있다. (출처)
- 리스크: 고객 파이낸싱 구조가 깨지는 시나리오는 칩 수요 급감이 아니라 '신용 경색'에서 온다. AI 인프라 파이낸싱 규모가 수천억 달러로 커진 지금, 모니터링 지표는 칩 출하량이 아니라 스프레드와 부도 스왑이다.
FAQ
Q1. TPU가 정말 1년 만에 투자금을 회수하나요? Google Cloud CEO가 2026년 9월 컨퍼런스에서 밝힌 공식 수치다. 전체 AI 서버 평균은 2년 미만, 자체 실리콘은 그 절반 수준. 단, 이는 Google의 내부 집계 기준이며, 외부 고객이 같은 조건을 재현할 수 있다는 의미는 아니다. (출처)
Q2. Ironwood의 '달러당 성능 50% 우위'는 공정한 비교인가요? 단일 모델·단일 조건의 벤더 테스트라는 한계가 있다. 다만 독립 스타트업(Inferact)의 제3자 벤치마크에서도 TPUv7이 GB200 대비 우위를 보였고, 내부 TCO 기준 44% 절감 분석도 있어 방향성 자체는 여러 소스가 일치한다. 반론으로는 FP8까지만 네이티브 지원이라는 제약이 있다. (출처)
Q3. Broadcom이 Anthropic에 420억 달러를 빌려주는 게 왜 중요한가요? 칩 판매와 금융이 결합된 새로운 영업 모델이기 때문이다. 고객의 구매력을 직접 떠받쳐 수주를 확보하는 대신, 고객 신용 리스크를 떠안는다. 2001년 통신장비 버블의 vendor financing과 닮은 구조라 양면성을 봐야 한다. (출처)
Q4. 한국 기업에 미치는 영향은? HBM 수요 측면에서는 SK하이닉스·삼성전자에 우호적이다. 커스텀 칩에도 HBM이 대량으로 붙기 때문이다. 설계 측면에서는 MediaTek의 '스마트폰 IP 재활용' 전략이 한국 팹리스의 교본이 될 수 있고, 삼성 파운드리의 선단 캐파 확보가 관건이다.
더 읽을거리
- AI 칩 패권 경쟁의 큰 그림: Chip War — Chris Miller (Amazon)
- NVIDIA의 비즈니스 모델 해부: The Nvidia Way — Tae Kim (Amazon)
이 링크로 구매 시 수수료가 발생할 수 있습니다.
본 글은 공개된 보도자료·실적 발표·언론 보도를 바탕으로 한 분석이며 투자 조언이 아닙니다. 인용된 수치는 각 출처의 발표 시점(2026년 4월~10월) 기준이며, 이후 변경될 수 있습니다.