VLSI Korea
HBM 없이 AI 추론? 인텔 480GB LPDDR5X 베팅과 추론 메모리 TCO 전쟁
인텔이 HBM 없이 480GB LPDDR5X로 AI 추론에 도전한다. FP8 1.3 PFLOPS, 공랭식 350W — 프론티어 학습이 아니라 추론 팜의 TCO 전쟁을 노린 베팅이다. HBM 쇼티지가 아키텍처를 바꾸는 지금, 추론 메모리의 승부처는 대역폭이 아니라 토큰당 비용이다.


30초 요약: 인텔이 OCP 2026에서 AI 추론 전용 GPU D270(Crescent Island)을 공개했다. FP8 1.3 PFLOPS, 메모리 대역폭 1.5 TB/s, 350W 공랭 PCIe 카드. 핵심은 HBM이 아닌 LPDDR5X다 — 인텔 자체 카드는 160GB, ODM 파트너 카드는 최대 480GB까지 장착 가능하다. FP8 기준 3,000억 파라미터 모델을 한 장에 올리고, 8장 시스템으로 1조+ 파라미터에 대응한다. 가격은 미공개, 독립 벤치마크는 없다. 한편 HBM은 2026년 물량이 사실상 완판됐고 2027년 물량의 상당 부분도 이미 잠겼다. 메모리를 구할 수 있는 쪽이 아키텍처를 정하는 시대 — 추론의 승부처는 대역폭이 아니라 토큰당 총소유비용(TCO)이다.
Background
AI 인프라의 무게중심이 학습(training)에서 추론(inference)으로 넘어가고 있다. 학습은 한 번의 거대한 연산 레이스지만, 추론은 매일 수십억 개의 토큰을 토해내는 지속적인 서비스다. 서비스가 지속되면 비용 구조가 전략이 된다.
그런데 2026년 하반기, 추론 인프라를 설계하는 엔지니어와 조달 담당자가 가장 먼저 부딪히는 벽은 GPU의 FLOPS가 아니라 메모리 조달이다. 삼성전자는 2026년 HBM4 물량이 사실상 완판됐다고 밝혔고, SK하이닉스는 2026년 DRAM·NAND 전량이 완판 상태다. 마이크론은 2027년 메모리 공급 물량의 상당 부분을 이미 높은 가격에 잠갔다는 보도가 나온다. (Source: RCR Wireless)
이런 와중에 인텔이 10월 12일 OCP Global Summit에서 내놓은 답이 흥미롭다. HBM 쟁탈전에 뛰어들지 않고, 아예 다른 메모리로 판을 짜겠다는 선언이다.
Business Deep Dive
1. D270 스펙 분해 — 왜 LPDDR5X인가
인텔 GPU D270(코드명 Crescent Island)의 공개 스펙은 다음과 같다. (Source: Intel)
| 항목 | 스펙 |
|---|---|
| 아키텍처 | Xe3P — 32 Xe3P 코어, 256 XMX 행렬 엔진, 32MB 통합 L2 |
| 연산 성능 | FP8 1.3 PFLOPS |
| 메모리 | LPDDR5X, 인텔 자체 카드 160GB / ODM 파트너 카드 최대 480GB |
| 메모리 대역폭 | 1.5 TB/s |
| 전력·쿨링 | 350W, 공랭식 PCIe 5.0 x16 |
| 모델 대응 | 단일 카드 3,000억 파라미터, 8-GPU 시스템 1조+ 파라미터 |
가장 눈에 띄는 설계 결정은 3D 그래픽과 레이 트레이싱 하드웨어를 통째로 들어냈다는 점이다. GPU 다이에서 그래픽 고정기능 유닛이 차지하던 면적을 AI 연산에 재배치한 것이다. 추론 전용이라는 선언을 실리콘에 새긴 셈이다.
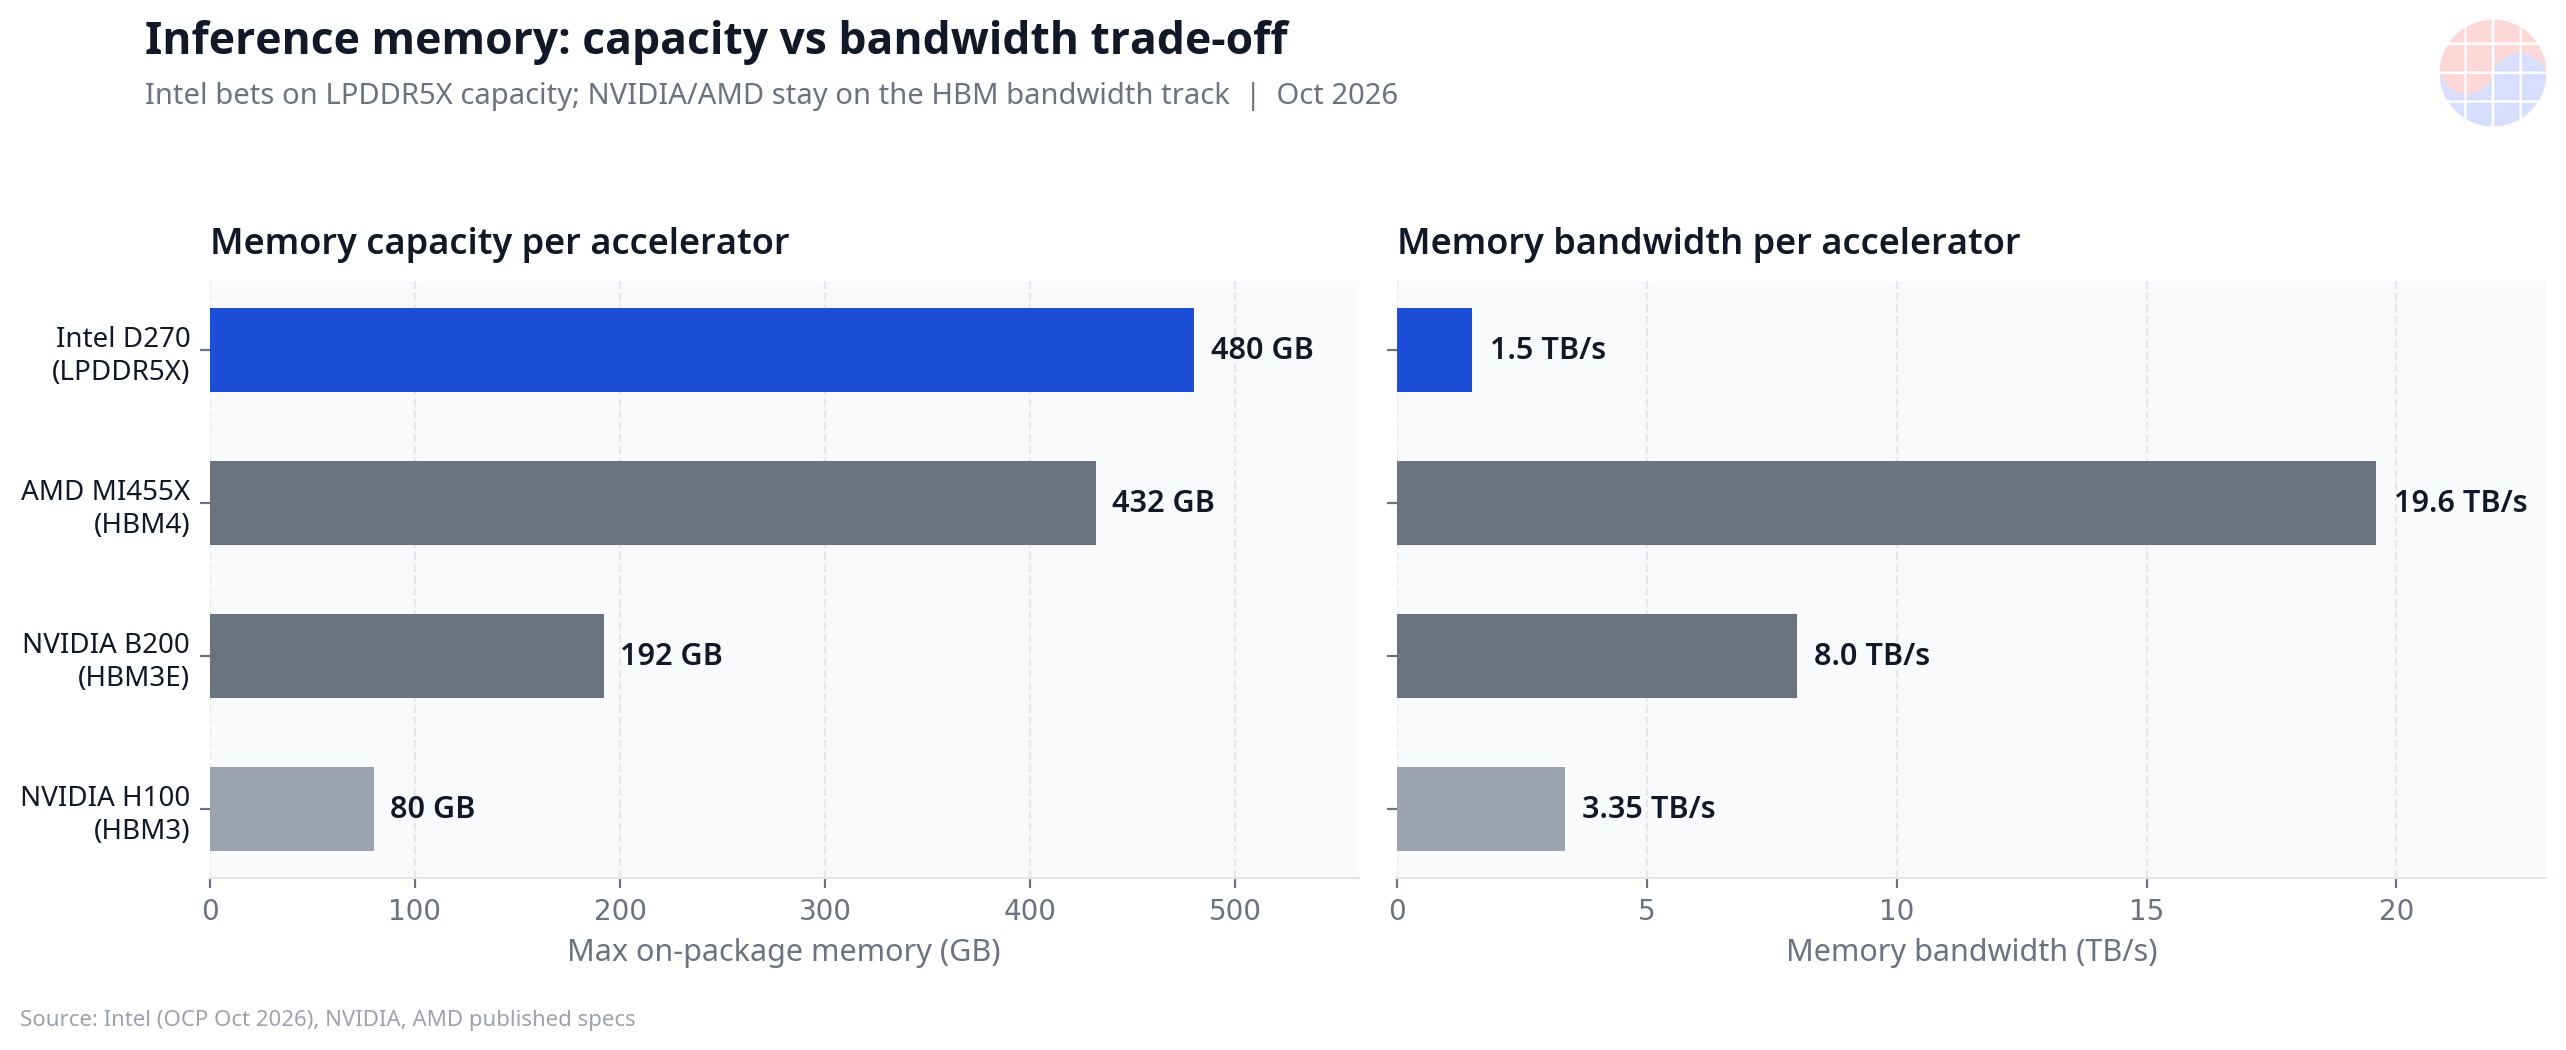
두 번째 결정이 메모리다. HBM 대신 LPDDR5X를 택했다. 대역폭 1.5 TB/s는 HBM3E급 카드(8 TB/s)의 5분의 1 수준이다. 대신 용량은 압도적이다. ODM 파트너 카드 기준 480GB는 같은 세대 HBM 플래그십의 2.5배에 달한다.
수학은 단순하다. FP8 정밀도에서 파라미터 1개는 약 1바이트다. 3,000억 파라미터 모델의 가중치는 약 300GB — 480GB 카드 한 장에 여유롭게 들어간다. 남는 180GB는 추론의 숨은 메모리 먹는 하마인 KV cache와 배치 처리에 쓸 수 있다. 1조 파라미터 모델은 8장으로 나누면 카드당 125GB — 역시 충분하다. 대역폭이 낮다는 약점은, 한 번 로드한 가중치를 수천·수만 토큰 생성에 재사용하는 추론 워크로드의 특성상 학습 때만큼 치명적이지 않다.
세 번째 결정은 전력과 폼팩터다. 350W 공랭 PCIe 카드는 기존 데이터센터 인프라에 그대로 꽂힌다. 1,000W급 액냉 랙을 요구하는 플래그십 가속기와 달리, 특수한 전력·쿨링 인프라 없이 추론 팜을 깔 수 있다. TCO 계산에서 이 차이는 생각보다 크다.
단, 짚어야 할 한계도 명확하다. 가격은 미공개고, 출시 시점도 "2027년 중"이라는 보도 수준이며, 독립 벤치마크가 전혀 없다. 1.3 PFLOPS는 이론적 피크치다. (Source: VideoCardz)
2. 메모리 쇼티지가 아키텍처를 바꾼다
D270의 베팅을 이해하려면 메모리 시장의 현재 위치를 봐야 한다. 2026년 10월 기준 팩트는 이렇다.
- HBM4(현행 세대): 삼성 2026년 물량 사실상 완판, SK하이닉스 2026년 DRAM·NAND 전량 완판. 사고 싶어도 살 수 없는 상태.
- HBM4E(차세대): 2,048-bit 인터페이스, 핀당 14~16 Gbps, 스택당 최대 3.6 TB/s. 12-high 기준 384Gb(48GB) 샘플이 삼성(5월)과 SK하이닉스(6월)에서 이미 고객사로 나갔다. 양산 목표는 2027년. 아직 JEDEC 표준이 제정되지 않은 vendor-defined 세대다. (Source: RCR Wireless)
- 삼성 12-high HBM4E는 NVIDIA 인증 테스트를 통과했다는 보도가 나왔다. 다만 삼성과 NVIDIA 모두 공식 확인은 하지 않았다 — 보도 단계의 정보다. (Source: HardwareBrief)
- 마이크론은 2027년 메모리 공급 물량의 75%가 이미 판매 완료됐다는 보도가 있다. (Source: Tech Insider)
즉, HBM 로드맵에 올라타려면 2027년 물량부터 줄을 서야 하는 시장이다. 이런 시장에서 "HBM 없이 추론 팜을 짓는다"는 선택지는 단순한 원가 절감이 아니라 조달 리스크 회피 그 자체다. LPDDR5X는 스마트폰·PC용으로 대량 양산되는 commodity DRAM이다. HBM처럼 TSV·인터포저 패키징 병목을 타지 않고, 공급 풀이 넓고, GB당 조달 단가가 낮다. 테슬라도 같은 결론에 도달했다.
3. 테슬라도 같은 방향 — AI5/AI6 메모리 스펙 하향
일론 머스크는 10월 1일, 테슬라 AI5의 메모리를 당초 계획 144GB LPDDR5에서 72GB로 절반으로 줄이고, AI6는 144GB LPDDR6로 3분의 1 줄인다고 밝혔다. 이유는 명확했다. Optimus 양산에 필요한 물량을 확보하기 위해서. 이후 AI5는 96GB로 재조정됐다. "메모리 대역폭이 용량보다 더 큰 제약"이라 성능 영향은 무시할 수준이라는 설명도 덧붙였다. (Source: Wccftech)
여기서 드러나는 패턴은 분명하다. 메모리 크런치가 설계 스펙 자체를 바꾸고 있다. 확보 가능한 메모리로 제품을 재정의하는 것 — 이것이 2026년 하반기 AI 하드웨어의 표준 동작이 되고 있다. 참고로 AI5는 삼성 파운드리 Taylor 팹(텍사스)에서 이미 시험 생산 중이다.
4. 분기하는 메모리 전략 — NVIDIA vs Intel
반면 메모리 확보에 자신이 있는 쪽은 정반대 방향으로 간다. NVIDIA의 로드맵이다.
- Rubin(2026): HBM4 탑재
- Rubin Ultra(2027): HBM4E 탑재
- Feynman(2028): custom HBM 채택 보도 — 표준 HBM이 아닌 맞춤형 설계 (Source: Wccftech)
- NVHBM(2026년 8월 공개): NVIDIA의 custom HBM 베이스 다이 기술. 메모리 제조사와 공동 설계·검증하며, 표준 HBM4E 대비 스택당 대역폭 +30%, HBM 전력 -15%, PHY 면적 -67%를 내세운다. (Source: WeDoAny)
AMD도 HBM 트랙을 유지한다. MI455X는 432GB(3,456Gb) HBM4에 대역폭 19.6 TB/s다. (Source: TweakTown)
정리하면 메모리 전략이 두 갈래로 분기하고 있다.
| 전략 | 대표 주자 | 방향 |
|---|---|---|
| 대역폭·전력 최적화 | NVIDIA (NVHBM custom HBM), AMD (HBM4/HBM4E) | 비싼 메모리를 더 효율적으로 — 플래그십 학습·추론 |
| 용량·비용 최적화 | Intel (LPDDR5X 480GB), Tesla (LPDDR5/6) | 싼 메모리를 더 많이 — 추론 팜 TCO 경쟁 |
어느 쪽이 "옳다"가 아니다. 워크로드가 갈리는 것이다. 프론티어 모델 학습과 고부가 추론은 대역폭 집약적이고, 대량 토큰 서비스·온디바이스·로보틱스 추론은 용량과 비용이 관건이다.
5. TCO 분해 — 토큰당 비용을 정하는 4개의 레버
추론 인프라의 TCO는 다음 네 레버로 분해된다.
① 메모리 조달. HBM은 완판 상태라 웃돈을 얹고도 할당량을 다퉈야 한다. LPDDR5X는 commodity 시장이라 가격 협상력과 공급 안정성이 다르다. 조달 가능성이 TCO의 첫 단추인 시대다.
② 전력·쿨링. 350W 공랭 카드와 1,000W급 액냉 가속기의 차이는 칩 전력만이 아니다. 랙당 전력 밀도, 액냉 인프라 투자, 전기료가 전부 따라온다. 인텔이 "특수한 랙·쿨링 인프라 없이 확장"을 내세우는 이유다.
③ 서버당 용량. D270 8장 시스템은 메모리 총 3.84TB로 1조+ 파라미터 모델을 커버한다. 노드 수를 줄이면 네트워킹·전력·운영 복잡도가 함께 내려간다. 용량이 곧 노드 집적도다.
④ 활용률. 추론 서버의 적은 유휴(idle)가 아니라 메모리 바운드 상태에서 돈다. 대역폭이 낮아도 KV cache와 배치를 크게 가져가면 토큰 처리량을 뽑을 수 있다. 테슬라가 "대역폭이 용량보다 큰 제약"이라고 한 것과 같은 맥락이다.
Chase's Take
학습 시대의 지표가 FLOPS였다면, 추론 시대의 지표는 토큰당 달러다. 인텔의 베팅은 이 명제를 실리콘으로 번역한 것이다. 1.3 PFLOPS라는 숫자는 플래그십 대비 초라해 보이지만, 질문을 "누가 더 빠른가"에서 "누가 토큰을 더 싸게 찍어내는가"로 바꾸면 게임이 달라진다.
두 가지 구조적 포인트를 짚고 싶다.
첫째, HBM 쇼티지는 일시적 수급 문제가 아니라 아키텍처 선택을 강제하는 구조 변수가 됐다. 테슬라가 스펙을 깎고, 인텔이 LPDDR로 돌아선 것은 같은 압력에 대한 다른 응답이다. 메모리를 쥔 쪽(SK하이닉스 HBM 매출 비중 57% 등)이 밸류체인에서 가격 결정력을 갖는 동안, 메모리를 쓰는 쪽은 "구할 수 있는 메모리"에 맞춰 설계를 바꾼다. 앞으로 2~3년의 AI 하드웨어 뉴스는 이 긴장 위에서 읽어야 한다.
둘째, 한국의 이해관계는 양쪽에 걸려 있다. HBM 프리미엄의 직접 수혜자는 삼성전자·SK하이닉스다. 동시에 삼성 파운드리는 테슬라 AI5를 Taylor에서 찍고 있고, LPDDR 공급망에서는 중국 CXMT의 추격이 거세다. 메모리 믹스가 HBM 일변도에서 LPDDR 병행으로 바뀌면, 한국 메모리 2강의 제품 포트폴리오와 파운드리 고객 구성에도 파장이 온다. 어느 한쪽에 베팅하는 분석은 반쪽짜리다.
반론도 공정하게 달아둔다. D270의 대역폭 1.5 TB/s는 낮다. 지연 민감한 실시간 추론(TTFT)에서는 불리할 수 있다. 무엇보다 가격이 공개되지 않았다. TCO 우위는 가격표가 나와야 검증된다. 독립 벤치마크 없이 이론치만으로 "추론 가성비"를 단정하는 것은 금물이다.
Implications
투자 시사점: - 추론 워크로드 비중이 커질수록 메모리 믹스는 HBM 일변도에서 벗어난다. LPDDR5X·서버 DRAM 수요의 구조적 수혜를 점검할 시점이다. - HBM 프리미엄은 2027년까지 지속될 가능성이 높다 — 2026년 완판 + 2027년 물량 선점 + HBM4E vendor-defined 과도기. 메모리 3사의 가격 결정력은 당분간 유지된다. - 전력·쿨링 인프라(공랭 유지 vs 액냉 전환)는 데이터센터 CAPEX의 새로운 변수다. 350W급 추론 카드의 확산은 액냉 전환 속도를 늦출 수 있다.
경영 시사점: - AI 인프라 조달의 기준이 "가장 빠른 칩"에서 "확보 가능한 메모리"로 바뀌고 있다. 2027년 캐파 계획은 메모리 할당량부터 거꾸로 짜야 한다. - 벤더 락인 회피 차원에서 LPDDR 기반 추론 옵션의 성숙도를 트래킹할 필요가 있다. NVIDIA 대안의 첫 번째 실전 테스트 케이스가 될 수 있다.
FAQ
Q1. LPDDR5X는 HBM보다 대역폭이 훨씬 낮은데 추론에 정말 괜찮은가? A. 워크로드에 따라 다르다. 학습처럼 가중치를 계속 갈아엎는 작업이 아니라, 추론은 가중치를 한 번 로드해두고 수천~수만 토큰을 생성한다. 이때 병목은 대역폭보다 KV cache를 담을 용량과 배치 크기인 경우가 많다. 다만 초응답 지연(TTFT)이 중요한 실시간 서비스에서는 대역폭 열위가 드러날 수 있다.
Q2. 480GB면 정말 3,000억 파라미터 모델이 한 장에 돌아가나? A. FP8 기준 파라미터 1개 ≈ 1바이트이므로 3,000억 파라미터 ≈ 300GB다. 480GB 카드에 가중치를 올리고도 180GB가 남아 KV cache와 배치 처리에 쓸 수 있다. 인텔의 주장과 수학적으로 정합적이다. 단, 실제 구동 여부는 독립 벤치마크로 검증되지 않았다.
Q3. 가격은 얼마인가? A. 미공개다. 인텔은 고객 샘플링이 진행 중이라고만 밝혔다. 가격이 나와야 HBM 카드 대비 진짜 TCO 우위를 계산할 수 있다. 가격 없는 가성비 논쟁은 반쪽짜리다.
Q4. HBM 쇼티지는 언제 풀리나? A. 2026년 물량은 사실상 완판, 2027년 물량도 상당 부분 선점된 상태다. HBM4E 양산이 2027년으로 예정돼 있지만 vendor-defined 세대라 램프업 속도가 변수다. 2027년 내내 타이트할 가능성을 열어둬야 한다.
더 읽을거리
- Chris Miller, Chip War — 반도체 패권 전쟁의 지정학과 공급망을 다룬 필독서. Amazon에서 보기
- Clayton Christensen, The Innovator's Dilemma — 저가·저성능 진입자가 시장을 뒤집는 구조를 설명하는 MBA 고전. 인텔의 LPDDR 베팅을 읽는 렌즈. Amazon에서 보기
이 링크로 구매 시 수수료가 발생할 수 있습니다.
면책: 본 글의 수치와 일정은 2026년 10월 13일 기준 공개 자료에 근거하며, 인텔 D270의 성능 수치는 제조사 발표 이론치로 독립 벤치마크 검증이 없습니다. 투자 판단의 근거로 사용하지 마십시오.