VLSI Korea
베라 루빈 양산의 수학: 랙 1대 = HBM4 576개, GPU 100만 개 = 웨이퍼 30만 장 (TSMC·SK하이닉스·삼성전자·마이크론)
젠슨 황이 선언한 베라 루빈 본격 양산을 숫자로 해부한다. 랙 1대 = GPU 72개·HBM4 576스택·웨이퍼 약 21.5장, 2027년 11,000~21,000대 시나리오와 TSMC·SK하이닉스·삼성전자·마이크론 공급 지도, 병목 판정까지.


한 줄 결론 — 베라 루빈의 생산 속도를 결정하는 것은 GPU가 아니라 HBM4 비트 수다. 랙 1대가 HBM4 스택 576개와 웨이퍼 21장 이상을 먹어치우는 구조에서, 2027년 램프의 상한은 메모리 3사의 웨이퍼가 정한다.
30초 요약
- 젠슨 황 CEO는 2026년 10월 21일 GTC 베를린 키노트에서 베라 루빈이 "현재 본격 생산 중"이라고 선언했다. 노드 조립 시간은 그레이스 블랙웰의 2시간에서 5분 미만으로 줄었고, 냉각은 100% 액체냉각이다.
- 랙 1대(NVL72)에는 Rubin GPU 72개, Vera CPU 36개, HBM4 스택 576개(20.7TB = 165,888Gb)가 들어간다. GPU 1개당 HBM4는 12단 36GB 스택 8개, 288GB(2,304Gb)다.
- 물량은 추정으로만 존재한다. 2026년 하반기 5,000~7,000대(공급망 추산), 2027년 11,000~21,000대(80만~150만 GPU) 범위가 현재 시장의 베이스 시나리오다.
- 웨이퍼로 환산하면 GPU 1개가 로직 웨이퍼 0.037장 + CoWoS 웨이퍼 0.143장 + HBM DRAM 웨이퍼 0.118장, 합계 약 0.30장을 소비한다. GPU 100만 개 = 웨이퍼 약 30만 장이다.
- 병목 판정: 1순위는 HBM4(2026년 물량 소진, 할당 축소 보도, 2027년 계약가 급등 전망), 2순위는 CoWoS, 로직 웨이퍼와 랙 조립은 제약이 아니다.
1. 베를린 선언 — 확정된 사실부터
2026년 10월 21일, 젠슨 황 CEO는 독일 베를린 GTC 키노트에서 베라 루빈 노드를 직접 들어 보이며 세 가지를 확정했다. 첫째, 베라 루빈은 현재 본격 생산 중이다. 둘째, 노드 조립 시간은 그레이스 블랙웰 세대의 2시간에서 5분 미만으로 단축됐다 — 케이블과 전선을 없앤 설계 덕분이다. 셋째, 냉각은 80% 액체냉각이던 전 세대와 달리 100% 액체냉각이며, 냉각수 입구 온도는 45°C다.
양산 자체는 이번이 첫 선언이 아니다. 엔비디아는 2026년 1월 CES에서 양산 진입을 밝혔고, 5월 31일 GTC 타이베이 발표에서 가을부터 양산 출하가 시작된다고 했다. 6월 1일에는 클라우드 사업자 코어위브가 첫 NVL72 랙의 브링업을 완료해 실전 가동을 확인했다. 베를린 선언의 의미는 "생산 중"이라는 문구가 샘플과 초기 물량을 넘어 본격 램프 단계에 들어섰다는 확인이다. 황 CEO는 베라 루빈 뒤에 대만 공급망 파트너 150곳이 있다고도 언급했다.
이 글은 그 선언을 숫자로 해부한다. 얼마나 만드는지, 랙 1대에 무엇이 얼마나 들어가는지, 그 물량이 웨이퍼 몇 장으로 환산되는지, 그리고 어느 회사가 무엇을 얼마나 공급하는지 — 전부 표로 정리한다. 공식 발표와 보도 기반 수치는 출처를 밝혔고, 계산으로 도출한 수치는 가정과 함께 "추정"으로 표시했다.
2. 랙 1대 해부 — NVL72의 구성
베라 루빈의 기본 판매 단위는 GPU 칩이 아니라 랙이다. NVL72 1대는 컴퓨트 트레이 18개와 NVLink 스위치 트레이 9개로 구성되며, 72개의 GPU가 NVLink 6 패브릭으로 하나의 거대한 가속기처럼 묶인다.
| 구성 요소 | 수량/사양 | 비고 |
|---|---|---|
| Rubin GPU | 72개 | GPU당 트랜지스터 3,360억 개(다이 2개), TSMC 3nm |
| Vera CPU | 36개 | 88코어 Arm, GPU와 NVLink-C2C 연결 |
| HBM4 | 576스택, 20.7TB | GPU당 8스택 × 36GB |
| LPDDR5X (CPU용) | 최대 54TB | CPU당 최대 1.5TB, SOCAMM2 모듈 (증권사 분석 기준) |
| NVLink 6 패브릭 | 랙당 260 TB/s | GPU당 3.6 TB/s |
| 네트워킹 | ConnectX-9 NIC, BlueField-4 DPU | 스케일아웃은 Spectrum-X 이더넷 |
| 냉각 | 100% 액체냉각 | 냉각수 입구 45°C |
| 소비전력 | 약 190~230 kW | 공급망 추산 |
| 랙 가격 | 500만~780만 달러 | 2026년 3월 보도·증권사 부품가 분석 |
Source: 엔비디아 NVL72 사양 공개 자료, GTC 베를린 2026 키노트 보도(2026-10-21), 증권사 부품가 분석.
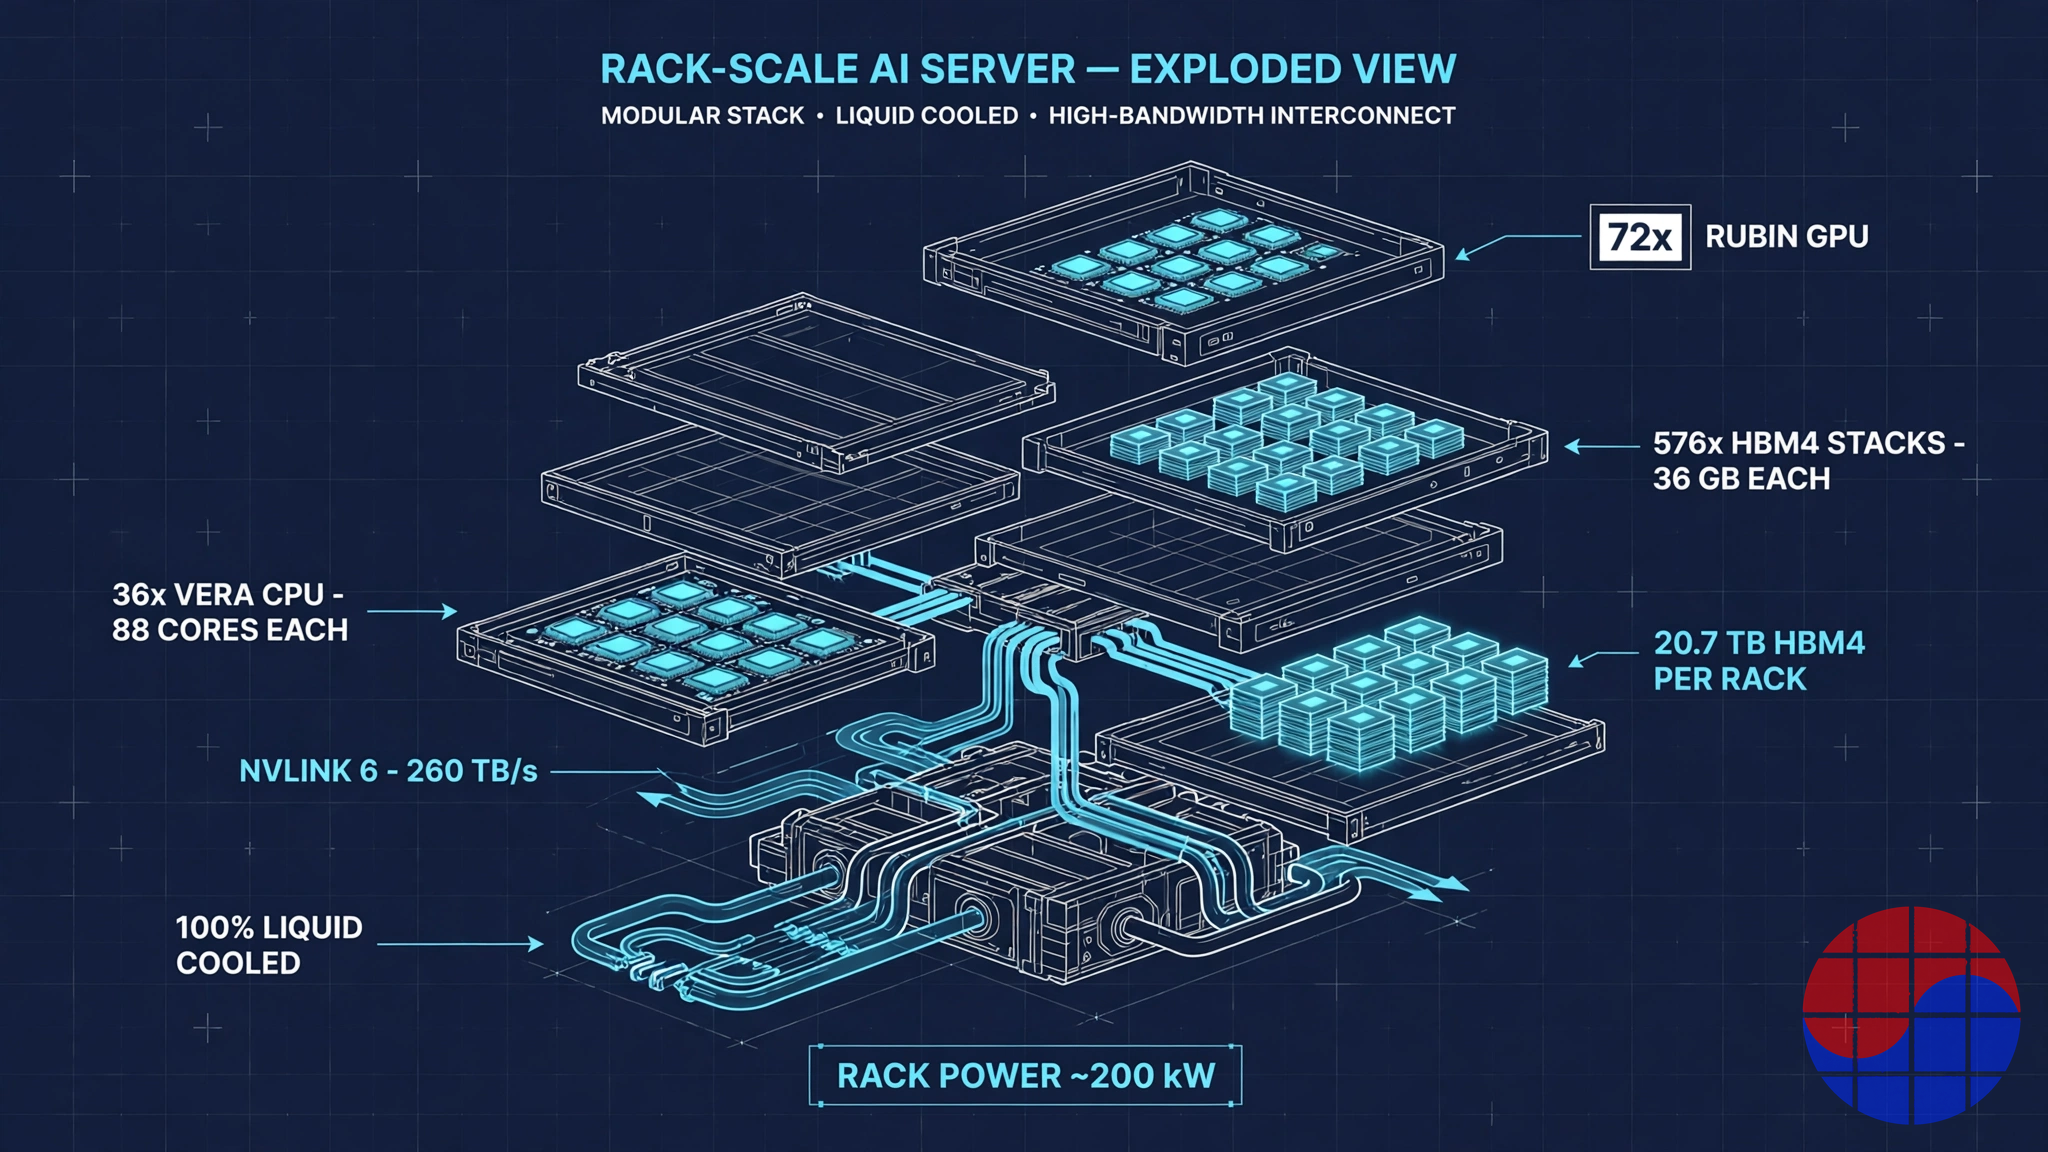
Vera Rubin NVL72 랙 구조도 — 72개의 GPU와 576개의 HBM4 스택이 하나의 랙에 들어간다. Source: VLSI Korea
HBM4의 산수
이 플랫폼의 본질은 메모리다. GPU 1개의 HBM4 구성을 비트 단위로 풀면 다음과 같다.
| 항목 | 값 | 계산 |
|---|---|---|
| HBM4 스택 1개 용량 | 36GB (288Gb) | 24Gb 다이 12단 적층 |
| GPU당 스택 수 | 8개 | 엔비디아 사양 |
| GPU당 HBM4 | 288GB (2,304Gb) | 8 × 36GB |
| GPU당 대역폭 | 22 TB/s | 엔비디아 사양 |
| 랙당 스택 수 | 576개 | 72 × 8 |
| 랙당 HBM4 | 20.7TB (165,888Gb) | 72 × 288GB |
| 랙당 HBM DRAM 다이 수 | 6,912개 | 576스택 × 12단 |
블랙웰 세대와 비교하면 GPU당 HBM 용량은 192GB에서 288GB로 1.5배, 대역폭은 8 TB/s에서 22 TB/s로 2.75배가 됐다. 스택 수는 8개로 같지만 스택당 용량이 24GB에서 36GB로 늘고 핀 속도가 뛰었다. 생산 관점에서 중요한 것은 용량 증가가 전부 "더 많은 DRAM 웨이퍼"로 청구된다는 점이다. 스택 1개를 만들려면 24Gb 다이 12개가 필요하고, 다이 수율을 감안하면 실제 웨이퍼 소모는 그 이상이다.
3. 얼마나 만드는가 — 물량 시나리오
엔비디아는 루빈의 출하 대수를 공개하지 않는다. 시장에 존재하는 숫자는 전부 추정이며, 이 글에서는 추정 방식을 투명하게 공개한 것만 쓴다.
역산 1: 매출에서 거꾸로 세기
엔비디아의 실적 가이던스와 경영진 발언을 근거로, 시장에서는 베라 루빈이 분기 매출 약 200억 달러를 기여하는 구간이 거론된다. 랙 단가 보도 범위(500만~780만 달러)로 나누면 분기 2,550~3,975대, 연율로 약 1만~1.6만 대가 된다. 단, 이 역산은 루빈 매출 전액이 NVL72 랙에서 나온다고 가정하므로 상한에 가까운 참고치다 — 실제로는 보드·모듈 단위 판매와 블랙웰 병행 매출이 섞인다.
역산 2: 공급망 추산
대만 공급망을 추적하는 애널리스트들은 2026년 하반기 VR200 랙 출하를 5,000~7,000대로 본다(궈밍치 추산으로 보도). GPU로 환산하면 36만~50만 개다. 다만 HBM4 할당 축소 보도가 겹치면서 2026년 루빈 GPU 총량은 25만~35만 개 수준의 컨센서스도 병존한다. 2027년은 본격 스케일링의 해로, 베이스 시나리오는 GPU 80만~150만 개(랙 11,000~21,000대)다. NVL72급 랙 전체(GB300+VR200+VR300) 출하는 2027년 전년 대비 50% 이상 증가하고, VR200이 최대 비중을 차지한다는 업계 추산도 나와 있다.
| 기간 | 랙 (추정) | GPU (추정) | HBM4 스택 (추정) | 근거 |
|---|---|---|---|---|
| 2026년 하반기 | 3,500~7,000대 | 25만~50만 개 | 200만~400만 개 | 공급망 추산, 가을 출하 개시 |
| 분기 (램프 정점) | 2,550~3,975대 | 18만~29만 개 | 147만~229만 개 | 분기 매출 약 200억 달러 역산 |
| 2027년 | 11,000~21,000대 | 80만~150만 개 | 640만~1,200만 개 | 베이스 시나리오 범위 |
위 표의 모든 수치는 추정치이며 확정치가 아니다. 확정된 것은 "양산 중"이라는 사실과 가을 출하 개시뿐이다.
물량을 HBM4 비트로 환산하면 그림이 달라진다. 2027년 베이스 시나리오의 하단(80만 GPU)만으로도 HBM4 230PB(230,400TB)가 필요하고, 상단(150만 GPU)에서는 432PB에 달한다. 2026년 전 세계 HBM 출하량의 상당 부분을 루빈 한 플랫폼이 가져가는 구조다.
4. 웨이퍼 환산 — GPU 1개 = 웨이퍼 0.30장
물량을 웨이퍼로 바꾸면 병목의 위치가 보인다. 아래 계산은 가정을 전부 공개한 자체 모델이며, 수치는 범위로 읽어야 한다.
계산 가정
| 웨이퍼 종류 | 가정 | 결과 |
|---|---|---|
| 로직 (TSMC 3nm) | 다이 면적 약 800mm² × 2개 (레티클 한계 858mm² 근접), 300mm 웨이퍼당 그로스 약 65개, 다이 수율 85% | 웨이퍼당 양품 다이 약 55개 = GPU 약 27개 |
| CoWoS 패키징 | 패키지 풋프린트 약 4,700mm² (2026년 5.5 레티클급), 웨이퍼당 패키지 6~8개 | 웨이퍼당 GPU 약 7개 |
| HBM4 DRAM | 24Gb 다이 약 60mm², 웨이퍼당 그로스 약 1,090개, KGD·적층 유효 수율 75% | 웨이퍼당 다이 약 820개 = GPU 약 8.5개 |
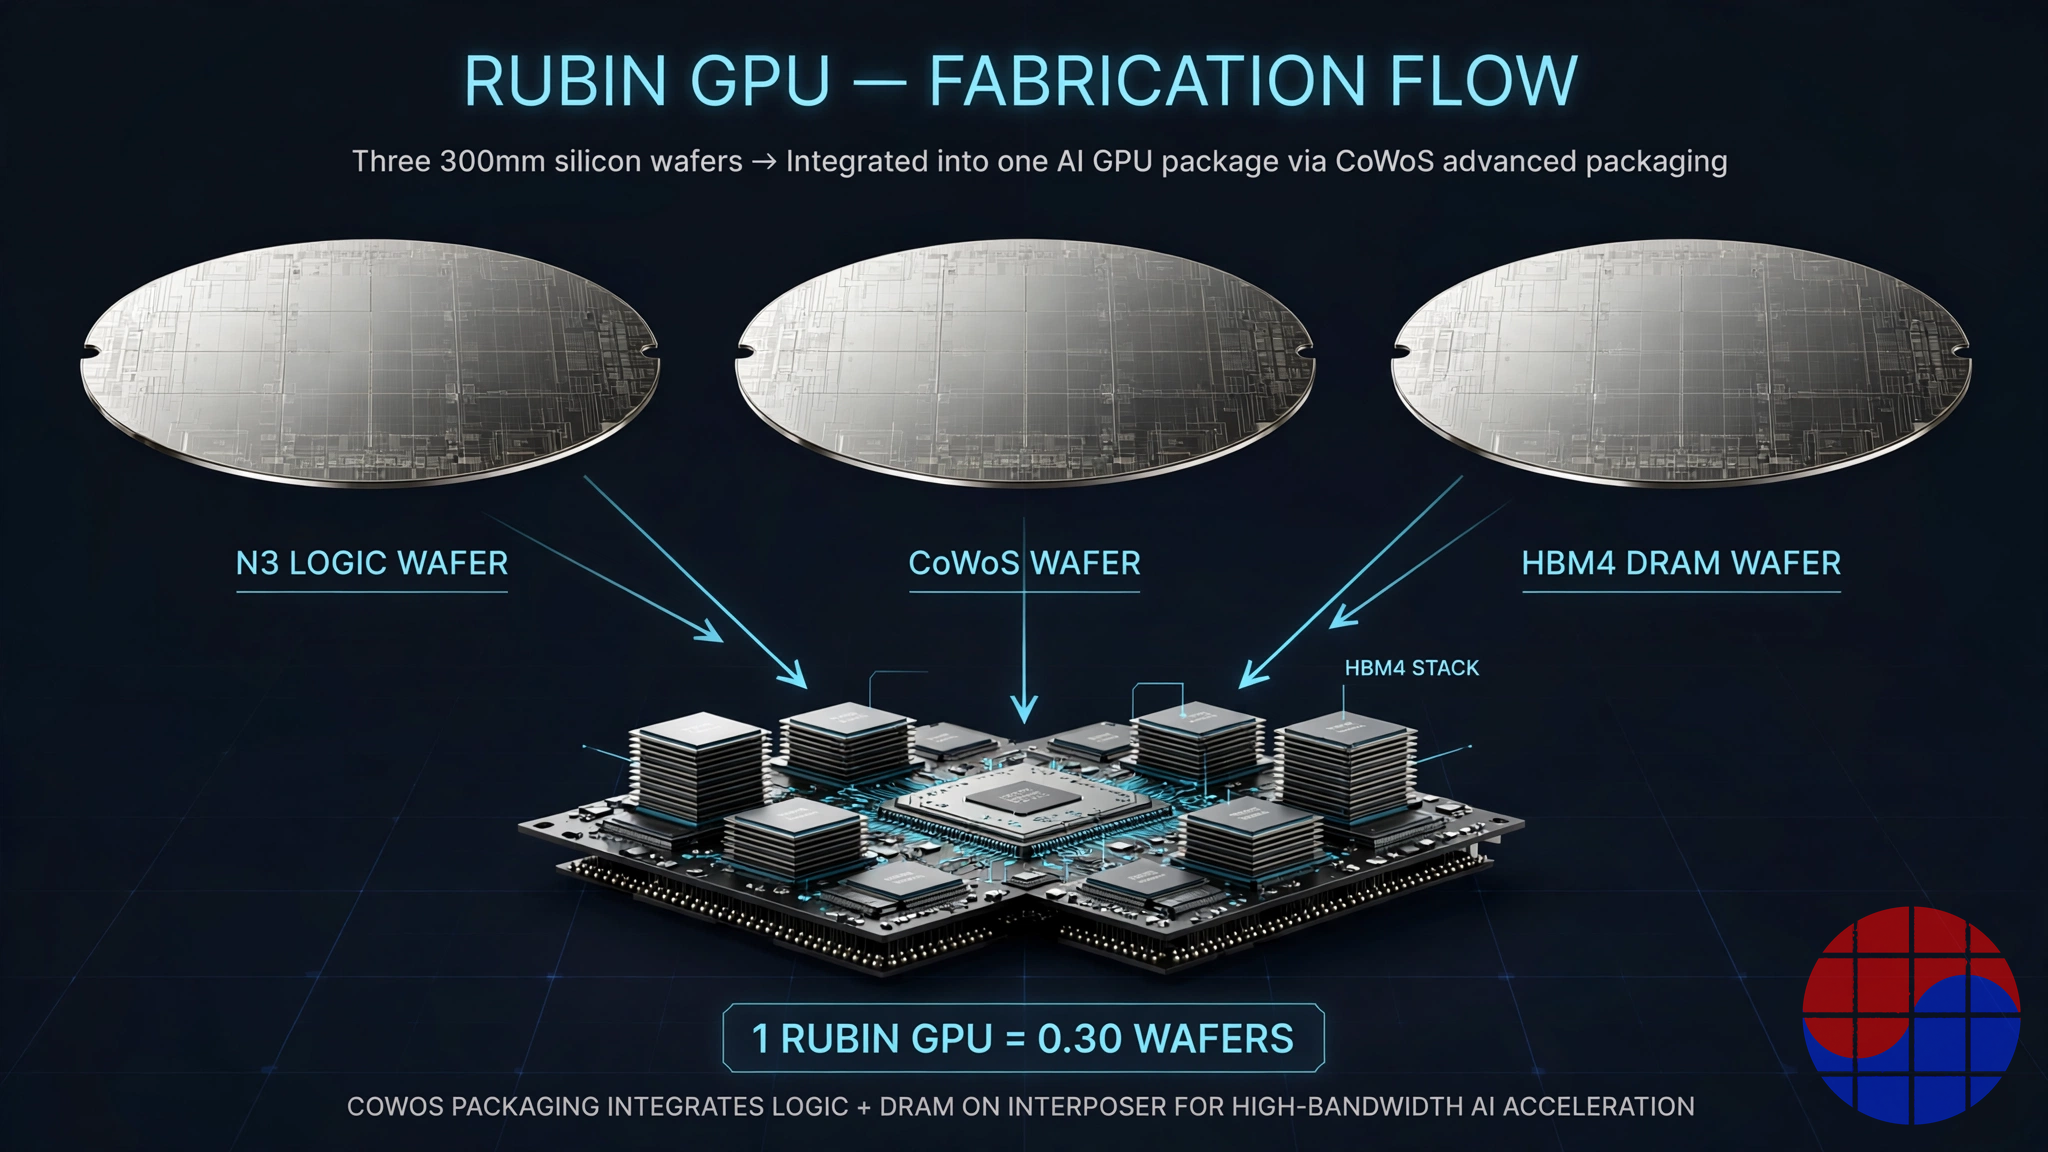
GPU 1개가 소비하는 세 종류의 웨이퍼 — 로직, CoWoS, HBM DRAM. Source: VLSI Korea
환산 결과
| 구분 | GPU 1개당 | 랙 1대당 (72 GPU) | 2027년 (GPU 80만~150만) |
|---|---|---|---|
| 로직 웨이퍼 (3nm) | 0.037장 | 약 2.7장 | 3.0만~5.6만 장 |
| CoWoS 웨이퍼 | 0.143장 | 약 10.3장 | 11.4만~21.4만 장 |
| HBM4 DRAM 웨이퍼 | 0.118장 | 약 8.5장 | 9.4만~17.6만 장 |
| 합계 | 약 0.30장 | 약 21.5장 | 약 24만~45만 장 |
이 표가 말하는 것은 명확하다. GPU 100만 개를 만들려면 세 종류를 합쳐 웨이퍼 약 30만 장이 필요하고, 그중 90% 가까이가 패키징(CoWoS)과 메모리(DRAM) 웨이퍼다. 순수 로직 웨이퍼는 전체의 12% 수준에 불과하다. 실제로 업계 보도에 따르면 상위 4개 AI 칩 설계사가 소비하는 선단 로직 웨이퍼는 전체 선단 생산의 약 12%뿐이다 — 로직 팹이 AI 램프의 제약이 아닌 이유다.
공급 측과 대조하면 CoWoS는 TSMC가 2026년 말 월 12만~15만 장 체제를 갖추고, OSAT 파트너 물량까지 합치면 업계 전체 월 약 20만 장 규모로 추정된다. 엔비디아는 2026년 TSMC CoWoS의 약 60%를 선점한 것으로 보도됐다. 루빈의 2027년 CoWoS 소요량(11만~21만 장/연)은 TSMC 연간 캐파의 한 자릿수 % 수준이라 블랙웰과 나눠 써도 계산이 서지만, 문제는 패키지 대형화다 — 패키지 면적이 커질수록 웨이퍼 1장에서 나오는 패키지 수가 줄어, 캐파 증설분이 면적 증가에 상쇄되는 구조가 반복되고 있다.
5. 회사별 수혜 지도 — 누가 무엇을 얼마나
베라 루빈 1대 뒤에는 황 CEO가 언급한 150곳의 대만 파트너를 포함해 수백 개 공급사가 있다. 핵심만 추리면 다음과 같다.
| 회사 | 공급 품목 | 물량/역할 |
|---|---|---|
| TSMC | 3nm GPU 다이, CoWoS-L 패키징 | GPU 다이 전량. CoWoS 2026년 캐파의 약 60%를 엔비디아가 선점 (보도) |
| SK하이닉스 | HBM4, SOCAMM2 LPDDR5X | HBM4 초기 배분의 50%대 중반 (보도). 12단 36GB 스택, Vera CPU용 SOCAMM2 전시 |
| 삼성전자 | HBM4 | 초기 배분의 20%대 중반 (보도). 1c DRAM + 4nm 베이스다이, 스택당 최대 3.0 TB/s·11.7Gbps로 최고 속도. HBM4E 샘플은 루빈 울트라용 |
| 마이크론 | HBM4 | 초기 배분의 약 20% (보도). 36GB 12단을 2026년 1분기부터 대량 출하, 스택당 2.8 TB/s 이상 |
| Ibiden·신코·유니마이크론·난야PCB | ABF 기판 | 5.5 레티클급 대형 패키지용 빌드업 기판. 기판 면적이 곧 캐파인 품목 |
| ASE·앰코 | 후공정 (CoWoS 일부) | OSAT 신규 캐파 월 5만~6만 장으로 TSMC 오버플로 흡수 (추산) |
| 폭스콘·퀀타·위스트론·잉잉텍(인벤텍) | 랙 조립·통합 | 폭스콘이 최대 조립사로 거론. 노드 조립 5분 설계가 처리량을 좌우 |
| 델·HPE·레노버·슈퍼마이크로·기가바이트 | 시스템 공급 | 랙 단위 완제품을 CSP·기업에 공급 |
| 버티브·슈나이더일렉트릭·델타 | 전력·냉각 | 200kW급 랙용 CDU·전원. DSX POD 파트너 |
| 엔비디아 (자체) | ConnectX-9, BlueField-4, NVLink 스위치, Spectrum-X 포토닉스 | BOM 내재화 확대 — 랙 매출에서 엔비디아가 가져가는 몫이 세대마다 증가 |
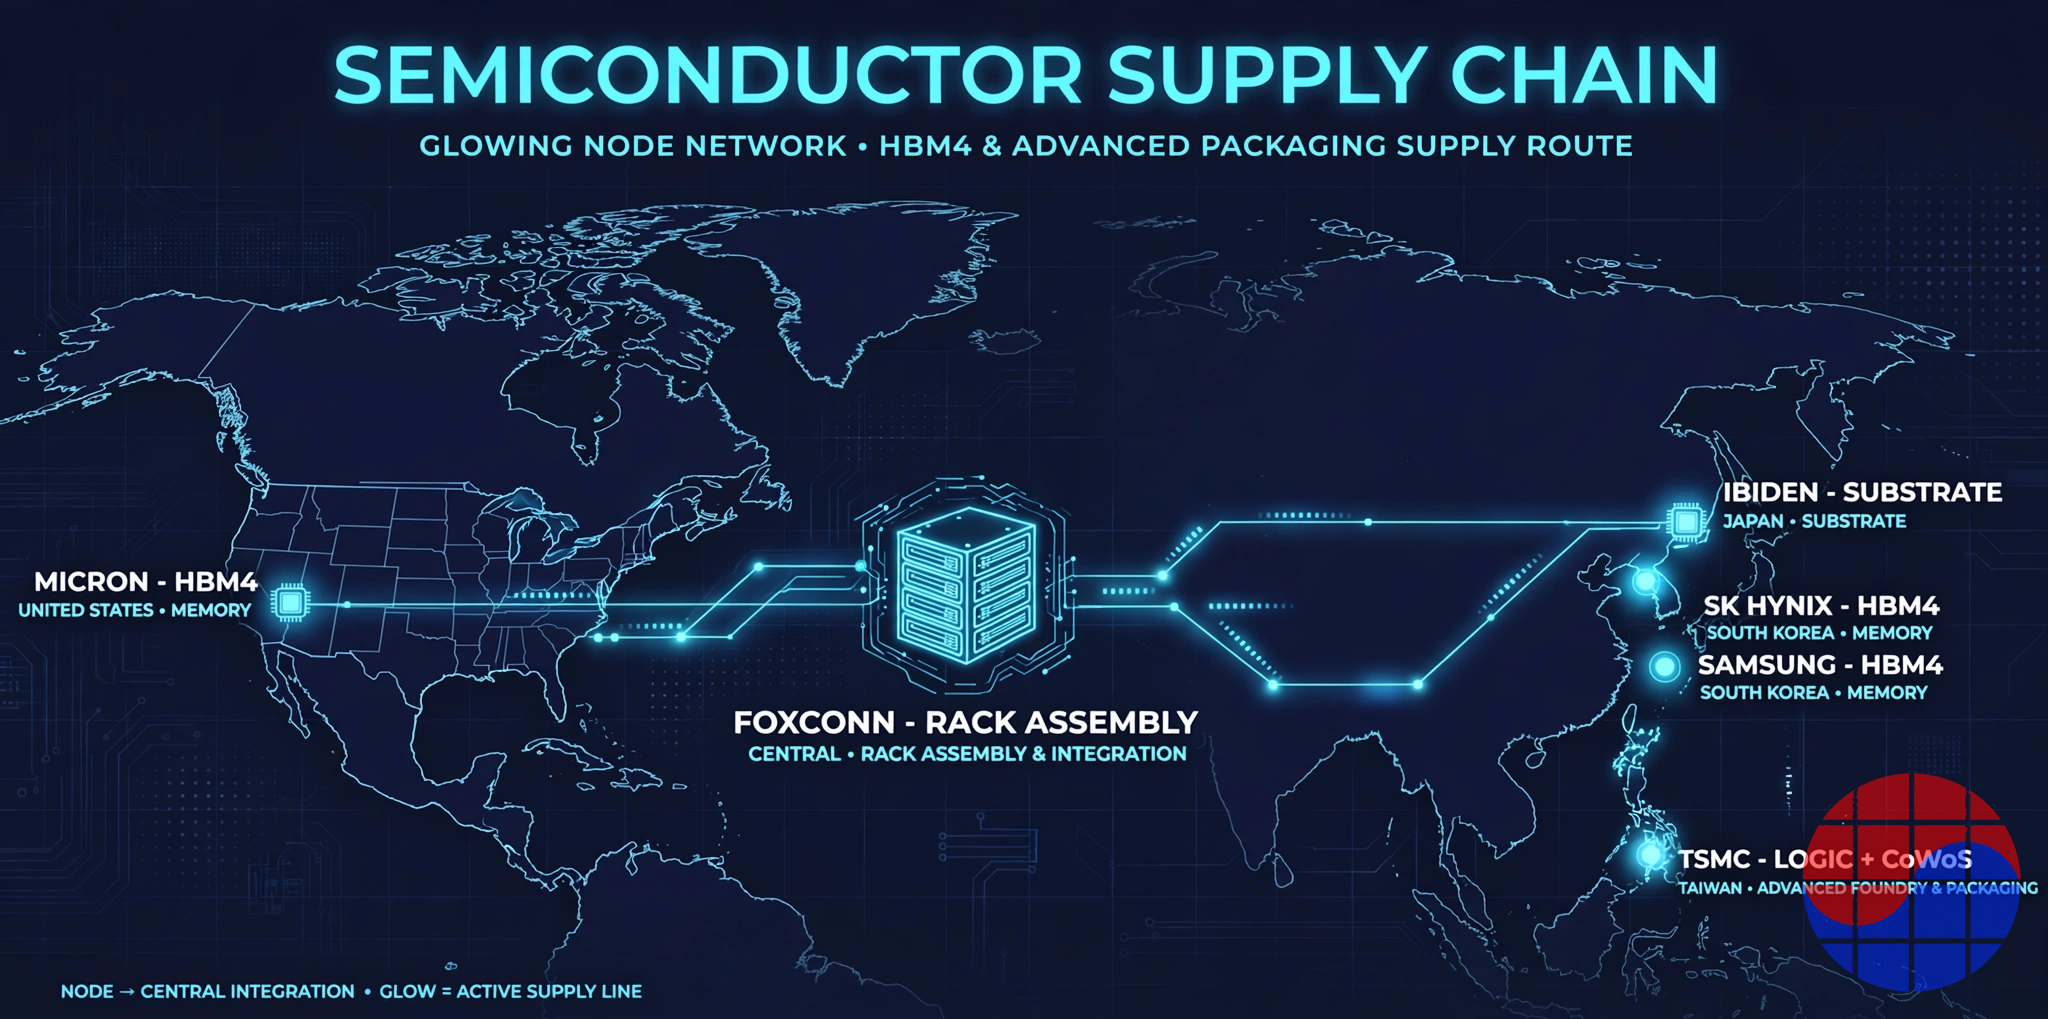
베라 루빈 공급망 지도 — 로직과 패키징은 대만, HBM4는 한국과 미국, 기판은 일본이 나눠 갖는다. Source: VLSI Korea
HBM4 배분은 2025년 말 엔비디아의 물량 배분 보도가 기준이다. SK하이닉스가 50%대 중반으로 최대, 삼성전자가 20%대 중반, 마이크론이 약 20%다. 이 배분은 고정값이 아니다. 삼성전자는 2026년 2월 업계 최초로 HBM4 양산 출하를 시작했고 속도 사양에서 앞서 있으며, SK하이닉스는 2026년 4월 자사 HBM4의 엔비디아향 출하를 20~30% 줄이는 방안을 검토한다는 보도가 나올 만큼 램프 타이밍에 민감하다. 분기마다 배분이 흔들릴 수 있는 구조다.
랙 조립의 경제학도 바뀌었다. 노드 조립이 2시간에서 5분으로 줄면 조립 캐파는 인력 문제가 아니라 부품 입고 속도의 문제가 된다. 조립사 입장에서 베라 루빈은 "만드는 랙"이 아니라 "부품이 도착하는 속도로 나가는 랙"이며, 이는 곧 HBM4와 CoWoS 완료품의 입고가 조립 라인 가동률을 결정한다는 뜻이다. 엔비디아의 모듈형 AI 팩토리 설계(DSX POD)가 구축 속도를 다루는 글은 베라 루빈 DSX POD 딥다이브에서 따로 정리했다 — 이 글은 그 하드웨어가 몇 대, 어떤 웨이퍼로 만들어지는지에 집중한다.
6. 병목 판정 — 무엇이 램프를 막는가
| 공정 | 판정 | 근거 |
|---|---|---|
| HBM4 | 최우선 제약 | 2026년 물량 사실상 소진. 출하 축소 검토 보도. 12단 36GB 스택 가격이 2026년 약 600달러에서 2027년 약 1,300달러로 뛴다는 전망(계약가 전년 대비 +121% 추산 보도) |
| CoWoS | 타이트, 관리 가능 | 3년 새 캐파 약 8배. 그러나 패키지 면적 증가가 증설을 상쇄. 업계 수급 부족 10~20% 지속 추산 |
| ABF 기판 | 주의 | 대형 패키지 면적 증가 직격. 과거에도 조용히 병목이 된 이력 |
| 3nm 로직 웨이퍼 | 제약 아님 | 상위 4개 설계사의 선단 로직 소비 비중 약 12% (보도) |
| 랙 조립 | 제약 아님 | 노드 조립 5분, 모듈화. 제약은 부품 입고 속도 |
| 전력·부지 | 고객 측 제약 | 랙당 190~230kW, 800VDC 전환과 액체냉각 인프라가 현장의 과제 |
결론은 단순하다. 베라 루빈의 생산 함수는 min(HBM4 스택 ÷ 576, CoWoS 패키지 ÷ 72, 로직 다이 ÷ 144)로 쓰이며, 2026~2027년에 이 최소값을 정하는 항은 HBM4다. 엔비디아 분기 실적에서 루빈 매출이 가이던스에 못 미친다면, 수요가 아니라 HBM4 입고를 먼저 의심해야 한다. 반대로 HBM4 계약가가 2027년에 실제로 두 배 가까이 오른다면, 그것은 메모리 3사가 램프의 과실을 나눠 갖기 시작했다는 신호다.
Chase's Take
숫자를 다 깔고 보면 베라 루빈은 GPU 제품이 아니라 메모리 구매 계약의 물리적 형상이다. 랙 가격 500만~780만 달러 중 GPU 다이 자체의 웨이퍼 원가가 차지하는 비중은 생각보다 작고, 돈과 캐파는 HBM4 스택 576개와 CoWoS 면적에 묶여 있다.
한국 관점에서 볼 것은 배분의 기울기다. SK하이닉스의 50%대 중반은 블랙웰 세대의 연장선이지만, 삼성전자의 20%대 중반은 "복귀의 최소치"에 가깝다 — 속도와 HBM4E에서 앞선 카드가 2027년 배분 재산정에서 작동하면 기울기는 바뀐다. 그리고 이 기울기를 정하는 것은 마케팅이 아니라 분기마다의 KGD 수율과 적층 처리량이다.
마지막으로, 웨이퍼 0.30장이라는 숫자를 기억해 둘 가치가 있다. AI 가속기 경쟁은 이제 팹리스의 설계 경쟁인 동시에, 세 종류 웨이퍼의 할당 경쟁이다. 다음 세대의 승부처가 HBM5와 14 레티클급 패키지라는 TSMC의 로드맵은, 이 할당 경쟁이 더 비싸질 뿐 끝나지 않는다는 뜻이다.
수치 출처: 엔비디아 사양 공개 자료 및 GTC 베를린 2026 키노트 보도(2026년 10월 21일), 국내외 언론의 공급망·실적 보도, 증권사 부품가 분석. 물량·웨이퍼 환산은 명시된 가정에 따른 자체 추정으로, 실제 출하량과 다를 수 있다. 본 글은 투자 권유가 아니다.
FAQ
Q: 베라 루빈 랙 1대에 HBM4가 몇 개 들어가나요? A: 576개입니다. GPU 1개에 12단 36GB 스택 8개(288GB)가 들어가고, 랙에는 GPU 72개가 들어가므로 72 × 8 = 576스택, 용량으로는 20.7TB(165,888Gb)입니다.
Q: 베라 루빈은 2027년에 몇 대나 생산되나요? A: 확정 수치는 없습니다. 공급망 추산과 매출 역산을 종합한 베이스 시나리오는 2027년 랙 11,000~21,000대, GPU 80만~150만 개 범위입니다. 2026년 하반기는 3,500~7,000대 수준으로 추정됩니다.
Q: GPU 1개를 만들려면 웨이퍼가 몇 장 필요한가요? A: 세 종류를 합쳐 약 0.30장입니다. 3nm 로직 웨이퍼 0.037장, CoWoS 웨이퍼 0.143장, HBM4 DRAM 웨이퍼 0.118장으로, 이 글에서 공개한 가정(다이 면적·수율·패키지 면적)에 따른 자체 추정입니다. 랙 1대로는 약 21.5장입니다.
Q: 베라 루빈 양산의 진짜 병목은 무엇인가요? A: HBM4입니다. 2026년 물량은 사실상 소진됐고, 공급사의 출하 축소 검토 보도와 2027년 계약 가격 급등 전망이 이를 뒷받침합니다. CoWoS는 타이트하지만 캐파 증설이 진행 중이고, 3nm 로직 웨이퍼와 랙 조립은 제약으로 보기 어렵습니다.
Q: HBM4 공급은 어느 회사가 얼마나 맡나요? A: 2025년 말 배분 보도 기준 SK하이닉스가 50%대 중반, 삼성전자가 20%대 중반, 마이크론이 약 20%입니다. 삼성전자는 2026년 2월 업계 최초 양산 출하와 최고 속도 사양을, SK하이닉스는 최대 배분과 SOCAMM2를, 마이크론은 2026년 1분기부터의 대량 출하를 각각 강점으로 갖고 있으며 배분은 분기마다 조정될 수 있습니다.
📩 VLSI Korea 뉴스레터 구독하기
매일 발행되는 반도체 심층 분석을 이메일로 가장 먼저 받아보세요. 구독은 무료입니다.