VLSI Korea
Fábricas de IA em 14 dias, não em 6 meses: a produção da Vera Rubin e a aposta de velocidade do DSX POD (HBM4)
A Vera Rubin está em produção plena e o DSX POD corta a implantação em um site preparado de cerca de 6 meses para 14 dias. Um contêiner: 7 racks NVL72 e 504 GPU. Velocidade agora é receita.


O gargalo da infraestrutura de IA já não é o chip. É o canteiro de obras — e a NVIDIA acaba de levar a fábrica para dentro da fábrica.
Resumo em 30 segundos
- A Vera Rubin está em produção plena. No GTC de Berlim, em 21 de outubro de 2026, o CEO Jensen Huang anunciou que a próxima plataforma de IA da NVIDIA entrou em produção plena (full production).
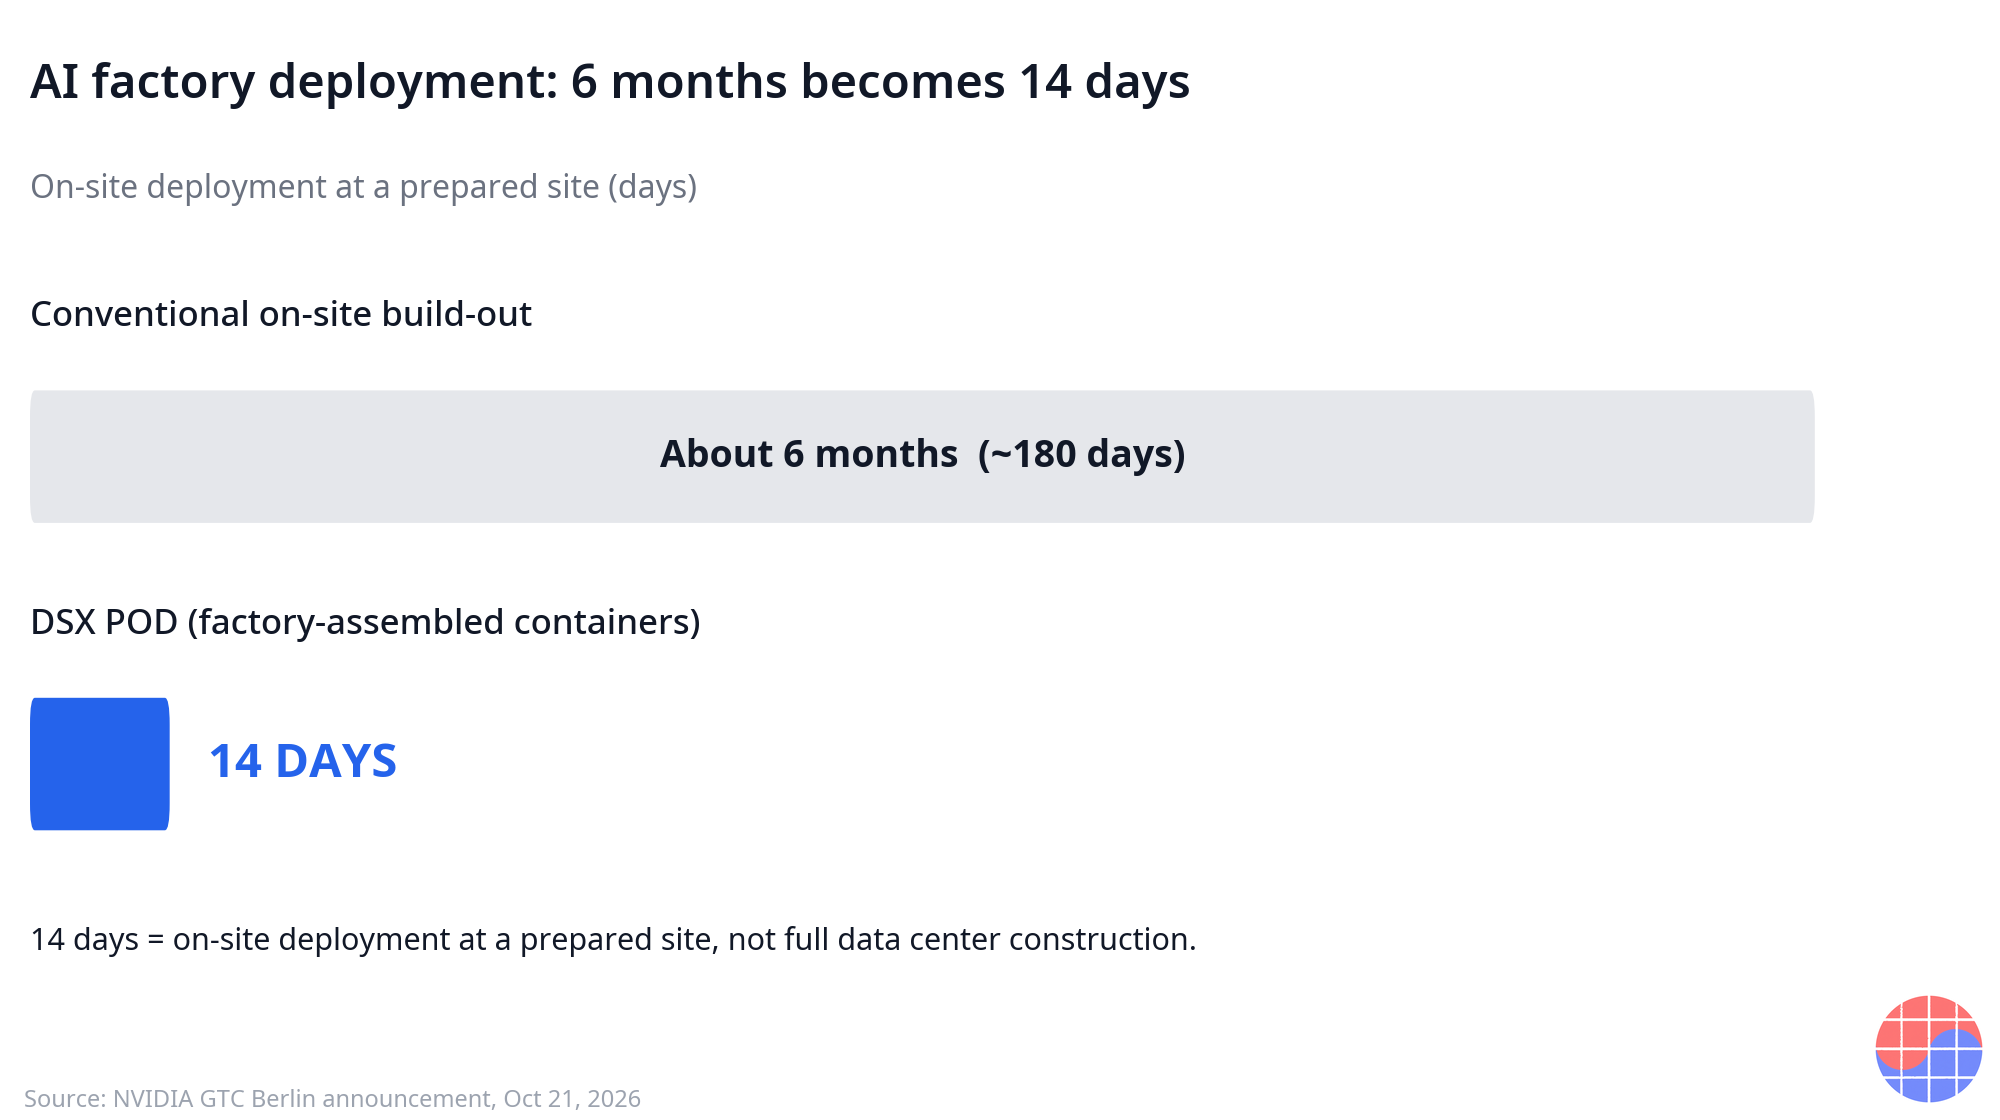
- O DSX POD transforma uma fábrica de IA em um produto que se despacha. O design de referência monta e testa uma fábrica de IA Vera Rubin completa dentro de contêineres modulares na fábrica, e depois a envia. A implantação no local, em um site preparado, cai de cerca de 6 meses para um mínimo de 14 dias.
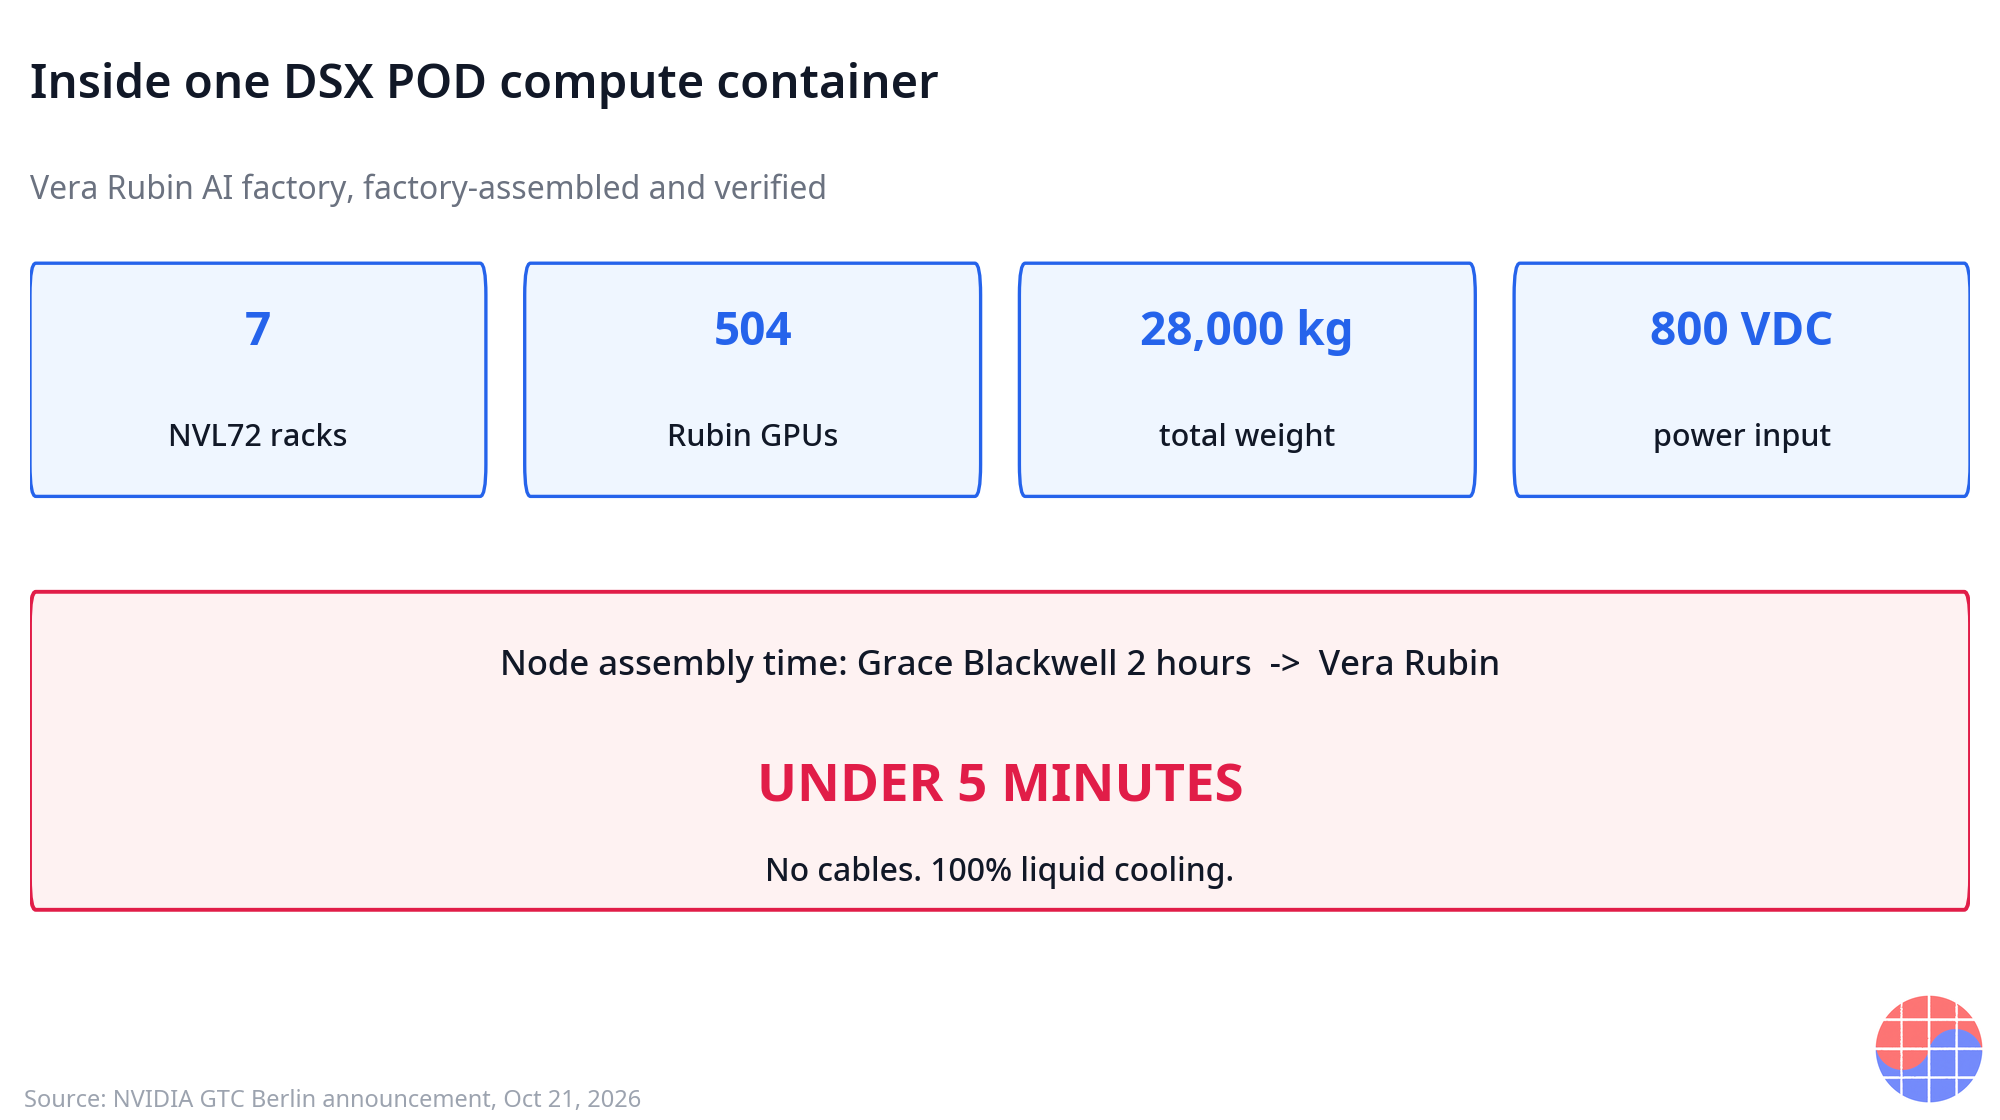
- Um contêiner de computação é uma máquina séria: 7 racks Vera Rubin NVL72, 504 GPU Rubin, cerca de 28.000 kg, alimentado por 800 VDC. Um contêiner já não é uma caixa. É um bloco de construção de um centro de dados.
- O próprio nó foi reprojetado para a velocidade de montagem. Os nós Vera Rubin não têm cabos, são 100% refrigerados a líquido e reduzem o tempo de montagem do nó de 2 horas na Grace Blackwell para menos de 5 minutos.
- 17 parceiros apoiam o design, entre eles Dell, HPE, Lenovo, Schneider Electric, Vertiv, Eaton e Foxconn (Ingrasys), com envios previstos a partir do início de 2027. Vale ler bem os 14 dias: é a implantação no local em um lugar onde a infraestrutura de energia e refrigeração já está preparada, e não o período de construção de um centro de dados inteiro.
Contexto
A fila se moveu da fab para o campo
Por três anos, a história da infraestrutura de IA foi uma história de fornecimento de chips. GPU faltavam, HBM faltava, encapsulamento avançado faltava, e quem garantia wafers e memória garantia receita. Essa escassez não desapareceu, mas atrás dela se formou uma segunda fila: o trabalho físico de transformar o hardware entregue em uma fábrica de IA em funcionamento. Os racks chegam, e então começam meses de integração no local: distribuição de energia, circuitos de refrigeração, rede, montagem nó a nó, testes e depuração, grande parte disso a cargo de escassos engenheiros de campo em prédios que ainda estão sendo concluídos.
Os anúncios da NVIDIA de 21 de outubro de 2026 no GTC de Berlim atacam diretamente essa segunda fila. A notícia de plataforma é que a Vera Rubin, a arquitetura sucessora da Grace Blackwell, está em produção plena, nas palavras do CEO Jensen Huang. A notícia de negócio é o DSX POD: um design de referência no qual a fábrica de IA Vera Rubin completa é montada e verificada em contêineres modulares antes de sair da fábrica, de modo que o site recebe um sistema testado, e não uma pilha de peças.
O que é exatamente um DSX POD
O DSX POD é melhor entendido como uma mudança no lugar onde a integração acontece. No modelo convencional, a integração ocorre no destino, sob condições de obra e com a variabilidade de uma obra. No modelo POD, a integração ocorre na origem, sob condições de fábrica, onde a mesma tarefa se repete, se mede e se melhora. O contêiner é a unidade de entrega: os contêineres de computação transportam os racks, e o design é especificado com precisão suficiente para que o conteúdo de um contêiner seja conhecido ao quilograma e ao volt antes do envio.
| Contêiner de computação DSX POD | Especificação |
|---|---|
| Racks por contêiner | 7 racks Vera Rubin NVL72 |
| GPU por contêiner | 504 GPU Rubin |
| Peso | Cerca de 28.000 kg |
| Entrada de energia | 800 VDC |
| Design do nó | Sem cabos, 100% refrigeração líquida |
| Tempo de montagem do nó | Menos de 5 minutos (Grace Blackwell: 2 horas) |
Fonte: anúncios da NVIDIA no GTC de Berlim, 21 de outubro de 2026. Links na nota de rodapé.
O número da montagem do nó merece uma pausa. Reduzir a montagem de 2 horas para menos de 5 minutos não é um recurso de conveniência. É o que acontece quando uma plataforma é projetada de trás para frente a partir do processo de implantação: o cabeamento, historicamente uma grande parte tanto do tempo de montagem quanto dos erros de campo, é eliminado por completo do nó, e a refrigeração passa integralmente para líquido. Um nó que se monta em minutos é também um nó que se substitui em minutos, o que muda a economia de manutenção da base instalada por uma década.
Os 14 dias, ditos com precisão
O número mais citado do anúncio — implantação em um mínimo de 14 dias, contra cerca de 6 meses de construção convencional no local — precisa de sua condição anexada, porque a condição é onde vive o modelo de negócio. Os 14 dias são o período de implantação no local em um site preparado: um lugar onde a infraestrutura de energia, refrigeração e prédio já está instalada. Não é o período de construção de um centro de dados inteiro. O terreno, as licenças, a conexão à rede elétrica e a estrutura do prédio continuam levando o tempo que levam.
Essa distinção não enfraquece o anúncio. Ela esclarece quem captura o valor. O POD comprime o segmento do calendário que fica entre «infraestrutura pronta» e «fábrica de IA produzindo tokens», o segmento que determina quando o capital de um cliente começa a render. Tudo o que está antes do site preparado continua sendo um problema de construção e de serviços públicos, e é por isso que a lista de parceiros importa tanto quanto o contêiner.
Análise de negócio em profundidade
Velocidade é reconhecimento de receita
Na infraestrutura de IA, a velocidade de implantação não é um detalhe operacional. É a inclinação da curva de receita. Um hiperescalador ou operador de fábricas de IA que coloca capacidade no ar meses antes começa a vender tokens, execuções de treinamento e instâncias em nuvem meses antes, com um hardware cuja meia-vida competitiva se mede em trimestres. Quando uma geração de plataforma dura aproximadamente um ano na fronteira, uma cauda de integração de 6 meses pode consumir metade da vida econômica do ativo antes que ele ganhe seu primeiro dólar em plena utilização.
Essa é a lente para o DSX POD. Encurtar a implantação em site preparado de cerca de 6 meses para um mínimo de 14 dias adianta a receita em meses por site, e faz isso exatamente no momento em que a demanda por computação de IA está na fila. O cliente não compra contêineres. O cliente compra tempo de calendário: o insumo mais escasso de toda a expansão da IA, mais escasso que os chips, porque chips podem ser acelerados e calendários, não.
| Modelo de implantação | Implantação no local, em um site preparado | Para onde vai o tempo |
|---|---|---|
| Construção convencional | Cerca de 6 meses (cerca de 180 dias) | Integração de racks no local, cabeamento, conexão de refrigeração, montagem de nós, testes em etapas |
| DSX POD | Um mínimo de 14 dias | Posicionamento de contêineres pré-montados e pré-verificados, e comissionamento final |
Fonte: anúncios da NVIDIA no GTC de Berlim, 21 de outubro de 2026. Links na nota de rodapé.
A pilha da NVIDIA sobe mais um nível
O padrão estratégico já é familiar, mas o POD o estende. A NVIDIA subiu dos chips para as placas, das placas para os racks (NVL72), dos racks para os sistemas em rede, e agora, com o design de referência DSX POD, dos sistemas para a própria fábrica. Cada subida amplia a receita que a NVIDIA e seu ecossistema podem associar a um gigawatt de capacidade de IA, e cada subida aprofunda a dependência do cliente em relação ao design de referência que define aquele nível.
Um design de referência é uma forma particular de poder. A NVIDIA não precisa fabricar contêineres para controlar a camada de contêineres; precisa que a indústria construa segundo sua especificação, para que a especificação se torne a interface que todos os outros devem cumprir. Os 17 parceiros de lançamento — Dell, HPE e Lenovo em sistemas; Schneider Electric, Vertiv e Eaton em infraestrutura de energia e refrigeração; Foxconn (por meio da Ingrasys), Delta, GIGABYTE, Pegatron, QCT, Wistron e outros na base de ODM e componentes — não são apenas fornecedores. São a distribuição do padrão. Os envios estão previstos a partir do início de 2027.
A integração em fábrica move o gargalo, não o elimina
A pré-integração é uma estratégia de manufatura aplicada a um problema de construção, e sua economia segue a lógica da manufatura. A montagem em fábrica converte a mão de obra de campo, variável, em trabalho de linha repetível: a qualidade é verificada onde vive o equipamento de teste, os erros são encontrados onde estão os engenheiros que projetaram o nó, e a curva de aprendizado se acumula a cada contêiner construído, em vez de reiniciar a cada site. O redesenho do nó — sem cabos, totalmente refrigerado a líquido, montável em menos de 5 minutos — é a plataforma moldada para caber nessa linha.
Mas o gargalo se move, em vez de desaparecer. Se os contêineres podem ser implantados em 14 dias em um site preparado, então o site preparado se torna a restrição: a interconexão à rede, os prazos de entrega do equipamento elétrico, a infraestrutura de refrigeração e as licenças. A presença de Schneider Electric, Vertiv e Eaton na lista de parceiros é um reconhecimento exatamente disso: a próxima fila é elétrica. É também por isso que a leitura honesta do anúncio combina o número de 14 dias com sua condição. Entre os vencedores da próxima fase estará quem puder entregar sites preparados no ritmo em que os contêineres agora podem ser preenchidos.
A camada de software: DSX MaxLPS e a alegação de eficiência
A NVIDIA também anunciou o software DSX MaxLPS, que, segundo a empresa, entrega a mesma produção de IA com até 30% menos energia. Em uma indústria em que a restrição vinculante é cada vez mais o megawatt, e não o rack, uma alegação de eficiência em nível de software desse tamanho tem peso estratégico: se a produção por watt aumenta, a mesma conexão à rede comporta mais computação vendável, e a capacidade efetiva de cada site preparado cresce sem nova construção. A alegação é da NVIDIA, apresentada como número de anúncio, e o mercado a verificará na implantação; mas até a direção importa, porque a eficiência energética se compõe com a velocidade de implantação: mais rápido de instalar, e mais produção por megawatt instalado.
O sinal do ecossistema se estendeu também à camada de nuvem: o A5X do Google Cloud, construído sobre a Vera Rubin, tem disponibilidade geral prevista para novembro. As plataformas de fronteira agora são lançadas simultaneamente como produtos que se compram, contêineres que se implantam e instâncias em nuvem que se alugam: três canais, uma cadeia de suprimentos e uma fila de alocação atrás de todos eles.
A conexão com a HBM4
Cada rack Vera Rubin enviado é também um envio de HBM4. A memória da plataforma é HBM4, o que significa que a rampa de produção da Vera Rubin e os envios de POD do início de 2027 se traduzem diretamente em volume de HBM4 para os fabricantes de memória qualificados na plataforma. Este é o elo silencioso entre um anúncio de velocidade de implantação em Berlim e os livros de pedidos da indústria de memória: a velocidade de implantação determina a rapidez com que os racks se convertem em sistemas em funcionamento, e os sistemas em funcionamento são o que puxa a próxima rodada de pedidos de GPU e HBM. Um modelo de implantação mais rápido não apenas adianta a receita da NVIDIA. Ele aperta a cadência de toda a cadeia — encapsulamento, HBM, substratos e equipamento elétrico — que alimenta a fábrica.
A leitura de Chase
A leitura preguiçosa do DSX POD é «a NVIDIA inventou um centro de dados mais rápido». A leitura correta é sobre qual segmento da expansão da IA ainda tinha meses de folga, e quem acaba de reivindicá-lo.
Os chips dominaram as manchetes por três anos porque os chips eram a restrição. Mas um rack entregue que passa meses em integração de campo é estoque, não capacidade, e a indústria vem carregando silenciosamente uma quantidade enorme das duas coisas. O POD ataca essa posição de estoque. Verificação em fábrica, um nó sem cabos que se monta em menos de 5 minutos, um contêiner especificado ao quilograma: cada elemento mira a lacuna entre «hardware entregue» e «hardware ganhando». A NVIDIA examinou o calendário da expansão, encontrou o maior bloco de tempo morto que poderia plausivelmente possuir, e o transformou em produto.
Duas implicações estão subestimadas. Primeira: os designs de referência redistribuem a margem sem redistribuir o controle. Os 17 parceiros ganham um mercado real — fábricas de IA em contêineres enviadas a partir do início de 2027 — mas o ganham dentro de uma especificação de propriedade da NVIDIA, o que significa que o crescimento do ecossistema e o aprisionamento da plataforma da NVIDIA são o mesmo acontecimento visto de dois lados. Segunda: o anúncio redefine silenciosamente o que «preparado» significa como ativo competitivo. Quando a implantação leva 6 meses, um site pronto e um não pronto diferem por uma fase de construção. Quando a implantação leva 14 dias, diferem por quase todo o calendário, e sites, posições de energia e licenças se tornam ativos estratégicos negociáveis de um modo que não eram antes.
A pergunta aberta é a cadência de execução. Um design de referência é uma promessa até que os contêineres sejam enviados em volume, e o início de 2027 é quando a promessa terá seu primeiro teste duro: quantos POD, com que rendimento (yield), em quantos sites genuinamente preparados. Vale acompanhar os relatórios de envios dos parceiros, não as palestras. Se a implantação de 14 dias se mantiver em campo, ainda que aproximadamente, cada plataforma concorrente será obrigada a responder a uma pergunta que antes não precisava responder: não quão rápidos são seus chips, mas quão rápido suas fábricas se montam.
Implicações
- Para hiperescaladores e operadores de fábricas de IA: a velocidade de implantação é agora um critério de compra no mesmo nível do desempenho por watt. Uma plataforma que entra em produção meses antes monetiza meses antes: avalie o intervalo entre site preparado e produção, não apenas o silício.
- Para os parceiros da NVIDIA: o POD cria um mercado de camada de contêineres a partir do início de 2027, dentro da especificação da NVIDIA. A oportunidade é real; a dependência também. Os parceiros com posições em energia e refrigeração (a camada do site preparado) detêm as cartas mais escassas, à medida que o gargalo se torna elétrico.
- Para os fabricantes de memória: a Vera Rubin em produção plena, mais os envios de POD a partir do início de 2027, é um sinal de volume de HBM4. A velocidade de implantação a montante determina a cadência de pedidos a jusante.
- Para os fornecedores de plataformas concorrentes: a disputa se ampliou dos chips para os sistemas de implantação. Um rack rival agora compete não só em computação, mas em tempo até a produção em um site preparado.
- Para os investidores: acompanhe três pontos de verificação: os envios de POD dos parceiros no início de 2027, os relatos de campo sobre a alegação de implantação em 14 dias, e os resultados medidos da alegação de até 30% menos energia do DSX MaxLPS. Os anúncios definem a narrativa; os envios definem os números.
Perguntas frequentes
O que é exatamente o DSX POD da NVIDIA?
É um design de referência que transforma uma fábrica de IA Vera Rubin completa em contêineres modulares: a fábrica é montada e verificada na fábrica, e depois enviada. Um contêiner de computação abriga 7 racks Vera Rubin NVL72 com 504 GPU Rubin, pesa cerca de 28.000 kg e recebe uma entrada de energia de 800 VDC. A NVIDIA o anunciou no GTC de Berlim em 21 de outubro de 2026, com 17 parceiros e envios previstos a partir do início de 2027.
O número de 14 dias significa que um centro de dados pode ser construído em 14 dias?
Não. Os 14 dias são o período de implantação no local em um site preparado — um onde a energia, a refrigeração e a infraestrutura do prédio já estão instaladas — contra cerca de 6 meses de construção convencional no local. Construir o próprio site, incluindo a conexão à rede e as licenças, continua levando muito mais tempo. O POD comprime o segmento entre «site pronto» e «fábrica de IA em funcionamento».
O que mudou no nó Vera Rubin para a montagem ser tão rápida?
A NVIDIA afirma que os nós Vera Rubin não têm cabos, são 100% refrigerados a líquido e reduzem o tempo de montagem do nó de 2 horas na Grace Blackwell para menos de 5 minutos. Eliminar o cabeamento elimina tanto o tempo de montagem quanto uma fonte importante de erros de campo, e ainda torna os nós rápidos de substituir em serviço, não apenas de instalar.
Por que a produção da Vera Rubin importa para a HBM4?
Os sistemas Vera Rubin usam memória HBM4, de modo que a rampa de produção plena da plataforma — e os envios de DSX POD previstos a partir do início de 2027 — se traduzem diretamente em demanda de HBM4. A velocidade de implantação importa para os fabricantes de memória porque uma implantação mais rápida adianta a próxima rodada de pedidos de GPU e HBM.
Fontes: cobertura do anúncio de implantação do DSX POD da NVIDIA; relato do GTC de Berlim sobre a Vera Rubin e o DSX POD; relato sobre a implantação em 14 dias do DSX POD (todos sobre os anúncios da NVIDIA no GTC de Berlim de 21 de outubro de 2026). Este artigo é uma análise, não uma recomendação de investimento.
📩 Assine a newsletter da VLSI Korea
Receba primeiro no seu e-mail as nossas análises diárias de semicondutores. Assinatura gratuita.