VLSI Korea
DeepX 把 NPU 接上 Intel 軟體:韓國 AI 晶片新創的生態系布局
DeepX 正把自家 NPU 整合進 Intel 的 OpenVINO,成為可選的推論處理器,初期成果預計明年初出爐,之後才會正式公布。與 AMD 的實務協商已經展開,但仍在確認方向的階段。本篇分析:邊緣 NPU 的勝負關鍵不是 TOPS,而是軟體生態系的摩擦。


🆓 免費文章 · 任何人都可以免費閱讀

30秒摘要
DeepX 是一家設計低功耗神經網路處理器(NPU)的韓國無晶圓廠新創公司。執行長 Kim Nok-won 在 2026 年 10 月 15 日的訪談中表示,公司正把旗下 DX-M1 晶片整合進英特爾的 OpenVINO 軟體工具包,作為可選取的推論處理器。初步成果預計明年初出爐,之後將正式宣布合作夥伴關係。該公司也在 10 月 7 日於首爾與超微執行長 Lisa Su 舉行圓桌會議後,與超微展開工作層級的對談,不過雙方都表示,討論仍在確認方向的階段,而非已敲定的合作關係。與此同時,DeepX 採用三星晶圓代工 2 奈米製程的次世代晶片 DX-M2 本月投片,首批矽晶預計 2027 年 3 月至 4 月出爐。貫穿其中的共同主線是策略性的:DeepX 賭的是,對於邊緣 AI 晶片而言,決定性的戰場不是原始 TOPS,而是晶片在其他公司的軟體堆疊與通路中,製造了多麼少的摩擦。
背景
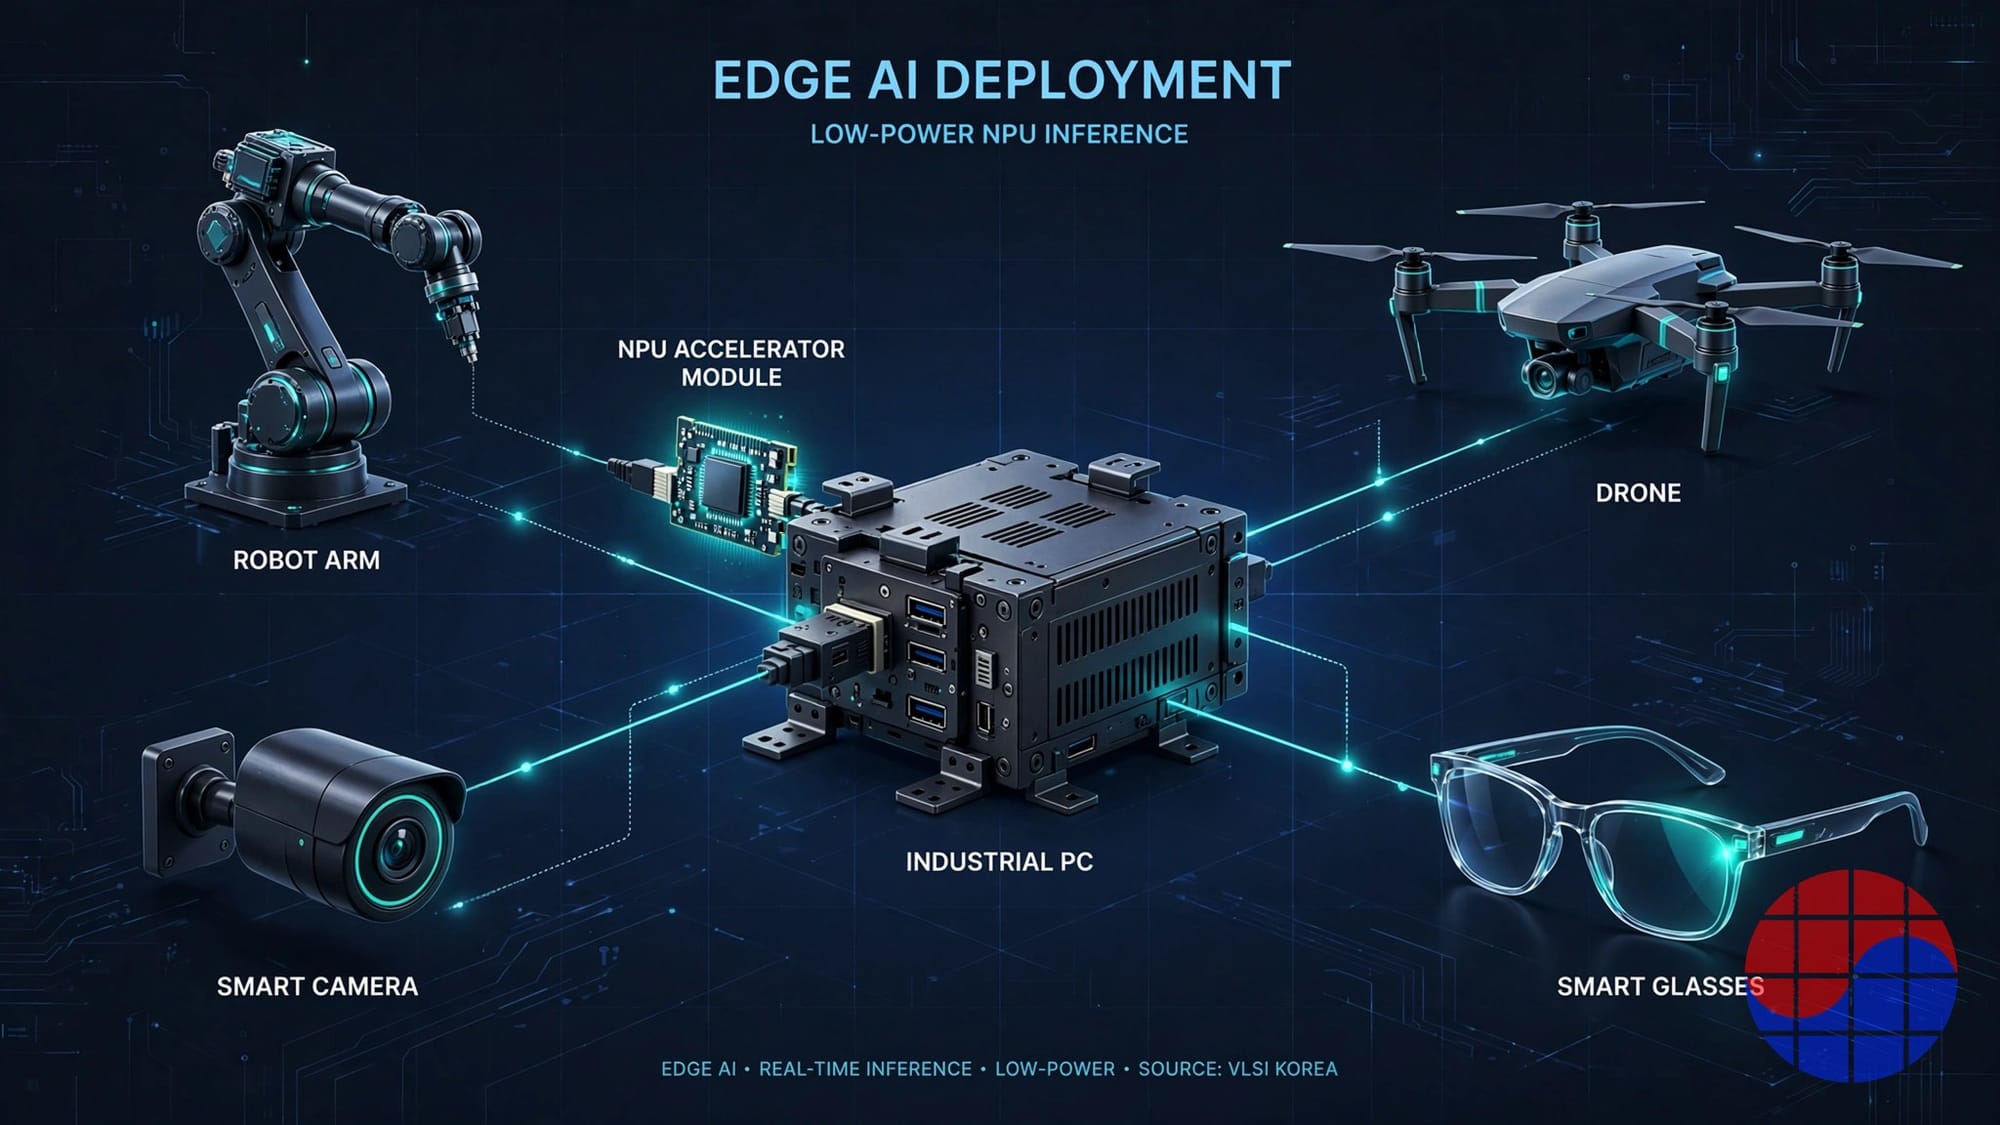
DeepX 由 Kim Nok-won 於 2018 年創立。他擁有 UCLA 電機工程博士學位,曾任職於博通、Cisco 與 IBM。該公司是無晶圓廠設計商,開發 AI 推論晶片,並將製造外包。其產品鎖定裝置端 AI 與邊緣 AI,包括機器人、無人機、工業電腦、智慧攝影機與智慧眼鏡,這些裝置必須在沒有雲端連線的情況下,以數瓦功耗在本機執行 AI 模型。
旗艦產品 DX-M1 已於 2025 年 8 月以三星晶圓代工 5 奈米製程進入量產。它在 3–5W 下提供最高 25 TOPS 的 AI 運算效能,以可插入現有系統的 M.2 模組形式出貨,據公司表示,每顆晶片售價低於 100 美元。DeepX 報告該晶片量產良率達 91.1%,這是公司揭露的數字,但之所以重要,是因為它支撐了低售價。
商業動能是可以量化的。2025 年 8 月至 2026 年 7 月期間,DeepX 取得來自 10 多個國家客戶的 77 筆採購訂單,累計達 183 億韓元(約 1,300 萬美元)。全球約 300 家公司正在評估其晶片,其中韓國超過 100 家;公司已簽署 27 份經銷協議,並計畫在日本與歐洲設立辦公室。據報告,營收從 2025 年的 33 億韓元,成長到 2026 年的 200 億韓元以上。已揭露的客戶與平台合作夥伴包括現代汽車集團的機器人事業、工業運算領導廠商 Advantech 與 AAEON、Lenovo 與 Baidu。
融資也隨動能而至。DeepX 在 2024 年 5 月的 C 輪募資中募得 1,100 億韓元,2026 年 D 輪正在進行中。今年 10 月,三星證券與由 Samsung Venture Investment 管理的合夥事業 SVIC 33,認購了 1,230 萬美元的新股配售。
商業深度剖析
OpenVINO 整合實際改變了什麼
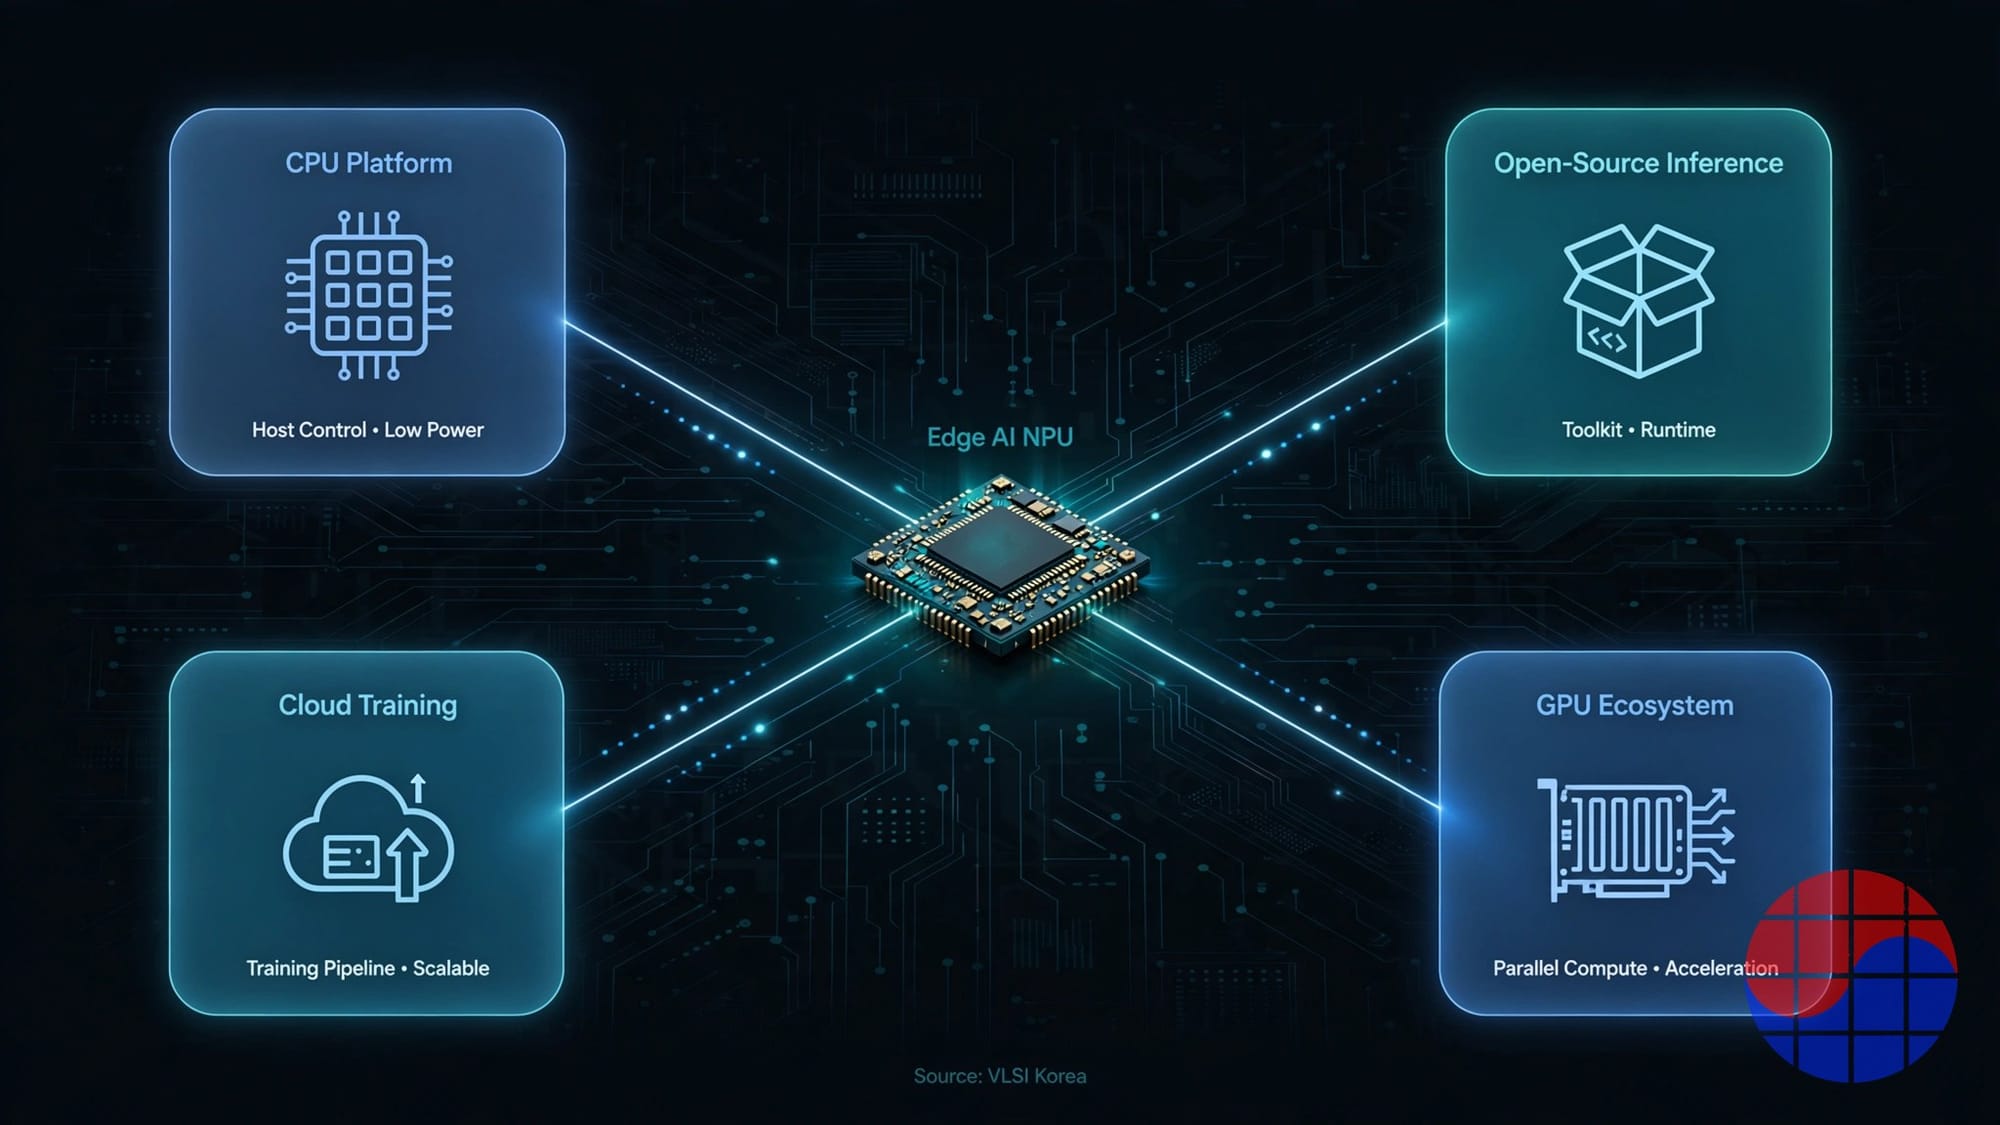
OpenVINO 是英特爾的開源工具包,用於在 CPU、GPU 與加速器上部署 AI 推論。開發者只需按照其 API 與模型格式撰寫一次,就能在執行時選擇硬體裝置。DeepX 正把自家 NPU 加入為其中一個可選裝置,並進行模型最佳化與開發者工具作業,讓這條路徑達到量產等級。
其實際意義,從 DeepX 晶片目前所處的位置來看最容易理解。DeepX 的 NPU 已經被設計導入採用英特爾處理器的工業電腦,但目前整合商必須手動安裝並接通 DeepX 的軟體。每一個手動步驟,都是採用上的一道稅:對 OEM 而言是工程工時,對 DeepX 而言是支援負擔,也是設計停留在「評估」而無法進入量產的理由。成為 OpenVINO 的原生裝置,就能消除這道稅。已經在使用 OpenVINO 的開發者,也就是英特爾架構工業電腦世界中多數預設推論堆疊的使用者,只要更改裝置字串,就能鎖定 DeepX 矽晶,而不必採用新的 SDK。
這也是順序之所以重要的原因。DeepX 表示,只有在整合產生結果後,才會正式宣布與英特爾的合作關係,初步成果預計明年初出爐。這是一種成果優先的姿態,也表明這項整合是正在進行的工程作業,而非一份備忘錄。
英特爾能從中得到什麼
OpenVINO 對英特爾的策略價值,隨著它支援的每一款加速器而提升。英特爾自家的矽晶路線圖,並未直接涵蓋 5W 以下的獨立附加加速器利基市場。正如 Kim 在超微圓桌會議上指出的,整合在 CPU 中的 NPU 可達 40–50 TOPS,但 5W 等級的產品很少,因此機器人與現場裝置需要在 CPU 旁邊配備低功耗的輔助加速器。如果 OpenVINO 成為用來編程這些輔助晶片的層級,包括英特爾沒有製造的晶片,那麼即使英特爾沒有贏得矽晶訂單,也能守住軟體標準。對 DeepX 而言,方程式是對稱的:它借用英特爾的裝機基礎與開發者習慣,而非從零打造專有堆疊,這正是軟體人力有限的新創公司,不能慢慢輸掉的一場仗。
與超微的對談:有實質內容,但界限明確
超微這條故事線需要謹慎校準。10 月 7 日在首爾的活動,是一場圍繞 7 月簽署的韓國政府與超微備忘錄所舉辦的圓桌會議,包括 FuriosaAI、Rebellions 與 Mobilint 在內的 13 家韓國 AI 基礎設施公司,與 Lisa Su 同席。議程具結構性:結合超微 CPU 與 GPU 以及韓國 NPU 的異質運算、參與超微開放的 ROCm 軟體生態系,以及政府希望在國內驗證並出口的參考設計。超微承諾在年內在韓國設立 AI 研究中心。
在這個框架內,DeepX 的雙邊後續跟進是真實的,但仍處於早期。Kim 表示,他確認了超微願意與外部公司在開放的實體 AI 生態系上合作;超微的技術團隊已以電子郵件跟進;DeepX 計畫在次週與超微韓國負責人會面,討論具體細節。Kim 本人把這個階段形容為透過工作層級對談確認方向。目前沒有已宣布的技術合作,沒有共同產品,也沒有針對 DeepX 矽晶的 ROCm 整合承諾。
有兩個事實讓這個故事保持落地。第一,通路層級的共存已經存在:結合超微系統與 DeepX NPU 的產品,已透過經銷商 Avnet 在市場上銷售。第二,結構性邏輯是真實的,超微的開放生態系策略需要非超微的加速器接入其 CPU 與 GPU,而韓國 NPU 需要全球平台的通路引力。今天存在的,是一扇由政府扶著打開的門,而不是已簽署的聯盟。
韓國 NPU 版圖:兩種不同的賽局
韓國的 NPU 新創公司常被歸為一類,但他們打的是不同的運動。Rebellions 與 FuriosaAI 鎖定資料中心推論:FuriosaAI 的 RNGD 是用於伺服器的 180W PCIe 加速器,兩家公司都在輝達生態系的引力下,向雲端與企業買家銷售機櫃規模的每瓦效能。DeepX 與 Mobilint 則鎖定邊緣:個位數的瓦數、低於 100 美元的價格,買家是裝置 OEM 與工業電腦製造商,而非資料中心營運商。
護城河的邏輯因此也不同。資料中心業者必須在軟體戰中生存,也就是編譯器成熟度對抗 CUDA。邊緣業者必須在通路戰中生存:在 Advantech 與 AAEON 平台中的貨架空間、橫跨 27 家合作夥伴的經銷協議、與整合商已經在使用的工具鏈的相容性。DeepX 近期的動作全都是通路與工具鏈的動作。它已完成與 Amazon Web Services 的軟體作業,讓在雲端訓練的模型能部署到 DeepX 裝置上,並計畫在年內推出與輝達 Isaac 平台相容的機器人軟體。OpenVINO、AWS 流程、Isaac 相容性,這些都不是矽晶發表。它們全都減少了整合商說「不」的理由數量。
矽晶路線圖作為第二條戰線平行推進。採用三星晶圓代工 2 奈米製程的 DX-M2 於 2026 年 10 月投片,首批晶片預計 2027 年 3 月至 4 月出爐,量產目標訂在 2027 年稍晚;公司目標是在同樣的低功耗等級中達到最高 80 TOPS。DeepX 也是三星先進製程節點上具代表性的韓國無晶圓廠公司,而多數同業是在台積電製造,這種定位讓它與韓國的主權 AI 政策推動方向一致,而其成敗取決於三星 2 奈米的執行。Kim 已公開表達信心,認為 2 奈米良率可從 70% 出頭起步,並在一年內攀升至 80% 以上;這項說法將由 DX-M2 的量產爬坡來檢驗。
Chase's Take
邊緣 AI 市場不會由最好的晶片贏得。它會由讓整合商花費最少工程工時的晶片贏得。DeepX 的管理層清楚理解自己實際在賣什麼:不是處理器,而是別人物料清單上的一個項目。Advantech、AAEON 或 Lenovo 的買家,第一個問的不是「有多少 TOPS?」他們問的是「要把這個裝進我的機箱出貨,需要多少工作量,誰來支援?」DeepX 今年的每一項宣布,OpenVINO 整合、AWS 部署流程、與 Isaac 相容的機器人軟體、27 家經銷商,都是對第二個問題的回答。
這個框架也正確地為與超微的對談定價。它是一個選擇權,而不是資產:之所以有價值,是因為超微的開放生態系推動是真實的,且有政府支持;在技術範疇存在之前,它毫無價值。OpenVINO 的作業正好相反,它不光鮮、具體,而且瞄準 DeepX 現有英特爾架構設計導入中確切的摩擦點。如果要我排序什麼會推動 DeepX 2027 年的營收,那就是 OpenVINO 如期出貨、DX-M2 如期送樣,以及約 300 家評估中的公司轉化為採購訂單,依此順序。Kim 表示希望最遲在三年內完成的 IPO,是跟隨這三件事之後的里程碑,而不是它們的替代品。
影響與意涵
- 對裝置 OEM 與整合商而言: 一個低於 5W、低於 100 美元的推論選項,鎖定已經在使用的軟體堆疊,英特爾架構工業電腦用的 OpenVINO、雲端訓練模型部署用的 AWS,降低了在邊緣嘗試非輝達加速器的轉換成本。
- 對韓國的 AI 晶片政策而言: 主權 AI 計畫正在產生通路順風,而不只是補貼。超微圓桌會議的形式,平台持有者、政府召集人、在地新創公司,將成為衡量其他平台公司的範本。
- 對邊緣 NPU 競爭者而言: 貨架空間就是競賽。全球邊緣對手爭奪的是同一份 OpenVINO 裝置清單、同樣的工業電腦平台、同樣的經銷商。工具鏈的存在感正成為先決條件,而非差異化因素。
- 對投資人而言: 問題從「晶片能不能贏得設計導入?」轉移,77 筆採購訂單說明它能,轉向「在 2 奈米世代重置賽局之前,設計導入能不能複合累積成平台鎖定?」D 輪的執行與 2027 年初的 OpenVINO 成果,是接下來的兩個檢核點。
| 平台 / 夥伴 | 內容 | 狀態 / 時程 |
|---|---|---|
| OpenVINO (Intel) | 將 DX-M1 加入 OpenVINO,成為可選擇的推論裝置 | 初步成果預計明年初; 正式夥伴關係宣布在其後 |
| AMD | 10 月 7 日首爾圓桌會議(執行長 Lisa Su 出席)後的工作層級洽談 | 僅為方向確認; 尚無已宣布的技術合作或 ROCm 整合承諾 |
| AWS | 讓雲端訓練的模型可部署到 DeepX 裝置的軟體工作 | 已完成 |
| NVIDIA Isaac | 與 Isaac 平台相容的機器人軟體 | 規劃於年內 |
| DX-M2 (三星晶圓代工 2nm) | 目標最高 80 TOPS 的次世代晶片 | 2026 年 10 月流片; 首批晶片 2027 年 3–4 月 |
FAQ
Q: DeepX 到底把什麼整合進英特爾的 OpenVINO? A: DeepX 正把自家 NPU 作為可選的推論處理器,加入英特爾的部署工具包 OpenVINO,並提供模型最佳化與開發者工具支援。初步成果預計明年初出爐,公司計畫在成果出爐後正式宣布合作夥伴關係。目前,在英特爾架構工業電腦中使用 DeepX 晶片,需要手動安裝並連接 DeepX 的軟體。
Q: DeepX 正在與超微合作嗎? A: 還沒有。2026 年 10 月 7 日在首爾與超微執行長 Lisa Su 舉行圓桌會議後,雙方展開了工作層級對談,超微的技術團隊已以電子郵件跟進。執行長 Kim Nok-won 形容這個階段是在確認方向。尚未宣布技術合作或共同產品,儘管結合超微系統與 DeepX NPU 的產品已經透過經銷商 Avnet 銷售。
Q: DX-M1 與即將推出的 DX-M2 規格為何? A: DX-M1 採用三星晶圓代工 5 奈米製程,在 3–5W 下提供最高 25 TOPS,自 2025 年 8 月起量產。DX-M2 採用三星 2 奈米製程,於 2026 年 10 月投片,首批晶片預計 2027 年 3 月至 4 月出爐,量產目標訂在 2027 年稍晚;DeepX 目標是在相近的低功耗範圍內達到最高 80 TOPS。
Q: DeepX 何時上市? A: 目前沒有訂定日期。Kim 表示,他希望最遲在三年內完成 IPO,並形容這是成為全球產業領導者的工具與里程碑。公司先前曾表示,會先考慮在韓國國內上市。
註:上文引用的訂單、營收與良率數字,皆為公司在訪談與簡報中揭露的資料,尚未經獨立查核。
📩 訂閱 VLSI Korea 電子報
每日半導體深度分析,第一時間寄到您的信箱。免費訂閱。