VLSI Korea
Vera Rubin 量產的數學:一座機櫃 = 576 顆 HBM4、100 萬顆 GPU = 30 萬片晶圓 (台積電・SK 海力士・三星・美光)
Vera Rubin 已進入全面量產。一座機櫃消耗 576 顆 HBM4 與約 21.5 片晶圓,100 萬顆 GPU 需要約 30 萬片晶圓。決定 2027 年上限的不是 GPU,而是 HBM4。本文以數字完整拆解台積電、SK 海力士、三星與美光的供應地圖與良率假設。


一句話結論 — 決定 Vera Rubin 生產速度的不是 GPU,而是 HBM4 的位元數。在一座機櫃就消耗 576 顆 HBM4 堆疊與 21 片以上晶圓的結構下,2027 年產能爬坡的上限,是由記憶體製造商的晶圓畫定的。
30 秒摘要
- 2026 年 10 月 21 日,在 GTC Berlin 主題演講中,執行長黃仁勳宣布 Vera Rubin「已進入全面量產」。節點組裝時間從 Grace Blackwell 的 2 小時降至 5 分鐘以內,冷卻則是 100% 液冷。
- 一座 NVL72 機櫃內含 72 顆 Rubin GPU、36 顆 Vera CPU,以及 576 顆 HBM4 堆疊(20.7 TB = 165,888 Gb)。每顆 GPU 的 HBM4 為八顆 36 GB 12 層堆疊,合計 288 GB(2,304 Gb)。
- 數量僅存在於估算之中。市場目前的基準情境是 2026 年下半年 5,000–7,000 座機櫃(供應鏈估算),以及 2027 年 11,000–21,000 座機櫃(80 萬–150 萬顆 GPU)。
- 換算為晶圓,每顆 GPU 消耗 0.037 片邏輯晶圓 + 0.143 片 CoWoS 晶圓 + 0.118 片 HBM DRAM 晶圓,合計約 0.30 片。100 萬顆 GPU 就意味著約 30 萬片晶圓。
- 瓶頸判定:第一是 HBM4(2026 年產量實質上已被分配完畢、有分配下修的報導、2027 年合約價 outlook 陡峭上揚);第二是 CoWoS。邏輯晶圓與機櫃組裝都不是限制。
1. 柏林宣言 — 先看已確認的事實
2026 年 10 月 21 日,黃仁勳在 GTC Berlin 主題演講中舉起 Vera Rubin 節點,確認了三件事。第一,Vera Rubin 已進入全面量產。第二,節點組裝時間從 Grace Blackwell 世代的 2 小時降至 5 分鐘以內 — 這是拿掉纜線與線材的成果。第三,冷卻為 100% 液冷,高於前一世代的 80% 液冷,冷卻液入口溫度為 45°C。
量產本身並不是新聞。NVIDIA 在 2026 年 1 月的 CES 上宣布進入生產,並在 5 月 31 日的 GTC Taipei 發布中定下秋季開始量產出貨。6 月 1 日,雲端業者 CoreWeave 完成首座 NVL72 機櫃的上線,並確認實際運作。柏林所確認的是,「量產中」現在意味的是全面爬坡,而不是樣品與早期機台。黃仁勳也提到,Vera Rubin 背後有 150 家台灣供應鏈夥伴。
本文用數字拆解這項宣言:會打造多少套系統、一座機櫃裡裝了什麼、各有多少、這些數量換算成多少片晶圓,以及哪家公司供應什麼、供應多少。來自官方揭露與報導的數字都標明來源;由計算推導的數字則標示為估算並揭露其假設。
2. 一座機櫃的解剖 — NVL72 內部
Vera Rubin 的銷售單位不是一顆 GPU 晶片,而是一座機櫃。一座 NVL72 由 18 個運算托盤與 9 個 NVLink 交換托盤組成,72 顆 GPU 由 NVLink 6 架構連結,行為就像一顆巨大的加速器。
| 元件 | 數量 / 規格 | 備註 |
|---|---|---|
| Rubin GPU | 72 | 每顆 GPU 3,360 億個電晶體(兩顆晶粒),台積電 3nm |
| Vera CPU | 36 | 88 核心 Arm,透過 NVLink-C2C 與 GPU 相連 |
| HBM4 | 576 顆堆疊,20.7 TB | 每顆 GPU 8 顆堆疊 × 36 GB |
| LPDDR5X(供 CPU 使用) | 最高 54 TB | 每顆 CPU 最高 1.5 TB,SOCAMM2 模組(依券商分析) |
| NVLink 6 架構 | 每座機櫃 260 TB/s | 每顆 GPU 3.6 TB/s |
| 網路 | ConnectX-9 NIC、BlueField-4 DPU | 透過 Spectrum-X 乙太網路進行橫向擴展 |
| 冷卻 | 100% 液冷 | 冷卻液入口 45°C |
| 功耗 | 約 190–230 kW | 供應鏈估算 |
| 機櫃價格 | 500 萬–780 萬美元 | 2026 年 3 月報導與券商物料清單分析 |
來源:NVIDIA 公布的 NVL72 規格、GTC Berlin 2026 主題演講報導(2026 年 10 月 21 日)、券商物料清單分析。
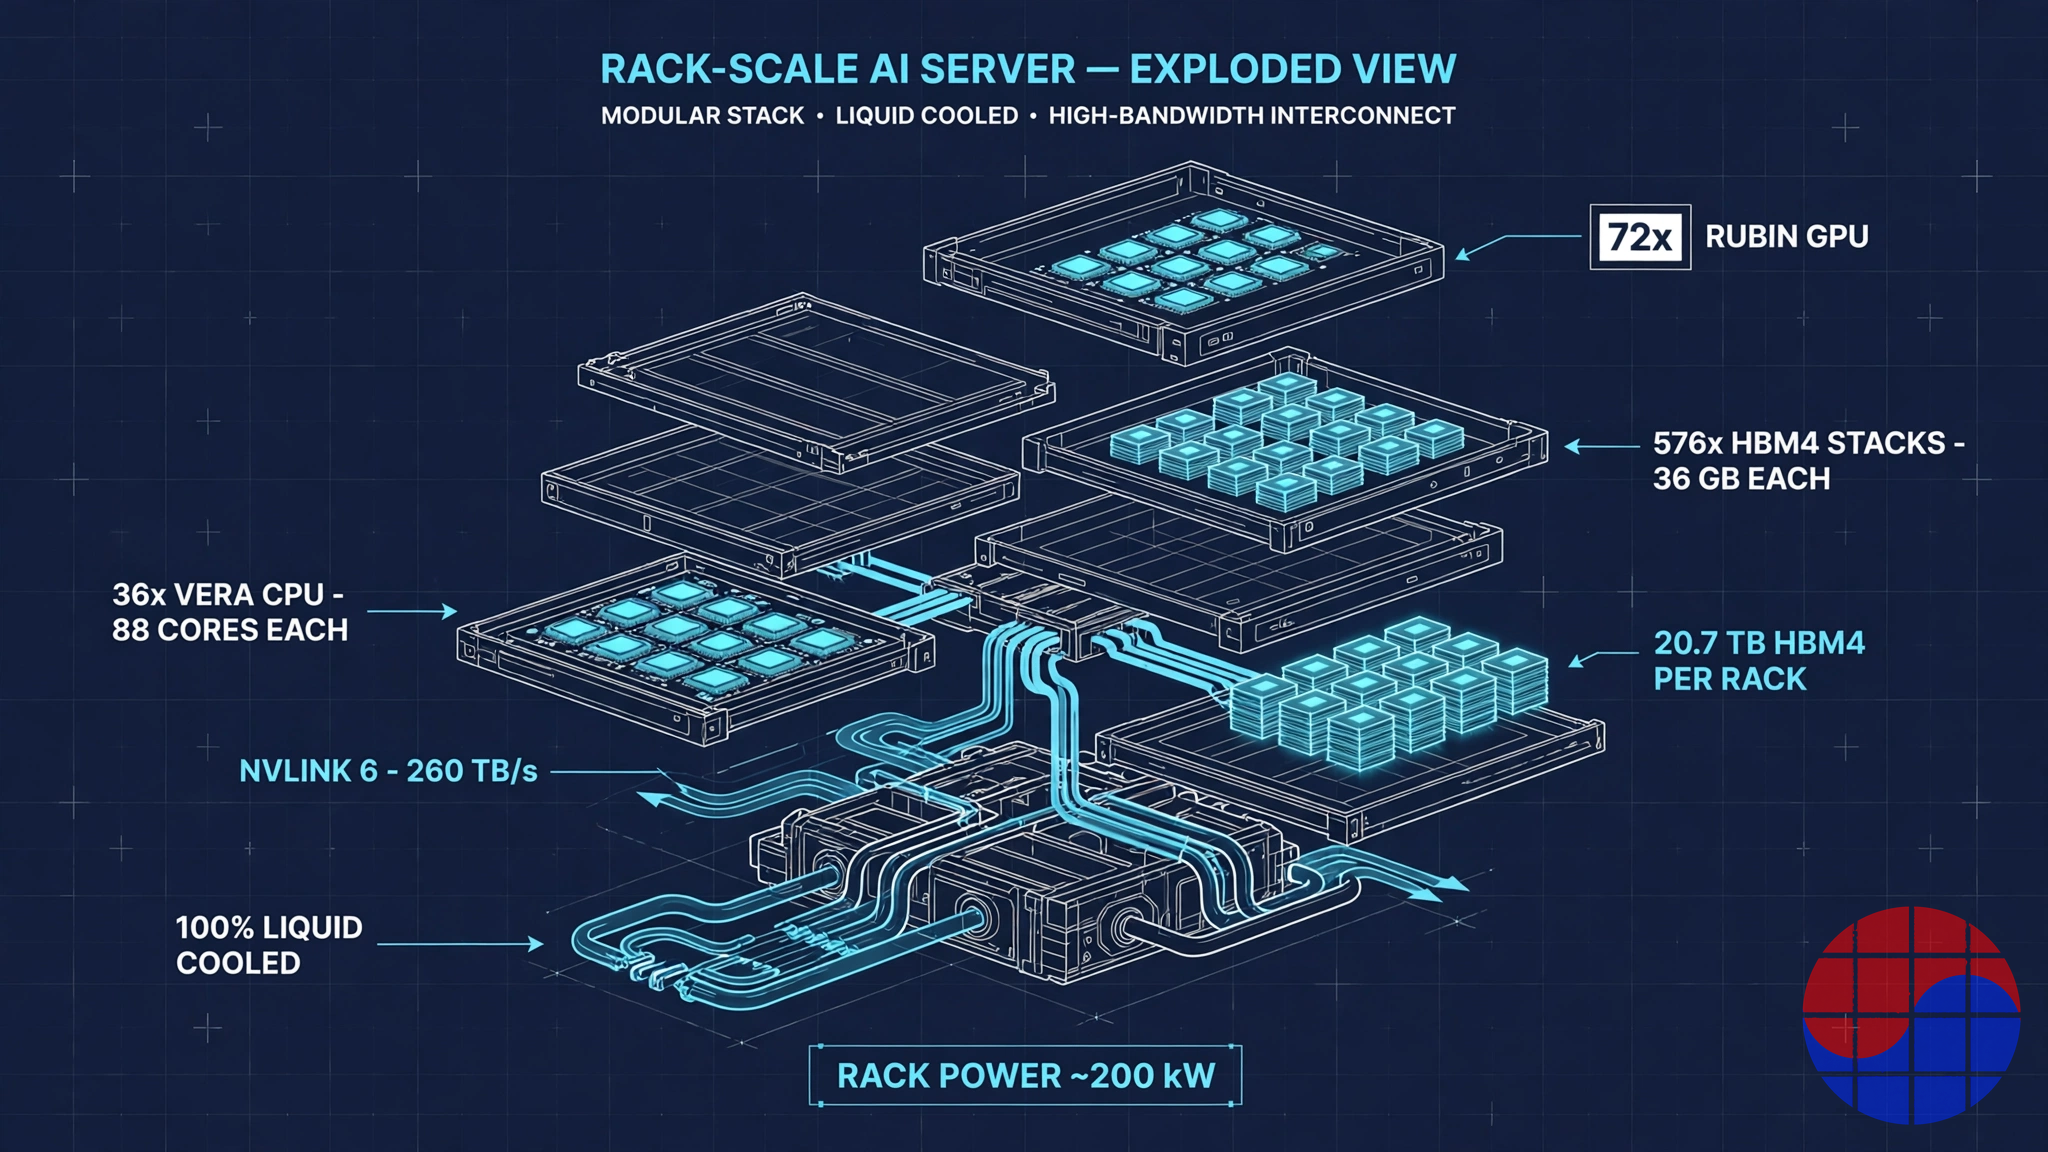
Vera Rubin NVL72 機櫃的解剖 — 一座機櫃內含 72 顆 GPU 與 576 顆 HBM4 堆疊。 Source: VLSI Korea
HBM4 的算術
這個平台在本質上是一套記憶體系統。把一顆 GPU 的 HBM4 用位元拆開來看:
| 項目 | 數值 | 算式 |
|---|---|---|
| 一顆 HBM4 堆疊 | 36 GB(288 Gb) | 堆疊十二顆 24 Gb 晶粒 |
| 每顆 GPU 的堆疊數 | 8 | NVIDIA 規格 |
| 每顆 GPU 的 HBM4 | 288 GB(2,304 Gb) | 8 × 36 GB |
| 每顆 GPU 的頻寬 | 22 TB/s | NVIDIA 規格 |
| 每座機櫃的堆疊數 | 576 | 72 × 8 |
| 每座機櫃的 HBM4 | 20.7 TB(165,888 Gb) | 72 × 288 GB |
| 每座機櫃的 HBM DRAM 晶粒數 | 6,912 | 576 顆堆疊 × 12 顆晶粒 |
與 Blackwell 相比,每顆 GPU 的 HBM 容量從 192 GB 提升到 288 GB,成長 1.5 倍,頻寬從 8 TB/s 提升到 22 TB/s,成長 2.75 倍。堆疊數量維持在八顆,但每顆堆疊從 24 GB 成長到 36 GB,引腳速度也提高。對生產而言,關鍵在於容量的全部增量,都以額外的 DRAM 晶圓來計價:每顆堆疊需要十二顆 24 Gb 晶粒,若計入晶粒良率,實際的晶圓消耗還會更高。
3. 會打造多少 — 數量情境
NVIDIA 並未揭露 Rubin 的出貨台數。市場上流通的每一個數字都是估算,本文只採用估算方法透明者。
反推 1:從營收反推
以 NVIDIA 的財測與高階主管評論為基礎的市場討論,設想 Vera Rubin 每季貢獻約 200 億美元營收的運行水準。以報導的機櫃價格區間(500 萬–780 萬美元)相除,得到每季 2,550–3,975 座機櫃,年化約 10,000–16,000 座機櫃。請注意,這個反推假設 Rubin 的全部營收都來自 NVL72 機櫃,因此是偏上限的參考值 — 實際上還混有板卡與模組層級的銷售,以及並行的 Blackwell 營收。
反推 2:供應鏈估算
追蹤台灣供應鏈的分析師將 2026 年下半年 VR200 機櫃出貨量估為 5,000–7,000 座(報導為郭明錤的估算),換算為 360,000–500,000 顆 GPU。另有並行的市場共識,在納入 HBM4 分配下修的報導後,將 2026 年 Rubin GPU 總量估為 250,000–350,000 顆。至於規模放大的 2027 年,基準情境為 80 萬–150 萬顆 GPU(11,000–21,000 座機櫃)。業界估算也預期,NVL72 級機櫃整體(GB300 + VR200 + VR300)出貨在 2027 年將年增超過 50%,其中 VR200 佔比最大。
| 期間 | 機櫃(估算) | GPU(估算) | HBM4 堆疊(估算) | 依據 |
|---|---|---|---|---|
| 2026 年下半年 | 3,500–7,000 | 25 萬–50 萬 | 200 萬–400 萬 | 供應鏈估算;秋季開始出貨 |
| 爬坡高峰的每季 | 2,550–3,975 | 18 萬–29 萬 | 147 萬–229 萬 | 由約 200 億美元季度營收反推 |
| 2027 年 | 11,000–21,000 | 80 萬–150 萬 | 640 萬–1,200 萬 | 基準情境區間 |
本表中的每一個數字都是估算,不是已確認的數字。已確認的是量產本身,以及秋季開始出貨。
換算為 HBM4 位元,圖像的規模就不同了。即使是 2027 年基準情境的低端(80 萬顆 GPU),也需要 230 PB(230,400 TB)的 HBM4;高端(150 萬顆 GPU)則達到 432 PB。單一平台就吸收了全球 HBM 總產量的相當大一部分。
4. 晶圓換算 — 一顆 GPU = 0.30 片晶圓
把數量換算成晶圓,就能看出瓶頸在哪裡。下面的模型是我們自行建立的,所有假設都完整揭露;請把輸出視為區間來解讀。
假設
| 晶圓種類 | 假設 | 結果 |
|---|---|---|
| 邏輯(台積電 3nm) | 晶粒面積約 800 mm² × 2(接近 858 mm² 的光罩極限),每片 300 mm 晶圓約 65 顆總晶粒,晶粒良率 85% | 每片晶圓約 55 顆良品晶粒 = 約 27 顆 GPU |
| CoWoS 封裝 | 封裝面積約 4,700 mm²(2026 年的 5.5 倍光罩級別),每片晶圓 6–8 個封裝 | 每片晶圓約 7 顆 GPU |
| HBM4 DRAM | 24 Gb 晶粒約 60 mm²,每片晶圓約 1,090 顆總晶粒,KGD/堆疊有效良率 75% | 每片晶圓約 820 顆晶粒 = 約 8.5 顆 GPU |
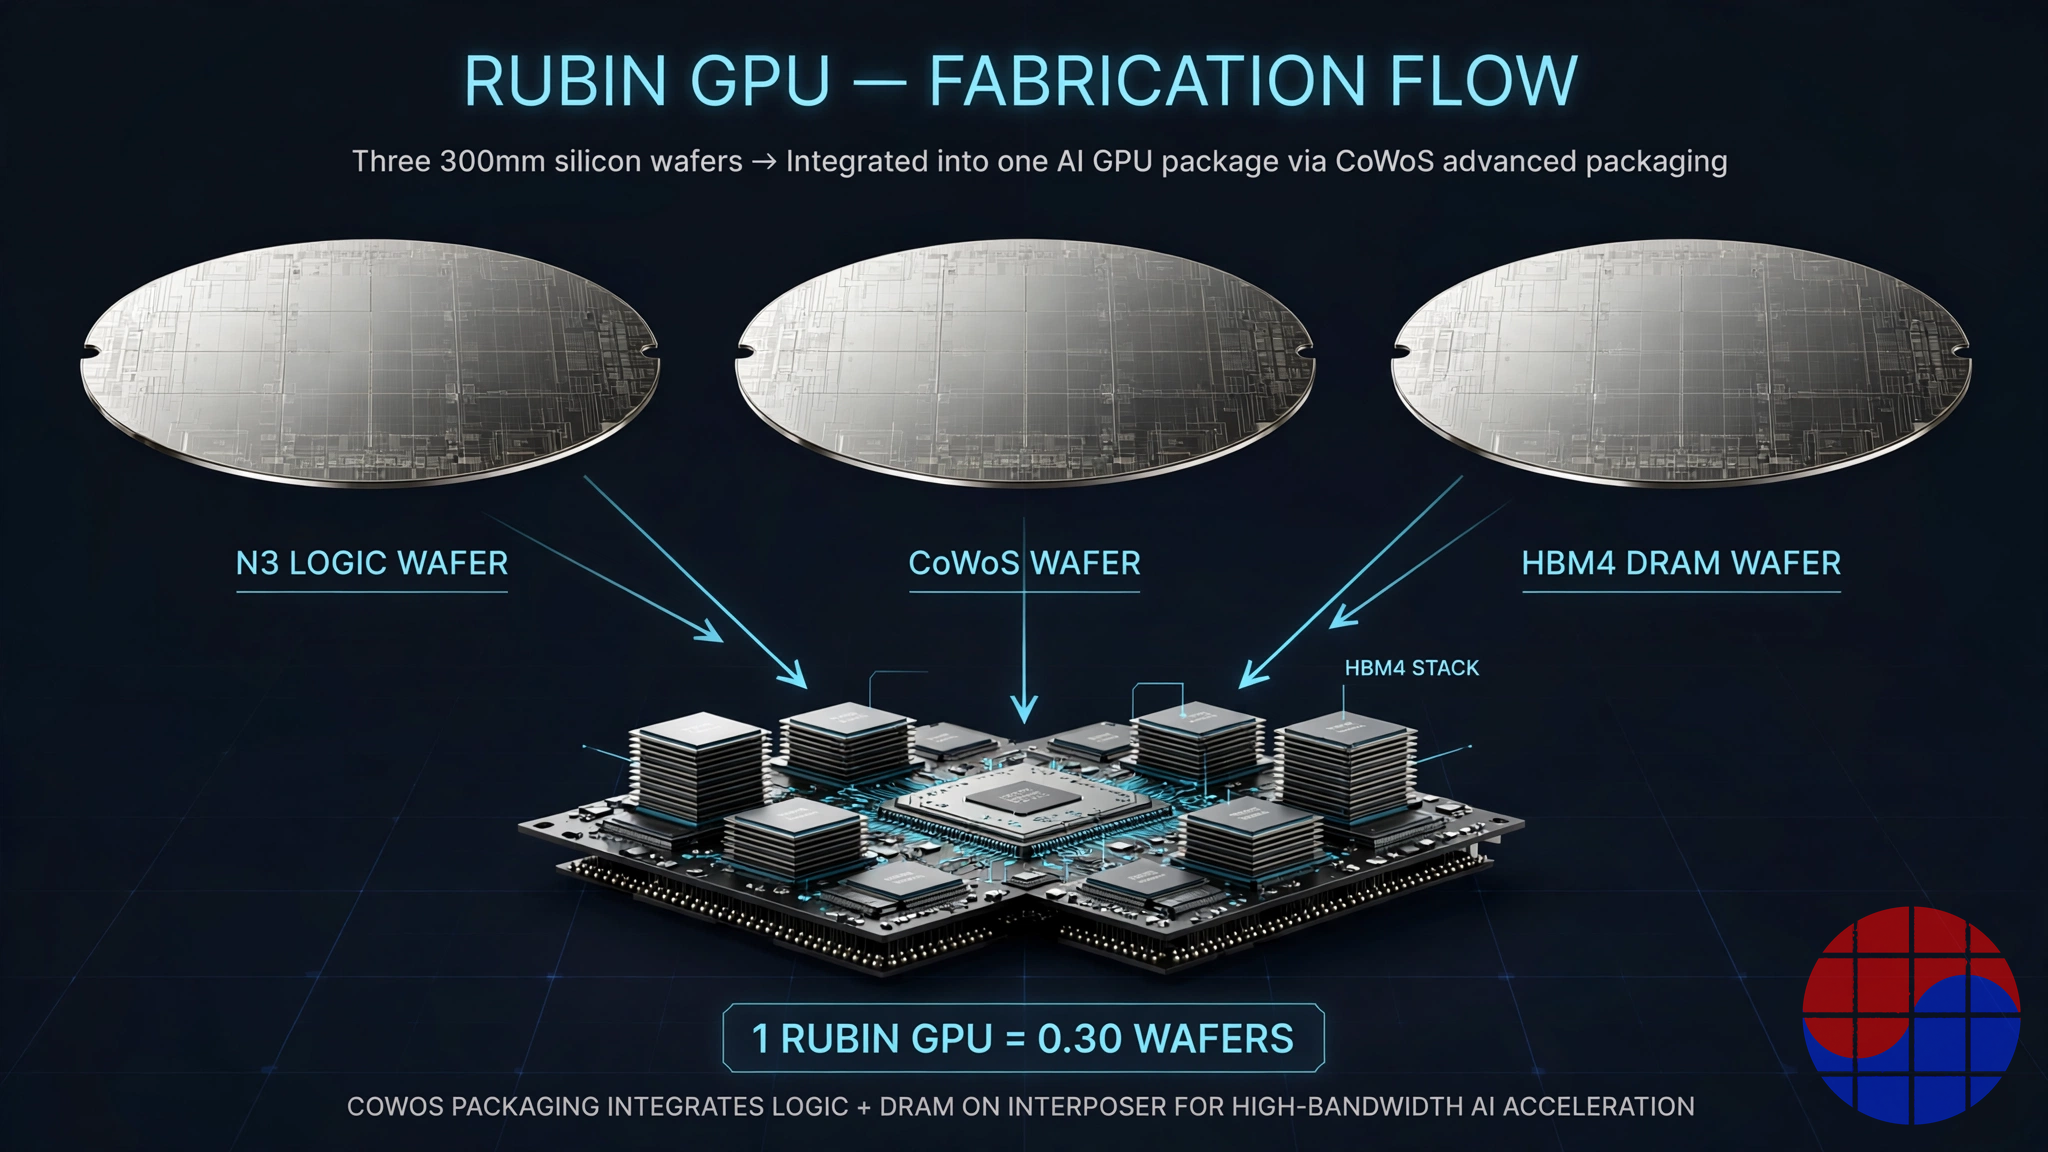
一顆 GPU 所消耗的三種晶圓 — 邏輯、CoWoS 與 HBM DRAM。 Source: VLSI Korea
換算結果
| 類別 | 每顆 GPU | 每座機櫃(72 顆 GPU) | 2027 年(80 萬–150 萬顆 GPU) |
|---|---|---|---|
| 邏輯晶圓(3nm) | 0.037 | 約 2.7 | 3.0 萬–5.6 萬 |
| CoWoS 晶圓 | 0.143 | 約 10.3 | 11.4 萬–21.4 萬 |
| HBM4 DRAM 晶圓 | 0.118 | 約 8.5 | 9.4 萬–17.6 萬 |
| 合計 | 約 0.30 | 約 21.5 | 約 24 萬–45 萬 |
結論毫不含糊。打造 100 萬顆 GPU,需要三種晶圓合計約 30 萬片,其中接近 90% 是封裝(CoWoS)與記憶體(DRAM)晶圓。純邏輯晶圓只佔總量約 12%。報導同樣指出,前四大 AI 晶片設計商只消耗約 12% 的先進製程邏輯產出 — 這正是邏輯晶圓廠不是 AI 爬坡限制的原因。
與供給對照:台積電的 CoWoS 到 2026 年底估計達到每月 12 萬–15 萬片,加上 OSAT 夥伴的產能,業界總量接近每月約 20 萬片。據報導,NVIDIA 已預訂台積電 2026 年 CoWoS 產能的約 60%。Rubin 在 2027 年的 CoWoS 需求(每年 11.4 萬–21.4 萬片),僅佔台積電年產能的個位數百分比,因此即使與 Blackwell 共享,算術上也成立 — 問題在於封裝的成長:隨著封裝面積擴大,每片晶圓能放的封裝數下降,擴產不斷被面積吃掉。
5. 供應商地圖 — 誰供應什麼、供應多少
一座 Vera Rubin 機櫃背後,站著數百家供應商,包括黃仁勳提到的 150 家台灣夥伴。核心地圖如下:
| 公司 | 供應項目 | 數量 / 角色 |
|---|---|---|
| 台積電 | 3nm GPU 晶粒、CoWoS-L 封裝 | 全部 GPU 晶粒。據報導,輝達已預訂 2026 年 CoWoS 產能的約 60% |
| SK 海力士 | HBM4、SOCAMM2 LPDDR5X | HBM4 初始分配的 50% 中段區間(報導)。12 層堆疊 36 GB 堆疊;為 Vera CPU 展示 SOCAMM2 |
| 三星電子 | HBM4 | 初始分配的 20% 中段區間(報導)。1c DRAM + 4nm 基礎裸晶;最快規格為每顆堆疊最高 3.0 TB/s、11.7 Gbps。HBM4E 樣品瞄準 Rubin Ultra |
| 美光 | HBM4 | 初始分配的約 20%(報導)。36 GB 12 層堆疊自 2026 年第一季起大量出貨;每顆堆疊超過 2.8 TB/s |
| Ibiden、Shinko、Unimicron、Nan Ya PCB | ABF 載板 | 供 5.5 倍光罩級封裝使用的增層載板;載板面積就是產能 |
| 日月光、艾克爾 | 後段(CoWoS 溢出) | 估計新增每月 5 萬–6 萬片的 OSAT 產能,吸收台積電的溢出 |
| 鴻海、廣達、緯創、英業達 | 機櫃組裝與整合 | 鴻海被指為最大的組裝商;5 分鐘節點設計決定了產出速度 |
| Dell、HPE、Lenovo、Supermicro、GIGABYTE | 系統交付 | 將完整機櫃交付給雲端服務供應商與企業 |
| Vertiv、Schneider Electric、Delta | 電力與冷卻 | 供約 200 kW 機櫃使用的 CDU 與電源;DSX POD 夥伴 |
| 輝達(自有) | ConnectX-9、BlueField-4、NVLink 交換器、Spectrum-X Photonics | 自有物料清單佔比上升 — 輝達在機櫃營收中的份額每一代都在成長 |
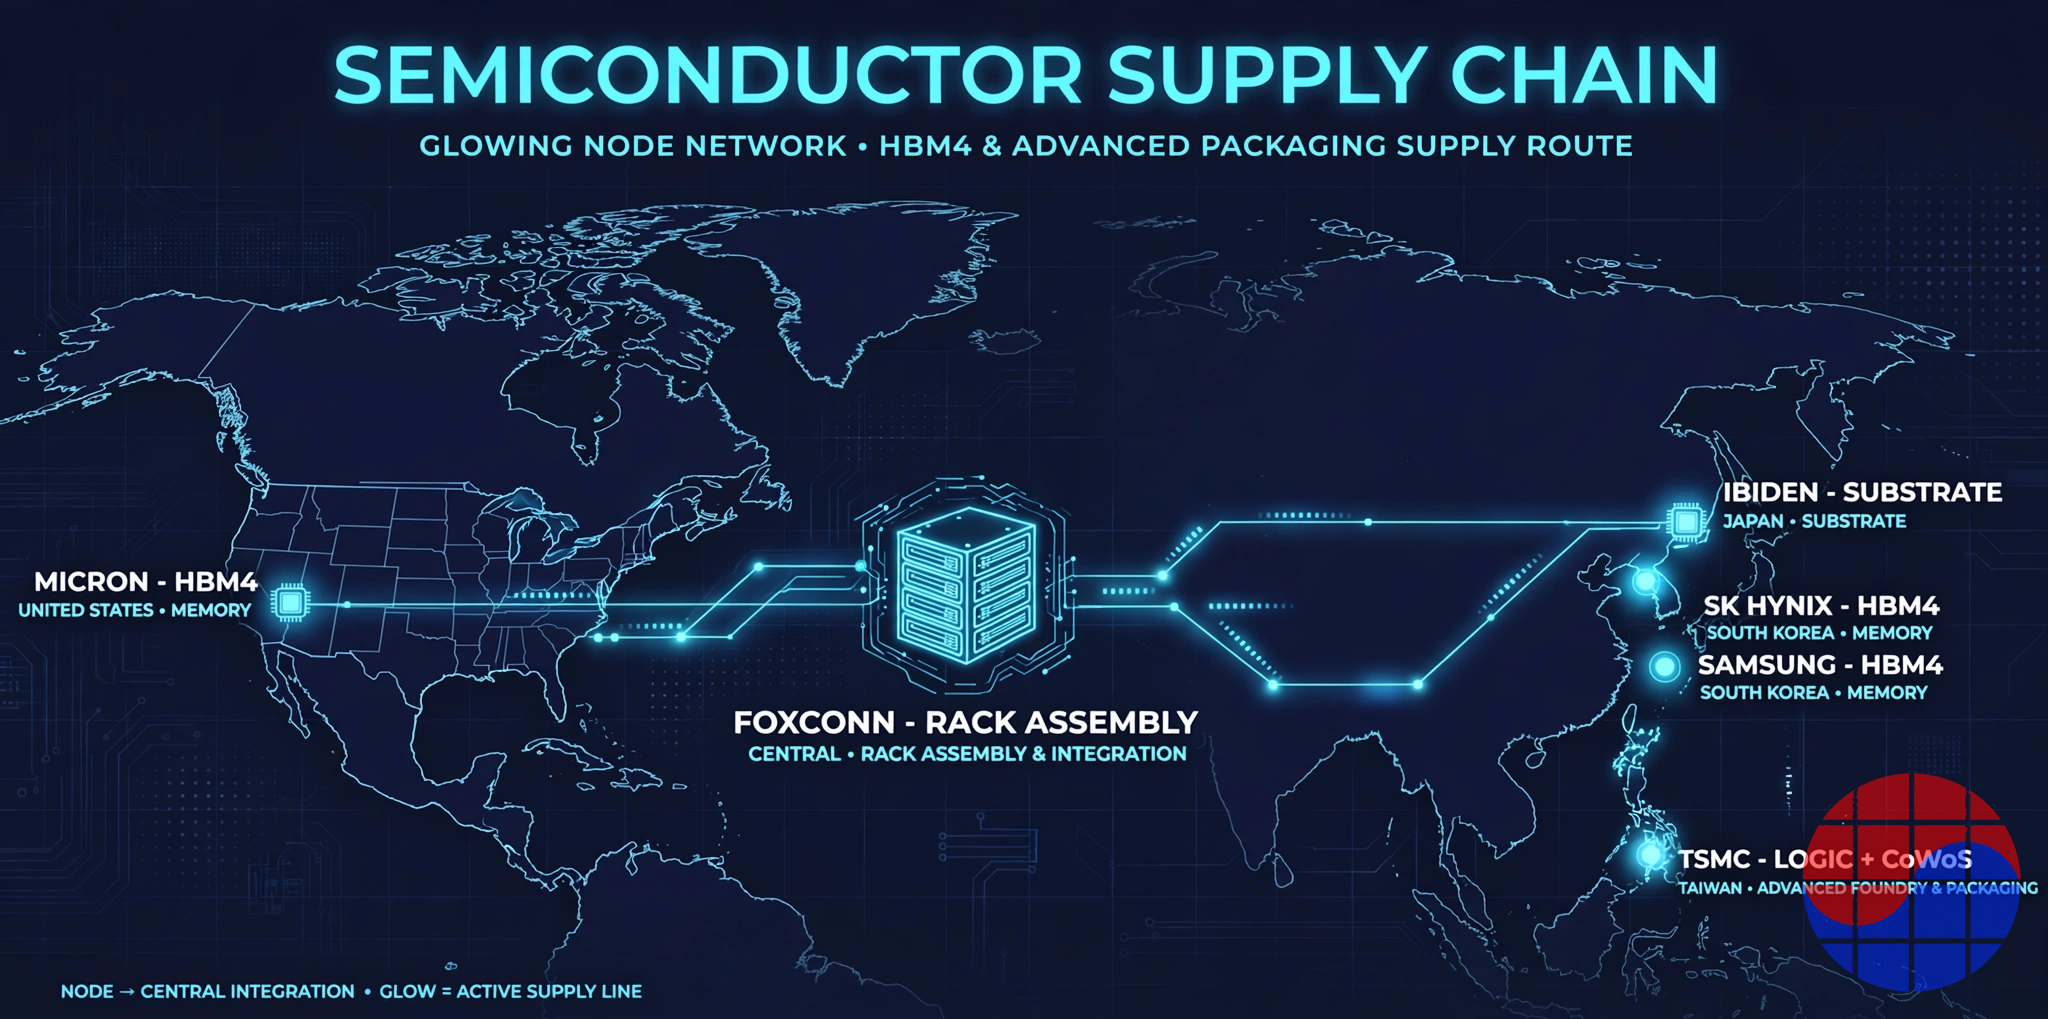
Vera Rubin 供應鏈 — 邏輯與封裝在台灣,HBM4 由韓國與美國分攤,載板在日本。 Source: VLSI Korea
HBM4 的分配,依據的是 2025 年末輝達數量分配的報導:SK 海力士最大,處於 50% 中段區間,三星電子處於 20% 中段區間,美光約為 20%。這個比例並非固定。三星電子在 2026 年 2 月開始業界首批 HBM4 量產出貨,並在速度規格上領先,而 4 月的報導指出,在爬坡時程的考量下,SK 海力士曾考慮將 2026 年對輝達的 HBM4 出貨下修 20–30% — 這是一種每季分配都可能變動的結構。
機櫃組裝的經濟學也改變了。隨著節點組裝從 2 小時降到 5 分鐘,組裝產能不再是人力問題,而是零件到貨的問題。對組裝商而言,Vera Rubin 是一座以零件到貨速度出貨的機櫃 — 也就是說,HBM4 與完成的 CoWoS 封裝決定了產線的利用率。我們關於輝達模組化 AI 工廠設計的姊妹文章,Vera Rubin DSX POD 深度解析,探討的是部署速度;本文聚焦在會打造多少套系統,以及由多少片晶圓打造。
6. 瓶頸判定 — 到底是什麼在限制爬坡
| 製程 | 判定 | 證據 |
|---|---|---|
| HBM4 | 首要限制 | 2026 年產量實質上已售罄。有出貨下修評估的報導。12 層堆疊 36 GB 堆疊預計從 2026 年的約 600 美元,上漲到 2027 年的約 1,300 美元(合約價年增 +121% 的估算,報導) |
| CoWoS | 緊張,但可管理 | 產能在三年內成長約 8 倍,但封裝面積的成長抵銷了擴產。業界供需缺口 10–20% 的估算持續存在 |
| ABF 載板 | 需留意 | 直接受大型封裝面積成長影響;過去曾悄悄成為瓶頸 |
| 3nm 邏輯晶圓 | 不是限制 | 前四大 AI 設計商消耗約 12% 的先進製程邏輯產出(報導) |
| 機櫃組裝 | 不是限制 | 5 分鐘節點組裝、模組化設計;限制在於零件到貨 |
| 電力與場地 | 客戶端的限制 | 每座機櫃 190–230 kW;800VDC 轉換與液冷基礎設施是場地挑戰 |
結論很簡單。Vera Rubin 的生產函數寫作 min(HBM4 堆疊 ÷ 576、CoWoS 封裝 ÷ 72、邏輯晶粒 ÷ 144),而在 2026–2027 年決定最小值的,就是 HBM4。如果 Rubin 的營收在輝達的財報中未達財測,先懷疑 HBM4 的交付,而不是需求。反過來說,如果 HBM4 合約價在 2027 年真的接近翻倍,那正是記憶體三強開始收取其在這波爬坡中經濟份額的訊號。
Chase's Take
把所有數字都攤開來看,Vera Rubin 與其說是 GPU 產品,不如說是記憶體採購合約的物理形態。在一座機櫃 500 萬–780 萬美元的價格中,GPU 晶粒本身的晶圓成本佔比,比直覺所想的更小;資金與產能都被鎖在 576 顆 HBM4 堆疊與 CoWoS 面積之中。
從韓國的視角來看,要觀察的是分配的斜率。SK 海力士的 50% 中段區間,是 Blackwell 世代的延續,但三星電子的 20% 中段區間看起來像是捲土重來的下限 — 如果它的速度與 HBM4E 籌碼在 2027 年的分配重置中發揮作用,斜率就會改變。而決定這條斜率的,不是行銷,而是每一季的 KGD 良率與堆疊產出量。
最後,0.30 片晶圓這個數字值得記住。AI 加速器的競爭,現在同時是一場設計競賽,也是一場圍繞三種晶圓的分配競賽。台積電的藍圖指向下一世代的 HBM5 與 14 倍光罩級封裝,這說明這場分配競賽不會結束 — 只會變得更昂貴。
來源:NVIDIA 公布的規格與 GTC Berlin 2026 主題演講報導(2026 年 10 月 21 日)、韓國與國際供應鏈及財報報導、券商物料清單分析。數量與晶圓換算是我們在所述假設下的自行估算,可能與實際出貨不同。本文不構成投資建議。
FAQ
Q: 一座 Vera Rubin 機櫃裡有多少顆 HBM4 堆疊? A: 576 顆。每顆 GPU 搭載八顆 36 GB 12 層堆疊(288 GB),一座機櫃有 72 顆 GPU,因此 72 × 8 = 576 顆堆疊 — 合計 20.7 TB(165,888 Gb)。
Q: 2027 年會生產多少套 Vera Rubin 系統? A: 沒有已確認的數字。結合供應鏈估算與營收反推,2027 年的基準情境是 11,000–21,000 座機櫃,或 80 萬–150 萬顆 GPU。2026 年下半年估計約為 3,500–7,000 座機櫃。
Q: 打造一顆 GPU 需要多少片晶圓? A: 三種晶圓合計約 0.30 片:0.037 片 3nm 邏輯晶圓、0.143 片 CoWoS 晶圓,以及 0.118 片 HBM4 DRAM 晶圓 — 這是我們在本文揭露的假設(晶粒面積、良率、封裝面積)下的自行估算。每座機櫃約為 21.5 片。
Q: Vera Rubin 生產真正的瓶頸是什麼? A: HBM4。2026 年的產量實質上已被分配完畢,出貨下修評估的報導,以及 2027 年合約價陡峭上揚的展望,都支持這個判定。CoWoS 緊張但正在擴產;3nm 邏輯晶圓與機櫃組裝很難稱為限制。
Q: 哪些公司供應 HBM4,各自佔多少份額? A: 依 2025 年末的分配報導,SK 海力士處於 50% 中段區間,三星電子處於 20% 中段區間,美光約為 20%。三星電子帶來業界首批的量產出貨(2026 年 2 月)與最快的規格,SK 海力士帶來最大的分配與 SOCAMM2,美光則自 2026 年第一季起大量出貨 — 而分配可以逐季調整。
📩 訂閱 VLSI Korea 電子報
每日半導體深度分析,第一時間寄到您的信箱。免費訂閱。