VLSI Korea
NVIDIA Vera CPU 深度分析 — 比88核更重要的1.2TB/s内存带宽
Vera每个插槽提供1.5TB SOCAMM2 LPDDR5X和1.2TB/s带宽,每核约13.6GB/s。分析与Grace和EPYC Turin的比较、厂商说法的局限,以及三星电子、SK海力士、美光之间的SOCAMM2竞争。


TL;DR
- NVIDIA Vera是搭载88个Armv9.2-A兼容定制Olympus核心的数据中心CPU,于2025年3月在GTC上与Vera Rubin平台一同发布,架构细节已通过2026年7月NVIDIA公开资料得到确认(NVIDIA架构公开,2026年7月)。
- 核心数字不是核心数量。单个Vera插槽支持最高1.5TB SOCAMM2 LPDDR5X和最高1.2TB/s内存带宽,按简单除法计算每核约13.6GB/s(NVIDIA架构公开,2026年7月;基于公开数字计算,2026年10月20日)。
- 每核带宽约为前代Grace的1.8倍,约为按12通道DDR5-6400计算的128核AMD EPYC Turin旗舰配置计算值的2.8倍(基于厂商规格计算,2026年10月20日)。
- NVIDIA声称在AI相关工作负载中IPC最高可达Turin的1.9倍,但这是厂商说法,迄今公开的合作伙伴基准测试并未公开完整设置和TDP(NVIDIA公开,2026年7月)。
- 战略变化在于每个插槽的内存搭载量。Vera在单个插槽上搭载了Grace 3倍的容量,因此CPU插槽将成为三星电子、SK海力士、美光之间LPDDR5X供应竞争的舞台(NVIDIA架构公开,2026年7月)。
背景
过去20年,数据中心CPU营销大多是核心数量的竞争。其逻辑是,核心越多,虚拟机越多、容器越多、每机架线程也越多。在通用工作负载主要受计算吞吐量限制的时代,这句话是对的。但在智能体AI时代,这一逻辑正在变弱。AI系统的CPU不再只是在GPU旁边等待的主机。它要协调工具调用,准备和移动数据,执行检索和排序阶段,处理网络和存储流量,并在数据迟到时向会立即停滞的加速器供应数据。
NVIDIA凭借Grace进入了这一市场。Grace是一款配备72个Arm Neoverse V2核心、最高480GB LPDDR5X和546GB/s内存带宽的CPU(依据在2026年7月Vera公开之前发布的NVIDIA Grace规格)。Grace证明了Arm CPU可以站在NVIDIA机架的中心。同时,它也暴露了下一个瓶颈。随着GPU系统越来越快,主机CPU需要更大的内存容量、每线程更多的带宽,以及与GPU更快速的一致性连接。
Vera就是对这一问题的回答。它于2025年3月在GTC上作为Vera Rubin平台的一部分发布,细节在2026年7月的架构公开中披露(GTC,2025年3月;NVIDIA架构公开,2026年7月)。Vera放弃了授权的Neoverse设计,改为88个定制Olympus核心。据NVIDIA称,它通过Spatial Multithreading提供176个线程,并配备单片计算芯片、每核2MB L2、164MB L3和第二代Scalable Coherency Fabric(NVIDIA架构公开,2026年7月)。
核心周边的平台数字也很重要。Vera提供用于一致性CPU-GPU通信的1.8TB/s NVLink-C2C、PCIe Gen6、CXL 3.1,TDP可设置为250~450W(NVIDIA架构公开,2026年7月)。由2个Vera组成的Superchip提供176个核心、352个线程、16个SOCAMM2模块、合计2.4TB/s内存带宽和3TB内存。配备128个Superchip的机架参考设计可达到22,528个核心和384TB内存(NVIDIA架构公开,2026年7月)。单独CPU销售和向早期客户出货已由2026年的报道传出,因此本文中关于可用性的表述均按报道标准标注,而非NVIDIA直接确认的出货(行业报道,2026年)。
深度解析1:内存系统 — 每个插槽1.5TB与1.2TB/s
定义Vera的选择是内存系统。单个插槽支持最高9,600MT/s SOCAMM2 LPDDR5X、最高1.5TB,从而提供最高1.2TB/s内存带宽(NVIDIA架构公开,2026年7月)。SOCAMM2是NVIDIA主导的插槽型LPDDR模块规格。与焊接式LPDDR不同,插槽型模块可根据系统设计进行配置、更换和扩展,同时保留LPDDR5X相对于普通DDR5服务器内存的能效优势。
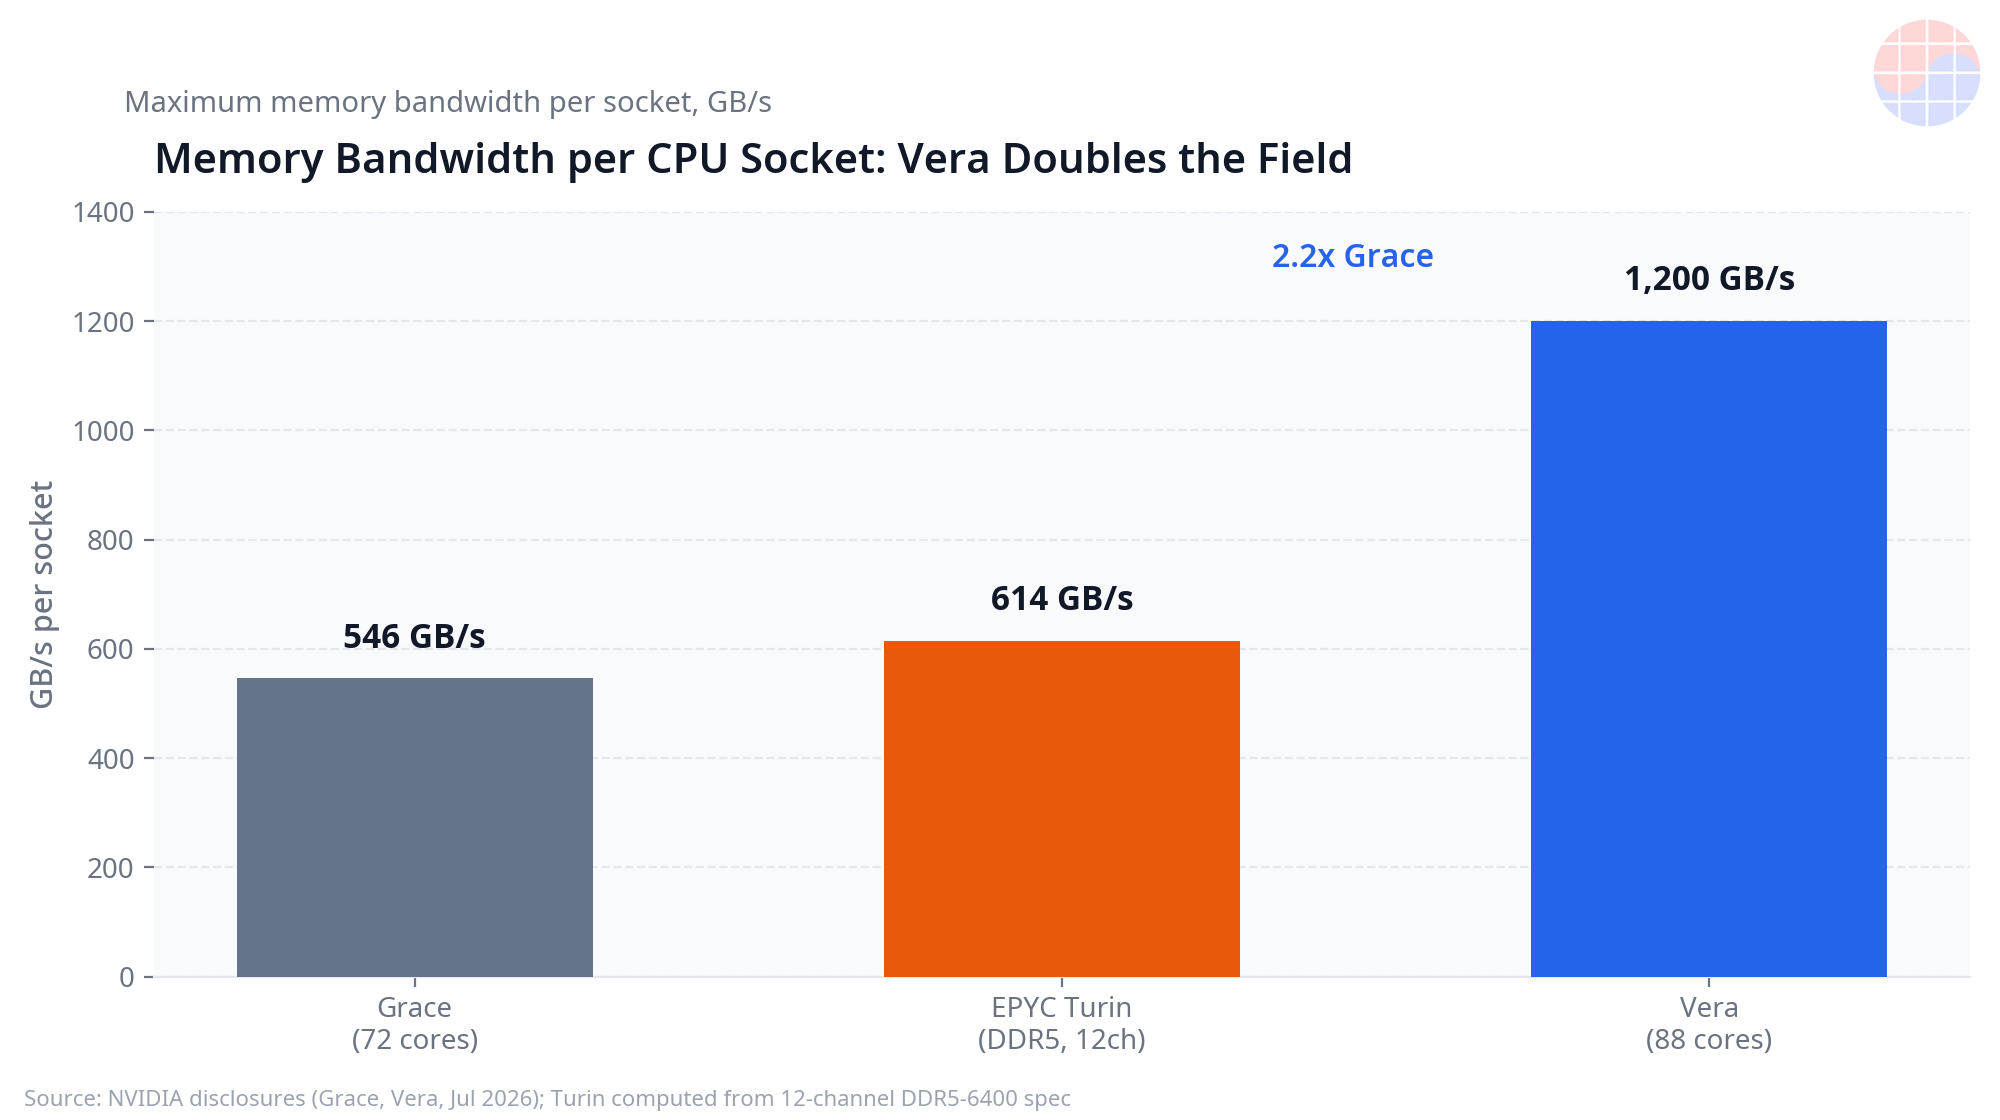
与Grace相比,可以看到一代的跨越幅度。Grace每个插槽提供最高480GB LPDDR5X和546GB/s带宽(NVIDIA Grace规格)。Vera将容量扩大3倍至1.5TB,将带宽提升约2.2倍至1,200GB/s(NVIDIA架构公开,2026年7月;计算,2026年10月20日)。在实际应用中,Vera插槽可以在本地内存中容纳更大的工作集。这意味着可以准备更大的键值缓存、更大的嵌入表、更多的并发智能体会话,以及更多供GPU消费的数据,而不会掉落到较慢的存储或远程内存。
容量和带宽必须同时提升。如果只有容量大而带宽不足,核心会在拥挤的内存路径上等待。如果只有带宽大而容量不足,则会频繁发生驱逐和重新获取。Vera的设计点——1.5TB和1.2TB/s——瞄准的是许多线程同时触及庞大且不断变化的数据集的工作负载。检索流水线、特征服务、向量搜索预处理、数据加载,以及围绕大规模模型推理的控制逻辑,都正好符合这一特征,与传统的整数运算基准测试相距甚远。
供应链层面的结果也存在。插槽型LPDDR5X模块规格创造了一个可更换的标准内存内容单元,供系统构建商大批量采购。如果单个插槽搭载的不是480GB而是1.5TB,那么在计算连接到GPU的HBM之前,仅连接到CPU的LPDDR5X内容就能让一台Vera系统的内存搭载量翻倍。第4节将讨论这一点对三星电子、SK海力士、美光意味着什么。
深度解析2:每核带宽与x86比较
如果内存带宽跟不上,核心数量就会产生误导。将插槽带宽除以核心数量,可以得到当所有核心都繁忙时单个核心可使用的内存吞吐量的大致指标。Vera以1,200GB/s除以88个核心,每核约13.6GB/s,与NVIDIA标注的每核约14GB/s一致(NVIDIA架构公开,2026年7月;计算,2026年10月20日)。Grace以546GB/s除以72个核心,每核约7.6GB/s。
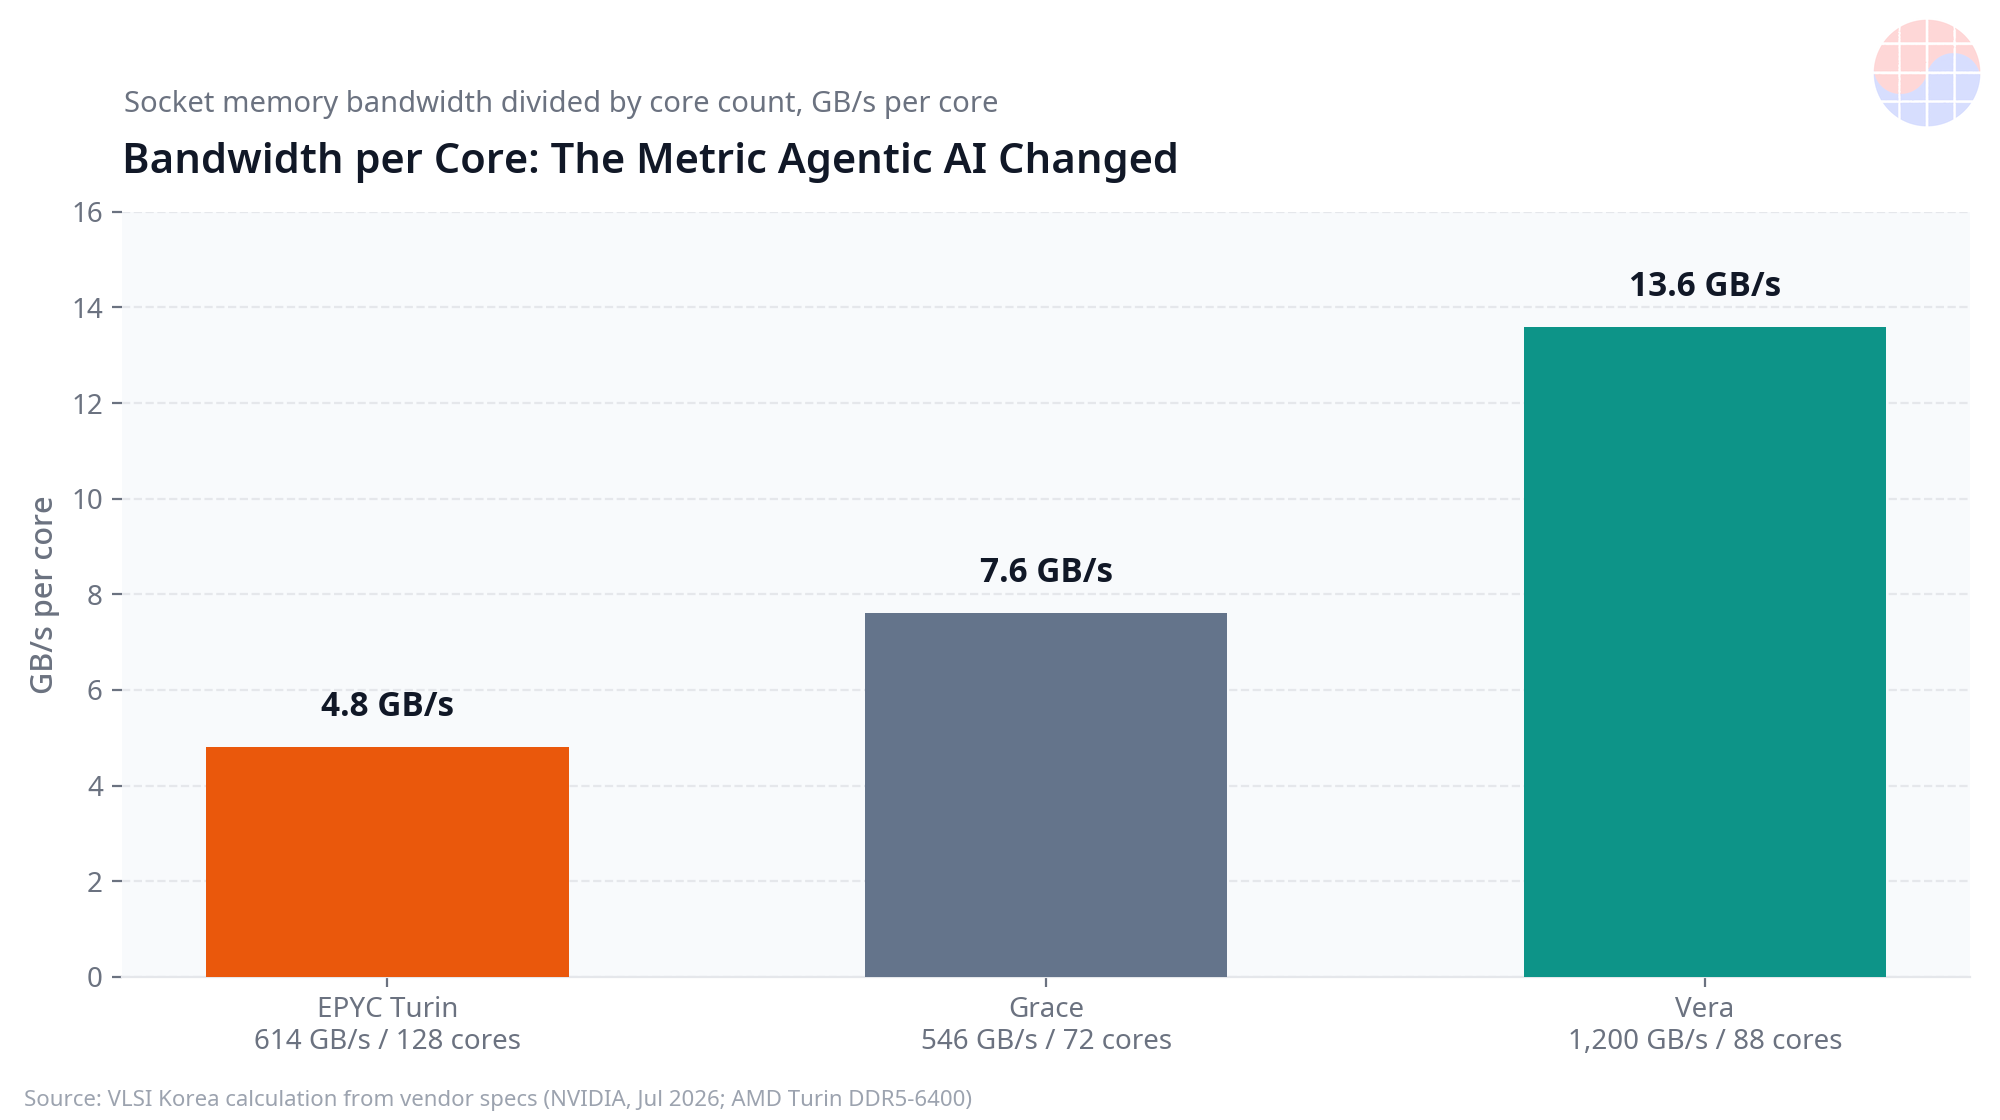
与x86的比较需要透明的方法论。使用12通道DDR5-6400的AMD EPYC Turin系统的理论最大值是按12通道 × 6,400MT/s × 每次传输8字节计算出的614GB/s(基于AMD EPYC Turin内存规格计算,2026年10月20日)。将其除以128核旗舰配置,每核约4.8GB/s。在这一比较的所有平台上,实际持续带宽都低于理论最大值,因此这些数字应理解为基于规格的比率,而不是实测的应用结果。
按这一标准,Vera提供的每核带宽约为该Turin配置的2.8倍、Grace的1.8倍(计算,2026年10月20日)。这是NVIDIA主张中最有力的部分。智能体工作负载和数据密集型工作负载往往会运行许多对数据进行流式处理、过滤和转换的线程。如果每核带宽较低,即使增加核心,也只是共享固定的内存管道,效果会停滞。如果每核带宽较高,线程扩展能持续有效的范围就更长。
NVIDIA还声称在AI相关工作负载中,IPC最高可达EPYC Turin的1.9倍(厂商说法,NVIDIA公开,2026年7月)。这一说法应谨慎对待。IPC在很大程度上取决于工作负载、编译器和指令组合,而Arm定制核心与x86核心执行的指令流并不相同。这一说法展示了NVIDIA为更宽、更高效的核心供应更多带宽的设计意图,但它不是独立测量值,若要用于采购决策,应等待设置公开、可复现的基准测试。
深度解析3:Olympus核心、一致性与Superchip
Vera的88个Olympus核心是Armv9.2-A兼容的定制设计,相比Grace授权的Neoverse V2核心又迈进了一步(NVIDIA架构公开,2026年7月)。直接拥有核心设计,可以根据NVIDIA机架系统实际运行的工作负载,调整向量吞吐量、分支行为和缓存层级。每核2MB L2、整个芯片164MB L3这些数字也很重要,因为缓存越大,线程在主内存上等待的频率就越低(NVIDIA架构公开,2026年7月)。
Spatial Multithreading将暴露的线程数翻倍至每个插槽176个(NVIDIA架构公开,2026年7月)。只有当内存系统能够喂饱额外线程时,线程翻倍才有效果。因此,1.2TB/s这一数字和线程数不应理解为两个独立的规格,而应理解为同一个设计决定。
第二个轴是一致性。Vera的第二代Scalable Coherency Fabric和1.8TB/s NVLink-C2C使CPU和GPU能够以远超普通PCIe链路的速度一致性地共享数据(NVIDIA架构公开,2026年7月)。Vera还支持PCIe Gen6和CXL 3.1,可连接普通加速器、网络适配器和内存扩展设备(NVIDIA架构公开,2026年7月)。在AI机架中,一致性共享可减少显式复制开销。CPU准备的数据结构可由GPU直接消费,中间结果也可以减少由软件管理的传输来移动。
Superchip配置扩展了同样的思路。2个Vera CPU提供176个核心、352个线程、2.4TB/s内存带宽,并通过16个SOCAMM2模块提供3TB内存(NVIDIA架构公开,2026年7月)。在机架规模上,以128个Superchip为基准的22,528个核心和384TB内存这一参考总量表明,NVIDIA将CPU层设计为面向智能体集群和数据流水线的池化基础设施,而不仅仅是辅助GPU的最小配置(NVIDIA架构公开,2026年7月)。
功耗可在TDP 250~450W范围内设置(NVIDIA架构公开,2026年7月)。这一范围对所有基准测试的解读都很重要。450W的结果和250W的结果说明的是不同的工作点,未注明设置的比较是不完整的。
深度解析4:诚实的局限 — 基准测试、x86的应对、单片成本
需要直接指出的局限有三个。第一,公开的基准测试依据单薄。包括与Redpanda相关的流式数据结果在内的合作伙伴结果,都是在未完整公开设置和TDP的情况下发布的(合作伙伴基准测试发布,2026年)。如果没有测试时的核心数量、内存配置、固件和功耗设置,外部读者既无法复现这些数字,也无法判断比较是否公平。NVIDIA最高1.9倍IPC的主张也具有同样的地位。在通过公开方法进行的独立测试确认之前,它只是厂商说法(NVIDIA公开,2026年7月)。
第二,x86厂商并未停滞不前。服务器平台正在向更快的DDR5、提高每通道有效带宽的MRDIMM内存,以及增加内存通道的新一代平台迈进。MRDIMM和下一代x86平台将从上文所用的614GB/s规格基准线出发,缩小每核带宽差距,尤其是在以核心数量换取带宽的配置中。Vera的优势在截至2026年10月20日公开的规格中确实存在,但这只是一个时间点的优势,并非永久的结构性差距。
第三,Vera的单片计算芯片存在成本结构。大型单片芯片通常比小芯片设计更难获得良率经济性,因为小芯片设计可以只丢弃有缺陷的小芯片,并将正常芯片复用于多种产品(一般半导体制造原则,2026年10月20日表述)。NVIDIA并未公开Vera的良率或单位成本,因此本文不作具体的成本主张。这是一个方向性的指出。有利于延迟和一致性的设计选择也会集中制造风险,价格将反映这一点。
最后,硬件优势中有多少能在实际运营中保留下来,将由软件决定。尽管Arm生态系统在企业工具、可观测性和遗留中间件方面的成熟度已有改善,但对于拥有大规模x86资产的运营者来说,迁移成本依然真实存在。带宽在基准测试中取胜,总拥有成本在采购订单中取胜。
Chase的观点
重要的变化不是NVIDIA制造了一款88核CPU这一事实,而是瓶颈已经移动这一事实。在智能体AI系统中,CPU负责编排:规划循环、工具调用、检索、为长上下文进行的内存管理,以及在存储、网络和GPU之间移动数据。这类工作线程多、内存使用量大。受限资源通常不是峰值浮点吞吐量,而是每个线程在不排在其他所有线程后面等待的情况下,能以多快的速度触及多少数据。Vera正是为这一现实而设计的:先于核心数量的是每核带宽和每个插槽的内存容量。
从商业角度看,SOCAMM2可能比Olympus核心更重要。通过为CPU插槽定义插槽型LPDDR5X模块,NVIDIA将主机内存变成了标准化的大批量内容插槽。Vera每个插槽搭载1.5TB,相对于Grace的480GB,搭载了3倍的内存内容(NVIDIA架构公开,2026年7月)。采用Vera的机架将从供应链中拉取相应多得多的LPDDR5X。
因此,CPU插槽将成为内存内容竞争的舞台。三星电子、SK海力士、美光都在LPDDR5X供应上竞争,而获得大批量平台NVIDIA平台的资格,其价值超过单个设计订单,因为它能锁定出货量、价格谈判力和在下一次模块修订中的位置。对韩国供应商而言,这具有特别的意义。因为LPDDR领导地位历来是韩国的强项,而SOCAMM2为这一强项新开了一个超越智能手机的服务器端出口。在首尔读到的Vera故事,一半是CPU的故事,另一半是谁在销售环绕CPU的内存的故事。
我的判断是这样的。Vera应以在真实智能体工作负载中交付的每核带宽来评价,而不是以88核这一标题,也不是以设置未公开的基准测试来评价。即使独立测试只确认了规格优势的大部分,施加在x86路线图上的压力——扩大通道、采用MRDIMM、按带宽等级减少核心数量——也将成为Vera已经改变市场的最明确信号。
影响
- AI系统采购方: 应以自身的智能体、检索和数据加载工作负载为基准,评估每个插槽的每核带宽和内存容量,并要求所有厂商基准测试公开TDP和内存配置(依据:NVIDIA架构公开,2026年7月)。
- x86平台规划: 规格差距——Vera每核约13.6GB/s对比按DDR5-6400计算的128核Turin配置每核约4.8GB/s——使MRDIMM和通道扩大设计不再是选择,而是路线图优先事项(计算,2026年10月20日)。
- 内存供应商: SOCAMM2将CPU侧的LPDDR5X内容提升至每个插槽1.5TB、为Grace的3倍,因此三星电子、SK海力士、美光将争夺一个更大、更具战略意义的插槽(NVIDIA架构公开,2026年7月)。
- 运营者: 迁移成本、软件生态系统适配性和单片芯片价格可能会抵消一部分硬件优势。比起头条IPC主张,总拥有成本测试更重要。
- CPU市场: 如果智能体工作负载继续增长,每核带宽将与核心数量并列成为首要采购标准,而只主打核心的CPU营销将很快过时。
本文基于2025年3月和2026年7月NVIDIA公开资料以及截至2026年10月20日的规格计算,厂商性能数字均标注为厂商说法,未经独立验证。
FAQ
Q1. 什么是NVIDIA Vera CPU,它是什么时候发布的? Vera是NVIDIA的数据中心CPU,配备88个Armv9.2-A兼容定制Olympus核心和按Spatial Multithreading计算的176个线程。它于2025年3月在GTC上与Vera Rubin平台一同发布,NVIDIA于2026年7月公开了详细的架构资料。
Q2. Vera每个插槽提供多少内存带宽和容量? 单个Vera插槽支持最高9,600MT/s SOCAMM2 LPDDR5X、最高1.5TB,以及最高1.2TB/s内存带宽,按88个核心计算每核约13.6GB/s(NVIDIA架构公开,2026年7月)。
Q3. 按每核带宽标准,Vera与Grace及AMD EPYC Turin相比如何? Grace以72个核心提供546GB/s,每核约7.6GB/s。按12通道DDR5-6400计算的128核EPYC Turin配置理论上为614GB/s,每核约4.8GB/s。Vera每核约13.6GB/s,按规格计算约为Grace的1.8倍、该Turin配置的约2.8倍(计算,2026年10月20日)。
Q4. Vera的主要局限和未解问题是什么? 相对于Turin最高1.9倍IPC这一NVIDIA数字是厂商说法,Redpanda等合作伙伴基准测试未公开完整设置和TDP,x86平台正以MRDIMM和下一代内存设计应对,而Vera的单片芯片的制造成本可能高于小芯片替代方案。仍然需要方法公开的独立基准测试(截至2026年10月20日)。
📩 今天错过的分析,明天早上发到您的邮箱
每天10:30(KST)Daily Silicon与财报·机构报告核心解读抢先送达。订阅后可选择韩语/英语/日语新闻通讯,中文深度分析每日在网站更新。
免费订阅 →
免费 · 无垃圾邮件 · 随时退订