 VLSI Korea
d-Matrix y sus 2.000 millones: por qué el mercado paga por calcular dentro de la memoria
d-Matrix cerró en noviembre de 2025 una Serie C de 275 millones con una valoración de 2.000 millones. Corsair calcula dentro de la SRAM a 150 TB/s por tarjeta. Analizamos la física, la economía de la SRAM, la hoja de ruta 3DIMC de Raptor y qué debe ser verdad para sostener la valoración.


🆓 Artículo gratuito · Cualquiera puede leerlo gratis
Resumen en 30 segundos
d-Matrix vale 2.000 millones de dólares porque vende lo único que escasea en la economía de la inferencia: ancho de banda de memoria que no sale del chip. La startup de Santa Clara cerró el 12 de noviembre de 2025 una ronda Serie C de 275 millones de dólares con una valoración de 2.000 millones, lo que eleva su financiación total a 450 millones. Su acelerador Corsair calcula dentro de la SRAM —Digital In-Memory Computing, o DIMC— y declara 150 TB/s de ancho de banda en el chip por tarjeta, hasta 30.000 tokens por segundo en Llama 70B a 2 ms por token, y una eficiencia energética de 3 a 5 veces superior a la de los sistemas basados en GPU. Corsair entró en producción plena en junio de 2026. Los 2.000 millones no pagan los ingresos de hoy: pagan una opción, la de que cuando la inferencia sea el coste dominante de la IA, la arquitectura ganadora será la que trate la memoria, y no la aritmética, como el producto.
| Concepto | Detalle |
|---|---|
| Valoración | US$2.000 millones (Serie C, 12 nov 2025) |
| Financiación total | US$450 millones |
| Producto | Corsair (DIMC, TSMC 6 nm) |
| Cómputo | 2.400 TFLOPS (8 bits) |
| Memoria en chip | 2 GB SRAM, 150 TB/s |
| Memoria externa | Hasta 256 GB LPDDR5 |
| Próxima generación | Raptor / 3DIMC (tape-out previsto a finales de 2026) |
Background: una empresa fundada para la segunda mitad de la IA
d-Matrix fue fundada en 2019 en Santa Clara, California, por Sid Sheth (CEO) y Sudeep Bhoja (CTO). La apuesta fundacional no estaba de moda: el entrenamiento no seguiría siendo el cuello de botella de la IA. Una vez entrenados, los modelos deben responder preguntas de forma continua, a escala y para usuarios que pagan. Esa fase de servicio, la inferencia, se convertiría en el mayor coste del sector. La empresa pasó seis años construyendo para esa fase antes de que el mercado le diera la razón.
El historial de financiación refleja cómo la tesis fue ganando creyentes. Una ronda de 110 millones de dólares en 2023 incorporó a M12, el fondo de capital riesgo de Microsoft. La Serie C de noviembre de 2025 fue coliderada por BullhoundCapital, Triatomic Capital y Temasek, con nueva participación de la Qatar Investment Authority (QIA) y de EDBI de Singapur, y capital de seguimiento de M12, Nautilus Venture Partners, Industry Ventures y Mirae Asset. La financiación total llegó a 450 millones de dólares y la plantilla superó las 250 personas entre Santa Clara, Toronto, Sídney, Bangalore y Belgrado.
El momento importa. A finales de 2025, los hiperescaladores estaban desplazando públicamente su gasto de capital desde los clústeres de entrenamiento hacia las flotas de inferencia, y la pregunta central del sector pasó de «¿cuán rápido podemos entrenar?» a «¿cuánto cuesta cada token?». d-Matrix es una de las pocas startups que diseñó su silicio desde el primer día para la segunda pregunta. La valoración de 2.000 millones de una empresa de chips aún sin escala debe leerse sobre ese fondo.
Business Deep Dive
El producto: calcular donde viven los pesos
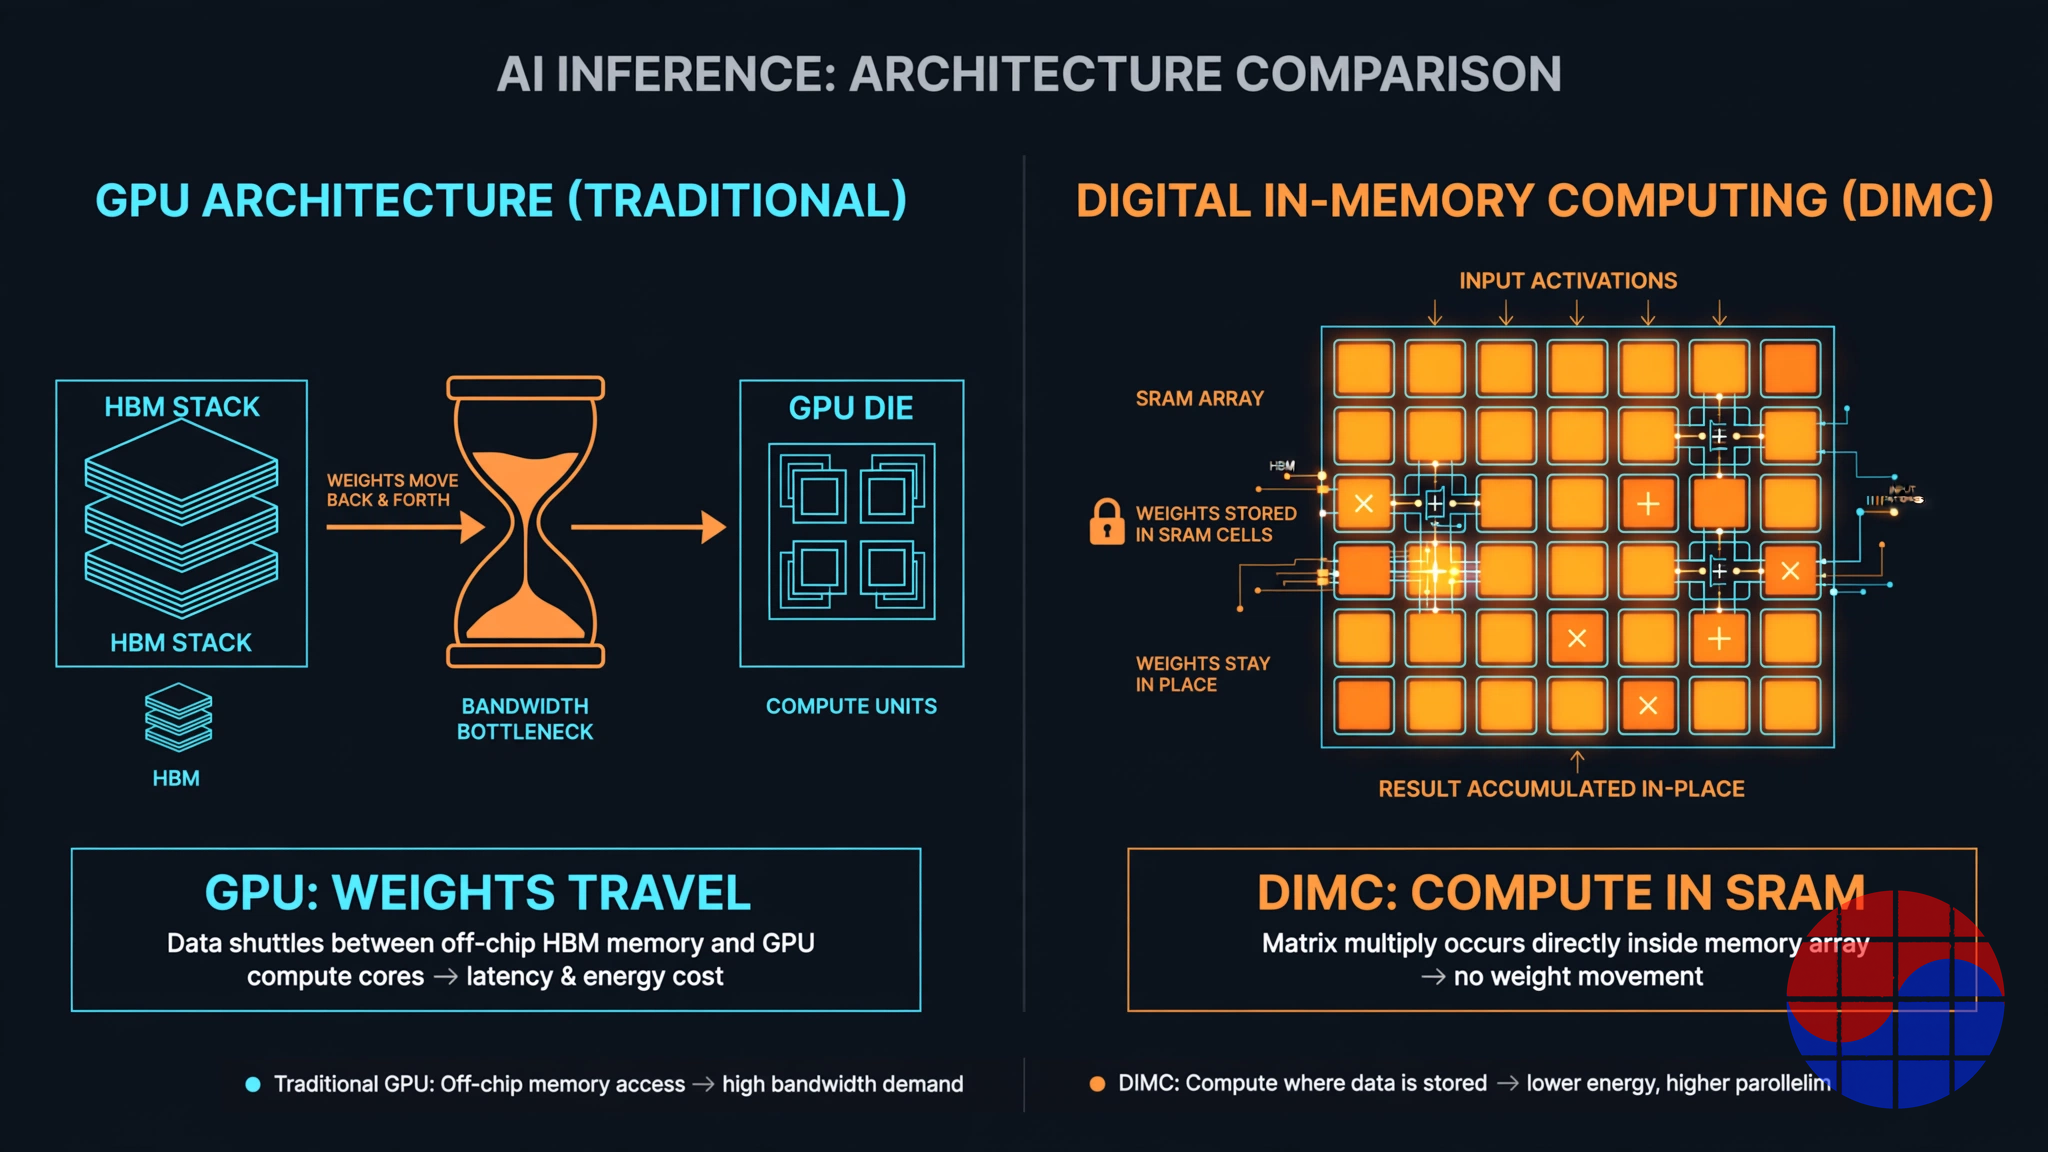
La inferencia en fase de decodificación está limitada por la memoria. Generar cada token exige leer los pesos del modelo, y una GPU dedica gran parte de su tiempo y energía a mover esos pesos entre las pilas HBM y las unidades de cálculo. Corsair ataca el movimiento en sí. Sus núcleos DIMC ejecutan las operaciones matriciales dentro de las matrices SRAM: los pesos no viajan hasta donde se calcula, se calculan donde están.
Las cifras de la tarjeta en producción definen el intercambio. Cada tarjeta Corsair, fabricada en el proceso de 6 nm de TSMC en formato estándar PCIe Gen5, ofrece 2.400 TFLOPS de cálculo pico de 8 bits, 2 GB de Performance Memory en el chip (SRAM) a 150 TB/s, y hasta 256 GB de Capacity Memory LPDDR5 fuera del chip. Comparado con HBM: una pila HBM3e de última generación entrega alrededor de 1,2 TB/s por pila, y un paquete GPU completo suma del orden de 8 TB/s. Los 150 TB/s de Corsair son ancho de banda SRAM dentro del chip, no del paquete: una magnitud distinta, y la comparación favorece a d-Matrix. Pero la dirección es real: en decodificación de lotes pequeños y sensible a la latencia, mantener los pesos en SRAM elimina el viaje de ida y vuelta que domina la latencia de token de una GPU.
Lo que el dinero de la Serie C compra en realidad es la plataforma alrededor del chip. Las NIC JetStream conectan tarjetas y racks con baja latencia. La pila de software Aviator compila modelos escritos en PyTorch y Triton sobre el tejido DIMC. SquadRack, una arquitectura de rack de referencia construida con Arista, Broadcom y Supermicro, convierte las tarjetas en sistemas desplegables, y los clústeres Squadron, anunciados como disponibles en general en octubre de 2026, escalan hasta 1.024 XPU Corsair en 16 racks dentro de centros de datos estándar con refrigeración por aire. Corsair entró en producción plena en junio de 2026, con envíos en volumen dirigidos a hiperescaladores, neoclouds y laboratorios de IA de frontera. En abril de 2026 la empresa adquirió además el negocio de centros de datos de GigaIO, sumando el tejido de memoria FabreX y los diseños de sistema SuperNODE.
El techo de la SRAM, y por qué existe Raptor
La fortaleza de la arquitectura es también su techo. La SRAM es rápida y ruinosa por bit. Los 2 GB de Performance Memory de Corsair no pueden contener un modelo de 70B; el resto vive en la LPDDR5 Capacity Memory, y el rendimiento real depende de lo bien que Aviator reparta el trabajo entre los dos niveles. La SRAM tampoco se reduce como la lógica: en nodos avanzados su densidad mejora despacio, de modo que una hoja de ruta de SRAM pura encarece cada generación el coste por capacidad de generación de tokens. Es la pregunta de economía de proceso que toda startup de computación en memoria debe responder.
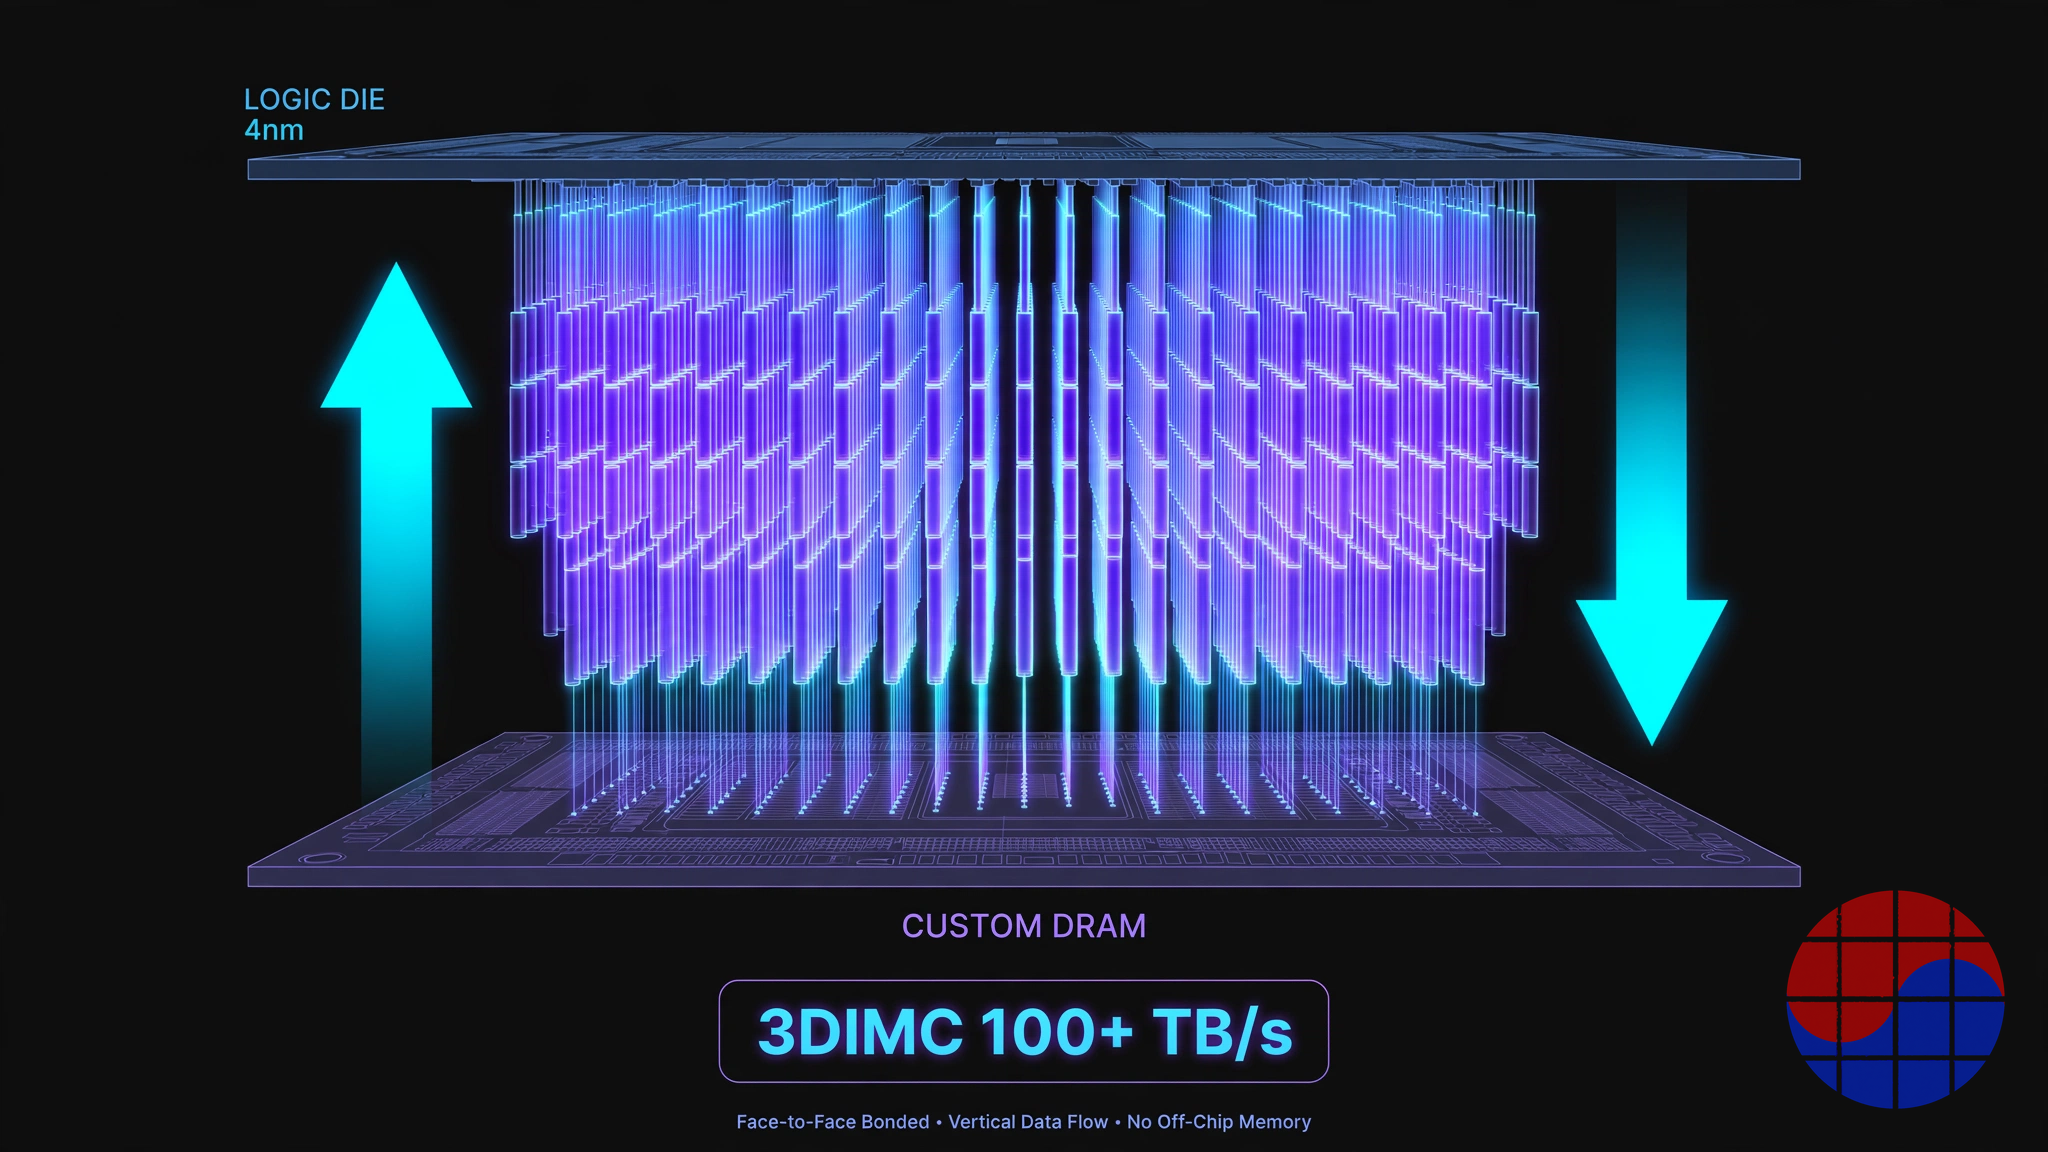
La respuesta de d-Matrix es 3DIMC, encarnada en la próxima plataforma Raptor. Presentada a través del vehículo de prueba Pavehawk junto a Alchip en noviembre de 2025, Raptor une cara a cara un chip lógico de 4 nm de TSMC con un chip DRAM personalizado a un paso de 36 micrones. La empresa proyecta más de 100 TB/s de ancho de banda y 32 GB —256 Gb— de memoria apilada por acelerador a 0,37 pJ/bit, y los primeros resultados de silicio presentados en 2026 reportaron un rendimiento de inferencia por acelerador unas 4,7 veces superior al de una configuración basada en HBM. Raptor debería completar su diseño (tape-out) a finales de 2026, con disponibilidad en rack en el cuarto trimestre de 2027. En septiembre de 2026, d-Matrix se unió al ecosistema NVLink Fusion de NVIDIA, de modo que las XPU Raptor están diseñadas para insertarse en racks MGX de NVIDIA junto a GPU, en lugar de exigir una sustitución completa.
Qué debe ser verdad para que valgan 2.000 millones
Reducida a aritmética, la historia es esta: una valoración de 2.000 millones sobre 450 millones recaudados, antes de ingresos en volumen, valora a d-Matrix como un futuro negocio de plataforma, no como un vendedor de componentes. Deben cumplirse tres cosas. Primera: el gasto en inferencia debe seguir creciendo de forma compuesta, hasta que una capa de decodificación especializada sea una partida presupuestaria que los hiperescaladores financien por separado de las GPU. Segunda: la economía declarada por Corsair —10 veces más interactividad, 3 veces mejor rendimiento por coste total de propiedad, 3 a 5 veces mejor eficiencia energética, todo cifras reportadas por la empresa— debe sobrevivir al contacto con cargas de trabajo de producción de clientes con nombre, no solo con benchmarks de Llama. Tercera: debe formarse el foso de software; Aviator tiene que volverse lo bastante adherente para que los clientes no traten el hardware como una mercancía intercambiable cuando NVIDIA, AMD o el equipo ASIC de un hiperescalador presente una respuesta suficientemente buena.
La evidencia de tracción hasta ahora es real pero incompleta. El estado de producción plena, una línea de racks fabricada por Supermicro, una adquisición que añade tejido a nivel de sistema y una lista de inversores con peso de fondos soberanos (Temasek, QIA, EDBI) indican que compradores sofisticados están haciendo due diligence y se quedan. Lo que aún falta es la clase de evidencia que en última instancia pone precio a las startups de chips: despliegues de producción divulgados con hiperescaladores nombrados y pedidos repetidos. Un esfuerzo reportado en julio de 2026 para recaudar capital adicional a una valoración mayor, y el interés reportado de NVIDIA en invertir, siguen sin confirmarse y deben tratarse como reportados, no establecidos.
El lado bajista: la HBM contraataca, y el software es un impuesto
El caso bajista tiene dos frentes. El primero es la física y las hojas de ruta. La HBM no está quieta: HBM4 amplía la interfaz a 2.048 bits por pila, y los vendedores de GPU integran SRAM más grandes, interconexiones más rápidas y referencias optimizadas para inferencia. Cada generación estrecha la brecha de latencia que justifica un acelerador separado, mientras el incumbente de GPU ofrece una única pila de software para entrenamiento e inferencia. El segundo frente es el impuesto de adopción. Toda plataforma que no es CUDA pide a los clientes portar modelos, confiar en un compilador joven y aceptar el riesgo de proveedor sobre el balance de una startup. d-Matrix lo mitiga con posicionamiento heterogéneo: Corsair como descarga de decodificación junto a las GPU, formalizado con el movimiento NVLink Fusion y la demostración de Attention-FFN Disaggregation (AFD), que repartió la atención a las GPU y las capas feed-forward a las XPU Corsair y mostró 845 tokens por segundo por usuario con 64 usuarios concurrentes. Mitigar no es eliminar: el impuesto se paga en cada ciclo de ventas.
Chase's Take
La mayoría de las startups de chips de IA venden un motor más rápido. d-Matrix vende otra identidad contable: en la decodificación, los tokens por segundo son aproximadamente el ancho de banda dividido por el tamaño del modelo, así que quien posee el ancho de banda posee el margen. Elegir computación en memoria digital en lugar de analógica fue la decisión silenciosamente correcta: la IMC analógica deslumbra en demos y se descalibra en producción, mientras DIMC conserva el determinismo de la SRAM y sobrevive a las migraciones de proceso. La pregunta honesta no es si la física funciona; Pavehawk y los resultados de silicio de 2026 dicen que sí. La pregunta es si la economía de la SRAM más una pila de software joven pueden sostener una capa defendible frente a un incumbente que puede empaquetar su respuesta dentro del rack de GPU que el cliente ya compró. La decisión de NVLink Fusion me dice que la dirección lo entiende: d-Matrix no intenta vencer al rack de NVIDIA, intenta convertirse en una partida dentro de él. A 2.000 millones, los inversores no pagan por ese resultado: pagan por el camino ponderado por probabilidad hasta él, con el efectivo de la Serie C financiando exactamente las dos pruebas que aún faltan: escala de producción con nombre y Raptor a tiempo.
Implications
Para hiperescaladores y neoclouds: los aceleradores de clase Corsair convierten la inferencia en un problema de diseño heterogéneo. La pregunta de compra pasa de «¿qué GPU?» a «¿qué capas se ejecutan dónde?», y la desagregación tipo AFD se convierte en una disciplina de planificación de capacidad, no en un experimento.
Para la industria de la memoria: d-Matrix es una señal de demanda con una advertencia. Su producto actual rodea la HBM con SRAM y LPDDR5, y la DRAM apilada personalizada de Raptor sugiere que la contienda a largo plazo no es HBM contra nada, sino HBM estándar contra memoria diseñada alrededor de un chip de cálculo concreto. Los fabricantes de memoria que codiseñen pilas con startups de aceleradores ganan un canal que el duopolio de GPU no controla.
Para inversores: el precio de 2.000 millones se revalorizará con dos eventos observables: el primer despliegue hiperescala de Corsair con nombre y repetido, y el tape-out de Raptor a finales de 2026. Hasta entonces, la valoración descansa en afirmaciones de benchmark y en la calidad de los inversores: señales fuertes, pero señales, no flujo de caja.
FAQ
¿Qué hace d-Matrix?
d-Matrix construye aceleradores de centro de datos especializados en inferencia de IA. Su plataforma Corsair usa Digital In-Memory Computing (DIMC) —calcular dentro de la SRAM— junto con la red JetStream y la pila de software Aviator, orientada a la generación de tokens de baja latencia y alta eficiencia energética, no al entrenamiento de modelos.
¿Por qué d-Matrix vale 2.000 millones de dólares?
La valoración de 2.000 millones la fijó su Serie C de 275 millones de dólares cerrada el 12 de noviembre de 2025, coliderada por BullhoundCapital, Triatomic Capital y Temasek, con participación de QIA, EDBI y M12 de Microsoft. Los inversores valoran la expectativa de que la inferencia se convierta en el coste dominante de la infraestructura de IA y de que una arquitectura centrada en la memoria capture una parte duradera de ese gasto.
¿En qué se diferencia Corsair de una GPU?
Una GPU lee los pesos del modelo desde HBM en cada token, con un ancho de banda de paquete del orden de 8 TB/s. Corsair mantiene los pesos calientes en SRAM dentro del chip y calcula dentro de la matriz de memoria, alcanzando 150 TB/s de ancho de banda en el chip por tarjeta, dirigido a las cargas de decodificación de lote pequeño y baja latencia donde las GPU son menos eficientes. Cada tarjeta lleva 2 GB de Performance Memory SRAM y hasta 256 GB de Capacity Memory LPDDR5.
¿Qué son 3DIMC y Raptor?
3DIMC es la evolución con apilado 3D de la arquitectura en memoria de d-Matrix. La plataforma Raptor une cara a cara un chip lógico de 4 nm con un chip DRAM personalizado, proyectando más de 100 TB/s de ancho de banda y 32 GB (256 Gb) de memoria por acelerador. Raptor debería completar su tape-out a finales de 2026, con disponibilidad en rack prevista para el cuarto trimestre de 2027, incluida la integración en racks NVLink Fusion de NVIDIA.
Nota: las cifras de rendimiento y eficiencia (10 veces de interactividad, 3 veces de rendimiento por TCO, 3 a 5 veces de eficiencia energética, 150 TB/s) son las reportadas por la empresa en las fechas citadas en el texto. La valoración de 2.000 millones de dólares es la cifra post-money reportada en el anuncio de la Serie C de noviembre de 2025.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.


