VLSI Korea
A inferência se divide em duas: 5 fatos (decodificação SRAM vs. HBM)
A inferência se parte em duas: a decodificação premia a largura de banda da SRAM sem HBM do Groq 3 LPX, e o treinamento continua premiando a capacidade da HBM. A Samsung fica nos dois lados.


A inferência se divide em duas: 5 fatos (decodificação SRAM vs. HBM)
A inferência já não é um único problema de memória: a decodificação premia a largura de banda da SRAM e o treinamento continua premiando a capacidade da HBM.
Resumo em 30 segundos
A conclusão vem primeiro. A inferência se divide em dois trabalhos. Na decodificação, em que o modelo gera token a token e cada milissegundo conta, um projeto com SRAM no próprio chip, sem HBM, oferece uma largura de banda muito superior por chip. No treinamento e no prefill com contextos longos, manda a capacidade: armazenar trilhões de parâmetros exige HBM. O Groq 3 LPX da NVIDIA, já em produção plena segundo o Hot Chips 2026, materializa a primeira metade. O Trainium3 da AWS, o Rainier e o TorchNeuron materializam a segunda. A Samsung fica nos dois lados: foundry exclusiva do chip sem HBM e candidata a recuperar participação na HBM. A SK hynix fica exposta, sobretudo, ao lado da HBM. Não há um vencedor único: há dois muros de memória.
Contexto
Durante anos, a conversa sobre aceleradores de IA girou em torno de uma única pergunta: quanta HBM o chip carrega. Fazia sentido, porque o mesmo hardware treinava o modelo, processava o prompt no prefill e gerava a resposta token a token na decodificação.
A alternativa SRAM sempre existiu, mas nas margens. O primeiro GroqChip, descrito na ficha da Groq de 2022, já apostava nela: 230 MB de SRAM no die, até 80 TB/s de largura de banda interna, 750 TOPS em INT8, em 14 nm, com execução determinística programada pelo compilador. O WSE-3 da Cerebras, de 2024, levou a ideia a um wafer completo, com 44 GB de SRAM no chip e 21 PB/s. Eram projetos reais, mas não definiam o centro do mercado.
O centro se moveu em 24 de dezembro de 2025, quando a Groq anunciou um acordo de licenciamento não exclusivo com a NVIDIA. Jonathan Ross, Sunny Madra e parte da equipe central se juntaram à NVIDIA. A Groq seguiu independente, com Simon Edwards como diretor executivo, e a GroqCloud não fez parte do acordo. Os 20 bilhões de dólares são um número reportado pela imprensa naquela data, não divulgado pela NVIDIA.
No GTC de março de 2026, a NVIDIA apresentou o Groq 3 LPX. Em seu projeto de plataforma, que é uma decisão do fornecedor e não um fato medido por terceiros, as GPU Rubin mantêm o prefill de contexto longo e a atenção na decodificação, enquanto as LPU assumem o trabalho feed-forward e de MoE mais sensível à latência. A divisão acontece dentro do mesmo rack. Ali, Jensen Huang afirmou que a Samsung fabricava o chip para a NVIDIA e que os envios começariam no segundo semestre, provavelmente por volta do terceiro trimestre. A Samsung confirmou em junho de 2026 que já produzia o LP30.
O outro campo também não ficou parado: a AWS colocou o Trainium3 em disponibilidade geral em 2 de dezembro de 2025, e em 19 de outubro de 2026 a Amazon anunciou o TorchNeuron contra a barreira histórica do silício personalizado: o software.
Análise em profundidade
Fato 1: O LPX já está em produção plena, sem HBM, com números extremos de SRAM
- No Hot Chips 2026, em 24 e 25 de agosto de 2026, a NVIDIA anunciou que o Groq 3 LPX estava em produção plena. O chip LP30 integra 500 MB de SRAM no die e oferece 150 TB/s de largura de banda de SRAM por chip, sem HBM. Acrescenta 96 enlaces chip a chip de 112 Gbps, 2,5 TB/s de largura de banda de escalonamento por chip e uma latência chip a chip de 350 ns, segundo os materiais da NVIDIA. O rack LPX reúne 256 chips LP30, em 32 bandejas de 8, e soma 128 GB de SRAM, 40 PB/s de largura de banda agregada de SRAM, 640 TB/s de escalonamento e 315 PFLOPS de computação FP8. A fabricação cabe à Samsung Foundry em 4 nm, como fabricante única. Segundo o reportado em 13 de outubro de 2026 sobre o OCP 2026, a Samsung exibiu um wafer de LPU da Groq, produzido em massa em Pyeongtaek.
A NVIDIA afirma, e é uma afirmação do fornecedor, até 35 vezes mais desempenho por megawatt em modelos de um trilhão de parâmetros quando o LPX é combinado com o Vera Rubin NVL72. Não é uma medição independente. A primeira medição de terceiros, em um endpoint preliminar do Gemma 4 31B via Google Cloud, com contexto de 100.000 tokens, concorrência 1 e mediana de 50 requisições sequenciais, registrou 3.400 tokens de saída por segundo, cerca de 4 vezes mais do que a alternativa mais próxima nesse teste. É um resultado reportado pela NVIDIA e mede latência de um único usuário, não desempenho com lotes. A Nebius foi a primeira cliente anunciada.
Fato 2: A assimetria é a história, largura de banda por dezenas frente a capacidade por mais de cem
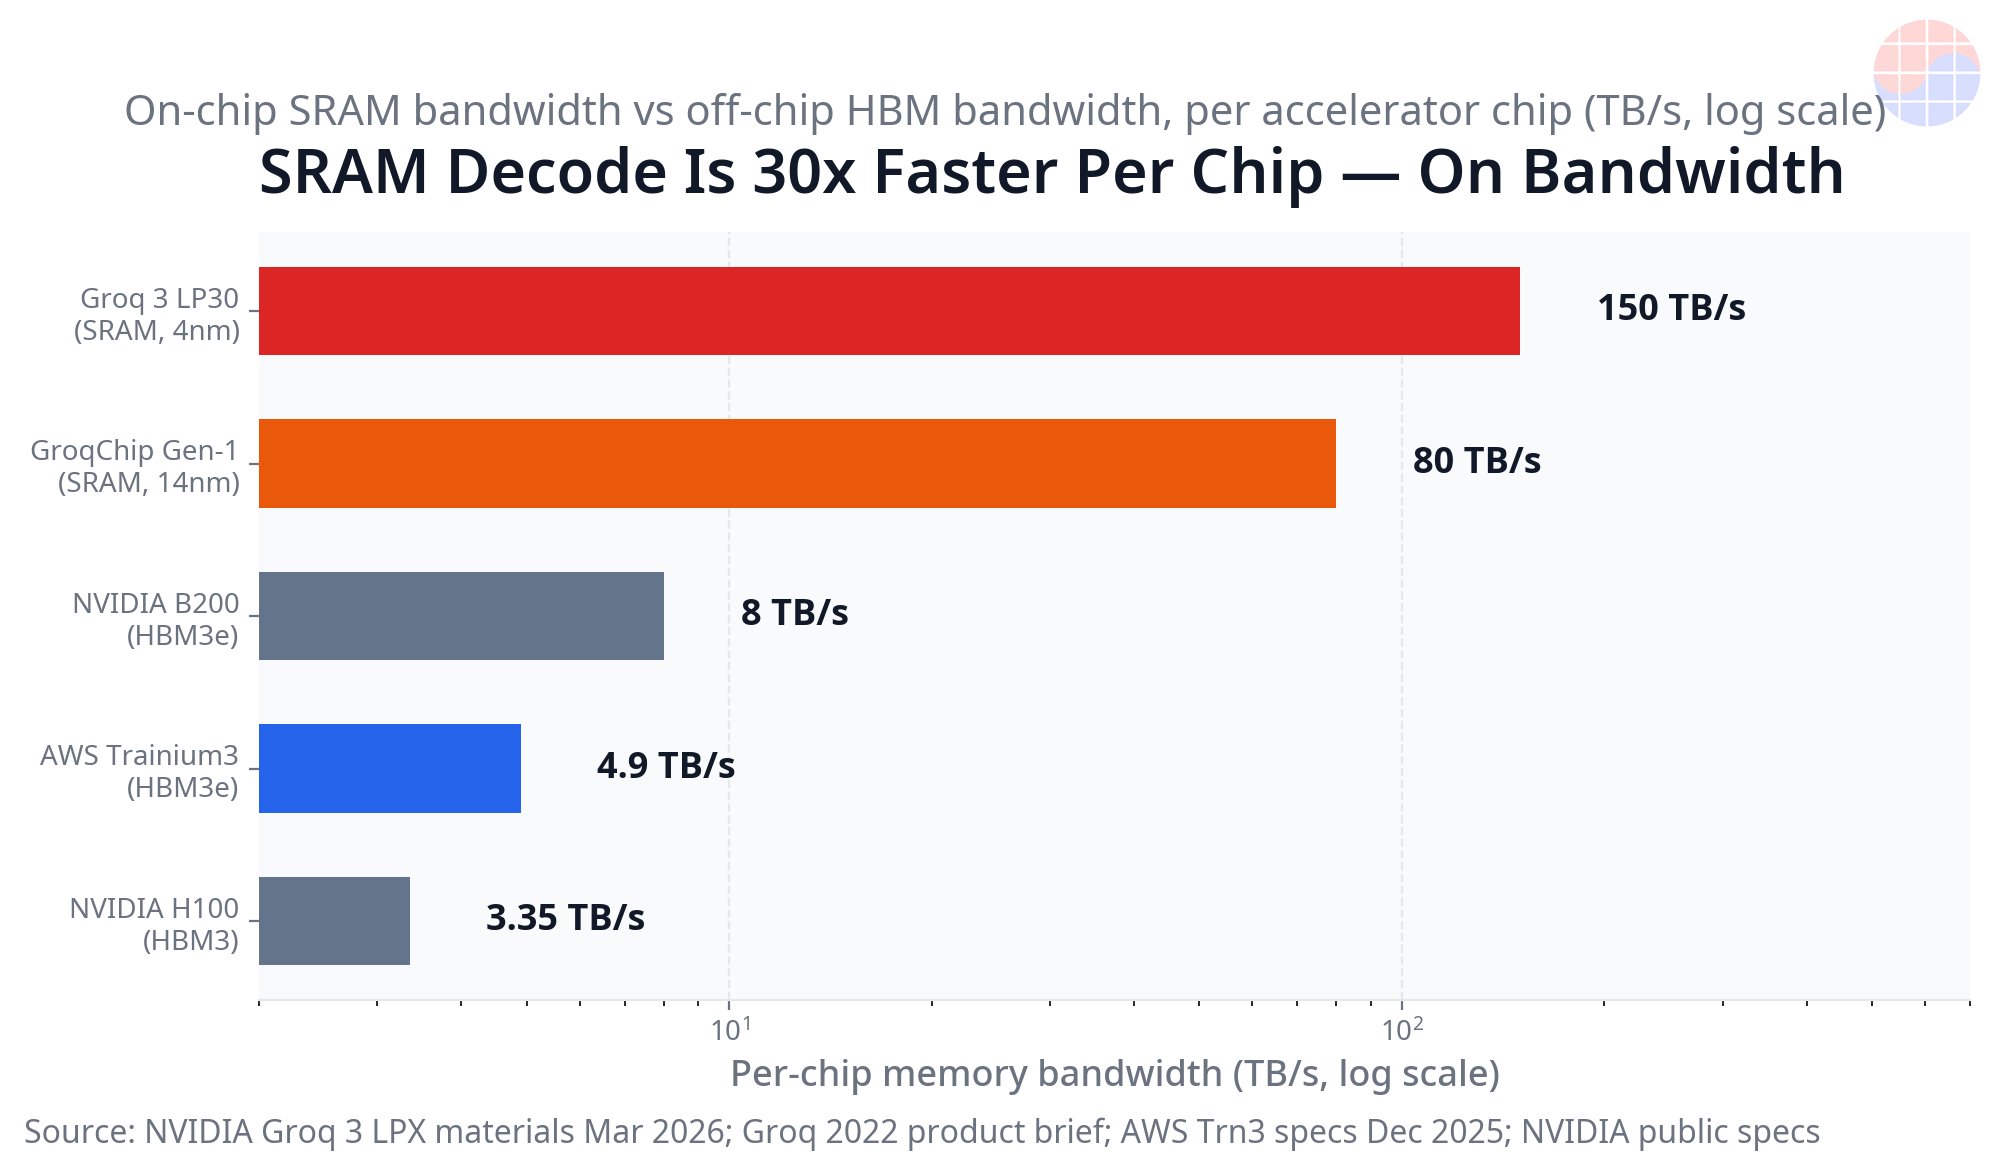
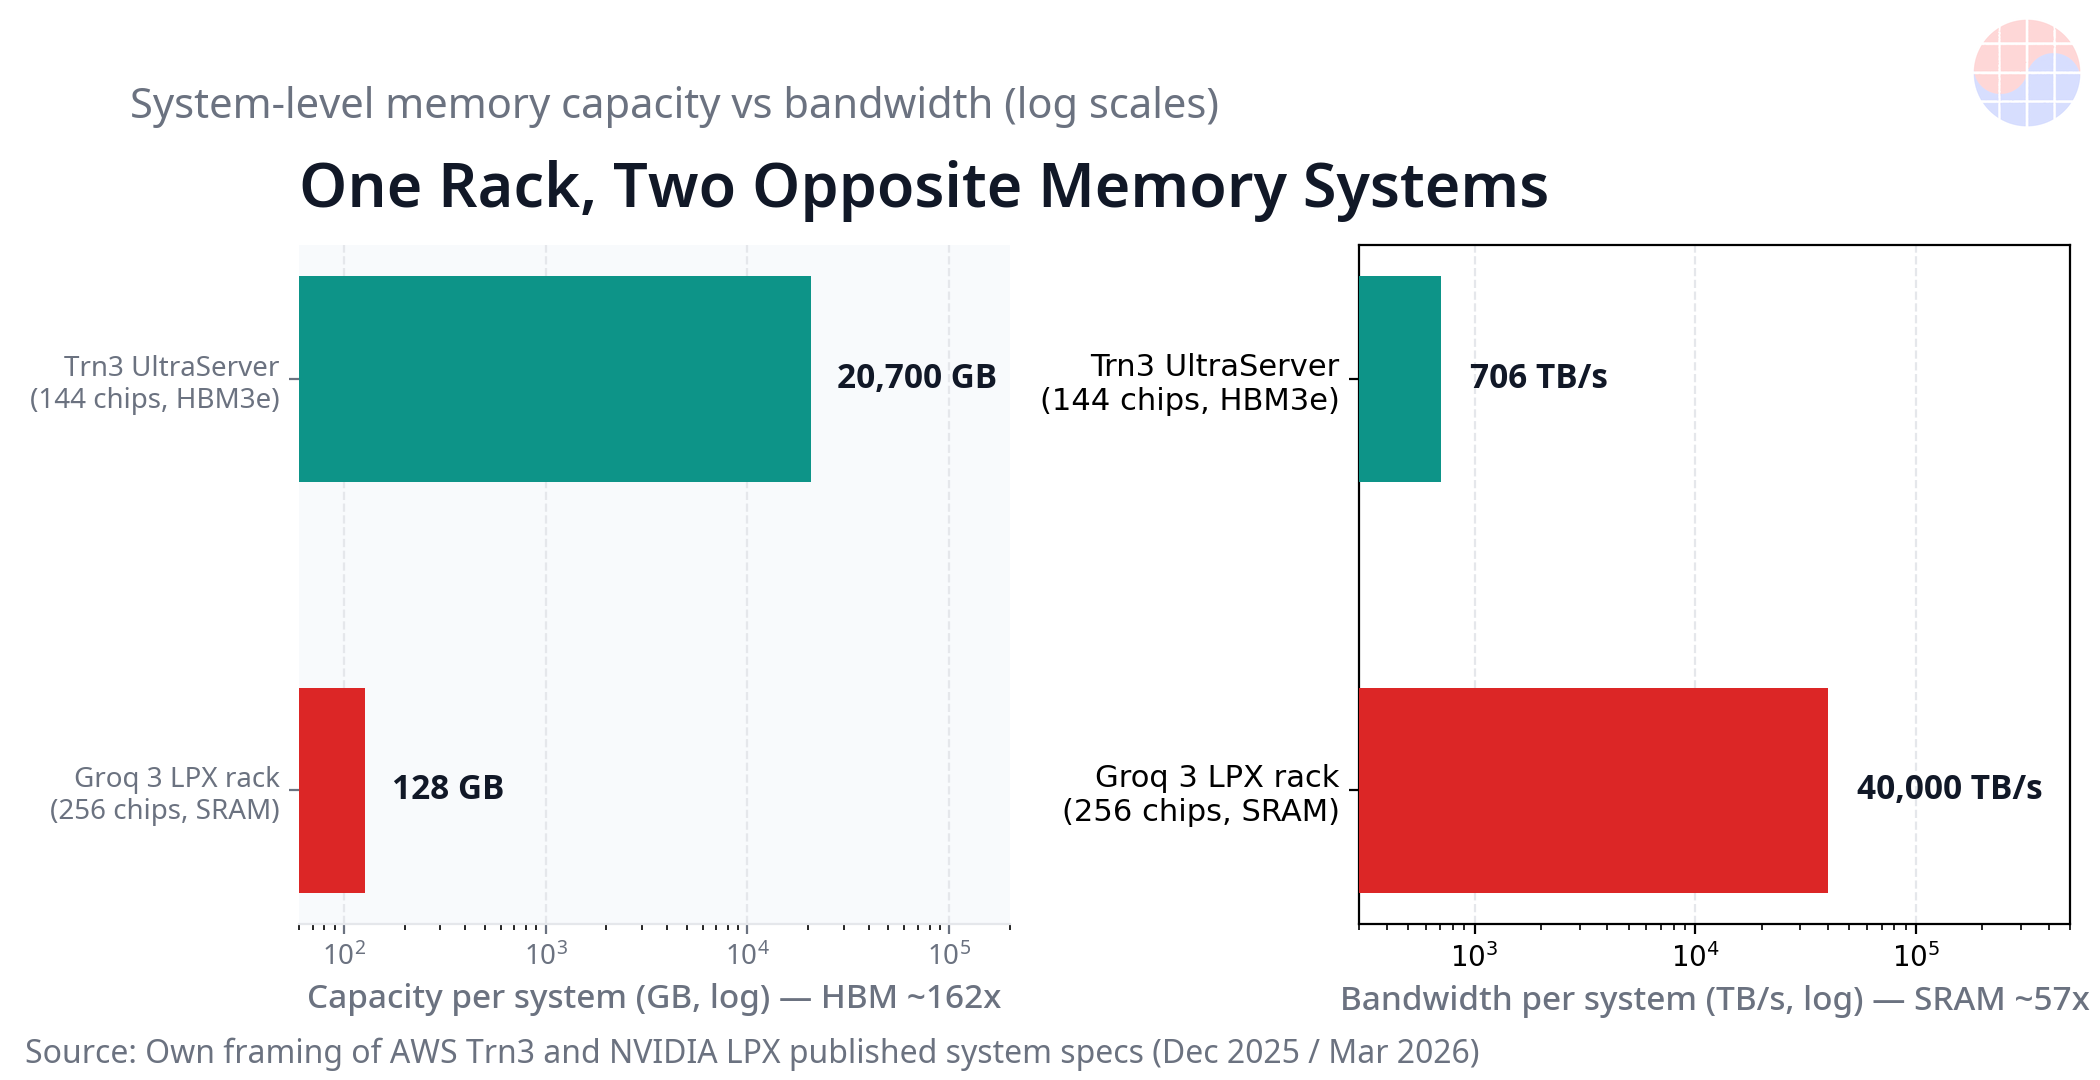
- O segundo fato sai das fichas oficiais, e os quocientes são cálculo próprio. Por chip, os 150 TB/s do LP30 equivalem a cerca de 31 vezes os 4,9 TB/s de HBM3e do Trainium3 e a cerca de 45 vezes os 3,35 TB/s do H100. Em escala de rack, o cálculo próprio dá 40 PB/s do LPX frente a 706 TB/s do Trn3 UltraServer: cerca de 57 vezes mais. Mas a segunda metade é a inversão exata: em capacidade, os 20,7 TB de HBM3e do Trn3 UltraServer equivalem a cerca de 162 vezes os 128 GB de SRAM de um rack LPX. Essa assimetria é a notícia.
A aritmética de pesos, também cálculo próprio, torna isso prático. Em FP8, com 1 byte por parâmetro e apenas pesos, antes do cache KV, um modelo de 70 bilhões ocupa 70 GB e cabe em um rack LPX. Um de 405 bilhões precisa de um mínimo de 4 racks. Um de um trilhão, um mínimo de 8 racks. Os três cabem em um único Trn3 UltraServer, com ampla margem. Como contraste, também cálculo próprio: com GroqChips de 230 MB, apenas os pesos de um modelo de 70 bilhões em FP8 precisariam de cerca de 305 chips. A SRAM moderna torna viável o que era uma curiosidade, mas desloca o problema de capacidade para a quantidade de racks.
Fato 3: O campo do treinamento reforça a HBM e ataca sua barreira de software
- O terceiro fato é que o campo oposto é silício personalizado de um hiperescalador com escala real. O Trainium3, segundo a AWS, é fabricado em 3 nm da TSMC, oferece 2,52 PFLOPS FP8 por chip e carrega 144 GB de HBM3e por chip com 4,9 TB/s. O Trn3 UltraServer reúne 144 chips, com 362 PFLOPS FP8, 20,7 TB de HBM3e e 706 TB/s agregados. A AWS afirma, como afirmação do fornecedor em relação ao Trainium2, 4,4 vezes mais computação e cerca de 4 vezes mais largura de banda. O Rainier traz a prova de uso, com cerca de 500.000 Trainium2 no fim de 2025 e uma rota para um milhão de chips. Segundo informações reportadas em outubro de 2026, a Anthropic se comprometeu com mais de 100 bilhões de dólares em 10 anos para capacidade da AWS, e o acordo da OpenAI com a AWS, de 38 bilhões, inclui cerca de 2 GW de Trainium. Ambos os números são reportados.
O movimento recente é o TorchNeuron, anunciado em 19 de outubro de 2026 e em beta público desde 20 de outubro de 2026: um backend nativo de PyTorch, de código aberto com licença Apache 2.0, para Trainium2 e Trainium3. Abandona a rota XLA e admite modo eager, torch.compile e FSDP/DTensor. A AWS o apresenta como a eliminação da barreira de portabilidade para treinar no Trainium. Não garante adoção, mas elimina a desculpa técnica mais repetida. Se o treinamento migrar em parte para chips com 144 GB de HBM3e em centenas de milhares de unidades, a demanda de HBM do treinamento não desaparece por causa da decodificação SRAM: cresce por outra via.
Fato 4: A Samsung está nos dois lados e a SK hynix, sobretudo, em um
- A Samsung ocupa os dois lados ao mesmo tempo. Tenta recuperar participação em HBM nas plataformas de GPU da NVIDIA, em que a memória empilhada continua imprescindível para treinamento, prefill e atenção. E é a foundry única do LP30, o chip sem HBM, em 4 nm. A virada SRAM não é uma perda simples para a Samsung: converte um risco de HBM em volume de foundry em Pyeongtaek. O cálculo de volume, apenas como ilustração e como cálculo próprio, dimensiona isso: cada rack LPX carrega 256 LPU da Samsung, assim 1.000 racks seriam 256.000 LPU. Não é uma previsão, e sim uma regra de três por rack.
A SK hynix é a exposição pura à HBM, o que não corta seu negócio amanhã: treinamento e prefill continuam famintos por HBM, e o Rainier rumo a um milhão de chips sustenta a demanda próxima. O que a SRAM limita é apenas uma parte do crescimento da HBM: o trecho de inferência e, dentro dele, a decodificação em que a latência tem preço premium. Além disso, a NVIDIA mantém a atenção nas GPU Rubin, com sua HBM.
Fato 5: Três verificações diriam se a divisão é falsa, e nenhuma está resolvida
- A tese enfraqueceria se acontecessem três coisas verificáveis. Primeira: se a atenção, que hoje fica nas GPU Rubin, absorvesse de volta o trabalho feed-forward e de MoE, a LPU seria um experimento de uma geração. A pergunta aberta é se a próxima Rubin aumenta ou reduz a decodificação na GPU. Segunda: se a aritmética de capacidade em escala de um trilhão de parâmetros tornasse impraticável repartir os pesos entre muitos racks, o mercado preferiria capacidade concentrada com HBM mesmo que a latência fosse pior. Terceira: o ângulo da China continua vazio. Em teoria, uma rota SRAM contornaria o controle de exportação sobre a HBM avançada. Mas em 24 de outubro de 2026 nenhum acelerador chinês de decodificação SRAM em produção em massa foi divulgado publicamente, e é preciso afirmar exatamente essa ausência. Como análise, as razões são estruturais: um die carregado de SRAM consome muita superfície, com 500 MB por LP30 já em 4 nm; precisa de lógica avançada, também restringida; e a vantagem real é o compilador determinístico, não a célula de memória.
Chase's Take
A decodificação é um negócio de latência; o treinamento, de capacidade. O muro de memória se partiu em dois: um muro de largura de banda, que decide a decodificação, e um muro de capacidade, que decide treinamento, prefill e contexto longo. Cada um premia um silício distinto. Nem a HBM está morta, nem a SRAM é uma anedota.
A nota prática de EDA e STA é, para mim, a mais interessante. Um chip determinístico programado pelo compilador transfere o problema difícil da arbitragem em tempo de execução para o planejamento em tempo de compilação. Com 256 chips e enlaces de 350 ns, o rack inteiro é um único problema gigante de análise de temporização estática. Quem possui o compilador, possui a arquitetura. Por isso o acordo de dezembro de 2025 importa tanto quanto o silício.
Implicações
Para a HBM, a implicação é de composição, não de volume total. O crescimento ligado a treinamento e prefill permanece, sustentado pelo Trn3 UltraServer e por compromissos reportados em outubro de 2026. O da inferência começa a ter um teto parcial onde pagar por latência compensa implantar racks de SRAM.
Para as foundry, um nó maduro, mas avançado, como o de 4 nm, pode capturar valor novo: cada rack LPX são 256 chips de um único fabricante. Para os hiperescaladores, a adoção dependerá menos do transistor e mais de se o TorchNeuron reduz o custo de portar cargas reais de PyTorch.
A verificação é concreta: envios de racks LPX nos resultados do quarto trimestre de 2026, participação da Groq como empresa independente frente ao seu projeto licenciado dentro da NVIDIA, um segundo laboratório de fronteira no Trainium após o TorchNeuron, e quanta decodificação a seguinte Rubin deixa na GPU. Até lá, a divisão é a melhor leitura dos fatos, não uma certeza fechada.
Perguntas frequentes
A SRAM substituirá a HBM na inferência de IA? Não por completo. A SRAM vence na decodificação sensível à latência, mas o próprio projeto da NVIDIA mantém o prefill de contexto longo e a atenção da decodificação em GPU com HBM. A substituição é parcial e acontece dentro do mesmo rack, não como uma troca total de uma memória por outra.
Por que a SRAM é muito mais rápida, mas armazena muito menos? Porque está integrada no próprio die, junto à lógica, e não precisa sair do chip para encapsulamentos de memória empilhada. Essa proximidade entrega 150 TB/s por chip no LP30, mas a superfície do die é limitada: 500 MB por chip e 128 GB por rack LPX, frente aos 20,7 TB de HBM de um Trn3 UltraServer, segundo o cálculo próprio a partir das fichas oficiais.
O que a divisão significa para a Samsung e a SK hynix? Para a Samsung significa estar nos dois lados: aspira a recuperar participação em HBM e, ao mesmo tempo, fabrica com exclusividade o LP30 sem HBM em 4 nm, de modo que parte do risco de memória se converte em volume de foundry. Para a SK hynix significa uma exposição concentrada na HBM, protegida no curto prazo pelo treinamento e pelo prefill, mas com um teto novo no trecho de decodificação de inferência com latência premium.
Quando será possível comprovar se a divisão é real? As primeiras provas duras virão com os dados de envios do quarto trimestre de 2026, com a evolução da participação da Groq como empresa independente, com novos adotantes do Trainium para treinamento após o TorchNeuron e com a decisão da geração seguinte Rubin sobre quanta decodificação fica na GPU. Se esses quatro indicadores se moverem na mesma direção, a divisão deixará de ser uma tese.
Nota: este artigo se baseia unicamente em anúncios e materiais oficiais da NVIDIA, Groq, AWS e Samsung e em informações datadas citadas no texto; as afirmações de fornecedores são identificadas como tais, os números reportados são identificados como reportados e os quocientes assinalados são cálculo próprio. Não constitui aconselhamento de investimento.
Leitura relacionada
- Inferência de IA sem HBM? A aposta de 480 GB LPDDR5X da Intel e a…
- Citi mantém alvo da SK hynix em 3 milhões de wones: inferência de IA…
- GPU de inferência da Intel, a fundo: por que o D270 troca o HBM por 480…
- Ascend 950 e sua HBM própria: 5 fatos sobre a aposta de 160.000 chips…
- Samsung vs SK Hynix na SEDEX 2026: duas estratégias para a guerra da…
📩 Perdeu a análise de hoje? Receba a de amanhã no seu e-mail
Daily Silicon às 10:30 KST e os principais pontos de resultados e relatórios, primeiro. Ao assinar, você escolhe a newsletter em coreano, inglês ou japonês; as análises em português saem todos os dias no site.
Assinar grátis →
Grátis · Sem spam · Cancele quando quiser