 VLSI Korea
La inferencia se divide en dos: 5 hechos (decodificación SRAM frente a HBM)
La inferencia se parte en dos: la decodificación premia el ancho de banda de la SRAM sin HBM del Groq 3 LPX, y el entrenamiento sigue premiando la capacidad de la HBM. Samsung queda en ambos lados.


La inferencia se divide en dos: 5 hechos (decodificación SRAM frente a HBM)
La inferencia ya no es un solo problema de memoria: la decodificación premia el ancho de banda de la SRAM y el entrenamiento sigue premiando la capacidad de la HBM.
Resumen en 30 segundos
La conclusión va primero. La inferencia se divide en dos trabajos. En la decodificación, donde el modelo genera token a token y cada milisegundo cuenta, un diseño con SRAM en el propio chip, sin HBM, ofrece un ancho de banda muy superior por chip. En el entrenamiento y en el prefill con contextos largos, manda la capacidad: almacenar billones de parámetros exige HBM. El Groq 3 LPX de NVIDIA, ya en producción plena según Hot Chips 2026, materializa la primera mitad. El Trainium3 de AWS, Rainier y TorchNeuron materializan la segunda. Samsung queda en ambos lados: foundry exclusiva del chip sin HBM y aspirante a recuperar cuota en HBM. SK hynix queda expuesta, sobre todo, al lado de la HBM. No hay un ganador único: hay dos muros de memoria.
Antecedentes
Durante años, la conversación sobre aceleradores de IA giró en torno a una sola pregunta: cuánta HBM lleva el chip. Tenía sentido, porque el mismo hardware entrenaba el modelo, procesaba el prompt en el prefill y generaba la respuesta token a token en la decodificación.
La alternativa SRAM siempre existió, pero en los márgenes. El primer GroqChip, descrito en la ficha de Groq de 2022, ya apostaba por ella: 230 MB de SRAM en el die, hasta 80 TB/s de ancho de banda interno, 750 TOPS en INT8, en 14 nm, con ejecución determinista programada por el compilador. El WSE-3 de Cerebras, de 2024, llevó la idea a una oblea (wafer) completa, con 44 GB de SRAM en el chip y 21 PB/s. Eran diseños reales, pero no definían el centro del mercado.
El centro se movió el 24 de diciembre de 2025, cuando Groq anunció un acuerdo de licencia no exclusiva con NVIDIA. Jonathan Ross, Sunny Madra y parte del equipo central se incorporaron a NVIDIA. Groq siguió independiente, con Simon Edwards como consejero delegado, y GroqCloud no formó parte del acuerdo. Los 20.000 millones de dólares son una cifra reportada por la prensa en esa fecha, no revelada por NVIDIA.
En el GTC de marzo de 2026, NVIDIA presentó el Groq 3 LPX. En su diseño de plataforma, que es una decisión del proveedor y no un hecho medido por terceros, las GPU Rubin conservan el prefill de contexto largo y la atención en la decodificación, mientras las LPU asumen el trabajo feed-forward y de MoE más sensible a la latencia. La división ocurre dentro del mismo rack. Allí, Jensen Huang afirmó que Samsung fabricaba el chip para NVIDIA y que los envíos empezarían en la segunda mitad del año, probablemente hacia el tercer trimestre. Samsung confirmó en junio de 2026 que ya producía el LP30.
El otro campo tampoco se quedó quieto: AWS puso Trainium3 en disponibilidad general el 2 de diciembre de 2025, y el 19 de octubre de 2026 Amazon anunció TorchNeuron contra la barrera histórica del silicio personalizado: el software.
Análisis en profundidad
Hecho 1: El LPX ya está en producción plena, sin HBM, con cifras extremas de SRAM
- En Hot Chips 2026, los días 24 y 25 de agosto de 2026, NVIDIA anunció que el Groq 3 LPX estaba en producción plena. El chip LP30 integra 500 MB de SRAM en el die y ofrece 150 TB/s de ancho de banda de SRAM por chip, sin HBM. Añade 96 enlaces chip a chip de 112 Gbps, 2,5 TB/s de ancho de banda de escalado por chip y una latencia chip a chip de 350 ns, según los materiales de NVIDIA. El rack LPX reúne 256 chips LP30, en 32 bandejas de 8, y suma 128 GB de SRAM, 40 PB/s de ancho de banda agregado de SRAM, 640 TB/s de escalado y 315 PFLOPS de cálculo FP8. La fabricación corresponde a Samsung Foundry en 4 nm, como fabricante único. Según lo reportado el 13 de octubre de 2026 sobre el OCP 2026, Samsung mostró una oblea (wafer) de LPU de Groq, producida en masa en Pyeongtaek.
NVIDIA afirma, y es una afirmación del proveedor, hasta 35 veces más rendimiento por megavatio en modelos de un billón de parámetros cuando el LPX se combina con Vera Rubin NVL72. No es una medición independiente. La primera medición de terceros, sobre un endpoint preliminar de Gemma 4 31B vía Google Cloud, con contexto de 100.000 tokens, concurrencia 1 y mediana de 50 peticiones secuenciales, registró 3.400 tokens de salida por segundo, unas 4 veces más que la alternativa más cercana en esa prueba. Es un resultado reportado por NVIDIA y mide latencia de un solo usuario, no rendimiento con lotes. Nebius fue el primer cliente anunciado.
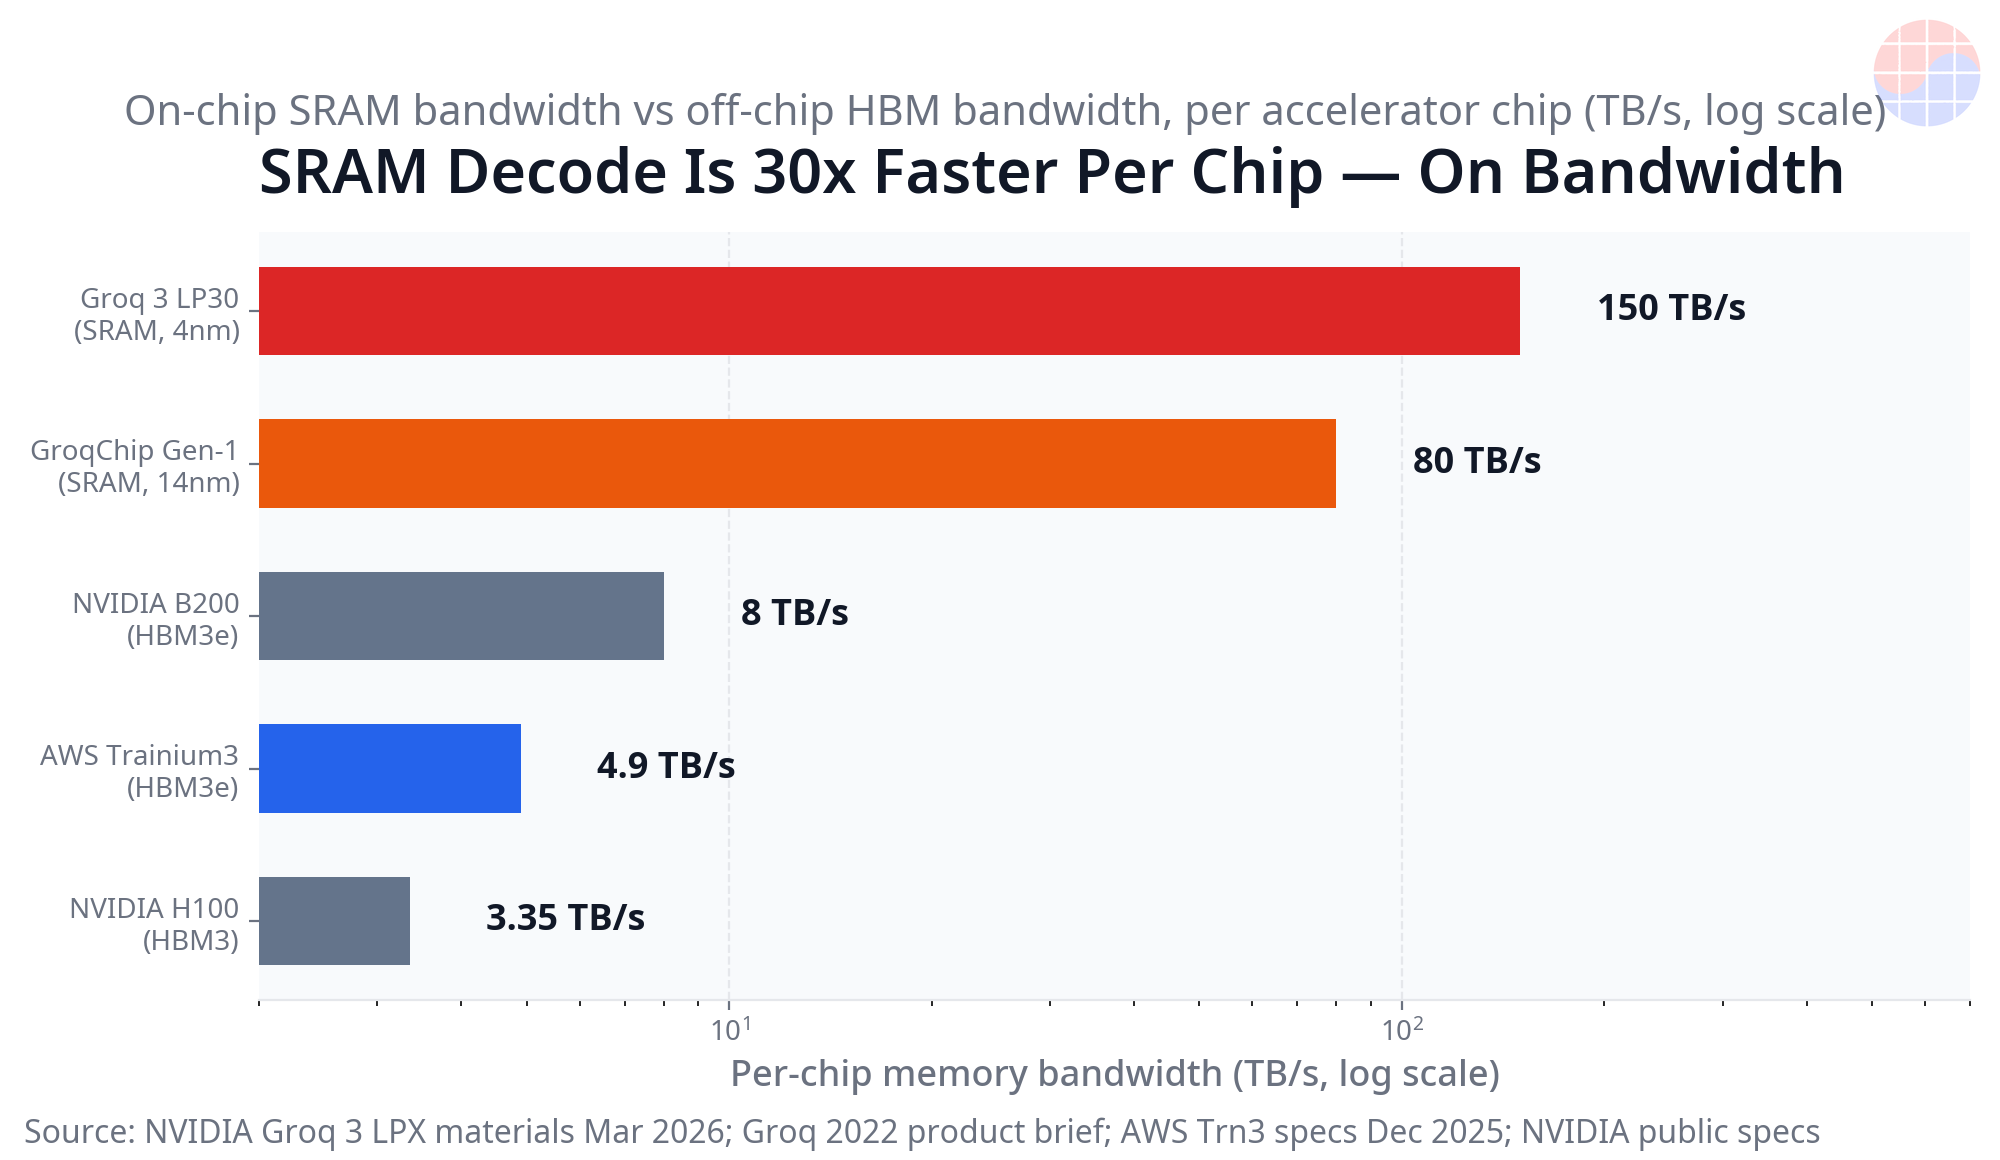
Hecho 2: La asimetría es la historia, ancho de banda por decenas frente a capacidad por más de cien
- El segundo hecho sale de las fichas oficiales, y los cocientes son cálculo propio. Por chip, los 150 TB/s del LP30 equivalen a unas 31 veces los 4,9 TB/s de HBM3e del Trainium3 y a unas 45 veces los 3,35 TB/s del H100. A escala de rack, el cálculo propio da 40 PB/s del LPX frente a 706 TB/s del Trn3 UltraServer: unas 57 veces más. Pero la segunda mitad es la inversión exacta: en capacidad, los 20,7 TB de HBM3e del Trn3 UltraServer equivalen a unas 162 veces los 128 GB de SRAM de un rack LPX. Esa asimetría es la noticia.
La aritmética de pesos, también cálculo propio, lo hace práctico. En FP8, con 1 byte por parámetro y solo pesos, antes de la caché KV, un modelo de 70.000 millones ocupa 70 GB y cabe en un rack LPX. Uno de 405.000 millones necesita un mínimo de 4 racks. Uno de un billón, un mínimo de 8 racks. Los tres caben en un solo Trn3 UltraServer, con amplio margen. Como contraste, también cálculo propio: con GroqChips de 230 MB, solo los pesos de un modelo de 70.000 millones en FP8 necesitarían unos 305 chips. La SRAM moderna hace viable lo que era una curiosidad, pero desplaza el problema de capacidad a la cantidad de racks.
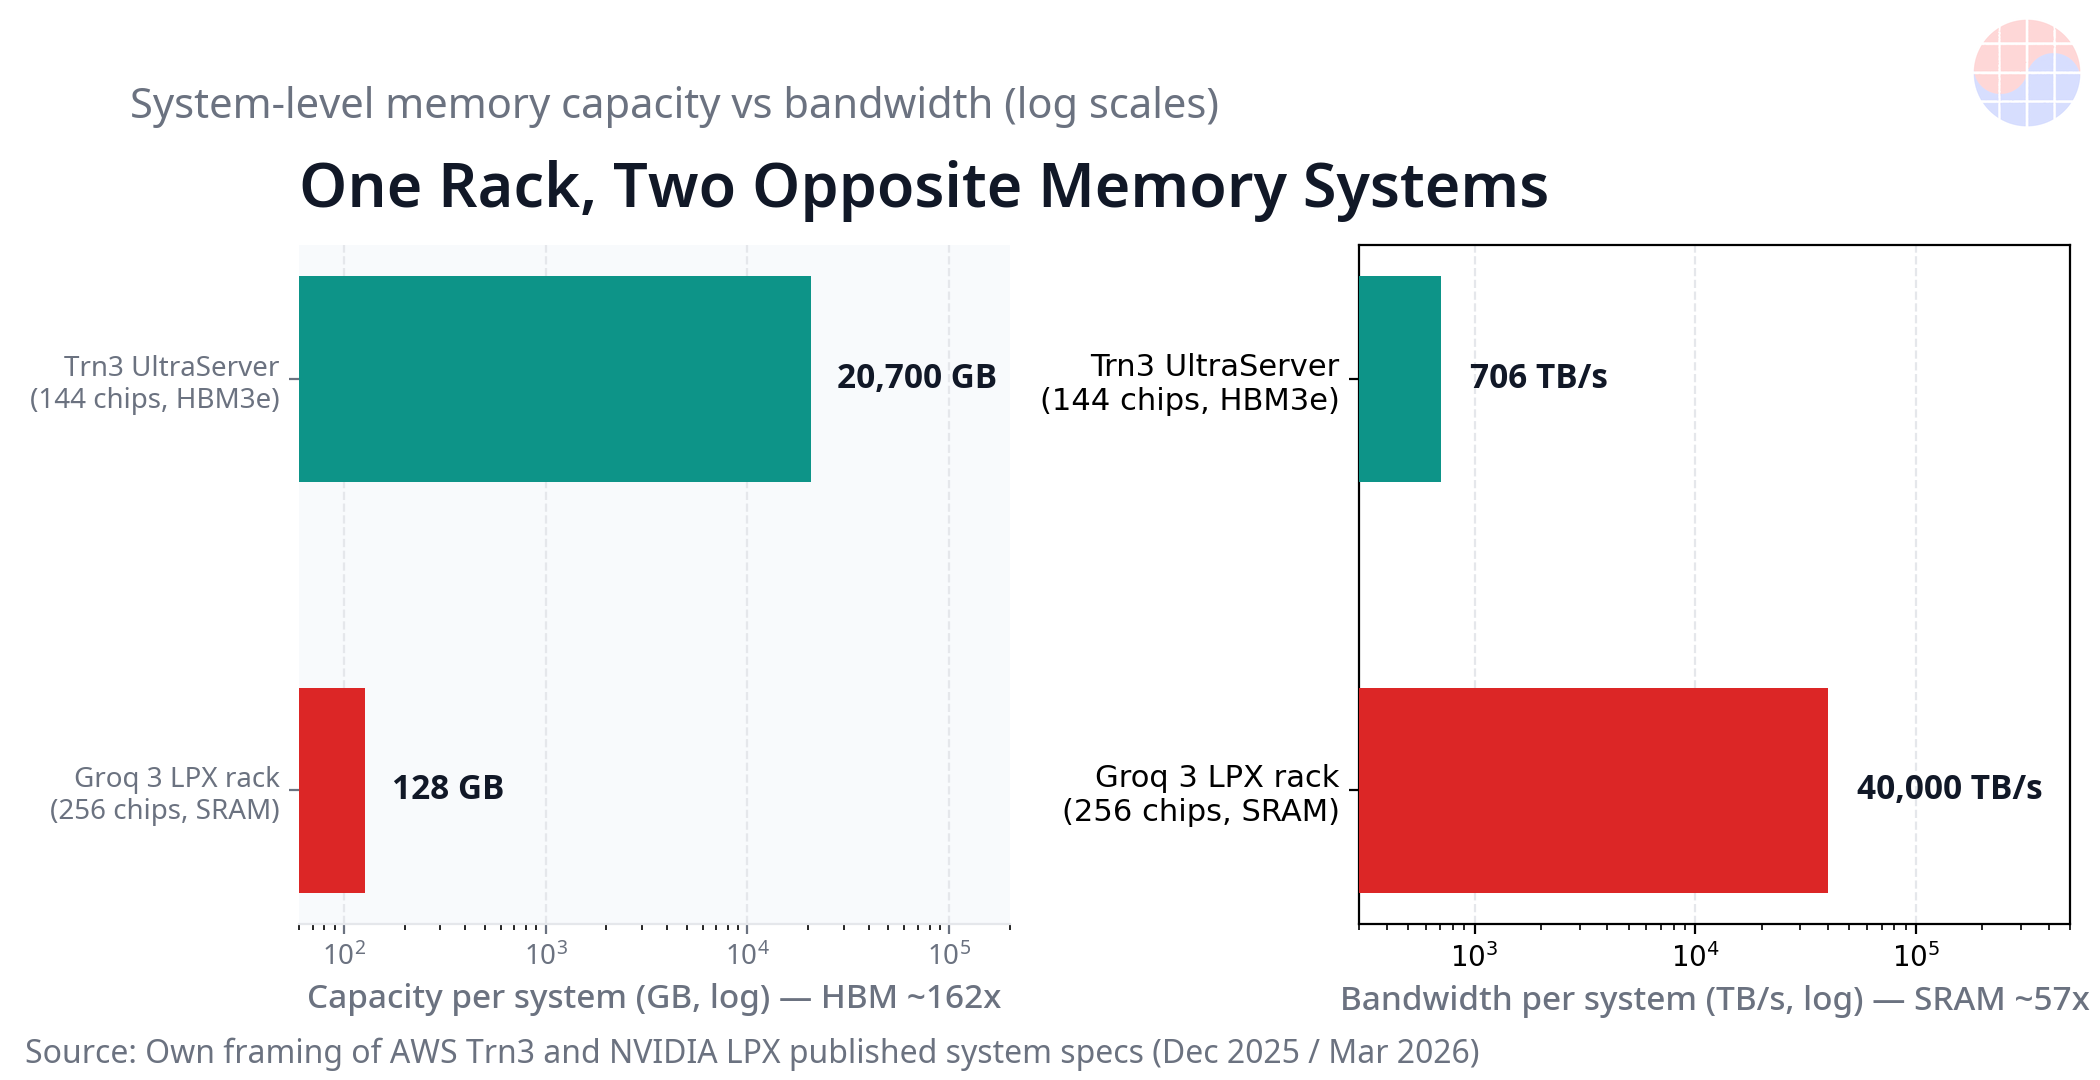
Hecho 3: El campo del entrenamiento refuerza la HBM y ataca su barrera de software
- El tercer hecho es que el campo contrario es silicio personalizado de un hiperescalador con escala real. El Trainium3, según AWS, se fabrica en 3 nm de TSMC, ofrece 2,52 PFLOPS FP8 por chip y lleva 144 GB de HBM3e por chip con 4,9 TB/s. El Trn3 UltraServer reúne 144 chips, con 362 PFLOPS FP8, 20,7 TB de HBM3e y 706 TB/s agregados. AWS afirma, como afirmación del proveedor frente a Trainium2, 4,4 veces más cálculo y unas 4 veces más ancho de banda. Rainier aporta la prueba de uso, con unos 500.000 Trainium2 a finales de 2025 y una ruta hacia un millón de chips. Según información reportada en octubre de 2026, Anthropic se comprometió a más de 100.000 millones de dólares en 10 años para capacidad de AWS, y el acuerdo de OpenAI con AWS, de 38.000 millones, incluye unos 2 GW de Trainium. Ambas cifras son reportadas.
El movimiento reciente es TorchNeuron, anunciado el 19 de octubre de 2026 y en beta pública desde el 20 de octubre de 2026: un backend nativo de PyTorch, de código abierto con licencia Apache 2.0, para Trainium2 y Trainium3. Abandona la ruta XLA y admite modo eager, torch.compile y FSDP/DTensor. AWS lo presenta como la eliminación de la barrera de portabilidad para entrenar en Trainium. No garantiza adopción, pero elimina la excusa técnica más repetida. Si el entrenamiento migra en parte a chips con 144 GB de HBM3e en cientos de miles de unidades, la demanda de HBM del entrenamiento no desaparece por la decodificación SRAM: crece por otra vía.
Hecho 4: Samsung está en ambos lados y SK hynix, sobre todo, en uno
- Samsung ocupa los dos lados a la vez. Intenta recuperar cuota de HBM en las plataformas de GPU de NVIDIA, donde la memoria apilada sigue siendo imprescindible para entrenamiento, prefill y atención. Y es la foundry única del LP30, el chip sin HBM, en 4 nm. El giro SRAM no es una pérdida simple para Samsung: convierte un riesgo de HBM en volumen de foundry en Pyeongtaek. El cálculo de volumen, solo como ilustración y como cálculo propio, lo dimensiona: cada rack LPX lleva 256 LPU de Samsung, así que 1.000 racks serían 256.000 LPU. No es una previsión, sino una regla de tres por rack.
SK hynix es la exposición pura a la HBM, lo que no recorta su negocio mañana: entrenamiento y prefill siguen hambrientos de HBM, y Rainier hacia un millón de chips sostiene la demanda cercana. Lo que la SRAM limita es solo una parte del crecimiento de la HBM: el tramo de inferencia y, dentro de él, la decodificación donde la latencia tiene precio premium. Además, NVIDIA mantiene la atención en las GPU Rubin, con su HBM.
Hecho 5: Tres comprobaciones dirían si la división es falsa, y ninguna está resuelta
- La tesis se debilitaría si ocurrieran tres cosas verificables. Primera: si la atención, que hoy queda en las GPU Rubin, absorbiera de vuelta el trabajo feed-forward y de MoE, la LPU sería un experimento de una generación. La pregunta abierta es si la próxima Rubin aumenta o reduce la decodificación en la GPU. Segunda: si la aritmética de capacidad a escala de un billón de parámetros hiciera impracticable repartir los pesos entre muchos racks, el mercado preferiría capacidad concentrada con HBM aunque la latencia fuera peor. Tercera: el ángulo de China sigue vacío. En teoría, una ruta SRAM esquivaría el control de exportaciones sobre la HBM avanzada. Pero a 24 de octubre de 2026 no se ha revelado públicamente ningún acelerador chino de decodificación SRAM en producción en masa, y hay que afirmar exactamente esa ausencia. Como análisis, las razones son estructurales: un die cargado de SRAM consume mucha superficie, con 500 MB por LP30 ya en 4 nm; necesita lógica avanzada, también restringida; y la ventaja real es el compilador determinista, no la celda de memoria.
Chase's Take
La decodificación es un negocio de latencia; el entrenamiento, de capacidad. El muro de memoria se ha partido en dos: un muro de ancho de banda, que decide la decodificación, y un muro de capacidad, que decide entrenamiento, prefill y contexto largo. Cada uno premia un silicio distinto. Ni la HBM está muerta, ni la SRAM es una anécdota.
La nota práctica de EDA y STA es, para mí, la más interesante. Un chip determinista programado por el compilador traslada el problema difícil de la arbitraje en tiempo de ejecución a la planificación en tiempo de compilación. Con 256 chips y enlaces de 350 ns, el rack entero es un único problema gigante de análisis de temporización estática. Quien posee el compilador, posee la arquitectura. Por eso el acuerdo de diciembre de 2025 importa tanto como el silicio.
Implicaciones
Para la HBM, la implicación es de composición, no de volumen total. El crecimiento ligado a entrenamiento y prefill permanece, sostenido por el Trn3 UltraServer y por compromisos reportados en octubre de 2026. El de la inferencia empieza a tener un techo parcial donde pagar por latencia compensa desplegar racks de SRAM.
Para las foundry, un nodo maduro pero avanzado, como el de 4 nm, puede capturar valor nuevo: cada rack LPX son 256 chips de un solo fabricante. Para los hiperescaladores, la adopción dependerá menos del transistor y más de si TorchNeuron reduce el coste de portar cargas reales de PyTorch.
La verificación es concreta: envíos de racks LPX en los resultados del cuarto trimestre de 2026, cuota de Groq como empresa independiente frente a su diseño licenciado dentro de NVIDIA, un segundo laboratorio de frontera en Trainium tras TorchNeuron, y cuánta decodificación deja la siguiente Rubin en la GPU. Hasta entonces, la división es la mejor lectura de los hechos, no una certeza cerrada.
Preguntas frecuentes
¿Sustituirá la SRAM a la HBM en la inferencia de IA? No por completo. La SRAM gana en la decodificación sensible a la latencia, pero el propio diseño de NVIDIA mantiene el prefill de contexto largo y la atención de la decodificación en GPU con HBM. La sustitución es parcial y ocurre dentro del mismo rack, no como un reemplazo total de una memoria por otra.
¿Por qué la SRAM es mucho más rápida pero almacena mucho menos? Porque está integrada en el propio die, junto a la lógica, y no necesita salir del chip hacia paquetes de memoria apilada. Esa cercanía da 150 TB/s por chip en el LP30, pero la superficie del die es limitada: 500 MB por chip y 128 GB por rack LPX, frente a los 20,7 TB de HBM de un Trn3 UltraServer, según el cálculo propio a partir de las fichas oficiales.
¿Qué significa la división para Samsung y SK hynix? Para Samsung significa estar en ambos lados: aspira a recuperar cuota de HBM y, a la vez, fabrica en exclusiva el LP30 sin HBM en 4 nm, de modo que parte del riesgo de memoria se convierte en volumen de foundry. Para SK hynix significa una exposición concentrada en la HBM, protegida a corto plazo por el entrenamiento y el prefill, pero con un techo nuevo en el tramo de decodificación de inferencia con latencia premium.
¿Cuándo se podrá comprobar si la división es real? Las primeras pruebas duras llegarán con los datos de envíos del cuarto trimestre de 2026, con la evolución de la cuota de Groq como empresa independiente, con nuevos adoptantes de Trainium para entrenamiento tras TorchNeuron y con la decisión de la próxima generación Rubin sobre cuánta decodificación queda en la GPU. Si esos cuatro indicadores se mueven en la misma dirección, la división dejará de ser una tesis.
Nota: este artículo se basa únicamente en anuncios y materiales oficiales de NVIDIA, Groq, AWS y Samsung y en informaciones fechadas citadas en el texto; las afirmaciones de proveedores se identifican como tales, las cifras reportadas se identifican como reportadas y los cocientes señalados son cálculo propio. No constituye asesoramiento de inversión.
Lecturas relacionadas
- ¿Inferencia de IA sin HBM? La apuesta de Intel con 480 GB de LPDDR5X y…
- Citi mantiene el objetivo de SK hynix en 3 millones de wones: la…
- Intel y su GPU de inferencia, a fondo: por qué el D270 deja el HBM por…
- Samsung vs SK Hynix en SEDEX 2026: dos estrategias para la guerra de la…
- Ascend 950 y su HBM propia: 5 datos sobre la apuesta de 160.000 chips…
📩 ¿Te perdiste el análisis de hoy? Recibe el de mañana en tu correo
Daily Silicon a las 10:30 KST y los puntos clave de resultados e informes, primero. Al suscribirte eliges la newsletter en coreano, inglés o japonés; el análisis en español se publica cada día en el sitio.
Suscribirme gratis →
Gratis · Sin spam · Cancela cuando quieras


