VLSI Korea
Ascend 950 y su HBM propia: 5 datos sobre la apuesta de 160.000 chips de DeepSeek y el cuello de botella de memoria (HBM·SuperPoD)
Huawei apuesta por HBM propia HiBL/HiZQ para el Ascend 950, pero la Atlas 350 llegó con 112GB y 1.4 TB/s frente a los 128GB y 1.6 TB/s de la hoja de ruta. DeepSeek codiseña con TileLang y un supernode de 128 chips.


🆓 Artículo gratuito · Cualquiera puede leerlo gratis
La batalla por el Ascend 950 no se decidirá por el cómputo, sino por el ancho de banda de la HBM de desarrollo propio — y el codiseño de Huawei y DeepSeek es un intento de romper ese cuello de botella con escala.
Resumen en 30 segundos
- Conclusión primero: Huawei anunció en Huawei Connect en septiembre de 2025 que el Ascend 950PR llegaría en el primer trimestre de 2026 y el Ascend 950DT en el cuarto trimestre de 2026, con una cadencia de generación anual.
- Cifras clave: el 950PR fue anunciado con HBM de desarrollo propio HiBL 1.0 de 128GB y 1.6 TB/s, pero la tarjeta comercial Atlas 350, presentada el 20 de marzo de 2026, llegó con 112GB y 1.4 TB/s. La brecha entre la hoja de ruta y las especificaciones comerciales es el primer punto de verificación.
- DeepSeek anunció a través de su WeChat oficial el 30 de septiembre de 2026 que había publicado como código abierto una pila de programación para Ascend que incluye TileLang, junto con una solución conjunta de "supernode" que conecta 128 chips Ascend 950.
- Escala: un informe del 4 de septiembre de 2026 describió que DeepSeek planea un centro de datos de aproximadamente 1GW en Ulanqab, Mongolia Interior, construido en torno a 160.000 o más chips Ascend. Esto es un informe, no un anuncio confirmado de la compañía.
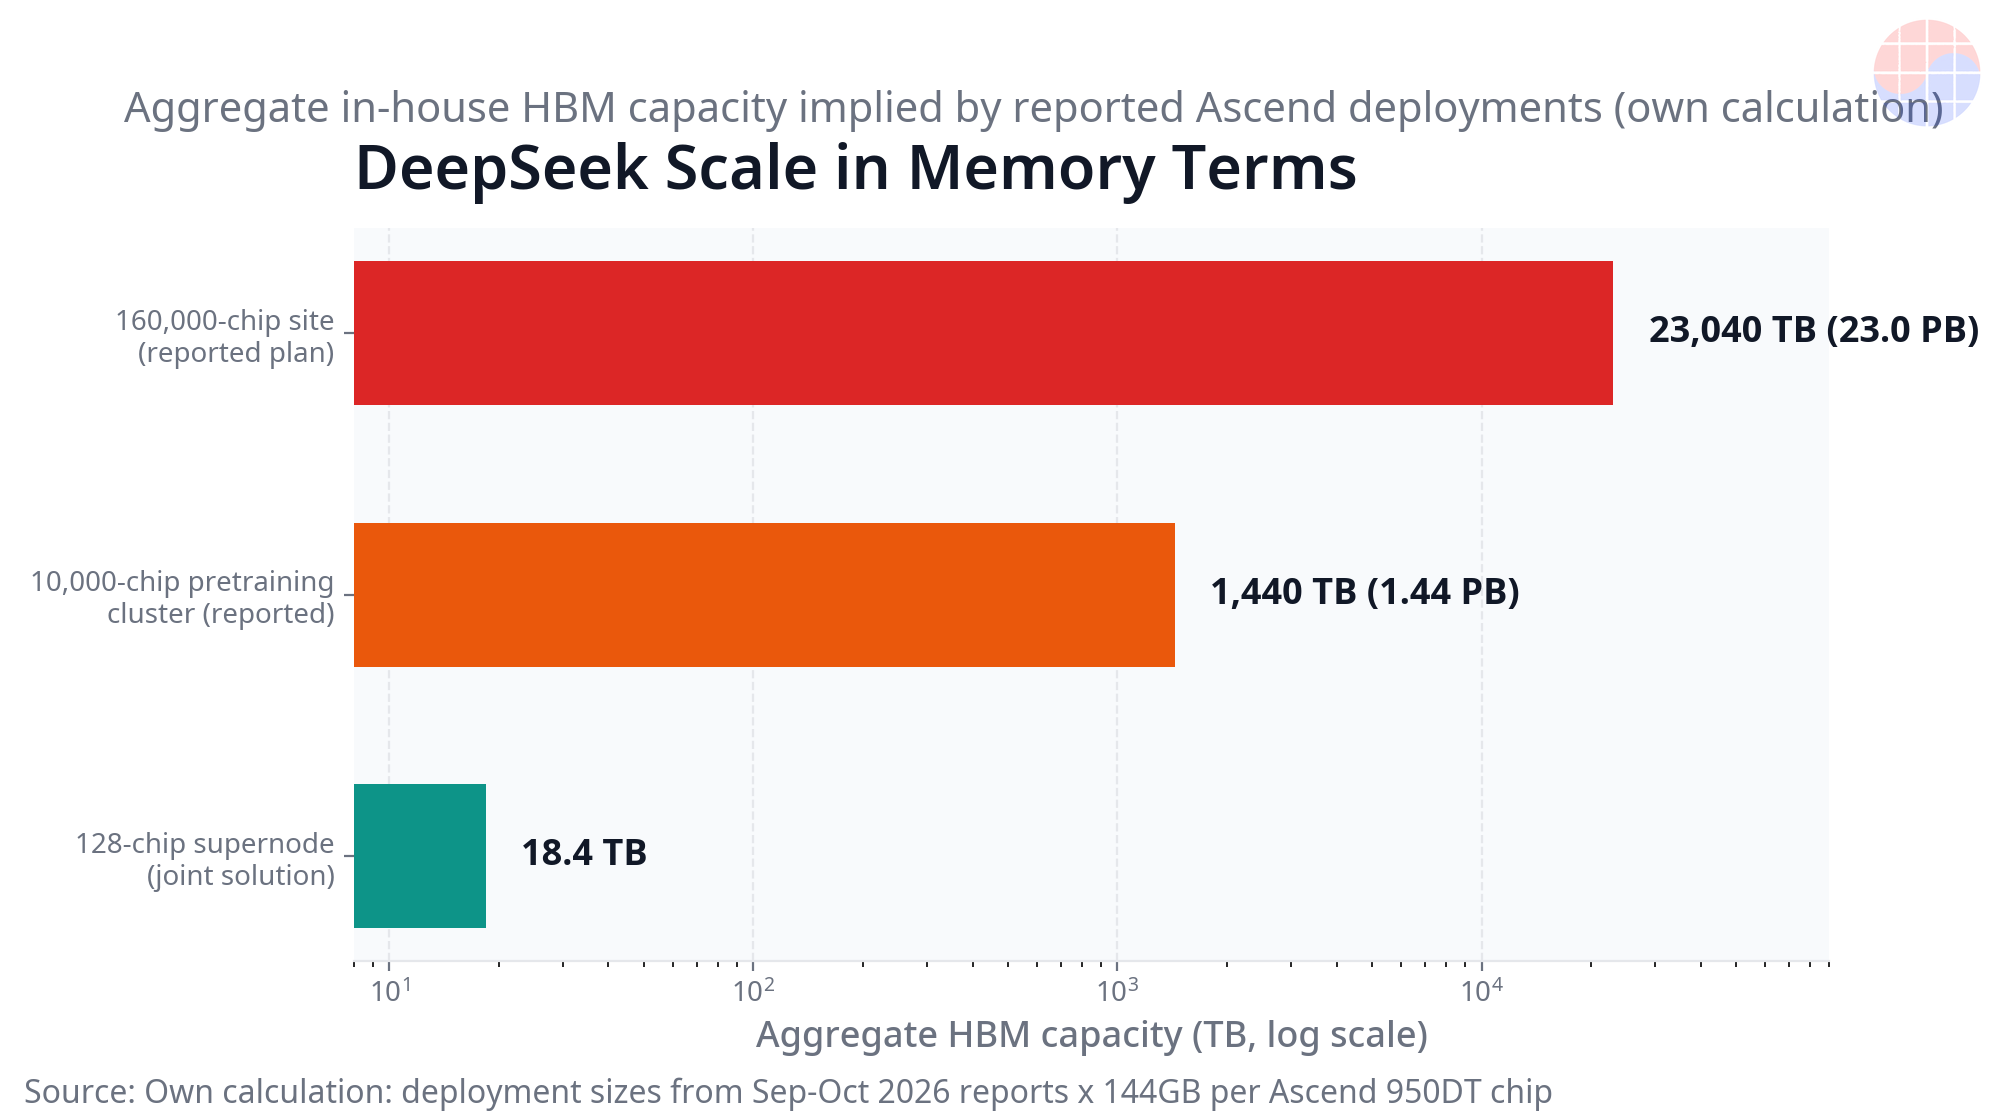
- Cálculo propio: con 144GB por chip 950DT, un sitio de 160.000 chips corresponde a 23.0PB de capacidad total de memoria (cálculo propio).
Contexto
La generación anterior, el Ascend 910C, entró en producción en masa en el primer trimestre de 2025 con aproximadamente 800 TFLOPS de FP16, 3.2 TB/s de ancho de banda de memoria y 128GB de capacidad — utilizando HBM comprada. El mayor cambio en la generación 950 no es el núcleo de cómputo, sino el propio suministro de memoria. Al codiseñar HBM de desarrollo propio — bajo las marcas HiBL 1.0 y HiZQ 2.0 — junto con el die lógico, Huawei traslada la adquisición de memoria desde las cadenas de suministro externas hacia su propia hoja de ruta.
Detrás de este giro están los controles de exportación. La norma HBM del BIS de diciembre de 2024 ya restringe las exportaciones de HBM avanzada a China, por lo que Samsung Electronics y SK hynix no pueden vender HBM a Huawei. Por tanto, una rampa de Ascend no quita directamente pedidos de HBM coreana. La verdadera cuestión es de segundo orden: si la lógica, la memoria y el software maduran todos dentro de China como una única pila de autosuministro, uno de los mayores futuros pools de demanda de HBM podría consolidarse fuera del mercado direccionable — y como un estándar de ecosistema competidor.
El CEO de NVIDIA, Jensen Huang, afirmó en declaraciones públicas de 2026 que las restricciones de exportación de Estados Unidos redujeron la cuota de NVIDIA en el mercado chino de chips avanzados de IA desde alrededor del 95% hasta efectivamente cero, y que las ventas de H200 a China fueron inferiores al 1% de los ingresos de centro de datos en el trimestre finalizado el 26 de julio de 2026. La pregunta central es con qué rapidez — y hasta qué punto — la combinación Huawei–DeepSeek puede llenar ese vacío.
El software se mueve en la misma dirección. TileLang, DeepGEMM, DeepEP, FlashMLA, TileKernels y DeepSelect — publicados como código abierto por DeepSeek — se corresponden uno a uno con sus equivalentes en la pila de NVIDIA, y DeepSeek presenta TileLang como más sencillo de programar que CUDA. El objetivo declarado es un ecosistema de software para GPU independiente y autocontrolado.
Análisis en profundidad
1. Una cadencia anual dividida en dos vías — 950PR para prefill, 950DT para decode y entrenamiento
La conclusión: Huawei no diseñó un solo chip, sino dos variantes de memoria ajustadas para cargas de trabajo diferentes. Según la hoja de ruta presentada por el presidente rotatorio Eric Xu en Huawei Connect en septiembre de 2025, el Ascend 950PR estaba previsto para el primer trimestre de 2026 con 1 PFLOPS de FP8, 2 PFLOPS de FP4, 2 TB/s de interconexión y HBM de desarrollo propio HiBL 1.0 de 128GB y 1.6 TB/s, orientado a prefill más inferencia de recomendación. El Ascend 950DT estaba previsto para el cuarto trimestre de 2026 con 144GB de HiZQ 2.0 a 4.0 TB/s, orientado a decode y entrenamiento. El mismo anuncio situó el Ascend 960 en el cuarto trimestre de 2027 con 288GB y 9.6 TB/s, con aproximadamente el doble de cómputo que el 950, y el Ascend 970 en el cuarto trimestre de 2028 (cifras de hoja de ruta, según el anuncio de Huawei).
2. La tarjeta comercial Atlas 350 frente a la hoja de ruta — las afirmaciones de Huawei deben leerse separadas de los puntos de verificación
La conclusión: el producto comercial se reportó por debajo de las cifras de la hoja de ruta, y toda comparación de rendimiento debe leerse como una afirmación de Huawei. En la Huawei China Partner Conference del 20 de marzo de 2026, el responsable del negocio Ascend, Zhang Dixuan, presentó la Atlas 350, una tarjeta comercial basada en el Ascend 950PR, reportada con 1.56 PFLOPS de FP4, 112GB de HBM propia, 1.4 TB/s de ancho de banda de memoria y 600W. Huawei afirma que esta tarjeta ofrece 2.8x el cómputo FP4 de la H20 de NVIDIA, 1.16x su capacidad HBM y hasta un 60% más de velocidad de generación multimodal. Estas son afirmaciones del fabricante, no benchmarks independientes. La brecha entre la hoja de ruta de septiembre de 2025 (128GB, 1.6 TB/s) y la tarjeta comercial de marzo de 2026 (112GB, 1.4 TB/s) no es un error que ocultar — es el punto de verificación, y la pregunta es si la brecha se cierra en la variante DT.
3. La primera generación de HBM propia fue más lenta que la HBM comprada — ancho de banda a cambio de seguridad de suministro
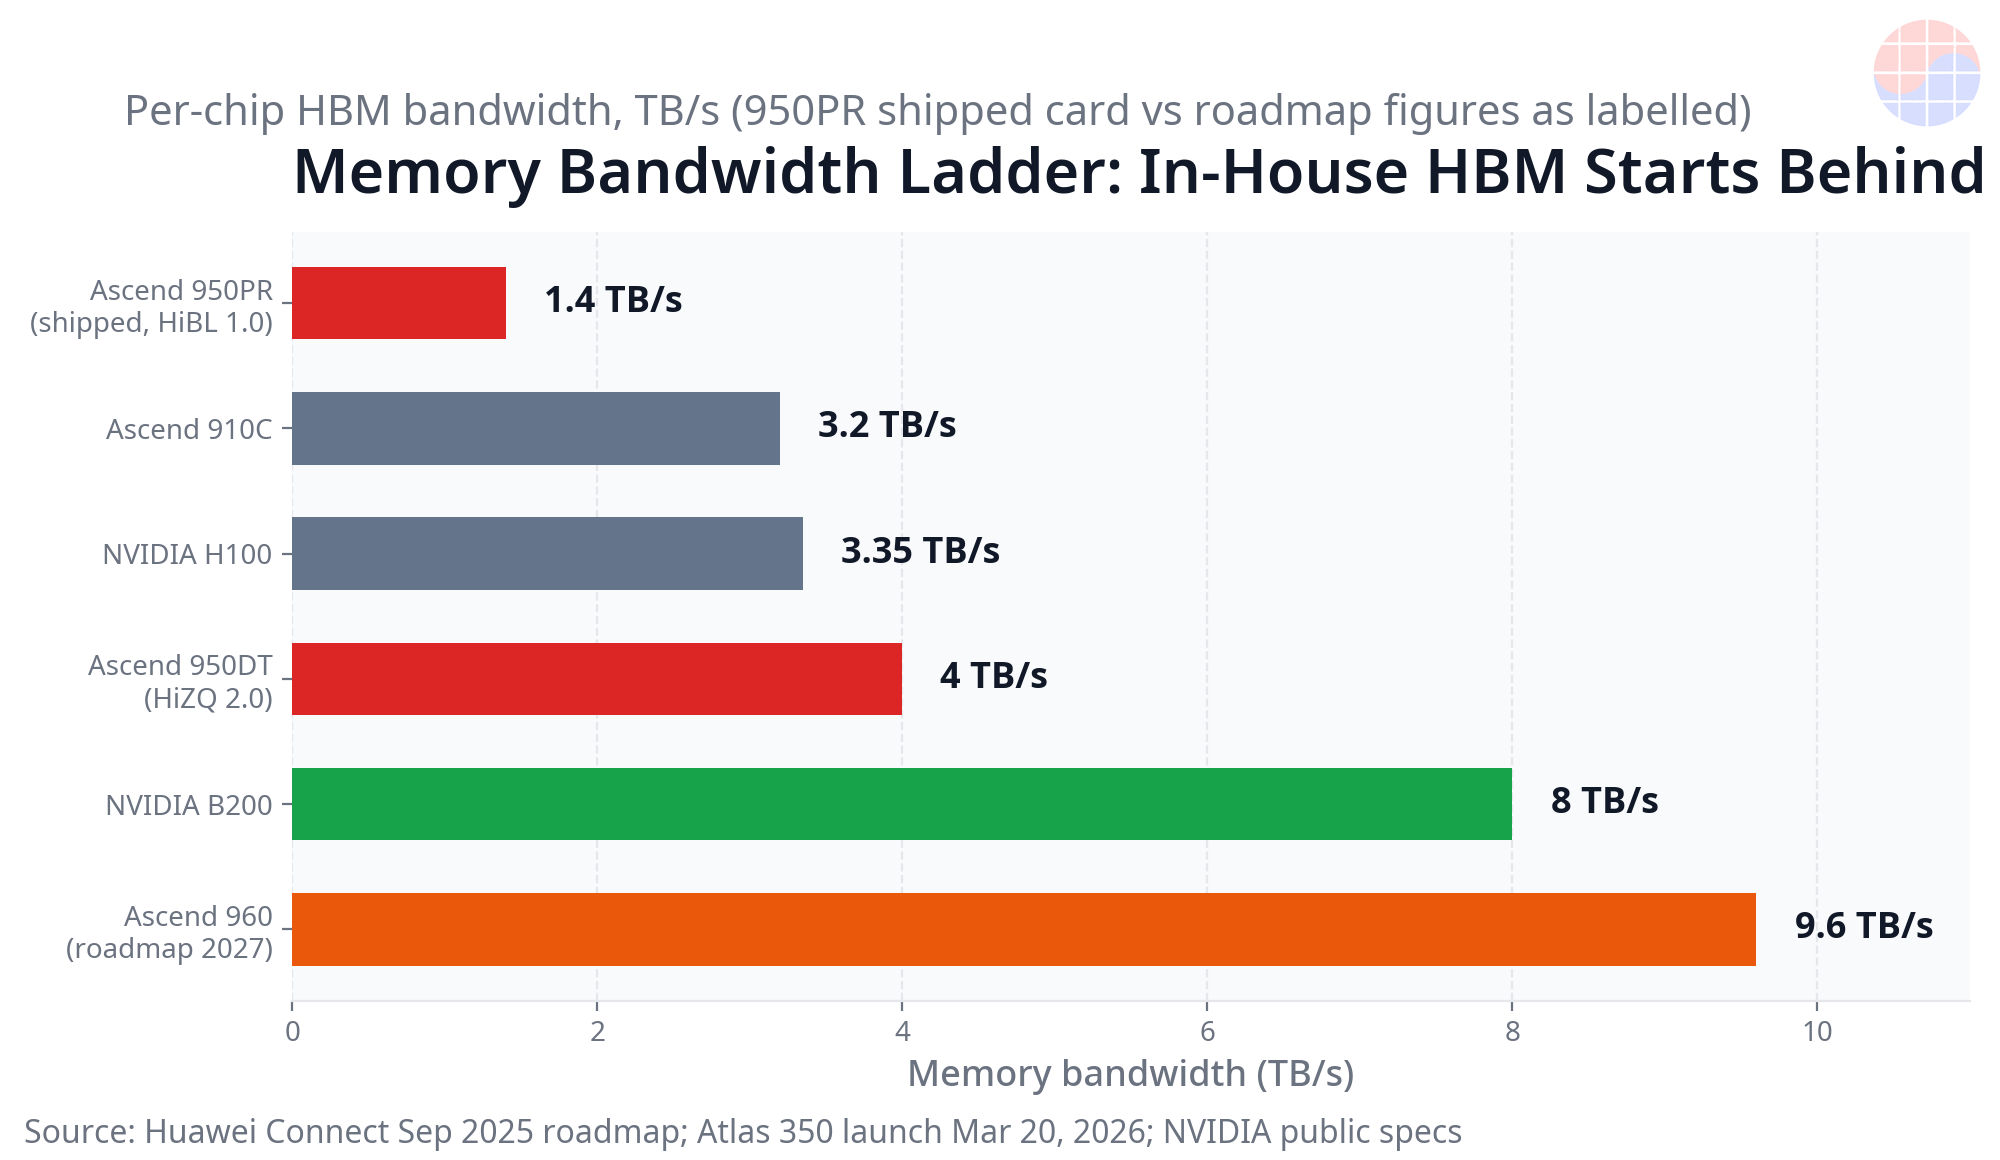
La conclusión: la primera generación de HBM de desarrollo propio retrocede en ancho de banda, y la hoja de ruta solo cierra esa brecha con HiZQ 2.0. La escalera de ancho de banda, elaborada como cálculo propio anclado a las fechas de anuncio, se lee así. El Ascend 910C se situó en 3.2 TB/s (primer trimestre de 2025), el 950PR comercial en 1.4 TB/s (reportado el 20 de marzo de 2026; HiBL 1.0), el 950DT en 4.0 TB/s (previsto para el cuarto trimestre de 2026; HiZQ 2.0) y la hoja de ruta del 960 en 9.6 TB/s (cuarto trimestre de 2027). Como referencia, las especificaciones públicas de NVIDIA sitúan la H100 en 3.35 TB/s y la B200 en 8.0 TB/s. La estructura cómputo-ancho de banda del 950PR comercial — 1.56 PFLOPS de FP4 frente a 1.4 TB/s (cálculo propio) — apunta a la misma conclusión. El prefill consume mucho ancho de banda, por lo que el sistema de memoria del PR es en sí mismo la restricción; esa es exactamente la razón por la que existe la variante DT. En resumen, la primera generación de HBM propia compró control de suministro y lo pagó en ancho de banda.
4. El código abierto de TileLang de DeepSeek y el supernode de 128 chips — el software entró dentro del diseño del chip
La conclusión: DeepSeek dejó de ser solo un cliente y se convirtió en codiseñador, publicando como código abierto la pila de programación y la arquitectura de supernode de forma conjunta. En su anuncio oficial en WeChat del 30 de septiembre de 2026, DeepSeek publicó como código abierto TileLang (un lenguaje de alto nivel y compilador), DeepGEMM, DeepEP, FlashMLA, TileKernels y DeepSelect, en correspondencia uno a uno con sus versiones de la pila de NVIDIA. En el mismo anuncio, con el pleno apoyo de Huawei, ambas compañías presentaron una solución conjunta de "supernode" que conecta 128 chips Ascend 950 y optimiza cómputo y comunicación de forma conjunta. Informes de febrero a abril de 2026 describen que DeepSeek dio a Huawei acceso anticipado a V4 antes que a proveedores estadounidenses, que la vista previa de V4 fue adaptada para chips Huawei, que Huawei afirmó que sus chips se utilizaron en parte del entrenamiento de V4, y que DeepSeek V4-Flash fue optimizado para chips Huawei. Cada uno de estos elementos debe leerse como un informe con fecha.
5. El informe de despliegue de 160.000 chips y el plan de preentrenamiento de más de 10.000 chips — ganar por agregado, no por chip
La conclusión: la respuesta de Huawei no es la paridad por chip, sino la escalada horizontal mediante SuperPoD y SuperCluster, con DeepSeek reportado como la demanda ancla. En el anuncio de Huawei de septiembre de 2025, el Atlas 950 SuperPoD agrupa 8,192 NPU Ascend en una sola unidad lógica en el cuarto trimestre de 2026, y el Atlas 960 SuperPoD escala hasta 15,488 NPU en el cuarto trimestre de 2027. La escala de SuperCluster fue anunciada en más de 500.000 chips para la generación 950 y más de 1.000.000 para la generación 960. Un informe del 4 de septiembre de 2026 describió que DeepSeek planea un centro de datos de aproximadamente 1GW en Ulanqab, Mongolia Interior, construido en torno a 160.000 o más chips Ascend, con esos chips destinados a cargas de inferencia allí. Un informe del 19 de octubre de 2026 describió a ingenieros de Huawei integrados en las oficinas de DeepSeek incorporando requisitos de entrenamiento al diseño de chips de próxima generación, a DeepSeek planeando iniciar el preentrenamiento en Ascend 950DT para finales de 2026, una ejecución completa que posiblemente necesitaría más de 10.000 chips funcionando durante semanas, y a Huawei con la expectativa de asignar la mayor parte del suministro de Ascend 960DT a DeepSeek, con entregas desde el primer trimestre de 2027. Todo esto son informes, no anuncios confirmados. Convertido como cálculo propio: con 144GB por chip 950DT, un supernode de 128 chips alberga 18.4TB, un clúster de preentrenamiento de 10.000 chips alberga 1.44PB de capacidad con 40 PB/s de ancho de banda de memoria agregado (a 4.0 TB/s por chip), y un sitio de 160.000 chips alberga 23.0PB. Estimaciones independientes de terceros sitúan el cómputo bruto de la B300 de NVIDIA en aproximadamente 7x el de un solo chip Ascend 950 — una estimación — por lo que la brecha por chip sigue siendo grande, incluso cuando la estrategia traslada la contienda a la escala del sistema.
La opinión de Chase
El cuello de botella se desplazó. En FP4 y FP8, los dies lógicos están lo suficientemente cerca de ser buenos para inferencia; las restricciones vinculantes son ahora el ancho de banda de memoria por chip, la madurez del software de entrenamiento a escala de 10.000 chips y el volumen. Desde el punto de vista de un profesional de STA/EDA, el chip en sí rara vez es lo primero que falla — es la memoria y la interconexión alrededor del chip, y si el entrenamiento se mantiene estable durante semanas en lugar de días a esa escala. Yo daría menos peso a las cifras principales de cómputo y más a los registros de estabilidad de la tercera semana, que son los que no llegamos a ver.
SuperPoD es un intercambio a nivel de sistema: aceptar la brecha por chip y ganar por agregado mediante interconexión más software codiseñado con el cliente ancla. Que los requisitos de ingeniería de DeepSeek fluyan directamente al diseño de chips de Huawei refleja el patrón de codiseño hyperscaler-ASIC. Cuando la demanda define la especificación, el desperdicio de la hoja de ruta se reduce — pero también se reduce la póliza de seguro, porque el silicio se ajusta a las cargas de trabajo de un solo cliente.
Los lectores pueden comprimir la verificación en cuatro preguntas. Primero, ¿se comercializa realmente el 950DT en el cuarto trimestre de 2026 a 4.0 TB/s en producto, no en una hoja de ruta? Segundo, ¿se completa y se divulga la ejecución de preentrenamiento reportada para finales de 2026? Tercero, ¿mantiene TileLang la estabilidad del entrenamiento más allá de 10.000 chips? Cuarto, ¿se cierra la brecha de la tarjeta comercial de 112GB frente a 128GB en la variante DT?
Implicaciones
Para los inversores, esta no es una historia sobre ingresos de HBM coreana que se pierden hoy. Desde la norma de diciembre de 2024, Samsung Electronics y SK hynix no han podido vender HBM avanzada a Huawei de todos modos. La implicación es la reducción del mercado direccionable a largo plazo: si una pila de autosuministro compuesta por lógica Ascend, memoria HiBL/HiZQ y DRAM nacional madura dentro de China, uno de los mayores futuros pools de demanda se consolida en un estándar que los proveedores externos no pueden alcanzar. Un ecosistema de software centrado en TileLang y un estándar de interconexión SuperPoD acelerarían ese bloqueo.
Para la dirección, la variable CXMT pertenece al mismo marco. Si la HBM propia de Huawei cubre el segmento premium pero el volumen de memoria nacional no acompaña, un despliegue de 160.000 chips sigue siendo un plan en papel. Si el volumen sí acompaña, la discusión pasa del rendimiento de un solo chip al coste total de propiedad del centro de datos, la energía y los costes de cambio de software.
Para NVIDIA, las cifras de cuota ya cuentan la historia: según las declaraciones de Jensen Huang en 2026, su posición en el mercado avanzado de China ha desaparecido efectivamente. La contienda se desplaza hacia dentro — hacia quién se convierte en el estándar dentro de China. Si la combinación Huawei–DeepSeek cierra el ciclo de entrenamiento de forma estable, la etiqueta de "alternativa solo para inferencia" ya no se sostiene.
Preguntas frecuentes
P: ¿Cuál es la diferencia entre Ascend 950PR y 950DT? R: Según la hoja de ruta de Huawei de septiembre de 2025, el 950PR estaba previsto para el primer trimestre de 2026 con 128GB de HiBL 1.0 a 1.6 TB/s para prefill e inferencia de recomendación, mientras que el 950DT estaba previsto para el cuarto trimestre de 2026 con 144GB de HiZQ 2.0 a 4.0 TB/s para decode y entrenamiento. La tarjeta Atlas 350 comercializada el 20 de marzo de 2026 fue reportada con 112GB y 1.4 TB/s, por lo que debe seguirse la brecha entre especificación de hoja de ruta y especificación comercial.
P: ¿Está verificada la afirmación de Huawei de 2.8x de rendimiento frente a la H20? R: No. El cómputo FP4 de 2.8x, la capacidad HBM de 1.16x y hasta un 60% más de velocidad de generación multimodal anunciados el 20 de marzo de 2026 son afirmaciones de Huawei, no cifras verificadas de forma independiente. Toda comparación de rendimiento en este artículo está etiquetada como afirmación de Huawei.
P: ¿Está confirmado el despliegue de 160.000 chips de DeepSeek? R: No es un anuncio confirmado. Un informe del 4 de septiembre de 2026 describió un plan de aproximadamente 1GW en Ulanqab, Mongolia Interior, en torno a más de 160.000 chips Ascend, y un informe del 19 de octubre de 2026 describió que DeepSeek planea iniciar el preentrenamiento en Ascend 950DT para finales de 2026. Como cálculo propio, 160.000 chips 950DT corresponden a 23.0PB de capacidad de memoria.
P: ¿Perjudica directamente la rampa de Ascend a Samsung Electronics y SK hynix? R: No en pedidos directos. La norma HBM del BIS de diciembre de 2024 ya prohíbe las exportaciones de HBM avanzada a China, por lo que ninguna de las dos compañías puede vender HBM a Huawei. El riesgo es de segundo orden: una pila china de autosuministro en maduración consolida un futuro pool de demanda de HBM fuera del mercado direccionable, y el progreso de HBM de CXMT es el complemento de volumen a vigilar.
Las cifras de este artículo se basan en anuncios de Huawei, el anuncio de DeepSeek, declaraciones de NVIDIA e informes con fecha según se indica; las comparaciones de rendimiento de Huawei son afirmaciones de Huawei, los elementos de despliegue y preentrenamiento son informes, y las cifras convertidas son cálculos propios.
Lecturas relacionadas
- El cuello de botella oculto de HBM es el test: el muro de inspección…
- Micron abre AATT2 en Taichung: capacidad de encapsulado HBM para 2027…
- ¿Inferencia de IA sin HBM? La apuesta de Intel con 480 GB de LPDDR5X y…
- Micron a fondo: el webinar tecnológico, pieza a pieza — HBM vertical,…
- Samsung apuesta vertical con zHBM y SK hynix crea un nuevo nivel con…
📩 ¿Te perdiste el análisis de hoy? Recibe el de mañana en tu correo
Daily Silicon a las 10:30 KST y los puntos clave de resultados e informes, primero. Al suscribirte eliges la newsletter en coreano, inglés o japonés; el análisis en español se publica cada día en el sitio.
Suscribirme gratis →
Gratis · Sin spam · Cancela cuando quieras