 VLSI Korea
Samsung apuesta vertical con zHBM y SK hynix crea un nuevo nivel con HBF: la disputa por la memoria después de HBM
En SEDEX 2026, Samsung y SK hynix presentaron HBM4E, pero la disputa real es otra: zHBM apila memoria sobre la GPU y HBF crea un nuevo nivel con flash NAND. El cuello de botella ya no es la velocidad, es la distancia.


La conclusión llegó antes que la próxima generación. En SEDEX 2026, Samsung y SK hynix presentaron HBM4E casi al mismo tiempo, pero lo importante estaba al lado de esa memoria: Samsung mostró zHBM, HBM apilada verticalmente encima de la GPU, y SK hynix defendió HBF, un nuevo nivel basado en flash NAND entre HBM y DRAM. Ambas coinciden en el diagnóstico y difieren en la respuesta. El cuello de botella ya no es solo el ancho de banda de memoria. Es la distancia que recorren los datos, la energía que cuesta moverlos y la latencia que aparece cuando la inferencia con contexto largo desborda la HBM.
Samsung apuesta por acortar físicamente la distancia, integrando memoria, foundry y encapsulado. SK hynix apuesta por crear un nivel nuevo y definir su estándar. Una ventaja de velocidad puede desaparecer en doce meses; una posición en un estándar ordena el mercado durante años.
Qué se presentó en SEDEX 2026
SEDEX 2026, la 28.ª edición de la Semiconductor Exhibition, se celebró del 14 al 16 de octubre de 2026 en COEX, en Seúl, con unas 300 empresas participantes. El 15 de octubre se informó que Samsung y SK hynix habían presentado HBM4E, la séptima generación de HBM, una al lado de la otra. No es un concepto lejano: es la extensión inmediata del negocio que hoy concentra la escasez y los pedidos de IA.
La HBM4E de Samsung combina DRAM 1c, de clase 10 nm y sexta generación, con una base die en proceso de foundry de 4 nm. La velocidad por pin es de 14 a 16 Gbps, más de un 20 % por encima de HBM4, y el ancho de banda máximo alcanza 3,6 TB/s, sin romper la arquitectura actual de encapsulado 2.5D/3D.
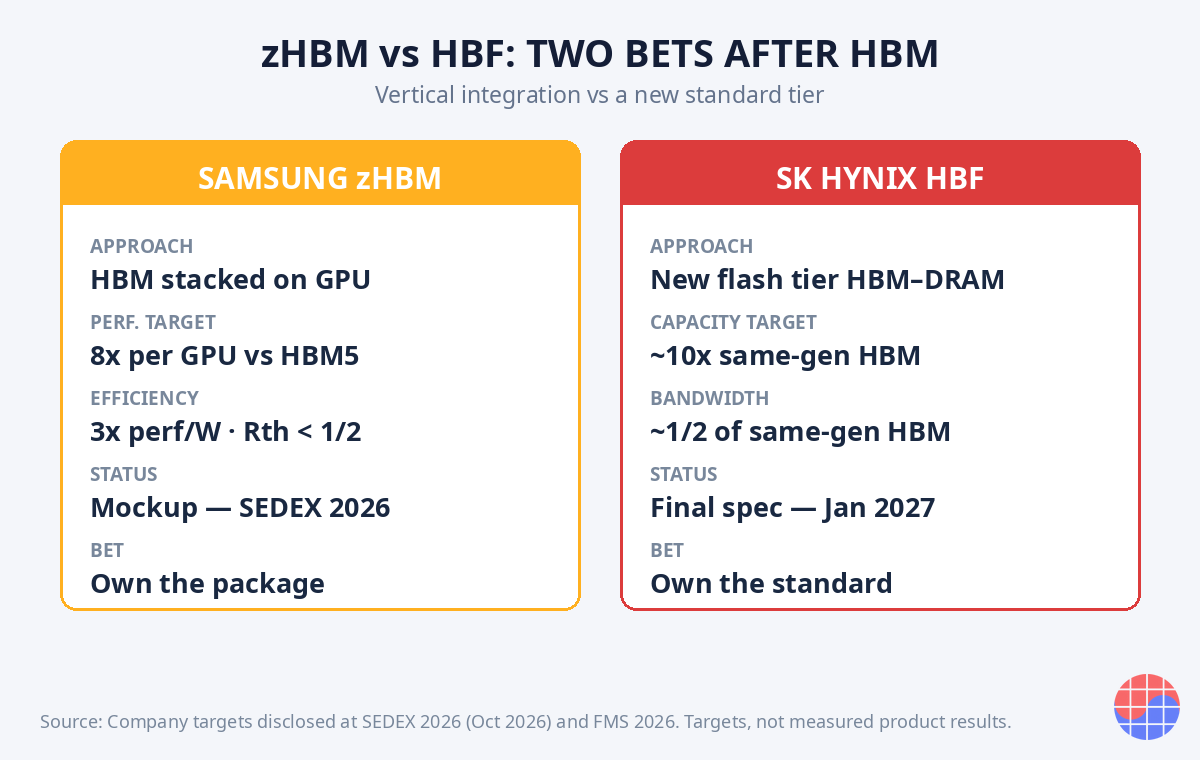
Samsung también enseñó zHBM, todavía en fase de maqueta en SEDEX. La idea se había mostrado por primera vez en FMS 2026, en agosto. zHBM apila HBM encima de la GPU, en lugar de colocarla al lado sobre un interposer. Frente a los objetivos atribuidos a HBM5, plantea hasta 8 veces más rendimiento por GPU, hasta 3 veces más rendimiento por vatio y una resistencia térmica inferior a la mitad. Son metas de diseño, no resultados de un producto en producción, y deben leerse así.
SK hynix eligió otro camino. HBF, High Bandwidth Flash, no intenta sustituir a HBM. Inserta un nuevo nivel entre HBM y DRAM, usando flash NAND para ofrecer un ancho de banda cercano a la mitad del de una HBM de la misma generación y una capacidad aproximada de 10 veces. La estandarización con SanDisk ya comenzó, la primera especificación se publicó en agosto de 2026, la especificación final está prevista para enero de 2027 con socios que incluyen a Google y el lanzamiento de producto apunta a finales de 2027.
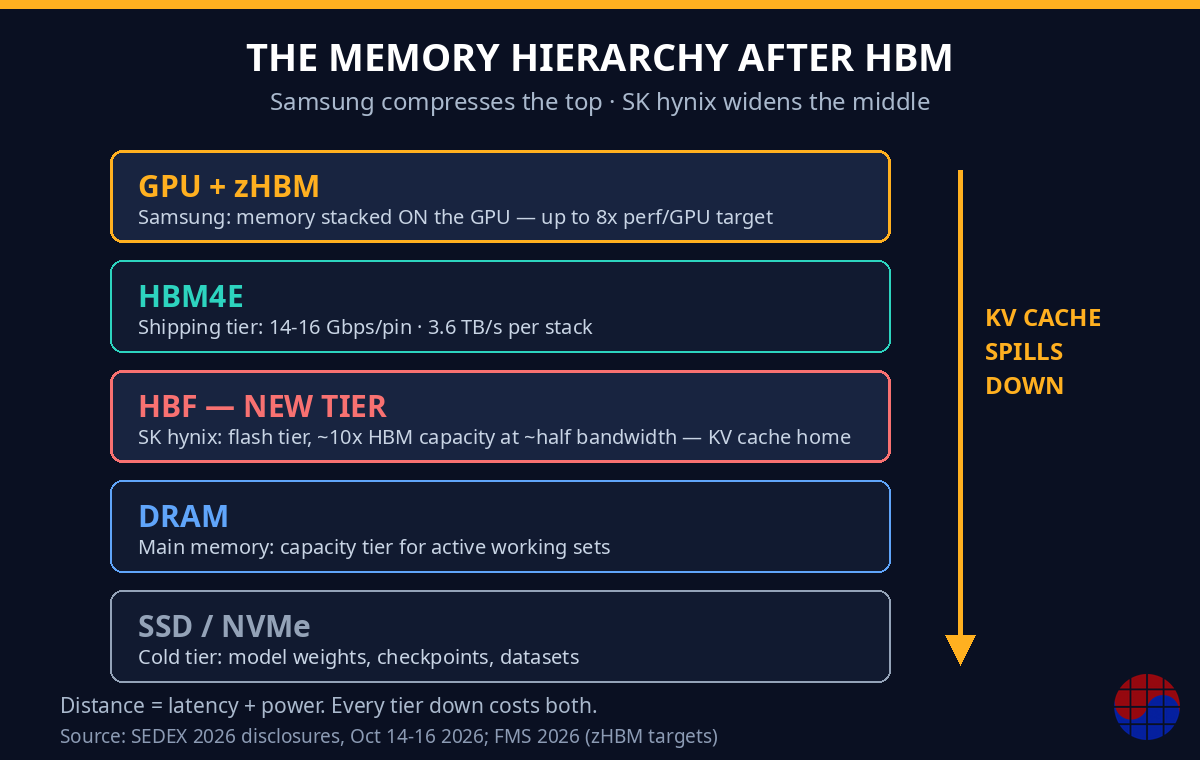
Tabla comparativa: zHBM frente a HBF
| Aspecto | Samsung zHBM | SK hynix HBF |
|---|---|---|
| Enfoque | Vertical: apilar HBM encima de la GPU | Horizontal: crear un nuevo nivel entre HBM y DRAM |
| Problema | Reducir distancia, latencia y energía por dato movido | Aumentar capacidad cerca del cálculo sin pagar el coste completo de HBM |
| Tecnología base | HBM apilada sobre GPU, integración estrecha con encapsulado | Flash NAND organizada como nivel de alto ancho de banda |
| Objetivo declarado | Hasta 8x rendimiento por GPU y 3x por vatio frente a objetivos de HBM5; resistencia térmica menor a la mitad | Ancho de banda cercano a la mitad de HBM de la misma generación, capacidad aproximada de 10x |
| Estado en octubre de 2026 | Maqueta en SEDEX; primera presentación en FMS 2026, en agosto | Primera especificación publicada en agosto de 2026 |
| Próximo hito | Pasar de maqueta a prototipo integrable y validable | Especificación final prevista para enero de 2027 |
| Lanzamiento orientativo | Sin fecha de producto confirmada en los datos presentados | Producto previsto para finales de 2027 |
| Riesgo central | Ruta térmica, rendimiento (yield) del encapsulado y KGD | Controlador, pila de software y adopción del estándar |
| Ventaja si funciona | Paquete integrado de memoria, foundry y encapsulado | Quien define la especificación reparte el mercado del nuevo nivel |
zHBM busca ganar acortando milímetros. HBF busca ganar escribiendo las reglas de una capa que todavía no tiene dueño.
Por qué la distancia se convirtió en el cuello de botella
Durante años, la conversación sobre memoria para IA se resumió en una cifra: cuántos terabytes por segundo puede entregar HBM a una GPU. Esa cifra sigue importando, pero ya no explica todo. En inferencia con contexto largo, el modelo no solo necesita pesos. Necesita mantener y reutilizar la caché KV, que crece con la longitud de la secuencia y con el número de usuarios simultáneos. Cuando esa caché no cabe en HBM, desborda hacia DRAM y después hacia SSD. Cada salto aumenta la latencia y consume energía en mover datos, no en calcular.
En su discurso en SEDEX, el CTO de SK hynix, Ahn Hyun, lo formuló de forma directa: el movimiento de datos entre niveles se ha convertido en el cuello de botella más importante. También proyectó que la infraestructura de IA podría multiplicarse por unas 20 veces hacia 2030. El coste no estará solo en comprar aceleradores, sino en alimentarlos.
Aquí aparece el giro que explica HBF. La inferencia es una carga de lectura intensiva. La flash NAND es débil en escritura frente a DRAM, pero esa debilidad pesa menos cuando domina la lectura repetida de grandes volúmenes. Por eso vuelve a ser útil, no como sustituto de HBM, sino como capa intermedia.
Desde signoff y STA, el cambio es familiar: en un chip importa si las señales llegan a tiempo, con qué consumo y con qué margen. El muro de memoria ya no es solo pines y Gbps. Es topología: dónde está cada dato y cuánta energía cuesta traerlo.
La visión del ingeniero: los problemas reales no son los del titular
zHBM promete lo que todo diseñador quiere: menos distancia. Pero apilar memoria sobre la GPU crea tres problemas inmediatos. El primero es la ruta térmica. Si la HBM queda encima de la GPU, el calor debe atravesar una estructura más compleja o encontrar caminos laterales muy eficientes. Que el objetivo sea reducir la resistencia térmica a menos de la mitad reconoce que el calor es el precio de la proximidad.
El segundo es el rendimiento (yield). En encapsulado avanzado, un buen chip puede perderse por un mal apilado, y KGD se convierte en economía pura: cada die defectuoso detectado tarde destruye más valor en un conjunto más caro. El tercero es la propiedad de la integración: ¿quién es dueño de la interfaz entre GPU y memoria, y quién asume el encapsulado? Samsung puede ofrecer el paquete completo, pero el cliente acepta una dependencia mayor.
HBF tiene el problema inverso. La flash NAND no es el misterio; lo son el controlador, la gestión de desgaste, la corrección de errores y la pila de software que permita a los frameworks de IA usar ese nivel sin reescribir cada aplicación. Por eso la estandarización no es burocracia: es el producto antes del producto. Como ocurre en EDA con PDK y reglas de diseño, quien define el marco define dónde se crea el valor.
Estándar frente a integración: el análisis de negocio
Desde una mirada VLSI+MBA, Samsung compra integración y SK hynix compra posición en un estándar. Si zHBM madura, Samsung no vende solo memoria: vende DRAM, base die, foundry y encapsulado como sistema, difícil de copiar pieza a pieza. Esa lógica ya aparece en HBM4E, puente entre memoria y lógica.
HBF solo crea un mercado grande si otros lo adoptan, aparecen controladores y los hiperescaladores lo prueban, con una especificación final en enero de 2027 lo bastante abierta para generar ecosistema y lo bastante concreta para conservar el liderazgo de SK hynix. Si funciona, la recompensa es duradera: los estándares sobreviven a los liderazgos de una sola generación.
Liderar por velocidad es valioso, pero frágil: HBM4 es superada por HBM4E, y esta por la siguiente iteración. Definir un nivel nuevo cambia la lista de la compra: antes de discutir precio, el cliente ya aceptó que ese nivel debe existir. El riesgo es simétrico: zHBM puede quedarse en maqueta y HBF puede quedarse en una especificación sin adopción.
Lo que todavía genera dinero hoy: HBM4 y HBM4E
El dinero de hoy no está en zHBM ni en HBF. Está en HBM4 y en HBM4E. El contexto lo confirmó TSMC en sus resultados del tercer trimestre de 2026, presentados el 15 de octubre: ingresos de 1,494 billones de NT$ (46.700 millones de US$), beneficio neto de 763.060 millones de NT$, un aumento del 68,7 % interanual, y el mensaje de la dirección de que la demanda de IA todavía supera a la oferta. En la industria también se ha informado de que la escasez de memoria podría persistir hasta 2028.
En un mercado con escasez, 14 a 16 Gbps por pin y 3,6 TB/s son argumentos de calificación frente a clientes que necesitan suministro. Ganar una calificación antes puede valer más que prometer una arquitectura para dentro de tres años.
Samsung también persigue HBM5, con un objetivo informado de producción en masa en 2029 y hybrid bonding para 20 capas o más. Es un plan comunicado, no un hecho cerrado, pero revela la secuencia: monetizar HBM4E ahora y mantener zHBM como opción. Hay que vigilar además a CXMT en DRAM básica: si esa capacidad abunda, el valor se desplazará hacia HBM calificada, encapsulado avanzado y niveles diferenciados.
Qué vigilar a continuación
Primero, la especificación final de HBF en enero de 2027: socios, interoperabilidad y controladores. Segundo, la calificación de HBM4E, el puente entre la feria y los ingresos. Tercero, si zHBM supera la maqueta con un prototipo medible en calor, señal y rendimiento del apilado. Cuarto, el ritmo de CXMT en DRAM básica y si la escasez hasta 2028 se acorta o se extiende.
En octubre de 2026, Samsung sube en vertical para que los datos recorran menos camino; SK hynix se mueve en horizontal para que exista un nuevo camino que otros deban usar. La próxima capa se decidirá en encapsulados, controladores y especificaciones, no solo en laboratorios de DRAM.
Preguntas frecuentes
¿Qué es zHBM de Samsung?
zHBM apila HBM verticalmente encima de la GPU. Se mostró por primera vez en FMS 2026, en agosto, y en SEDEX 2026 estaba en fase de maqueta. Sus objetivos frente a HBM5 llegan hasta 8x rendimiento por GPU, 3x rendimiento por vatio y una resistencia térmica inferior a la mitad.
¿Qué es HBF de SK hynix?
HBF, High Bandwidth Flash, es un nuevo nivel entre HBM y DRAM basado en flash NAND. Apunta a un ancho de banda cercano a la mitad del de HBM de la misma generación y a una capacidad aproximada de 10x. La especificación final está prevista para enero de 2027 y el producto para finales de 2027.
¿Por qué importa tanto el movimiento de datos?
Porque en inferencia con contexto largo la caché KV puede desbordar HBM hacia DRAM y SSD, y cada movimiento extra añade latencia y consumo. El CTO de SK hynix, Ahn Hyun, afirmó en SEDEX que el movimiento de datos entre niveles se ha convertido en el cuello de botella más importante.
¿Qué genera ingresos ahora, zHBM o HBF?
Ninguno de los dos todavía. En octubre de 2026 el negocio inmediato sigue en HBM4 y HBM4E. Samsung anunció para HBM4E 14-16 Gbps por pin y hasta 3,6 TB/s. zHBM es una apuesta de integración futura y HBF apunta a producto a finales de 2027.
Disclosure: Este artículo tiene fines informativos y se basa en datos presentados en SEDEX 2026 (14-16 de octubre de 2026), en la primera especificación de HBF de agosto de 2026 y en los resultados de TSMC del tercer trimestre de 2026 comunicados el 15 de octubre de 2026. Las cifras de zHBM y HBF son objetivos o planes comunicados, no resultados garantizados de productos en producción. El autor trabaja en EDA y signoff; este contenido no es asesoramiento de inversión.


