VLSI Korea
Suy luận chia làm hai: 5 sự thật (Giải mã SRAM so với HBM)
Giải mã theo đuổi độ trễ bằng SRAM không dùng HBM trên Groq 3 LPX, trong khi huấn luyện và prefill vẫn theo đuổi dung lượng HBM trên Trainium3. Bất đối xứng băng thông và dung lượng chia suy luận làm hai.


Suy luận chia làm hai: 5 sự thật (Giải mã SRAM so với HBM)
Suy luận AI nay chia hai: giải mã theo độ trễ bằng SRAM, huấn luyện và prefill theo dung lượng bằng HBM.
Tóm tắt 30 giây
Kết luận là bức tường bộ nhớ nay đã tách thành hai. Với giải mã, tốc độ đọc trọng số từ bộ nhớ gần nhất quan trọng hơn tổng dung lượng. Với huấn luyện, prefill ngữ cảnh dài và attention, dung lượng lớn vẫn quyết định. Bên thắng không còn là một chip cho mọi việc, mà là rack không đồng nhất biết chia việc trong cùng hệ thống.
Bằng chứng đến từ hai hướng ngược nhau. NVIDIA đưa SRAM không dùng HBM vào sản xuất hàng loạt qua Groq 3 LPX. Cùng lúc, AWS củng cố phe HBM bằng Trainium3, Rainier quy mô lớn và TorchNeuron. Cả hai đều đúng vì giải hai bài toán khác nhau.
Với chuỗi cung ứng, Samsung đứng ở cả hai phía, vừa là nhà cung cấp HBM tiềm năng, vừa là foundry duy nhất cho LP30 không dùng HBM. SK hynix vẫn là bên thuần HBM nhất, và nhu cầu đó ngắn hạn không bị giải mã SRAM cắt giảm.
Bối cảnh
Nhiều năm qua, tranh luận về bộ tăng tốc AI luôn quay về một câu hỏi: gắn được bao nhiêu HBM quanh chip logic. Mô hình lớn lưu hàng tỷ tham số, mỗi token đều buộc phần cứng đọc lại phần lớn trọng số. Băng thông nhỏ khiến tính toán phải chờ dữ liệu, dung lượng nhỏ khiến mô hình và bộ đệm ngữ cảnh không vừa. HBM giải cả hai bằng cách xếp DRAM rất gần bộ xử lý.
Nhưng huấn luyện và suy luận không có nhu cầu giống nhau, và prefill khác hẳn giải mã. Prefill xử lý toàn bộ prompt cùng lúc, nặng tính toán, cần dung lượng lớn. Giải mã sinh token theo bước nhỏ liên tiếp, cực nhạy độ trễ. Thêm dung lượng không làm bước đó nhanh hơn nếu dữ liệu vẫn đi đường xa.
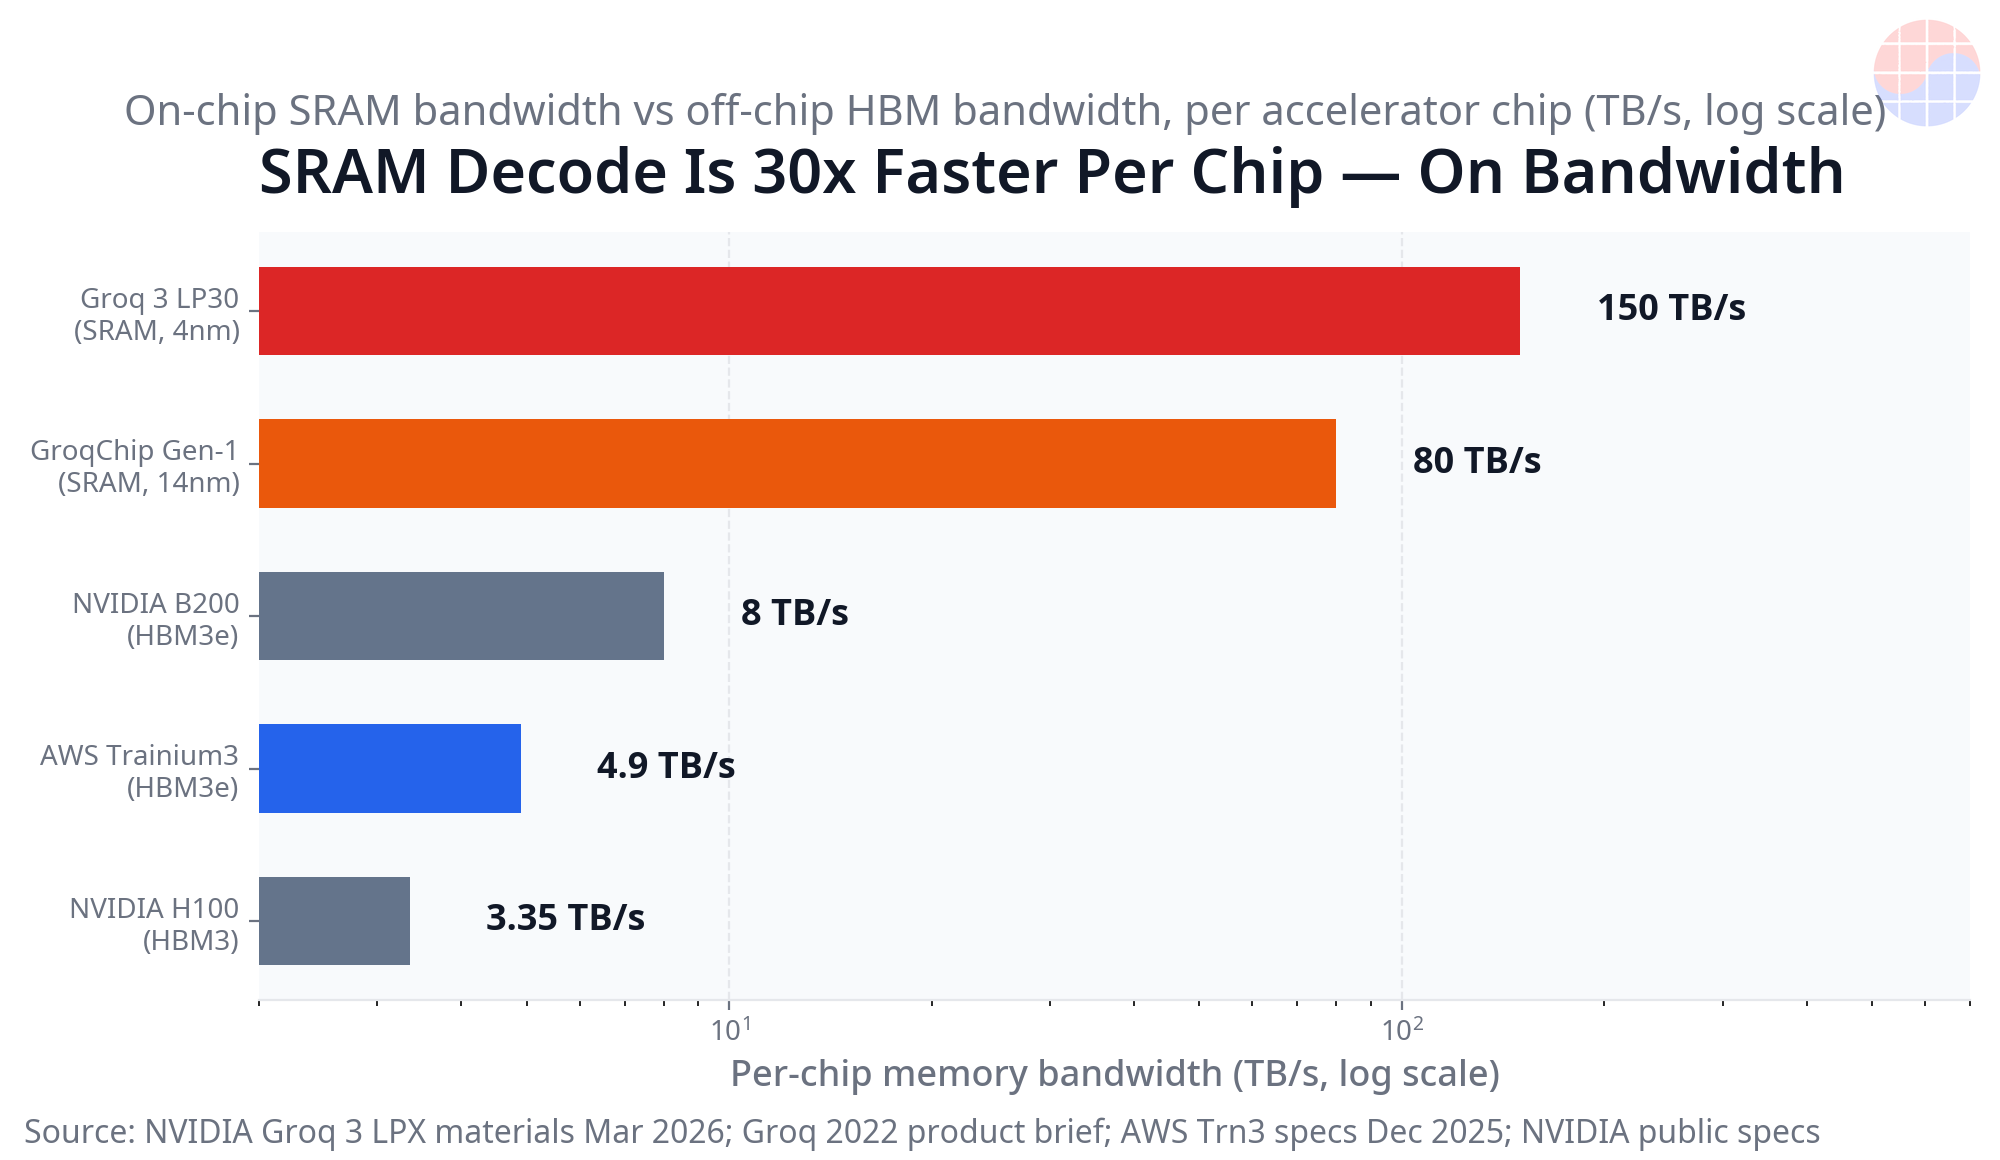
SRAM là đáp án ngược lại: nằm ngay trong die logic, rất gần tính toán, đọc được với băng thông nội bộ cực lớn. Điểm yếu là nền tảng: SRAM ngốn diện tích silic, nên mỗi chip chỉ có hàng trăm megabyte, không phải hàng chục gigabyte như HBM. Thiết kế SRAM phải trải mô hình ra nhiều chip nối bằng mạng độ trễ cực thấp, với lập lịch xác định. GroqChip thế hệ đầu trong tài liệu Groq năm 2022 có SRAM 230 MB, băng thông tới 80 TB/s theo thông số của nhà cung cấp và thực thi xác định do trình biên dịch lập lịch. Ở cực cùng triết lý, Cerebras WSE-3 công bố năm 2024 dùng một tấm wafer, 900.000 lõi, SRAM 44 GB và băng thông 21 PB/s theo công ty.
Phân tích chuyên sâu
Năm sự thật dưới đây tóm tắt điều đã xác nhận, điều vẫn là tuyên bố của nhà cung cấp, và vì sao hai phe cùng tăng trưởng được.
- Sự thật thứ nhất — Groq 3 LPX vào sản xuất hàng loạt và đưa SRAM không dùng HBM lên quy mô rack. Nền tảng là thỏa thuận cấp phép không độc quyền NVIDIA và Groq do Groq công bố ngày 24 tháng 12 năm 2025. Nhà sáng lập Jonathan Ross, chủ tịch Sunny Madra và đội ngũ cốt lõi gia nhập NVIDIA, còn Groq vẫn độc lập dưới CEO Simon Edwards và GroqCloud không thuộc thỏa thuận. Giá trị khoảng 20 tỷ USD là thông tin báo chí được báo cáo tháng 12 năm 2025, không phải số NVIDIA công bố. Chip LP30 có SRAM trên die 500 MB mỗi chip, băng thông SRAM 150 TB/s mỗi chip và không dùng HBM. NVIDIA nêu 96 liên kết chip tới chip ở 112 Gbps, băng thông mở rộng 2,5 TB/s mỗi chip và độ trễ chip tới chip 350 ns. Một rack LPX gồm 256 chip LP30 trong 32 khay, tổng SRAM 128 GB, băng thông tổng hợp 40 PB/s, băng thông mở rộng 640 TB/s và 315 PFLOPS FP8. Trong thiết kế của nhà cung cấp, GPU Rubin xử lý prefill ngữ cảnh dài và attention, còn LPU xử lý feed-forward và MoE nhạy độ trễ. NVIDIA tuyên bố, với tư cách tuyên bố của nhà cung cấp, thông lượng trên mỗi megawatt cao hơn tới 35 lần cho mô hình nghìn tỷ tham số khi LPX đi cùng Vera Rubin NVL72. Tại Hot Chips 2026 ngày 24 đến 25 tháng 8 năm 2026, NVIDIA công bố LPX đã sản xuất hàng loạt. Điểm chuẩn bên thứ ba đầu tiên do NVIDIA báo cáo, trên endpoint Gemma 4 31B tiền phát hành qua Google Cloud với ngữ cảnh 100 nghìn token, mức đồng thời bằng một và trung vị 50 yêu cầu liên tiếp, đạt 3.400 token mỗi giây, khoảng bốn lần nền tảng thay thế gần nhất. Đây là kiểm tra độ trễ một người dùng, không phải thông lượng theo lô. Nebius là khách hàng LPX đầu tiên, và dịch vụ đám mây qua AWS, Google Cloud, Microsoft Azure và Oracle dự kiến nửa cuối 2026 theo NVIDIA. LP30 do Samsung Foundry sản xuất duy nhất trên nút công nghệ 4nm. Tại GTC tháng 3 năm 2026, Jensen Huang nói Samsung sản xuất chip LPU Groq 3 và lô hàng bắt đầu nửa cuối năm, có thể khoảng quý ba. Samsung xác nhận tháng 6 năm 2026 đang sản xuất LP30, và tại OCP 2026, như được báo cáo ngày 13 tháng 10 năm 2026, Samsung trưng bày tấm wafer LPU Groq sản xuất hàng loạt tại Pyeongtaek.
- Sự thật thứ hai — bất đối xứng băng thông và dung lượng là cốt lõi. Theo tính toán riêng, băng thông SRAM 150 TB/s của LP30 bằng khoảng 31 lần HBM3e 4,9 TB/s mỗi chip của Trainium3, và khoảng 45 lần 3,35 TB/s của H100. Ở cấp rack, tính toán riêng cho thấy 40 PB/s của LPX, tức 40.000 TB/s, bằng khoảng 57 lần 706 TB/s của Trn3 UltraServer. Nhưng so sánh đảo ngược ở dung lượng: Trn3 UltraServer có HBM3e 20,7 TB, bằng khoảng 162 lần SRAM 128 GB của một rack LPX. Toán trọng số ở FP8, một byte mỗi tham số, trước bộ đệm KV, làm rõ điều này. Theo tính toán riêng, mô hình 70 tỷ tham số cần 70 GB nên vừa một rack LPX, mô hình 405 tỷ cần 405 GB nên cần tối thiểu bốn rack LPX, và mô hình một nghìn tỷ cần 1.000 GB nên cần tối thiểu tám rack LPX. Cả ba đều vừa một Trn3 UltraServer. Trên GroqChip thế hệ đầu 230 MB, trọng số FP8 70 tỷ tham số đã cần khoảng 305 chip theo tính toán riêng. SRAM mua tốc độ bằng mật độ, chỉ hợp lý cho lát giải mã có giá trị độ trễ cao nhất.
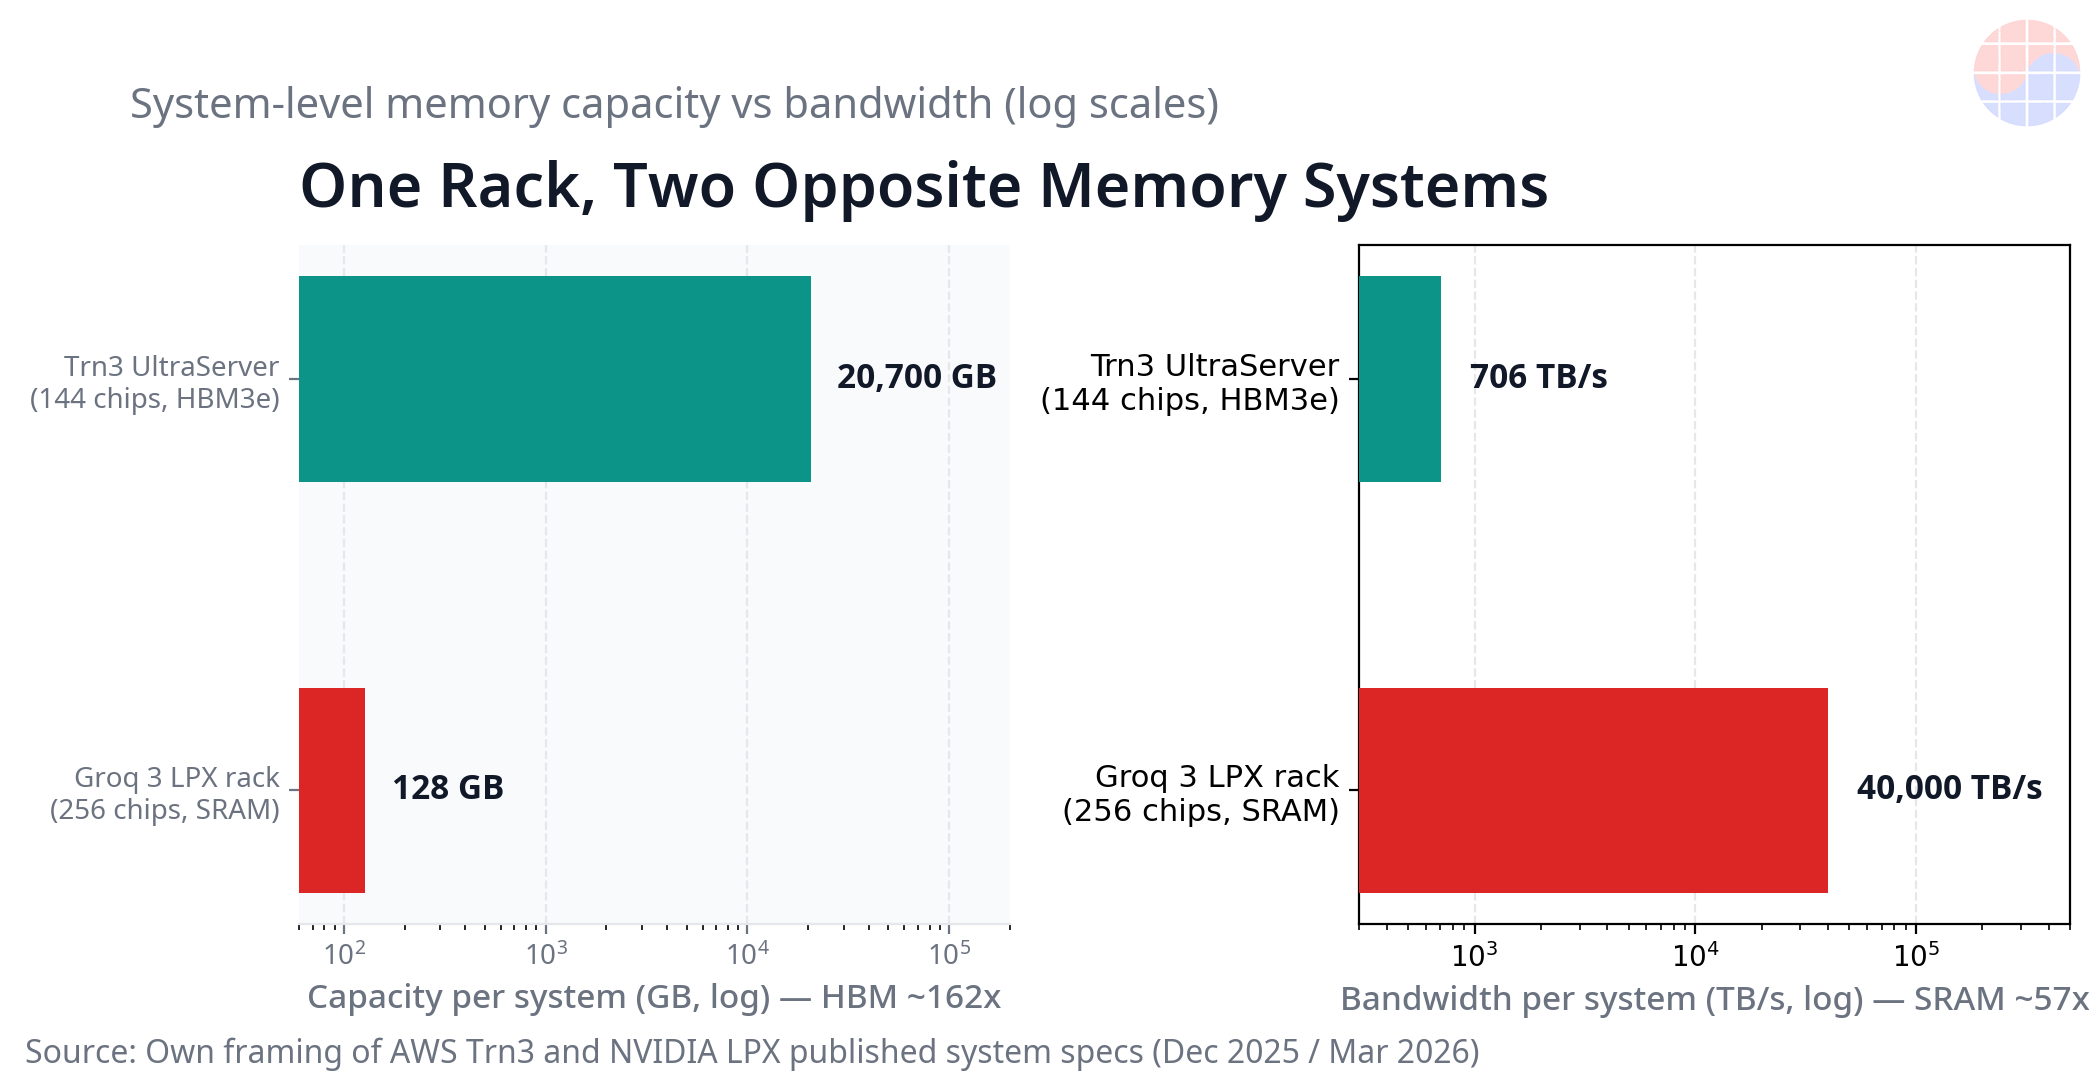
- Sự thật thứ ba — phe huấn luyện dựa trên HBM không yếu đi mà mạnh lên về phần mềm và quy mô. Trainium3 đạt sẵn sàng chung tại re:Invent ngày 2 tháng 12 năm 2025 theo AWS. Chip 3nm của TSMC này cho 2,52 PFLOPS FP8 mỗi chip, HBM3e 144 GB mỗi chip và băng thông 4,9 TB/s. Trn3 UltraServer gồm 144 chip thành 362 PFLOPS FP8, HBM3e 20,7 TB và băng thông tổng hợp 706 TB/s. AWS tuyên bố, với tư cách tuyên bố của nhà cung cấp, tính toán gấp 4,4 lần và băng thông bộ nhớ khoảng bốn lần so với Trainium2. Project Rainier cùng Anthropic đã chạy từ cuối 2025 với khoảng 500.000 chip Trainium2 huấn luyện Claude, hướng tới khoảng một triệu chip. Như được báo cáo tháng 10 năm 2026, Anthropic cam kết hơn 100 tỷ USD trong mười năm cho năng lực AWS, và thỏa thuận 38 tỷ USD của OpenAI gồm khoảng 2 GW năng lực Trainium; cả hai là thông tin báo chí được báo cáo. Yếu tố mới nhất là TorchNeuron, do Amazon công bố ngày 19 tháng 10 năm 2026 và beta công khai ngày 20 tháng 10 năm 2026 tại PyTorch Conference North America. Backend PyTorch gốc mã nguồn mở theo Apache 2.0 này bỏ đường XLA cũ, hỗ trợ eager, torch.compile và FSDP/DTensor.
- Sự thật thứ tư — Samsung đứng ở cả hai phía, còn SK hynix là bên thuần HBM. Samsung đang giành lại thị phần HBM trên nền tảng GPU của NVIDIA, đồng thời là foundry duy nhất cho LP30 không dùng HBM. Dịch chuyển giải mã vì thế biến rủi ro HBM thành khối lượng foundry trên dây chuyền 4nm tại Pyeongtaek. Như minh họa theo tính toán riêng, mỗi rack LPX chứa 256 LPU do Samsung làm, nên một nghìn rack bằng 256.000 LPU; đây là minh họa, không phải dự báo lô hàng. Với SK hynix, bức tranh rất thẳng: huấn luyện và prefill vẫn khát HBM, và Trainium3 mang HBM3e 144 GB mỗi chip. Nhu cầu HBM ngắn hạn không bị giải mã SRAM cắt. Phần bị giới hạn chỉ là chân suy luận của tăng trưởng HBM, ở lát giải mã cao cấp có độ trễ thấp nhất.
- Sự thật thứ năm — luận điểm chia hai có điều kiện bác bỏ rõ ràng. Thứ nhất, giải mã không rời hẳn GPU: attention vẫn ở GPU Rubin dùng HBM, và chia việc xảy ra trong một rack, không phải thắng tuyệt đối của một loại bộ nhớ. Nếu Rubin đời sau tăng tỷ trọng giải mã phía GPU, vai trò LPU có thể thu hẹp. Thứ hai, toán dung lượng ở quy mô nghìn tỷ tham số ép 128 GB mỗi rack LPX nhanh hơn nhiều so với ngăn HBM nhiều terabyte. Thứ ba, hướng Trung Quốc vẫn trống. Về lý thuyết giải mã SRAM tránh được điểm nghẽn kiểm soát xuất khẩu HBM, nhưng tính đến ngày 24 tháng 10 năm 2026 chưa có bộ tăng tốc giải mã SRAM nào của Trung Quốc vào sản xuất hàng loạt được công bố công khai. Lý do mang tính cấu trúc: die nặng SRAM ngốn diện tích, cần năng lực logic nút tiên tiến vốn hạn chế, và lợi thế thật nằm ở trình biên dịch xác định. Nếu một điều kiện đổi trọng yếu, kết luận chia hai phải viết lại.
Chase's Take
Giải mã là kinh doanh độ trễ, huấn luyện là kinh doanh dung lượng. Sai lầm phổ biến nhất là coi bức tường bộ nhớ như một bức tường duy nhất. Thực tế nó đã tách thành tường băng thông cho giải mã và tường dung lượng cho huấn luyện. Silic khác nhau thắng ở tường khác nhau.
Ghi chú thú vị nhất nằm ở trình biên dịch. Chip được lập lịch xác định chuyển bài toán khó nhất từ trọng tài phần cứng lúc chạy sang lập lịch lúc biên dịch. Ở 256 chip với liên kết 350 ns, toàn bộ rack là một bài toán phân tích thời gian tĩnh khổng lồ. Ai giữ trình biên dịch, người đó giữ kiến trúc.
Lô hàng LPX phải hiện thành số đơn vị trong cuộc gọi kết quả quý bốn 2026. Groq độc lập phải tiếp tục thắng thị phần đám mây trước chính thiết kế được cấp phép của mình bên trong NVIDIA. Việc dùng Trainium sau TorchNeuron phải cho thấy phòng thí nghiệm frontier thứ hai ngoài Anthropic và OpenAI. Rubin đời sau phải được đọc theo hướng tỷ trọng giải mã phía GPU tăng hay giảm.
Hệ quả
Với hyperscaler, hoạch định năng lực không còn dùng được một tỷ lệ tính toán trên HBM cho mọi tải. Huấn luyện và prefill vẫn cần ngăn HBM lớn. Giải mã tương tác có thể biện minh rack SRAM riêng dù chi phí mỗi gigabyte cao hơn nhiều, vì thứ bán ra là mili giây.
Với nhà cung cấp bộ nhớ và foundry, bản đồ giá trị dịch chuyển mà không xóa bản đồ cũ. HBM vẫn được nâng bởi huấn luyện quy mô Rainier và vai trò GPU trong prefill và attention. Cùng lúc, khối lượng foundry nút tiên tiến đến từ die logic nặng SRAM. Samsung nắm cả hai dòng, SK hynix nắm dòng HBM trực tiếp nhất, TSMC nắm dòng huấn luyện qua Trainium3.
FAQ
Liệu giải mã SRAM có giết chết nhu cầu HBM hay không? Không trong ngắn hạn. Huấn luyện, prefill và attention trong giải mã vẫn cần dung lượng HBM lớn, và thiết kế của chính NVIDIA giữ attention trên GPU Rubin dựa trên HBM. SRAM chỉ giới hạn lát cắt tăng trưởng suy luận nhạy nhất với độ trễ, không phải toàn bộ nhu cầu HBM.
Vì sao SRAM nhanh hơn nhiều cho giải mã nhưng không thay thế hoàn toàn HBM? Vì SRAM nằm trong die logic nên băng thông của nó rất lớn, nhưng dung lượng rất nhỏ và ngốn diện tích. Tính toán riêng cho thấy một rack LPX vượt khoảng 57 lần về băng thông tổng hợp so với Trn3 UltraServer, nhưng thua khoảng 162 lần về dung lượng, nên mô hình lớn và ngữ cảnh dài vẫn cần HBM.
TorchNeuron thay đổi gì cho Trainium? TorchNeuron được công bố ngày 19 tháng 10 năm 2026 cung cấp backend PyTorch gốc mã nguồn mở cho Trainium2 và Trainium3 mà không dùng đường XLA cũ. Thay đổi đó làm giảm chi phí chuyển đổi phần mềm cho huấn luyện, nên quyết định dùng Trainium được quyết định nhiều hơn bởi hiệu năng và dung lượng thay vì buộc phải viết lại ngăn xếp mô hình.
Samsung và SK hynix đứng ở đâu trong sự phân tách này? Samsung đứng ở cả hai phía vì vừa theo đuổi thị phần HBM vừa là foundry duy nhất cho LP30 4nm không dùng HBM, nên dịch chuyển giải mã trở thành khối lượng foundry tại Pyeongtaek. SK hynix là bên hưởng lợi thuần túy nhất ở phía HBM, vốn vẫn được nâng đỡ bởi huấn luyện và prefill quy mô lớn.
Lưu ý: Bài viết này chỉ nhằm mục đích thông tin và không phải khuyến nghị đầu tư. Tuyên bố của nhà cung cấp được nêu là tuyên bố, thông tin báo chí được nêu là được báo cáo kèm ngày tháng, và các phép tính do tác giả thực hiện được nêu là tính toán riêng.
Bài viết liên quan
- Suy luận AI không cần HBM? Canh bạc LPDDR5X 480GB của Intel và cuộc…
- Citi giữ mục tiêu SK hynix 3 triệu won: suy luận AI thúc đẩy nhu cầu…
- Phân tích sâu GPU suy luận Intel: vì sao D270 bỏ qua HBM để dùng…
- Samsung vs SK Hynix tại SEDEX 2026: Hai chiến lược trong cuộc chiến bộ…
- Ascend 950 và HBM tự phát triển: 5 sự thật về canh bạc 160.000 chip của…
📩 Bỏ lỡ phân tích hôm nay? Nhận bản ngày mai qua email
Daily Silicon lúc 10:30 KST cùng các điểm chính từ báo cáo kết quả kinh doanh và phân tích, sớm nhất. Khi đăng ký, bạn chọn bản tin tiếng Hàn, Anh hoặc Nhật; phân tích tiếng Việt đăng mỗi ngày trên trang.
Đăng ký miễn phí →
Miễn phí · Không spam · Hủy bất cứ lúc nào