VLSI Korea
Inferensi Terbagi Dua: 5 Fakta (Decode SRAM vs HBM)
Decode mengejar latensi dengan SRAM tanpa HBM di Groq 3 LPX, sementara pelatihan dan prefill tetap mengejar kapasitas HBM di Trainium3. Asimetri lebar pita versus kapasitas membelah inferensi menjadi dua.


Inferensi Terbagi Dua: 5 Fakta (Decode SRAM vs HBM)
Inferensi AI kini terbagi dua: decode mengejar latensi dengan SRAM, sedangkan pelatihan dan prefill tetap mengejar kapasitas dengan HBM.
Ringkasan 30 Detik
Kesimpulannya, dinding memori kini benar-benar terbelah menjadi dua. Untuk decode, yaitu tahap ketika model menghasilkan token satu per satu, kecepatan membaca bobot dari memori terdekat jauh lebih penting daripada kapasitas total. Untuk pelatihan, prefill konteks panjang, dan attention pada decode, kapasitas besar tetap menentukan. Pemenangnya karena itu bukan satu chip untuk semua pekerjaan, melainkan rak heterogen yang membagi pekerjaan di dalam satu sistem.
Buktinya datang dari dua arah berlawanan. NVIDIA membawa desain SRAM tanpa HBM ke produksi penuh melalui Groq 3 LPX. Pada saat yang sama, AWS memperkuat kubu HBM dengan Trainium3, Project Rainier berskala besar, dan TorchNeuron yang menurunkan hambatan perangkat lunak pelatihan. Keduanya bisa benar bersamaan karena menyelesaikan masalah yang berbeda.
Bagi rantai pasok, ini bukan cerita kalah total. Samsung berada di kedua sisi, sebagai calon pemasok HBM dan sebagai foundry tunggal chip LP30 tanpa HBM. SK hynix tetap eksposur paling murni ke HBM, yang dalam jangka dekat tidak terpotong oleh decode SRAM. Yang berubah hanyalah batas pertumbuhan kaki inferensi dari cerita HBM.
Latar Belakang
Selama bertahun-tahun, perdebatan akselerator AI selalu berujung pada satu pertanyaan: seberapa besar dan seberapa cepat HBM yang dapat dipasang di sekitar chip logika. Alasannya masuk akal. Model besar menyimpan miliaran parameter, dan setiap token memaksa perangkat keras membaca kembali sebagian besar bobot. Lebar pita memori yang kecil membuat unit komputasi menunggu data, sedangkan kapasitas yang kecil membuat model dan cache konteks tidak muat. HBM menjawab keduanya dengan menumpuk DRAM sangat dekat dengan prosesor.
Namun pelatihan dan inferensi tidak memiliki kebutuhan yang sama, dan di dalam inferensi pun prefill berbeda tajam dari decode. Prefill memproses seluruh prompt sekaligus, intensif komputasi, dan diuntungkan oleh kapasitas besar. Decode menghasilkan token berikutnya dalam langkah kecil berurutan yang sangat sensitif terhadap latensi, yang dirasakan pengguna langsung sebagai kecepatan respons. Menambah kapasitas tidak otomatis mempercepat langkah kecil itu jika data tetap menempuh jalur lebih jauh dari chip logika.
SRAM adalah jawaban sebaliknya. SRAM dibangun di dalam die logika, sangat dekat dengan komputasi, dan dapat dibaca dengan lebar pita internal sangat besar. Kelemahannya mendasar: SRAM rakus area silikon, sehingga kapasitas per chip hanya ratusan megabyte, bukan puluhan gigabyte seperti HBM. Desain berbasis SRAM karena itu harus menyebar model ke banyak chip yang terhubung jaringan berlatensi sangat rendah, dengan penjadwalan deterministik. GroqChip generasi pertama dalam dokumen produk Groq tahun 2022 membawa SRAM on-die 230 MB dengan lebar pita on-die hingga 80 TB/s menurut spesifikasi vendor dan eksekusi deterministik yang dijadwalkan compiler. Di ujung ekstrem filosofi yang sama, Cerebras WSE-3 dengan spesifikasi yang diterbitkan pada tahun 2024 memakai satu wafer penuh, 900.000 core, SRAM on-chip 44 GB, dan lebar pita memori 21 PB/s menurut perusahaan. Pertanyaan baru pada tahun 2026 adalah apakah pendekatan itu akhirnya masuk produksi volume di platform pusat data terbesar, sementara kubu HBM justru menguat.
Analisis Mendalam
Lima fakta berikut merangkum apa yang sudah dikonfirmasi, apa yang masih berupa klaim vendor, dan perhitungan sendiri apa yang menjelaskan mengapa kedua kubu dapat tumbuh bersamaan.
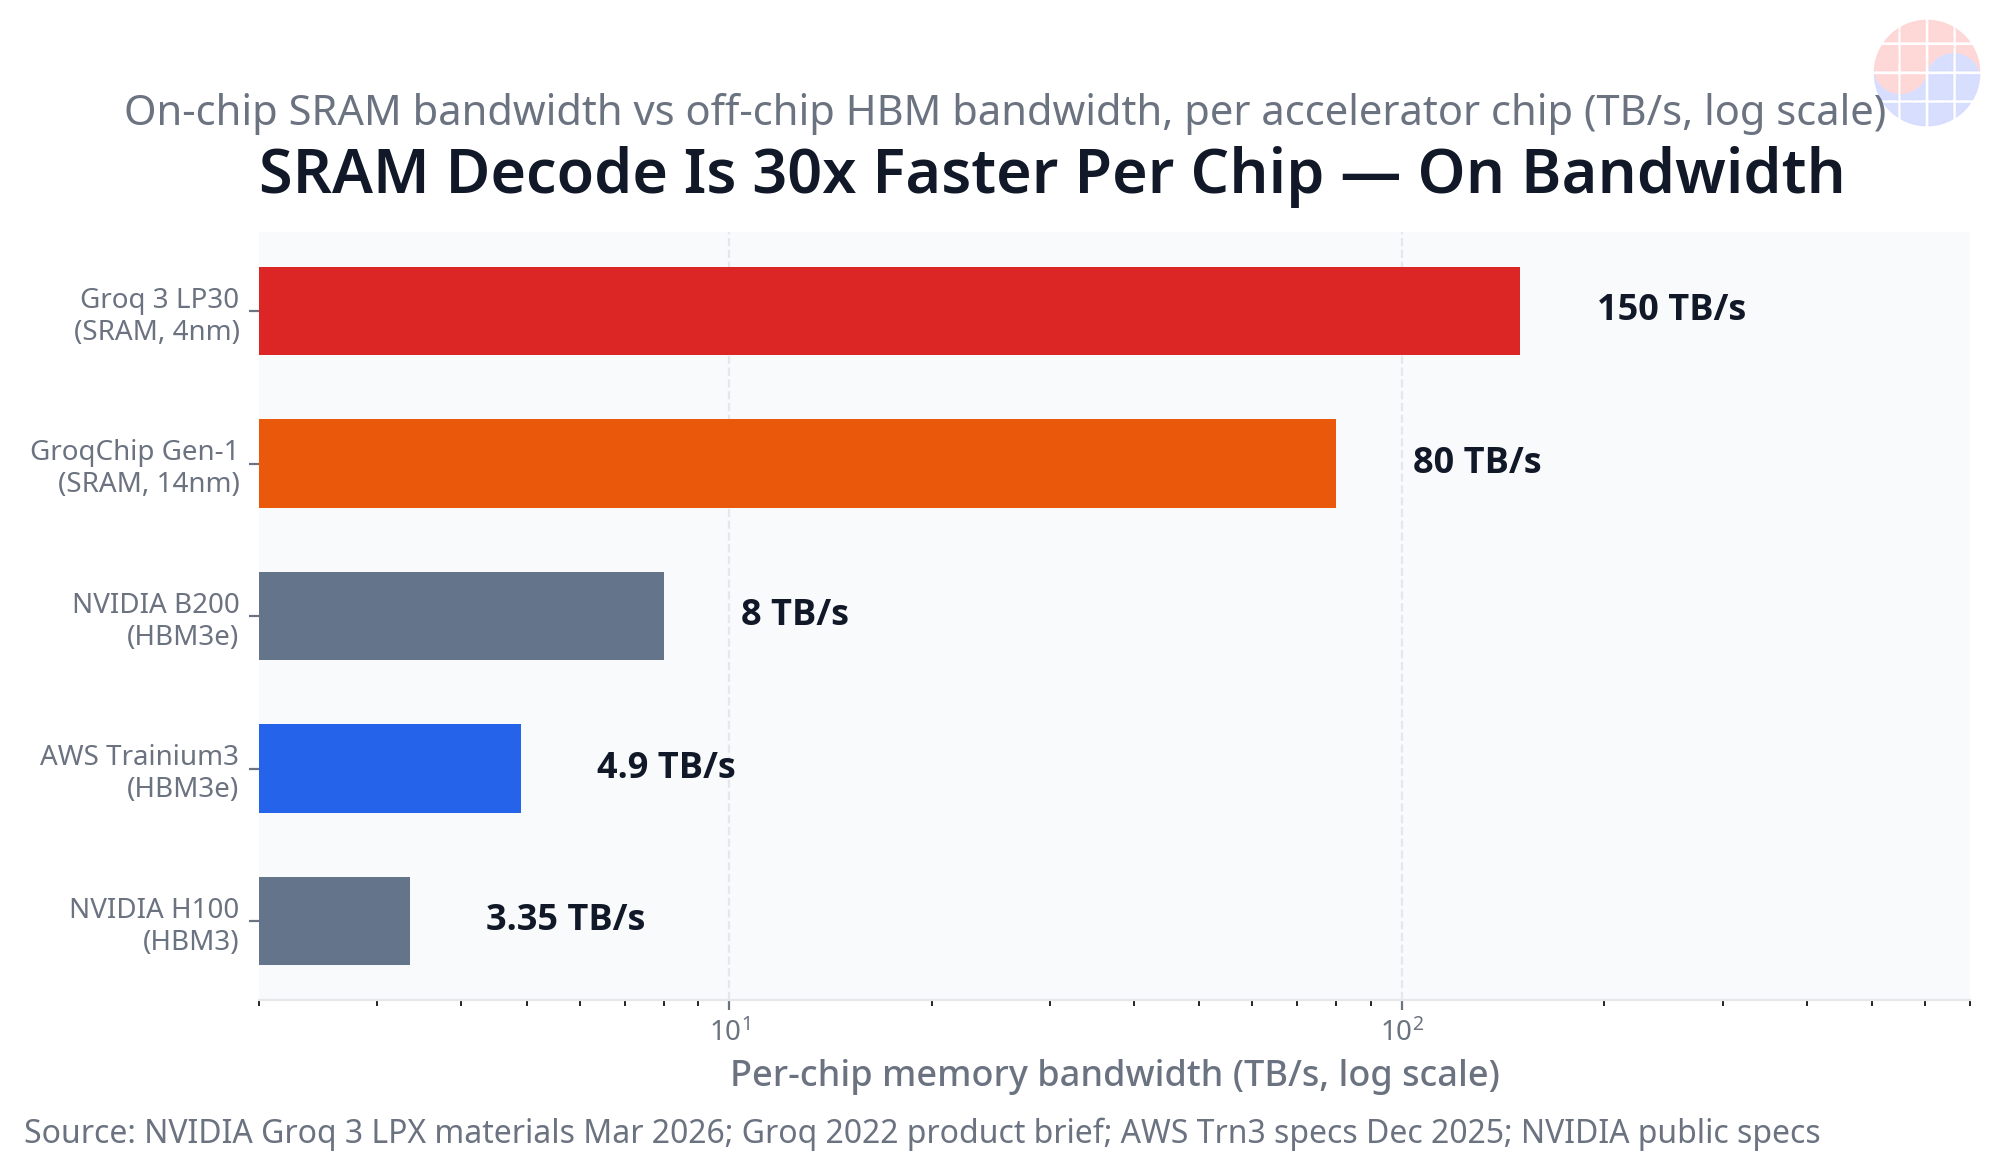
- Fakta pertama — Groq 3 LPX masuk produksi penuh dan membawa SRAM tanpa HBM ke skala rak. Fondasinya adalah perjanjian lisensi non-eksklusif NVIDIA dan Groq yang diumumkan Groq pada 24 Desember 2025. Pendiri Jonathan Ross, presiden Sunny Madra, dan tim inti bergabung dengan NVIDIA, sementara Groq tetap independen di bawah CEO Simon Edwards dan GroqCloud tidak termasuk dalam kesepakatan. Nilai sekitar USD 20 miliar adalah laporan pers yang dilaporkan pada Desember 2025, bukan angka yang diungkapkan NVIDIA. LPX diperkenalkan pada GTC Maret 2026. Chip LP30 membawa SRAM on-die 500 MB per chip, lebar pita SRAM 150 TB/s per chip, dan tanpa HBM. NVIDIA menyebut 96 tautan chip-ke-chip pada 112 Gbps, lebar pita scale-up 2,5 TB/s per chip, dan latensi chip-ke-chip 350 ns. Satu rak LPX berisi 256 chip LP30 dalam 32 tray, dengan total SRAM 128 GB, lebar pita SRAM agregat 40 PB/s, lebar pita scale-up 640 TB/s, dan 315 PFLOPS FP8. Dalam desain platform vendor NVIDIA, GPU Rubin menangani prefill konteks panjang dan attention pada decode, sedangkan LPU menangani feed-forward dan MoE yang sensitif latensi. NVIDIA mengklaim, sebagai klaim vendor, throughput per megawatt hingga 35 kali untuk model triliun parameter saat LPX dipasangkan dengan Vera Rubin NVL72. Pada Hot Chips 2026, 24 sampai 25 Agustus 2026, NVIDIA mengumumkan LPX dalam produksi penuh. Benchmark pihak ketiga pertama yang dilaporkan NVIDIA, pada endpoint Gemma 4 31B pra-rilis via Google Cloud dengan konteks 100 ribu token, konkurensi satu, dan median 50 permintaan berurutan, mencapai 3.400 token output per detik, sekitar empat kali platform alternatif terdekat pada uji itu. Uji tersebut adalah uji latensi pengguna tunggal, bukan uji throughput batch. Nebius adalah pelanggan LPX pertama, dan ketersediaan cloud via AWS, Google Cloud, Microsoft Azure, dan Oracle direncanakan pada paruh kedua 2026 menurut NVIDIA. LP30 diproduksi tunggal oleh Samsung Foundry pada node proses 4nm. Jensen Huang menyatakan pada GTC Maret 2026 bahwa Samsung memproduksi chip LPU Groq 3 dan pengiriman mulai paruh kedua, kemungkinan sekitar kuartal ketiga. Samsung mengonfirmasi pada Juni 2026 sedang memproduksi LP30, dan pada OCP 2026, seperti dilaporkan pada 13 Oktober 2026, Samsung menampilkan wafer LPU Groq yang diproduksi massal di Pyeongtaek.
- Fakta kedua — asimetri lebar pita versus kapasitas adalah inti cerita. Berdasarkan perhitungan sendiri, lebar pita SRAM LP30 sebesar 150 TB/s setara sekitar 31 kali lebar pita HBM3e Trainium3 sebesar 4,9 TB/s per chip, dan sekitar 45 kali lebar pita H100 sebesar 3,35 TB/s. Pada tingkat rak, perhitungan sendiri menunjukkan agregat LPX 40 PB/s, atau 40.000 TB/s, setara sekitar 57 kali total 706 TB/s Trn3 UltraServer. Namun perbandingan berbalik pada kapasitas: Trn3 UltraServer membawa HBM3e 20,7 TB, menurut perhitungan sendiri sekitar 162 kali kapasitas SRAM satu rak LPX sebesar 128 GB. Matematika bobot pada FP8, satu byte per parameter dan hanya bobot sebelum cache KV, memperjelasnya. Menurut perhitungan sendiri, model 70 miliar parameter sebesar 70 GB muat dalam satu rak LPX, model 405 miliar parameter sebesar 405 GB memerlukan minimal empat rak LPX, dan model satu triliun parameter sebesar 1.000 GB memerlukan minimal delapan rak LPX. Ketiganya muat dalam satu Trn3 UltraServer dengan ruang besar. Pada GroqChip generasi pertama 230 MB, bobot FP8 70 miliar parameter saja membutuhkan sekitar 305 chip menurut perhitungan sendiri. SRAM membeli kecepatan dengan mengorbankan kepadatan, dan pembelian itu hanya masuk akal untuk irisan decode yang nilai latensinya tertinggi.
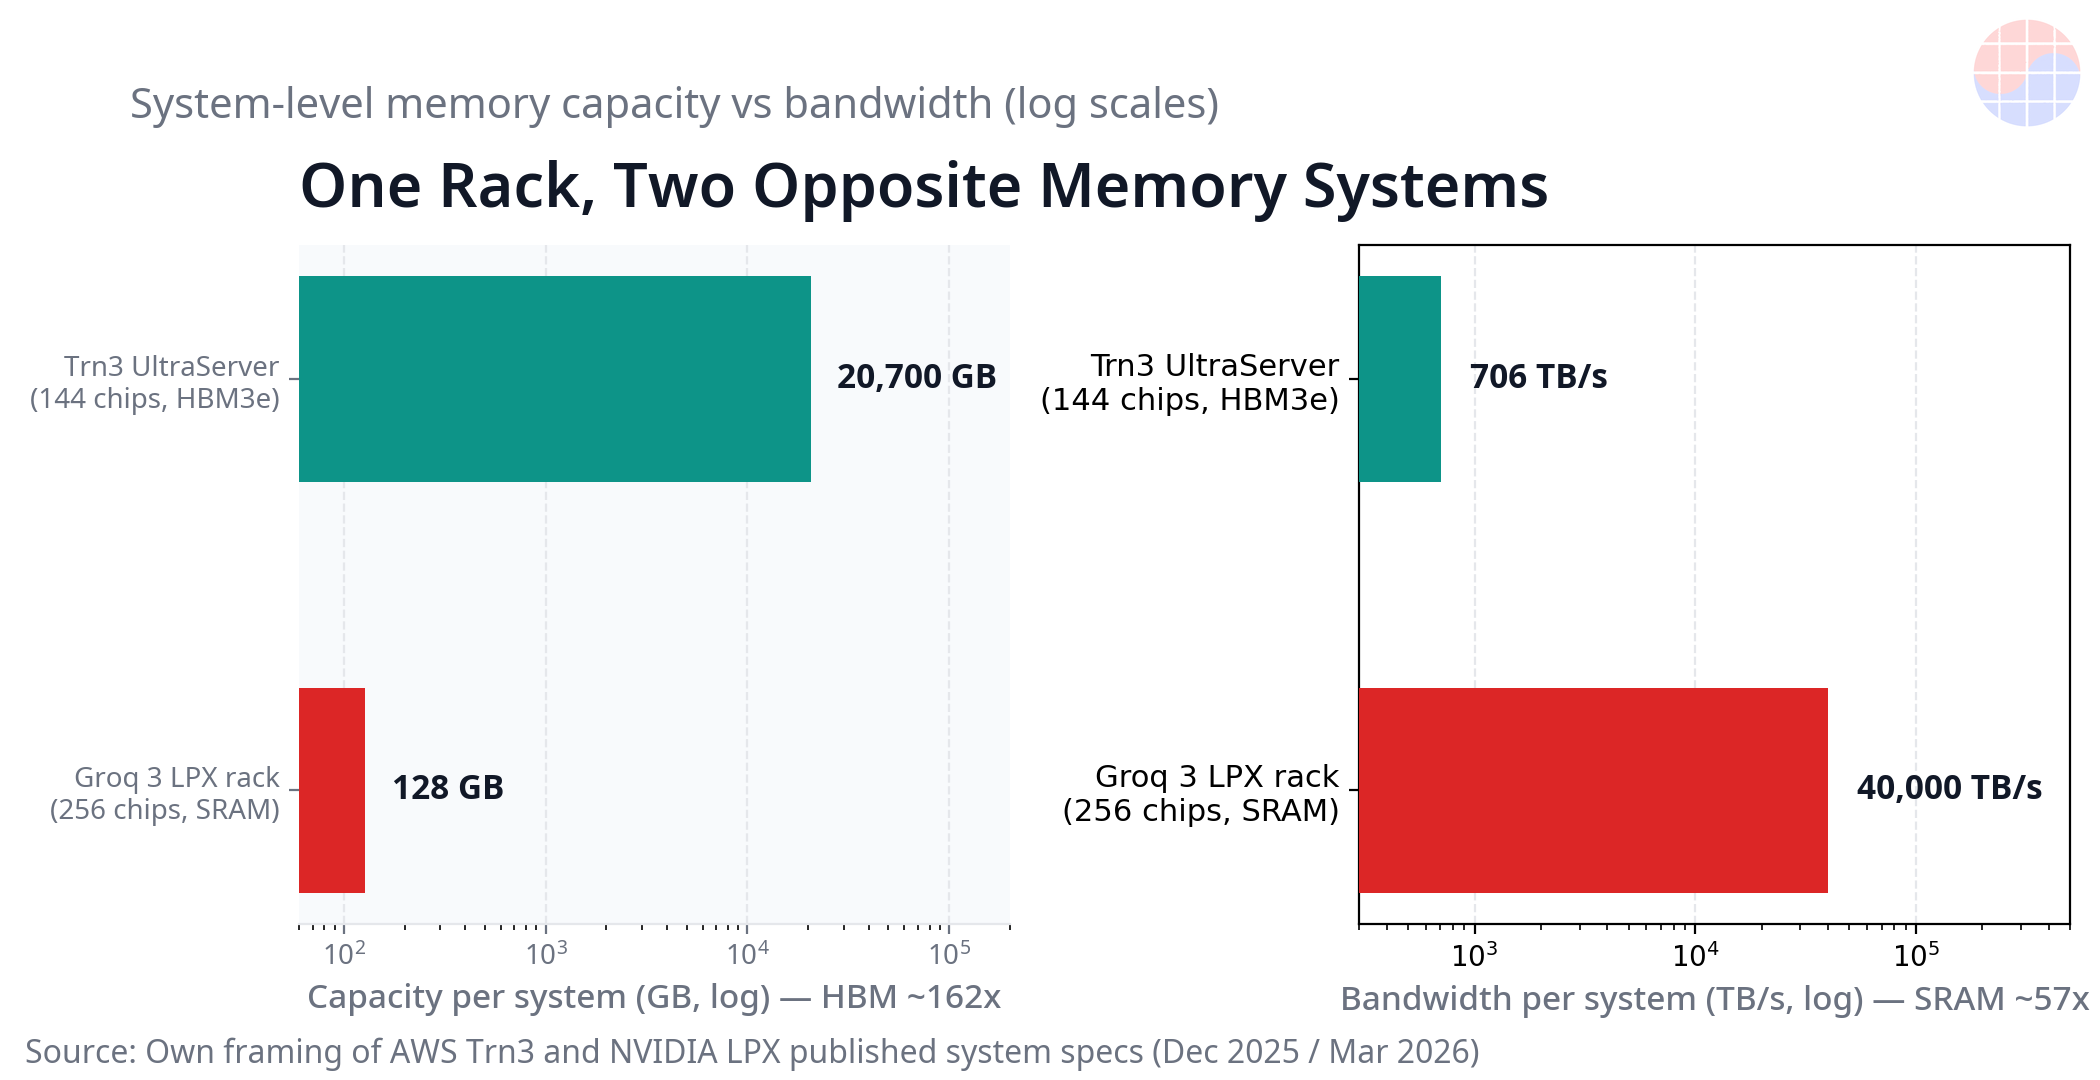
- Fakta ketiga — kubu pelatihan berbasis HBM tidak melemah, melainkan menguatkan perangkat lunak dan skala. Trainium3 mencapai ketersediaan umum pada re:Invent 2 Desember 2025 menurut AWS. Chip 3nm TSMC ini menyediakan 2,52 PFLOPS FP8 per chip, HBM3e 144 GB per chip, dan lebar pita 4,9 TB/s. Trn3 UltraServer menggabungkan 144 chip menjadi 362 PFLOPS FP8, HBM3e 20,7 TB, dan lebar pita agregat 706 TB/s. AWS mengklaim, sebagai klaim vendor, komputasi 4,4 kali dan lebar pita memori sekitar empat kali dibanding Trainium2. Project Rainier bersama Anthropic sudah beroperasi sejak akhir 2025 dengan sekitar 500.000 chip Trainium2 untuk melatih Claude dan berkembang menuju sekitar satu juta chip. Seperti dilaporkan pada Oktober 2026, Anthropic berkomitmen lebih dari USD 100 miliar selama sepuluh tahun untuk kapasitas AWS, dan perjanjian AWS OpenAI senilai USD 38 miliar mencakup sekitar 2 GW kapasitas Trainium; keduanya adalah laporan pers yang dilaporkan, bukan pengungkapan resmi. Penguat terbaru adalah TorchNeuron, diumumkan Amazon pada 19 Oktober 2026 dan beta publik pada 20 Oktober 2026 di PyTorch Conference North America. Backend PyTorch native open-source berlisensi Apache 2.0 untuk Trainium2 dan Trainium3 ini meninggalkan jalur XLA lama, mendukung mode eager, torch.compile, dan FSDP/DTensor. AWS memposisikannya sebagai penghilang hambatan porting perangkat lunak pelatihan. Persaingan pelatihan kini juga soal apakah tim model dapat tetap bekerja di PyTorch tanpa menulis ulang tumpukannya.
- Fakta keempat — Samsung berada di kedua sisi, sedangkan SK hynix adalah eksposur murni HBM. Samsung berusaha merebut kembali pangsa pasar HBM di platform GPU NVIDIA, dan pada saat yang sama menjadi foundry tunggal LP30 yang tidak memakai HBM. Pergeseran decode karena itu mengubah risiko HBM menjadi volume foundry pada lini 4nm yang matang tetapi canggih di Pyeongtaek. Sebagai ilustrasi perhitungan sendiri, setiap rak LPX berisi 256 LPU buatan Samsung, sehingga seribu rak setara 256.000 LPU; angka ini ilustrasi, bukan prakiraan pengiriman. Bagi SK hynix, gambarannya lurus. Pelatihan dan prefill tetap haus HBM, dari Rainier yang bergerak dari sekitar 500.000 chip Trainium2 menuju sekitar satu juta chip, hingga Trainium3 yang membawa HBM3e 144 GB per chip. Permintaan HBM jangka dekat tidak dipotong decode SRAM. Yang dibatasi hanyalah kaki inferensi cerita pertumbuhan HBM, dan hanya untuk irisan decode premium berlatensi terendah. Arsitektur yang diumumkan sendiri tetap menempatkan HBM di pusat pelatihan, prefill, dan attention.
- Fakta kelima — tesis perpecahan ini memiliki syarat pembatalan yang jelas. Pertama, decode tidak sepenuhnya meninggalkan GPU: dalam desain NVIDIA, attention pada decode tetap di GPU Rubin berbasis HBM, dan perpecahan terjadi di dalam satu rak, bukan kemenangan mutlak satu memori. Jika Rubin berikutnya memperbesar porsi decode di GPU, peran LPU dapat menyusut. Kedua, matematika kapasitas pada skala triliun parameter, konteks lebih panjang, dan cache KV yang tumbuh menekan 128 GB per rak LPX jauh lebih cepat daripada tumpukan HBM multi-terabyte. Ketiga, jalur China masih kosong. Secara teori decode SRAM dapat menghindari titik sempit kontrol ekspor HBM, tetapi hingga 24 Oktober 2026 belum ada akselerator decode SRAM asal China yang masuk produksi massal dan diungkapkan publik, dan ketiadaan itu harus dinyatakan persis demikian. Alasannya struktural: die berat SRAM rakus area, membutuhkan kapasitas logika node mutakhir yang terbatas, dan keunggulan sesungguhnya ada pada compiler deterministik, bukan sel memorinya. Jika salah satu syarat ini berubah material, kesimpulan perpecahan harus ditulis ulang.
Chase's Take
Decode adalah bisnis latensi; pelatihan adalah bisnis kapasitas. Kesalahan paling umum adalah memperlakukan dinding memori sebagai satu dinding. Kenyataannya dinding itu terbelah menjadi dinding lebar pita untuk decode dan dinding kapasitas untuk pelatihan, prefill, dan konteks panjang. Silikon berbeda memenangkan dinding berbeda.
Catatan paling menarik bagi praktisi ada pada compiler. Chip yang dijadwalkan compiler secara deterministik memindahkan masalah tersulit dari arbitrase perangkat keras saat runtime ke penjadwalan saat kompilasi. Pada 256 chip dengan tautan 350 ns, seluruh rak adalah satu masalah static timing analysis raksasa. Siapa yang memiliki compiler, dialah yang memiliki arsitekturnya. Determinisme berharga untuk prediktabilitas latensi, tetapi rapuh jika asumsi waktu atau perilaku model berubah, sehingga keunggulan LPX harus dinilai dari ketahanan penjadwalannya di produksi nyata, bukan hanya angka lebar pita.
Daftar verifikasinya jelas. Pengiriman rak LPX harus muncul sebagai angka unit dalam panggilan laba kuartal keempat 2026. Groq independen harus terus memenangkan pangsa inferensi cloud melawan desain berlisensinya sendiri di dalam NVIDIA. Adopsi pelatihan Trainium setelah TorchNeuron harus menunjukkan laboratorium frontier kedua di luar Anthropic dan OpenAI. Generasi Rubin berikutnya harus dibaca dari arah porsi decode di sisi GPU. Tanpa itu, perpecahan masih arsitektur yang meyakinkan, belum pergeseran pasar yang terbukti.
Implikasi
Bagi hyperscaler, perencanaan kapasitas tidak lagi dapat memakai satu rasio komputasi terhadap HBM untuk semua beban kerja. Pelatihan dan prefill konteks panjang tetap membutuhkan tumpukan HBM besar. Decode interaktif yang pendapatannya bergantung pada responsivitas dapat membenarkan rak SRAM khusus meski biaya per gigabyte jauh lebih tinggi, karena yang dijual adalah milidetik, bukan kapasitas. Klaster homogen akan membayar terlalu mahal untuk latensi atau kekurangan kapasitas pada pekerjaan yang salah.
Bagi pemasok memori dan foundry, peta nilai bergeser tanpa menghapus peta lama. HBM tetap ditopang pelatihan berskala Rainier serta peran GPU di prefill dan attention. Bersamaan dengan itu, volume foundry node mutakhir muncul dari die logika berat SRAM. Samsung menangkap kedua arus, SK hynix menangkap arus HBM paling langsung, dan TSMC menangkap arus pelatihan melalui Trainium3. Bagi perancang chip, keunggulan berikutnya kemungkinan datang bukan dari memilih SRAM atau HBM secara ideologis, melainkan dari mempartisi model, menjadwalkan gerakan data, dan membuktikan latensi ujung ke ujung di produksi. Di pasar yang terbagi dua, arsitektur terbaik tahu persis pekerjaan mana yang tidak boleh dilakukannya.
FAQ
Apakah decode SRAM akan membunuh permintaan HBM? Tidak dalam jangka dekat. Pelatihan, prefill, dan attention pada decode tetap membutuhkan kapasitas HBM yang besar, dan desain NVIDIA sendiri mempertahankan attention di GPU Rubin berbasis HBM. SRAM membatasi hanya irisan pertumbuhan inferensi yang paling sensitif terhadap latensi, bukan seluruh permintaan HBM.
Mengapa SRAM jauh lebih cepat untuk decode tetapi tidak menggantikan HBM sepenuhnya? Karena SRAM berada di dalam die logika sehingga lebar pitanya sangat besar, tetapi kapasitasnya sangat kecil dan rakus area. Perhitungan sendiri menunjukkan satu rak LPX unggul sekitar 57 kali dalam lebar pita agregat dibandingkan Trn3 UltraServer, tetapi kalah sekitar 162 kali dalam kapasitas, sehingga model besar dan konteks panjang tetap membutuhkan HBM.
Apa yang berubah dengan TorchNeuron untuk Trainium? TorchNeuron yang diumumkan pada 19 Oktober 2026 menyediakan backend PyTorch native open-source untuk Trainium2 dan Trainium3 tanpa jalur XLA lama. Perubahan itu menurunkan biaya porting perangkat lunak untuk pelatihan, sehingga keputusan memakai Trainium lebih ditentukan oleh kinerja dan kapasitas daripada oleh keharusan menulis ulang tumpukan model.
Bagaimana posisi Samsung dan SK hynix dalam perpecahan ini? Samsung berada di kedua sisi karena mengejar pangsa HBM sekaligus menjadi foundry tunggal LP30 4nm tanpa HBM, sehingga pergeseran decode berubah menjadi volume foundry di Pyeongtaek. SK hynix adalah eksposur paling murni ke sisi HBM, yang tetap ditopang oleh pelatihan dan prefill berskala besar.
Catatan: Artikel ini hanya untuk tujuan informasi dan bukan merupakan rekomendasi investasi. Klaim vendor disebut sebagai klaim, laporan pers disebut sebagai dilaporkan dengan tanggalnya, dan perhitungan yang berasal dari penulis disebut sebagai perhitungan sendiri.
Bacaan terkait
- Ascend 950 dan HBM In-House: 5 Fakta tentang Taruhan 160.000 Chip…
- Inferensi AI tanpa HBM? Taruhan 480GB LPDDR5X Intel dan perang TCO…
- Citi Pertahankan Target SK hynix KRW 3 Juta: Inferensi AI Mendorong…
- Bedah GPU Inferensi Intel: Mengapa D270 Melewatkan HBM demi LPDDR5X 480GB
- Samsung vs SK Hynix di SEDEX 2026: Dua Strategi dalam Perang Memori AI
📩 Melewatkan analisis hari ini? Terima yang besok di email Anda
Daily Silicon pukul 10:30 KST plus poin penting laporan keuangan dan riset, lebih dulu. Saat berlangganan, pilih newsletter Korea, Inggris, atau Jepang; analisis Bahasa Indonesia terbit setiap hari di situs.
Berlangganan gratis →
Gratis · Tanpa spam · Berhenti kapan saja