 VLSI Korea
Ascend 950 dan HBM In-House: 5 Fakta tentang Taruhan 160.000 Chip DeepSeek dan Hambatan Memori (HBM·SuperPoD)
Huawei bertaruh pada HBM in-house HiBL/HiZQ untuk Ascend 950, tetapi Atlas 350 hadir dengan 112GB dan 1.4 TB/s versus roadmap 128GB dan 1.6 TB/s. DeepSeek codesign dengan TileLang dan supernode 128 chip.


🆓 Artikel gratis · Siapa pun dapat membaca artikel ini secara gratis
Pertarungan untuk Ascend 950 tidak akan ditentukan oleh komputasi, melainkan oleh lebar pita HBM in-house — dan codesign Huawei–DeepSeek adalah upaya untuk memecahkan hambatan itu dengan skala.
Ringkasan 30 detik
- Kesimpulan terlebih dahulu: Huawei mengumumkan di Huawei Connect pada September 2025 bahwa Ascend 950PR akan tiba pada Q1 2026 dan Ascend 950DT pada Q4 2026, dengan irama generasi tahunan.
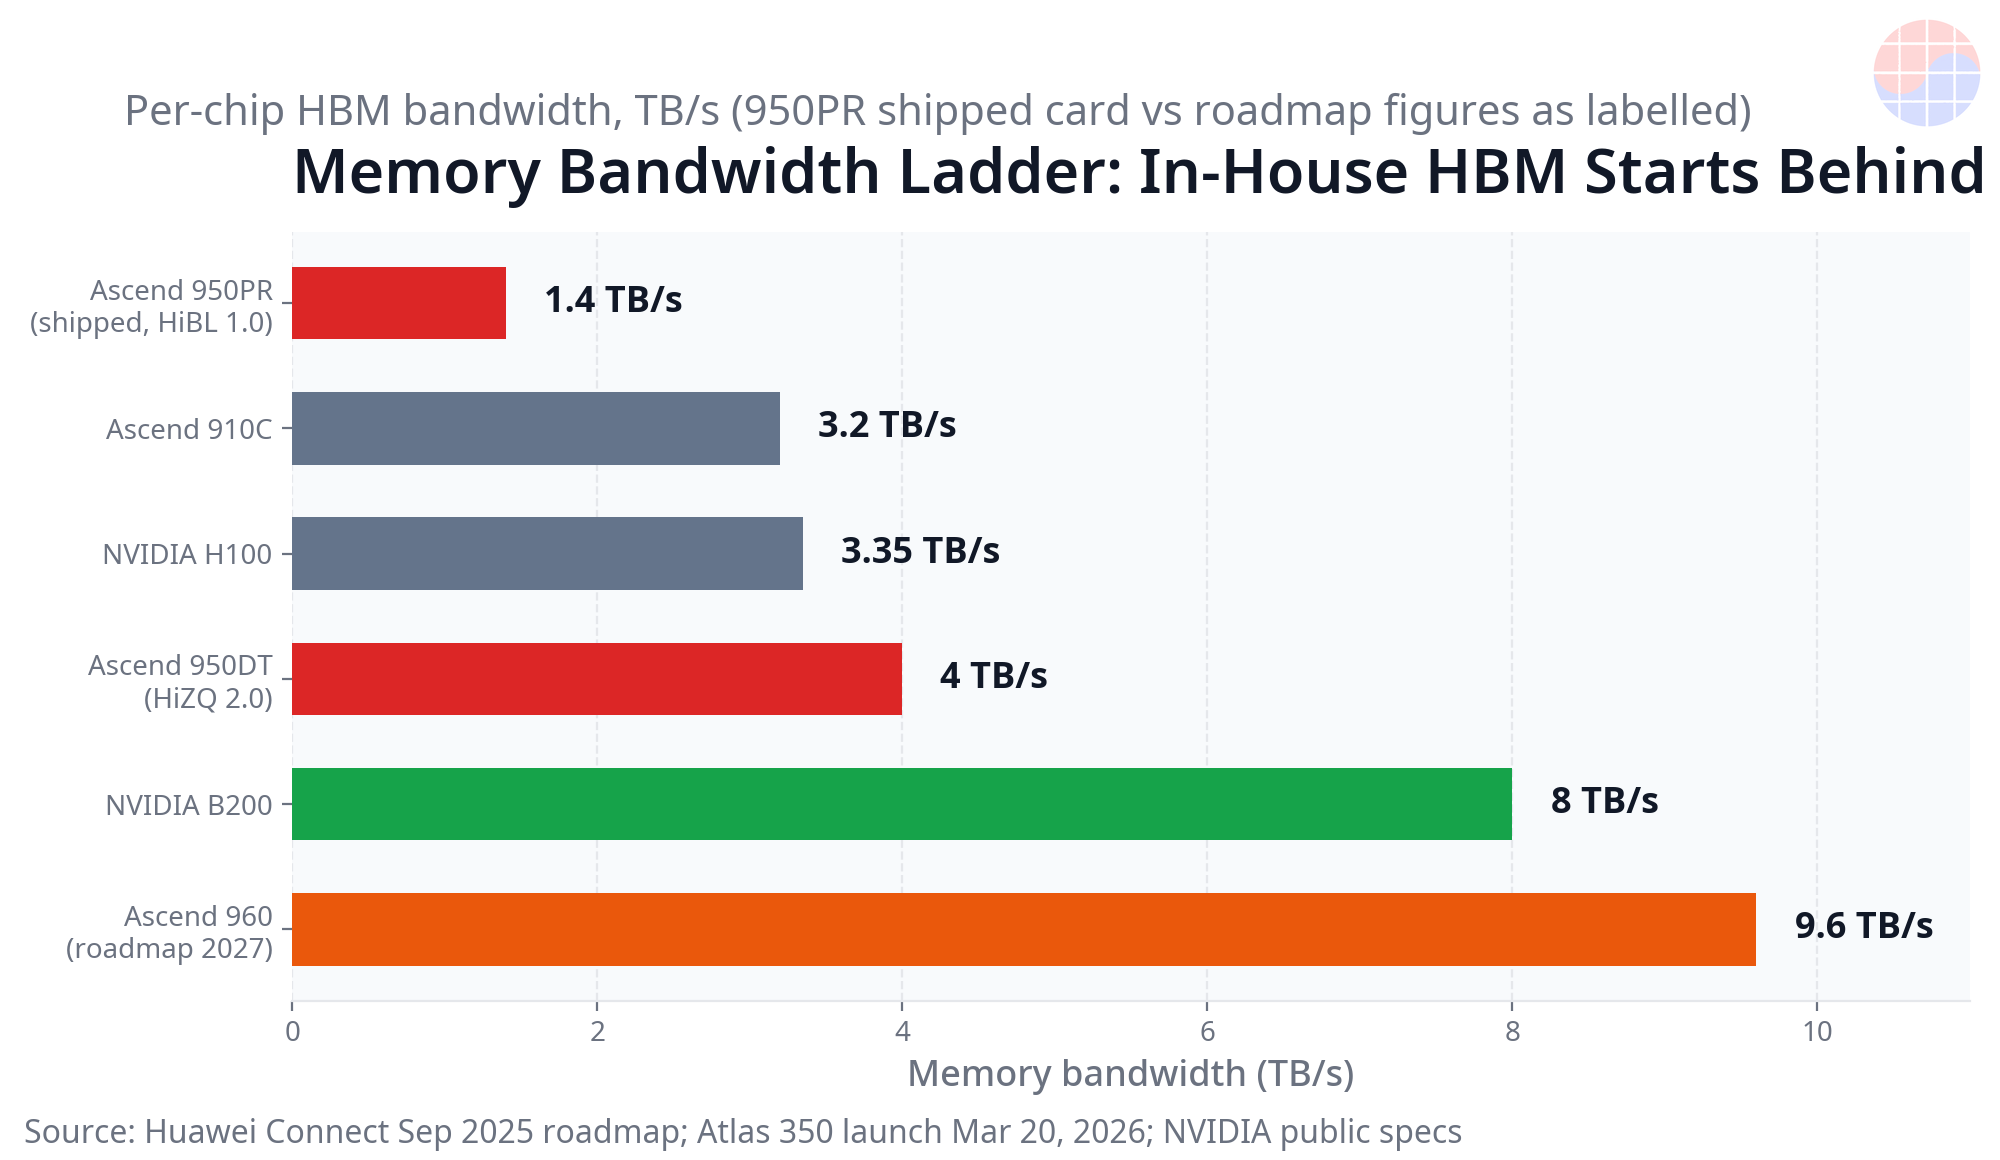
- Angka kunci: 950PR diumumkan dengan HBM in-house HiBL 1.0 sebesar 128GB dan 1.6 TB/s, tetapi kartu komersial Atlas 350 yang dilaporkan pada 20 Maret 2026 hadir dengan 112GB dan 1.4 TB/s. Kesenjangan antara roadmap dan spesifikasi yang dikirim adalah titik verifikasi pertama.
- DeepSeek mengumumkan melalui WeChat resminya pada 30 September 2026 bahwa mereka telah membuka sumber tumpukan pemrograman Ascend termasuk TileLang, bersama dengan solusi "supernode" bersama yang menghubungkan 128 chip Ascend 950.
- Skala: laporan 4 September 2026 menggambarkan DeepSeek merencanakan pusat data sekitar 1GW di Ulanqab, Mongolia Dalam, yang dibangun di sekitar 160.000 chip Ascend atau lebih. Ini adalah laporan, bukan pengumuman perusahaan yang dikonfirmasi.
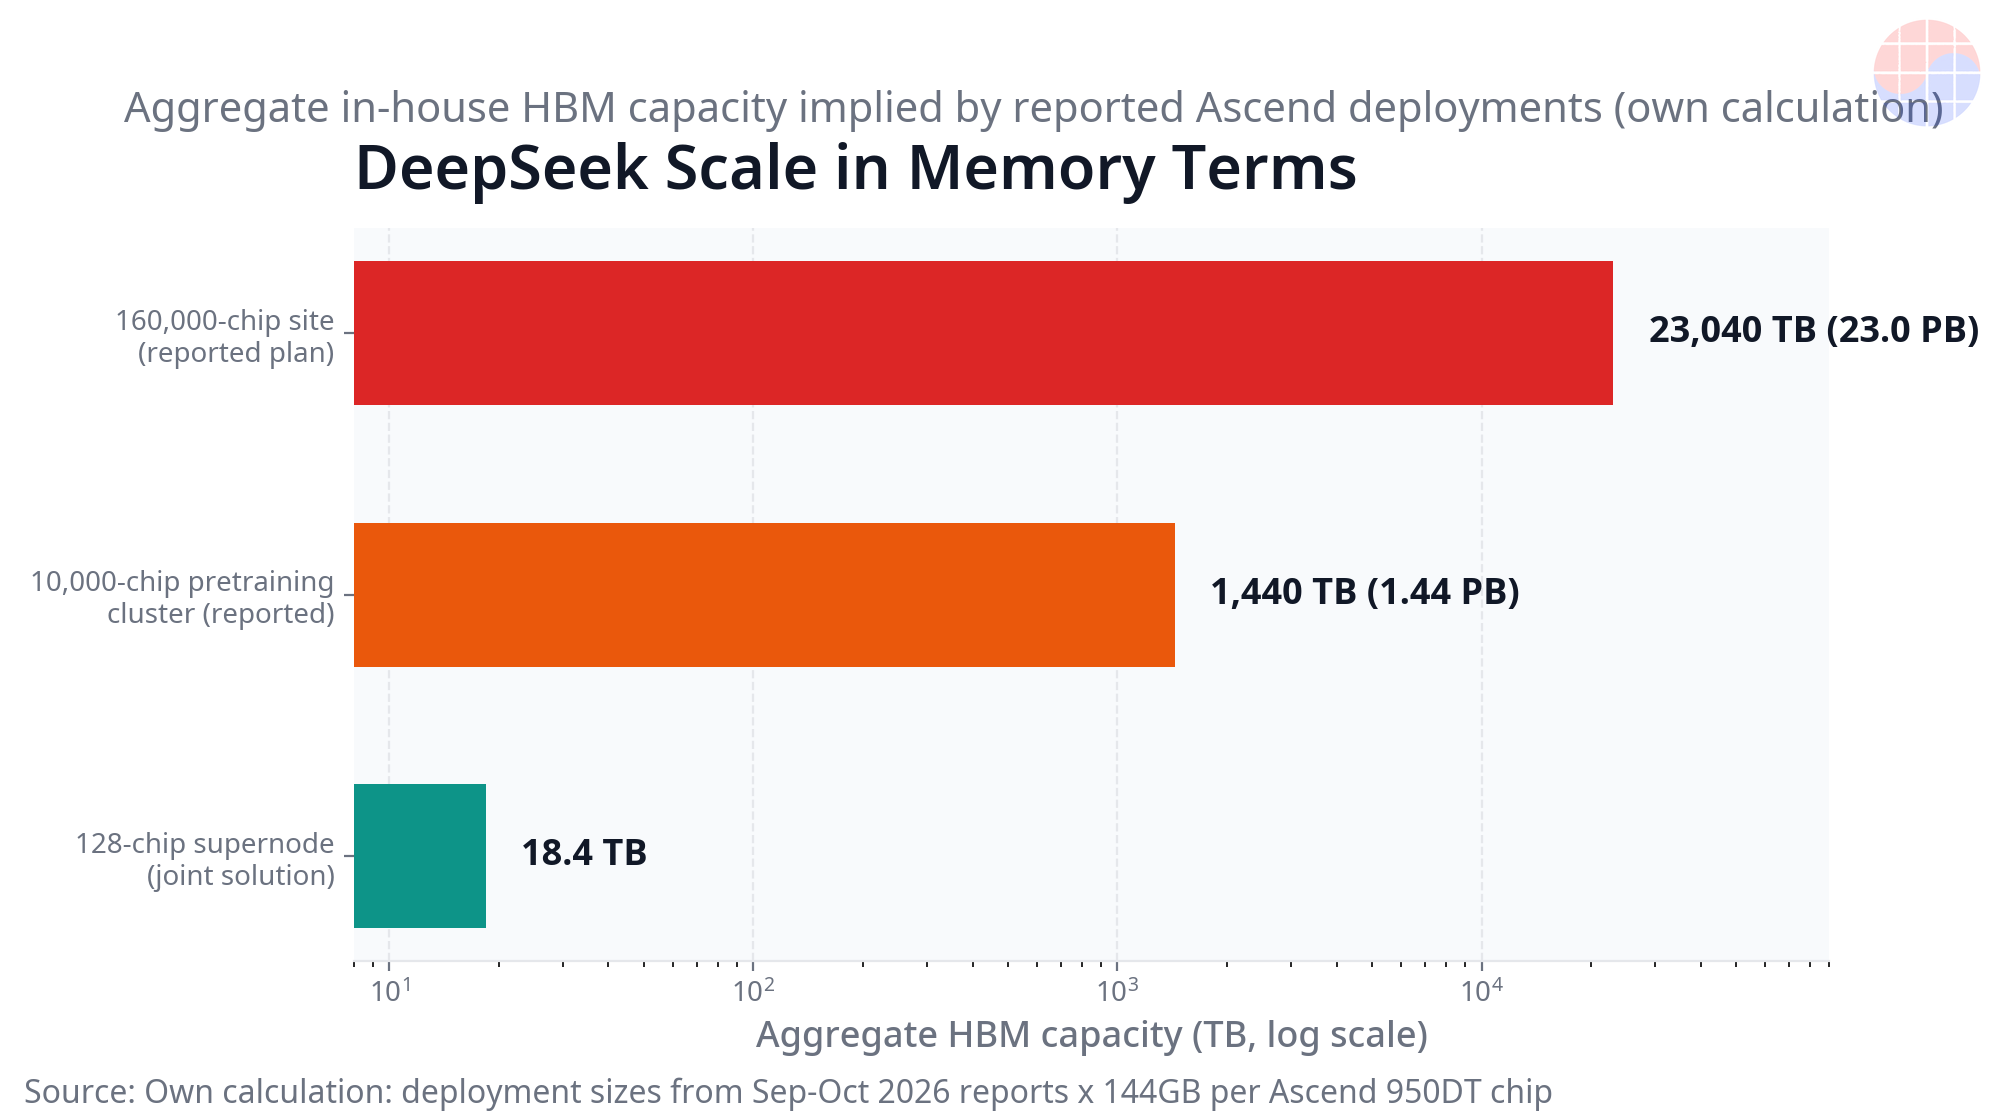
- Perhitungan sendiri: dengan 144GB per chip 950DT, situs 160.000 chip setara dengan 23.0PB total kapasitas memori (perhitungan sendiri).
Latar Belakang
Generasi sebelumnya, Ascend 910C, memasuki produksi massal pada Q1 2025 dengan sekitar 800 TFLOPS FP16, lebar pita memori 3.2 TB/s, dan kapasitas 128GB — menggunakan HBM yang dibeli. Perubahan terbesar pada generasi 950 bukanlah inti komputasi, melainkan pasokan memori itu sendiri. Dengan codesign HBM in-house — bermerek HiBL 1.0 dan HiZQ 2.0 — bersama die logika, Huawei memindahkan pengadaan memori dari rantai pasok eksternal ke roadmap-nya sendiri.
Kontrol ekspor berada di balik pergeseran ini. Aturan HBM BIS Desember 2024 sudah membatasi ekspor HBM canggih ke Tiongkok, sehingga Samsung Electronics dan SK hynix tidak dapat menjual HBM kepada Huawei. Oleh karena itu, peningkatan Ascend tidak secara langsung mengambil pesanan HBM Korea. Pertanyaan sebenarnya bersifat orde kedua: jika logika, memori, dan perangkat lunak semuanya matang di dalam Tiongkok sebagai satu tumpukan pasokan mandiri, salah satu kumpulan permintaan HBM masa depan terbesar dapat mengeras di luar pasar yang dapat dijangkau — dan sebagai standar ekosistem pesaing.
CEO NVIDIA Jensen Huang mengatakan dalam pernyataan publik 2026 bahwa pembatasan ekspor AS mendorong pangsa NVIDIA di pasar chip AI canggih Tiongkok dari sekitar 95% menjadi secara efektif nol, dan bahwa penjualan H200 ke Tiongkok berada di bawah 1% dari pendapatan pusat data pada kuartal yang berakhir 26 Juli 2026. Pertanyaan utamanya adalah seberapa cepat — dan seberapa jauh — kombinasi Huawei–DeepSeek dapat mengisi kekosongan itu.
Perangkat lunak bergerak ke arah yang sama. TileLang, DeepGEMM, DeepEP, FlashMLA, TileKernels, dan DeepSelect — yang dibuka sumbernya oleh DeepSeek — dipetakan satu-satu ke padanannya dalam tumpukan NVIDIA, dan DeepSeek memposisikan TileLang sebagai lebih sederhana untuk diprogram daripada CUDA. Tujuan yang dinyatakan adalah ekosistem perangkat lunak GPU yang independen dan dapat dikendalikan sendiri.
Analisis Mendalam
1. Irama tahunan yang dibagi menjadi dua jalur — 950PR untuk prefill, 950DT untuk decode dan pelatihan
Kesimpulannya: Huawei tidak merancang satu chip, melainkan dua varian memori yang disetel untuk beban kerja yang berbeda. Menurut roadmap yang dipresentasikan oleh ketua bergilir Eric Xu di Huawei Connect pada September 2025, Ascend 950PR dijadwalkan untuk Q1 2026 dengan 1 PFLOPS FP8, 2 PFLOPS FP4, interkoneksi 2 TB/s, dan HBM in-house HiBL 1.0 sebesar 128GB dan 1.6 TB/s, menargetkan prefill ditambah inferensi rekomendasi. Ascend 950DT dijadwalkan untuk Q4 2026 dengan 144GB HiZQ 2.0 pada 4.0 TB/s, menargetkan decode dan pelatihan. Pengumuman yang sama menempatkan Ascend 960 pada Q4 2027 dengan 288GB dan 9.6 TB/s dengan sekitar dua kali komputasi 950, dan Ascend 970 pada Q4 2028 (angka roadmap, menurut pengumuman Huawei).
2. Kartu komersial Atlas 350 versus roadmap — klaim Huawei harus dibaca terpisah dari titik verifikasi
Kesimpulannya: produk yang dikirim dilaporkan di bawah angka roadmap, dan setiap perbandingan kinerja harus dibaca sebagai klaim Huawei. Pada Huawei China Partner Conference pada 20 Maret 2026, kepala bisnis Ascend Zhang Dixuan meluncurkan Atlas 350, kartu komersial berbasis Ascend 950PR, yang dilaporkan memiliki 1.56 PFLOPS FP4, 112GB HBM in-house, lebar pita memori 1.4 TB/s, dan 600W. Huawei mengklaim kartu ini menghasilkan komputasi FP4 2.8x dari H20 NVIDIA, kapasitas HBM 1.16x, dan kecepatan pembuatan multimodal hingga 60% lebih cepat. Ini adalah klaim vendor, bukan benchmark independen. Kesenjangan antara roadmap September 2025 (128GB, 1.6 TB/s) dan kartu komersial Maret 2026 (112GB, 1.4 TB/s) bukanlah kesalahan yang harus disembunyikan — itu adalah titik verifikasi, dan pertanyaannya adalah apakah kesenjangan itu tertutup pada varian DT.
3. Generasi HBM in-house pertama lebih lambat daripada HBM yang dibeli — lebar pita ditukar demi keamanan pasokan
Kesimpulannya: generasi pertama HBM in-house mundur dalam lebar pita, dan roadmap baru menutup kesenjangan itu pada HiZQ 2.0. Tangga lebar pita, yang disusun sebagai perhitungan sendiri yang berlabuh pada tanggal pengumuman, berbunyi sebagai berikut. Ascend 910C berada pada 3.2 TB/s (Q1 2025), 950PR yang dikirim pada 1.4 TB/s (dilaporkan 20 Maret 2026; HiBL 1.0), 950DT pada 4.0 TB/s (direncanakan Q4 2026; HiZQ 2.0), dan roadmap 960 pada 9.6 TB/s (Q4 2027). Sebagai referensi, spesifikasi publik NVIDIA menempatkan H100 pada 3.35 TB/s dan B200 pada 8.0 TB/s. Struktur komputasi-lebar pita 950PR yang dikirim — 1.56 PFLOPS FP4 terhadap 1.4 TB/s (perhitungan sendiri) — mengarah pada kesimpulan yang sama. Prefill sangat haus lebar pita, sehingga sistem memori PR itu sendiri adalah kendalanya; itulah alasan varian DT ada. Singkatnya, generasi HBM in-house pertama membeli kontrol pasokan dan membayarnya dengan lebar pita.
4. Sumber terbuka TileLang DeepSeek dan supernode 128 chip — perangkat lunak masuk ke dalam desain chip
Kesimpulannya: DeepSeek berhenti menjadi sekadar pelanggan dan menjadi codesigner, membuka sumber tumpukan pemrograman dan arsitektur supernode secara bersamaan. Dalam pengumuman WeChat resminya pada 30 September 2026, DeepSeek membuka sumber TileLang (bahasa tingkat tinggi dan kompiler), DeepGEMM, DeepEP, FlashMLA, TileKernels, dan DeepSelect, dipetakan satu-satu ke versi tumpukan NVIDIA-nya. Dalam pengumuman yang sama, dengan dukungan penuh dari Huawei, kedua perusahaan mempresentasikan solusi "supernode" bersama yang menghubungkan 128 chip Ascend 950 dan mengoptimalkan komputasi serta komunikasi secara bersamaan. Laporan dari Februari hingga April 2026 menggambarkan DeepSeek memberikan Huawei akses awal ke V4 sebelum pemasok AS, pratinjau V4 yang diadaptasi untuk chip Huawei, Huawei menyatakan chip-nya digunakan dalam sebagian pelatihan V4, dan DeepSeek V4-Flash yang dioptimalkan untuk chip Huawei. Masing-masing item ini harus dibaca sebagai laporan bertanggal.
5. Laporan penyebaran 160.000 chip dan rencana pra-pelatihan lebih dari 10.000 chip — menang secara agregat, bukan per chip
Kesimpulannya: jawaban Huawei bukanlah paritas per chip, melainkan scale-out melalui SuperPoD dan SuperCluster, dengan DeepSeek dilaporkan sebagai permintaan jangkar. Dalam pengumuman Huawei September 2025, Atlas 950 SuperPoD mengikat 8,192 NPU Ascend menjadi satu unit logis pada Q4 2026, dan Atlas 960 SuperPoD berskala hingga 15,488 NPU pada Q4 2027. Skala SuperCluster diumumkan pada lebih dari 500.000 chip untuk generasi 950 dan lebih dari 1.000.000 untuk generasi 960. Laporan 4 September 2026 menggambarkan DeepSeek merencanakan pusat data sekitar 1GW di Ulanqab, Mongolia Dalam, yang dibangun di sekitar 160.000 chip Ascend atau lebih, dengan chip-chip tersebut melayani beban kerja inferensi di sana. Laporan 19 Oktober 2026 menggambarkan insinyur Huawei yang ditempatkan di kantor DeepSeek memasukkan persyaratan pelatihan ke dalam desain chip generasi berikutnya, DeepSeek berencana memulai pra-pelatihan pada Ascend 950DT pada akhir 2026, eksekusi penuh yang mungkin membutuhkan lebih dari 10.000 chip yang berjalan selama berminggu-minggu, dan Huawei diperkirakan mengalokasikan sebagian besar pasokan Ascend 960DT kepada DeepSeek dengan pengiriman mulai Q1 2027. Semua ini adalah laporan, bukan pengumuman yang dikonfirmasi. Dikonversi sebagai perhitungan sendiri: dengan 144GB per chip 950DT, supernode 128 chip menampung 18.4TB, cluster pra-pelatihan 10.000 chip menampung kapasitas 1.44PB dengan lebar pita memori agregat 40 PB/s (pada 4.0 TB/s per chip), dan situs 160.000 chip menampung 23.0PB. Perkiraan independen pihak ketiga menempatkan komputasi mentah B300 NVIDIA pada sekitar 7x dari satu chip Ascend 950 — sebuah perkiraan — sehingga kesenjangan per chip tetap besar bahkan ketika strategi memindahkan kontes ke skala sistem.
Pandangan Chase
Hambatannya bergeser. Pada FP4 dan FP8, die logika sudah cukup dekat untuk inferensi; kendala yang mengikat sekarang adalah lebar pita memori per chip, kematangan perangkat lunak pelatihan pada skala 10.000 chip, dan volume. Dari sudut pandang praktisi STA/EDA, chip itu sendiri jarang yang pertama gagal — melainkan memori dan interkoneksi di sekitar chip, dan apakah pelatihan tetap stabil selama berminggu-minggu, bukan berhari-hari, pada skala itu. Saya akan memberi bobot lebih sedikit pada angka komputasi utama dan lebih banyak pada log stabilitas minggu ketiga, yang tidak dapat kita lihat.
SuperPoD adalah pertukaran tingkat sistem: terima kesenjangan per chip dan menang secara agregat melalui interkoneksi ditambah perangkat lunak yang codesign dengan pelanggan jangkar. Mengalirnya persyaratan rekayasa DeepSeek secara langsung ke desain chip Huawei mencerminkan pola codesign hyperscaler-ASIC. Ketika permintaan mendefinisikan spesifikasi, pemborosan roadmap menyusut — tetapi polis asuransinya juga menyusut, karena silikon disetel untuk beban kerja satu pelanggan.
Pembaca dapat memadatkan verifikasi menjadi empat pertanyaan. Pertama, apakah 950DT benar-benar dikirim pada Q4 2026 pada 4.0 TB/s dalam produk, bukan di roadmap? Kedua, apakah eksekusi pra-pelatihan yang dilaporkan untuk akhir 2026 selesai dan diungkapkan? Ketiga, apakah TileLang mempertahankan stabilitas pelatihan melewati 10.000 chip? Keempat, apakah kesenjangan kartu komersial 112GB versus 128GB tertutup pada varian DT?
Implikasi
Bagi investor, ini bukan cerita tentang pendapatan HBM Korea yang diambil hari ini. Sejak aturan Desember 2024, Samsung Electronics dan SK hynix memang tidak dapat menjual HBM canggih kepada Huawei. Implikasinya adalah penyusutan pasar yang dapat dijangkau dalam jangka panjang: jika tumpukan pasokan mandiri yang terdiri dari logika Ascend, memori HiBL/HiZQ, dan DRAM domestik matang di dalam Tiongkok, salah satu kumpulan permintaan masa depan terbesar mengeras menjadi standar yang tidak dapat dijangkau pemasok luar. Ekosistem perangkat lunak yang berpusat pada TileLang dan standar interkoneksi SuperPoD akan mempercepat penguncian itu.
Bagi manajemen, variabel CXMT termasuk dalam bingkai yang sama. Jika HBM in-house Huawei mencakup tingkat premium tetapi volume memori domestik tidak mengikuti, penyebaran 160.000 chip tetap menjadi rencana di atas kertas. Jika volume mengikuti, diskusi beralih dari kinerja chip tunggal ke total biaya kepemilikan pusat data, daya, dan biaya peralihan perangkat lunak.
Bagi NVIDIA, angka pangsa sudah menceritakan kisahnya: menurut pernyataan Jensen Huang pada 2026, posisinya di pasar canggih Tiongkok secara efektif telah hilang. Kontes bergeser ke dalam — kepada siapa yang menjadi standar di dalam Tiongkok. Jika kombinasi Huawei–DeepSeek menutup loop pelatihan secara stabil, label "alternatif hanya untuk inferensi" tidak lagi berlaku.
Tanya Jawab
T: Apa perbedaan antara Ascend 950PR dan 950DT? J: Menurut roadmap Huawei September 2025, 950PR dijadwalkan untuk Q1 2026 dengan 128GB HiBL 1.0 pada 1.6 TB/s untuk prefill dan inferensi rekomendasi, sedangkan 950DT dijadwalkan untuk Q4 2026 dengan 144GB HiZQ 2.0 pada 4.0 TB/s untuk decode dan pelatihan. Kartu Atlas 350 yang dikirim pada 20 Maret 2026 dilaporkan memiliki 112GB dan 1.4 TB/s, sehingga kesenjangan antara spesifikasi roadmap dan yang dikirim harus dilacak.
T: Apakah klaim kinerja Huawei 2.8x H20 terverifikasi? J: Tidak. Komputasi FP4 2.8x, kapasitas HBM 1.16x, dan kecepatan pembuatan multimodal hingga 60% lebih cepat yang diumumkan pada 20 Maret 2026 adalah klaim Huawei, bukan angka yang di-benchmark secara independen. Setiap perbandingan kinerja dalam artikel ini dilabeli sebagai klaim Huawei.
T: Apakah penyebaran 160.000 chip DeepSeek terkonfirmasi? J: Ini bukan pengumuman yang dikonfirmasi. Laporan 4 September 2026 menggambarkan rencana sekitar 1GW di Ulanqab, Mongolia Dalam, di sekitar lebih dari 160.000 chip Ascend, dan laporan 19 Oktober 2026 menggambarkan DeepSeek berencana memulai pra-pelatihan pada Ascend 950DT pada akhir 2026. Sebagai perhitungan sendiri, 160.000 chip 950DT setara dengan kapasitas memori 23.0PB.
T: Apakah peningkatan Ascend merugikan Samsung Electronics dan SK hynix secara langsung? J: Tidak dalam pesanan langsung. Aturan HBM BIS Desember 2024 sudah melarang ekspor HBM canggih ke Tiongkok, sehingga kedua perusahaan tidak dapat menjual HBM kepada Huawei. Risikonya bersifat orde kedua: tumpukan pasokan mandiri Tiongkok yang matang mengeraskan kumpulan permintaan HBM masa depan di luar pasar yang dapat dijangkau, dan kemajuan HBM CXMT adalah pelengkap volume yang harus diperhatikan.
Angka-angka dalam artikel ini didasarkan pada pengumuman Huawei, pengumuman DeepSeek, pernyataan NVIDIA, dan laporan bertanggal sebagaimana ditandai; perbandingan kinerja Huawei adalah klaim Huawei, item penyebaran dan pra-pelatihan adalah laporan, dan angka yang dikonversi adalah perhitungan sendiri.
Bacaan terkait
- Inferensi Terbagi Dua: 5 Fakta (Decode SRAM vs HBM)
- Micron Resmikan AATT2 di Taichung: Kapasitas Pengemasan HBM 2027 Ludes…
- Inferensi AI tanpa HBM? Taruhan 480GB LPDDR5X Intel dan perang TCO…
- SK hynix Menghentikan Pencatatan Solidigm: 5 Fakta tentang Pembiayaan…
- Kemacetan tersembunyi HBM adalah pengujian: dinding inspeksi di balik…
📩 Melewatkan analisis hari ini? Terima yang besok di email Anda
Daily Silicon pukul 10:30 KST plus poin penting laporan keuangan dan riset, lebih dulu. Saat berlangganan, pilih newsletter Korea, Inggris, atau Jepang; analisis Bahasa Indonesia terbit setiap hari di situs.
Berlangganan gratis →
Gratis · Tanpa spam · Berhenti kapan saja


