 VLSI Korea
Ascend 950 e sua HBM própria: 5 fatos sobre a aposta de 160.000 chips da DeepSeek e o gargalo de memória (HBM·SuperPoD)
A Huawei aposta em HBM própria HiBL/HiZQ para o Ascend 950, mas a Atlas 350 chegou com 112GB e 1.4 TB/s frente aos 128GB e 1.6 TB/s do roteiro. A DeepSeek codesenha com TileLang e um supernode de 128 chips.


🆓 Artigo gratuito · Qualquer pessoa pode ler gratuitamente
A batalha pelo Ascend 950 não será decidida pelo poder de computação, mas pela largura de banda da HBM desenvolvida internamente — e o codesign da Huawei e da DeepSeek é uma tentativa de romper esse gargalo com escala.
Resumo em 30 segundos
- Conclusão primeiro: a Huawei anunciou no Huawei Connect em setembro de 2025 que o Ascend 950PR chegaria no primeiro trimestre de 2026 e o Ascend 950DT no quarto trimestre de 2026, com uma cadência anual de gerações.
- Números-chave: o 950PR foi anunciado com HBM própria HiBL 1.0 de 128GB e 1.6 TB/s, mas a placa comercial Atlas 350, apresentada em 20 de março de 2026, chegou com 112GB e 1.4 TB/s. A diferença entre o roteiro e as especificações comerciais é o primeiro ponto de verificação.
- A DeepSeek anunciou por seu WeChat oficial em 30 de setembro de 2026 que havia disponibilizado em código aberto uma pilha de programação para Ascend incluindo o TileLang, junto com uma solução conjunta de "supernode" conectando 128 chips Ascend 950.
- Escala: um relatório de 4 de setembro de 2026 descreveu que a DeepSeek planeja um centro de dados de cerca de 1GW em Ulanqab, Mongólia Interior, construído em torno de 160.000 ou mais chips Ascend. Isso é um relatório, não um anúncio confirmado da empresa.
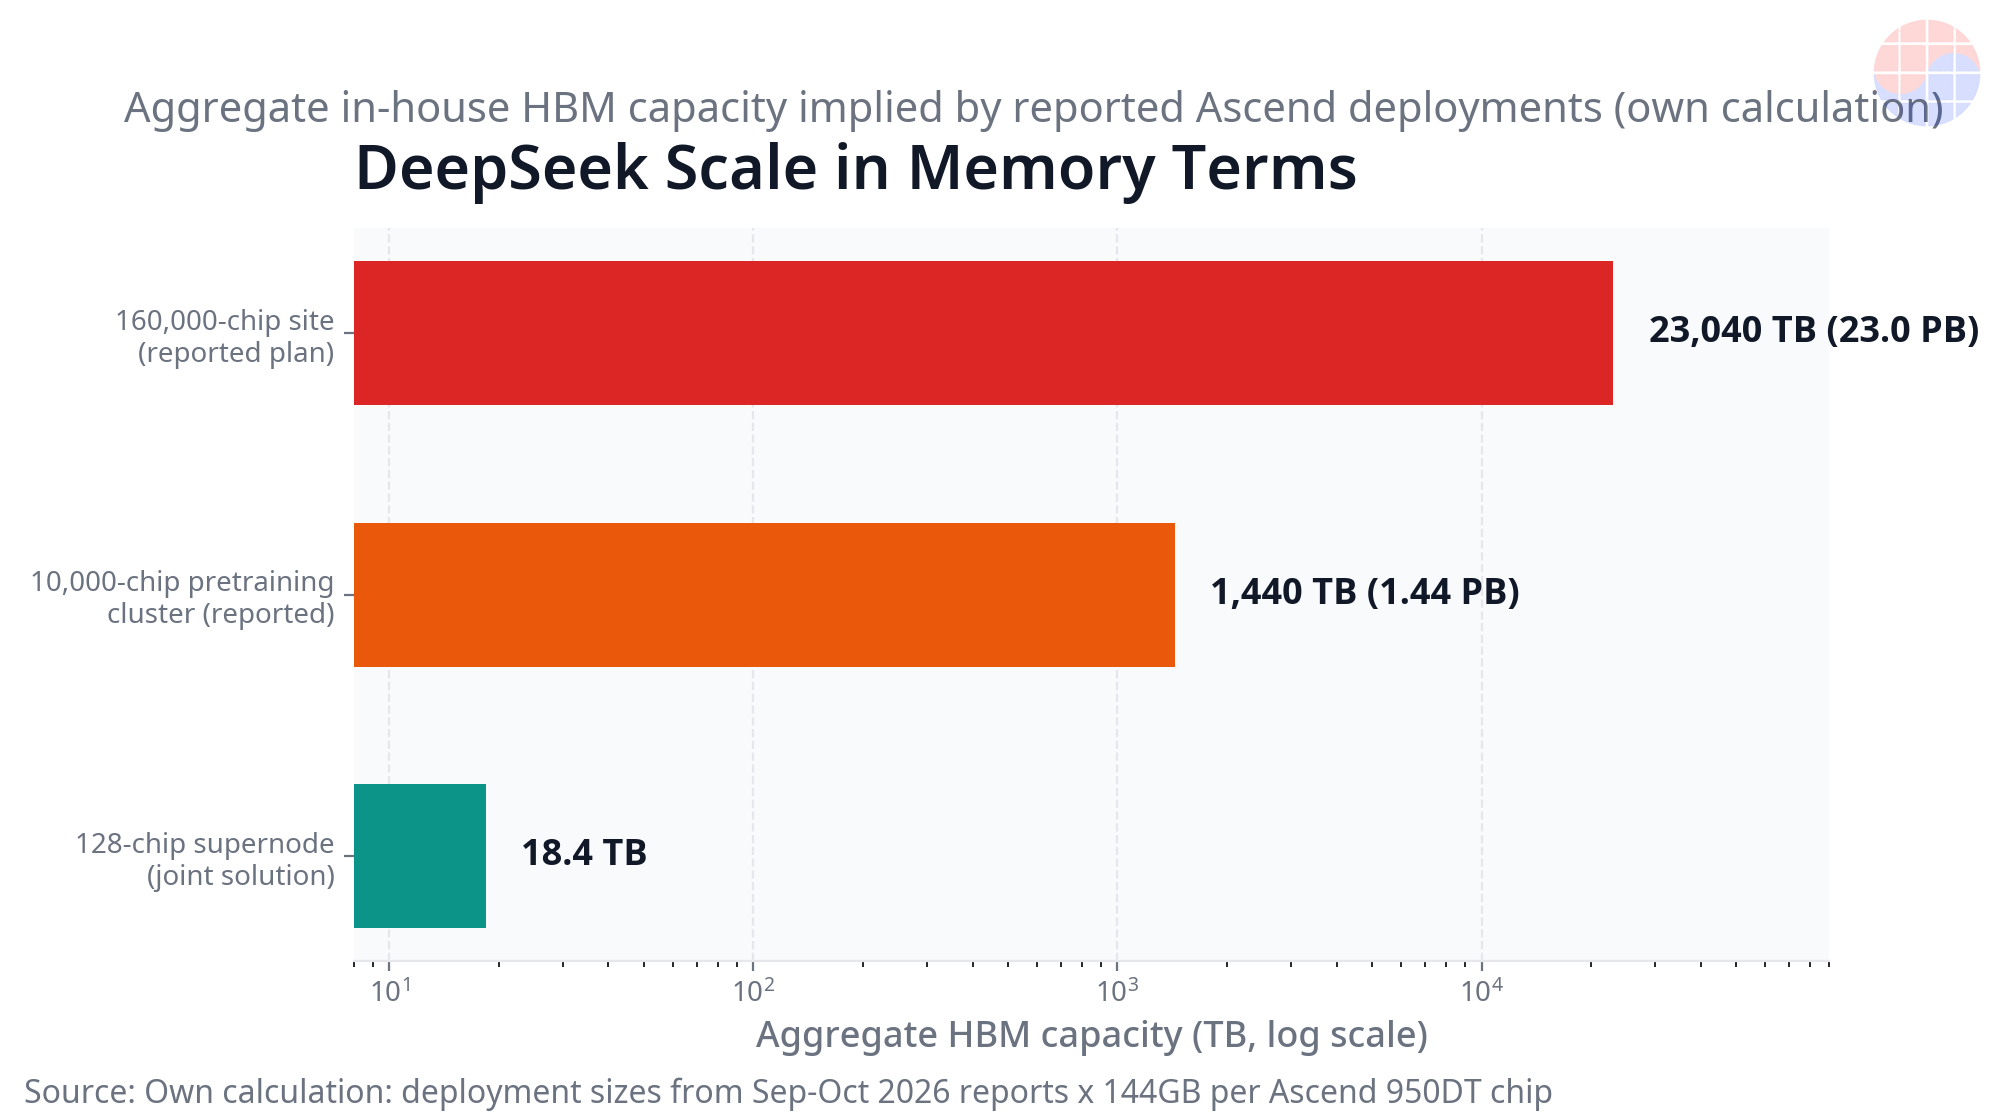
- Cálculo próprio: com 144GB por chip 950DT, um site de 160.000 chips corresponde a 23.0PB de capacidade total de memória (cálculo próprio).
Contexto
A geração anterior, o Ascend 910C, entrou em produção em massa no primeiro trimestre de 2025 com aproximadamente 800 TFLOPS de FP16, 3.2 TB/s de largura de banda de memória e 128GB de capacidade — usando HBM comprada. A maior mudança na geração 950 não é o núcleo de computação, mas o próprio fornecimento de memória. Ao codesenhar HBM própria — sob as marcas HiBL 1.0 e HiZQ 2.0 — junto com o die lógico, a Huawei transfere a aquisição de memória das cadeias de suprimentos externas para seu próprio roteiro.
Os controles de exportação estão por trás dessa mudança. A regra HBM do BIS de dezembro de 2024 já restringe as exportações de HBM avançada para a China, de modo que a Samsung Electronics e a SK hynix não podem vender HBM para a Huawei. Portanto, uma expansão do Ascend não retira diretamente pedidos de HBM coreana. A questão real é de segunda ordem: se lógica, memória e software amadurecerem todos dentro da China como uma única pilha de autofornecimento, um dos maiores futuros pools de demanda de HBM pode se consolidar fora do mercado endereçável — e como um padrão de ecossistema concorrente.
O CEO da NVIDIA, Jensen Huang, afirmou em declarações públicas de 2026 que as restrições de exportação dos EUA reduziram a participação da NVIDIA no mercado chinês de chips avançados de IA de cerca de 95% para efetivamente zero, e que as vendas de H200 para a China ficaram abaixo de 1% da receita de centro de dados no trimestre encerrado em 26 de julho de 2026. A pergunta central é com que rapidez — e até onde — a combinação Huawei–DeepSeek pode preencher esse vácuo.
O software se move na mesma direção. TileLang, DeepGEMM, DeepEP, FlashMLA, TileKernels e DeepSelect — disponibilizados em código aberto pela DeepSeek — correspondem um a um aos seus equivalentes na pilha da NVIDIA, e a DeepSeek posiciona o TileLang como mais simples de programar do que o CUDA. O objetivo declarado é um ecossistema de software para GPU independente e autocontrolado.
Análise aprofundada
1. Uma cadência anual dividida em duas trilhas — 950PR para prefill, 950DT para decode e treinamento
A conclusão: a Huawei não projetou um único chip, mas duas variantes de memória ajustadas para cargas de trabalho diferentes. Segundo o roteiro apresentado pelo presidente rotativo Eric Xu no Huawei Connect em setembro de 2025, o Ascend 950PR estava previsto para o primeiro trimestre de 2026 com 1 PFLOPS de FP8, 2 PFLOPS de FP4, 2 TB/s de interconexão e HBM própria HiBL 1.0 de 128GB e 1.6 TB/s, voltado a prefill mais inferência de recomendação. O Ascend 950DT estava previsto para o quarto trimestre de 2026 com 144GB de HiZQ 2.0 a 4.0 TB/s, voltado a decode e treinamento. O mesmo anúncio colocou o Ascend 960 no quarto trimestre de 2027 com 288GB e 9.6 TB/s, com aproximadamente o dobro da computação do 950, e o Ascend 970 no quarto trimestre de 2028 (números de roteiro, segundo o anúncio da Huawei).
2. A placa comercial Atlas 350 versus o roteiro — as alegações da Huawei devem ser lidas separadas dos pontos de verificação
A conclusão: o produto comercial foi reportado abaixo dos números do roteiro, e toda comparação de desempenho deve ser lida como uma alegação da Huawei. Na Huawei China Partner Conference em 20 de março de 2026, o chefe do negócio Ascend, Zhang Dixuan, apresentou a Atlas 350, uma placa comercial baseada no Ascend 950PR, reportada com 1.56 PFLOPS de FP4, 112GB de HBM própria, 1.4 TB/s de largura de banda de memória e 600W. A Huawei alega que essa placa entrega 2.8x a computação FP4 da H20 da NVIDIA, 1.16x sua capacidade HBM e até 60% mais velocidade de geração multimodal. Essas são alegações do fabricante, não benchmarks independentes. A diferença entre o roteiro de setembro de 2025 (128GB, 1.6 TB/s) e a placa comercial de março de 2026 (112GB, 1.4 TB/s) não é um erro a esconder — é o ponto de verificação, e a questão é se a diferença se fecha na variante DT.
3. A primeira geração de HBM própria foi mais lenta que a HBM comprada — largura de banda em troca de segurança de fornecimento
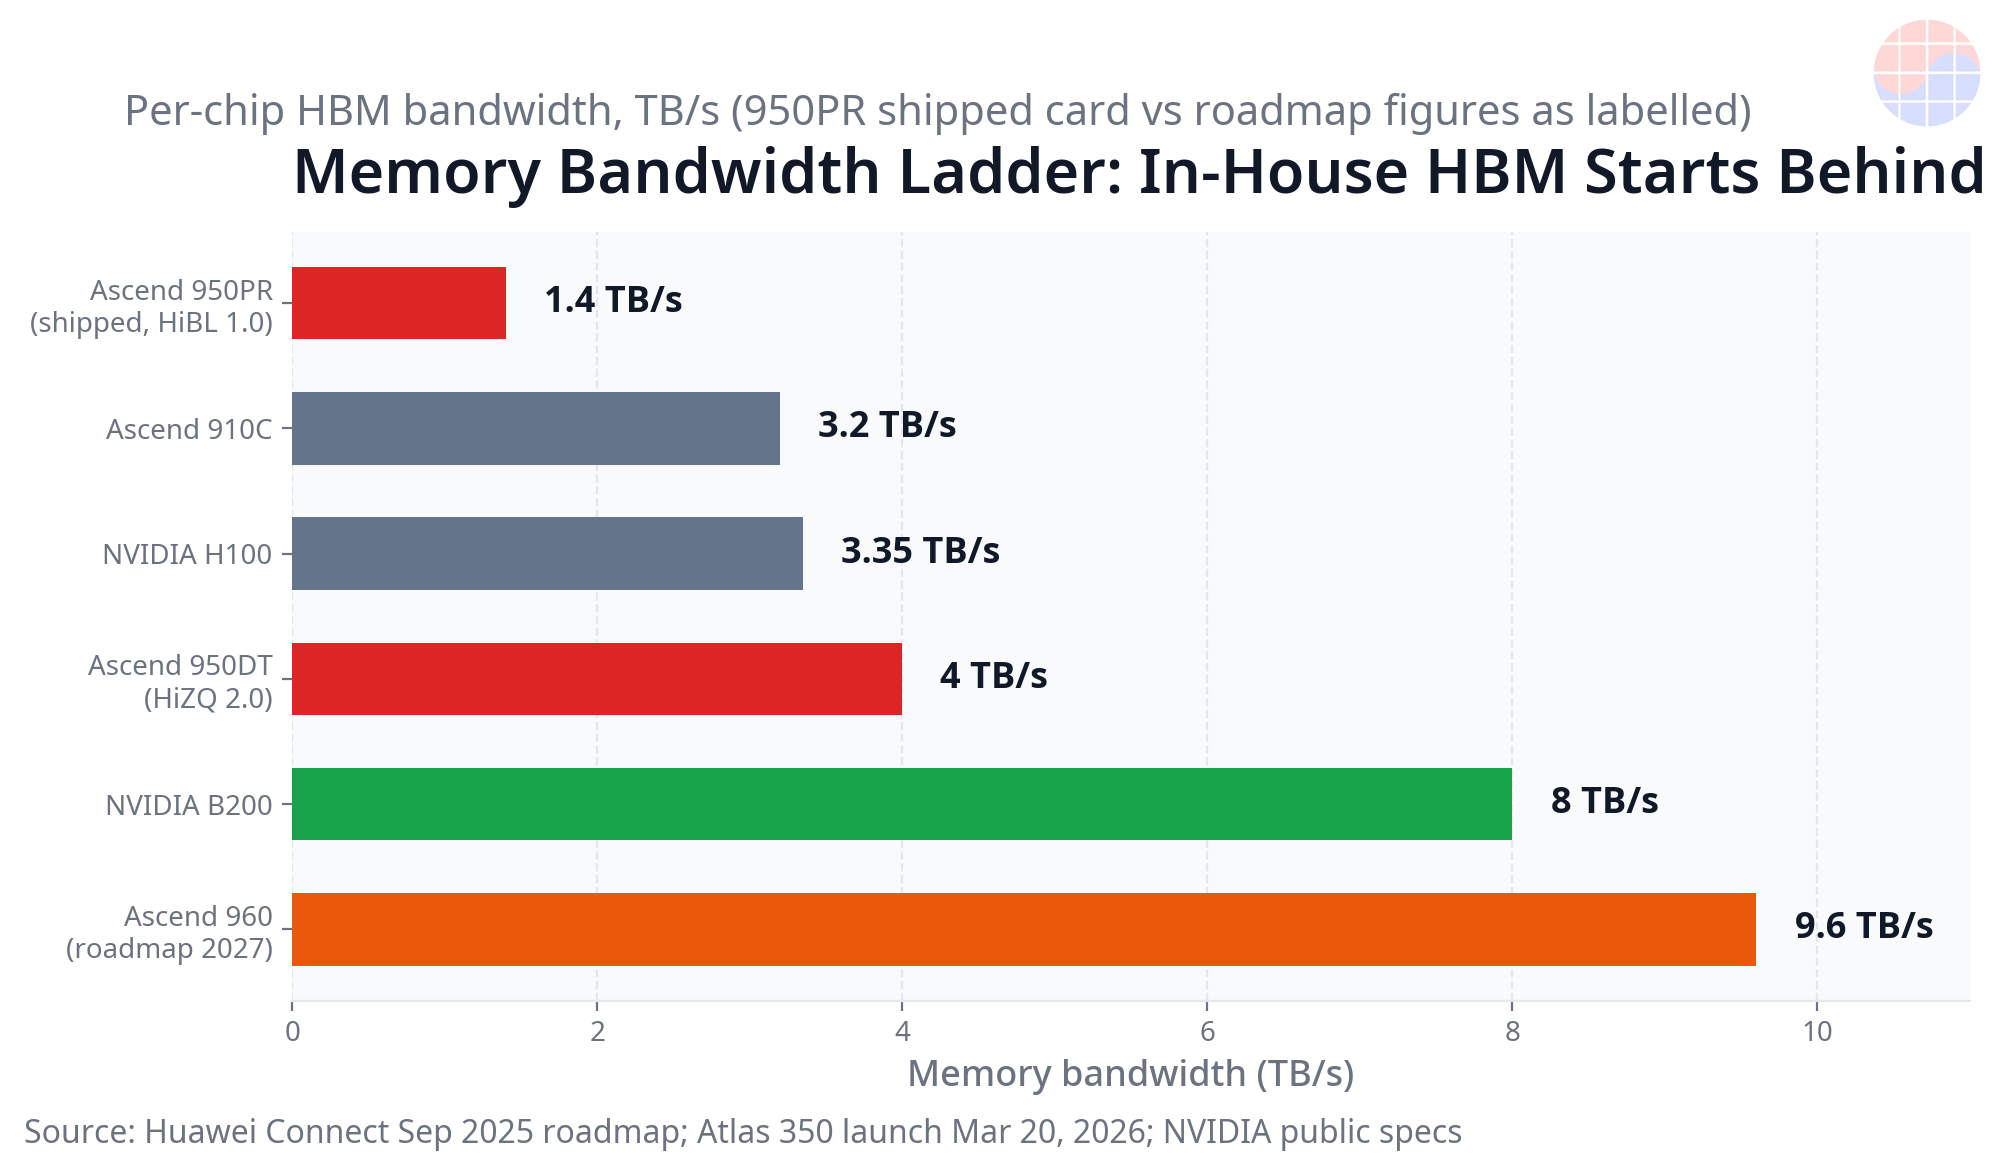
A conclusão: a primeira geração de HBM própria recua em largura de banda, e o roteiro só fecha essa lacuna com a HiZQ 2.0. A escada de largura de banda, elaborada como cálculo próprio ancorado nas datas de anúncio, lê-se assim. O Ascend 910C ficou em 3.2 TB/s (primeiro trimestre de 2025), o 950PR comercial em 1.4 TB/s (reportado em 20 de março de 2026; HiBL 1.0), o 950DT em 4.0 TB/s (planejado para o quarto trimestre de 2026; HiZQ 2.0) e o roteiro do 960 em 9.6 TB/s (quarto trimestre de 2027). Como referência, as especificações públicas da NVIDIA colocam a H100 em 3.35 TB/s e a B200 em 8.0 TB/s. A estrutura computação-largura de banda do 950PR comercial — 1.56 PFLOPS de FP4 frente a 1.4 TB/s (cálculo próprio) — aponta para a mesma conclusão. O prefill consome muita largura de banda, portanto o sistema de memória do PR é ele próprio a restrição; essa é exatamente a razão pela qual a variante DT existe. Em resumo, a primeira geração de HBM própria comprou controle de fornecimento e pagou por isso em largura de banda.
4. O código aberto do TileLang da DeepSeek e o supernode de 128 chips — o software entrou no projeto do chip
A conclusão: a DeepSeek deixou de ser apenas uma cliente e se tornou codesigner, disponibilizando em código aberto a pilha de programação e a arquitetura de supernode juntas. Em seu anúncio oficial no WeChat em 30 de setembro de 2026, a DeepSeek disponibilizou em código aberto o TileLang (uma linguagem de alto nível e compilador), DeepGEMM, DeepEP, FlashMLA, TileKernels e DeepSelect, em correspondência um a um com suas versões da pilha da NVIDIA. No mesmo anúncio, com total apoio da Huawei, as duas empresas apresentaram uma solução conjunta de "supernode" conectando 128 chips Ascend 950 e otimizando computação e comunicação juntas. Relatórios de fevereiro a abril de 2026 descrevem que a DeepSeek deu à Huawei acesso antecipado ao V4 antes de fornecedores dos EUA, que a prévia do V4 foi adaptada para chips Huawei, que a Huawei afirmou que seus chips foram usados em parte do treinamento do V4 e que o DeepSeek V4-Flash foi otimizado para chips Huawei. Cada um desses itens deve ser lido como um relatório datado.
5. O relatório de implantação de 160.000 chips e o plano de pré-treinamento de mais de 10.000 chips — vencer no agregado, não por chip
A conclusão: a resposta da Huawei não é a paridade por chip, mas a expansão horizontal via SuperPoD e SuperCluster, com a DeepSeek reportada como a demanda âncora. No anúncio da Huawei de setembro de 2025, o Atlas 950 SuperPoD agrupa 8,192 NPU Ascend em uma única unidade lógica no quarto trimestre de 2026, e o Atlas 960 SuperPoD escala até 15,488 NPU no quarto trimestre de 2027. A escala do SuperCluster foi anunciada em mais de 500.000 chips para a geração 950 e mais de 1.000.000 para a geração 960. Um relatório de 4 de setembro de 2026 descreveu que a DeepSeek planeja um centro de dados de cerca de 1GW em Ulanqab, Mongólia Interior, construído em torno de 160.000 ou mais chips Ascend, com esses chips atendendo cargas de inferência lá. Um relatório de 19 de outubro de 2026 descreveu engenheiros da Huawei alocados nos escritórios da DeepSeek incorporando requisitos de treinamento ao projeto de chips de próxima geração, a DeepSeek planejando iniciar o pré-treinamento no Ascend 950DT até o fim de 2026, uma execução completa possivelmente exigindo mais de 10.000 chips rodando por semanas, e a Huawei com expectativa de alocar a maior parte do fornecimento do Ascend 960DT para a DeepSeek, com entregas a partir do primeiro trimestre de 2027. Tudo isso são relatórios, não anúncios confirmados. Convertido como cálculo próprio: com 144GB por chip 950DT, um supernode de 128 chips detém 18.4TB, um cluster de pré-treinamento de 10.000 chips detém 1.44PB de capacidade com 40 PB/s de largura de banda de memória agregada (a 4.0 TB/s por chip), e um site de 160.000 chips detém 23.0PB. Estimativas independentes de terceiros colocam a computação bruta da B300 da NVIDIA em aproximadamente 7x a de um único chip Ascend 950 — uma estimativa — portanto a lacuna por chip continua grande, mesmo quando a estratégia transfere a disputa para a escala do sistema.
A visão de Chase
O gargalo se deslocou. Em FP4 e FP8, os dies lógicos estão perto o suficiente de serem bons para inferência; as restrições vinculantes são agora a largura de banda de memória por chip, a maturidade do software de treinamento em escala de 10.000 chips e o volume. Do ponto de vista de um profissional de STA/EDA, o chip em si raramente é o primeiro a falhar — é a memória e a interconexão ao redor do chip, e se o treinamento permanece estável por semanas em vez de dias nessa escala. Eu daria menos peso aos números principais de computação e mais aos registros de estabilidade da terceira semana, que são os que não vemos.
O SuperPoD é uma troca em nível de sistema: aceitar a lacuna por chip e vencer no agregado por meio de interconexão mais software codesenhado com o cliente âncora. O fato de os requisitos de engenharia da DeepSeek fluírem diretamente para o projeto de chips da Huawei espelha o padrão de codesign hyperscaler-ASIC. Quando a demanda define a especificação, o desperdício do roteiro diminui — mas a apólice de seguro também diminui, porque o silício é ajustado às cargas de trabalho de um único cliente.
Os leitores podem comprimir a verificação em quatro perguntas. Primeiro, o 950DT realmente chega ao mercado no quarto trimestre de 2026 a 4.0 TB/s em produto, não em um roteiro? Segundo, a execução de pré-treinamento reportada para o fim de 2026 se completa e é divulgada? Terceiro, o TileLang mantém a estabilidade do treinamento além de 10.000 chips? Quarto, a diferença da placa comercial de 112GB versus 128GB se fecha na variante DT?
Implicações
Para investidores, esta não é uma história sobre receita de HBM coreana sendo retirada hoje. Desde a regra de dezembro de 2024, a Samsung Electronics e a SK hynix já não podiam vender HBM avançada para a Huawei. A implicação é o encolhimento do mercado endereçável de longo prazo: se uma pilha de autofornecimento composta por lógica Ascend, memória HiBL/HiZQ e DRAM doméstica amadurecer dentro da China, um dos maiores futuros pools de demanda se consolida em um padrão que fornecedores externos não podem alcançar. Um ecossistema de software centrado no TileLang e um padrão de interconexão SuperPoD acelerariam esse aprisionamento.
Para a gestão, a variável CXMT pertence ao mesmo quadro. Se a HBM própria da Huawei cobrir o segmento premium, mas o volume de memória doméstica não acompanhar, uma implantação de 160.000 chips permanece um plano no papel. Se o volume acompanhar, a discussão passa do desempenho de um único chip para o custo total de propriedade do centro de dados, energia e custos de troca de software.
Para a NVIDIA, os números de participação já contam a história: segundo as declarações de Jensen Huang em 2026, sua posição no mercado avançado da China desapareceu efetivamente. A disputa está se deslocando para dentro — para quem se torna o padrão dentro da China. Se a combinação Huawei–DeepSeek fechar o ciclo de treinamento de forma estável, o rótulo de "alternativa apenas para inferência" não se sustenta mais.
Perguntas frequentes
P: Qual é a diferença entre o Ascend 950PR e o 950DT? R: Segundo o roteiro da Huawei de setembro de 2025, o 950PR estava previsto para o primeiro trimestre de 2026 com 128GB de HiBL 1.0 a 1.6 TB/s para prefill e inferência de recomendação, enquanto o 950DT estava previsto para o quarto trimestre de 2026 com 144GB de HiZQ 2.0 a 4.0 TB/s para decode e treinamento. A placa Atlas 350 comercializada em 20 de março de 2026 foi reportada com 112GB e 1.4 TB/s, portanto a diferença entre especificação de roteiro e especificação comercial deve ser acompanhada.
P: A alegação da Huawei de 2.8x de desempenho frente à H20 está verificada? R: Não. A computação FP4 de 2.8x, a capacidade HBM de 1.16x e até 60% mais velocidade de geração multimodal anunciados em 20 de março de 2026 são alegações da Huawei, não números verificados de forma independente. Toda comparação de desempenho neste artigo está rotulada como alegação da Huawei.
P: A implantação de 160.000 chips da DeepSeek está confirmada? R: Não é um anúncio confirmado. Um relatório de 4 de setembro de 2026 descreveu um plano de cerca de 1GW em Ulanqab, Mongólia Interior, em torno de mais de 160.000 chips Ascend, e um relatório de 19 de outubro de 2026 descreveu que a DeepSeek planeja iniciar o pré-treinamento no Ascend 950DT até o fim de 2026. Como cálculo próprio, 160.000 chips 950DT correspondem a 23.0PB de capacidade de memória.
P: A expansão do Ascend prejudica diretamente a Samsung Electronics e a SK hynix? R: Não em pedidos diretos. A regra HBM do BIS de dezembro de 2024 já proíbe exportações de HBM avançada para a China, portanto nenhuma das duas empresas pode vender HBM para a Huawei. O risco é de segunda ordem: uma pilha chinesa de autofornecimento em maturação consolida um futuro pool de demanda de HBM fora do mercado endereçável, e o progresso de HBM da CXMT é o complemento de volume a observar.
Os números deste artigo baseiam-se em anúncios da Huawei, no anúncio da DeepSeek, em declarações da NVIDIA e em relatórios datados conforme indicado; as comparações de desempenho da Huawei são alegações da Huawei, os itens de implantação e pré-treinamento são relatórios, e os números convertidos são cálculos próprios.
Leitura relacionada
- A inferência se divide em duas: 5 fatos (decodificação SRAM vs. HBM)
- O gargalo oculto da HBM é o teste: o muro de inspeção por trás das…
- O gargalo oculto da HBM é o teste: o muro de inspeção por trás das…
- Micron inaugura AATT2 em Taichung: capacidade de encapsulamento HBM…
- Inferência de IA sem HBM? A aposta de 480 GB LPDDR5X da Intel e a…
📩 Perdeu a análise de hoje? Receba a de amanhã no seu e-mail
Daily Silicon às 10:30 KST e os principais pontos de resultados e relatórios, primeiro. Ao assinar, você escolhe a newsletter em coreano, inglês ou japonês; as análises em português saem todos os dias no site.
Assinar grátis →
Grátis · Sem spam · Cancele quando quiser


